Ringkasan: Artikel ini membandingkan budget output, nilai default reasoning, dan cara penagihan antara Qwen4-Max-Preview dengan versi resmi Qwen4-Max, serta memberikan langkah pemeriksaan migrasi yang bisa dijalankan satu per satu sebelum Preview berhenti pada 25 November.
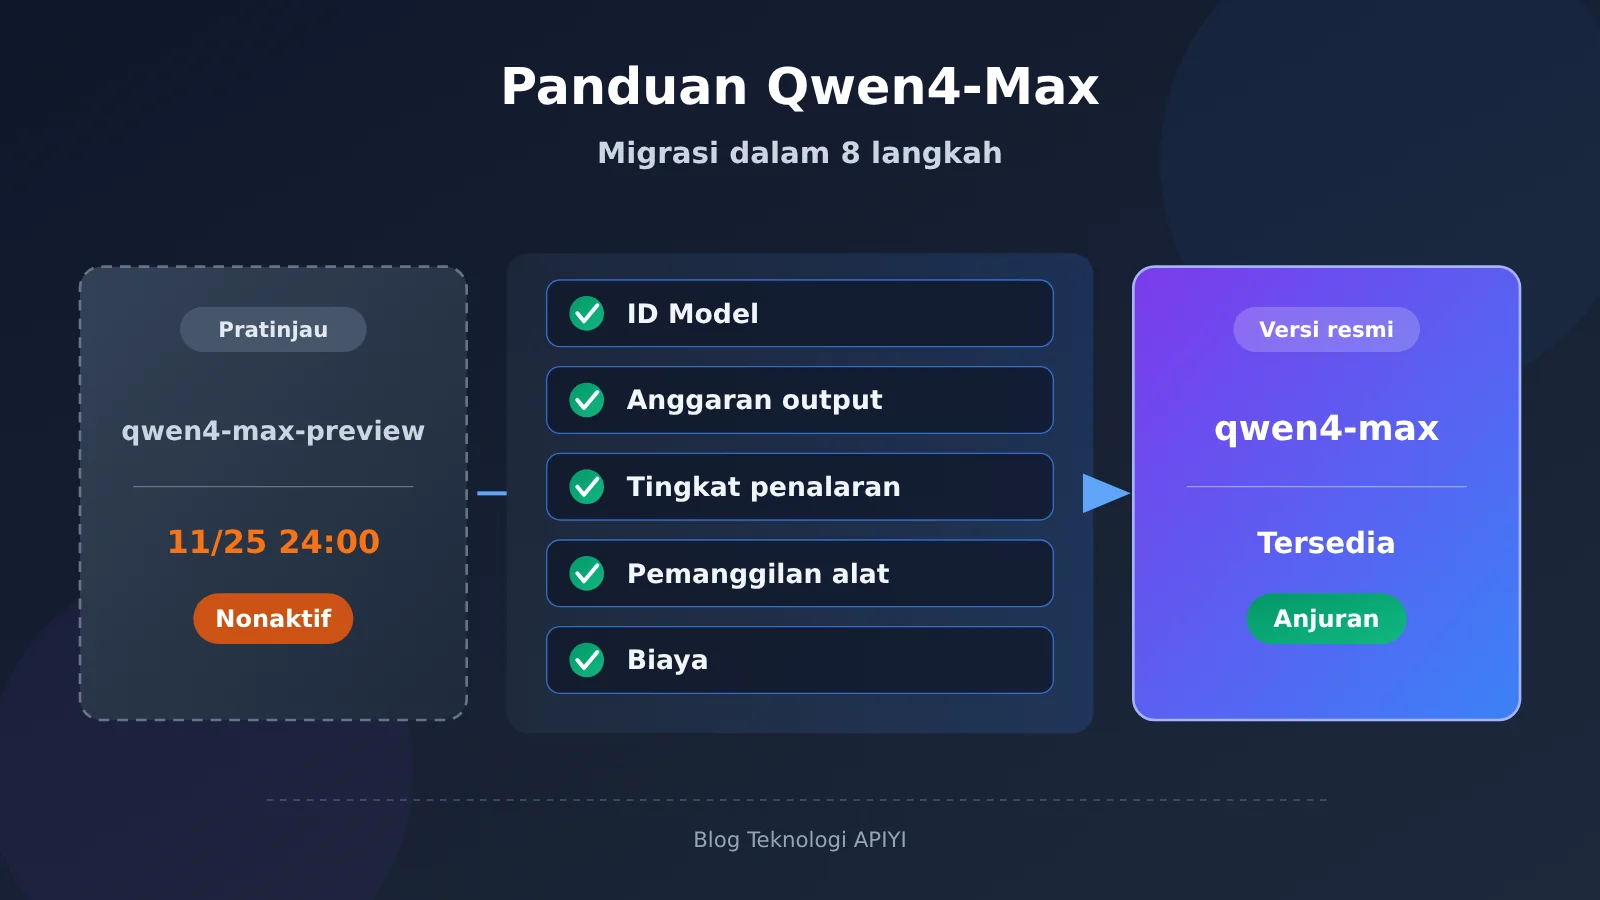
Qwen4-Max-Preview akan mengakhiri masa preview dan berhenti pada 25 November 2026 pukul 24:00 (UTC+8). Versi resmi Qwen4-Max sudah diluncurkan pada 16 November dengan ID model qwen4-max. Saat bermigrasi ke versi resmi, Anda perlu memeriksa lima hal sekaligus: produk akses, budget output, nilai default reasoning, perilaku tool, dan biaya. Kedua versi sama-sama menyediakan konteks 1 juta Token, tetapi batas output maksimum pada mode thinking versi resmi turun dari 393.216 menjadi 262.144, tingkat reasoning default berubah dari xhigh menjadi high, dan penagihan juga diperluas dari Token Plan Credits ke pembayaran sesuai pemakaian. Hanya mengubah ID model saja tidak menjamin performa tugas produksi tetap konsisten.
Di bawah ini kami rangkum dulu garis waktu dan perbedaan spesifikasi antara Preview dan versi resmi, lalu memperkenalkan protokol API, wilayah, harga, dan cache versi resmi. Setelah itu, kami berikan daftar migrasi dengan urutan “menyimpan baseline, konfigurasi akses, parameter request, verifikasi fungsi, observasi tagihan, peralihan bertahap (gray release)”, dan terakhir mencantumkan poin-poin penerimaan untuk tugas seperti laporan panjang, pembuatan kode, dan Agent multi-turn. Setelah selesai membaca, Anda bisa merapikan peralihan ini menjadi alur manajemen versi model yang dapat digunakan ulang oleh tim.
Perlu Diketahui: Terminologi Migrasi Qwen4-Max
| Istilah | Penjelasan |
|---|---|
| ID Model | Penanda yang digunakan dalam permintaan untuk menentukan versi model tertentu, misalnya qwen4-max. |
| Base URL | Alamat dasar antarmuka yang dipakai klien untuk terhubung ke suatu produk atau layanan di wilayah tertentu. |
| jendela konteks | Total kapasitas yang dapat diproses model dalam satu permintaan, mencakup input, riwayat, dan konten yang dihasilkan. |
| anggaran output | Batas maksimum Token yang boleh dihasilkan dalam satu permintaan. Pada mode berpikir, konten penalaran dan jawaban akhir berbagi anggaran yang sama. |
| reasoning_effort | Parameter permintaan yang mengatur intensitas penalaran. Nilai default Preview dan versi resmi berbeda. |
| thinking_budget | Parameter yang mengatur anggaran Token untuk berpikir. Pada Preview, parameter ini tidak dapat disetel bersamaan dengan reasoning_effort. |
| Token Plan | Layanan langganan Alibaba Cloud Bailian yang diukur dengan Credits, sekaligus satu-satunya jalur akses untuk Preview. |
| Function Calling | Mekanisme ketika model mengembalikan permintaan pemanggilan berdasarkan definisi alat, lalu aplikasi menjalankan alat tersebut dan mengirimkan hasilnya kembali. |
| JSON Schema | Spesifikasi yang mendeskripsikan struktur data, field, dan batasan JSON, digunakan untuk membatasi format output model. |
| TTL | Durasi penyimpanan cache, yang memengaruhi cakupan penggunaan ulang cache dan biaya terkait. |
| verifikasi regresi | Memakai tugas representatif yang sudah ada untuk memeriksa perubahan fungsi, hasil, dan biaya setelah pergantian versi. |
1 Kapan Qwen4-Max-Preview Berakhir dan Kapan Versi Resminya Dirilis
1.1 Timeline Versi Qwen4-Max
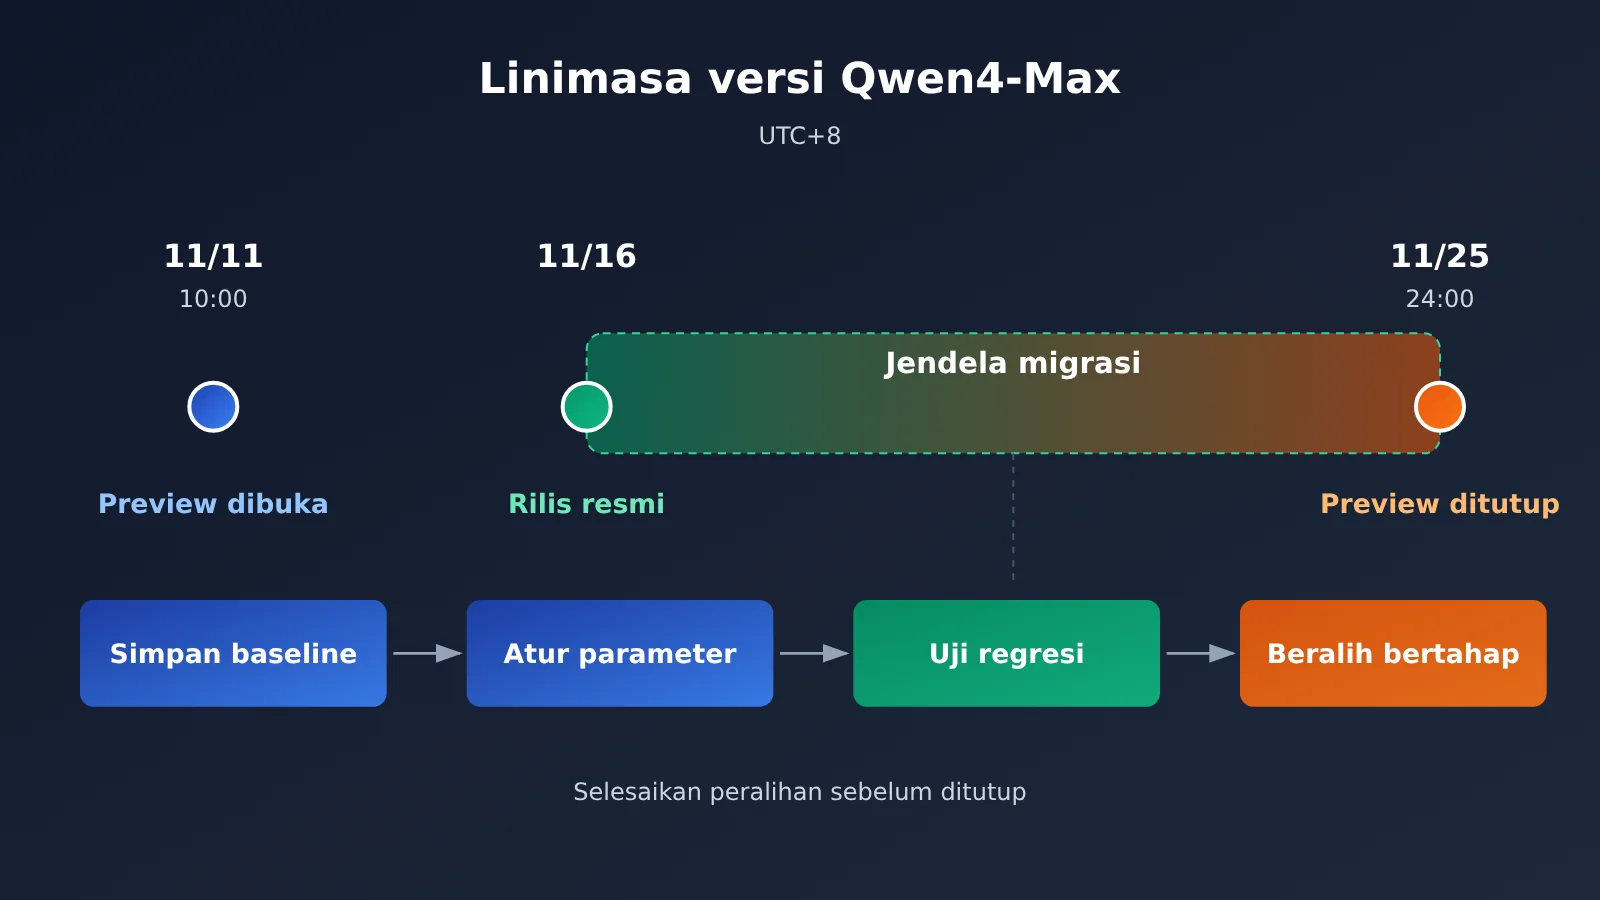
Catatan pembaruan fitur Aliyun Token Plan mencantumkan dua peristiwa terpisah: Preview diluncurkan pada 11 November, lalu versi resmi menyusul pada 16 November. Setelah versi resmi dirilis, jadwal penghentian Preview yang sudah ditetapkan sebelumnya tidak berubah. Bagian atas dokumentasi resmi Preview juga sudah memberi pemberitahuan: “Versi resmi Qwen4-Max sudah dirilis, disarankan menggunakan versi resmi.”
| Waktu (UTC+8) | Peristiwa | Artinya bagi Developer |
|---|---|---|
| 2026-11-11 10:00 | Qwen4-Max-Preview dibuka | Hanya bisa dipanggil lewat Token Plan edisi personal atau tim |
| 2026-11-16 | Versi resmi Qwen4-Max dirilis | Mendukung API bayar per penggunaan, juga bisa dipakai lewat Token Plan |
| 2026-11-25 24:00 | Preview berakhir dan dihentikan | qwen4-max-preview tidak bisa dipanggil lagi, dan juga tidak bisa dijadikan target cadangan (fallback) |
1.2 Dua Model ID dan Kanalnya Masing-masing
Model ID Preview adalah qwen4-max-preview, dengan alias qwen4.0-max-preview. Kedua ID ini sama-sama bisa dipanggil, dan dalam tagihan keduanya ditampilkan seragam sebagai qwen4.0-max-preview. Cara mengakses Preview adalah dengan kunci API khusus Token Plan ditambah Base URL khusus https://token-plan.cn-beijing.maas.aliyuncs.com, dan tidak mendukung pembayaran per penggunaan.
Model ID versi resmi adalah qwen4-max. Versi resmi menyediakan dua jalur penggunaan: pertama lewat Token Plan edisi personal atau tim, kedua lewat API bayar per penggunaan Bailian. Kunci API, Base URL, dan metode penagihan kedua jalur ini berbeda-beda, jadi saat migrasi Anda perlu menentukan dulu jalur mana yang akan dipakai.
2 Perbedaan Spesifikasi Qwen4-Max-Preview dan Versi Resmi
2.1 Tabel Perbandingan Spesifikasi Qwen4-Max
Data berikut berasal dari dokumentasi model resmi Preview dan versi resmi.
| Metrik teknis | Qwen4-Max-Preview | Qwen4-Max Versi Resmi |
|---|---|---|
| ID Model | qwen4-max-preview |
qwen4-max |
| Jendela konteks | 1,000,000 | 1,000,000 |
| Input maksimum (non-thinking / thinking) | Tidak dicantumkan terpisah dalam dokumentasi | 991,808 / 983,616 |
| Output maksimum (mode non-thinking) | Tidak dicantumkan terpisah dalam dokumentasi | 131,072 |
| Total maksimum thinking + jawaban | 393,216 | 262,144 |
| Tingkat penalaran default | xhigh | high |
| Anggaran penalaran default | Bergantung pada parameter antarmuka Preview | 131,072 |
| Protokol API | OpenAI Chat Completions, Responses, Anthropic Messages | Tiga yang pertama + DashScope |
| Metode penagihan | Hanya Token Plan Credits | API bayar sesuai pemakaian, atau Token Plan |
2.2 Perbedaan Jendela Konteks, Input, Output, dan Anggaran Penalaran
Keempat angka ini mengukur hal yang berbeda, dan bagian inilah yang paling mudah membingungkan saat migrasi. Jendela konteks adalah kapasitas total yang dapat diproses dalam satu permintaan; kedua versi sama-sama 1 juta. Input maksimum menentukan berapa banyak materi yang bisa dimasukkan dalam satu permintaan. Pada versi resmi, mode thinking memiliki nilai 983,616, sedikit lebih kecil daripada mode non-thinking karena sisanya dialokasikan untuk penalaran. Output maksimum menentukan berapa banyak Token yang dapat dihasilkan dalam satu proses, sedangkan anggaran penalaran menentukan berapa banyak dari jumlah tersebut yang dapat digunakan untuk penalaran.
Perubahan terbesar ada di sisi output. Pada Preview, thinking dan jawaban berbagi 393,216 Token, sedangkan versi resmi memiliki batas total 262,144 dalam mode thinking dengan anggaran penalaran default 131,072. Dengan konfigurasi default, ruang yang tersisa untuk jawaban akhir pada versi resmi sekitar 130 ribu Token. Jika use case Anda di Preview bergantung pada output panjang lebih dari 200 ribu Token per permintaan, setelah beralih Anda perlu merancang ulang cara output.
3 Kemampuan dan biaya integrasi API Qwen4-Max versi resmi
3.1 Protokol dan fitur
Versi resmi mendukung empat protokol: OpenAI Chat Completions, OpenAI Responses, Anthropic Messages, dan DashScope. Dari sisi fitur, pihak resmi mencantumkan Function Calling, pemanggilan alat paralel, pencarian web, JSON Object, JSON Schema, cache eksplisit, cache implisit, serta ringkasan rantai pemikiran dan enkripsi.
Dibandingkan dengan Preview, dokumentasi versi resmi kini menambahkan penjelasan tentang protokol DashScope, pemanggilan alat paralel, dan dua jenis cache. Jika aplikasi sebelumnya hanya menangani satu tool_call, sekarang pastikan kode dapat menangani beberapa pemanggilan alat yang dikembalikan dalam satu respons.
3.2 Wilayah dan harga sesuai pemakaian
API versi resmi dengan pembayaran sesuai pemakaian mencakup enam wilayah. Saat memilih wilayah, selain harga, pertimbangkan juga latensi jaringan, persyaratan residensi data, dan cakupan deployment bisnis. Kemampuan spesifik tiap wilayah mengacu pada matriks kemampuan resmi.
| Wilayah | Cakupan deployment | Input (yuan/juta Token) | Output (yuan/juta Token, termasuk reasoning) |
|---|---|---|---|
| Tiongkok Utara 2 (Beijing) | Tiongkok daratan | 10 | 30 |
| Amerika Serikat (Virginia) | Global | 10 | 30 |
| Jerman (Frankfurt) | Global | 10 | 30 |
| Jepang (Tokyo) | Global | 10 | 30 |
| Hong Kong, Tiongkok | Global | 10 | 30 |
| Singapura | Internasional | 10.938 | 32.813 |
Halaman resmi untuk wilayah Beijing mencantumkan kuota gratis 1 juta Token dengan masa berlaku 90 hari. Waktu mulai dihitung dari kondisi yang paling akhir di antara aktivasi Bailian, perilisan model, dan persetujuan aplikasi. Harga di atas hanya berlaku untuk versi resmi. Tarif 20% (diskon 80%) pada Preview dan tarif 8% setelah ditumpuk dengan promo malam hari merupakan bagian dari promo Token Plan Credits, dan tidak dapat diterapkan pada perhitungan biaya versi resmi.
3.3 Cache eksplisit dan cache implisit
Cache di versi resmi ditagih secara terpisah. Cache eksplisit dibuat secara aktif oleh developer dan cocok untuk prefix yang tidak berubah dalam jangka panjang, seperti petunjuk sistem, deskripsi alat, dan bahan referensi tetap. TTL dapat dipilih 5 menit atau 1 jam, serta mendukung Chat Completions, Responses, dan Anthropic Messages. Cache implisit ditangani otomatis oleh platform berdasarkan kondisi seperti prefix berulang, tanpa konfigurasi tambahan.
Agent multi-putaran membawa definisi alat dan materi latar yang sama pada setiap putaran. Penggunaan cache secara tepat dapat menurunkan biaya input berulang secara signifikan. TTL sebaiknya dipilih berdasarkan jeda sesi: sesi dengan interaksi padat menggunakan 5 menit, sedangkan alur pemrosesan batch dengan jeda lebih panjang dapat mempertimbangkan 1 jam.
4 Langkah-langkah migrasi dari Qwen4-Max-Preview ke versi resmi
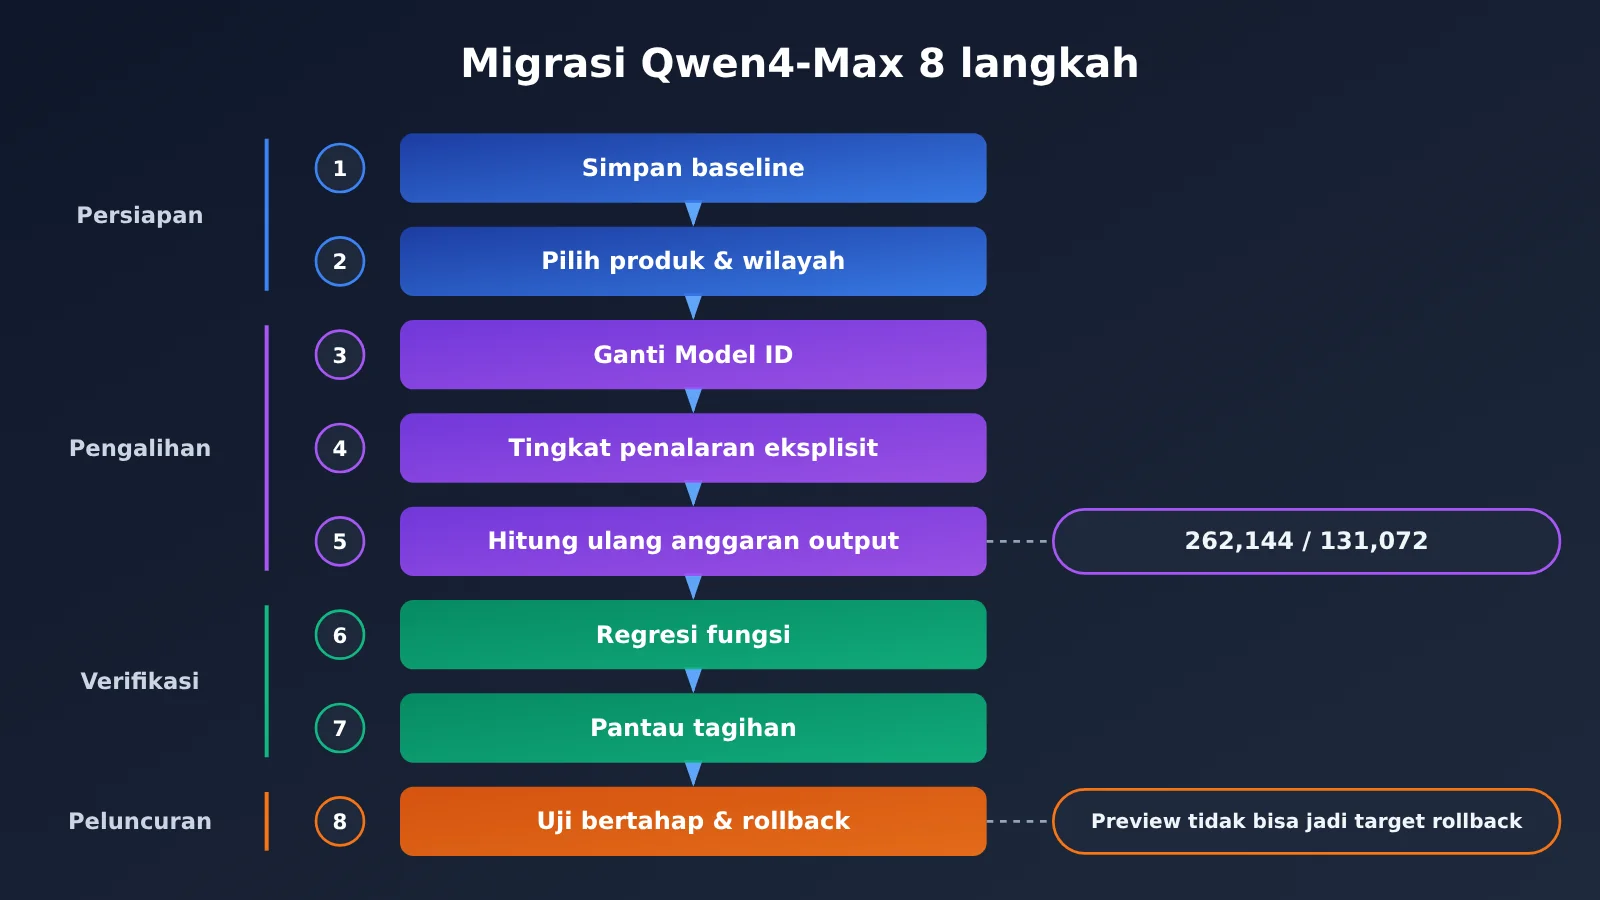
Delapan langkah berikut adalah alur pemeriksaan developer yang disusun berdasarkan spesifikasi resmi. Pihak resmi tidak menyediakan alat migrasi otomatis, dan juga tidak menyatakan bahwa semua parameter permintaan kompatibel tanpa penyesuaian, sehingga setiap langkah perlu diverifikasi secara nyata pada bisnis Anda sendiri.
| Langkah | Item pemeriksaan | Kriteria penerimaan |
|---|---|---|
| 1 | Simpan konfigurasi lama dan tugas representatif | Parameter permintaan, sampel output, waktu proses, dan penggunaan Preview sudah diarsipkan |
| 2 | Pilih produk akses, cocokkan region, Key, Base URL | Layanan backend menggunakan API bayar-per-penggunaan, alat interaktif menggunakan Token Plan |
| 3 | Ganti model menjadi qwen4-max |
Permintaan smoke test kembali normal, nama model pada tagihan sudah benar |
| 4 | Set reasoning effort secara eksplisit | Tulis reasoning_effort atau field terkait sesuai tugas, jangan bergantung pada nilai default |
| 5 | Hitung ulang anggaran output | Mode berpikir total ≤ 262.144, mode non-berpikir ≤ 131.072 |
| 6 | Verifikasi pemanggilan tool, struktur JSON, output panjang, riwayat multi-giliran | Tingkat kelulusan tugas representatif sejajar dengan baseline Preview |
| 7 | Amati penggunaan dan tagihan cache | Biaya input, output, dan cache sesuai ekspektasi |
| 8 | Alihkan dengan traffic kecil dan siapkan konfigurasi rollback | Target rollback adalah model yang masih valid, Preview tidak termasuk di dalamnya |
4.1 Simpan konfigurasi lama dan tugas representatif
Sebelum Preview dihentikan, ekspor semua konfigurasi yang saat ini memanggil qwen4-max-preview, termasuk max_tokens, reasoning_effort atau thinking_budget, definisi alat, response_format, dan petunjuk sistem. Pada saat yang sama, pilih 10 hingga 30 tugas representatif dan simpan output, waktu eksekusi, serta penggunaan Preview sebagai baseline perbandingan. Setelah 25 November, hasil Preview tidak akan bisa diperoleh lagi.
4.2 Pilih produk integrasi dan periksa Key serta Base URL
Token Plan hanya mengizinkan penggunaan interaktif di alat pemrograman atau alat agen seperti Claude Code, Cursor, Qwen Code, dan Qoder. Skrip otomatis, backend aplikasi mandiri, serta pemanggilan batch dari platform alur kerja tidak termasuk dalam cakupan yang diizinkan; pelanggaran dapat menyebabkan langganan dijeda atau Key diblokir. Jika Preview hanya digunakan di alat seperti Qoder, Anda tetap bisa beralih ke versi resmi melalui Token Plan. Jika ingin terhubung ke backend sendiri, sebaiknya gunakan API bayar-per-penggunaan versi resmi, dan gunakan Key serta Base URL untuk wilayah yang sesuai di konsol.
Token Plan versi personal juga mencakup ketentuan otorisasi data: selama masa penggunaan, input dan konten yang dihasilkan akan digunakan untuk peningkatan layanan. Tim yang menangani materi rahasia perlu memasukkan poin ini ke dalam evaluasi saat memilih produk integrasi.
4.3 Mengganti Model ID: Mulai Cepat dengan Qwen4-Max
Ubah Model ID menjadi qwen4-max dan permintaan pertama Anda langsung bisa dikirim. Berikut contoh minimal memakai antarmuka yang kompatibel dengan OpenAI — pastikan dulu permintaannya berhasil, baru masuk ke penyesuaian parameter:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI, juga bisa diganti dengan Base URL wilayah Bailian yang sesuai
)

resp = client.chat.completions.create(
    model="qwen4-max",                   # nilai asli adalah qwen4-max-preview
    messages=[{"role": "user", "content": "用三句话说明你的版本信息"}],
    reasoning_effort="high",             # tuliskan secara eksplisit, jangan bergantung pada nilai default
    max_tokens=8192
)
print(resp.choices[0].message.content)
Model apa saja yang tersedia di bawah antarmuka kompatibel OpenAI yang sama, patokannya adalah daftar model real-time platform. Untuk lingkungan produksi, pastikan sekali lagi sebelum rilis.
4.4 Mengatur Parameter Penalaran Secara Eksplisit
Preview default-nya xhigh, versi resmi default-nya high. Jika kode lama tidak menuliskan kekuatan penalaran, setelah beralih kekuatan penalaran akan turun otomatis, dan kualitas, waktu proses, serta penggunaan Token untuk tugas kompleks bisa ikut berubah. Sebaiknya tuliskan kekuatan penalaran sesuai jenis tugas: untuk kode kompleks dan penalaran ilmiah, pakai dulu kekuatan yang sama dengan Preview sebagai baseline perbandingan; untuk tugas ekstraksi dan format sederhana, coba turunkan.
Dokumen Preview menetapkan bahwa reasoning_effort dan thinking_budget tidak boleh diatur bersamaan. Nama field dan nilai pada versi resmi di empat protokol — Chat Completions, Responses, Anthropic Messages, dan DashScope — harus mengacu pada dokumen protokol yang bersangkutan. Di Preview, percakapan multi-giliran secara default mengaktifkan preserve_thinking, dan konten pemikiran historis harus dikembalikan ke field reasoning_content. Jika aplikasi Anda mengirim balik konten pemikiran, Anda juga perlu memverifikasi di versi resmi bahwa format pesan historis dapat diterima dengan benar.
4.5 Hitung Ulang Anggaran Output Berdasarkan Batas Maksimum Baru
Di Preview, max_tokens dan max_completion_tokens setara, dan proses berpikir serta jawaban berbagi total anggaran 393.216. Di versi resmi, total anggaran mode berpikir adalah 262.144, sedangkan batas output mode non-berpikir adalah 131.072. Semua permintaan yang diatur melebihi 262.144 di Preview harus diturunkan. Permintaan yang anggarannya tadinya ketat juga perlu memperhitungkan porsi yang akan terpakai oleh anggaran berpikir default 131.072.
Lihat kode konfigurasi migrasi lengkap (validasi anggaran + fallback)
from openai import OpenAI

# Batas resmi versi final (mode berpikir adalah total berpikir + jawaban)
LIMITS = {
    "qwen4-max": {"thinking": 262_144, "non_thinking": 131_072},
}

def plan_max_tokens(model: str, thinking: bool,
                    answer_tokens: int, thinking_tokens: int = 0) -> int:
    """Hitung max_tokens sesuai mode; jika melebihi batas resmi, langsung error agar tidak terpotong diam-diam"""
    limit = LIMITS[model]["thinking" if thinking else "non_thinking"]
    need = answer_tokens + (thinking_tokens if thinking else 0)
    if need > limit:
        raise ValueError(f"{model} 预算 {need} 超过上限 {limit},请拆分任务")
    return need

PRIMARY = {
    "model": "qwen4-max",
    "base_url": "https://api.apiyi.com/v1",  # Alamat kompatibel OpenAI dari APIYI
    "reasoning_effort": "high",
}
# Target fallback harus model yang masih aktif; qwen4-max-preview tidak tersedia setelah dihentikan
FALLBACK = {
    "model": "YOUR_FALLBACK_MODEL",
    "base_url": "https://api.apiyi.com/v1",
}

def call(cfg: dict, messages: list, max_tokens: int):
    client = OpenAI(api_key="YOUR_API_KEY", base_url=cfg["base_url"])
    kwargs = {"model": cfg["model"], "messages": messages, "max_tokens": max_tokens}
    if "reasoning_effort" in cfg:
        kwargs["reasoning_effort"] = cfg["reasoning_effort"]
    return client.chat.completions.create(**kwargs)

def run(messages: list, answer_tokens: int = 60_000, thinking_tokens: int = 131_072):
    budget = plan_max_tokens("qwen4-max", True, answer_tokens, thinking_tokens)
    try:
        resp = call(PRIMARY, messages, budget)
    except Exception as e:
        print(f"主模型失败,切换回退:{e}")
        resp = call(FALLBACK, messages, min(budget, 32_000))
    choice = resp.choices[0]
    if choice.finish_reason == "length":
        print("警告:输出因长度被截断,需要拆分任务或调整预算")
    print("用量:", resp.usage)
    return choice.message.content

if __name__ == "__main__":
    print(run([{"role": "user", "content": "生成一份模型迁移回归报告的大纲"}]))
4.6 Memverifikasi pemanggilan alat, output terstruktur, dan output panjang
Putar ulang tugas-tugas perwakilan satu per satu: apakah Function Calling mengembalikan nama alat dan struktur parameter yang sama, apakah pemanggilan alat paralel ditangani dengan benar oleh kode, apakah output JSON Schema dapat lolos validator yang sudah ada, apakah output panjang berakhir dengan finish_reason == "length", dan apakah konteks tetap runtut setelah riwayat multi-giliran dikirim kembali. Bandingkan setiap item dengan baseline yang disimpan pada 4.1, lalu catat perbedaannya.
4.7 Mengamati penggunaan dan tagihan cache
Setelah beralih dari Credits ke penagihan berdasarkan penggunaan, biaya harus dihitung terpisah untuk tiga komponen: input, output (termasuk proses berpikir), dan cache. Harga satuan output versi resmi adalah 3 kali harga input, dan Token berpikir juga dihitung sebagai output, jadi pengaturan tingkat penalaran (reasoning effort) langsung memengaruhi tagihan. Anda bisa lebih dulu menyelesaikan uji regresi menggunakan kuota gratis wilayah Beijing, lalu memperkirakan biaya bulanan berdasarkan penggunaan aktual.
4.8 Mengalihkan trafik kecil dan mempertahankan konfigurasi fallback
Alihkan dulu 5% hingga 10% trafik ke qwen4-max, lalu pantau tingkat error, tingkat pemotongan, dan biaya per tugas. Setelah dipastikan stabil, baru lakukan pengalihan penuh. Konfigurasi fallback harus mengarah ke model yang masih berjalan, misalnya versi lain dari seri yang sama yang masih tersedia, atau model dari vendor lain yang sudah tervalidasi. Setelah Preview dihentikan, model tersebut tidak dapat menjadi target fallback.
🎯 Saran teknis: Sebaiknya model fallback sudah divalidasi pada kumpulan tugas representatif yang sama sebelum pengujian bertahap. Melalui antarmuka kompatibel OpenAI dari APIYI apiyi.com, satu kunci API dapat beralih di antara beberapa model populer; cukup ubah bidang
modeluntuk melakukan pengujian fallback.
5 Masalah yang paling sering muncul setelah migrasi Qwen4-Max
5.1 Pemotongan output
Ini adalah masalah yang paling umum. Laporan panjang atau file besar yang dapat dihasilkan secara utuh di Preview mungkin terpotong setelah beralih ke versi resmi karena batas 262,144 atau karena terpakai oleh anggaran berpikir default. Solusinya adalah memeriksa finish_reason, menghasilkan tugas yang sangat panjang per bab atau per file, dan sekaligus menyisihkan anggaran yang jelas untuk bagian jawaban.
5.2 Intensitas penalaran default menurun
Setelah turun dari xhigh ke high, performa tugas kompleks bisa berubah, sementara waktu proses dan biaya tugas sederhana bisa menurun. Kode yang tidak menuliskan parameter penalaran akan berubah perilaku tanpa disadari. Semua permintaan produksi harus menetapkan intensitas penalaran secara eksplisit, lalu menentukan level yang sesuai untuk setiap jenis tugas melalui pemutaran ulang A/B.
5.3 Perbedaan pemanggilan tool dan protokol
Versi resmi secara eksplisit mendukung pemanggilan tool paralel, sehingga satu respons dapat berisi beberapa permintaan pemanggilan tool. Kode yang hanya membaca tool_call pertama akan melewatkan eksekusi tool dan menyebabkan alur Agent terhenti. Saat beralih protokol, misalnya dari Chat Completions ke DashScope, penamaan bidang dan cara pengembalian konten penalaran juga perlu dicocokkan ulang dengan dokumentasi.
5.4 Perubahan dasar perhitungan cache dan tagihan
Konsumsi Credits di Preview dipengaruhi oleh koefisien penagihan, cache hit, pemanggilan tool, dan faktor lain, sehingga tidak dapat langsung dikonversi menjadi harga satuan per juta Token. Versi resmi menggunakan tarif yuan per juta Token, dengan cache ditagih secara terpisah. Model anggaran yang sebelumnya dibuat berdasarkan Credits perlu dibangun ulang, sekaligus memasukkan biaya penulisan cache eksplisit dan pilihan TTL ke dalamnya.
6 Tugas yang Harus Diuji Ulang pada Qwen4-Max Versi Resmi
| Jenis tugas | Item verifikasi utama | Parameter yang diperhatikan |
|---|---|---|
| Pembuatan laporan panjang | Apakah terpotong, apakah bagian lengkap, apakah fakta konsisten di seluruh dokumen | Anggaran output, finish_reason |
| Pembuatan kode kompleks | Tingkat kelulusan kompilasi dan pengujian, panjang file tunggal, konsistensi antarfile | reasoning_effort, anggaran output |
| Agen multi-putaran | Urutan pemanggilan alat, penanganan pemanggilan paralel, pengiriman kembali riwayat pemikiran | tool_calls, reasoning_content |
| Pencarian dokumen panjang | Akurasi hubungan antarbagian, apakah input melebihi 983,616 atau 991,808 | Input maksimum, hit cache |
| Output terstruktur JSON | Tingkat kelulusan validasi skema, field hilang dan kesalahan tipe | response_format, JSON Schema |
Pencarian dokumen panjang memerlukan perhatian khusus: input maksimum versi resmi berbeda-beda tergantung mode, dan mode berpikir memiliki sekitar 8.000 token lebih sedikit daripada mode non-berpikir. Tugas yang mengisi materi hingga mendekati batas atas bisa melampaui batas setelah beralih mode. Untuk tugas terkait kode, disarankan langsung menggunakan kembali set pengujian unit yang sudah ada dan menggunakan tingkat kelulusan pengujian sebagai metrik penerimaan; ini lebih andal daripada membaca output secara manual.
💡 Saran pemilihan: Jika perlu membandingkan performa Qwen4-Max dengan model-model unggulan lain pada tugas-tugas ini secara bersamaan, Anda dapat menggunakan antarmuka terpadu APIYI apiyi.com untuk memutar ulang kumpulan tugas yang sama, sehingga mengurangi pekerjaan menulis kode adaptasi secara terpisah untuk setiap vendor.
7 Pertanyaan Umum Migrasi Qwen4-Max-Preview
Q1: Setelah Qwen4-Max-Preview dihentikan, apakah permintaan lama akan otomatis dialihkan ke versi resmi?
Dokumentasi resmi hanya menyatakan bahwa Preview akan dihentikan dan menyarankan penggunaan versi resmi; tidak ada penyebutan penerusan otomatis. Harap ubah `model` secara manual menjadi `qwen4-max` sebelum 25 November pukul 24.00, lalu selesaikan pemeriksaan pada Bagian 4 artikel ini.
Q2: Apakah cukup hanya mengubah ID model menjadi qwen4-max?
Tidak cukup. Batas output, tingkat penalaran default, dan skema penagihan semuanya berubah. Setidaknya Anda masih perlu menghitung ulang anggaran output, mengatur tingkat penalaran secara eksplisit, serta melakukan validasi regresi untuk pemanggilan alat dan output terstruktur.
Q3: Apakah diskon 80% (harga 20%) dan promo malam Preview masih berlaku di versi resmi?
Kedua promo tersebut hanya berlaku untuk konsumsi Credits oleh Preview dalam Token Plan. Untuk API bayar per penggunaan versi resmi, patokannya adalah input 10 yuan dan output 30 yuan per satu juta Token di wilayah Beijing, sehingga biaya perlu dihitung ulang.
Q4: Apakah layanan backend masih bisa menggunakan Key dari Token Plan?
Tidak bisa. Token Plan hanya mengizinkan penggunaan interaktif dalam alat coding atau agent tertentu. Backend aplikasi mandiri sebaiknya beralih ke API bayar per penggunaan versi resmi, atau menggunakan layanan agregasi seperti APIYI apiyi.com yang menyediakan antarmuka kompatibel OpenAI dengan penagihan per penggunaan.
Q5: Bagaimana cara cepat menyiapkan lingkungan regresi selama migrasi?
Susun tugas-tugas representatif menjadi kumpulan permintaan tetap, lalu gunakan kode yang sama dengan mengganti field `model` untuk melakukan replay. APIYI apiyi.com menyediakan kuota uji gratis bagi pengguna baru, yang dapat digunakan untuk memvalidasi model cadangan dan skema pembanding.
8 Kesimpulan: Memasukkan manajemen versi model ke dalam alur produksi Qwen4-Max
Peralihan dari Qwen4-Max-Preview ke versi resmi kali ini melibatkan lima dimensi yang perlu dikelola secara berkelanjutan:
- ID model: dipelihara terpusat di pusat konfigurasi, tidak di-hardcode di dalam kode, dan berlangganan pengumuman siklus hidup model.
- Parameter antarmuka: tingkat penalaran, anggaran berpikir, dan response_format semuanya diatur secara eksplisit.
- Batasan output: catat empat angka untuk setiap model—konteks, input maksimum, output maksimum, dan anggaran berpikir—lalu lakukan validasi sebelum mengirim permintaan.
- Biaya: pantau secara terpisah untuk input, output, dan cache; bangun ulang model anggaran saat mode penagihan berubah.
- Pengujian regresi: pertahankan kumpulan tugas representatif dan hasil baseline, lalu putar ulang sepenuhnya setiap kali berganti versi.
Siklus hidup Preview hanya dua minggu; setelah versi resmi pun akan tetap ada versi baru dan rencana penghentian. Bangun alur tetap berupa “menyimpan baseline, parameter eksplisit, peralihan bertahap, dan rollback yang tersedia”, sehingga pada pergantian versi berikutnya migrasi bisa selesai dalam beberapa hari. Tim yang perlu menyiapkan skema rollback multi-model dapat menyelesaikan validasi pada antarmuka yang sama melalui APIYI apiyi.com.
Referensi
-
Dokumentasi resmi Qwen4-Max versi resmi: konteks, batas input/output, tingkat penalaran default, wilayah, harga, dan cache
- Tautan:
help.aliyun.com/zh/model-studio/qwen4-max - Keterangan: sumber utama untuk parameter migrasi
- Tautan:
-
Dokumentasi resmi Qwen4-Max-Preview: spesifikasi Preview, cara integrasi, waktu penghentian
- Tautan:
help.aliyun.com/zh/model-studio/qwen4-max-preview - Keterangan: acuan pembanding saat menyimpan konfigurasi lama
- Tautan:
-
Pembaruan fitur Token Plan: catatan peluncuran Preview dan versi resmi
- Tautan:
help.aliyun.com/zh/model-studio/token-plan-product-updates - Keterangan: sumber timeline versi
- Tautan:
-
Perizinan dan ketentuan penggunaan Token Plan: cakupan penggunaan interaktif dan skenario yang dilarang
- Tautan:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Keterangan: dasar kepatuhan saat memilih produk integrasi
- Tautan:
-
Langganan dan hak Token Plan edisi personal: paket, Credits, dan diskon Preview
- Tautan:
help.aliyun.com/zh/model-studio/token-plan-personal-overview - Keterangan: membedakan diskon Preview dengan penagihan versi resmi
- Tautan:
Penulis: Tim Teknis APIYI
Komunikasi teknis: Silakan hubungi kami melalui beranda APIYI apiyi.com; lebih banyak materi integrasi dapat diakses di pusat dokumentasi docs.apiyi.com