作者注:今天要调接口,继续用 grok-4.7。Grok 4.8 到 2026-11-13 还没有模型 ID,本文按来源核对 Grok 4.7 的 3 个短板,看 4.8 是否已有证据补上。
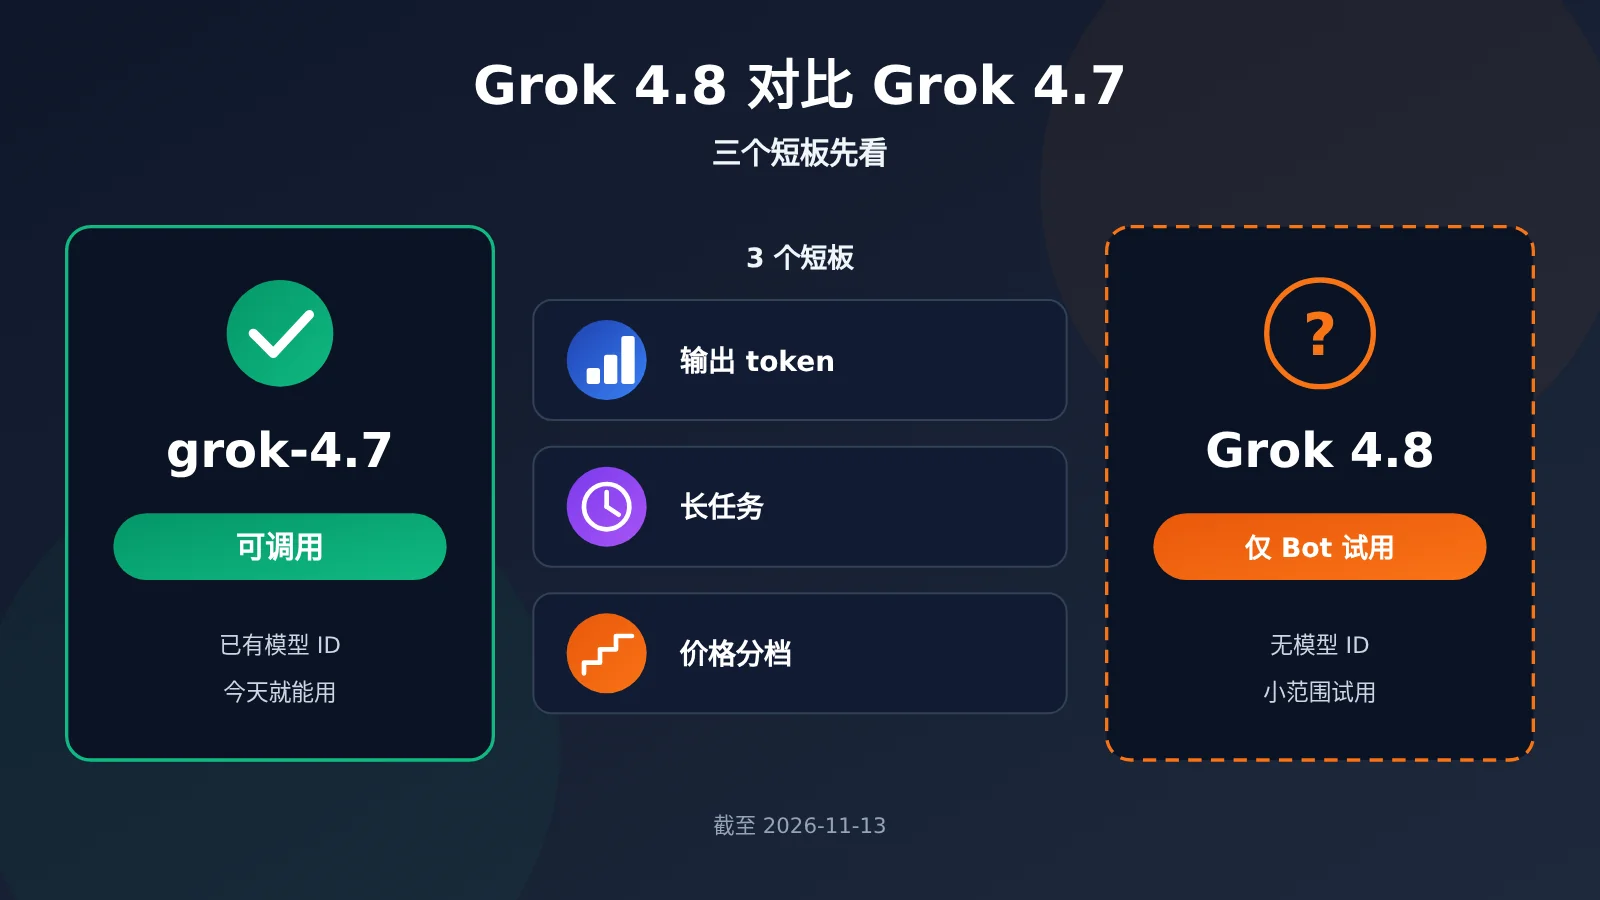
如果你已经在生产里调 grok-4.7,最近大概会犹豫一件事:要不要停下来,等 Grok 4.8。先说结论:今天要调接口,就用 grok-4.7。 截至 2026-11-13,Grok 4.8 没有模型 ID、没有模型卡、没有榜单分数,也没有价格。马斯克说的“本周”只是对 Grok Bot 用户的小范围试用(soft rollout),不是 API 开放。
这不是一篇“新版必然更强”的预告文。 本文只对照 Grok 4.7 公开数据里能对上的三处短板。每一处都标明来源:官方自报、第三方榜单,还是马斯克原话。然后再看,Grok 4.8 目前有没有证据补上它们。
核心价值:读完本文,你会知道 Grok 4.7 的短板具体在哪、出自谁的数据,以及在 Grok 4.8 上架前,怎样按 20 万 token 分档控制成本。
Grok 4.8 对比 Grok 4.7:今天怎么选
这次对比与常见的新旧版本对比不同。Grok 4.8 目前只有马斯克在 X 上的几句话,没有任何可复核的分数。因此“对比”的实际含义是:Grok 4.7 有哪些短板已被公开数据记录,Grok 4.8 的已知改动能不能对上这些短板。
| 你的情况 | 建议 | 理由 |
|---|---|---|
| 本周要上线或改接口 | 用 grok-4.7 | 平台型号列表里只有 grok-4.7 |
| 在评估长期选型 | 先用 grok-4.7 跑基线 | 4.8 没有榜单,无法横向比较 |
| 想第一时间试 4.8 | 关注平台型号列表 | Bot 软发布不等于 API 可用 |
| 对长任务要求极高 | 不要把希望押在 4.8 上 | 没有证据显示长任务差距已缩小 |
需要说明的是,“Bot users”指 Grok Bot 的用户,不是硬件机器人。“soft rollout”是小范围放量,不是对开发者开放的接口。把它当成“已经能换的模型 ID”,会直接导致调用报错。
Grok 4.8 对比 Grok 4.7 核心差异:3 个短板的来源
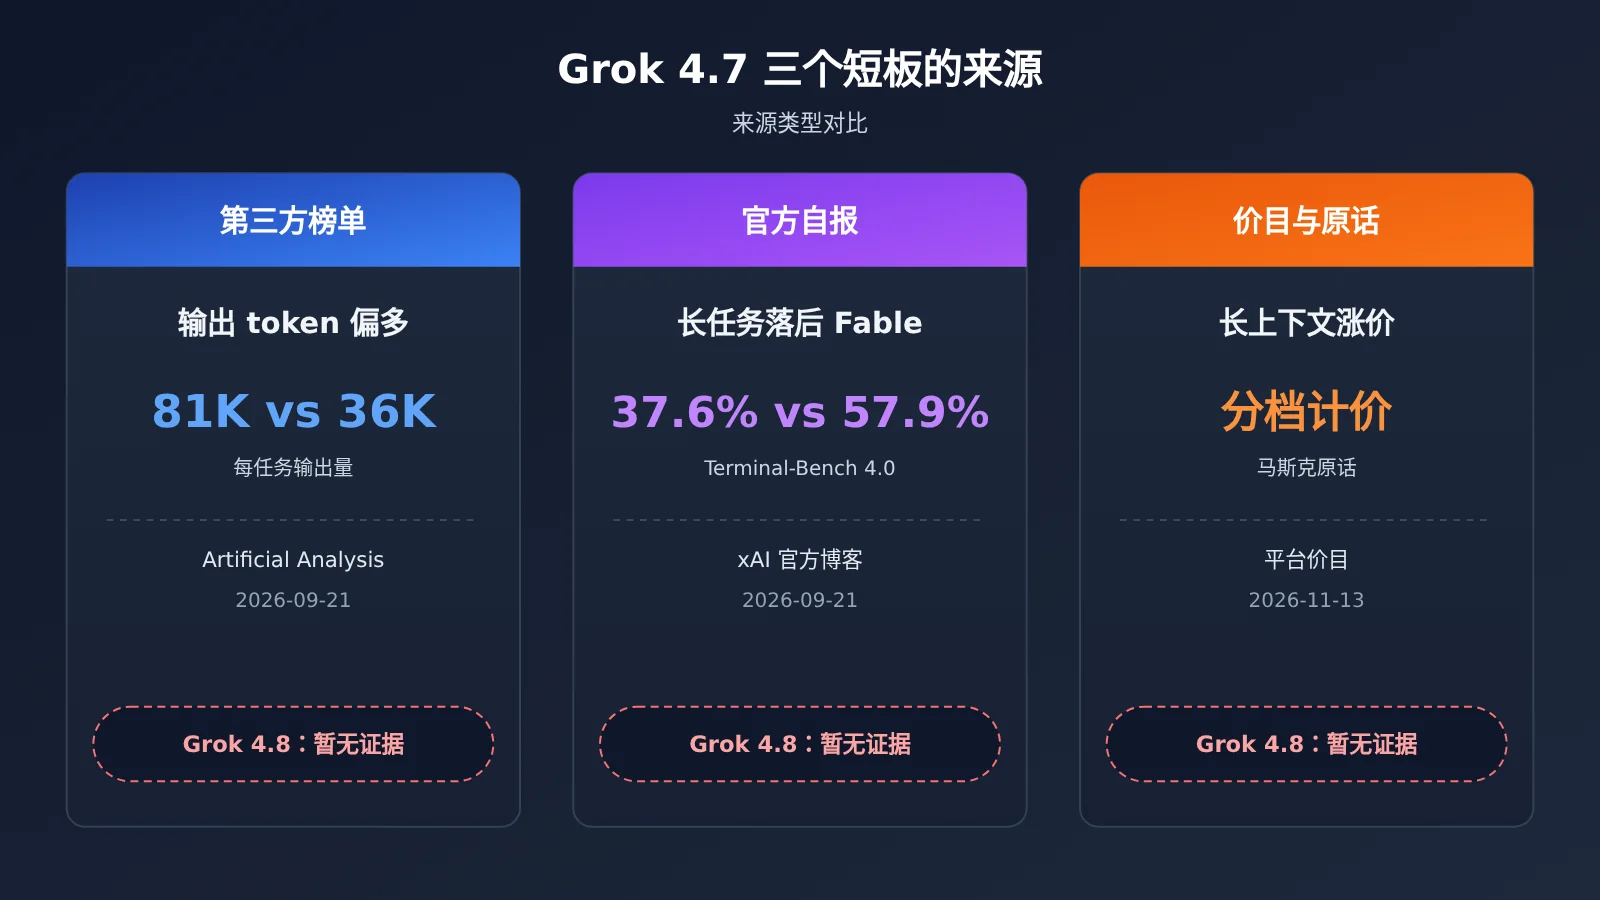
下表先列出三个短板各自的来源类型。之后的展开严格按这个顺序。
| 短板 | 来源类型 | 来源日期 | Grok 4.8 有无证据补上 |
|---|---|---|---|
| 输出 token 偏多 | 第三方榜单(Artificial Analysis) | 2026-09-21 | 无 |
| 多小时长任务落后 Fable | 官方自报(xAI 博客表格) | 2026-09-21 | 无 |
| 长上下文分档涨价 + 老马不认底子 | 平台价目 + 马斯克原话 | 2026-11-13 / 2026-11-10 | 无 |
短板一:Grok 4.7 输出 token 偏多(第三方榜单)
这一处的来源是 Artificial Analysis 在 2026-09-21 发布的 Grok 4.7 评测,属于第三方榜单,不是官方数据,也不是本文作者的测试。他们用 xhigh 档位测试,Grok 4.7 的智能指数为 46,比 Grok 4.6 高 2 分。分数涨了,但代价是输出 token 明显变多。
同一篇评测里的输出量对照如下,注意两个 Grok 4.6 数字对应不同档位,不能合成一个:
- Grok 4.7(xhigh):每个智能指数任务约
81,000输出 token - Grok 4.6(high):约
36,000输出 token - Grok 4.6(xhigh):约
38,000输出 token,评测称 4.7 是它的两倍多 - GPT-6 Astra(max):约
27,000输出 token
为了感受量级,可以用官方输出价 $6 / 1M tokens 粗算:8.1 万输出约 $0.49,3.6 万约 $0.22。这只是榜单任务的换算方法,用来说明“同样一道题,钱花在哪里”,不是任何平台的实际账单。
Artificial Analysis 同时写明,Grok 4.7 的上下文为 500K,标价 $2 / $6、缓存命中 $0.50,都与 4.6 相同。也就是说,单价没涨,但每个任务吐出的 token 多了,单任务成本实际是上升的。
短板二:Grok 4.7 多小时长任务仍落后 Fable(官方自报)
这一处的来源是 xAI 官方博客(2026-09-21)里的对比表,属于官方自报。表头四列依次是 Grok 4.7 xHigh、Grok 4.6 High、GPT-5.6 Sol Max、Fable 5.1 Max。最能说明长任务差距的是下面两项:
- Terminal-Bench 4.0:Grok 4.7
37.6%,Fable 5.1 Max57.9%(Grok 4.6 为20.3%,GPT-5.6 Sol 为37.3%) - CursorBench 4.0:Grok 4.7
46.3%,Fable 5.1 Max51.8%(Grok 4.6 为40.4%,GPT-5.6 Sol 为41.7%)
但官方表并不是“全面落后”。Grok 4.7 相对 4.6 的提升是实在的,而且在两项专业基准上排第一:
- EEBench:Grok 4.7
64.0%,高于 4.6 的53.0%、GPT-5.6 Sol 的39.4%、Fable 5.1 的56.4% - Harvey Legal Agent Benchmark:Grok 4.7
19.6%,高于15.8%/2.5%/6.7% - DeepSWE v1.1:Grok 4.7
71.0%,官方注明为 high effort 而非 xhigh,略低于 GPT-5.6 Sol 的72.7% - AA Briefcase v1.1:Grok 4.7
1657,略低于 Fable 的1678 - HealthBench Professional:Grok 4.7
56.7%,低于 GPT-5.6 Sol 的60.5%和 Fable 的62.1%
| 官方表基准 | 相对 Grok 4.6 | 相对 GPT-5.6 Sol | 相对 Fable 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | 明显更高 | 基本持平略高 | 差距明显 |
| CursorBench 4.0 | 更高 | 更高 | 更低 |
| DeepSWE v1.1 | 更高 | 略低 | 略高 |
| EEBench | 更高 | 更高 | 更高 |
| Harvey Legal Agent | 更高 | 更高 | 更高 |
| HealthBench Professional | 更高 | 更低 | 更低 |
第三方榜单另有一组数据,需要单独标注。Artificial Analysis 的评测显示,相对 Grok 4.6,Grok 4.7 在 Terminal-Bench 4.0 上高 4.5 个点,GDP.pdf 上高 3.0 个点;但 AA-LCR 低 3.7 个点,AutomationBench-AA 低 1.1 个点。这里的“+4.5 个点”与官方表上的 37.6% 对 20.3% 不是同一套绝对分,不能混用。
短板三:Grok 4.7 的价格分档与马斯克原话(价目 + 原话)
第三处有两部分:一是长上下文的价格,二是马斯克本人对 4.7 的态度。先看价格。平台总表与价目接口对 20 万 token 以上的记载并不完全一致:
| 价格项 | 平台型号总表 | 价目接口 billing_expr |
|---|---|---|
| ≤ 20 万 token 输入 / 输出 / 缓存读 | 已写明 | 已写明,与总表一致 |
| 20 万以上输入 | 已写明 | 已写明,与总表一致 |
| 20 万以上输出 | 未单独写明 | 已写明 |
| 20 万以上缓存读 | 未单独写明 | 已写明 |
具体数字如下,价格数据日期为 2026-11-13,单位均为每 1M tokens:
- 低档(0–200,000 tokens):输入
$2、输出$6、缓存读$0.5,总表与价目表达式一致 - 高档(200,001–500,000 tokens)输入:
$4,总表与价目表达式一致 - 高档输出:价目表达式为
$12,总表阶梯未写 - 高档缓存读:价目表达式为
$1,总表阶梯未写
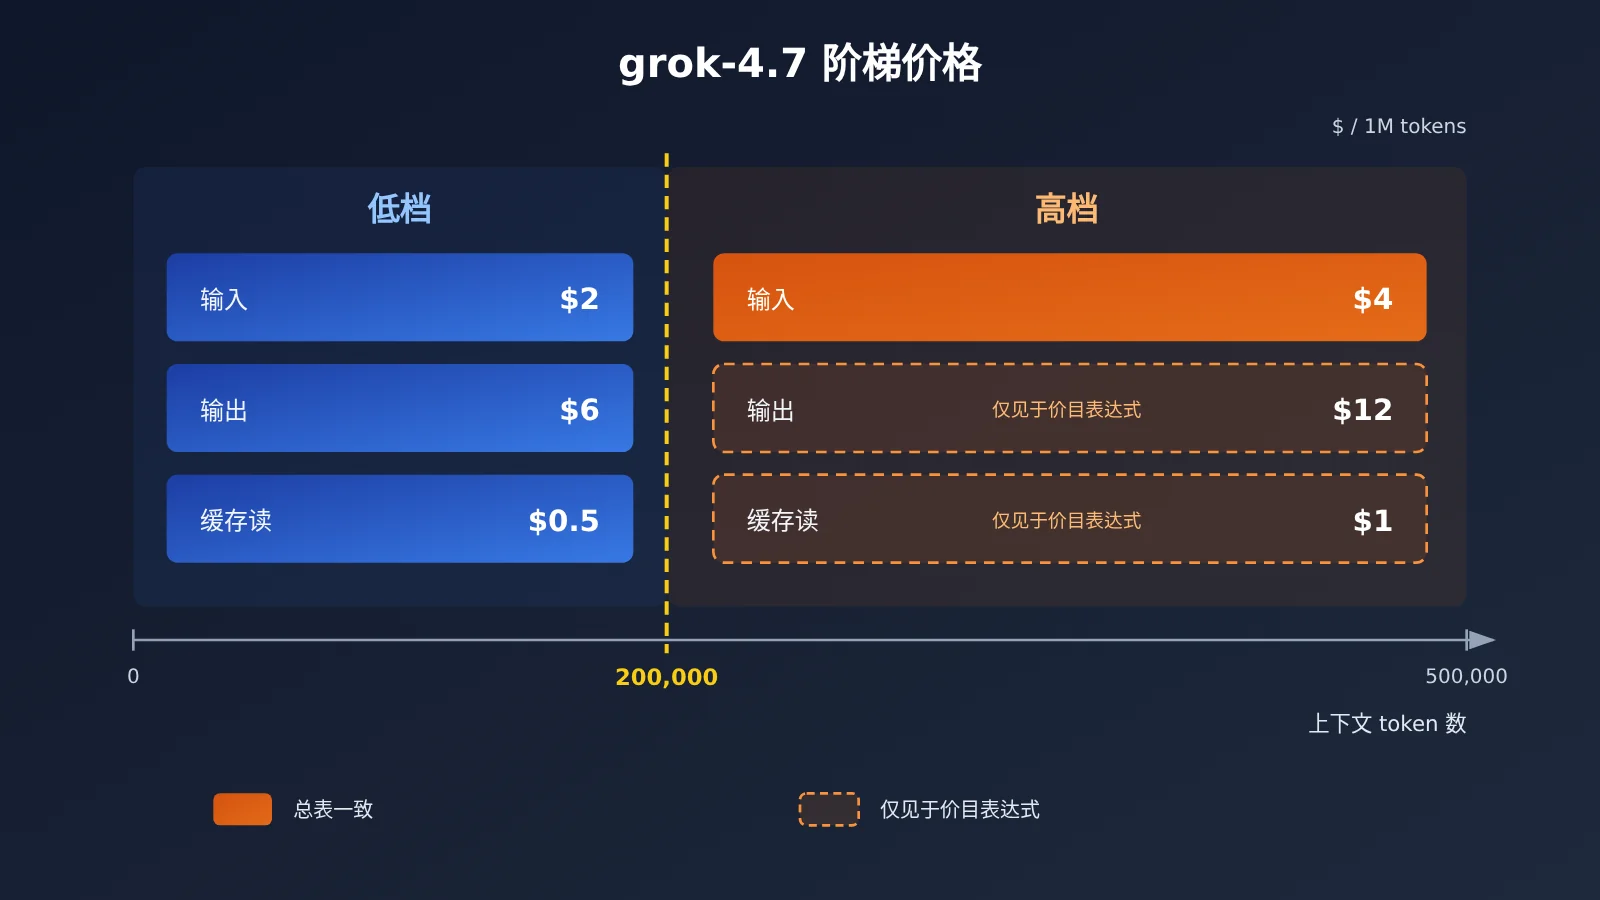
上图的价格信息来自 API易 apiyi.com 的价目接口与型号总表,核对日期 2026-11-13,以平台型号列表为准。
再看原话。2026-11-10 17:35,马斯克在 X 上说 Grok 4.8 “will bear no resemblance to 4.7 (thankfully). It is not yet incredible”。同一天 18:22 他在回复中又说 “Not as good. Opus 5.5 is a masterpiece.”,意思是 4.8 还不如 Opus 5.5。他同时预计 Grok 5 有望在两三个月内超过 Opus 5.5。
这些是态度,不是 Grok 4.8 的分数。一位创始人说新版“跟 4.7 不像,还好”,只能说明他不认可 4.7 的底子,不能推出 4.8 在上面三处短板上已经变好。
Grok 4.8 能补上这 3 个短板吗
能说到的只有马斯克原帖里的内容。他提到放弃 JAX/SGLang,用 C/C++ 从头重写了强化学习(RL)和推理栈;预训练已完成;SFT 数据做了大量清理;4.8 目前在 RL 阶段,“evals are starting to climb”。帖子没有给出任何榜单名称或分数,也没有参数量。
把这些信息与三处短板对照,结论很保守:
- 输出 token 偏多:RL 阶段确实可能影响输出长度,但他没有提到 token 效率。
- 长任务落后 Fable:没有提到 Terminal-Bench 或 CursorBench,也没有任何长任务数据。
- 20 万 token 以上的价格:没有任何价格信息,4.8 也没有上架任何价目表。
所以,猜测只能停在“重写了 RL 和推理栈,并清理了 SFT 数据”这一层。目前没有证据表明上面三处已经补上。等 4.8 有了模型卡和第三方榜单,再逐项对照才有意义。
现在调 grok-4.7、20 万 token 怎么分档
在 4.8 上架前,比较实际的做法是把 grok-4.7 的成本控制好。关键点就在 20 万 token 这条线:输入一旦越线,单价直接翻倍,按价目表达式输出和缓存读也会翻倍。下面是可落地的接入信息与分档建议:
- 模型 ID:
grok-4.7,端点为 chat,分组包括CodexResponses、Default、SVIP - 接口地址:OpenAI 兼容格式,base_url 填
https://api.apiyi.com/v1,把 model 设为grok-4.7即可 - 低档控制:单次请求上下文尽量压在
200,000tokens 以内,可用摘要、检索切片替代整份文档塞入 - 高档预算:确需长上下文时,按输入
$4、输出$12、缓存读$1预估,并留意总表未写高档输出这一处不一致 - 输出长度:结合短板一,给需要的任务设置 max_tokens,避免高推理档位下输出失控
型号与价格以平台型号列表为准,可在 docs.apiyi.com/models 查看最新信息。官方博客还提到 Grok 4.7 有一个 fast 变体,输出速度约两倍、价格约两倍,但平台总表没有单独的 fast 型号 ID,调用时不要自行拼写。
🚀 快速开始:grok-4.8 上架后,API易 apiyi.com 会尽快上架这个模型。在此之前,用同一个 API Key 先跑通 grok-4.7 的基线,等 4.8 可用时只需改一个 model 参数就能对比。
Grok 4.8 对比 Grok 4.7 场景推荐
适合继续用 Grok 4.7 的场景
- 法律、工程类专业任务:官方表里 EEBench 与 Harvey Legal Agent 两项 Grok 4.7 排第一,这类任务没有理由等。
- 上下文可控在 20 万以内的业务:可以稳定留在低档计价,单价与 4.6 相同。
- 需要立刻上线的项目:grok-4.7 是当前唯一可调的版本。
值得持续观望 Grok 4.8 的场景
- 多小时 Agent / 终端长任务:Terminal-Bench 4.0 与 Fable 5.1 差距明显,可同时评估其他模型作为备选。
- 对输出 token 成本敏感的批量任务:第三方榜单显示 4.7 输出偏长,4.8 若改善会直接降本,但目前无证据。
- 大量依赖 20 万以上上下文的应用:高档价格翻倍,值得关注 4.8 上架后的计价方式。
Grok 4.8 对比 Grok 4.7 决策建议
| 关注重点 | 当前动作 | 何时重新评估 |
|---|---|---|
| 上线稳定性 | 使用 grok-4.7 | 4.8 出现在平台型号列表时 |
| 单任务成本 | 控制上下文与输出长度 | 4.8 有第三方 token 用量数据时 |
| 长任务能力 | 并行评估备选模型 | 4.8 发布 Terminal-Bench 等分数时 |
| 价格透明度 | 以价目接口为准做预算 | 平台总表补齐高档输出价时 |
💡 选择建议:选哪个版本,取决于你的任务是否属于长任务、是否频繁越过 20 万 token。建议通过 API易 apiyi.com 用同一套接口跑你自己的样本,再决定是否把长任务切到其他模型。
常见问题 FAQ
Q1:Grok 4.8 现在能通过 API 调用吗?
不能。截至 2026-11-13,Grok 4.8 没有模型 ID,平台型号总表与价目接口里都只有 grok-4.7。马斯克说的本周软发布只面向 Grok Bot 用户。
Q2:Grok 4.8 对比 Grok 4.7 到底谁更强?
目前无法判断。Grok 4.8 没有任何公开榜单或分数,马斯克只说“评测在爬升”“还不惊艳”“不如 Opus 5.5”。这些是态度,不是可比较的数据。
Q3:Grok 4.7 输出 token 多的说法出自哪里?
出自 Artificial Analysis 2026-09-21 的第三方评测,测试档位为 xhigh。每个任务约 8.1 万输出 token,对照 4.6 high 的 3.6 万、4.6 xhigh 的 3.8 万。这不是官方数据。
Q4:Grok 4.7 是不是比 Grok 4.6 全面变差了?
不是。官方表里 Grok 4.7 在 Terminal-Bench、CursorBench、EEBench 等多项上高于 4.6。第三方榜单显示 AA-LCR 低 3.7 个点、AutomationBench-AA 低 1.1 个点,属于个别项回落。
Q5:如何现在就调用 grok-4.7?
在 API易 apiyi.com 注册并获取 API Key,新用户有免费测试额度。使用 OpenAI 兼容 SDK,base_url 填平台接口地址,model 设为 grok-4.7 即可。
Q6:20 万 token 以上的输出到底按多少计费?
价目表达式写的是输出 $12、缓存读 $1;总表阶梯只写了高档输入 $4,没有单独写高档输出。两处记载不完全一致,预算时建议按价目表达式保守估算,并以平台型号列表为准。
Q7:Grok 4.8 上架后要怎么迁移?
平台实时动态里还没有 Grok 4.8 上架记录。上架后通常只需替换 model 参数,建议先用同一批样本对照输出 token、长任务成功率和分档成本,再切换流量。
Grok 4.8 对比 Grok 4.7 核心要点 Key Takeaways
- 今天的选择:要调接口就用 grok-4.7,Grok 4.8 尚无模型 ID。
- 短板一(第三方榜单):xhigh 下每任务约 8.1 万输出 token,偏长。
- 短板二(官方自报):Terminal-Bench 与 CursorBench 仍落后 Fable 5.1。
- 不是全面落后:EEBench、Harvey 两项 Grok 4.7 排第一。
- 短板三(价目 + 原话):20 万 token 以上输入翻倍,老马不认 4.7 底子。
- 4.8 的已知改动:重写 RL 与推理栈、清理 SFT,无证据补上三处短板。
- 上手方式:通过 API易 apiyi.com 先跑 grok-4.7 基线,4.8 上架后直接对比。
总结
Grok 4.8 对比 Grok 4.7 的核心要点:
- 可用性:截至 2026-11-13,只有 grok-4.7 能调,Bot 软发布不等于 API 开放。
- 三个短板:输出 token 偏多(第三方榜单)、长任务落后 Fable(官方自报)、长上下文涨价与创始人表态(价目与原话),来源各不相同。
- 4.8 的证据:目前只有 RL 与推理栈重写、SFT 清理的说法,没有分数、价格和模型卡。
与其停下来等,不如先把 grok-4.7 的上下文分档和输出长度管好,等 4.8 有了可复核的数据再逐项对照。推荐通过 API易 apiyi.com 用统一接口先验证 grok-4.7 在你业务上的表现,为后续切换留好基线。
📚 参考资料
- xAI 官方博客 – Grok 4.7 发布:官方自报的基准对比表与定价
- 链接:
x.ai/news/grok-4-7 -
说明:Terminal-Bench 4.0、CursorBench 4.0、EEBench 等数据来源
-
Artificial Analysis – Grok 4.7 评测:第三方榜单,含输出 token 用量
- 链接:
artificialanalysis.ai/articles/benchmarking-grok-4-7 -
说明:智能指数、输出 token 对照、AA-LCR 等项变化
-
马斯克 X 帖子(2026-11-10):关于 Grok 4.8 进展的原话
- 链接:
x.com/elonmusk/status/2120088070443655190 -
说明:RL 与推理栈重写、SFT 清理、Bot 软发布
-
马斯克 X 回复(2026-11-10):对 4.8 与 Opus 5.5 的比较表态
- 链接:
x.com/elonmusk/status/2120099798078656909 -
说明:“Not as good”的出处
-
API易 型号总表:grok-4.7 型号、分组与阶梯价格
- 链接:
docs.apiyi.com/models - 说明:型号与价格以此为准,核对日期 2026-11-13
作者:APIYI 技术团队
技术交流:欢迎在 API易 网站首页联系我们,更多资料可访问 docs.apiyi.com 文档中心