最近有客户在群里问了一个很典型的问题:「我们这种 images2,可以生成电商套图吧?」答案是可以,但不是一次调用就吐出一整套图。gpt-image-2 的接口是「一个提示词对应一次生成」,想要主图、卖点图、场景图、详情页这样内容各不相同的一套图,需要在调用方式上做一点设计。
本文把 gpt-image-2 电商套图拆成两条路线:一条是用一张图承载多维度信息,适合详情页长图;另一条是先用文本模型拆解需求、生成每张图的提示词,再并发调用 gpt-image-2,适合真正意义上的多图套图。读完你会拿到完整的流程设计、可运行的代码,以及保持整套图风格统一的几个关键技巧。
gpt-image-2 电商套图的核心限制:一次调用只对应一个提示词
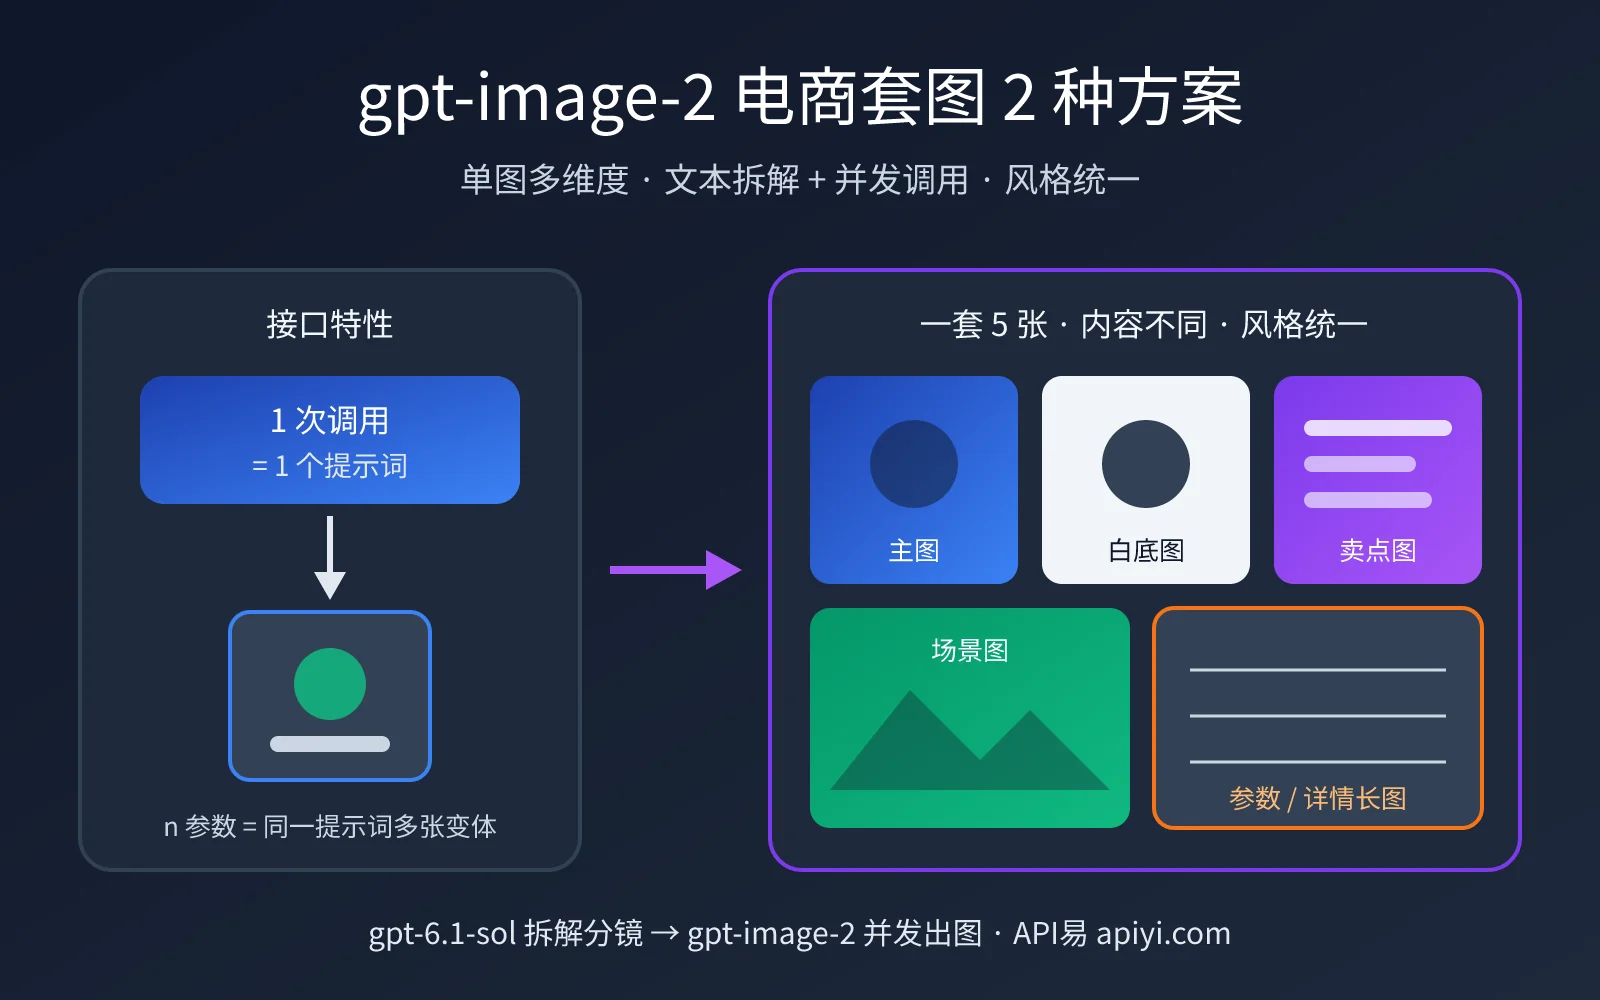
先把接口行为说清楚,后面的方案设计都建立在这个前提上。gpt-image-2 的 /v1/images/generations 和 /v1/images/edits 每次请求只接受一个 prompt。官方 gpt-image-2 和 2.5 系列都支持 n 参数,API易 也完整支持,但 n 的含义是「同一个提示词生成 n 张变体」,而不是「n 个提示词各出 1 张」。
所以 n=5 拿到的是同一画面的 5 个版本,适合「多出几张挑一张最好的」,不适合做套图。电商套图的本质是多张内容不同、风格统一的图片:主图要突出产品,卖点图要配文案,场景图要有使用环境,参数图要有尺寸标注。每张图的提示词都不一样,自然需要多次调用。
gpt-image-2 电商套图的 3 个真正难点
想清楚限制之后,会发现套图的难点其实不在「出多张」,而在下面三件事:
- 主体一致:5 张图里的产品必须是同一个产品,颜色、Logo、结构不能每张都变样。
- 风格一致:色调、光线、背景质感、字体风格要像出自同一个设计师之手。
- 信息分工:每张图承担不同的营销任务,不能 5 张都在讲同一个卖点。
这三件事决定了套图不能靠「把一句话丢给模型」解决,需要在调用之前先做规划。下面这张表是常见电商平台套图的标准构成,可以作为规划的起点。
| 套图位置 | 主要用途 | 推荐比例 | 信息密度 | 是否需要文字 |
|---|---|---|---|---|
| 主图(首图) | 搜索结果点击率 | 1:1 | 低,突出产品 | 可选,少量 |
| 白底图 | 平台规范、广告投放 | 1:1 | 极低 | 不需要 |
| 卖点图 | 传达 2-3 个核心卖点 | 1:1 或 3:4 | 中 | 需要 |
| 场景图 | 营造使用氛围 | 1:1 或 4:5 | 中 | 可选 |
| 尺寸/参数图 | 降低咨询和退货 | 1:1 | 高 | 需要 |
| 详情页长图 | 完整讲解产品 | 9:16 或更长 | 很高 | 需要 |
🎯 规划建议:动手写代码前,先按上表确定你的平台需要几张图、每张图承担什么任务。我们建议在 API易 apiyi.com 上用 gpt-image-2 先手动跑 2-3 张单图,确认产品还原度和文字渲染效果符合预期,再进入批量套图流程。
方案一:gpt-image-2 单图承载多维度信息(详情页长图)
第一条路线是「一张图讲完一套话」。gpt-image-2 的中文文字渲染和版面理解能力很强,在一张竖版大图里分区排布主视觉、卖点、参数表是完全可行的。对于详情页长图、卖点合集图、信息图这类需求,一次调用就能出一张信息量很大的成品。
这条路线最大的好处是天然没有一致性问题。所有内容都在同一张图里由模型一次生成,色调和风格自然统一,也不需要额外的编排代码。缺点是单图篇幅有限,内容太多时文字会变小、变挤,而且没法拆成独立的主图去投放。
gpt-image-2 详情长图的分区提示词写法
单图多维度的关键在于分区描述。不要写一大段混在一起的描述,而是按从上到下的版面顺序,告诉模型每个区域放什么。下面是一个保温杯详情长图的提示词结构示例:
竖版 9:16 电商详情页长图,整体风格:简约北欧风,米白色背景,柔和自然光。
【顶部区域】产品主视觉:一只哑光墨绿色保温杯斜 45 度放置,标题文字“24 小时长效保温”。
【中部区域】三栏卖点,每栏一个线性图标加短文案:“316 不锈钢内胆”“一键弹盖单手开”“500ml 大容量”。
【底部区域】参数表格:容量 500ml、重量 320g、高度 22cm、材质 316 不锈钢。
所有文字使用清晰的无衬线中文字体,不要出现多余文字。
尺寸方面,长图建议用 9:16 竖版,比如 2K 档的 1152x2048。如果需要更高清的最终素材,可以用 4K 档的 2160x3840。
单图方案只需 1 次调用,成本最低,风格天然统一;代价是信息容量有限,超过 5 个区块文字就容易拥挤,也无法拆出来单独作为搜索主图投放。它最适合家电、数码配件、日用品这类参数型标品的详情页和卖点合集。
💡 实践提示:分区超过 5 个时,文字渲染错误率会明显上升。建议把长图拆成 2-3 张「半屏图」分别生成,再在详情页里纵向拼接。这些半屏图本身就是一组小套图,也就自然过渡到了方案二。
方案二:文本模型拆解 + gpt-image-2 多次调用生成电商套图
如果你要的是真正的多图套图(主图、卖点图、场景图各自独立),就需要一条小型流水线。思路是把「理解需求、规划分镜」交给文本模型,把「出图」交给 gpt-image-2,两者用结构化的 JSON 衔接。
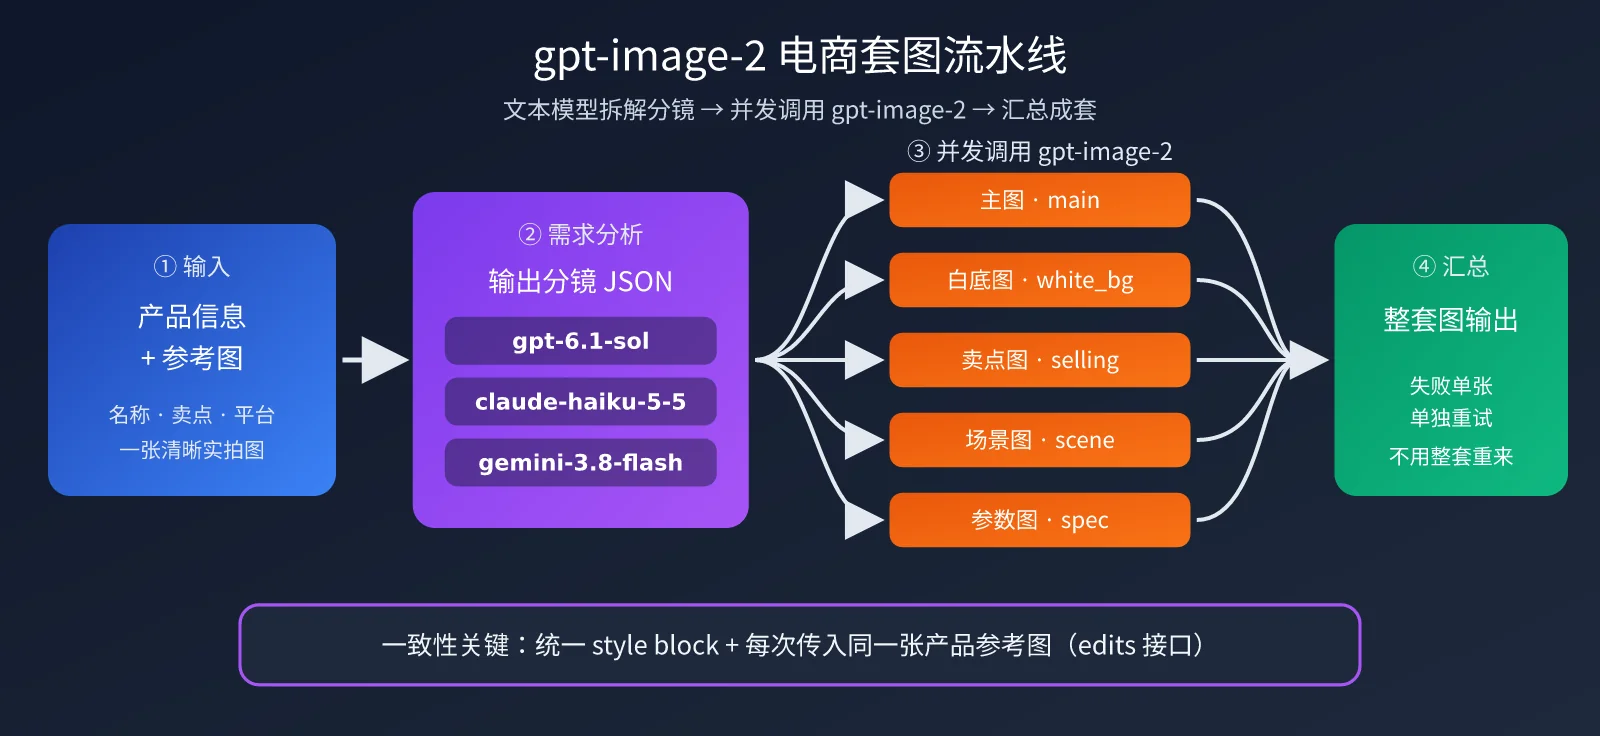
完整流程分 4 步:
- 输入:商家提供产品名称、卖点、目标平台,以及至少一张清晰的产品实拍图。
- 需求分析:文本模型根据输入,输出一个 JSON 数组,每个元素是一张图的分镜,包括用途、提示词、尺寸、文案。
- 并发出图:程序遍历分镜数组,每条分镜调用一次 gpt-image-2,带上同一张产品参考图。
- 汇总校验:收集所有结果,失败的单张单独重试,最后按顺序输出整套图。
文本模型怎么选:gpt-image-2 套图的「大脑」
需求分析这一步对文本模型的要求是:能理解电商营销逻辑、能稳定输出 JSON、能写出画面感强的提示词。目前 API易 上的几款最新模型都能胜任:
| 模型 | 定位 | 适合场景 | 选择理由 |
|---|---|---|---|
| gpt-6.1-sol | 旗舰推荐 | 高客单价商品、复杂卖点提炼 | 营销文案和分镜规划质量最好 |
| claude-haiku-5-5 | 低价高速 | 批量 SKU、标准化品类 | 指令遵循稳定,JSON 输出规整 |
| gemini-3.8-flash | 低价高速 | 大批量、多语言跨境商品 | 速度快、成本低,多语言文案自然 |
需求分析每套图只调用一次,token 消耗很少,成本主要还是在出图上。我们建议先用 gpt-6.1-sol 把提示词模板调到满意,批量跑量时再切换到 claude-haiku-5-5 或 gemini-3.8-flash 降本。三款模型在 API易 apiyi.com 上都走 OpenAI 兼容接口,切换时只需改 model 参数。
gpt-image-2 电商套图的分镜 JSON 设计
让文本模型输出固定结构的 JSON,是整条流水线稳定运行的关键。下面是推荐的字段设计:
| 字段 | 类型 | 说明 | 示例 |
|---|---|---|---|
scene |
string | 套图位置标识 | main / white_bg / selling |
purpose |
string | 这张图的营销任务 | 突出产品外观,提升点击率 |
prompt |
string | 给 gpt-image-2 的完整提示词 | 哑光墨绿保温杯置于木质桌面… |
size |
string | 输出尺寸 | 2048x2048 |
text_overlay |
string | 图中需要渲染的文字 | 24 小时长效保温 |
gpt-image-2 套图极简代码
下面是最小可运行版本:先让文本模型生成分镜,再逐条调用 gpt-image-2 的 edits 接口(带产品参考图)。
import json, base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

plan = client.chat.completions.create(
    model="gpt-6.1-sol",
    response_format={"type": "json_object"},
    messages=[{"role": "user", "content": "为墨绿色 316 保温杯规划 5 张淘宝套图,输出 {\"shots\": [...]},"
               "每项含 scene/purpose/prompt/size/text_overlay,统一风格:北欧简约、米白背景、柔和自然光"}],
)
shots = json.loads(plan.choices[0].message.content)["shots"]

for s in shots:
    img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                             prompt=s["prompt"], size=s["size"])
    open(f"{s['scene']}.png", "wb").write(base64.b64decode(img.data[0].b64_json))
这段代码是串行执行的,5 张图要依次等待,下一节会改成并发版本。
如何保持 gpt-image-2 电商套图风格一致
多次调用最容易出的问题,就是 5 张图看起来像 5 个不同店铺的。下面几个技巧组合使用,可以把一致性提升到可商用的水平:
- 统一 style block:把色调、光线、背景、镜头语言写成一段固定文字,拼接在每条分镜提示词的末尾。不要让文本模型每次自由发挥风格描述。
- 固定产品参考图:每次调用都通过 edits 接口传入同一张产品实拍图,并在提示词里明确「保持参考图中产品的颜色、Logo 和结构不变」。这是保证主体一致最有效的手段。
- 固定参数:同一套图使用相同的
quality档位,尺寸只在必要时变化(比如长图用竖版)。 - 用 n 参数做择优:对主图这种最关键的位置,可以设置
n=2或n=3生成几个变体,人工挑一张最好的。这正是 n 参数的正确用法。
🎯 一致性建议:style block 是整套图的「品牌规范」,建议为每个店铺沉淀一份固定模板。通过 API易 apiyi.com 调用 gpt-image-2 时,可以把 style block 存在配置文件里,所有 SKU 共用,换季时统一更新即可。
gpt-image-2 电商套图并发调用:提速与放量策略
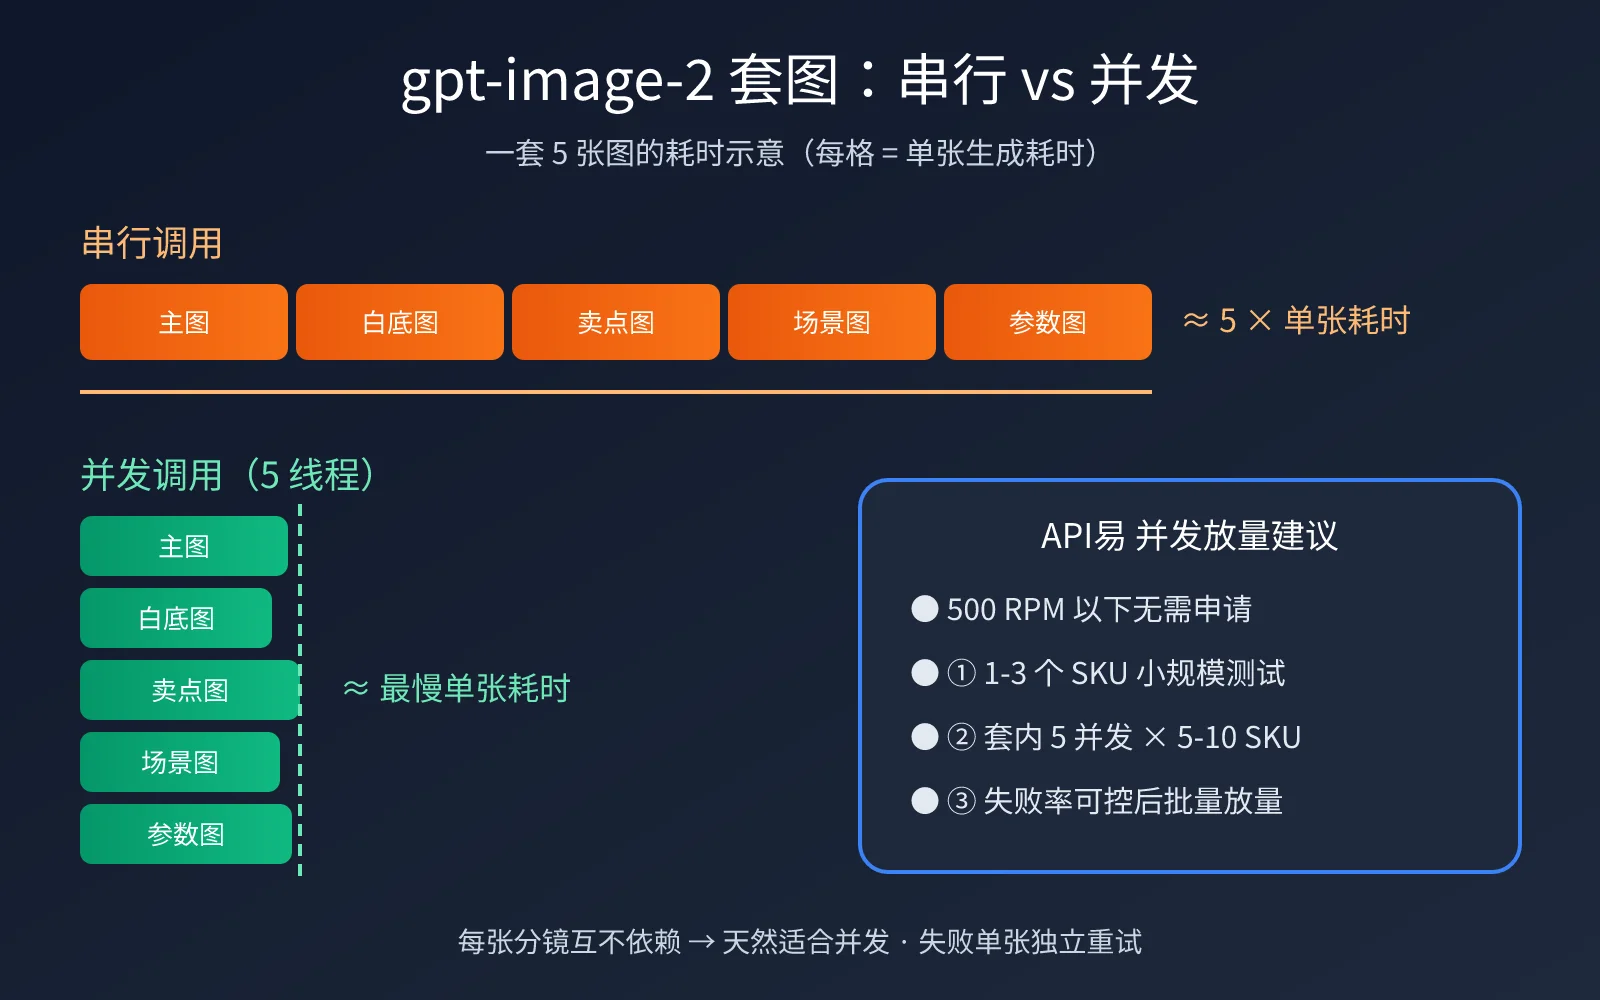
串行生成一套 5 张图,等待时间是每张图耗时的总和,图片越多越慢。由于每张分镜之间互不依赖,完全可以并发调用,让整套图的耗时接近「最慢那一张」的耗时。
API易 对 gpt-image-2 的调用没有设置并发上限,500 RPM 以下可以直接使用,不需要额外申请。对绝大多数商家来说,即使同时跑几十个 SKU 的套图,也远到不了这个量级。
gpt-image-2 套图并发代码
把上面的串行循环换成线程池,就能实现并发出图,同时加入失败重试,避免一张失败导致整套重来:
from concurrent.futures import ThreadPoolExecutor

def gen_one(s, retries=2):
    for i in range(retries + 1):
        try:
            img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                                     prompt=s["prompt"] + STYLE_BLOCK, size=s["size"])
            return s["scene"], img.data[0].b64_json
        except Exception as e:
            if i == retries:
                return s["scene"], None

with ThreadPoolExecutor(max_workers=5) as pool:
    results = dict(pool.map(gen_one, shots))
failed = [k for k, v in results.items() if v is None]
查看完整版代码(含 style block、多 SKU 批量、失败补生成、结果落盘)
import json, base64, time
from pathlib import Path
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

STYLE_BLOCK = (
    "。整体风格:北欧简约,米白色背景,柔和自然光,低饱和配色,"
    "保持参考图中产品的颜色、Logo 和结构完全不变,文字使用清晰无衬线中文字体。"
)

PLAN_PROMPT = """你是资深电商视觉策划。根据以下商品信息规划一套 {count} 张的{platform}套图。
商品信息:{product}
输出 JSON:{{"shots": [{{"scene": "...", "purpose": "...", "prompt": "...",
"size": "2048x2048", "text_overlay": "..."}}]}}
要求:每张图承担不同营销任务;prompt 只描述画面内容,不要描述整体风格;
需要文字时把文字原文写进 prompt 并用引号标出。"""


def plan_shots(product: str, platform: str = "淘宝", count: int = 5,
               model: str = "gpt-6.1-sol") -> list:
    """用文本模型拆解分镜,批量时可换 claude-haiku-5-5 / gemini-3.8-flash"""
    resp = client.chat.completions.create(
        model=model,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": PLAN_PROMPT.format(
            count=count, platform=platform, product=product)}],
    )
    return json.loads(resp.choices[0].message.content)["shots"]


def gen_one(shot: dict, ref_image: str, retries: int = 2):
    """单张出图,失败指数退避重试"""
    for attempt in range(retries + 1):
        try:
            with open(ref_image, "rb") as f:
                img = client.images.edit(
                    model="gpt-image-2",
                    image=f,
                    prompt=shot["prompt"] + STYLE_BLOCK,
                    size=shot.get("size", "2048x2048"),
                )
            return shot["scene"], img.data[0].b64_json
        except Exception as e:
            print(f"[{shot['scene']}] 第 {attempt + 1} 次失败:{e}")
            time.sleep(2 ** attempt)
    return shot["scene"], None


def gen_image_set(sku: str, product: str, ref_image: str, workers: int = 5):
    shots = plan_shots(product)
    out_dir = Path("output") / sku
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / "plan.json").write_text(json.dumps(shots, ensure_ascii=False, indent=2))

    with ThreadPoolExecutor(max_workers=workers) as pool:
        results = dict(pool.map(lambda s: gen_one(s, ref_image), shots))

    # 失败单张补生成一轮
    failed = [s for s in shots if results.get(s["scene"]) is None]
    for s in failed:
        results[s["scene"]] = gen_one(s, ref_image, retries=3)[1]

    for scene, b64 in results.items():
        if b64:
            (out_dir / f"{scene}.png").write_bytes(base64.b64decode(b64))
    print(f"{sku}: 成功 {sum(1 for v in results.values() if v)}/{len(shots)} 张")


if __name__ == "__main__":
    gen_image_set(
        sku="cup-green-500",
        product="墨绿色 316 不锈钢保温杯,500ml,24 小时保温,一键弹盖",
        ref_image="cup.png",
    )
并发放量的 3 个阶段
虽然没有并发上限,我们仍然建议按阶段放量,先验证效果再扩大规模,避免一次性跑出几百张不合格的图:
- 小规模测试:选 1-3 个 SKU,串行或低并发跑通,人工检查产品还原度、文字正确率和风格统一度。
- 中等并发:效果稳定后,开到每套图 5 并发、同时 5-10 个 SKU,观察失败率和平均耗时。
- 批量放量:确认失败率可控后,按业务量继续提高并发,500 RPM 以内都可以直接跑。
| 调用方式 | 一套 5 张耗时 | 稳定性 | 适用阶段 |
|---|---|---|---|
| 串行调用 | 约 5 倍单张耗时 | 最稳,便于调试 | 提示词调试期 |
| 套内并发(5 线程) | 约等于最慢单张 | 稳定 | 日常上新 |
| 多 SKU + 套内并发 | 与单套接近 | 需配合重试 | 大促批量上新 |
🚀 放量建议:对于大促前集中上新的场景,我们推荐通过 API易 apiyi.com 采用「多 SKU + 套内并发」模式。平台 500 RPM 以下无需任何申请,配合失败单张补生成机制,几十个 SKU 的整套图可以在很短时间内全部完成。
gpt-image-2 电商套图方案怎么选
两种方案并不互斥,实际业务中经常组合使用。下面按常见平台和场景给出推荐:
| 平台/场景 | 推荐方案 | 建议张数 | 说明 |
|---|---|---|---|
| 淘宝/天猫主图 | 方案二 | 5 张 | 主图、白底、卖点、场景、参数各一张 |
| 淘宝/拼多多详情页 | 方案一 + 方案二 | 3-6 张半屏图 | 分段生成后纵向拼接 |
| 亚马逊 Listing | 方案二 | 7 张 | 首图白底严格合规,其余做卖点和场景 |
| 独立站商品页 | 方案二 | 4-6 张 | 场景图权重更高,突出品牌调性 |
| 小红书种草 | 方案二 | 3-6 张 | 3:4 竖版,生活化场景为主 |
| 活动海报/卖点合集 | 方案一 | 1 张 | 单图信息集中,传播效率高 |
选择的核心原则很简单:需要独立投放、独立展示的图,用方案二;只在一个页面里连续阅读的内容,用方案一。如果拿不准,就先用方案二出主图和场景图,再用方案一出一张卖点合集长图,覆盖面最广。
💡 组合建议:两种方案用的是同一个 gpt-image-2 模型、同一套 API Key。建议把两套流程封装成一个服务,按商品类型自动选择方案,商家只需要上传一张产品图和几行卖点文字即可。
常见问题
gpt-image-2 的 n 参数能直接生成电商套图吗?
不能。官方 gpt-image-2 和 2.5 系列都支持 n 参数,API易 也支持,但它是同一个提示词生成 n 张变体。套图的每张图内容不同,需要不同的提示词,所以要多次调用。n 更适合用在主图这种关键位置做择优。
生成的多张图里产品长得不一样怎么办?
这是套图最常见的问题。最有效的做法是每次调用都用 edits 接口传入同一张产品实拍图,并在提示词里写明「保持参考图中产品的颜色、Logo 和结构不变」。同时把风格描述固定成 style block,不要让文本模型自由发挥。参考图建议用背景干净、光线均匀的实拍图,还原效果最好。
图中的中文文字渲染错误怎么处理?
gpt-image-2 的中文渲染能力已经很强,但文字越多出错概率越高。建议每张图的文字控制在 2-3 个短句以内,在提示词中用引号标出文字原文。如果某张图文字出错,只重新生成这一张即可,不用整套重来。
文本拆解用哪个模型最划算?
调试提示词模板时用 gpt-6.1-sol,规划质量最好;模板稳定后批量跑量,可以切换到 claude-haiku-5-5 或 gemini-3.8-flash,成本更低、速度更快。这一步每套图只调用一次,花费远低于出图本身。三款模型在 API易 apiyi.com 上用同一个 API Key 即可调用。
并发调用需要申请额度吗?
不需要。API易 对 gpt-image-2 没有设置并发上限,500 RPM 以下直接使用即可。建议先用 1-3 个 SKU 做小规模测试,确认效果后再逐步提高并发放量。
总结
gpt-image-2 生成电商套图,关键在于理解它「一次调用对应一个提示词」的接口特性。n 参数解决的是择优问题,套图需要的是多个不同提示词的多次调用。在这个前提下,详情页、卖点合集这类连续阅读的内容,可以用单图多维度方案一次生成;主图、场景图这类需要独立展示的套图,用文本模型拆解 + 并发调用的流水线批量完成。
两条路线的共同核心是一致性控制:固定的 style block 加上同一张产品参考图,是让多张图看起来出自同一个设计团队的关键。并发方面,500 RPM 以下可以直接放量,按「小规模测试 → 中等并发 → 批量放量」三步走最稳妥。
我们建议通过 API易 apiyi.com 一站式完成整条流水线:gpt-6.1-sol、claude-haiku-5-5、gemini-3.8-flash 负责需求拆解,gpt-image-2 负责出图,一个 API Key 打通全部环节,可以快速搭建自己的电商套图生成服务。
作者: APIYI Team | 专注 AI 大模型 API 技术分享,更多模型接入教程欢迎访问 API易 apiyi.com