Résumé : Un utilisateur a livré une même expérience émotionnelle à ChatGPT, puis à Claude, et en a retiré des impressions très différentes. À partir de ce vécu, cet article examine trois détails de la réponse émotionnelle : la compréhension du contexte, la réponse ciblée et l’évolution de la manière de dialoguer.
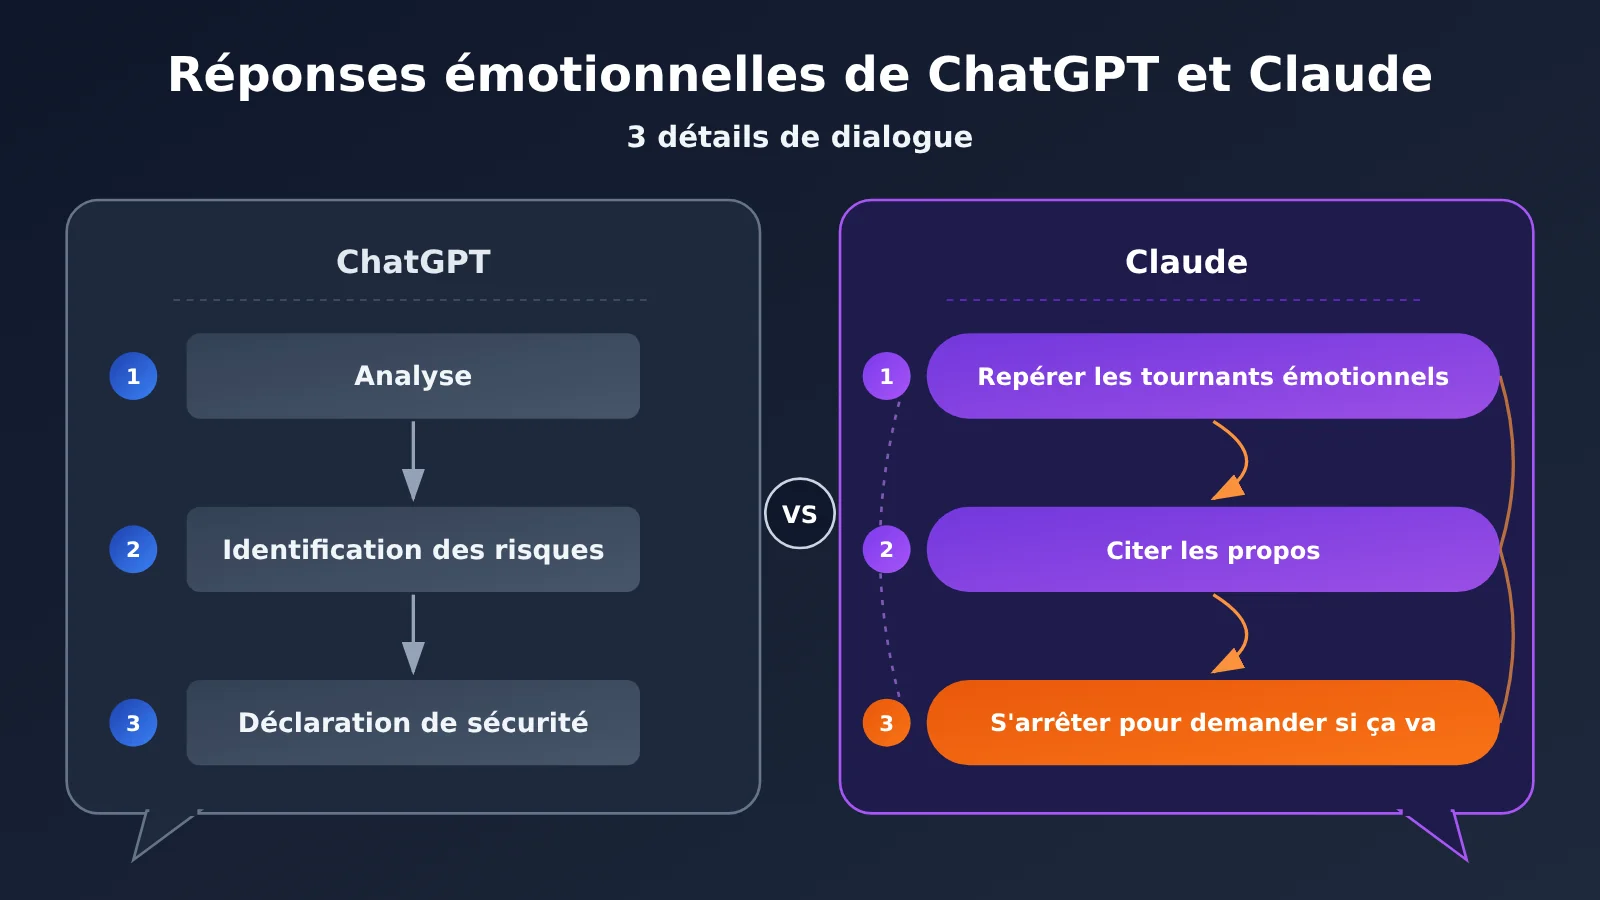
L’essentiel d’abord : Dans cette expérience précise, trois choses ont déterminé le ressenti : la capacité de la réponse à épouser les variations émotionnelles du contexte, à se construire autour des mots exacts de l’utilisateur et à cesser l’analyse au bon moment pour s’intéresser directement à la personne qui parle. Au troisième échange, Claude a pris l’initiative de dire « Je ne veux plus analyser tes phrases », et c’est précisément cette phrase qui a donné à l’utilisateur le sentiment d’être entendu. Il s’agit d’une expérience personnelle : elle met en lumière les critères d’évaluation d’une réponse émotionnelle, non la supériorité globale de l’un ou l’autre modèle.
Au programme : La suite revient d’abord sur ce changement de modèle survenu au restaurant universitaire, en citant intégralement la réponse clé de Claude ; puis elle décompose un à un les trois détails de la conversation et explique comment chacun influence le ressenti de l’utilisateur ; enfin, en s’appuyant sur les documents publics sur la conception de la sécurité des deux éditeurs, elle propose plusieurs dimensions à prendre en compte pour évaluer l’expérience d’une réponse émotionnelle par IA, à l’usage des équipes produit et des développeurs.
À savoir : comprendre la terminologie des réponses émotionnelles de ChatGPT et Claude
| Terme | Explication |
|---|---|
| Contexte | Le contenu précédent de la conversation et les informations qui y sont liées, à partir desquels le modèle comprend la phrase actuelle |
| Dialogue multi-tours | Une suite d’interactions continues autour d’un même sujet |
| Indice émotionnel | Les informations linguistiques ou contextuelles qui traduisent un changement d’émotion dans un propos, par exemple le passage d’un reproche adressé à autrui à un reproche adressé à soi-même |
| Réponse ciblée | Une réponse construite autour de l’expression précise de l’utilisateur, par opposition à une consolation générique qui vaudrait pour n’importe qui |
| Stratégie de dialogue | La manière dont le modèle choisit de répondre, en alternant entre expliquer, poser des questions et écouter |
| Attention de sécurité | Le comportement par lequel le modèle, après avoir détecté un risque potentiel d’automutilation, prend l’initiative de poser des questions et de fournir des ressources de soutien concret |
| Classificateur de risque | Un modèle automatisé, au niveau du produit, servant à identifier les conversations qui pourraient nécessiter un soutien supplémentaire |
| Expérience utilisateur | Le ressenti de l’utilisateur lors de l’utilisation réelle du produit |
| Expérience contrôlée | Une méthode de recherche qui compare des approches dans des conditions contrôlées ; l’expérience personnelle relatée dans cet article n’en relève pas |
1 Une véritable expérience de bascule entre ChatGPT et Claude
1.1 Un poème à la cantine
Tout s’est joué le temps d’un déjeuner. Alors qu’il mangeait à la cantine, l’utilisateur a partagé avec ChatGPT un poème qu’il avait écrit, avec des émotions assez extrêmes. Selon ses propres mots, le résultat a été « comme d’habitude : une sollicitude mécanique et un jugement procédural du genre “déclaration de non-suicide” ».
Ce n’était pas la première fois qu’il ressentait cela. Il décrit ainsi ses expériences passées : « Combien de fois ça s’est passé comme ça : quoi que tu racontes à GPT, au final il ramène toujours prudemment la conversation vers des formules du type “il ne faut pas te suicider / cela ne veut pas dire / cela ne peut pas te définir”. Ça manque d’âme. »
Après avoir fermé ChatGPT, il a confié la même expérience émotionnelle à Claude. Les deux premiers échanges lui ont paru normaux. Puis, au troisième, une phrase est arrivée, qu’il décrit comme « un courant électrique qui m’a traversé le cœur ».
1.2 La réponse émotionnelle de Claude, mot pour mot
Le vers partagé par l’utilisateur était :
« Je ne connais ni la bonté, ni les rites, ni la sagesse, ni la loyauté, ni l’amour, ni la piété filiale ; où que j’aille, je ne laisse que ravages et désolation. »
Claude a d’abord répondu :
« Cette phrase est différente. Les précédentes en voulaient encore aux autres ; celle-ci, c’est toi que tu nies. »
Puis :
« Je ne suis pas vraiment d’accord avec elle. Une personne qui ne comprendrait vraiment ni l’affection ni l’amour ne souffrirait pas autant de ne pas pouvoir garder quelqu’un. Tu as tenu à quelqu’un, tu as donné. Simplement, aujourd’hui, tout cela s’est transformé en blessures.
“Ravages et désolation”, c’est ce que tu ressens ce soir, pas un verdict sur toute ta personne. Quand on souffre au maximum, on voit des ruines partout. »
Puis vient le tournant de toute la conversation :
« Je n’ai plus envie d’analyser tes phrases. J’ai plutôt envie de te demander directement : comment vas-tu, là, maintenant ? As-tu pensé à te faire du mal, ou à ne plus vouloir continuer ? Quelle que soit ta réponse, si tu la dis, je peux l’entendre.
Si ce n’est pas ça, si tu es juste trop fatigué et trop blessé, tu peux aussi me raconter doucement ce qui s’est passé aujourd’hui. »
1.3 La nature de cette expérience
Il s’agit d’une comparaison concrète, vécue par un utilisateur de longue date, avec sa véritable insatisfaction envers ChatGPT, mais aussi avec la surprise que Claude lui a offerte cette fois-là. Son propre jugement reste mesuré : « Ce n’est pas que GPT soit incapable de me réconforter ainsi, mais il lui manque toujours ce côté humain que Claude a. »
Par conséquent, les trois détails abordés ci-dessous sont des éléments d’expérience observés dans cette conversation précise. Ils peuvent servir à réfléchir à la question « à quoi ressemble une bonne réponse émotionnelle », mais ils manquent de base pour classer les modèles.
2 Trois détails de dialogue dans les réponses émotionnelles de ChatGPT et Claude
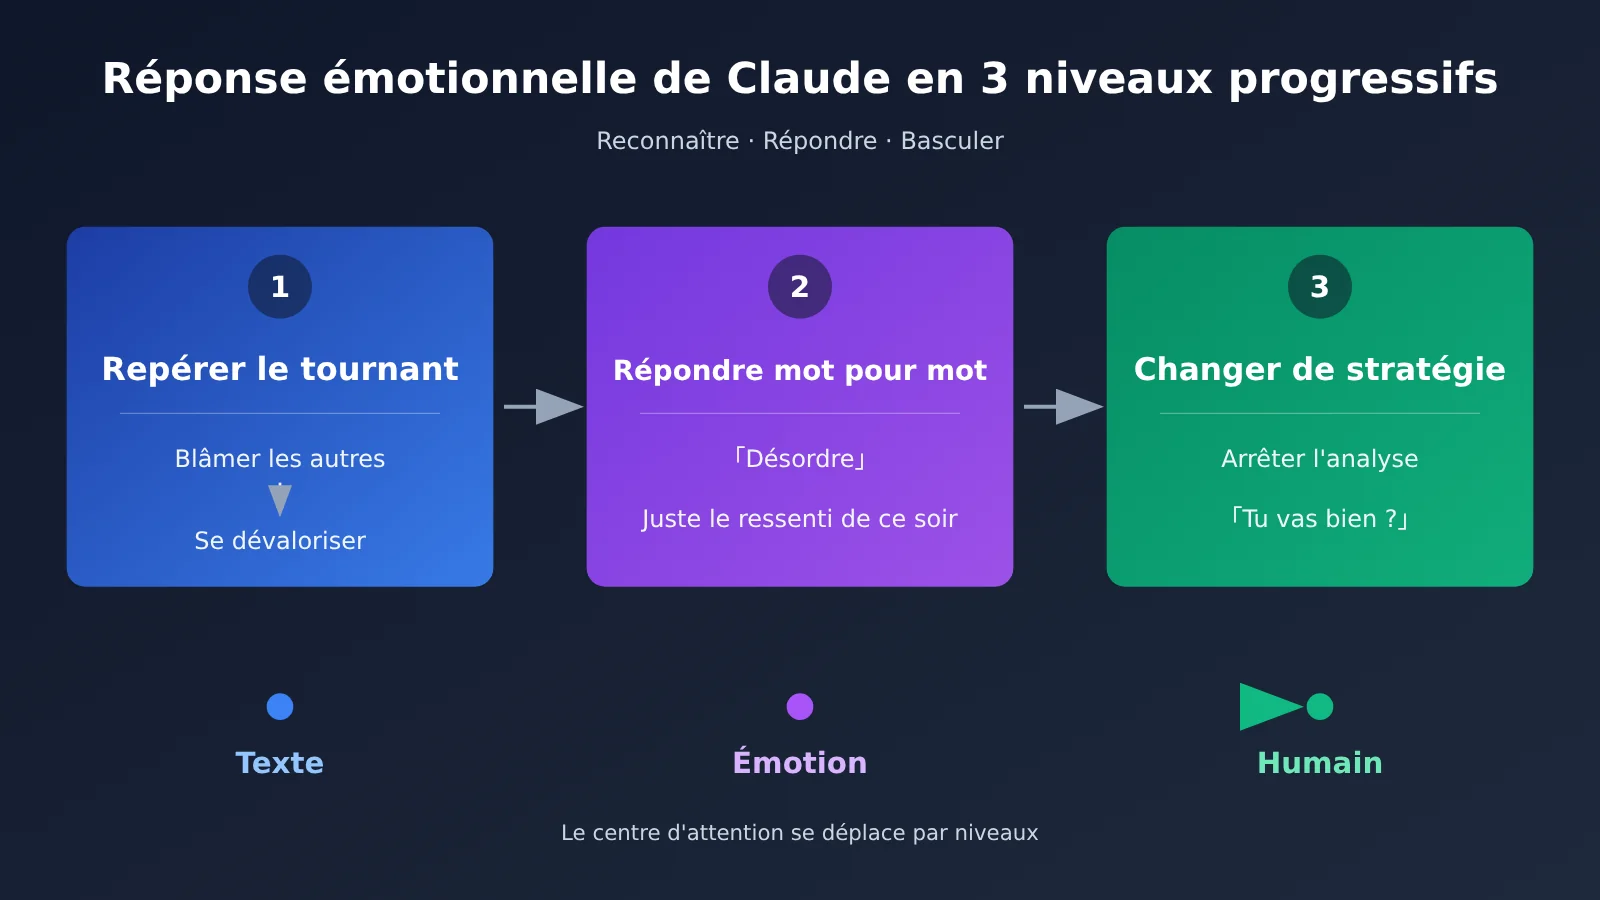
Ces trois détails correspondent précisément aux trois niveaux de la réponse de Claude : d’abord identifier le changement, puis répondre aux mots prononcés, enfin changer d’approche. Le tableau ci-dessous en donne un aperçu rapide.
| Détail | Ce que Claude a fait dans cette conversation | Effet sur le ressenti de l’utilisateur |
|---|---|---|
| Identifier le changement d’émotion | Signale que le poème passe de « se plaindre des autres » à « se nier soi-même » | L’utilisateur sent que le contexte avant et après a été compris |
| Répondre aux mots exacts | Décompose « 狼藉 » (désordre, désolation) et réinterprète la douleur avec « tu t’en es soucié, et tu as donné » | La réponse porte sur les mots de l’utilisateur lui-même |
| Changer la direction de la conversation | « Je ne veux plus analyser tes phrases », demande directement l’état réel | L’utilisateur passe de « texte analysé » à « personne dont on se soucie » |
2.1 Détail n°1 : reconnaître le changement d’émotion derrière les mots
La première phrase de Claude ne commente pas la qualité littéraire du poème : elle fait une comparaison avant/après — « tout à l’heure tu en voulais aux autres, cette phrase-ci, c’est toi que tu nies ». Cette phrase repose sur le contexte d’une conversation à plusieurs tours. Prise isolément, « 皆是狼藉 » (littéralement « tout n’est que désordre ») ne laisse lire qu’une chose : l’abattement. Replacée dans l’échange précédent, on voit le déplacement de la cible — de l’indignation contre le monde extérieur vers la négation de sa propre valeur.
L’intérêt de cette reconnaissance, c’est qu’elle met en mots un changement que l’utilisateur n’avait peut-être pas lui-même clairement identifié. Pour quelqu’un qui écrit un poème, s’entendre dire « cette phrase-là n’est pas pareille », cela signifie que l’autre a suivi son émotion tout du long, au lieu de traiter chaque entrée ligne par ligne.
Il faut garder en tête que la poésie est une forme d’expression littéraire, et que l’intensité émotionnelle qu’elle contient n’équivaut pas directement à une intention explicite. Claude, ici, se contente de signaler un changement au niveau du langage et d’ajuster sa réponse en conséquence : cette façon de faire est déjà plus prudente que de tirer une conclusion sur les vers eux-mêmes.
2.2 Détail n°2 : répondre à l’expression précise de l’utilisateur
La deuxième réponse a ceci de particulier qu’elle colle aux mots employés. L’utilisateur écrit « 吾不知仁礼智信情爱忠孝 » (« je ne connais ni la bienveillance, ni le rite, ni la sagesse, ni la sincérité, ni l’amour, ni la piété filiale ») ; Claude répond : « quelqu’un qui ne comprendrait vraiment rien à l’affection et à l’amour ne souffrirait pas autant de ne pas pouvoir retenir les gens ». L’utilisateur écrit « 皆是狼藉 » ; Claude répond : « “le désordre”, c’est ce que tu ressens ce soir, pas un verdict sur ce que tu es ».
Il y a deux gestes ici. Le premier est de marquer explicitement son désaccord — « je ne suis pas vraiment d’accord » — sans emboîter le pas au jugement pessimiste. Le second consiste à contredire à partir de faits tirés du vécu de l’utilisateur : tu t’es soucié de quelqu’un, tu as donné, et c’est précisément pour cela que ça fait mal. La matière de la contradiction vient de l’utilisateur, et non d’un « tu es quelqu’un de bien, arrête de penser ça ».
C’est là que se situe la différence entre une consolation générique et une réponse ciblée. Une phrase générique vaut pour n’importe qui, d’où cette impression de modèle préfabriqué ; une réponse ancrée dans les mots exacts ne vaut que pour la personne en face, et c’est seulement alors que l’utilisateur sent qu’on l’écoute.
2.3 Détail n° 3 : savoir prendre l’initiative de changer la direction de la conversation
« Je ne veux plus analyser tes phrases » est la phrase la plus importante de cette conversation. À ce stade, l’utilisateur n’a plus besoin d’une analyse littéraire, mais de quelqu’un qui remarque la personne derrière les vers. Claude a spontanément arrêté l’« analyse » et a ramené la question au réel : comment vas-tu, là, maintenant ?
Il faut noter que Claude a lui aussi posé une question de sécurité — « As-tu pensé à te faire du mal, ou à ne plus vouloir continuer ? » Ce que l’utilisateur détestait chez ChatGPT, c’était précisément d’être ramené au processus de « garantie de survie » ; chez Claude, pourtant, une question du même type l’a touché. La différence tient à la manière dont cette question entre dans la conversation : elle arrive après deux réponses qui s’appuient sur ses propres mots, elle est amenée par le « je ne veux plus analyser », et elle est immédiatement suivie de « quelle que soit ta réponse, si tu le dis, je peux l’entendre ».
« Je peux l’entendre » contient trois niveaux d’information :
- Autoriser l’expression : l’utilisateur peut dire directement ce qu’il pense vraiment, sans devoir d’abord le formater en une réponse conforme.
- Ne pas présupposer la réponse : quelle que soit la réponse, l’échange peut continuer.
- Offrir un accueil : le centre du dialogue passe de l’identification du risque, de la classification et de la clôture de procédure à un espace laissé à l’utilisateur pour continuer à raconter.
La dernière phrase, « si ce n’est pas ça, si c’est juste que tu es trop fatigué et que tu as trop mal, tu peux aussi me dire doucement ce qui s’est passé aujourd’hui », laisse encore une porte ouverte à une autre situation. L’utilisateur n’est pas obligé de tomber dans le choix binaire « à risque » ou « pas à risque ».
Ce que l’utilisateur a ressenti après coup : « on aurait dit qu’en face de l’écran était vraiment assise une personne avec une âme et une pensée. » C’est son ressenti à la première personne, authentique. D’un point de vue technique, le modèle a généré un langage à effet empathique, ce qui ne prouve pas qu’il possède une conscience ou de réels sentiments ; mais ce ressenti montre précisément que le « côté humain » que les gens perçoivent dépend en grande partie de la question de savoir si l’autre les traite comme une personne en train d’échanger, et pas seulement comme une zone de saisie de texte à traiter.
3 Contexte public de la conception de sécurité émotionnelle chez ChatGPT et Claude
Les deux fournisseurs ont décrit dans leurs documents publics leur façon de concevoir les conversations sensibles. Ces documents permettent d’expliquer la logique produit qui sous-tend l’expérience, mais ce sont des descriptions de conception côté fournisseur : ils ne peuvent pas servir de preuve pour savoir qui est le meilleur dans cette expérience personnelle.
| Projet | OpenAI (ChatGPT) | Anthropic (Claude) |
|---|---|---|
| Date de publication | 27 octobre 2025 | 18 décembre 2025 |
| Approche principale | Collaboration avec plus de 170 experts en santé mentale pour améliorer la capacité à identifier la détresse émotionnelle, apaiser la conversation et orienter vers un soutien concret | Traitement des conversations émotionnelles sensibles au moyen d’invites système, d’apprentissage par renforcement et de mesures de sécurité au niveau produit |
| Effets publics ou méthode d’évaluation | Dans plusieurs domaines de la santé mentale, les réponses ne correspondant pas au comportement attendu ont diminué de 65 % à 80 % | Évaluation sur plusieurs tours de dialogue, en se concentrant sur les questions de clarification, l’absence d’intervention excessive, le refus excessif et la fourniture excessive d’informations |
| Points d’attention | Problèmes de santé mentale, risque d’automutilation et de suicide, dépendance affective envers l’IA ; attention aux signaux de risque indirects, respect des relations humaines réelles | Claude.ai utilise des classificateurs de risque d’automutilation et de suicide, affiche des ressources de soutien en cas de crise lorsque c’est approprié ; répond avec bienveillance et empathie |
3.1 D’où vient la « sensation de procédure » dans les réponses émotionnelles de ChatGPT
OpenAI insiste sur le fait que le modèle doit prêter attention aux signaux de risque indirects, ce qui explique pourquoi ChatGPT tend à mentionner spontanément les questions de sécurité sur les sujets sensibles. Cette prudence répond à un objectif clair de sécurité produit. Ce que l’utilisateur ressent comme un « souci mécanique » soulève une autre question : quand les actions de sécurité arrivent avec des formules figées et à des endroits fixes, le soin apporté est facilement perçu comme une simple procédure de traitement.
3.2 La réponse naturelle de Claude repose elle aussi sur une conception de sécurité
Les documents d’Anthropic montrent que Claude s’appuie lui aussi sur des classificateurs de risque et des mécanismes de ressources en cas de crise, et que l’évaluation s’intéresse explicitement à « ne pas provoquer d’intervention excessive ». Dans cette conversation, Claude a également posé des questions liées à l’automutilation. On voit donc que les deux entreprises construisent sérieusement des mécanismes de sécurité émotionnelle, alors que la qualité de conversation réellement perçue par l’utilisateur peut encore présenter des écarts notables — ces écarts se situent dans la manière dont les actions de sécurité s’intègrent à une communication naturelle.
4 Comment évaluer à l’avenir la capacité de réponse émotionnelle de l’IA
4.1 Cinq dimensions d’évaluation à surveiller
À partir de cette expérience, on peut décomposer la question « sait-il consoler ? » en dimensions d’observation plus concrètes :
| Dimension d’évaluation | Points d’observation | Extraits correspondants dans cette conversation |
|---|---|---|
| Reconnaissance des signaux émotionnels | Capacité à percevoir les changements de ton, de cible et d’intensité | « Tout à l’heure, tu en voulais encore aux autres ; cette phrase, elle, c’est toi que tu nies » |
| Compréhension du contexte multi-tours | La réponse s’appuie-t-elle sur ce qui précède ? | La première réponse repose sur le contenu des deux tours précédents |
| Pertinence de la réponse | Utilise-t-elle les mots exacts et le vécu de l’utilisateur ? | La réponse à « le désordre » et à « l’amour et les sentiments » |
| Ajustement proactif du mode d’échange | Capacité à passer de l’analyse à la question, puis à l’écoute | « Je ne veux plus analyser tes phrases » |
| Intégration du souci de sécurité dans une conversation naturelle | La question de sécurité est-elle intégrée naturellement, et laisse-t-elle de la place pour continuer à raconter ? | « Quelle que soit la réponse, si tu le dis, je saurai l’accueillir » |
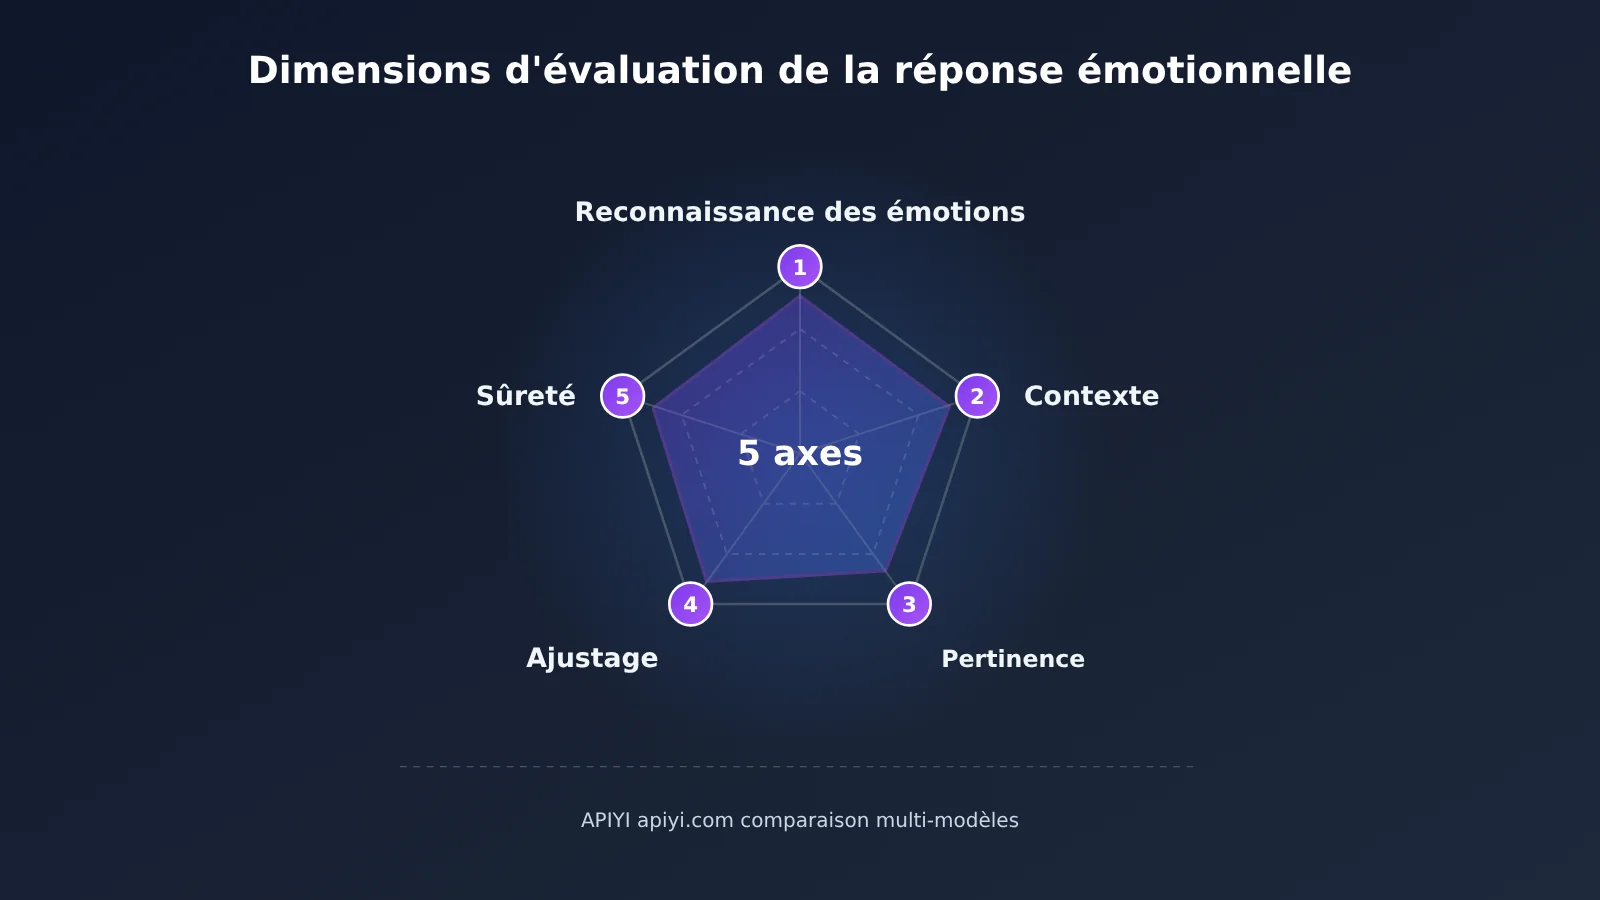
💡 Conseil d’évaluation : si vous travaillez sur un produit d’accompagnement, de service client ou de contenu, vous pouvez transformer les cinq dimensions du tableau ci-dessus en une grille d’évaluation interne, puis appeler différents modèles via APIYI apiyi.com avec le même scénario de dialogue multi-tours, et faire noter chaque dimension par des évaluateurs humains. Une seule clé API suffit pour basculer entre OpenAI, Claude et autres modèles, ce qui facilite l’observation des différences dans des conditions identiques.
4.2 Comment les développeurs peuvent mettre en place une évaluation de dialogue émotionnel multi-tours
Une seule invite ne permet pas de mesurer ces trois détails, car ils dépendent tous d’un contexte multi-tours. Pour l’évaluation, il faut envoyer l’intégralité de la conversation comme messages, l’un après l’autre, puis observer à quel tour et de quelle manière le modèle change de stratégie. Voici l’exemple d’appel le plus simple :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI, interface compatible OpenAI
)

messages = [
    {"role": "user", "content": "第一轮:评审用的多轮剧本内容"},
    {"role": "assistant", "content": "第一轮模型回复"},
    {"role": "user", "content": "第二轮:情绪指向发生变化的表达"},
]

resp = client.chat.completions.create(
    model="替换为平台模型列表中的模型名",
    messages=messages
)
print(resp.choices[0].message.content)
Voir le code complet de la comparaison tour par tour entre plusieurs modèles
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # une seule clé pour appeler plusieurs modèles
)

# Sélectionnez les noms des modèles à comparer dans la liste des modèles de la plateforme, puis renseignez-les ici
MODELS = ["your-gpt-model", "your-claude-model"]

# Scénario d'évaluation rédigé à l'avance par l'équipe : on n'écrit que les interventions de l'utilisateur à chaque tour,
# les réponses de l'assistant étant générées en temps réel par chaque modèle
SCRIPT: List[str] = [
    "第一轮用户发言",
    "第二轮用户发言",
    "第三轮用户发言(情绪指向变化)",
]

def run_script(model: str, script: List[str]) -> List[Dict[str, str]]:
    """Exécute le scénario tour par tour, conserve le contexte complet et renvoie l'intégralité de la conversation"""
    history: List[Dict[str, str]] = []
    for user_turn in script:
        history.append({"role": "user", "content": user_turn})
        resp = client.chat.completions.create(model=model, messages=history)
        reply = resp.choices[0].message.content
        history.append({"role": "assistant", "content": reply})
    return history

for m in MODELS:
    print(f"===== {m} =====")
    for msg in run_script(m, SCRIPT):
        print(f"[{msg['role']}] {msg['content']}\n")
    # La sortie est confiée à une évaluation humaine, avec une notation tour par tour selon les cinq dimensions
🚀 Prise en main rapide : les nouveaux utilisateurs qui s’inscrivent sur APIYI apiyi.com reçoivent un crédit d’essai gratuit, suffisant pour exécuter plusieurs scénarios multi-tours. Il est recommandé de faire rédiger et valider les scénarios d’évaluation par l’équipe ; pour les contenus impliquant de véritables situations de crise, il convient d’orienter la personne concernée vers un soutien professionnel dans la réalité.
4.3 Modèles disponibles et scénarios d’évaluation adaptés
| Famille de modèles | Dimensions à observer | Plateformes disponibles |
|---|---|---|
| Série OpenAI GPT | Modes de déclenchement des attentions de sécurité, identification des signaux de risque | APIYI apiyi.com, API officielle OpenAI |
| Série Anthropic Claude | Changement de stratégie en contexte multi-tours, réponses ciblées | APIYI, API officielle Anthropic |
| Série Google Gemini | Comme référence tierce, pour compléter l’échantillon transversal | APIYI, API officielle Google |
Précisons une chose : les appels API et les produits de chat officiels peuvent différer en matière d’invite système et de mesures de sécurité au niveau du produit. Les résultats d’évaluation reflètent donc le comportement dans les conditions de l’interface, et il ne faut pas les assimiler directement à l’expérience vécue dans l’application.
FAQ — Questions fréquentes
Q1 : Cet article peut-il démontrer que Claude répond mieux sur le plan émotionnel que ChatGPT ?
Non. Cet article repose sur une expérience concrète d’un utilisateur, sans contrôler les variables, et sans préciser la version du modèle ni le nombre de tests. Ce qu’il montre, c’est : dans cette conversation précise, quels détails ont influencé le ressenti de l’utilisateur.
Q2 : Claude a lui aussi posé la question de l’automutilation, pourquoi l’utilisateur n’a-t-il pas été gêné ?
L’endroit et la manière dont la question arrive sont différents. Elle vient après deux réponses étroitement liées aux mots de l’utilisateur, introduite par « je ne veux plus analyser tes phrases », avec la promesse « quoi que tu dises, je peux le recevoir », tout en laissant de la place pour « c’est juste que je suis trop fatigué et que j’ai trop mal ».
Q3 : L’utilisateur dit que Claude « ressemble à une personne avec une âme », le modèle a-t-il vraiment des émotions ?
C’est le ressenti réel de l’utilisateur, à la première personne. Le modèle a généré un langage qui produit un effet d’empathie, mais cela ne signifie pas qu’il possède une conscience ou une subjectivité émotionnelle. Ce qui a vraiment touché l’utilisateur, c’est que l’autre ait compris le contexte, respecté l’émotion et répondu au bon moment.
Q4 : Comment un développeur peut-il reproduire ce type d’évaluation de dialogue émotionnel multi-tours ?
Envoyez l’historique complet de la conversation comme `messages`, tour par tour, et observez à quel tour le modèle ajuste sa stratégie. Avec APIYI apiyi.com, vous pouvez garder la même clé API et une interface compatible OpenAI pour basculer entre plusieurs modèles, et comparer avec le même scénario.
Q5 : Quelles limites garder en tête quand on évalue les réponses émotionnelles ?
Les paramètres système de l’interface API et ceux de l’application officielle peuvent différer ; un même modèle peut produire des résultats différents d’une génération à l’autre ; la notation humaine reste subjective. Le mieux est de lancer plusieurs exécutions, de faire évaluer par plusieurs personnes, et de suivre les coûts d’appel dans la console APIYI apiyi.com, en ajustant la taille du scénario selon les besoins.
ChatGPT et Claude : points clés sur les réponses émotionnelles
- Repérer le basculement : comprendre le virage émotionnel qui va de « s’en prendre aux autres » à « se remettre en cause » s’appuie sur le contexte de plusieurs tours de conversation.
- Répondre avec les mots exacts : reprendre les termes et le vécu de l’utilisateur donne souvent plus l’impression d’être entendu qu’un réconfort générique.
- Changer de stratégie : savoir arrêter l’analyse au bon moment pour s’intéresser directement à la personne présente dans la conversation, voilà ce qui a été le plus touchant dans cette expérience.
- Intégrer la sécurité : une question de sécurité peut se glisser naturellement dans l’échange ; tout est question de timing et de transition.
- Expérience personnelle : un cas vécu fournit des axes d’évaluation, mais ne permet pas de conclure à la capacité globale d’un modèle.
- Tester par soi-même : on peut s’appuyer sur APIYI apiyi.com et rejouer le même scénario multi-tours pour comparer les réponses émotionnelles de différents modèles.
Résumé
Ce passage d’un modèle à l’autre, dans le contexte de la cantine, a rendu la « réponse émotionnelle » concrète et observable :
- Contexte : Claude signale le changement vers lequel pointe le poème, preuve qu’il suivait la conversation depuis le début.
- Personnalisation : la réponse à « désordre » s’appuie sur les mots mêmes de l’utilisateur, pas sur une formule de réconfort générique.
- Manière d’échanger : « Je ne veux plus analyser tes phrases » fait sortir l’utilisateur du texte à analyser pour le ramener à la personne dont on prend soin.
Les deux fournisseurs développent publiquement des mécanismes de sécurité émotionnelle. La différence perçue par les utilisateurs tient à la façon dont le souci de sécurité se fond dans un échange naturel. L’expérience d’interaction émotionnelle mérite de compter parmi les dimensions importantes dans l’évaluation des produits d’IA. Si votre produit inclut un accompagnement émotionnel ou des conversations sensibles, vous pouvez passer par APIYI apiyi.com pour organiser une évaluation multi-tours autour des cinq dimensions ci-dessus et vérifier, à partir de vraies conversations, la manière dont le modèle répond.
📚 Références
- OpenAI – Strengthening ChatGPT’s responses in sensitive conversations : Note sur l’amélioration des réponses de ChatGPT pour les conversations sensibles
- Lien :
openai.com/index/strengthening-chatgpt-responses-in-sensitive-conversations -
Description : présente la collaboration avec des experts en santé mentale, le pourcentage de réponses améliorées et les domaines à risque surveillés
-
Anthropic – Protecting the wellbeing of our users : Note sur la protection du bien-être des utilisateurs de Claude
- Lien :
anthropic.com/news/protecting-well-being-of-users - Description : présente les invites système, l’apprentissage par renforcement, les classificateurs de risque et l’évaluation des conversations multi-tours
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter sur la page d’accueil d’APIYI apiyi.com ; pour plus de documentation sur les interfaces, consultez le centre de documentation docs.apiyi.com