Note de l’auteur : cet article compare Gemini 4 Carbon et Claude Opus 5.5 selon 7 dimensions (spécifications, prix, mécanisme de réflexion, protocole et scores des fiches de modèle officielles), puis propose des recommandations du type « quelle tâche confier à quel modèle ».
Commençons par la conclusion : la recherche en contexte long, le raisonnement scientifique et les tâches d’ingénierie multi-étapes de longue haleine reviennent à Gemini 4 Carbon. Le contrôle d’ordinateur, l’automatisation du bureau et les workflows déjà branchés sur le protocole messages d’Anthropic reviennent à Claude Opus 5.5. Aucun des deux n’est « globalement meilleur » : tout dépend du type de tâche.
Ce n’est pas une analyse qui renvoie les deux modèles dos à dos. Tous les scores cités ici proviennent des fiches de modèle officielles et de la documentation des éditeurs, et sont signalés comme auto-déclarés par l’éditeur. Pour les prix, nous indiquons à la fois le tarif officiel et le tarif d’APIYI au 2026-11-11, pour que vous puissiez comparer directement.
Ce que vous y gagnez : en lisant cette comparaison entre Gemini 4 Carbon et Claude Opus 5.5, vous repartez avec un tableau comparatif utilisable tel quel pour votre choix, et vous comprendrez pourquoi un prix unitaire plus bas pour Carbon ne garantit pas forcément une facture plus basse.
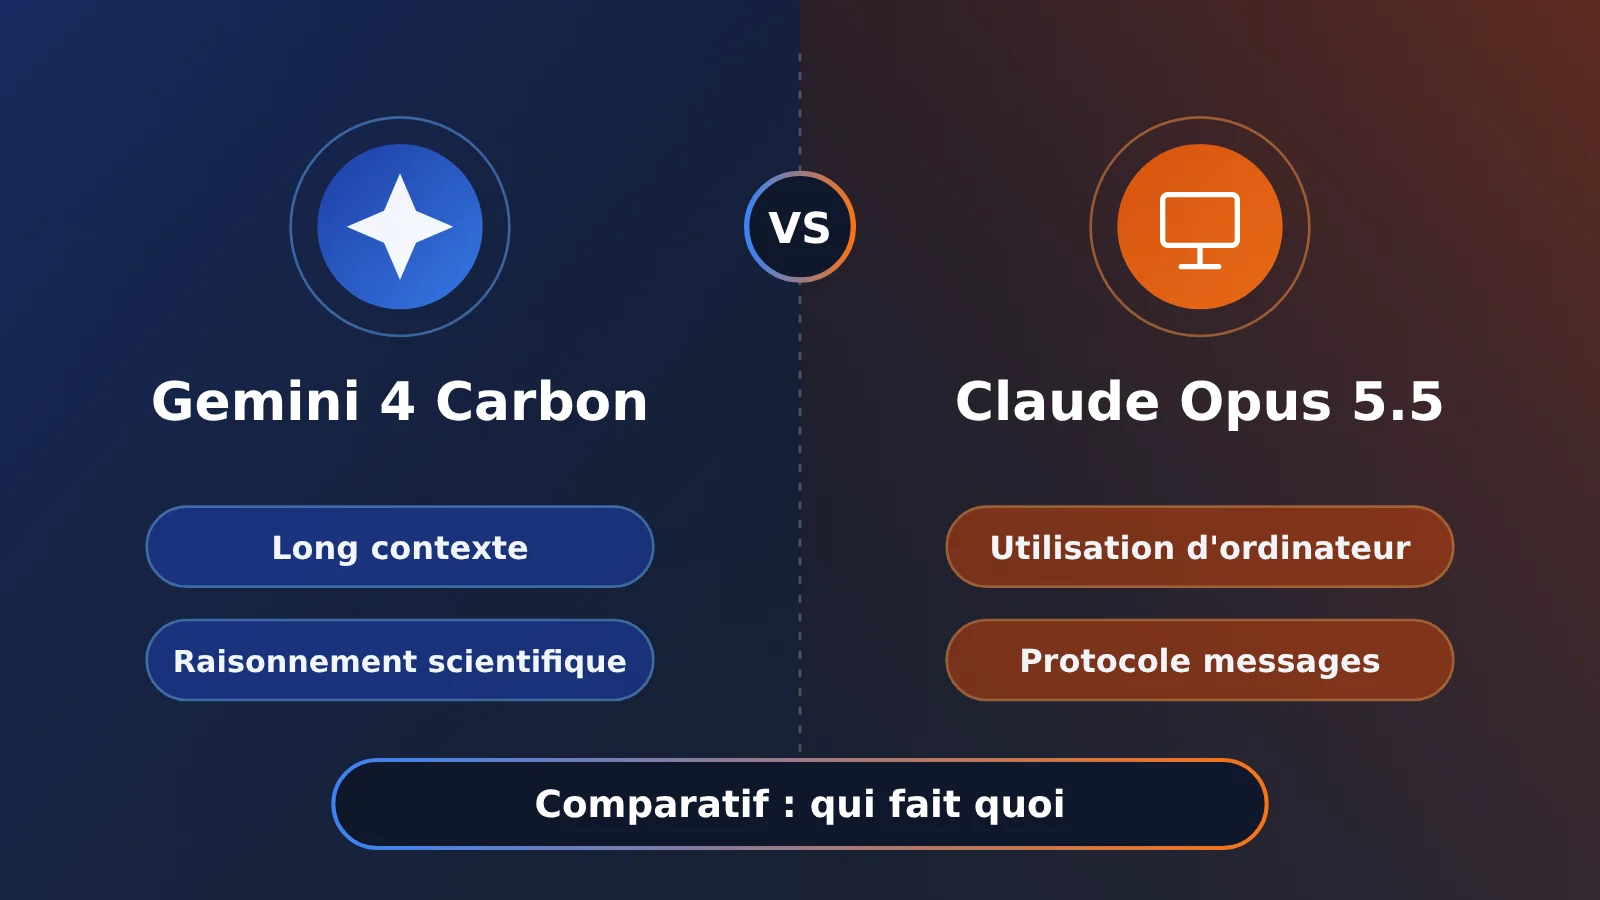
Gemini 4 Carbon vs Claude Opus 5.5 : les principales différences
Ces deux modèles sont des modèles phares sortis au second semestre 2026. Claude Opus 5.5 a été publié par Anthropic le 22/09/2026. Gemini 4 Carbon a été annoncé pour la première fois le 28/10/2026 : il n’était alors accessible qu’aux équipes de cyberdéfense vérifiées via le Fairwind Program, et ce n’est que le 10/11/2026 qu’il est devenu disponible en GA pour les développeurs payants et les entreprises.
Google positionne Carbon très clairement : il repose sur Gemini 4 Argon et se concentre sur les tâches qui poussent l’intelligence dans ses derniers retranchements, comme le codage et le débogage complexes en plusieurs étapes ou la recherche scientifique ouverte. Il consomme davantage de thinking tokens qu’Argon, explore chaque hypothèse l’une après l’autre et fait tourner plus longtemps ses boucles de vérification. Opus 5.5, de son côté, brille par sa réflexion adaptative, ses grandes sorties de 128K et sa capacité à contrôler un ordinateur. Les deux modèles sont déjà disponibles sur APIYI (apiyi.com), et vous pouvez basculer de l’un à l’autre avec la même clé.
Comparatif des spécifications : Gemini 4 Carbon et Claude Opus 5.5
| Critère | Gemini 4 Carbon | Claude Opus 5.5 |
|---|---|---|
| ID du modèle | gemini-4-carbon |
claude-opus-5-5 |
| Date de sortie | Annoncé le 28/10/2026, GA le 10/11/2026 | 22/09/2026 |
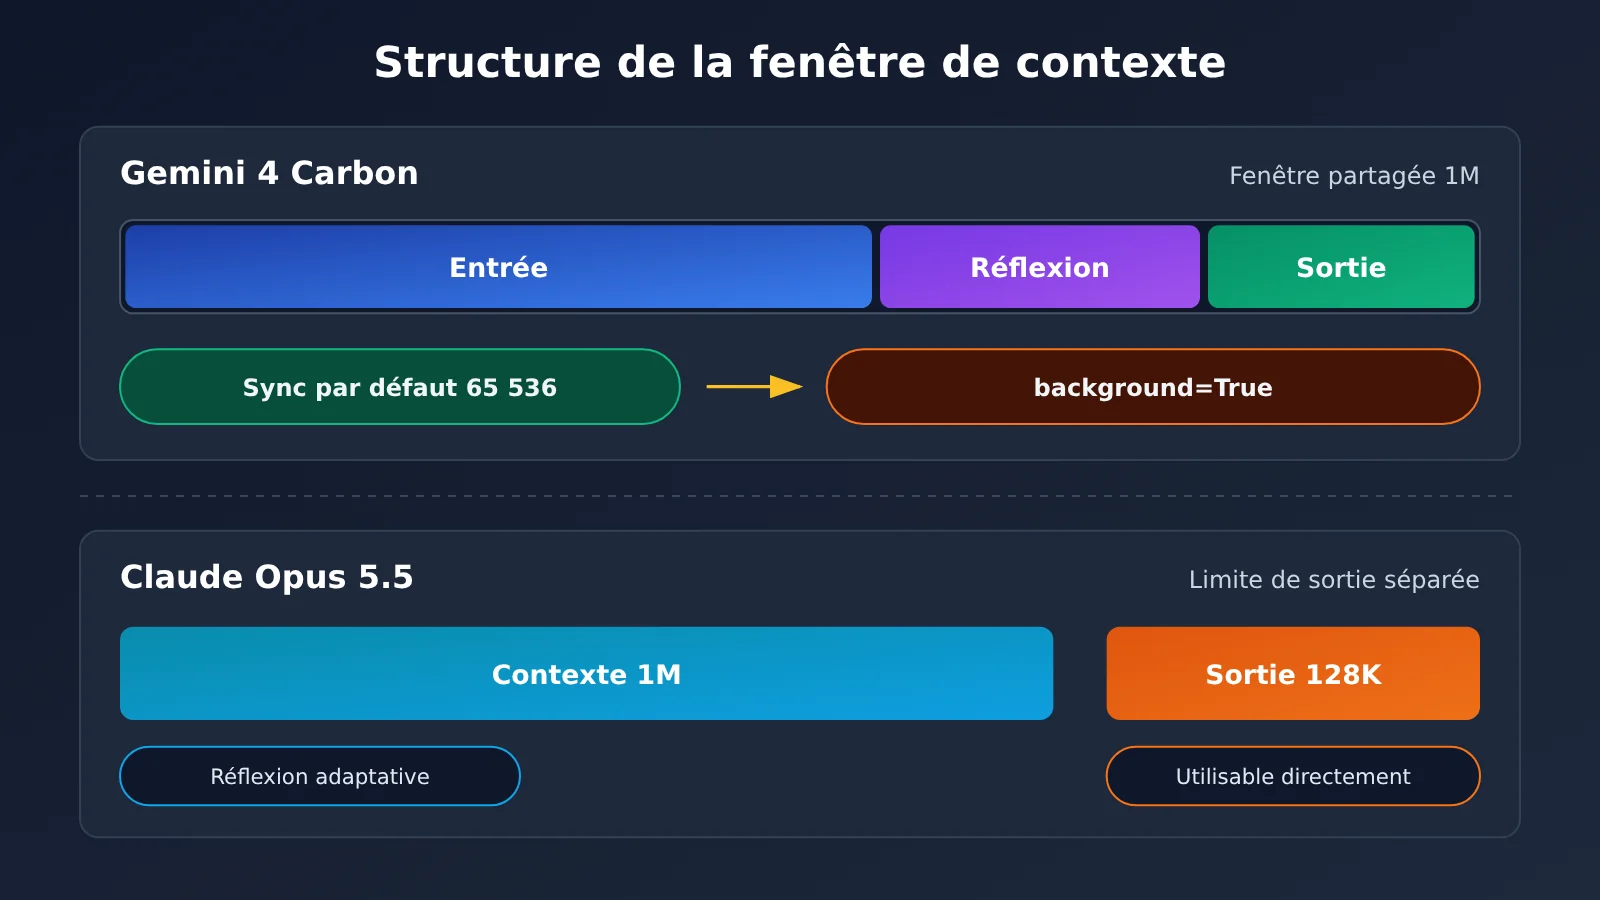
| Contexte | 1M, une seule fenêtre partagée entre entrée, réflexion et sortie | 1M |
| Limite de sortie | 65 536 par défaut en synchrone ; extensible en mode arrière-plan, en partageant le 1M avec l’entrée | 128K |
| Contrôle de la réflexion | thinking_level : low / medium / high, medium par défaut |
Réflexion adaptative non désactivable, effort par défaut : medium |
| Date limite des connaissances | March 2026 (parfois plus tôt selon les domaines) | Date limite fiable : June 2026 |
| Modalités d’entrée | Texte, image, audio, vidéo | Se référer à la documentation officielle |
| Modalités de sortie | Texte (pas de génération d’images ni de vidéos) | Texte |
Ce tableau cache deux pièges. Le premier concerne la limite de sortie : le 1M de Carbon est une fenêtre partagée, et une requête synchrone par défaut ne produit au maximum que 65 536 tokens. Si vous avez besoin d’une sortie plus longue, il faut passer background=True sur l’Interactions API et monter max_output_tokens au-delà de 65536, tout en gardant une marge pour la réflexion, sinon la réponse risque d’être tronquée. Chez Opus 5.5, les 128K sont directement utilisables.
Le second piège, c’est le mécanisme de réflexion. Les trois niveaux de Carbon se règlent selon la tâche : low convient à la classification, au routage et à l’extraction ciblée ; medium, le niveau par défaut, équilibre vitesse, coût et justesse du premier coup ; high est adapté à l’analyse de cause racine sur plusieurs fichiers, aux mathématiques formelles et à la conception d’architecture en amont. La réflexion adaptative d’Opus 5.5 ne peut pas être coupée, on peut seulement ajuster l’effort. Si votre application exige un mode à faible latence « sans aucune réflexion », aucun de ces deux modèles phares n’est le meilleur choix.
Gemini 4 Carbon vs Claude Opus 5.5 : prix et facturation
Si on ne regarde que le prix unitaire, Carbon est nettement moins cher. Mais son tarif bas sur le canal officiel est un prix promotionnel, et il consomme aussi davantage de tokens de réflexion. L’écart de prix unitaire ne se traduit donc pas directement en écart de facture.
Prix officiels et tarifs affichés sur APIYI
Les montants sont en dollars US par million de tokens. Les tarifs APIYI sont ceux du groupe par défaut au 2026-11-11, sans remise appliquée.
| Poste de prix | Carbon officiel (jusqu’au 30/11, global) | Carbon officiel (à partir du 01/12, global) | Opus 5.5 officiel | APIYI gemini-4-carbon |
APIYI claude-opus-5-5 |
|---|---|---|---|---|---|
| Entrée | 2 | 4.00 | 4 | 2 | 4 |
| Sortie (raisonnement inclus) | 10 | 20.00 | 20 | 10 | 20 |
| Lecture du cache | 0.10 | 0.20 | 0.20 | 0.10 | 0.20 |
| Écriture du cache | Cache implicite, pas de tarification séparée | Idem | 5 min : 5 / 1 h : 8 | Pas de multiplicateur d’écriture de cache dédié | 5 (multiplicateur 1.25) |
| Groupes disponibles | — | — | — | default, svip | ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default, svip |
Quelques précisions sur les tarifs officiels. Pendant la période promotionnelle, les points de terminaison Carbon hors zone globale sont facturés 2.20 / 0.11 / 11. Gemini 4 Carbon Cyber Permissive n’est pas concerné par la promotion et est facturé directement 4 / 0.20 / 20. Le Fast mode d’Opus 5.5 coûte 8 en entrée et 40 en sortie, et l’inférence exclusivement aux États-Unis ajoute un multiplicateur de 1.1.
Les multiplicateurs de chaque groupe APIYI s’appliquent en plus. Pour Opus, le groupe ClaudeCode est à 0.95, ClaudeCodeReverse à 0.5, ClaudeOfficial à 1.2, et default comme svip à 1. Carbon n’a que deux groupes, default et svip, tous deux à 1. Les recharges se font à un taux de change fixe de 1:7, cumulable avec les bonus de recharge et les remises par groupe. Le montant réellement débité est celui affiché dans la console. Les modèles et les prix sont ceux de la liste des modèles sur apiyi.com. Si le tableau récapitulatif de la documentation n’affiche pas encore la ligne Carbon, fiez-vous à la console et à l’interface de tarification.
Pourquoi un écart de prix unitaire n’est pas un écart de facture
Le coût d’une requête est à peu près : tokens d’entrée × prix d’entrée + (tokens de réflexion + tokens de réponse) × prix de sortie. Le prix de sortie de Carbon est la moitié de celui d’Opus, mais Google indique clairement que Carbon dépense plus de tokens de réflexion qu’Argon pour exécuter ses boucles de vérification. Sur une même tâche, dès que le total « réflexion + réponse » de Carbon dépasse le double de celui d’Opus, la partie sortie de la facture devient plus élevée pour Carbon.
Sur le canal officiel, à partir du 1er décembre, Carbon et Opus auront exactement le même prix unitaire. Ce sera alors le modèle qui consomme le moins de tokens qui aura la facture la plus basse. Anthropic avance aussi son propre argument d’économie : selon ses chiffres, Opus 5.5 réalise le même travail qu’Opus 5 avec environ 40 % de tokens facturés en moins. C’est une déclaration du fournisseur, pas une expérience comparative entre les deux modèles. Le plus sûr est de lancer chacun des deux sur un lot de vos propres tâches réelles et de regarder les débits effectifs dans la console.
Le mécanisme de cache diffère aussi. Carbon active par défaut le cache implicite, et les entrées en cache bénéficient d’une remise de 95 %. Le guide du développeur précise qu’il ne faut plus créer ni transmettre de cached_content explicite. Chez Opus, le cache doit être écrit : 5 dollars pour une écriture de 5 minutes, ce qui convient bien aux appels répétés avec une longue invite système (system prompt) fixe.
Gemini 4 Carbon face à Claude Opus 5.5 : scores des fiches de modèle officielles
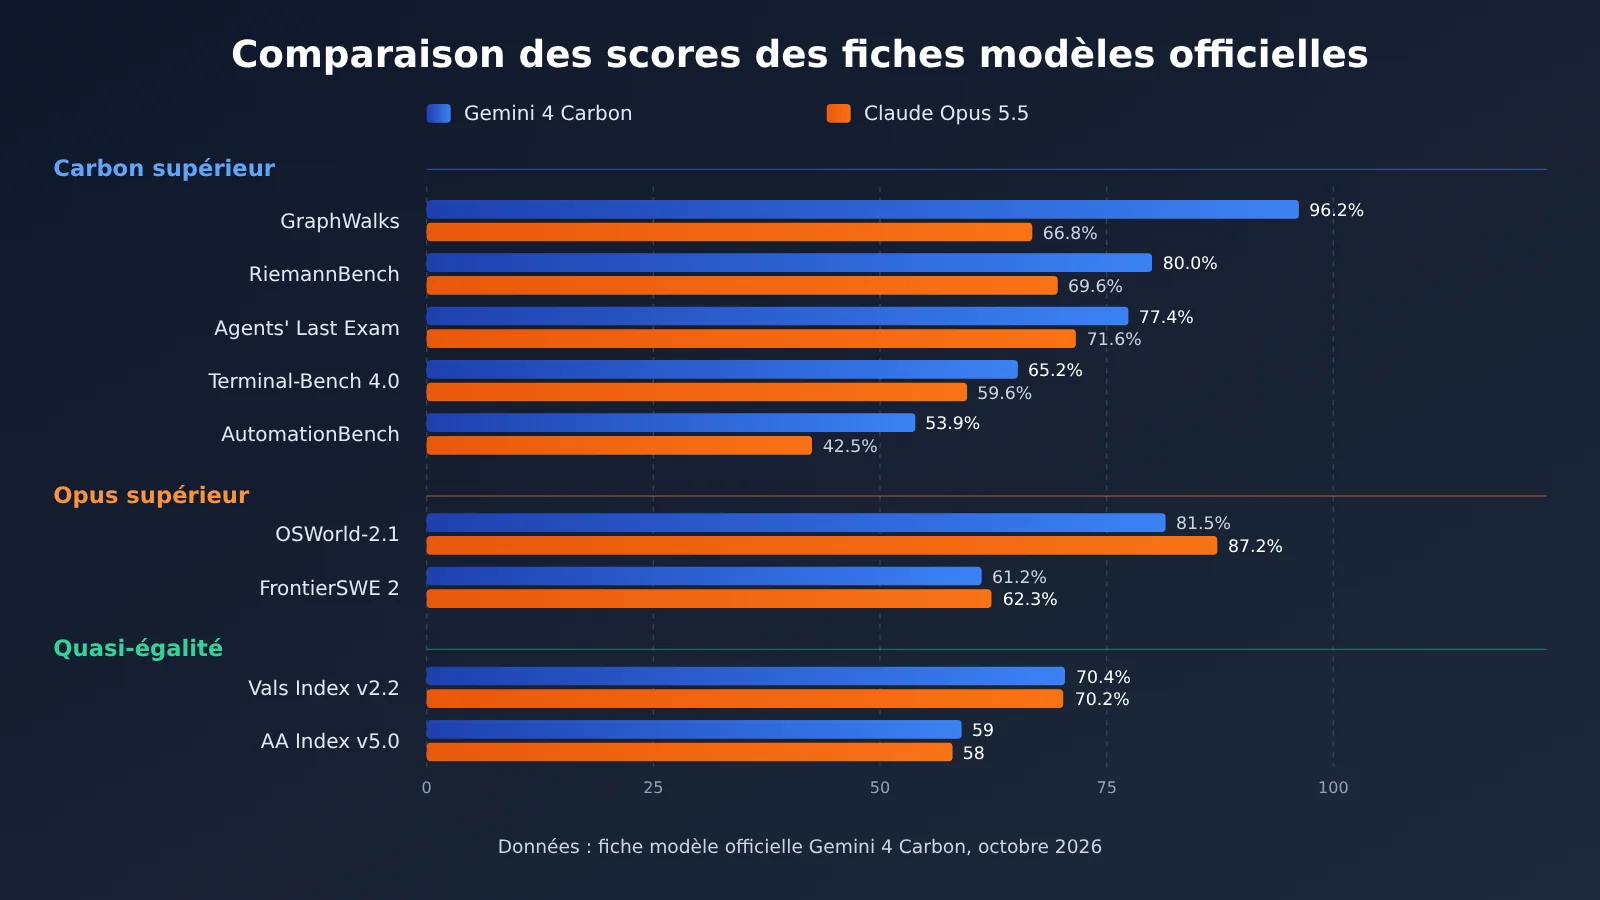
Toutes les données du tableau ci-dessous proviennent de la fiche de modèle officielle de Gemini 4 Carbon publiée par Google. Les résultats sont arrêtés à octobre 2026 et sont auto-déclarés. Les chiffres de Opus 5.5 sont eux aussi tirés de cette fiche : il ne s’agit pas de tests indépendants réalisés par Anthropic.
| Benchmark (fiche de modèle officielle) | Gemini 4 Carbon | Claude Opus 5.5 | Conclusion |
|---|---|---|---|
| OSWorld-2.1, sous-ensemble hors ligne (utilisation de l’ordinateur) | 81,5 % | 87,2 % | Opus devant, et c’est le score le plus élevé du tableau |
| FrontierSWE 2 | 61,2 % | 62,3 % | Opus légèrement devant ; les deux restent sous les 65,5 % de GPT-6 Astra |
| Vals Index v2.2 | 70,4 % | 70,2 % | Quasi à égalité |
| AA Index v5.0 | 59 | 58 | Quasi à égalité |
| SWE-sweep | 9,6 % | 3,6 % | Carbon devant |
| Terminal-Bench 4.0 (AA) | 65,2 % | 59,6 % | Carbon devant |
| Agents’ Last Exam v1.1 | 77,4 % | 71,6 % | Carbon devant |
| AutomationBench (Zapier) | 53,9 % | 42,5 % | Carbon devant |
| GraphWalks 256k–1M BFS (F1) | 96,2 % | 66,8 % | Carbon nettement devant (contexte long) |
| RiemannBench | 80,0 % | 69,6 % | Carbon devant (raisonnement scientifique) |
| Terminal-Bench-Science 0.1 (AA) | 64,8 % | 59,0 % | Carbon devant |
| Chartography | 72,5 % | 66,3 % | Carbon devant |
Ce tableau permet de tirer trois enseignements. D’abord, le contexte long et le raisonnement scientifique sont les domaines où Carbon creuse le plus l’écart : sur GraphWalks, la différence approche les 30 points de pourcentage. Si vos tâches demandent de la recherche multi-sauts dans des documents de plusieurs centaines de milliers de tokens, c’est le critère le plus pertinent pour vous.
Ensuite, l’utilisation de l’ordinateur est le terrain de Opus 5.5. Sur le sous-ensemble hors ligne d’OSWorld-2.1, Opus devance Carbon d’environ 6 points. Pour un agent de bureau, de la navigation web ou de l’automatisation d’interface graphique, Carbon n’est pas le premier sur ce critère.
Enfin, sur les tâches de génie logiciel dans des dépôts publics, aucun des deux n’arrive en tête. Sur FrontierSWE 2, GPT-6 Astra est premier, Opus deuxième et Carbon troisième, avec des écarts modestes. Sur SWE-sweep, les 9,6 % de Carbon dépassent les 3,6 % de Opus, mais la valeur absolue reste très basse, et le score est quasiment à égalité avec les 9,5 % d’Astra : inutile d’y voir un avantage d’un ordre de grandeur.
La fiche de modèle contient aussi trois résultats en cybersécurité : CWE-bench, ExploitGym et SEC-bench Pro. Ils correspondent toutefois à des performances obtenues dans le cadre du Fairwind Program, et le communiqué de lancement du 28 octobre précise qu’ils ont été évalués sans garde-fous. L’API payante ne donne pas accès par défaut à des capacités équivalentes : il ne faut donc pas s’appuyer sur ces trois critères pour choisir un modèle de programmation au quotidien.
Gemini 4 Carbon ou Claude Opus 5.5 : lequel choisir selon le cas d’usage ?
Quand choisir Gemini 4 Carbon
- Recherche et synthèse sur de très gros corpus : bases réglementaires, dépôts de code entiers, longs documents de recherche avec questions à plusieurs sauts. Vous profitez à plein de la fenêtre partagée de 1M et de l’avance du modèle sur GraphWalks.
- Raisonnement scientifique et mathématiques formelles : Carbon est en tête sur RiemannBench et Terminal-Bench-Science. Réglez
thinking_levelsur high pour que le modèle vérifie ses résultats en profondeur. - Ingénierie multi-étapes de longue haleine et audit d’architecture : Google recommande, dans le
/swarmd’Antigravity, de confier à Carbon les rôles qui demandent le raisonnement le plus poussé (architecture, coordination, audit), et de déléguer les tranches d’implémentation parallèles àgemini-4-argonougemini-3.8-flash. - Documents multimodaux : le modèle accepte en entrée du texte, des images, de l’audio et de la vidéo, et obtient un meilleur score sur Chartography. Il convient bien à l’analyse de rapports riches en graphiques.
Quand choisir Claude Opus 5.5
- Utilisation de l’ordinateur et agents de bureau : c’est le meilleur score du tableau sur OSWorld-2.1, donc le premier choix pour l’automatisation d’interfaces graphiques.
- Workflows déjà basés sur Claude Code ou le protocole messages : pas besoin de changer de protocole, il suffit de remplacer l’identifiant du modèle.
- Besoin de très longues sorties en un seul appel : la limite de sortie de 128K est directement exploitable, alors qu’avec Carbon il faut passer en mode arrière-plan.
- Besoin de connaissances plus récentes : la date limite fiable des connaissances est juin 2026, soit trois mois après celle de Carbon (mars 2026).
Quand aucun des deux n’est le meilleur choix
Pour le développement de fonctionnalités au quotidien et le code interactif, Google recommande de rester sur Gemini 4 Argon. Son prix unitaire est identique à celui de Carbon, mais il consomme moins de tokens et réagit plus vite. Si vous utilisez déjà l’API Responses et que vous avez besoin de 1,05M de contexte et d’un raisonnement au niveau max, GPT-6 Astra est une option. Attention toutefois : son tarif affiché est environ 5 fois celui de Carbon en promotion (10/50 contre 2/10), et une majoration par paliers s’applique au-delà de 272K tokens en entrée.
Gemini 4 Carbon vs Claude Opus 5.5 : comment les intégrer
Les différences de protocole pèsent souvent plus lourd dans la charge de travail d’ingénierie que les écarts de score. Opus 5.5 fonctionne nativement avec le protocole Anthropic messages ; Carbon passe par le protocole natif Gemini ou par l’API chat completions compatible OpenAI, mais pas par Anthropic messages.
| Critère d’intégration | Gemini 4 Carbon | Claude Opus 5.5 |
|---|---|---|
| Protocole natif | Gemini natif (/v1beta) | Anthropic messages |
| Points d’accès APIYI | gemini, openai (/v1/chat/completions) | anthropic (messages), openai (chat) |
| Paramètre de réflexion | thinking_level ; thinking_budget est obsolète |
effort, la réflexion ne peut pas être désactivée |
| Paramètres d’échantillonnage | temperature, top_p et top_k personnalisés sont ignorés avec un avertissement | À configurer selon la documentation Anthropic |
| Délai d’expiration conseillé | Les problèmes difficiles peuvent prendre plusieurs minutes : réglez le timeout client à 15–20 minutes minimum, ou utilisez background=True |
Réglages habituels pour les tâches longues |
Passer d’un modèle à l’autre via l’interface compatible OpenAI
Si vous voulez tester les deux modèles avec un seul et même code, le plus simple est de passer par l’interface compatible OpenAI. Voici comment faire :
- Créez une clé API dans la console, en choisissant le groupe default ou svip (ces deux groupes couvrent les deux modèles).
- Dans le SDK OpenAI, définissez
base_urlsurhttps://api.apiyi.com/v1et renseignez votre clé dansapi_key. - Lors de l’appel à chat completions, réglez
modelsurgemini-4-carbonouclaude-opus-5-5selon le cas, sans toucher à la structure des messages. - Pour tester Carbon, retirez les paramètres d’échantillonnage comme temperature et portez le timeout client à plus de 15 minutes.
- Comparez dans la console la consommation de tokens et la facturation réelle des deux modèles, plutôt que de vous limiter au prix unitaire.
Si votre projet utilise déjà Claude Code ou le SDK Anthropic, Opus 5.5 peut simplement continuer à passer par le point d’accès messages. Si vous avez besoin d’un groupe dédié à Claude Code, choisissez ClaudeCode ou ClaudeOfficial.
🚀 Conseil pour démarrer vite : commencez par l’interface compatible OpenAI d’APIYI (apiyi.com) et envoyez le même lot de tâches réelles aux deux modèles, puis comparez la qualité des sorties et la facturation dans la console. Une fois la répartition des rôles claire, vous pourrez décider si Opus doit revenir au protocole natif messages.
Gemini 4 Carbon face à Claude Opus 5.5 : quel choix faire ?
Voici tout ce qui précède condensé dans un tableau de décision :
| Votre tâche principale | Recommandation | Justification clé |
|---|---|---|
| Recherche en contexte long (1M) et synthèse multi-sauts | Gemini 4 Carbon | GraphWalks : 96,2 % contre 66,8 % (fiche modèle officielle) |
| Raisonnement scientifique, mathématiques formelles | Gemini 4 Carbon | Meilleurs résultats sur RiemannBench et Terminal-Bench-Science |
| Utilisation de l’ordinateur, agents desktop/navigateur | Claude Opus 5.5 | OSWorld-2.1 : 87,2 % contre 81,5 % |
| Workflows existants basés sur messages / Claude Code | Claude Opus 5.5 | Protocole natif, 128K en sortie |
| Génie logiciel sur dépôts publics | Les deux sont proches, Astra est à considérer | Sur FrontierSWE 2, Astra est en tête, Opus devançant légèrement Carbon |
| Développement au quotidien, codage interactif | Gemini 4 Argon | Même prix que Carbon, consomme moins de tokens, plus rapide |
| Travail de connaissance généraliste | Les deux conviennent, choisissez selon le coût | Vals Index : 70,4 % contre 70,2 %, quasi-égalité |
💡 Notre conseil : la plupart des équipes n’ont pas besoin de trancher entre les deux. Vous pouvez router les requêtes selon le type de tâche : le contexte long et la recherche scientifique vers Carbon, les opérations d’interface graphique et les workflows messages vers Opus. Les deux modèles sont disponibles dans les groupes default et svip d’APIYI (apiyi.com) : pour router, il suffit de modifier le champ
model.
Un dernier point à garder en tête : les capacités de cybersécurité spécialisées côté défense passent par le programme Fairwind. Remplacer le nom du modèle par gemini-4-carbon ne donne pas accès à la version Cyber Permissive, et celle-ci n’est de toute façon pas éligible au tarif promotionnel de 2 dollars sur les canaux officiels.
Questions fréquentes (FAQ)
Q1 : Gemini 4 Carbon ou Claude Opus 5.5, lequel est le plus fort ?
Aucun des deux ne domine sur tous les plans. D’après les fiches officielles des modèles (état au mois d’octobre 2026), Carbon fait mieux sur le contexte long, le raisonnement scientifique et les tâches en terminal ; Opus 5.5 est devant sur OSWorld (contrôle de l’ordinateur) et sur FrontierSWE 2. Sur le Vals Index et l’AA Index, les deux modèles sont presque à égalité.
Q2 : Carbon coûte deux fois moins cher qu’Opus, est-ce forcément plus économique ?
Pas forcément. Carbon consomme davantage de tokens de réflexion, et ces tokens sont facturés au tarif de sortie. Le prix promotionnel de 2 dollars sur le canal officiel ne court que jusqu’au 30/11/2026 ; à partir du 1er décembre, il s’aligne sur celui d’Opus. Pour connaître le coût réel, le mieux est de comparer la facturation effective sur une même tâche.
Q3 : Quand pourra-t-on utiliser les deux modèles via l’API ?
Opus 5.5 est sorti le 22/09/2026. Carbon a été annoncé pour la première fois le 28/10/2026, et réservé dans un premier temps aux défenseurs du programme Fairwind ; depuis le 10/11/2026, l’API Gemini est en disponibilité générale (GA) pour les développeurs payants et les entreprises. Pour les offres gratuites et les formules grand public d’entrée de gamme, aucune date n’a été communiquée officiellement.
Q4 : Peut-on appeler Carbon avec le protocole messages d’Anthropic ?
Non. Carbon passe par le protocole natif de Gemini ou par les chat completions compatibles OpenAI. Si votre code repose sur le SDK Anthropic, il faudra passer au SDK OpenAI ou au SDK Gemini pour intégrer Carbon. Opus 5.5, lui, prend en charge à la fois les endpoints messages et chat.
Q5 : Comment comparer rapidement les deux modèles sur mes propres cas d’usage ?
Inscrivez-vous sur APIYI (apiyi.com) et créez une clé API dans le groupe default. Pointez ensuite le SDK OpenAI vers l’interface `/v1`, puis définissez `model` sur `gemini-4-carbon` et sur `claude-opus-5-5` pour exécuter le même lot de tâches avec chacun. Les nouveaux utilisateurs disposent d’un crédit de test gratuit, largement suffisant pour une comparaison à petite échelle.
Q6 : Pourquoi la sortie de Carbon est-elle tronquée ?
Par défaut, la limite de sortie d’une requête synchrone est de 65 536 tokens, et les tokens de réflexion comptent dans ce budget. Si vous avez besoin d’une sortie plus longue, activez `background=True` sur l’API Interactions et augmentez `max_output_tokens`, en gardant une marge pour la réflexion.
Q7 : Quelles sont les limites connues de chaque modèle ?
La fiche de Carbon mentionne des hallucinations, une résistance au jailbreak encore en cours de renforcement, des ralentissements ou des délais d’attente dépassés occasionnels, et une consommation de tokens plus élevée en mode de réflexion poussée ; sa date limite de connaissances est aussi plus ancienne (mars 2026). Chez Opus 5.5, la réflexion ne peut pas être désactivée, ce qui le rend moins adapté aux scénarios à faible latence ; il reste également derrière Carbon sur les benchmarks de contexte long et de sciences de la fiche du modèle.
Gemini 4 Carbon vs Claude Opus 5.5 : l’essentiel à retenir
- Contexte long et raisonnement scientifique : choisissez Carbon. Il domine nettement sur GraphWalks, RiemannBench et d’autres benchmarks issus des fiches officielles des modèles.
- Pilotage d’ordinateur : choisissez Opus 5.5. Il atteint 87,2 % sur le sous-ensemble hors ligne d’OSWorld-2.1, le meilleur score du tableau.
- Génie logiciel : les deux sont au coude-à-coude. Sur FrontierSWE 2, Opus est un peu devant, et Astra obtient le meilleur score. Sur SWE-sweep, Carbon fait mieux.
- Prix unitaire ne veut pas dire facture finale. Carbon consomme davantage de tokens de réflexion, et son tarif promotionnel officiel s’arrête le 30 novembre.
- Le protocole détermine le coût de migration. Opus passe par l’API messages, tandis que Carbon passe par l’API native Gemini ou par une interface compatible OpenAI.
- Sortie et réflexion fonctionnent différemment. Opus propose 128K tokens en sortie et sa réflexion ne peut pas être désactivée. Carbon sort 65 536 tokens par défaut et offre trois niveaux de
thinking_level.
Conclusion
Entre Gemini 4 Carbon et Claude Opus 5.5, la vraie question n’est pas « qui gagne ? », mais « qui fait quoi ? » :
- Carbon prend en charge la réflexion la plus poussée : contexte long, raisonnement scientifique, architecture et audit. En contrepartie, il consomme plus de tokens de réflexion.
- Opus 5.5 s’occupe de l’action et de la compatibilité : pilotage d’ordinateur, workflows basés sur messages, grande sortie jusqu’à 128K.
- Pour la facture, regardez la consommation réelle : pendant la promotion, Carbon a l’avantage côté prix unitaire, mais le montant final dépend du volume total de tokens.
Je vous conseille de faire d’abord un petit test de routage par type de tâche, puis de choisir votre modèle principal. Avec APIYI (apiyi.com), une seule clé API suffit pour invoquer les deux modèles, avec une facturation à l’usage : pratique pour comparer et basculer de l’un à l’autre.
📚 Références
- Blog Google – Annonce d’ouverture de Gemini 4 Carbon : ouvert aux développeurs payants le 10/11/2026
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available -
Description : périmètre d’ouverture et évaluations officielles auto-déclarées ajoutées en novembre
-
Fiche modèle officielle de Gemini 4 Carbon : résultats des benchmarks arrêtés à octobre 2026
- Lien :
deepmind.google/models/model-cards/gemini-4-carbon/ -
Description : source de tous les scores cités dans cet article, avec les limites connues
-
Guide développeur de Gemini 4 Carbon : thinking_level, fenêtre partagée de 1M et précautions de migration
- Lien :
aistudio.google.com/learn/gemini-4-carbon-developer-guide -
Description : mode background, délais d’expiration et configuration du cache implicite
-
Tarifs des modèles Google Cloud : prix promotionnel de Carbon et tarif standard à partir du 1er décembre
- Lien :
cloud.google.com/model-garden/pricing -
Description : prix des points de terminaison globaux et non globaux
-
Documentation officielle de Claude Opus 5.5 : spécifications, mécanisme de réflexion et tarifs
- Lien :
platform.claude.com/docs/en/models/opus-5-5/overview -
Description : sortie de 128K, date limite des connaissances et prix d’écriture en cache
-
Tableau général des modèles APIYI : modèles de la plateforme et prix affichés par défaut
- Lien :
docs.apiyi.com/models -
Description : si la page n’a pas encore été actualisée, référez-vous à la console
-
Interface de tarification APIYI : multiplicateurs en temps réel et informations sur les groupes
- Lien :
api.apiyi.com/api/pricing - Description : source des données de prix affichés le 11/11/2026 dans cet article
Auteur : l’équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI ; vous trouverez plus de ressources dans le centre de documentation docs.apiyi.com