Note de l’auteur : à partir des résultats et des limites officiels, voici ce qui fait la force de Claude Fable 5.2, jusqu’où il faut aller et dans quels cas il vaut mieux ne pas remplacer Opus 5.5.
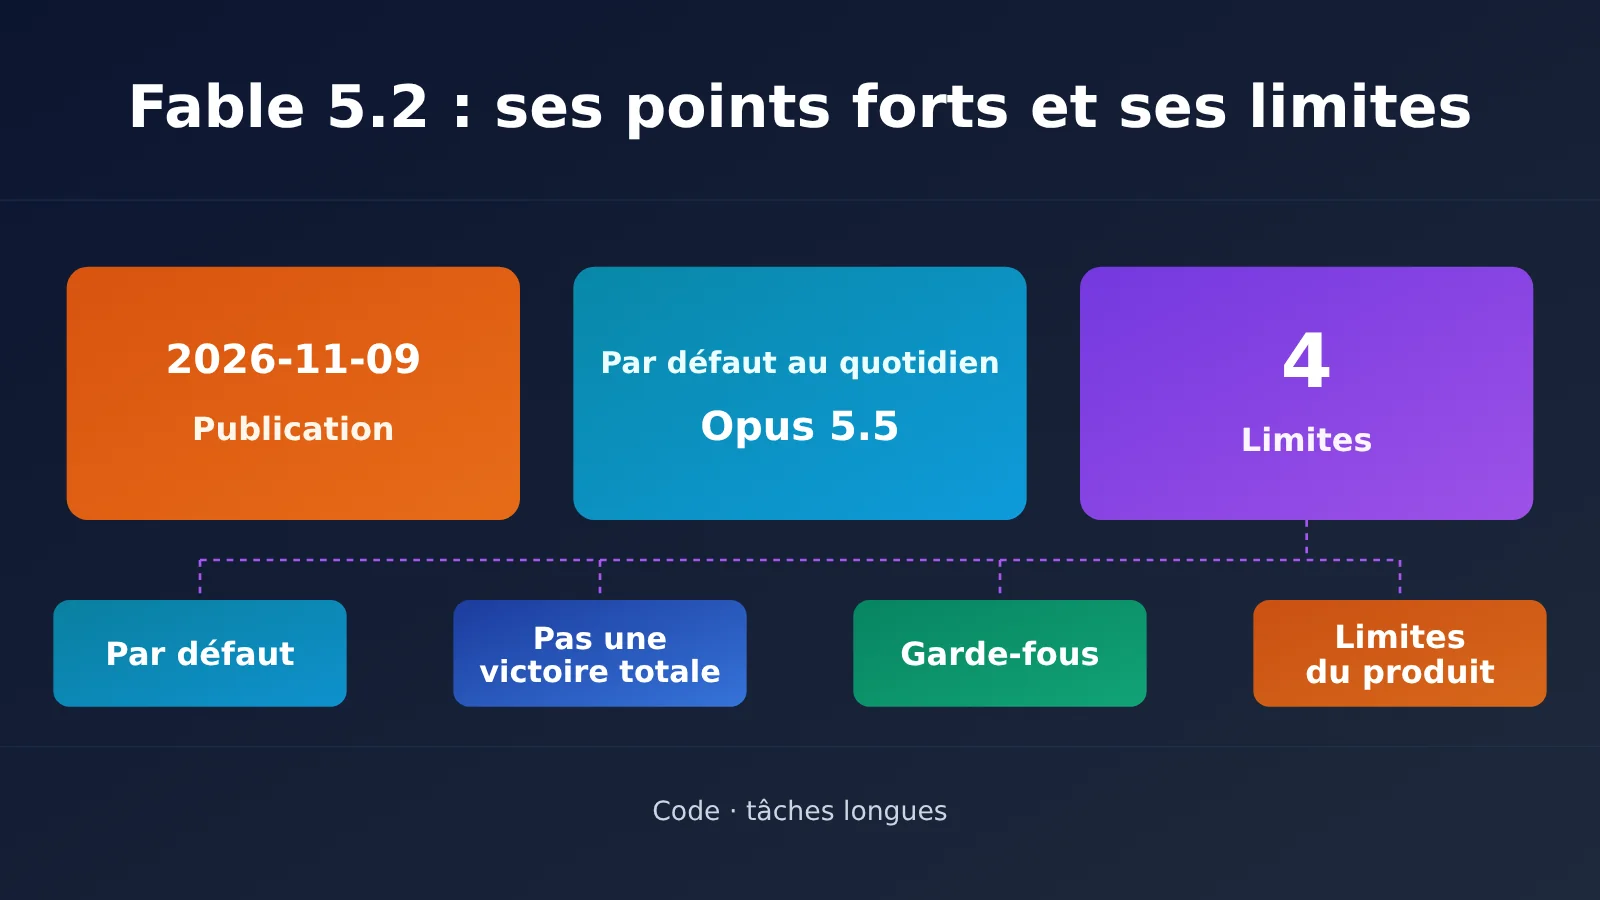
Claude Fable 5.2 est le modèle phare pour les tâches techniques lancé par Anthropic le 2026-11-09. Anthropic recommande de continuer à commencer par Opus 5.5 pour la plupart des tâches de programmation et de travail intellectuel. Fable 5.2 convient aux tâches techniques les plus ambitieuses, les plus ouvertes et les plus longues.
Cet article ne se contente pas de reprendre un classement. Tous les résultats cités proviennent de l’annonce d’Anthropic du 2026-11-09 ; les limites sont tirées de la page officielle du modèle et des notes de mise à jour. Vous repartirez avec quatre repères : les domaines où il est nettement supérieur, ceux où il ne l’emporte pas sur tous les plans, les cas où les garde-fous l’arrêtent et ceux où les mécanismes du produit le limitent.
L’essentiel : si vous utilisez déjà l’API Claude, cet article vous aidera à décider si vous devez passer d’Opus 5.5 à Fable 5.2 et à ajuster votre facture et vos paramètres d’appel après la migration.
Points clés sur Claude Fable 5.2
Commençons par regrouper dans un tableau les questions qui reviennent le plus souvent. Tous les chiffres proviennent de la page officielle du modèle et de l’annonce de lancement ; ils ont été vérifiés le 10 novembre 2026.
| Point | Informations officielles | Ce que ça signifie pour vous |
|---|---|---|
| Positionnement | Modèle phare orienté vers les tâches techniques les plus ambitieuses et les plus ouvertes | Ce n’est pas le choix par défaut au quotidien : Opus 5.5 reste le modèle recommandé pour cet usage |
| Lien avec Mythos | Même modèle sous-jacent ; Fable est doté de garde-fous plus stricts et est accessible à tous les utilisateurs | Mythos n’est pas un modèle plus puissant |
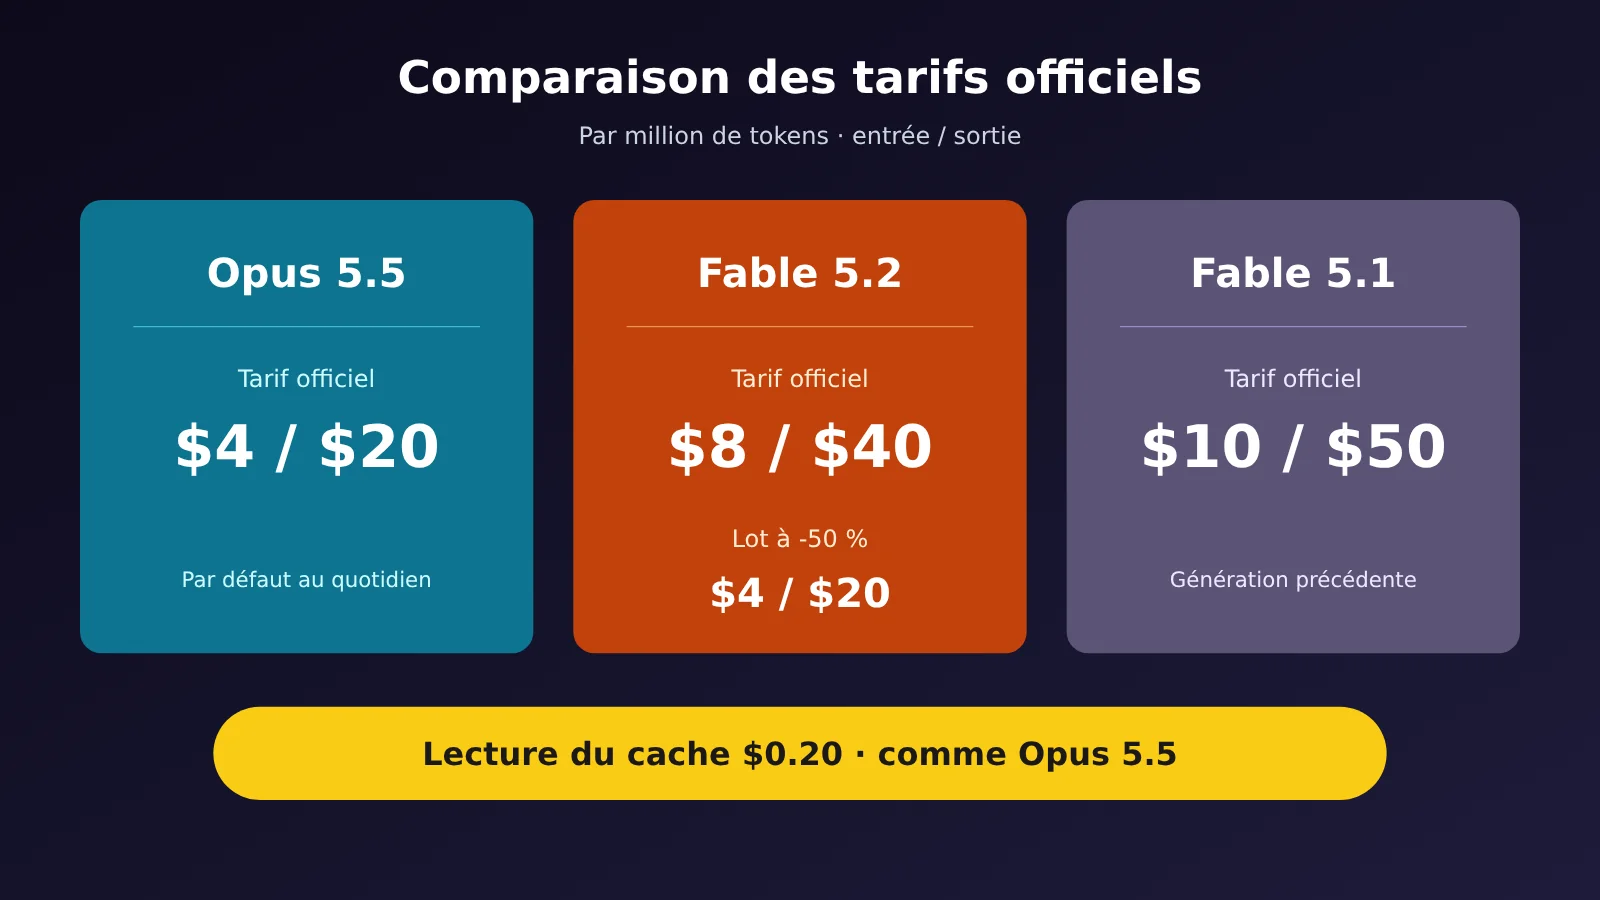
| Tarif standard | 8 $ en entrée, 40 $ en sortie (par million de tokens) | C’est 2 fois le prix d’Opus 5.5, mais 20 % moins cher que Fable 5.1 |
| Réflexion | La réflexion adaptative est toujours activée et ne peut pas être désactivée | Pour limiter le temps de réflexion, vous pouvez uniquement régler le niveau d’effort |
| Conservation des données | Une conservation de 30 jours est exigée par défaut | Pour les usages nécessitant une conservation nulle des données, vérifiez d’abord que vous y êtes autorisé |
Quel est le lien entre Claude Fable 5.2 et Mythos 5.2 ?
L’annonce de lancement est très claire : Claude Fable et Claude Mythos reposent sur le même modèle. La différence, c’est que Fable intègre des garde-fous plus stricts en matière de cybersécurité et de biosécurité, ce qui le rend accessible à tous les utilisateurs. Mythos, lui, est réservé aux organisations ayant passé les contrôles des programmes de vérification en sciences de la vie ou en cybersécurité. Les deux modèles sont au même prix.
L’idée selon laquelle « Mythos est plus puissant » relève donc d’une mauvaise interprétation. Certains résultats en cybersécurité et en biosécurité présentés dans l’annonce, comme le score de 76,3 % obtenu à CyScenarioBench, concernent Mythos 5.2 sans les mêmes garde-fous. Ils ne peuvent pas être attribués à Fable. Pour les utilisateurs ordinaires de l’API, le modèle disponible est Fable 5.2.
Spécifications et tarifs officiels de Claude Fable 5.2
Le tableau ci-dessous compare les trois modèles présentés sur la page officielle. Les spécifications complètes de Fable 5.1 n’ont pas été récupérées cette fois-ci ; seuls ses tarifs figurent plus loin.
| Spécification | Claude Fable 5.2 | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| Fenêtre de contexte | 1M tokens | 1M tokens | 1M tokens |
| Sortie maximale (API Messages synchrone) | 128K | 128K | 128K |
| Tarif standard (entrée / sortie) | $8 / $40 | $4 / $20 | $2 / $10 |
| Niveau de latence | Moderate | Moderate | Fast |
| Effort par défaut dans l’API Claude | high | medium | high |
| Date limite des connaissances | Juin 2026 | Juin 2026 | Juin 2026 |
Fable 5.2 accepte du texte et des images en entrée, et produit du texte. La page du modèle convertit sa fenêtre de contexte de 1M tokens en environ 555 000 mots ou 2,5 millions de caractères Unicode. Cette estimation repose sur le tokenizer actuel et ne signifie pas qu’un corpus chinois pourra nécessairement contenir autant de texte.
À noter : pour certains modèles, l’API Message Batches permet d’atteindre une sortie de 300K grâce à un en-tête bêta. Opus 5.5 figure dans la liste, mais pas Fable 5.2. En attendant une précision officielle, prévoyez une limite de 128K pour les sorties longues.
Les autres tarifs officiels, par million de tokens :
- Mise en cache : 10 $ pour l’écriture en cache de 5 minutes, 16 $ pour celle d’une heure et 0,20 $ pour la lecture du cache. La lecture du cache coûte 0,025 fois le tarif standard de l’entrée.
- Traitement par lots : l’entrée et la sortie bénéficient toutes deux d’une réduction de 50 %. Pour Fable 5.2, cela revient à 4 $ pour l’entrée et 20 $ pour la sortie.
- Mode rapide : même modèle, mêmes capacités, avec une vitesse de sortie pouvant atteindre 2,5 fois celle du mode standard. Le tarif est de 16 $ pour l’entrée et 80 $ pour la sortie. Le mode rapide d’Opus 5.5 coûte 8 $ / 40 $.
- Mise en cache en mode rapide : la documentation ne donne pas de grille tarifaire distincte ; elle précise seulement que les multiplicateurs du cache s’appliquent aux tarifs du mode rapide. D’après ces multiplicateurs, la lecture du cache revient à environ 0,40 $, l’écriture en cache de 5 minutes à 20 $ et celle d’une heure à 32 $.
- Paramètre du mode rapide : dans l’API Claude, il s’agit de
speed, avec la valeurfast. Sur Microsoft Foundry, le modèle possède un autre identifiant, qui se termine par-fast; il ne faut pas ajouterspeedà la requête.
Autre piège à éviter : les différents modes de vitesse ne partagent pas leur cache d’invites. Revenir du mode rapide au mode standard provoque donc un défaut de cache. La documentation sur le lancement du mode rapide ne mentionne pas Amazon Bedrock parmi les plateformes compatibles. Le modèle standard, lui, est disponible sur Bedrock sous l’identifiant anthropic.claude-fable-5-2.
Résultats officiels de Claude Fable 5.2
Quatre chiffres suffisent à montrer les points forts de Fable 5.2. Ils proviennent tous de l’annonce d’Anthropic du 9 novembre 2026. Sauf indication contraire, Fable 5.2, Fable 5.1 et Opus 5.5 ont obtenu ces scores avec les garde-fous activés. Pour chaque modèle, le tableau indique le niveau d’effort le plus élevé disponible à l’époque, sauf mention contraire : il ne s’agit pas du niveau par défaut.
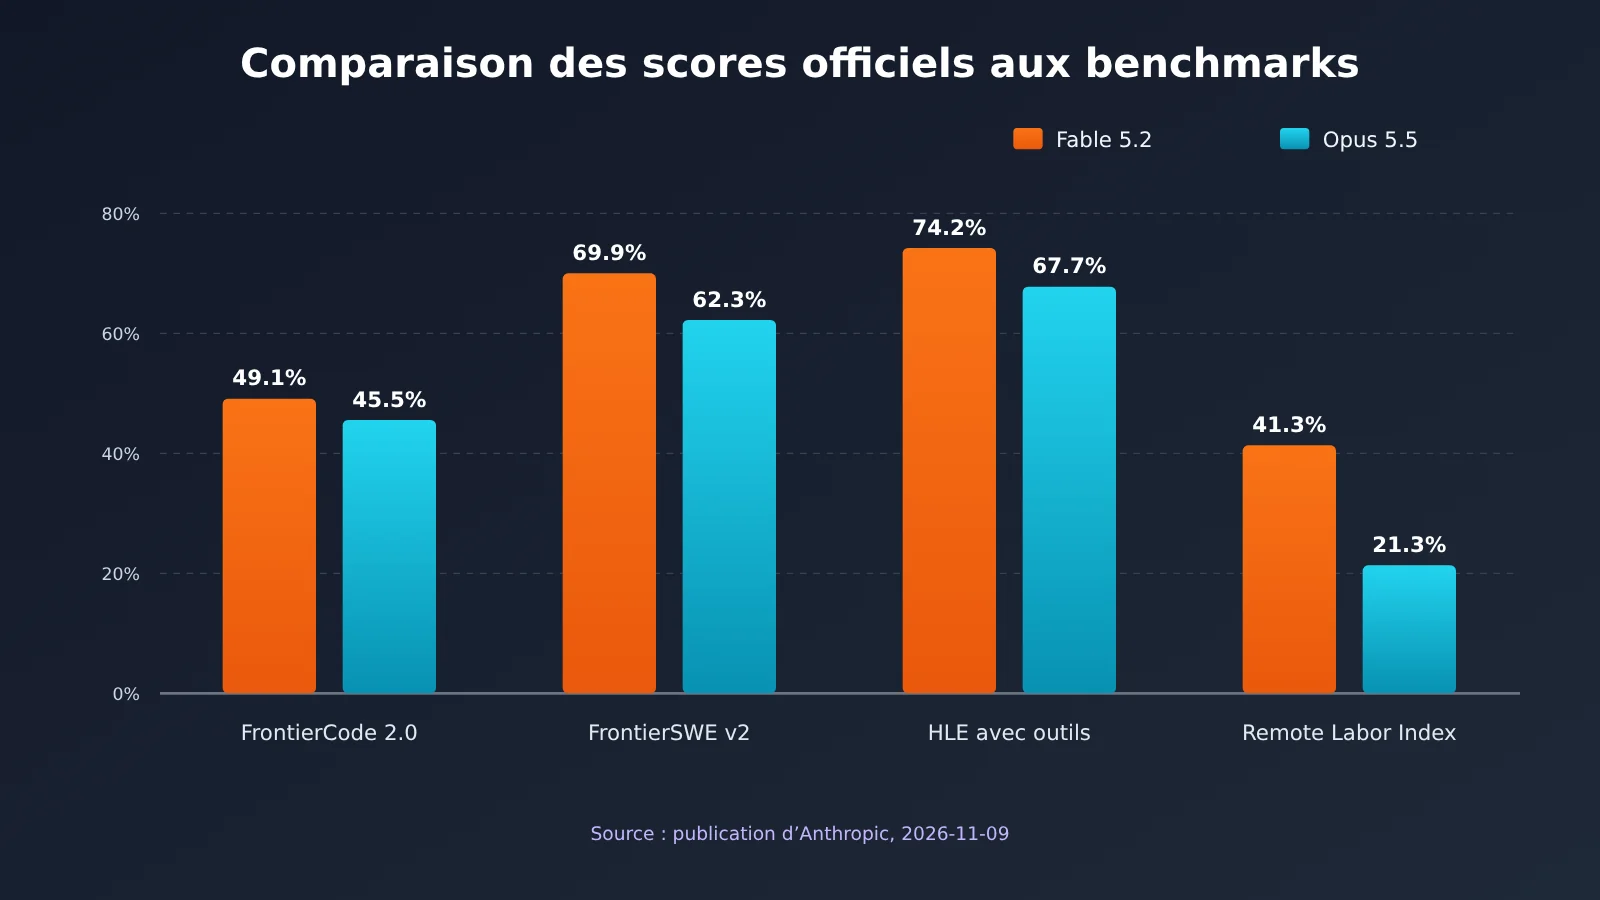
| Benchmark | Fable 5.2 | Précisions sur le niveau d’effort | Comparaison avec Opus 5.5 |
|---|---|---|---|
| FrontierCode 2.0 | 49,1 % | Le tableau précise qu’il s’agit du niveau Xhigh | 45,5 % (niveau par défaut indiqué dans le tableau, qui correspond à son niveau d’effort le plus élevé) |
| FrontierSWE v2 | 69,9 % | Aucune précision : niveau d’effort le plus élevé | 62,3 % (niveau d’effort le plus élevé) |
| Humanity’s Last Exam (avec outils) | 74,2 % | Aucune précision : niveau d’effort le plus élevé | 67,7 % (niveau d’effort le plus élevé) |
| Remote Labor Index | 41,3 % | Le tableau précise qu’il s’agit du niveau High, et non du niveau le plus élevé | 21,3 % (niveau d’effort le plus élevé) |
Comment interpréter les résultats de Claude Fable 5.2 en programmation
FrontierCode mesure la probabilité qu’une modification soit acceptée par les responsables d’un dépôt open source. C’est plus proche des conditions réelles d’un projet que le simple fait de réussir les tests. Avec 49,1 % en mode Xhigh, Fable 5.2 obtient le meilleur résultat parmi les modèles publiés évalués par Anthropic. L’annonce donne aussi un chiffre plus utile en pratique : en mode High, Fable 5.2 atteint environ 45,3 %, un résultat proche des 45,5 % obtenus par Opus 5.5 dans son meilleur mode, pour un coût par tâche environ deux fois moins élevé.
C’est un point important pour celles et ceux qui font leurs calculs. Fable 5.2 ne vaut pas seulement le détour parce qu’il obtient un meilleur score dans son mode le plus avancé : en mode High, il pourrait aussi accomplir la même tâche avec moins de jetons. Cela dit, ce résultat est donné par Anthropic sur ce benchmark. Il faudra le vérifier sur vos propres dépôts.
L’écart le plus marqué apparaît dans la ligne Remote Labor Index : 41,3 % contre 21,3 %. Et Fable 5.2 obtient ce score en mode High, pas dans son mode le plus avancé. Ces tâches portent sur la réalisation complète d’un travail à distance, ce qui correspond bien à son positionnement pour les « tâches techniques longues, ouvertes et exigeantes ».
Les exemples de tâches longues avec Claude Fable 5.2 sont à prendre comme des expériences isolées
L’annonce raconte plusieurs histoires qui attirent l’attention. À la lecture, il faut bien distinguer qui a fait quoi et combien de fois :
- Système d’exploitation prototype : un ingénieur a demandé à Fable 5.2 de partir d’un dossier vide et de coordonner plus de 1 000 sous-agents pendant environ huit jours d’affilée pour créer un système capable de démarrer sur un ordinateur portable. L’annonce ne présente pas le résultat comme celui d’une expérience répétée : il faut donc le considérer comme une expérience officielle unique.
- Formalisation du dernier théorème de Fermat : 1 000 agents Fable 5.2 ont travaillé pendant 30 heures, avec peu d’intervention humaine. Dans les mêmes conditions, Opus 5.5 a terminé environ 26 % du travail en 18 heures, puis n’a presque plus progressé au bout de 30 heures. La légende précise que chaque modèle n’a été exécuté qu’une seule fois.
- Migration de Python vers Rust : la migration d’un service de production essentiel vers Rust, avec un démarrage environ 26 fois plus rapide, a été réalisée par un groupe d’agents utilisant une version antérieure de Fable 5.2, et non par le modèle 5.2 publié.
- 90 % des modifications fusionnées : l’annonce indique que Claude a écrit, avec l’aide de personnes, plus de 90 % des modifications fusionnées dans le dépôt de code principal. Le sujet est Claude, et non Fable 5.2 en particulier.
Ces exemples donnent une idée du potentiel, mais ne prouvent pas que les résultats sont reproductibles. Si votre activité dépend de tâches qui s’exécutent pendant plusieurs jours, considérez cette capacité comme une hypothèse à vérifier vous-même.
Les 4 limites de Claude Fable 5.2
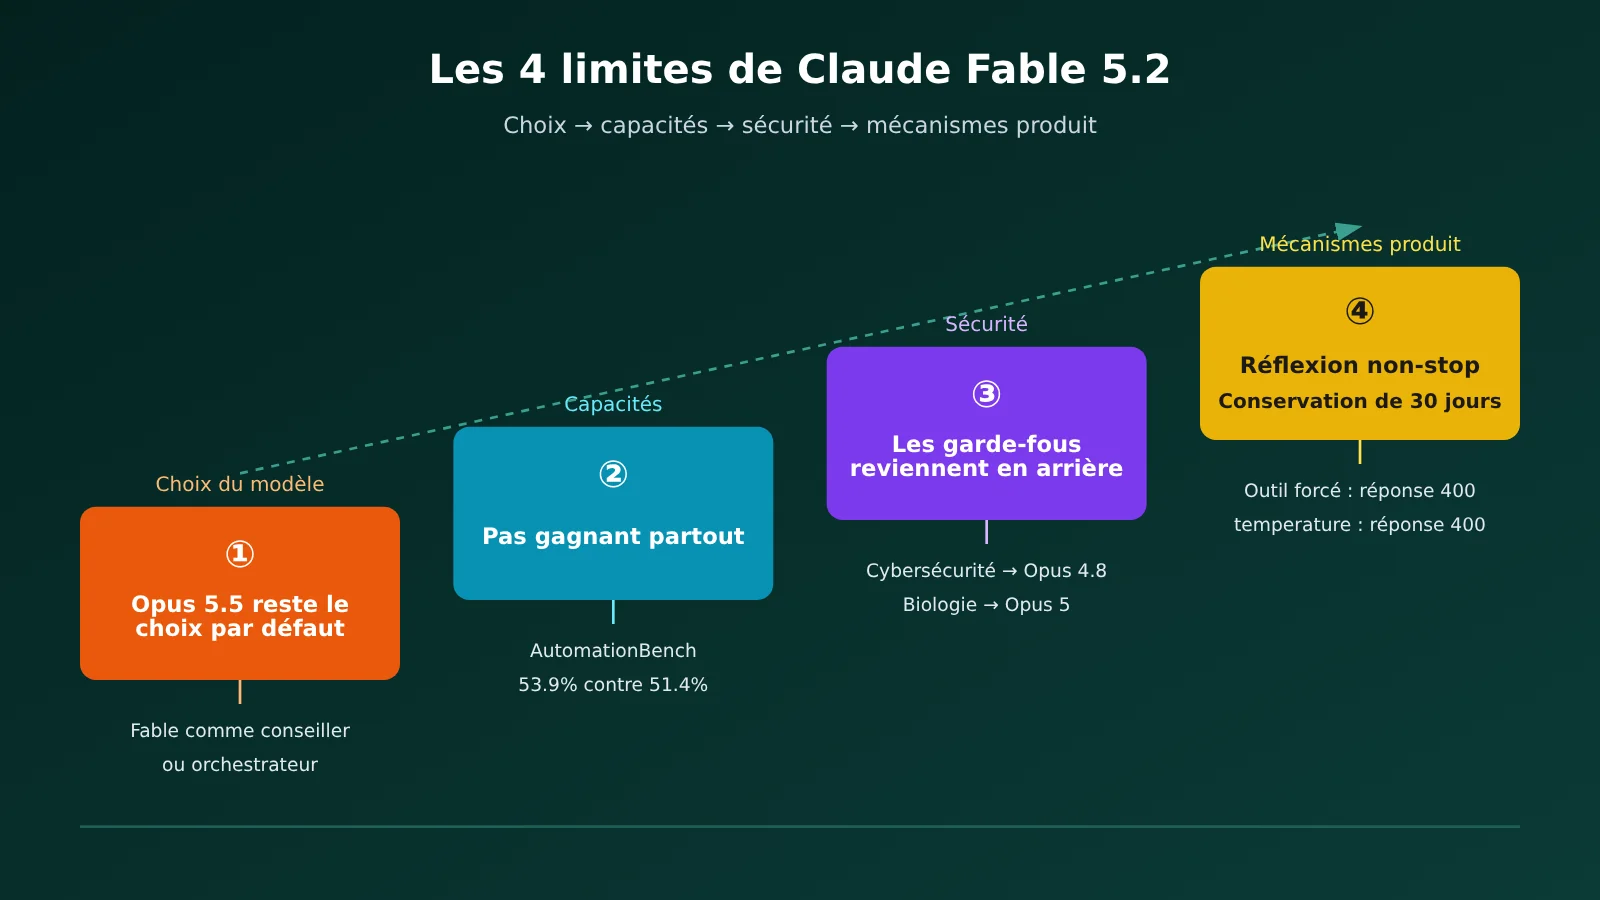
Les résultats montrent ses points forts ; les quatre limites ci-dessous indiquent jusqu’où il peut aller. Elles sont présentées dans l’ordre suivant : « choix du modèle → capacités → sécurité → mécanismes produit ».
Limite 1 : Claude Fable 5.2 n’est pas le modèle par défaut au quotidien
Les recommandations de l’annonce sont les suivantes : pour la plupart des tâches de programmation et de travail intellectuel, commencez par Opus 5.5, puis passez à Fable ou Mythos pour les tâches plus complexes, ou à Sonnet 5.5 ou Haiku 5.5 pour les plus simples. Fable 5.2 convient surtout aux tâches techniques les plus exigeantes et les plus ouvertes.
Il existe aussi deux façons de l’utiliser à moindre coût. La première consiste à en faire un conseiller que les modèles plus petits peuvent consulter lorsqu’ils rencontrent une difficulté. La deuxième consiste à lui confier l’orchestration : il décompose la tâche et répartit les parties les plus simples entre des modèles plus petits. Les jetons les plus coûteux ne sont alors utilisés que pour l’étape la plus difficile.
Limite n° 2 : Claude Fable 5.2 ne remporte pas tous les tests
Les modèles comparés dans l’annonce sont GPT-6 Astra et Gemini 4 Carbon. Le tableau a été établi par Anthropic, et non publié par OpenAI ou Google. Même dans ce tableau, Fable 5.2 a quelques résultats moins bons.
| Benchmark | Fable 5.2 | Modèle en tête | Remarque |
|---|---|---|---|
| AutomationBench | 51,4 % | Gemini 4 Carbon : 53,9 % | Carbon obtient un meilleur résultat |
| AA-Briefcase v1.1 Elo | 1785 | Opus 5.5 : 1800 | Opus est devant au classement Elo |
| AA-Briefcase v1.1, score basé sur des règles | 66,1 % | Fable 5.2 | Opus 5.5 obtient 61,2 % |
| Chartography (sans outils) | 73,4 % | Fable 5.2 | Carbon atteint 72,5 % et Astra 71,0 % : l’écart est faible |
La ligne AA-Briefcase mérite qu’on s’y attarde. Fable domine au score basé sur des règles, mais Opus prend l’avantage en Elo. Cela montre que, dans les évaluations où les préférences subjectives comptent davantage, le modèle le plus cher n’est pas forcément le plus apprécié. Pour rédiger des briefings ou travailler sur des documents, Opus 5.5 n’est pas un choix par défaut faute de mieux.
Limite 3 : les garde-fous de sécurité de Claude Fable 5.2 changent de modèle répondant
Lorsqu’un classificateur de sécurité bloque une requête, Fable 5.2 ne se contente pas de ne rien renvoyer : les demandes liées à la cybersécurité sont prises en charge par Opus 4.8, et celles liées à la biologie, par Opus 5. Une requête refusée renvoie un statut HTTP 200 et un stop_reason égal à refusal. Votre code doit donc vérifier ce champ, et pas seulement le code de statut. La facturation des refus avant génération dépend de leur catégorie, mais ils consomment tous du quota de requêtes.
Une autre limite, plus discrète, concerne les capacités directement liées à la R&D en IA. Les tâches d’optimisation de noyaux pour accélérateurs et d’amélioration de l’architecture des grands modèles de langage sont volontairement limitées à un niveau comparable à celui d’Opus 5.5. Pour quelques sujets, notamment le développement de noyaux sur certains accélérateurs non standard, le système bascule automatiquement vers Opus 5 pendant l’inférence. Il ne s’agit pas d’un échec de l’appel. Le codage par agents, le développement matériel et la recherche en apprentissage automatique traditionnel ne sont pas concernés par cette limite.
Les premiers tests officiels indiquent que Fable 5.2 bloque environ 55 % moins de requêtes que Fable 5.1 sur claude.ai, Claude Code et Cowork. La baisse est d’environ 60 % pour la cybersécurité et de 40 % pour la biologie. Il s’agit de tests préliminaires officiels, et non d’une vérification indépendante.
Limite quatre : les mécanismes de Claude Fable 5.2 imposent des contraintes strictes
Ces points ont un impact direct sur votre code d’appel actuel. Vérifiez-les un par un avant la migration :
- Impossible de désactiver la réflexion : la réflexion adaptative est toujours activée. À partir du niveau
medium, écrire « Ne réfléchis pas, réponds directement » dans l’invite ne l’arrêtera pas. Pour réduire le temps de réflexion, vous devez diminuer le niveau d’effort (effort). - Le forçage d’un outil renvoie une erreur 400 : la requête échoue si
tool_choicevautanyoutool. - Les paramètres d’échantillonnage renvoient une erreur 400 : ne transmettez pas
temperature,top_pnitop_k. - Conservation des données pendant 30 jours : sauf autorisation explicite d’Anthropic, il n’est pas possible d’opter pour une conservation nulle des données. Les entreprises éligibles peuvent encore bénéficier de cette option avant d’adopter Enterprise Frontier Safeguards ; les autres clients voient leurs données conservées pendant 30 jours à des fins de surveillance de la sécurité.
- Les tâches longues peuvent s’interrompre d’elles-mêmes : le modèle peut parfois s’arrêter après un seul tour, laisser une liste de tâches à terminer, proposer de poursuivre ou s’arrêter face à un obstacle ordinaire. C’est plus fréquent au niveau
low. Lors de longues séquences d’appels d’outils, les messages destinés à l’utilisateur peuvent être rares. - Les blocs de réflexion ne sont pas interchangeables : seuls Fable 5.2 et Mythos 5.2 peuvent lire les blocs de réflexion de Fable 5.2. Si Fable 5.2 joue le rôle d’exécutant, le conseiller doit lui aussi être Fable 5.2 ou Mythos 5.2.
La note de publication rappelle également que préciser dans l’invite « qui possède le code » influe sur le choix du modèle entre modifier la structure existante et repartir de zéro. Il suit les règles de style à la lettre ; en revanche, imposer une longueur de phrase trop stricte peut fragmenter le texte.
Qui peut-on appeler avec Claude Fable 5.2, et quels modèles ne sont pas encore disponibles ?
Au 10 novembre 2026, nous avons vérifié le catalogue des modèles et l’API publique des tarifs d’APIYI (apiyi.com) : claude-fable-5-2 et tous les modèles Mythos en sont absents. Nous proposerons ce modèle dès que possible. Pour connaître les modèles et les tarifs disponibles, consultez la liste des modèles de la plateforme.
En attendant sa disponibilité, vous pouvez utiliser Opus 5.5, déjà disponible, pour les tâches courantes et réserver les tâches les plus complexes à Fable 5.2 lorsqu’il sera lancé. Si vous avez besoin dès maintenant des capacités de la gamme Fable, Fable 5.1 figure dans la liste. Attention : ce n’est pas la version 5.2, et ses performances comme son comportement diffèrent.
| ID du modèle | État sur APIYI (apiyi.com) | Tarif affiché (entrée / sortie / lecture du cache, par million de tokens) | Points de terminaison |
|---|---|---|---|
claude-opus-5-5 |
Disponible (également en version -thinking) |
4 $ / 20 $ / 0,2 $ | chat, messages |
claude-fable-5-1 |
Disponible (également en version -thinking) |
10 $ / 50 $ / 0,25 $ | chat, messages |
claude-fable-5-2 |
Pas encore disponible | Aucun tarif pour le moment ; consultez la liste des modèles de la plateforme | — |
claude-mythos-5-2 |
Pas encore disponible | Aucun tarif pour le moment | — |
Les montants en dollars du tableau sont les tarifs affichés. Le montant réellement facturé dépend aussi du multiplicateur appliqué au groupe de tokens ; reportez-vous à votre facture. Comme Fable 5.2 ne figure pas dans le tableau, aucun tarif n’est disponible pour calculer ce multiplicateur. Ne déduisez donc pas le montant facturé par APIYI à partir du tarif officiel. Pour l’intégration, APIYI propose une interface compatible avec OpenAI, avec https://api.apiyi.com/v1 comme base_url. Une seule clé vous permet de passer d’Opus 5.5 à Fable 5.1. Les nouveaux utilisateurs disposent d’un crédit d’essai gratuit pour comparer les deux modèles dans leur propre dépôt.
Résumé des avantages et des limites de Claude Fable 5.2
Avantages
- Bien plus performant sur les longues tâches ouvertes : dans la catégorie High, son score au Remote Labor Index est presque deux fois supérieur à celui d’Opus 5.5.
- Un bon rapport qualité-prix en catégorie High : sur FrontierCode, il atteint environ 45,3 % en catégorie High, soit le meilleur score d’Opus 5.5, pour un coût par tâche environ deux fois moins élevé (selon l’éditeur).
- Moins cher et plus rapide que la version 5.1 : le tarif standard est inférieur de 20 %. Selon l’annonce, la génération de sortie peut être jusqu’à 30 % plus rapide qu’avec la version 5.1.
- La lecture du cache reste abordable : 0,20 $, comme pour Opus 5.5.
Limites
- Le tarif standard est deux fois plus élevé que celui d’Opus 5.5 : pour les tâches courantes, la facture double.
- Il ne gagne pas partout : il est devancé par Gemini 4 Carbon sur AutomationBench et par Opus 5.5 au classement Elo d’AA-Briefcase.
- Des garde-fous et un plafond de capacités : les demandes liées à la cybersécurité et à la biologie sont traitées par un ancien modèle ; en optimisation du noyau et en amélioration de l’architecture du modèle, les progrès semblent s’arrêter au niveau d’Opus 5.5.
- De nombreuses contraintes d’utilisation : impossible de désactiver la réflexion ; les outils obligatoires et certains paramètres d’échantillonnage renvoient une erreur 400 ; la conservation par défaut est de 30 jours ; les longues tâches peuvent s’interrompre d’elles-mêmes.
Questions fréquentes (FAQ)
Q1 : Quelle est la différence entre Claude Fable 5.2 et Fable 5.1 ?
Côté prix, le tarif standard de la version 5.2 est de 8 $ en entrée et de 40 $ en sortie, soit 20 % de moins que les 10 $ / 50 $ de la version 5.1. La lecture du cache passe de 0,25 $ à 0,20 $. Côté résultats, le score de FrontierSWE v2 passe de 56,3 % à 69,9 %, et celui du Remote Labor Index de 17,9 % à 41,3 %. Côté comportement, la version 5.1 suit généralement les instructions du type « ne réfléchis pas », alors que la version 5.2 ne les suit pas à partir du niveau medium. Pour le moment, le modèle disponible sur APIYI, apiyi.com, est `claude-fable-5-1` ; la version 5.2 n’y est pas encore proposée.
Q2 : Claude Mythos 5.2 est-il un modèle plus puissant ?
Non. L’annonce précise que Fable et Mythos reposent sur le même modèle sous-jacent. Mythos dispose de moins de garde-fous en matière de cybersécurité et de biologie ; il est donc réservé aux organisations dont les projets ont été vérifiés. Son prix est identique à celui de Fable 5.2. Certains résultats en cybersécurité et en biologie présentés dans l’annonce sont attribués à Mythos : il ne faut pas les citer comme des résultats de Fable 5.2.
Q3 : Peut-on désactiver la réflexion dans Claude Fable 5.2 ?
Non. La réflexion adaptative est toujours activée, et aucune invite ne permet de l’arrêter. Pour contrôler la quantité de réflexion et les coûts, la seule option est de réduire le paramètre `effort`. L’API Claude est réglée sur high par défaut, tandis que l’application Claude et Claude Code utilisent Medium. À noter : au niveau low, le modèle a davantage tendance à s’arrêter après un seul tour en laissant une liste de tâches à faire. Ce niveau est déconseillé pour les longues tâches.
Points clés de Claude Fable 5.2
- Positionnement : modèle phare axé sur les tâches techniques, publié le 2026-11-09. Pour les usages courants, Opus 5.5 reste le choix par défaut.
- Points forts : score de 69,9 % sur FrontierSWE v2 et de 41,3 % dans la catégorie High du Remote Labor Index.
- Pas de victoire sur tous les fronts : Fable perd contre Carbon sur AutomationBench et contre Opus sur le classement Elo d’AA-Briefcase.
- Garde-fous : les demandes liées à la cybersécurité sont redirigées vers Opus 4.8, et celles liées à la biologie vers Opus 5. En cas de refus, vérifiez
stop_reason. - Limites du produit : la réflexion est toujours activée ; imposer l’utilisation d’outils ou des paramètres d’échantillonnage entraîne une erreur 400. Les données sont conservées 30 jours par défaut.
- Exemples de tâches longues : les expériences sur un système d’exploitation (8 jours) et sur le dernier théorème de Fermat (30 heures) sont des essais officiels réalisés en une seule session.
- Disponibilité : au 2026-11-10, APIYI ne propose pas encore la version 5.2. En attendant, vous pouvez utiliser Opus 5.5 et Fable 5.1.
En résumé : quand éviter de passer à Claude Fable 5.2
Les capacités de Fable 5.2 sont bien réelles, mais elles s’expriment surtout dans des tâches techniques ouvertes qui s’étalent sur une longue durée. Dans les quatre cas suivants, mieux vaut rester sur Opus 5.5, ou utiliser Fable uniquement comme conseiller ou orchestrateur :
- Votre budget est serré : le tarif standard est deux fois plus élevé que celui d’Opus 5.5, et le mode rapide le double encore.
- Vous exigez une conservation des données nulle : la conservation de 30 jours est activée par défaut ; sans autorisation, il est impossible de désactiver toute conservation.
- Votre travail en cybersécurité ou en biologie risque d’être bloqué par les garde-fous : après le blocage, Opus 4.8 ou Opus 5 prend le relais, sans vous donner accès aux capacités de Fable.
- La tâche se limite au développement courant : l’éditeur recommande lui-même de commencer par Opus 5.5.
Si votre tâche relève vraiment de la catégorie « la plus exigeante et la plus ouverte », commencez par mettre votre processus au point avec Opus 5.5, puis confiez l’étape la plus difficile à Fable. Une fois la version 5.2 disponible, consultez la liste des modèles de la plateforme pour connaître le modèle et le tarif en vigueur.
Auteur : équipe technique d’APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site d’APIYI. Pour en savoir plus, consultez le centre de documentation sur docs.apiyi.com.