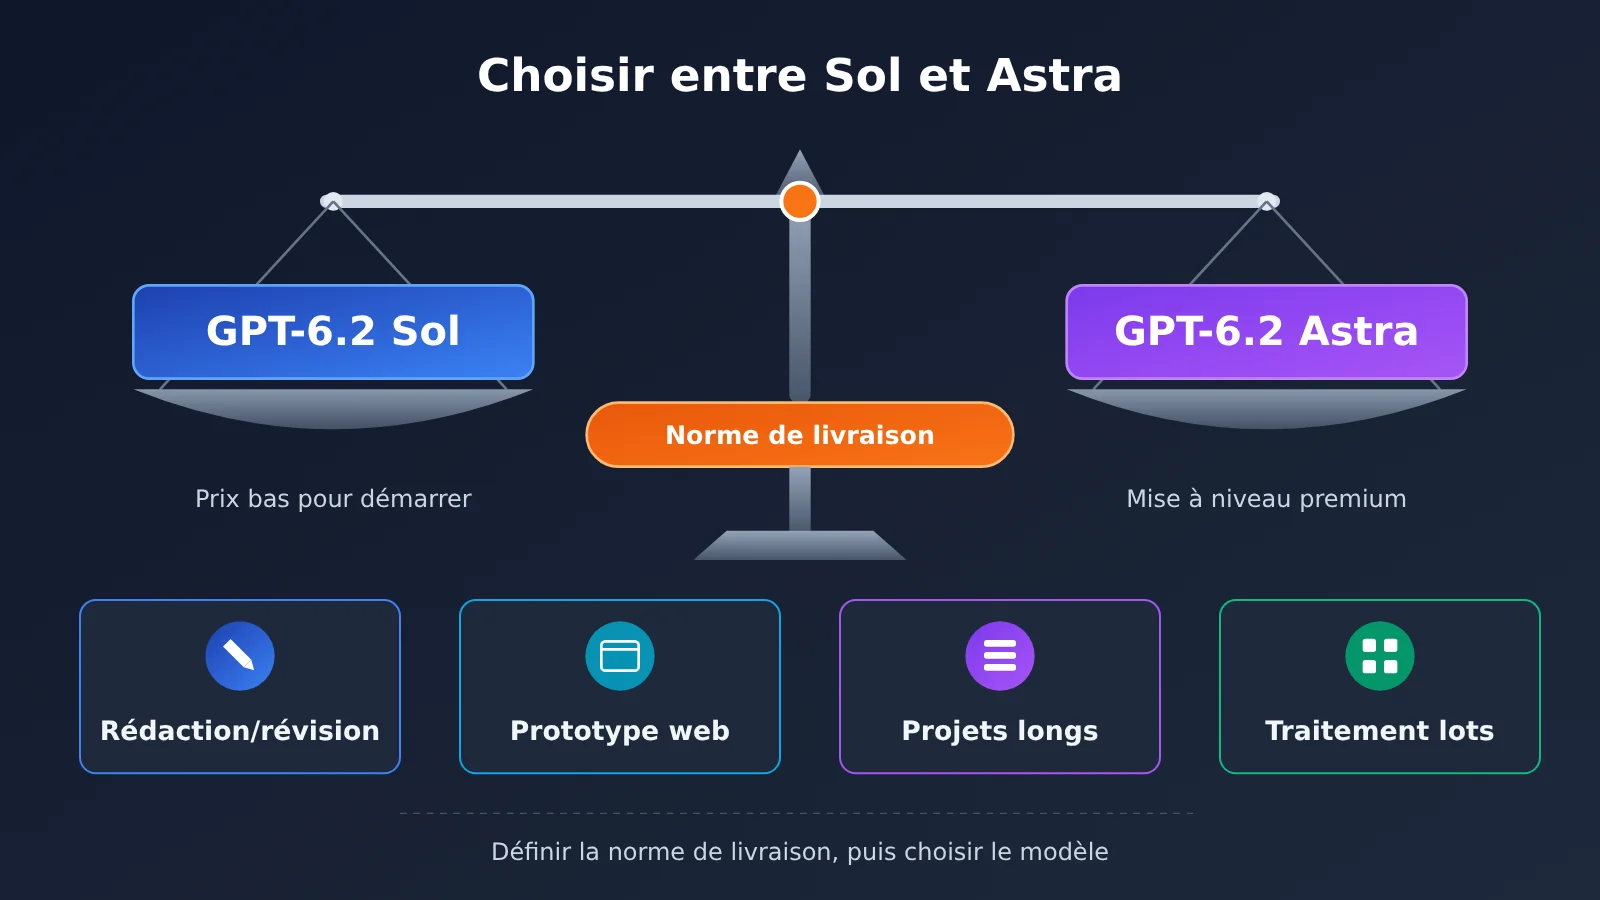
Réponse directe : pour la plupart des tâches de rédaction quotidienne, de prototypage web et de traitement par lots, commencez plutôt par GPT-6.2 Sol ; ne passez à GPT-6.2 Astra que si les résultats de Sol n’atteignent pas le niveau de livraison que vous avez défini à l’avance, ou si le coût des reprises dépasse déjà l’écart de prix. Les tarifs officiels des API des deux modèles vont du simple au quadruple. Les évaluations officielles indiquent que l’écart entre les deux est faible sur certaines tâches, mais ces résultats ne valent que pour des évaluations précises et ne doivent pas être pris pour une conclusion générale. Le vrai critère n’est donc pas de savoir lequel des deux est le plus puissant, mais quel niveau de qualité de livraison votre tâche exige.
Cette recommandation relève de l’avis éditorial : elle n’est ni un guide de choix officiel d’OpenAI, ni une conclusion tirée de nos propres tests. Les données d’évaluation citées dans cet article proviennent toutes des rapports officiels d’OpenAI.
Que retiendrez-vous de cet article ?
- Les dates de lancement, le périmètre d’accès, les capacités d’entrée et de sortie, ainsi que les tarifs officiels des API de GPT-6.2 Sol et Astra.
- Quels chiffres des évaluations officielles sont éclairants, et lesquels ne peuvent pas être extrapolés.
- Pour les 4 scénarios suivants — rédaction et révision au quotidien, prototypage web, projets longs et complexes, traitement par lots à budget serré — par quel modèle commencer, dans quels cas passer à Astra, et quelles étapes doivent impérativement être contrôlées par un humain.
- Un tableau de suivi de test A/B directement copiable, pour comparer l’exactitude des faits, l’utilité, le nombre de cycles de reprise et le coût total.
Sommaire : commencez par le tableau des concepts « To Know » et l’aperçu des impacts, pour comprendre rapidement les termes et ce que ce lancement signifie pour différents publics. La partie 1 rassemble les faits objectifs : informations de lancement, évaluations officielles et règles tarifaires. La partie 2 propose l’analyse éditoriale : un tableau de décision par scénario, une méthode d’estimation des coûts et un processus de test A/B, avec les liens sources en fin d’article.
À savoir : les concepts liés à GPT-6.2 Sol et Astra
| Concept | Explication rapide |
|---|---|
| GPT-6.2 Astra | Le modèle le plus haut de gamme et le plus cher de la série GPT-6.2, publiée par OpenAI le 17 novembre 2026 |
| GPT-6.2 Sol | L’autre modèle sorti le même jour, dont le tarif officiel de l’API représente environ un quart de celui d’Astra |
| GDPval v2 | L’un des benchmarks utilisés dans le rapport officiel d’OpenAI ; cet article ne reprend que le gain d’amélioration annoncé par l’éditeur |
| ALE (Agents’ Last Exam) | Évalue des workflows professionnels à plusieurs étapes ; ici, le gain cité prend GPT-6 Astra comme référence et n’est pas mélangé avec GDPval v2 |
| FrontierCode 2.0 | Le benchmark de programmation du rapport officiel ; la comparaison de coûts citée dans cet article ne vaut que dans le cadre de ce test |
| Niveau de raisonnement max | Le cran le plus élevé du paramètre d’intensité de raisonnement du modèle, qui implique en général plus de réflexion et un coût plus élevé |
| Point de pourcentage | L’écart entre deux pourcentages : passer de 50 % à 56,2 %, par exemple, c’est un gain de 6,2 points de pourcentage |
| Lecture de cache | Quand une entrée réutilisée touche le cache, elle est facturée à un tarif unitaire plus bas |
| Écriture de cache | Le coût généré par l’écriture du contenu dans le cache ; la documentation officielle précise que cela est facturé en plus |
| Seuil 272K | Au-delà d’environ 272 000 tokens en entrée sur une seule requête, l’ensemble de la requête est facturé à un tarif plus élevé |
| Critère de livraison | La condition de sélection posée par la rédaction : définir à l’avance « à partir de quel niveau de résultat une sortie est considérée comme utilisable » |
Aperçu de l’impact de GPT-6.2 Sol et Astra
- Utilisateurs ChatGPT ordinaires : la documentation d’aide officielle indique que cette vague est principalement déployée progressivement sur ChatGPT Work et Codex ; le Chat standard ne fait pas partie du périmètre de lancement de cette itération, ils pourraient donc ne pas percevoir de changement à court terme.
- Développeurs et petites équipes : les deux modèles seront progressivement ouverts via l’API. En raison d’un écart de prix unitaire de 4 fois, la stratégie de routage des modèles affectera directement la facture ; il vaut donc la peine de la concevoir à l’avance.
- Créateurs de contenu : l’entrée des deux modèles est composée de texte et d’images, la sortie est du texte ; ils ne disposent pas de capacité native de génération de vidéo et ne peuvent pas remplacer les outils de génération vidéo.
- Utilisateurs de traitement par lots sensibles au budget : la règle de multiplicateur appliquée au-delà de 272K sur les entrées longues a un impact important sur le coût du traitement de gros volumes de documents longs, plus important qu’une simple comparaison de prix unitaire.
1. Faits objectifs concernant GPT-6.2 Sol et Astra
Cette section ne rassemble que les informations publiques officielles d’OpenAI, sans jugement éditorial. Date de vérification : 18 novembre 2026.
1.1 Lancement et périmètre de disponibilité de GPT-6.2 Sol et Astra
Le 17 novembre 2026, OpenAI a publié en même temps GPT-6.2 Astra et GPT-6.2 Sol. D’après les informations officielles, les deux modèles seront déployés progressivement sur ChatGPT Work, Codex et l’API ; le Chat classique n’est pas concerné par cette première vague. « Déploiement progressif » signifie que les différents comptes peuvent obtenir l’accès à des moments différents — la documentation d’aide officielle fait foi.
Côté capacités, les deux modèles acceptent du texte et des images en entrée, et produisent du texte en sortie. Les documents officiels ne mentionnent pas de génération vidéo native. Si votre besoin est de produire des vidéos, cette annonce ne vous apporte pas de solution directe.
1.2 Les chiffres d’évaluation officiels de GPT-6.2 Sol et Astra
Le tableau ci-dessous récapitule les conclusions d’évaluation figurant dans le rapport officiel. Attention : chaque ligne est une évaluation indépendante, avec une base de comparaison qui lui est propre. On ne peut donc pas comparer horizontalement les chiffres de lignes différentes.
| Évaluation | Modèle | Résultat du rapport officiel | Limites d’usage |
|---|---|---|---|
| GDPval v2 | GPT-6.2 Astra | +6.2 points de pourcentage par rapport à GPT-6 Astra, avec 22 % de tokens de sortie en moins | La base de comparaison est l’Astra de la génération précédente |
| GDPval v2 | GPT-6.2 Sol | +5.3 points de pourcentage par rapport à GPT-6.1 Sol | La base de comparaison est GPT-6.1 Sol, donc différente de celle d’Astra |
| ALE | GPT-6.2 Astra | +5.2 points par rapport à GPT-6 Astra | L’unité est le « point », à ne surtout pas confondre avec les « points de pourcentage » de GDPval |
| FrontierCode 2.0 | Sol face à Astra | Quand les deux tournent au niveau de raisonnement max, l’écart entre Sol et Astra reste sous 0.5 point, pour un coût par tâche d’environ 1/5 de celui d’Astra | Valable uniquement pour ce test et ce niveau de raisonnement — ce n’est pas une conclusion générale sur les coûts |
Tous les chiffres ci-dessus proviennent du rapport officiel d’OpenAI, et non de nos propres mesures. Quant à la baisse de 22 % des tokens de sortie d’Astra, elle est donnée dans le contexte de GDPval v2 : reste à vérifier si elle se transpose à vos tâches précises.
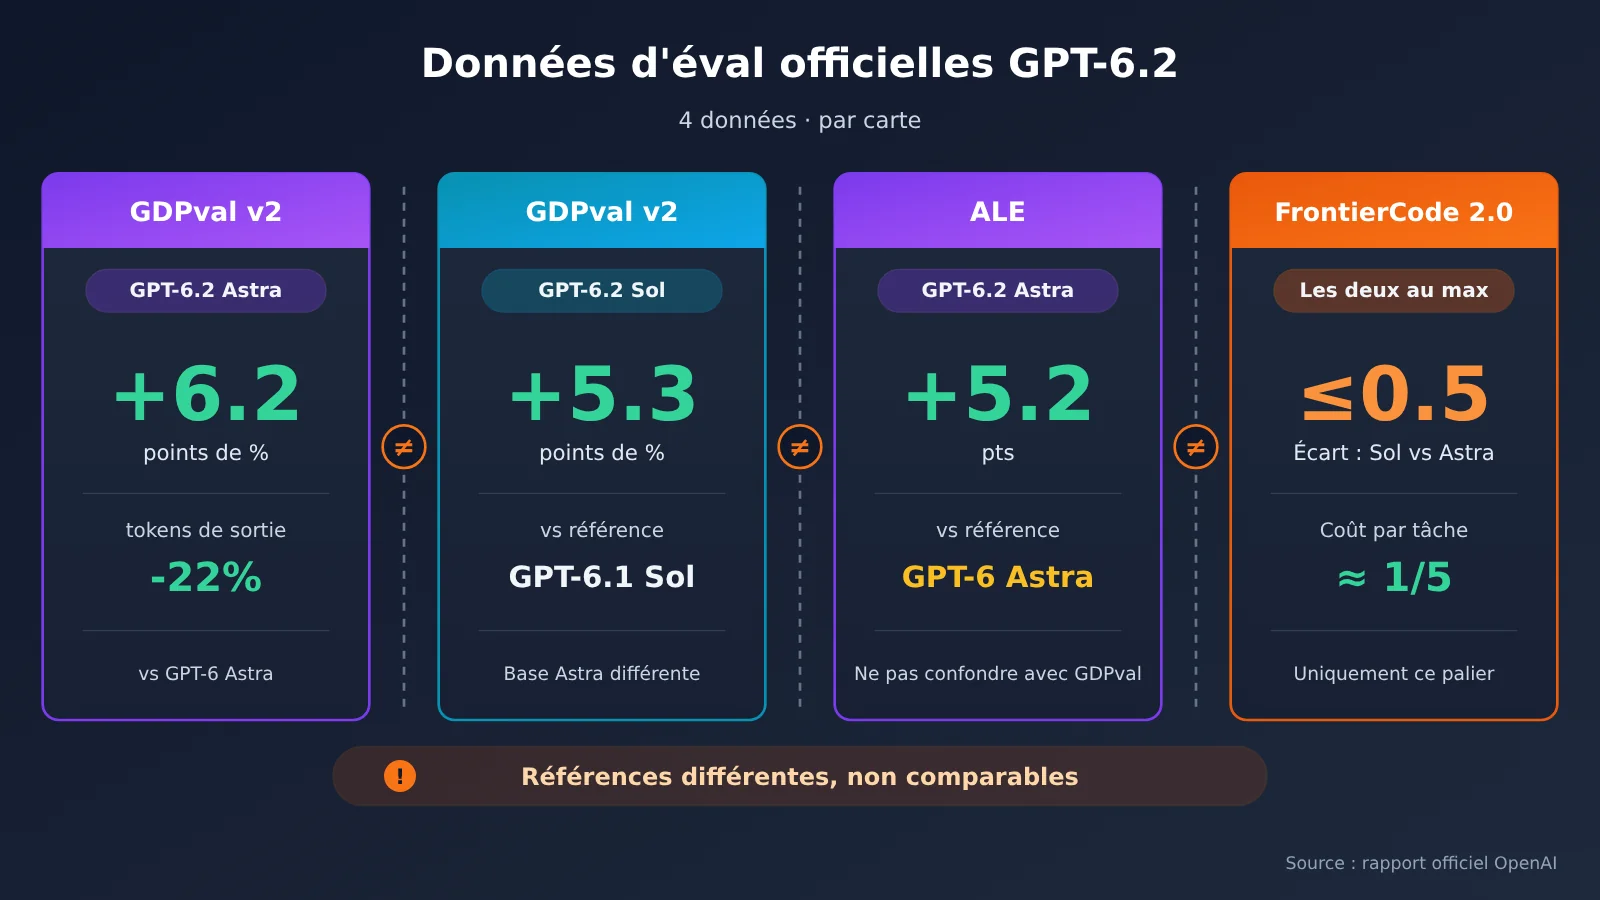
L’infographie ci-dessus éclate les 4 évaluations en cartes indépendantes, pour éviter que le lecteur mette côte à côte des chiffres issus de bases différentes. Si vous voulez faire ce type de comparaison sur vos propres données métier, vous pouvez consigner les résultats selon le modèle de la section 2.4, puis basculer d’un modèle à l’autre dans le même code via une interface compatible OpenAI comme APIYI (apiyi.com).
1.3 Règles de tarification officielles de l’API pour GPT-6.2 Sol et Astra
Voici les prix standard de l’API officielle, exprimés en dollars US par million de tokens :
| Élément de facturation | GPT-6.2 Astra | GPT-6.2 Sol | Description |
|---|---|---|---|
| Entrée non mise en cache | $8 | $2 | Sol représente 1/4 d’Astra |
| Lecture du cache | $0.4 | $0.1 | Prix unitaire de l’entrée après lecture du cache |
| Sortie | $40 | $10 | Sol représente 1/4 d’Astra |
| Écriture du cache | Facturé séparément | Facturé séparément | Voir la page officielle du modèle pour le détail |
| Entrée dépassant 272K | Tarif d’entrée et de cache de la requête entière ×2, sortie ×1.5 | Idem | Calculé sur la requête entière, pas uniquement sur la partie excédentaire |
Il faut prêter une attention particulière à la dernière ligne. Une fois le seuil de 272K franchi, le multiplicateur s’applique à la requête dans son ensemble, et pas seulement aux tokens qui dépassent le seuil. Pour les tâches qui doivent absorber de gros volumes de documents longs, il convient d’intégrer cette règle séparément dans le budget, et non de se contenter de regarder le prix unitaire de base.
💡 Précisions sur les prix : le tableau ci-dessus correspond aux prix standard de l’API officielle d’OpenAI. Les prix et la disponibilité sur les plateformes tiers doivent être vérifiés de votre côté. Cet article ne vérifie pas si ces deux modèles sont effectivement disponibles sur APIYI (apiyi.com) ; reportez-vous à la liste des modèles de la plateforme.
2. GPT-6.2 Sol ou Astra : comment choisir ? L’analyse de la rédaction
Le contenu ci-dessous est constitué des déductions et des recommandations de la rédaction, fondées sur les faits présentés dans la partie 1. Il ne représente pas le point de vue officiel d’OpenAI et n’a pas été vérifié par nos propres tests.
2.1 Définir d’abord le niveau de livrable, puis choisir GPT-6.2 Sol ou Astra
Quand il s’agit de choisir un modèle, beaucoup de gens commencent par demander « lequel est le plus puissant ». Or les données officielles de FrontierCode 2.0 suggèrent un autre angle : dans ce test, lorsque les deux modèles sont au niveau de raisonnement max, l’écart entre Sol et Astra reste inférieur à 0.5 point, alors que le coût de la tâche n’est qu’environ 1/5. Même si l’on ne peut pas généraliser cette conclusion, elle suffit à montrer que le gain apporté par le « plus puissant » peut être minime, tandis que l’écart de coût peut être énorme.
La rédaction recommande donc de répondre à trois questions avant de choisir un modèle : qui va utiliser ce livrable ? Quel est le coût d’une erreur ? Combien de cycles de reprise peut-on accepter au maximum ? Plus les réponses sont claires, plus il est facile de juger si Sol suffit déjà. Si le niveau de livrable n’est pas clairement défini, passer à Astra ne fera que répéter les essais-erreurs d’une manière plus coûteuse.
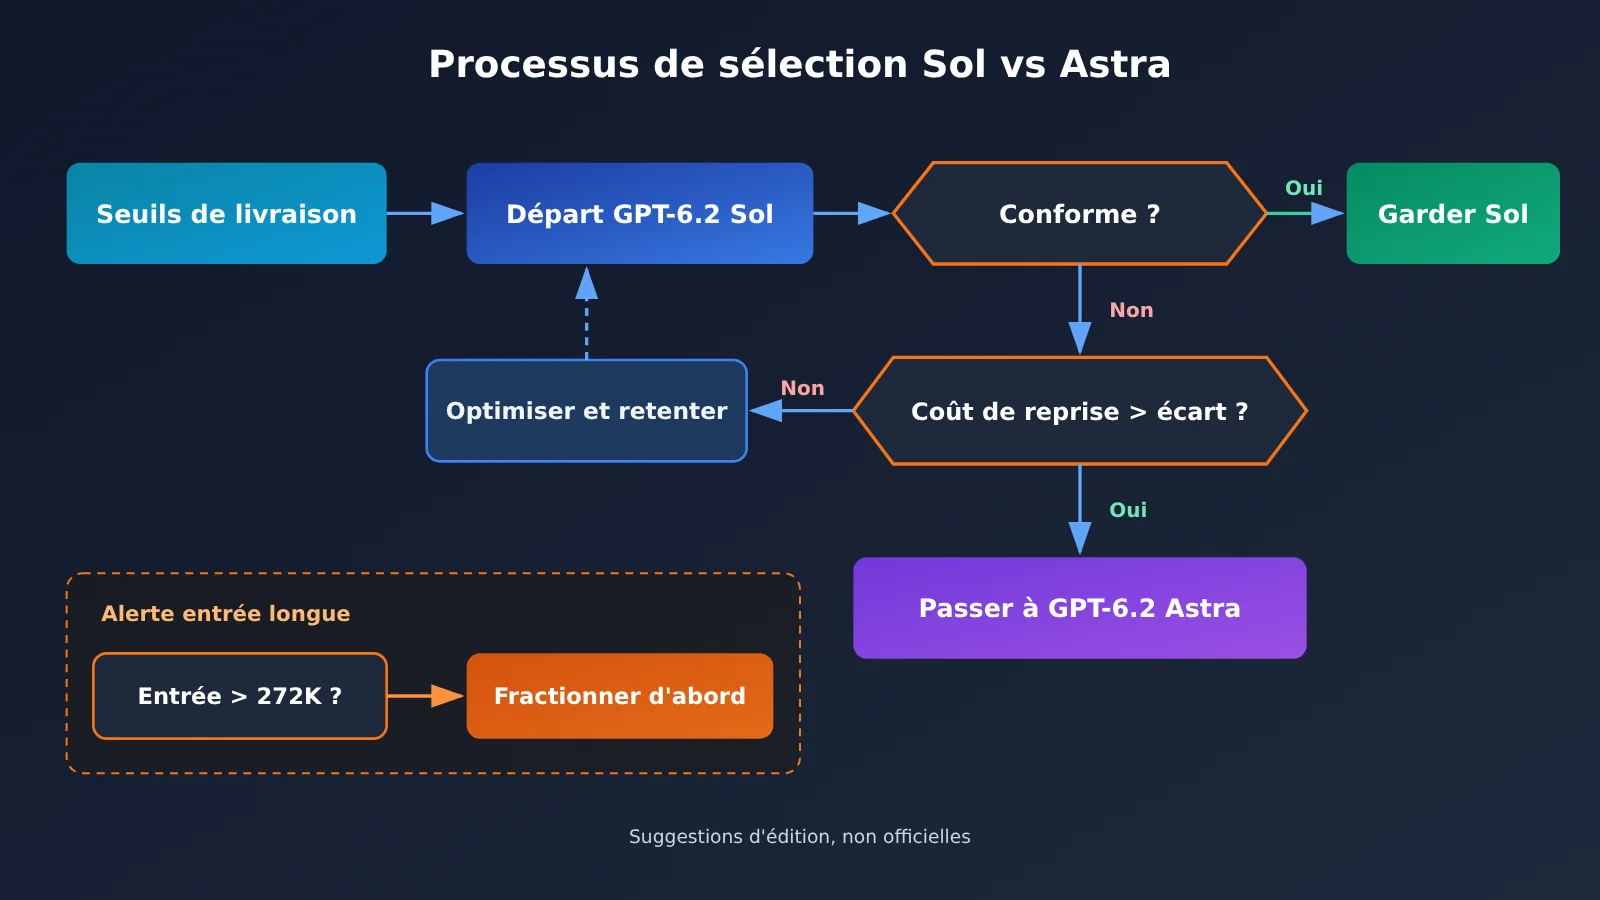
2.2 Tableau de décision pour 4 types de scénarios : GPT-6.2 Sol et Astra
Le tableau ci-dessous constitue une recommandation éditoriale, et non une directive officielle. Par « conditions déclenchant le passage à Astra », on entend les situations où cela vaut la peine d’essayer Astra ; par « points de contrôle humain », les étapes qu’on ne peut omettre quel que soit le modèle utilisé.
| Scénario | Modèle de départ | Conditions déclenchant le passage à Astra | Points de contrôle humain obligatoires |
|---|---|---|---|
| Rédaction et révision au quotidien | GPT-6.2 Sol | Le ton ou la structure ne conviennent toujours pas après 2 à 3 tours consécutifs ; besoin de traiter un texte long à l’argumentation rigoureuse | Faits, données, citations et noms de personnes ; vérifier qu’aucun sens n’a été altéré sans autorisation |
| Prototype web | GPT-6.2 Sol | La logique d’interaction s’étend sur plusieurs pages et le code généré par Sol présente des erreurs d’état récurrentes ; besoin d’une reproduction fidèle à partir d’une image de maquette | Exécution réelle dans le navigateur ; validation des formulaires, adaptation mobile ; vérifier que les paquets de dépendances existent réellement |
| Projet long et complexe | Selon le niveau d’exigence de livraison, on peut tester Astra directement | Chaîne de tâches longue, forte dépendance au contexte, une seule erreur entraîne une reprise massive en aval | Points de décision clés, cohérence entre fichiers, couverture des tests |
| Traitement par lots sensible au budget | GPT-6.2 Sol | Le taux d’erreur de l’échantillonnage dépasse le seuil que vous avez défini, et le coût de correction en post-traitement est plus élevé | Vérification par échantillonnage proportionnel ; vérifier si une entrée unique dépasse 272K ; taux de hit du cache |
Dans le scénario de rédaction et de révision au quotidien, la difficulté tient généralement à l’exactitude des faits et à l’adéquation du style, plutôt qu’à la profondeur du raisonnement. Démarrer avec Sol est plus avantageux, mais quel que soit le modèle utilisé, les données et les citations doivent être vérifiées manuellement.
Dans le scénario de prototype web, « ça fonctionne » est un critère impératif, qui peut s’évaluer objectivement. Pour savoir si Sol suffit, il faut l’exécuter réellement et vérifier les interactions clés, les états d’erreur et l’adaptation mobile ; une seule exécution réussie ne suffit pas à décider s’il faut passer à Astra.
Le projet long et complexe est le scénario où il est le plus justifié d’envisager directement Astra. Le rapport officiel mentionne une réduction de 22 % des tokens de sortie de GDPval v2, en prenant l’ancien GPT-6 Astra comme base de comparaison ; on ne peut pas en déduire les économies relatives par rapport à GPT-6.2 Sol. Le coût total des tâches des deux nouveaux modèles reste à vérifier par vous-même selon les mêmes exigences de livraison. Pour le traitement par lots sensible au budget, il faut avant tout contrôler la longueur d’une entrée unique afin d’éviter de déclencher le multiplicateur 272K.
2.3 Méthode d’estimation des coûts de GPT-6.2 Sol et Astra
Voici un calcul indicatif basé sur les tarifs officiels standards, destiné à illustrer l’impact des règles de facturation ; il ne représente pas la consommation d’une quelconque tâche réelle. On suppose une requête unique avec 50K tokens en entrée (hors cache) et 5K tokens en sortie :
- Sol : 0.05 × $2 + 0.005 × $10 = $0.15
- Astra : 0.05 × $8 + 0.005 × $40 = $0.60
Si l’on porte l’entrée à 300K tokens et la sortie à 10K tokens, le coefficient de 272K s’applique :
- Sol : 0.3 × $4 + 0.01 × $15 = $1.35
- Astra : 0.3 × $16 + 0.01 × $60 = $5.40
Cet exemple met en évidence deux choses. D’abord, à volume de tokens identique, l’écart de prix reste stable autour d’un facteur 4. Ensuite, dès qu’on dépasse 272K, le coût d’une requête augmente nettement. Pour les tâches de traitement par lots, découper les longs documents sous le seuil peut réduire les frais liés au contexte long, mais l’économie nette dépend du contexte répété, des requêtes supplémentaires et de la perte de qualité : impossible de partir du principe que c’est plus rentable que de changer de modèle.
Le coût réel dépend aussi de la longueur effective des sorties et du nombre de cycles de reprise. Si Sol a besoin en moyenne de 3 tours pour atteindre le niveau attendu, alors qu’Astra y parvient en 1 seul tour, l’écart sur la facture finale se resserre — c’est précisément pour cela que la section 2.4 recommande de noter le « nombre de cycles de reprise ».
Le code ci-dessous n’est qu’un exemple d’intégration, non testé dans cet article. Le script A/B renvoie une estimation équivalente aux tarifs officiels standards, hors cache et avec une entrée inférieure à 272K ; ce n’est pas une facture réelle d’un prestataire tiers. Les frais des services tiers doivent être calculés selon leurs tarifs effectifs.
L’exemple de code ci-dessous permet de basculer d’un modèle à l’autre au sein du même code. Les ID de modèles s’inspirent de la nomenclature de la page officielle des modèles ; fiez-vous à la liste réelle de votre plateforme :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI, la disponibilité des modèles dépend de la liste de la plateforme
)

response = client.chat.completions.create(
    model="gpt-6.2-sol",  # passer à "gpt-6.2-astra" pour une montée en gamme
    messages=[{"role": "user", "content": "按以下交付标准改写这段文案:……"}]
)
print(response.choices[0].message.content)
print(response.usage)  # enregistrer la consommation de tokens pour calculer le coût total
Voir le script de comparaison A/B (exécuter les deux modèles sur la même tâche et enregistrer la consommation)
import openai

PRICES = {  # Estimation équivalente au tarif standard officiel, et non à la facture réelle d'un tiers ; valable uniquement pour les requêtes ≤ 272K sans cache
    "gpt-6.2-sol":   {"input": 2.0, "output": 10.0},
    "gpt-6.2-astra": {"input": 8.0, "output": 40.0},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Basculer de modèle via l'interface unifiée APIYI
)

def run_once(model: str, prompt: str) -> dict:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    if u.prompt_tokens > 272000 or cached:
        raise ValueError("此简化估算仅适用于输入≤272K且无缓存的请求")
    p = PRICES[model]
    cost = u.prompt_tokens / 1e6 * p["input"] + u.completion_tokens / 1e6 * p["output"]
    return {
        "model": model,
        "output": resp.choices[0].message.content,
        "input_tokens": u.prompt_tokens,
        "output_tokens": u.completion_tokens,
        "official_standard_equivalent_usd": round(cost, 4),
    }

task = "在这里放同一个任务的完整提示词和交付标准"
for m in PRICES:
    r = run_once(m, task)
    print(r["model"], r["input_tokens"], r["output_tokens"], r["official_standard_equivalent_usd"])
🚀 Conseil pour démarrer : la clé d’un test A/B, c’est « même tâche, même invite, mêmes critères de livraison ». Avec une interface compatible OpenAI comme APIYI (apiyi.com), il suffit de modifier le paramètre
modelpour changer de modèle, ce qui facilite le contrôle des variables. Avant la mise en production, vérifiez d’abord que le modèle ciblé apparaît bien dans la liste des modèles de la plateforme.
2.4 Modèle de fiche d’enregistrement pour le test A/B entre GPT-6.2 Sol et Astra
Voici un modèle vierge : remplissez-le avec vos propres résultats de test. Pour chaque scénario, je vous conseille de choisir au moins 3 à 5 tâches représentatives et de les enregistrer séparément, plutôt que de tirer des conclusions à partir d’un seul résultat.
| Dimension de contrôle | Méthode d’enregistrement | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|---|
| Exactitude factuelle | Vérifier un par un les données, citations et noms, consigner le nombre d’erreurs | ||
| Utilisabilité | Le résultat atteint-il le niveau de livraison défini au préalable (oui / non / partiellement) | ||
| Nombre de cycles de reprise | Combien de cycles ont été nécessaires entre la première génération et la conformité | ||
| Tokens d’entrée / sortie | Cumulés sur chaque cycle, en vérifiant s’ils dépassent 272K | ||
| Coût total | Calculé sur le cumul des tokens de chaque cycle, y compris les cycles de reprise | ||
| Temps humain | Nombre de minutes consacrées à la vérification et aux modifications | ||
| Conclusion | Quel modèle utiliser par défaut pour cette tâche par la suite |
Au moment de remplir, je vous suggère d’examiner ensemble le « coût total » et le « temps humain ». Si la valeur du temps humain économisé par Astra dépasse le surcoût des frais d’API, alors le passage à Astra est justifié ; dans le cas contraire, il vaut mieux continuer avec Sol et concentrer vos efforts sur l’optimisation des invites et des critères de livraison.
2.5 Comment une petite équipe peut concevoir le routage pour GPT-6.2 Sol et Astra
Pour une petite équipe, l’éditorial recommande une approche de routage de type « Sol par défaut, montée vers Astra selon conditions ». Concrètement, on peut inscrire les conditions de déclenchement du tableau de la section 2.2 dans le flux de travail : par exemple, si un type de tâche est retravaillé plus que le nombre de tours défini, on bascule automatiquement sur Astra pour régénérer, et on consigne la raison dans les logs. Après un certain temps d’accumulation, vous obtiendrez une base de choix fondée sur vos propres données métier, plus fiable que n’importe quelle évaluation générique.
Ce type de routage exige une couche d’accès permettant de changer facilement de modèle. APIYI apiyi.com propose une interface compatible OpenAI : une seule clé API suffit pour appeler plusieurs modèles mainstream, ce qui en fait un bon outil pour mettre en place ce genre de routage. Toutefois, avant que la série GPT-6.2 n’apparaisse officiellement dans la liste des modèles de la plateforme, faites d’abord tourner le processus avec les modèles existants.
Un autre point à surveiller en continu : les deux modèles sont en phase d’ouverture progressive, et les prix officiels, la portée de disponibilité ainsi que les informations des pages modèles peuvent évoluer. Les jugements suivants sont des prévisions : à mesure que davantage d’évaluations tierces apparaîtront, les écarts entre Sol et Astra sur des tâches précises se révéleront plus fins que ne le montrent les rapports officiels. À ce moment-là, votre propre tableau de suivi A/B aura plus de valeur de référence que n’importe quel score isolé.
Références
- Page de publication officielle d’OpenAI : notes de version et évaluations officielles de GPT-6.2 Astra et Sol
- Lien :
openai.com/index/introducing-gpt-6-2-astra-sol/ - Notes : les chiffres GDPval v2, ALE et FrontierCode 2.0 de cet article proviennent tous de cette page
- Lien :
- Centre d’aide OpenAI : informations sur l’ouverture de ChatGPT Work et Codex
- Lien :
help.openai.com/en/articles/20001275-chatgpt-work-and-codex - Notes : périmètre de mise à disposition et ouverture progressive
- Lien :
- Documentation du modèle GPT-6.2 Astra : page officielle du modèle sur l’API
- Lien :
developers.openai.com/api/docs/models/gpt-6.2-astra - Notes : tarifs, cache et règles de facturation pour les contextes longs
- Lien :
- Documentation du modèle GPT-6.2 Sol : page officielle du modèle sur l’API
- Lien :
developers.openai.com/api/docs/models/gpt-6.2-sol - Notes : tarifs, cache et règles de facturation pour les contextes longs
- Lien :
Les modèles évoluent en permanence : la démarche la plus fiable consiste à définir d’abord clairement les critères de livraison, puis à comparer sur une même tâche. Si vous voulez comparer plusieurs modèles au sein d’un même code, vous pouvez passer par APIYI apiyi.com pour les intégrer, puis consigner les résultats selon le modèle présenté dans cet article.
Toute entreprise se prépare avant d’aboutir ; sans préparation, elle court à l’échec. — Livre des Rites · Zhongyong
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI apiyi.com ; vous trouverez davantage de ressources d’intégration dans le centre de documentation docs.apiyi.com