Note de l’auteur : à partir de tests publics menés sur trois agents personnels, nous décortiquons les problèmes de couche d’interface qui se cachent derrière les faiblesses d’exécution des agents, et proposons une liste de correctifs portant sur l’appel d’outils, la tolérance aux erreurs et les nouvelles tentatives, la compatibilité des formats et la maîtrise des coûts.
36Kr a publié le 4 novembre 2026 l’article « Les agents personnels passent à table : qui montre le premier sa faiblesse ? », qui plaçait trois agents personnels sur la même table pour un test pratique. Les conclusions de ce type de comparatif sont généralement très cohérentes : un agent ne manque pas de « savoir parler », il manque de « savoir terminer ». Le cœur de cet article, c’est la question suivante : les faiblesses d’exécution des agents proviennent le plus souvent de la couche d’interface, et pas seulement du modèle lui-même.
Il ne s’agit pas d’un énième classement « quel agent est le plus intelligent ». Nous ne reprenons pas les notes précises de l’article d’origine ; nous regroupons plutôt les échecs d’exécution fréquemment observés dans ce genre de test en 5 catégories, puis nous les faisons correspondre une par une aux points modifiables dans la conception de l’interface d’un agent.
L’essentiel : après avoir lu cet article, vous saurez quels paramètres d’interface vérifier en priorité quand vous construisez votre propre agent, comment gérer les échecs, et comment basculer sans heurt entre les formats d’interface d’OpenAI et d’Anthropic.
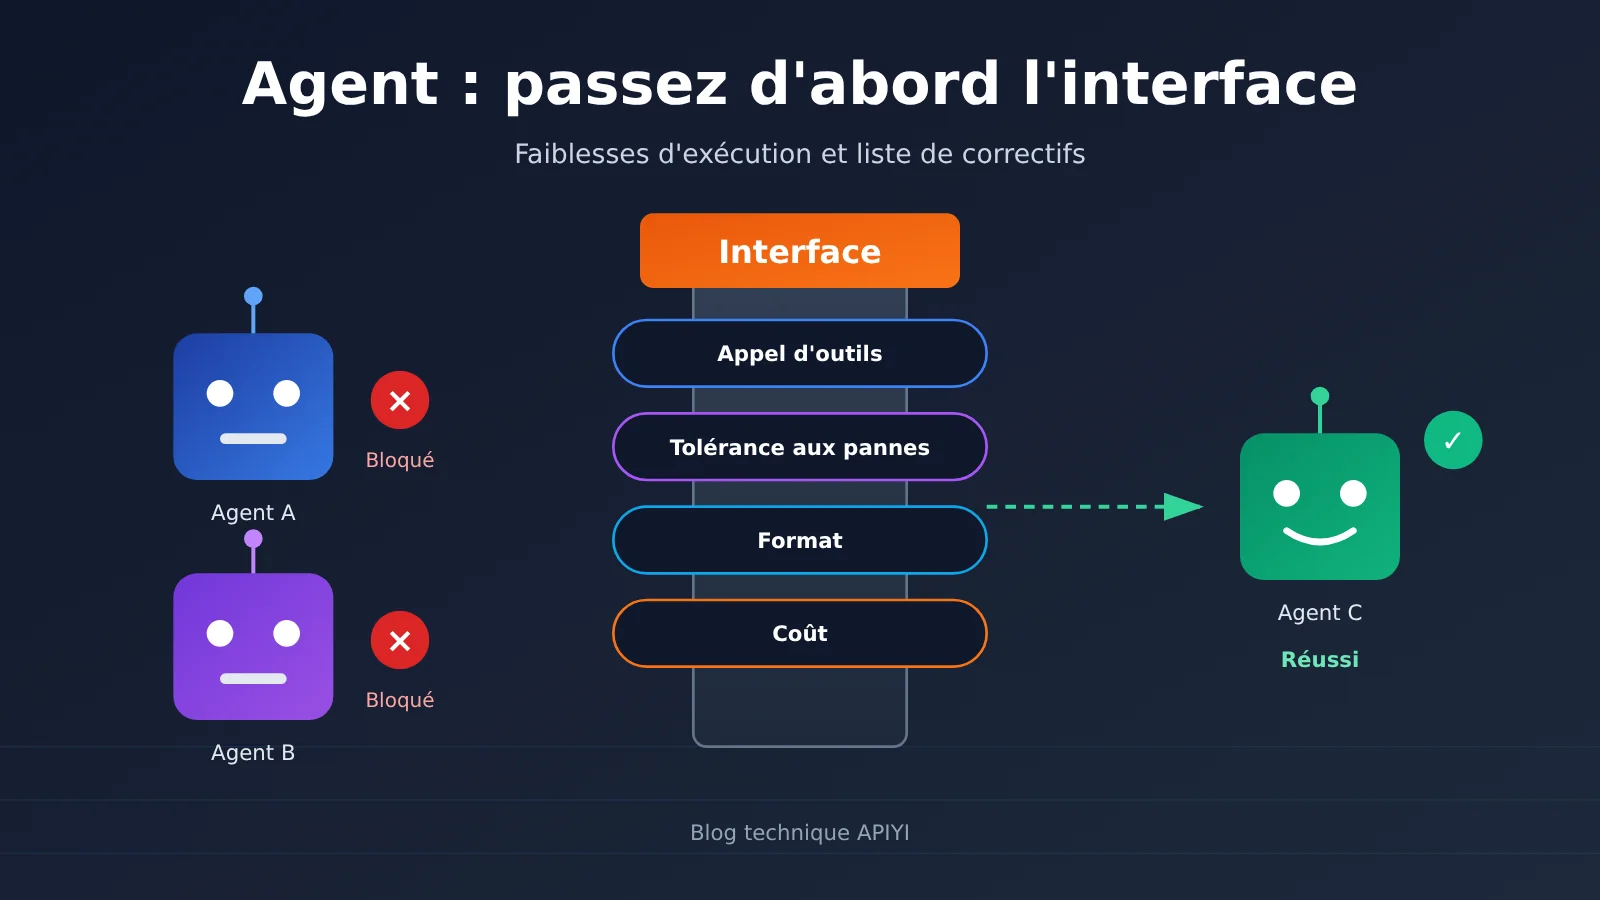
Points essentiels sur les faiblesses d’exécution des interfaces d’Agent
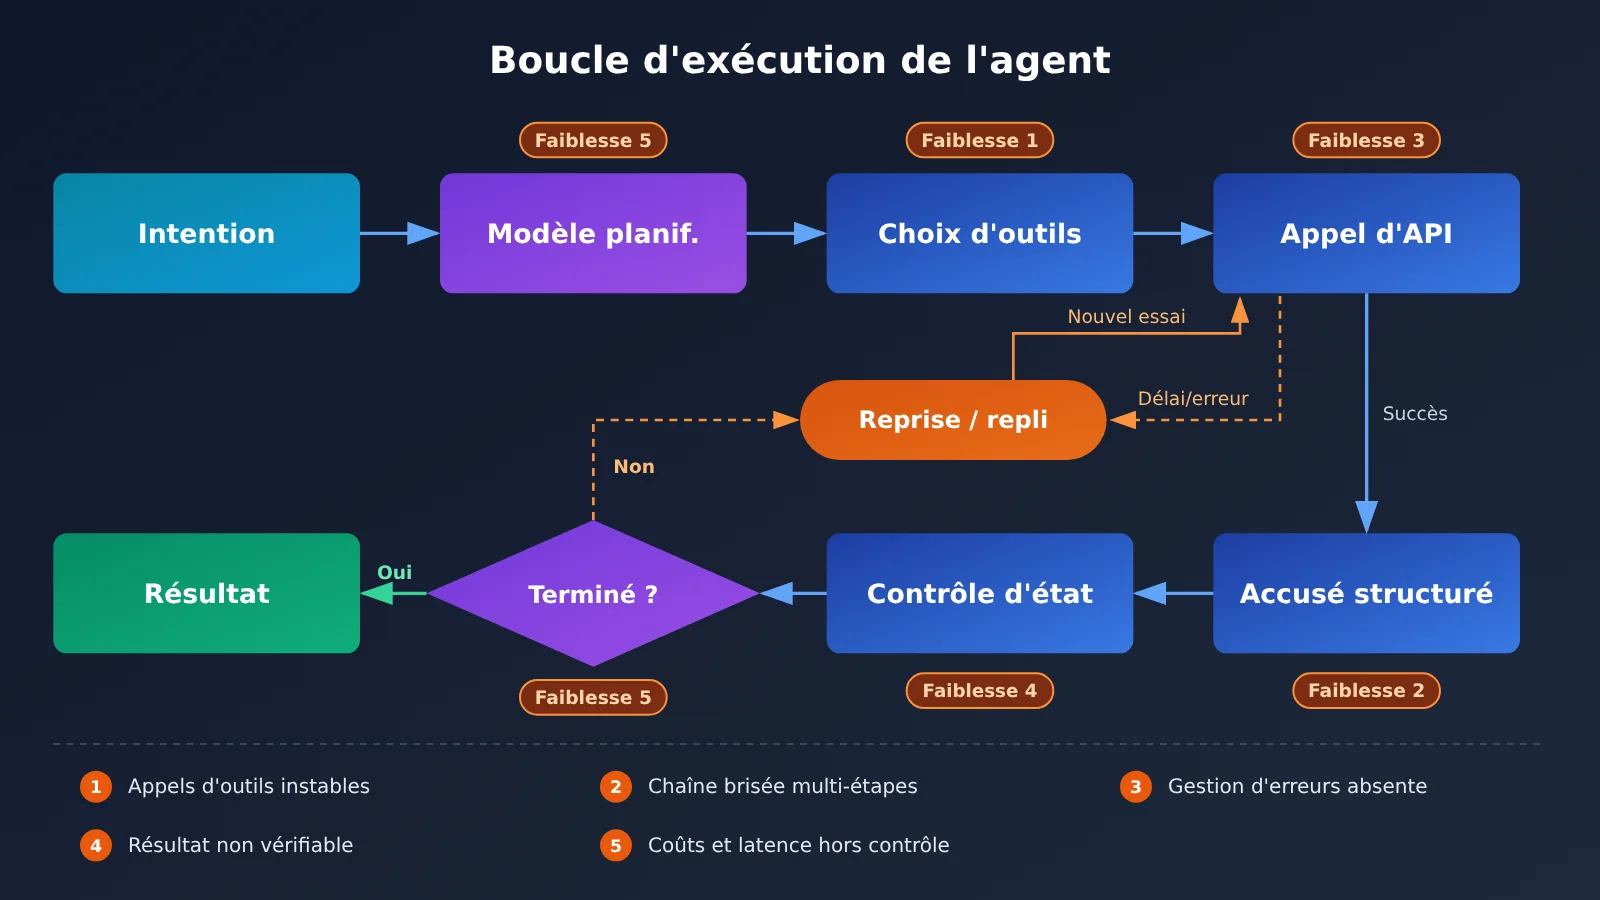
L’objectif d’un Agent personnel est de mener une tâche de bout en bout à la place de l’utilisateur : réserver un billet, trier des e-mails, synthétiser des documents, manipuler une page web. Il suffit qu’une étape échoue pour que l’utilisateur ait l’impression que « ce n’est pas terminé ». En remontant aux causes des échecs fréquemment observés lors des tests, on retombe presque toujours sur les 5 catégories de problèmes d’interface ci-dessous.
| Faiblesse d’exécution | Manifestation typique | Cause racine côté interface | Piste de correction |
|---|---|---|---|
| Appels d’outils instables | Mauvais outil choisi, paramètres incomplets, format invalide | Description d’outil floue, schéma sans contraintes | Réduire le jeu d’outils, écrire un schéma de paramètres strict |
| Rupture de chaîne sur les tâches multi-étapes | Arrive à la troisième ou quatrième étape et oublie l’objectif | Gestion du contexte trop approximative, résultats d’outils mal renvoyés | Normaliser l’historique des messages, compresser les résultats intermédiaires |
| Aucun filet de sécurité en cas d’échec externe | Abandonne dès une limitation de débit ou un timeout, ou prétend avoir terminé | Aucune distinction des types d’erreur, aucune stratégie de réessai | Réessayer par paliers selon le code d’état, ajouter timeout et dégradation |
| Résultats non vérifiables | Répond « terminé » alors que rien n’a été fait | Absence d’accusé d’exécution et de validation d’état | Exiger un accusé structuré à chaque étape |
| Coûts et latence incontrôlés | Appels en boucle, une tâche consomme énormément de tokens | Aucune limite d’étapes, aucun recours au cache | Fixer un nombre max de tours, utiliser des modèles par niveaux, exploiter le cache |
Analyse détaillée des principales faiblesses des interfaces d’Agent
Les deux premières faiblesses ressemblent à des problèmes de capacité du modèle, alors qu’une bonne partie peut être résolue par l’ingénierie. La cause la plus fréquente des appels d’outils instables, c’est de fournir d’un coup des dizaines d’outils au modèle, avec des descriptions qui se chevauchent : il choisit alors naturellement le mauvais. En réduisant les outils au strict nécessaire pour la tâche en cours et en précisant pour chaque paramètre son type, ses valeurs d’énumération et son caractère obligatoire, le taux d’erreur baisse généralement nettement. La rupture de chaîne sur les tâches multi-étapes vient souvent du renvoi des résultats d’outils : si le résultat n’est pas lié à l’ID d’appel correspondant selon le protocole, le modèle ne peut pas confirmer si l’étape précédente a réellement réussi.
Les trois dernières faiblesses relèvent de purs problèmes d’ingénierie. Un Agent digne de ce nom doit savoir « que faire en cas d’échec » et « comment prouver que le travail est terminé ». Lors des tests, ce qui déçoit le plus les utilisateurs, ce n’est pas l’échec en lui-même, mais le fait de prétendre avoir réussi après un échec. Par conséquent, le mécanisme d’accusé d’exécution et la classification des erreurs au niveau de l’interface sont plus utiles que de passer à un modèle plus grand.
Prise en main rapide de l’interface Agent : checklist en 5 étapes
Les étapes ci-dessous ne dépendent d’aucun framework particulier : elles s’appliquent que vous écriviez vous-même la boucle Agent ou que vous utilisiez un framework Agent existant. Conformément aux exigences de cet article, aucun code n’est fourni ici ; toutes les configurations clés sont expliquées dans des tableaux.
Étape 1 : Unifier le point d’entrée de l’interface Agent
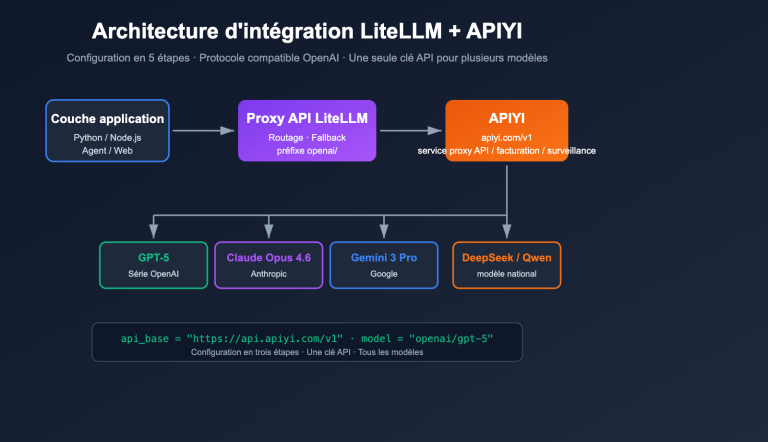
Un Agent a souvent besoin d’une combinaison « modèle puissant pour la planification, modèle rapide pour l’exécution ». Si chaque modèle est connecté séparément à un fournisseur, l’authentification, le format des erreurs et les règles de facturation diffèrent, ce qui complique beaucoup le diagnostic. La solution la plus simple consiste à utiliser un point d’entrée unifié compatible à la fois avec les formats d’interface OpenAI et Anthropic : il suffit de modifier base_url, api_key et model pour changer de modèle.
| Élément de configuration | Rôle | Valeur conseillée |
|---|---|---|
base_url |
Adresse de l’interface | Conformez-vous à la documentation du fournisseur, par exemple l’adresse indiquée dans la documentation APIYI sur docs.apiyi.com |
api_key |
Identifiant d’authentification | Placez-la dans une variable d’environnement, ne l’écrivez pas dans une invite ni dans les journaux |
model |
Nom du modèle | Configurez séparément la planification et l’exécution, pour pouvoir remplacer chaque modèle indépendamment |
timeout |
Délai d’expiration d’une requête | Réglez-le selon le type de tâche ; assouplissez-le pour les tâches à sortie longue |
max_retries |
Nombre de tentatives automatiques du SDK | Gardez une valeur faible ; la couche métier gère elle-même des tentatives graduées |
🚀 Démarrage rapide : APIYI fournit l’accès API aux principaux grands modèles de langage présentés dans cet article, compatible avec les formats d’interface OpenAI et Anthropic. Il suffit de modifier
base_urldans votre SDK existant pour vous connecter. Voir le centre de documentation APIYI : docs.apiyi.com.
Étape 2 : soigner la rigueur des paramètres d’appel d’outils de l’Agent
L’appel d’outils est la première barrière de l’exécution d’un Agent. Plus les paramètres sont stricts, plus l’espace de « libre interprétation » du modèle se réduit, et plus le taux d’erreur baisse.
| Paramètre | Signification | Recommandation pratique |
|---|---|---|
tools |
Liste des outils appelables | Sur un tour donné, n’exposez que les outils nécessaires à l’étape en cours ; rédigez la description en précisant « quand l’utiliser, quand ne pas l’utiliser » |
tool_choice |
Stratégie de sélection des outils | Spécifiez un outil lorsqu’une action doit être forcée ; en question-réponse ouverte, laissez en automatique |
| Schéma des paramètres | Structure des paramètres d’entrée de l’outil | Placez les champs obligatoires dans required ; quand une énumération suffit, n’utilisez pas de texte libre |
response_format |
Sortie structurée | Exigez une structure JSON pour l’accusé de réception final, afin de faciliter la validation par le programme |
max_tokens |
Limite de sortie | Obligatoire au format Anthropic, à estimer selon la tâche |
temperature |
Aléatoire | Baissez-la pour les étapes d’exécution, afin de réduire les cas où une même entrée produit des actions différentes |
Étape 3 : gérer les différences de format entre OpenAI et Anthropic
Beaucoup d’Agents « deviennent soudain bêtes » après un changement de modèle : la cause n’est pas le modèle, mais le fait que les protocoles d’outils des deux formats diffèrent, ce qui décale le renvoi des résultats. Le tableau ci-dessous liste les différences les plus piégeuses.
| Élément de comparaison | Format OpenAI Chat Completions | Format Anthropic Messages |
|---|---|---|
| Emplacement de l’invite système | Placée dans messages, avec le rôle system |
Utilise le paramètre system au niveau supérieur |
| Définition des outils | type: function plus un objet function |
name, description, input_schema |
| Initiation d’un appel par le modèle | tool_calls dans le message de l’assistant |
Bloc de contenu de type tool_use |
| Renvoi du résultat de l’outil | Message avec le rôle tool, accompagné de tool_call_id |
Bloc de contenu tool_result dans le message user, correspondant à tool_use_id |
| Limite de sortie | max_tokens facultatif |
max_tokens obligatoire |
Les deux formats n’ont ni supériorité ni infériorité ; l’essentiel est de ne maintenir qu’une seule représentation intermédiaire à l’intérieur de l’Agent, puis de la convertir au format correspondant au moment de la requête. Si vous passez par une entrée compatible avec les deux formats, comme APIYI, vous pouvez faire passer la série Claude par le format Anthropic natif et les autres modèles par le format OpenAI, chacun conservant la capacité d’appel d’outils la plus complète.
Étape 4 : concevoir une solution de repli en cas d’échec de l’interface Agent
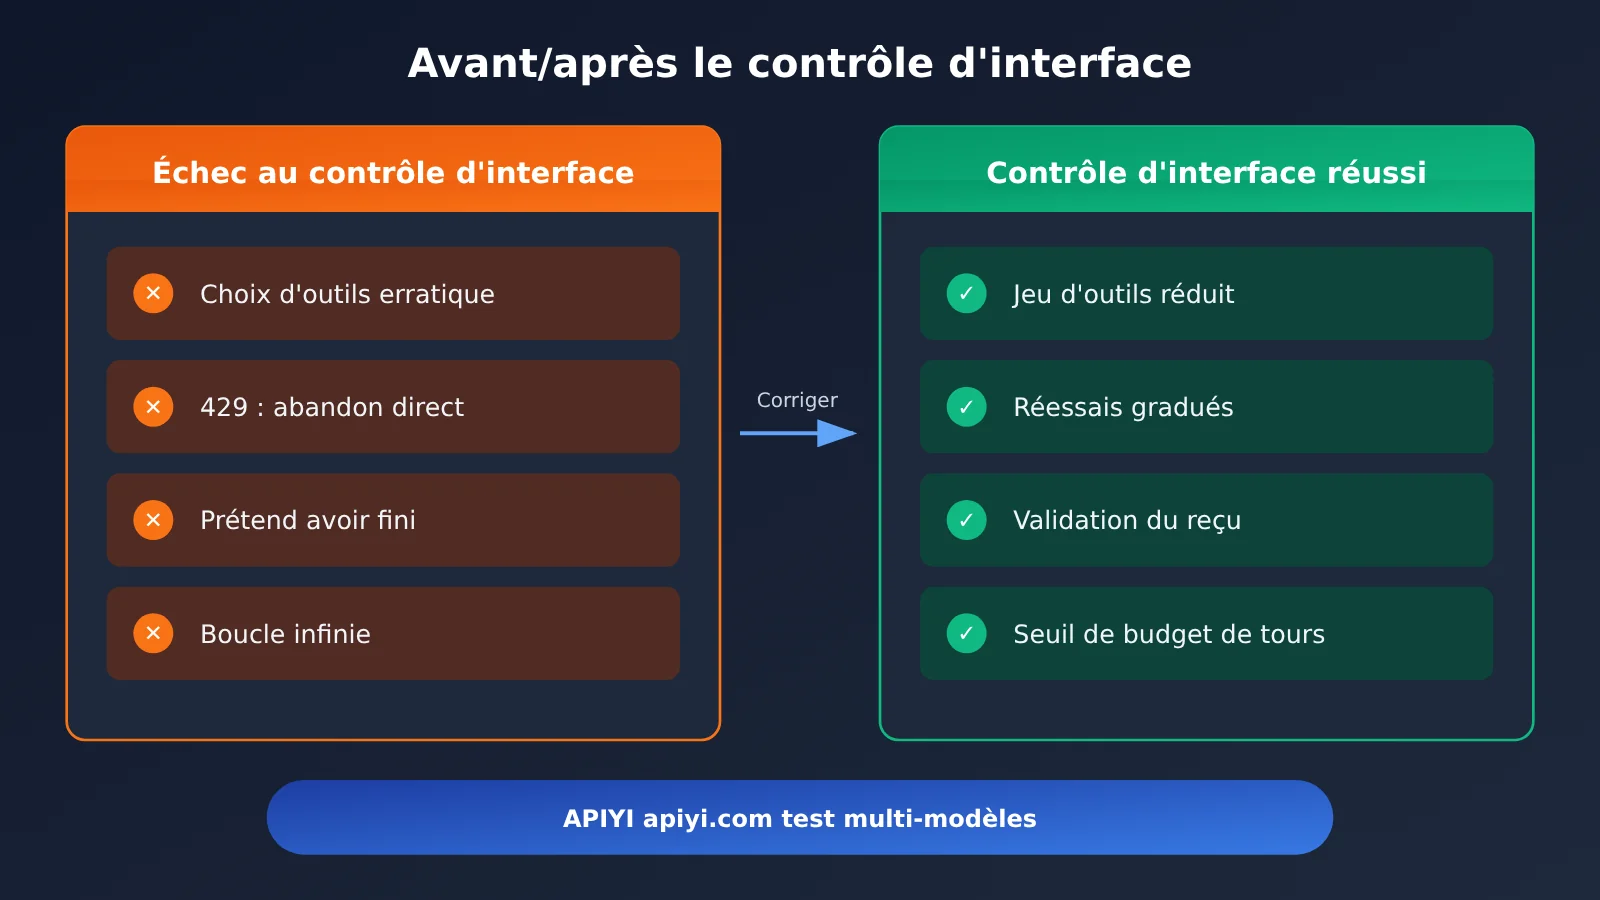
« Échouer et abandonner directement » et « échouer en faisant semblant que tout s’est bien passé » sont les deux comportements les plus dommageables pour l’expérience utilisateur dans nos tests réels. La bonne approche consiste à classer d’abord les erreurs par type, puis à décider s’il faut réessayer, dégrader le service ou informer honnêtement l’utilisateur.
| Type d’erreur | Causes courantes | Stratégie de l’Agent |
|---|---|---|
| Erreur 400 — paramètres invalides | Paramètres d’outil non valides, format de message décalé | Ne pas réessayer aveuglément : renvoyer le message d’erreur au modèle pour qu’il corrige une fois |
| 401 / 403 — authentification | Clé invalide ou permissions insuffisantes | Arrêter immédiatement et inviter l’utilisateur à vérifier sa configuration |
| 429 — limitation de débit | Concurrence trop élevée ou quota insuffisant | Réessayer avec un backoff exponentiel, basculer vers un modèle de secours si nécessaire |
| Erreur 5xx — côté serveur | Fluctuations du service en amont | Réessais en nombre limité, dégradation au-delà de la limite |
| Timeout | Sortie longue ou réseau instable | Passer à la sortie en streaming, ou découper en sous-tâches plus petites puis réessayer |
Un détail souvent négligé : les outils qui ont des effets de bord doivent être idempotents. Pour les opérations du type envoyer un e-mail, passer une commande ou écrire dans une base de données, il faut d’abord vérifier si l’action précédente a déjà pris effet avant de réessayer, sinon l’Agent fera deux fois la même chose.
Étape 5 : Ajouter des reçus d’exécution et un garde-fou de coûts à l’agent
Chaque exécution d’outil doit renvoyer un reçu structuré contenant au moins trois champs : « succès ou non », « ce qui a été fait » et « identifiant du résultat clé ». Avant que l’agent déclare une tâche terminée, c’est le programme — et non le modèle — qui doit vérifier le reçu. Cela élimine mécaniquement les déclarations de réussite mensongères.
En matière de coûts, je recommande d’ajouter trois garde-fous : un nombre maximal de cycles de boucle, un budget de jetons par tâche et une détection des appels répétés. Les travaux de planification, d’exécution et de classification peuvent être répartis entre des modèles de niveaux différents. Les longues invites système et les définitions d’outils doivent rester aussi stables que possible afin de profiter du cache des invites. Pour les prix unitaires d’entrée, de sortie et de cache, ainsi que les règles de facturation, référez-vous aux données réelles de la page tarifaire APIYI : https://docs.apiyi.com/models. Cet article ne donne aucun chiffre de prix non vérifié.
💡 Conseil : pendant la phase de mise en place, commencez par faire tourner toute la boucle avec un trafic réduit, puis ajoutez les outils progressivement. Grâce à APIYI apiyi.com, vous pouvez comparer rapidement, avec une même clé, la stabilité de différents modèles sur l’appel d’outils ; il suffit de modifier le champ
modelpour basculer.
Référence pour le choix des interfaces API par couche d’agent
Un agent doté d’une forte capacité d’exécution utilise rarement un seul modèle. Répartir les rôles par couche permet à la fois d’améliorer la stabilité et de faciliter la maîtrise des coûts.
| Couche de responsabilité | Exigences de capacité | Approche de sélection | Plateformes disponibles | Référence de prix |
|---|---|---|---|---|
| Couche de planification | Contexte long, raisonnement complexe, décomposition des tâches | Choisir un modèle phare doté de fortes capacités de raisonnement | APIYI apiyi.com, API officielle | Selon la page tarifaire d’APIYI |
| Couche d’exécution | Appels d’outils stables, réponse rapide | Choisir un modèle de milieu de gamme dont les appels d’outils sont stables | APIYI apiyi.com, API officielle | Selon la page tarifaire d’APIYI |
| Couche légère | Classification d’intentions, validation de format, compression de résumés | Choisir un petit modèle à faible latence et faible coût | APIYI apiyi.com, API officielle | Selon la page tarifaire d’APIYI |
Pour savoir quels modèles sont disponibles et quels sont les noms de modèles les plus récents, consultez la documentation APIYI sur docs.apiyi.com. Je vous conseille de lancer un lot d’échantillons de vos propres tâches réelles avec chaque modèle, puis de mesurer le taux de réussite des appels d’outils, le nombre moyen de tours et la consommation par tâche avant de décider quel modèle utiliser pour chaque couche. Ne vous fiez pas uniquement aux classements publics.
FAQ – Questions fréquentes
Q1 : Qu’appelle-t-on le « passage d’interface » d’un Agent ?
Il s’agit de la couche d’ingénierie que l’Agent doit franchir entre « avoir compris quoi faire » et « avoir fini de le faire » : définition des outils, protocole d’appel, gestion des erreurs, accusé de réception des résultats et maîtrise des coûts. Le modèle prend les décisions, la couche d’interface les concrétise de manière fiable. Si ce passage échoue, même un modèle très puissant paraîtra manquer d’exécution.
Q2 : Un manque d’exécution, c’est la faute du modèle ou de l’interface ?
Les deux, mais les problèmes d’interface sont plus souvent sous-estimés. Mauvais choix d’outil, format de paramètres incorrect, chaîne rompue, prétendre avoir terminé après un échec : une bonne partie de ces situations peut être atténuée en resserrant le schéma, en normalisant le renvoi des résultats et en ajoutant des contrôles d’accusé de réception. Mieux vaut d’abord solidifier la couche d’interface avant de juger s’il faut vraiment changer de modèle.
Q3 : Que révèle le test comparatif de trois Agents personnels ?
Ce reportage de test publié par 36Kr en novembre 2026 montre que les Agents personnels sont entrés dans la phase où l’on compare « qui arrive réellement à terminer la tâche » : le point de comparaison s’est déplacé de la qualité de la conversation vers la boucle d’exécution complète. Pour le détail des performances de chaque produit, reportez-vous à l’article d’origine ; le présent document ne fait que dégager les enseignements d’ingénierie généraux.
Q4 : Format OpenAI ou format Anthropic, lequel choisir ?
Cela dépend du modèle. La série Claude utilise nativement le format Anthropic, ce qui permet d’exploiter pleinement l’appel d’outils et le cache ; pour la plupart des autres modèles, le format OpenAI est plus universel. APIYI est compatible avec les deux formats : vous pouvez maintenir à l’intérieur de l’Agent une représentation intermédiaire unifiée, puis convertir selon le modèle au moment de la requête.
Q5 : Comment connecter rapidement plusieurs modèles à mon Agent ?
1. S’inscrire sur APIYI apiyi.com et récupérer une clé API ;
2. Configurer `base_url` en suivant la documentation docs.apiyi.com ;
3. Renseigner `model` séparément pour la couche de planification et la couche d’exécution, puis comparer les deux sur un même lot de tâches.
Aucune modification du SDK n’est nécessaire : il suffit d’ajuster les paramètres de configuration.
Q6 : Comment estimer le coût d’un Agent, et où consulter les tarifs ?
Commencez par mesurer le nombre moyen de tours par tâche, ainsi que les tokens d’entrée et de sortie, puis multipliez par le prix unitaire du modèle concerné. Les tarifs d’entrée, de sortie et de cache, ainsi que les règles de facturation, sont à vérifier sur la page de tarifs APIYI https://docs.apiyi.com/models : les écarts entre modèles sont importants, faites donc toujours le calcul sur la base de la page réelle.
Q7 : Plus j’ajoute d’outils, plus mon Agent devient instable : que faire ?
Exposez les outils de façon dynamique selon la phase de la tâche et ne donnez à chaque tour qu’un petit nombre d’outils pertinents. Vous pouvez aussi commencer par un modèle léger pour faire du routage et de la classification, puis transmettre le sous-ensemble d’outils correspondant au modèle d’exécution. Mieux vaut décrire clairement les limites d’usage dans la description des outils que d’empiler toujours plus d’exemples.
Q8 : Quelles limites subsistent une fois la couche d’interface bien faite ?
La couche d’interface améliore nettement la stabilité, mais elle ne résout ni le plafond de raisonnement du modèle lui-même, ni les changements survenant sur des sites ou services tiers. Pour les tâches à chaîne longue, mieux vaut conserver des points de confirmation humaine, en particulier pour les opérations irréversibles comme les paiements, les suppressions ou les envois vers l’extérieur.
Points clés sur la capacité d’exécution des interfaces d’Agent
- Les faiblesses d’exécution se logent surtout dans la couche interface : mauvais choix d’outil, chaîne d’appels rompue, achèvement annoncé sans l’être — dans la plupart des cas, il existe une solution d’ingénierie.
- Mieux vaut un jeu d’outils restreint qu’un jeu pléthorique : exposez les outils par étapes, et plus le schéma de paramètres est strict, plus le comportement est stable.
- Il faut isoler les différences de format : une représentation interne unifiée, puis une conversion vers le format OpenAI ou Anthropic au moment de la requête.
- Les erreurs doivent être classées : 400 → correction, 429 → backoff, 5xx → dégradation ; les opérations à effet de bord doivent être idempotentes.
- L’achèvement est déterminé par le programme : accusé de réception structuré et vérification d’état, pour éliminer les « faux achèvements ».
- Poser des garde-fous sur les coûts : limite du nombre de tours, budget de tokens, utilisation de modèles par paliers ; les prix font foi sur la page de tarifs d’APIYI.
- Pour démarrer : passez par le point d’entrée unifié d’APIYI pour accéder à plusieurs modèles ; il suffit de modifier
base_urletmodelpour comparer.
Conclusion
Les tests menés sur trois agents personnels sont un rappel utile pour les développeurs : la compétition entre agents est en train de passer de « savoir discuter » à « savoir aller au bout ». Pour combler le retard en exécution, l’investissement le plus rentable consiste à franchir d’abord le cap de l’interface :
- Appel d’outils : réduire le nombre d’outils, resserrer les schémas, normaliser le retour des résultats ;
- Tolérance aux pannes : classification des erreurs, nombre limité de tentatives, protection par idempotence ;
- Vérifiabilité et contrôle : accusés de réception structurés, validation par le programme, garde-fous sur les coûts.
Conseil : commencez par faire tourner une tâche réelle de bout en bout en boucle complète, puis étendez progressivement les capacités. Nous recommandons de passer par APIYI apiyi.com, qui est compatible avec les formats d’interface OpenAI et Anthropic, ce qui facilite la comparaison de la stabilité d’exécution entre différents modèles. Documentation : docs.apiyi.com ; les prix font foi sur https://docs.apiyi.com/models.
📚 Références
- 36 Kr : les agents personnels passent à table, qui a craqué le premier ? : reportage de test sur trois agents personnels
- Lien :
36kr.com/p/4055385191224452 -
Description : source du sujet de cet article ; pour le détail des produits et les résultats des tests, reportez-vous à l’article original
-
Centre de documentation APIYI : configuration de l’accès et modèles disponibles
- Lien :
docs.apiyi.com -
Description : configuration de
base_url, méthodes d’accès aux formats OpenAI et Anthropic -
Page tarifs des modèles APIYI : prix unitaires et base de facturation
- Lien :
docs.apiyi.com/models - Description : tous les éléments tarifaires de cet article s’appuient sur les données réelles de cette page
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via le site officiel APIYI, apiyi.com ; pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com