Note de l’auteur : le tarif de lancement de Gemini 4 Carbon se termine le 30 novembre 2026. cet article vous aide à refaire vos calculs de coûts avant l’échéance et à transformer la couche d’intégration en une structure où « changer de modèle ne demande que de modifier l’ID et le point de terminaison ».
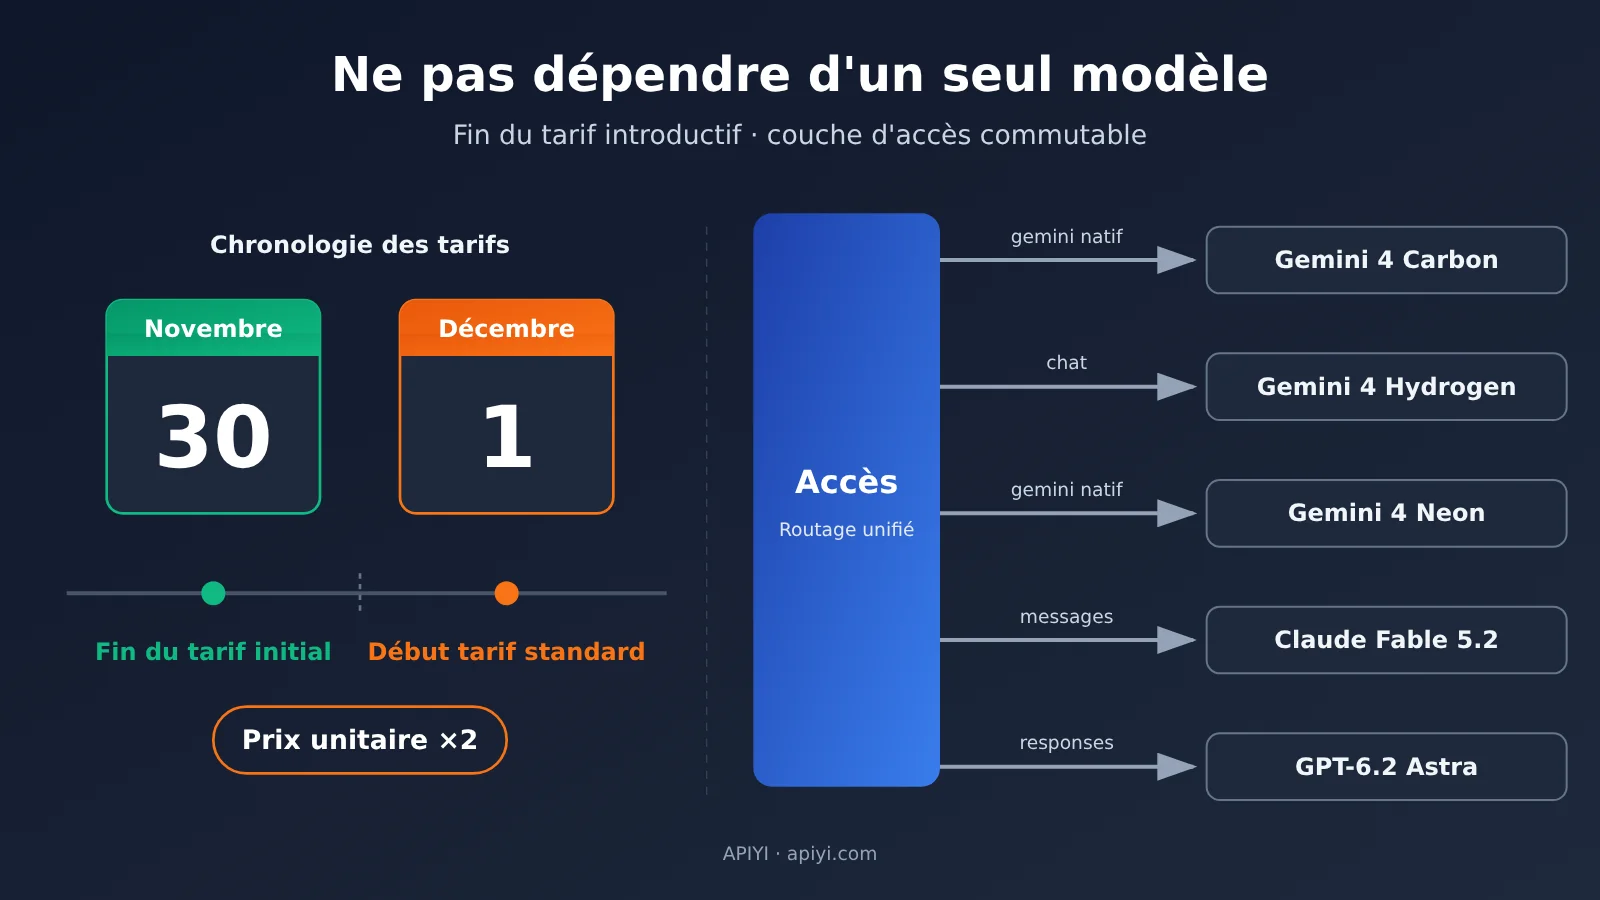
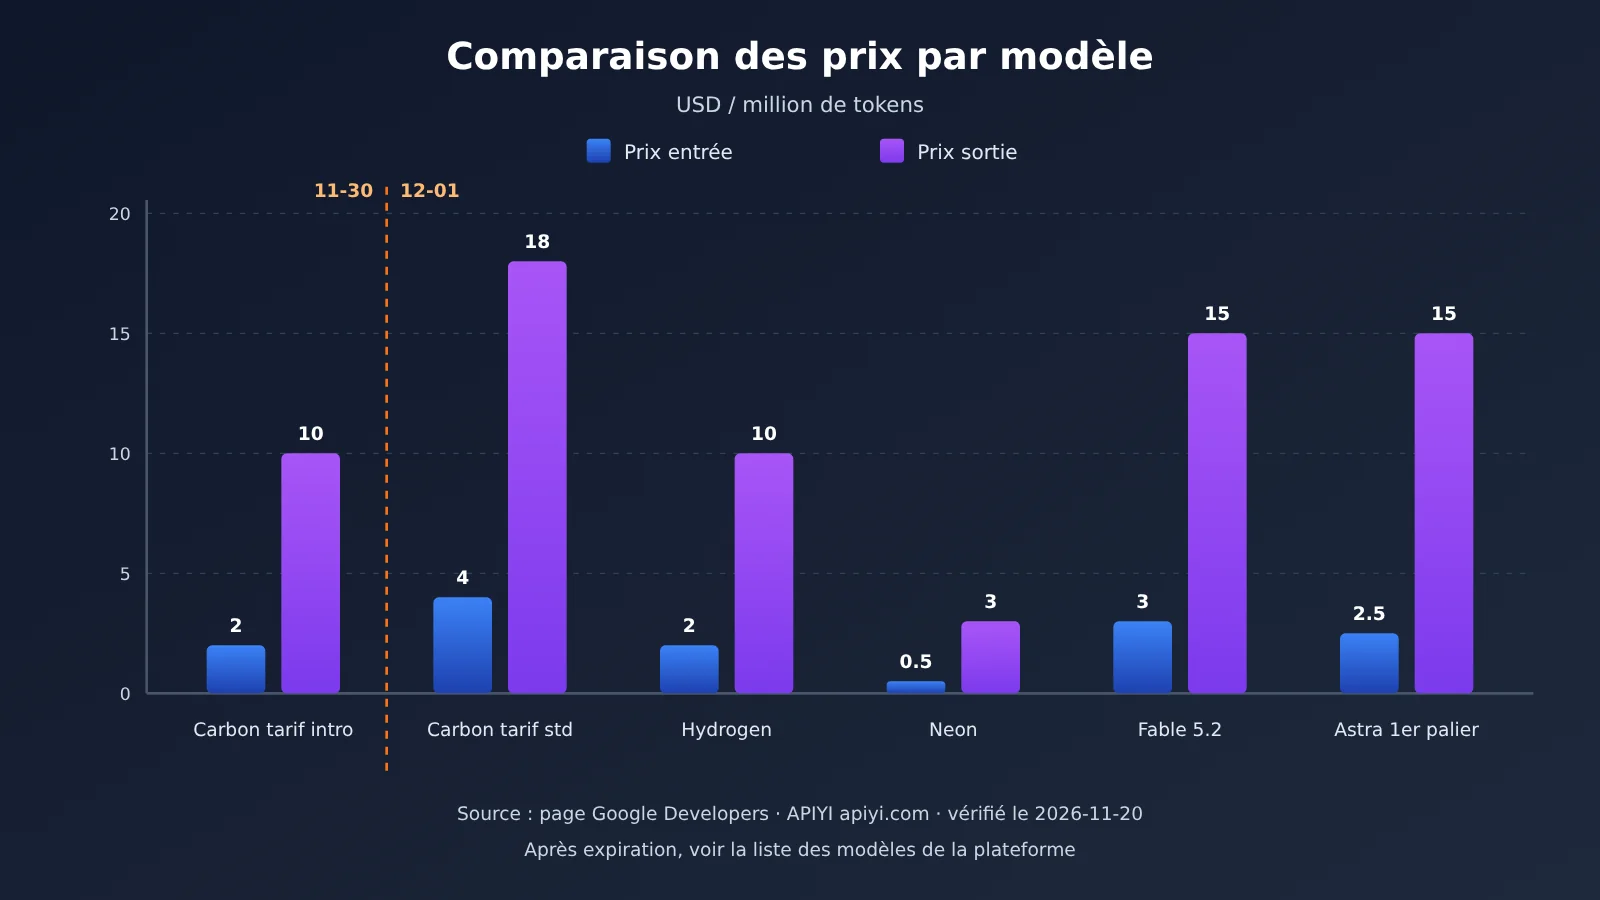
Si votre activité utilise déjà Gemini 4 Carbon, les 10 prochains jours méritent votre attention. La page développeurs de Google indique explicitement que le tarif de lancement de Gemini 4 Carbon court jusqu’au 2026-11-30 et que le tarif standard s’applique à partir du 2026-12-01, avec un doublement des prix unitaires d’entrée et de sortie. À la date du 2026-11-20, le tarif de lancement est encore en vigueur, et vous avez encore le temps d’ajuster votre modèle de coûts et votre code d’intégration.
Cet article ne vous pousse pas à changer de modèle sur-le-champ. Le changement ne sera pas forcément plus économique, et les résultats ne seront pas nécessairement équivalents. Il s’attaque à deux problèmes plus concrets : d’abord, comment refaire les calculs après l’échéance ; ensuite, comment transformer la couche d’appel en une structure capable de basculer à tout moment, pour que la prochaine variation de prix ou de fenêtre de contexte ne vous oblige à modifier que l’ID du modèle et le point de terminaison, sans réécrire tout l’appel.
L’essentiel : après lecture, vous aurez la date d’échéance, les montants des deux tarifs — tarif de lancement et tarif standard — ainsi que les points de terminaison à utiliser pour basculer vers Hydrogen, Neon, Fable ou Astra.
Gemini 4 Carbon : l’essentiel sur la fin du prix introductif
Commençons par rassembler les faits clés. Les chiffres du tableau proviennent de la page développeurs de Google et des informations tarifaires vérifiées par APIYI le 2026-11-20 ; ils sont exprimés en dollars par million de tokens.
| Point clé | Explication | Impact pour vous |
|---|---|---|
| Date de fin du prix introductif | Jusqu’au 2026-11-30 |
La facture de novembre est calculée au prix introductif |
| Prix introductif | Entrée 2, sortie 10, lecture du cache 0.10 |
Base de coût actuelle |
| Prix standard (à partir du 1er décembre) | Entrée 4, sortie 20, lecture du cache 0.20 |
À usage égal, le coût double environ |
| Offre actuelle sur APIYI | gemini-4-carbon entrée 2, lecture du cache 0.1, sortie 10 |
Aligné sur le prix introductif ; après l’échéance, se référer à la liste des modèles de la plateforme |
| Modèles de remplacement | Hydrogen, Neon, Fable, Astra | Points de terminaison différents : impossible de partager un même corps de requête |
Comment comprendre les deux grilles tarifaires de Gemini 4 Carbon
La différence entre le prix introductif et le prix standard est simple : l’entrée passe de 2 à 4, la sortie de 10 à 20, et la lecture du cache de 0.10 à 0.20 — les trois doublent. Le coût à partir de décembre correspond donc quasiment à « l’usage de novembre multiplié par 2 ». Si votre invite contient beaucoup de préfixes réutilisables et que le taux de réussite du cache est élevé, l’augmentation absolue de la partie lecture du cache sera un peu plus faible, mais la proportion reste un doublement.
Il faut bien distinguer le prix affiché sur APIYI apiyi.com. D’après la vérification du 2026-11-20, la plateforme indique pour gemini-4-carbon une entrée à 2, une lecture du cache à 0.1 et une sortie à 10, ce qui correspond au prix introductif de Google, pas au prix standard applicable après le 1er décembre. Une fois l’échéance passée, la façon dont la plateforme ajustera ses prix devra être vérifiée dans la liste des modèles du moment ; ne considérez pas le prix affiché aujourd’hui comme une garantie pour après décembre.
Pourquoi il ne faut pas se verrouiller sur un seul modèle
Si vous ne passez que par un seul modèle, le risque vient principalement de trois directions. D’abord, la révision des prix : la fin de la période introductive ou un ajustement promotionnel modifie directement le coût unitaire. Ensuite, la mise hors service ou le changement de nom d’un modèle : l’ancien ID devient soudain indisponible et les appels échouent massivement. Enfin, un même modèle peut avoir des niveaux de raisonnement et des fenêtres de contexte différents selon le point d’accès : des paramètres réglés à un endroit peuvent ne pas être pris en compte à un autre.
Ces trois types de changements ne dépendent pas de vous. Ce que vous pouvez contrôler, en revanche, c’est l’ampleur des modifications lorsqu’ils surviennent. Si l’ID du modèle, le type de point de terminaison et les paramètres de prix sont codés en dur dans le code métier, chaque changement impose de modifier le code, de retester et de redéployer. Si tout cela est centralisé dans la configuration de la couche d’intégration, un changement se limite à une ligne de configuration.
Comment recalculer le coût de Gemini 4 Carbon après expiration
Appliquez les deux grilles tarifaires à votre propre consommation
Le recalcul ne demande en réalité que trois chiffres : les tokens d’entrée par mois, les tokens de sortie par mois et les tokens lus depuis le cache par mois. Multipliez chacun par le prix unitaire correspondant, additionnez, et vous obtenez le coût mensuel. Voici une démonstration avec une consommation hypothétique : 100M tokens d’entrée et 20M tokens de sortie par mois, sans compter le cache pour l’instant. Cette consommation n’est qu’indicative, remplacez-la par les valeurs réelles figurant sur votre propre facture.
| Formule de facturation | Prix unitaire entrée | Prix unitaire sortie | Coût mensuel avec la consommation hypothétique |
|---|---|---|---|
| Prix de lancement Carbon (jusqu’au 11-30) | 2 |
10 |
100×2 + 20×10 = 400 dollars |
| Prix standard Carbon (à partir du 12-01) | 4 |
20 |
100×4 + 20×20 = 800 dollars |
gemini-4-hydrogen |
1.5 |
7.5 |
100×1.5 + 20×7.5 = 300 dollars |
gemini-4-neon |
3 |
15 |
100×3 + 20×15 = 600 dollars |
claude-fable-5-2 |
8 |
40 |
100×8 + 20×40 = 1600 dollars |
gpt-6.2-astra(premier palier) |
8 |
40 |
100×8 + 20×40 = 1600 dollars |
Ce tableau ne calcule que les prix unitaires, pas l’efficacité. Hydrogen a le prix unitaire le plus bas, mais savoir s’il peut remplacer Carbon dépend des exigences de votre tâche en matière de qualité de raisonnement et de stabilité du format. Fable et Astra ont des prix unitaires plus élevés ; ils conviennent aux étapes qui exigent une haute qualité et où l’on accepte de payer pour l’efficacité, plutôt qu’à une stratégie de réduction des coûts. Autrement dit, l’objectif du recalcul est de vous faire voir clairement le coût de chaque option, et non de supposer qu’un changement sera automatiquement plus économique.
Où vérifier les données tarifaires
Les prix d’APIYI peuvent être comparés via deux sources. La première est le tableau général des modèles, dont la version vérifiée le 2026-11-20 a été mise à jour le 2026-11-19 à 10:59 (UTC+8). La seconde est l’interface de tarification api.apiyi.com/api/pricing, en version shell-api-modelmak-v1, où un model_ratio de 1 correspond à 2 dollars par million de tokens en entrée, la sortie et le cache étant convertis respectivement via completion_ratio et cache_ratio.
Prenons gemini-4-neon : cette ligne n’apparaît pas dans le tableau général de cette version, mais elle figure dans l’interface de tarification : model_ratio à 1.5, completion_ratio à 5, cache_ratio à 0.05. Converti, cela donne 3 en entrée, 15 en sortie et 0.15 en lecture de cache, ce qui correspond aux prix affichés par Google. Je vous conseille de vous fier à l’interface de tarification pour établir vos budgets, et de consulter le tableau général à titre complémentaire.
gpt-6.2-astra a une tarification par paliers, il faut donc consulter les deux endroits. Le tableau général indique pour le premier palier 8 en entrée, 0.4 en lecture de cache et 40 en sortie, l’entrée passant à 16 au-delà de 272000 tokens ; l’interface de tarification indique, elle, qu’au-delà de 272000 tokens la sortie est facturée à 60 et la lecture de cache à 0.8. Si vos requêtes individuelles ont souvent un contexte très long, cette tarification par paliers pèse lourd sur le coût et doit être estimée séparément.
💰 Conseil pour vérifier les coûts : avant et après l’expiration, récupérez une fois l’interface de tarification et la liste des modèles d’APIYI apiyi.com, puis écrivez les prix unitaires dans votre configuration de routage plutôt que de les coder en dur dans les commentaires du code. Ainsi, lors du rapprochement mensuel, il suffit de comparer la configuration et les données de la plateforme pour voir si elles concordent.
Tableau de correspondance des endpoints pour les modèles de remplacement de Gemini 4 Carbon
Avant de changer de modèle, vérifiez les endpoints — ne partez pas du principe que le corps de requête est universel
C’est l’étape où l’on trébuche le plus facilement. Beaucoup d’équipes pensent « tout passe par une interface compatible OpenAI, il suffit de changer le champ model », alors qu’en réalité certains modèles recommandent des endpoints totalement différents, avec des champs de corps de requête qui ne sont pas les mêmes. Le tableau ci-dessous récapitule les types d’endpoints recommandés pour les modèles de remplacement ; tous les appels passent par l’adresse de base https://api.apiyi.com/v1.
| ID du modèle | Endpoint recommandé | Prix unitaire entrée / lecture cache / sortie | Points d’attention lors du changement |
|---|---|---|---|
gemini-4-carbon |
chat ou gemini natif | 2 / 0.1 / 10 (catalogue actuel) |
À l’expiration, se référer à la liste des modèles |
gemini-4-hydrogen |
chat ou gemini natif | 1.5 / 0.075 / 7.5 |
Endpoints identiques à Carbon, changement minimal |
gemini-4-neon |
chat ou gemini natif | 3 / 0.15 / 15 |
Les prix font foi via l’endpoint de tarification |
claude-fable-5-2 |
chat ou messages | 8 / 0.2 / 40 |
Les capacités natives sont plus complètes via messages |
claude-fable-5-2-thinking |
chat ou messages | 8 / 0.2 / 40 |
Le palier « réflexion » est un ID à part |
gpt-6.2-astra |
responses recommandé | premier palier 8 / 0.4 / 40 |
Au-delà de 272000 tokens, tarification par paliers |
Par ailleurs, gemini-4-argon figure aussi dans le tableau général, avec un tarif de 2 en entrée, 0.1 en lecture de cache et 10 en sortie, soit le même prix que Carbon sur le catalogue actuel. Les informations sur ses endpoints ne sont pas couvertes par les références de cet article : si vous l’envisagez, vérifiez d’abord l’endpoint recommandé dans la documentation de la plateforme avant de l’intégrer.
Où se situent les différences entre ces trois types d’endpoints
L’endpoint chat correspond au format de complétion de conversation compatible OpenAI ; le cœur du corps de requête est le champ model et le tableau messages, et la plupart des SDK utilisent ce format par défaut. L’endpoint gemini natif utilise la structure de requête propre à Gemini, adaptée aux scénarios qui ont besoin des paramètres natifs (par exemple une configuration de réflexion spécifique). L’endpoint messages est le format natif de Claude : la façon de placer le prompt système et la structure des blocs de contenu diffèrent de chat. L’endpoint responses est une forme d’interface plus récente d’OpenAI, et c’est là que gpt-6.2-astra est recommandé.
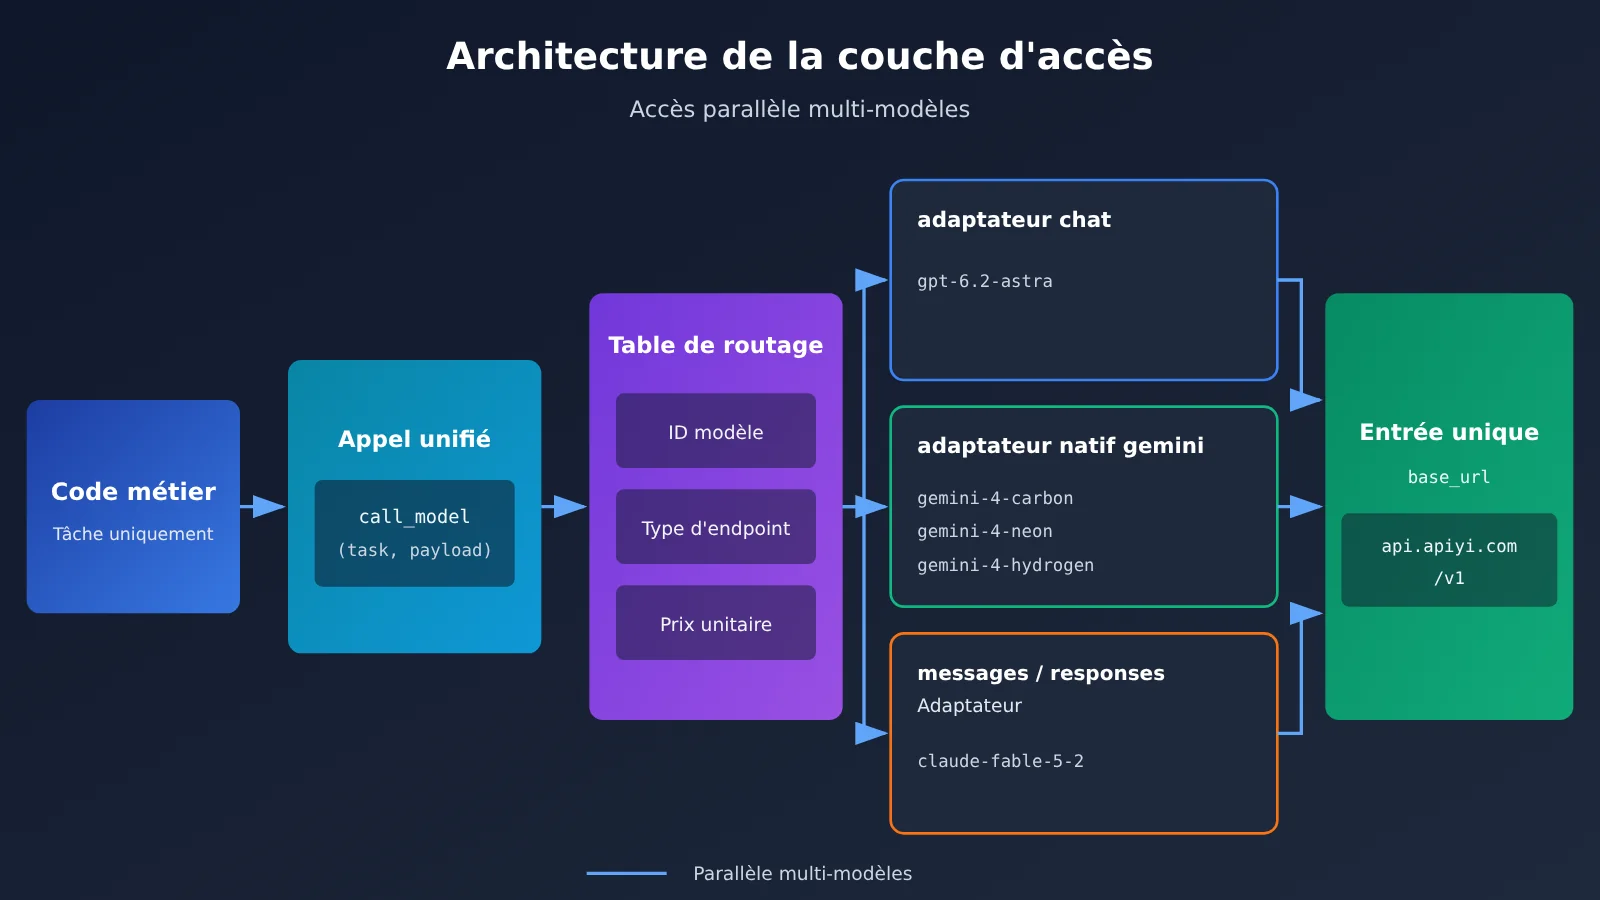
Une couche d’intégration robuste devrait donc prévoir un adaptateur indépendant pour chaque type d’endpoint : le code métier ne transmet que « type de tâche + contenu », et l’adaptateur se charge d’assembler le format correspondant. Pour les chemins d’endpoints et les champs exacts, référez-vous aux indications du centre de documentation APIYI.
🎯 Conseil technique : avant de basculer, utilisez la même clé API d’APIYI apiyi.com pour envoyer quelques vraies requêtes métier sur l’endpoint recommandé de chaque modèle candidat, confirmez que la structure de réponse, le comportement du palier de réflexion et la longueur de contexte correspondent bien à vos attentes, puis seulement modifiez la configuration de routage.
Prise en main rapide de la couche d’accès commutable Gemini 4 Carbon
Exemple minimal : un client unifié
Dans cette section, pas de longs blocs de code : uniquement la configuration clé. Lors de l’initialisation du client avec le SDK compatible OpenAI, seuls deux paramètres sont nécessaires : client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1"). Ensuite, pour appeler le point de terminaison chat, écrivez client.chat.completions.create(model="gemini-4-carbon", messages=msgs). Pour passer à Hydrogen, il suffit de remplacer model par gemini-4-hydrogen, car les deux partagent le point de terminaison chat et le corps de la requête n’a pas besoin d’être modifié.
Pour passer à gpt-6.2-astra, la situation est différente. L’approche recommandée est client.responses.create(model="gpt-6.2-astra", input=msgs) : le nom du paramètre passe de messages à input, et la structure de retour est également différente. C’est précisément pourquoi la couche d’accès doit séparer les adaptateurs par point de terminaison, plutôt que de simplement changer le nom du modèle.
Étapes complètes de la refonte
Pour transformer un appel mono-modèle en une structure commutable, on peut procéder dans cet ordre :
- Extraire la configuration de routage : créez une table de configuration où chaque ligne contient le nom de la tâche, l’ID du modèle, le type d’endpoint, le prix d’entrée, le prix de sortie et le prix de lecture du cache. Le code métier ne connaît que le nom de la tâche.
- Écrire un adaptateur par endpoint : implémentez séparément quatre adaptateurs — chat, gemini natif, messages et responses. Chacun se charge de convertir l’entrée unifiée en corps de requête correspondant, puis de transformer la valeur de retour en structure unifiée.
- Unifier l’URL de base et la clé : tous les adaptateurs partagent le même
base_urlet la même clé API ; changer de modèle ne demande donc aucune gestion de clé supplémentaire. - Ajouter une chaîne de repli : pour les tâches critiques, configurez un modèle principal et un modèle de secours — par exemple
gemini-4-carbonen principal etgemini-4-hydrogenen secours — afin de basculer automatiquement sur le secours si le principal renvoie une erreur ou est retiré. - Instrumenter les coûts : à chaque appel, enregistrez l’ID du modèle et l’usage de tokens, estimez le coût en temps réel avec les prix unitaires de la table de configuration, puis comparez avec la facture en fin de mois.
Voir un exemple de champs de configuration de routage
Une ligne de configuration de routage typique peut contenir ces champs : `task: « summary »`, `model: « gemini-4-carbon »`, `endpoint: « chat »`, `price_in: 2`, `price_out: 10`, `price_cache: 0.1`, `fallback: « gemini-4-hydrogen »`. Après le 1er décembre, il vous suffit de mettre à jour `price_in` et `price_out` selon la liste des modèles de la plateforme, ou de remplacer `model` et `endpoint` : le code métier n’a pas du tout besoin d’être modifié.
Pour un modèle à tarification par paliers comme `gpt-6.2-astra`, nous conseillons d’ajouter un champ `tier_threshold: 272000` ainsi que le champ de prix unitaire du palier supérieur correspondant ; le module d’instrumentation des coûts déterminera, à partir du nombre de tokens d’une requête, dans quel palier elle tombe.
🚀 Démarrage rapide : si vous n’avez pas encore de point d’entrée unifié, vous pouvez d’abord vous inscrire sur APIYI apiyi.com pour obtenir une clé API et un crédit d’essai gratuit, puis faire tourner Carbon, Hydrogen, Neon, Fable et Astra avec une seule clé avant de décider comment configurer le routage.
Liste de vérifications avant l’échéance
| Point à vérifier | Échéance conseillée | Description |
|---|---|---|
| Exporter l’usage de novembre | Avant le 25/11 | Récupérer les nombres réels de tokens pour les trois postes : entrée, sortie et lecture de cache |
| Appliquer les deux grilles tarifaires | Avant le 26/11 | Calculer le coût mensuel séparément avec le tarif de lancement et le tarif standard |
| Tester les modèles candidats | Avant le 28/11 | Envoyer une série de requêtes réelles sur chaque endpoint recommandé |
| Mettre en production la configuration de routage | Avant le 30/11 | Intégrer les modèles principal et de secours ainsi que les prix unitaires dans la configuration |
| Revérifier les prix de la plateforme | Après le 01/12 | Mettre à jour les prix unitaires en se basant sur la liste des modèles de la plateforme |
FAQ : questions fréquentes
Q1 : Jusqu’à quand exactement s’applique le tarif de lancement de Gemini 4 Carbon ?
D’après la page développeurs de Google, le tarif de lancement court jusqu’au 2026-11-30. Pendant cette période : entrée `2`, sortie `10`, lecture du cache `0.10` USD par million de tokens. À partir du 2026-12-01, on passe au tarif standard : entrée `4`, sortie `20`, lecture du cache `0.20`.
Q2 : Combien coûtera Carbon sur APIYI après décembre ?
Pour l’instant, sur le catalogue APIYI, `gemini-4-carbon` est à entrée `2`, lecture du cache `0.1`, sortie `10`, ce qui correspond au tarif de lancement. Pour le prix après le 1er décembre, référez-vous à la liste des modèles de la plateforme. Cet article ne garantit aucun tarif affiché après cette date ; une fois l’échéance passée, je vous conseille de vérifier directement sur APIYI apiyi.com.
Q3 : Combien de code faut-il modifier pour passer de Carbon à Hydrogen ?
Le changement est minimal. Les deux utilisent le même endpoint recommandé : chat ou Gemini natif. Si vous passez déjà par l’endpoint chat, il suffit de remplacer le champ `model` de `gemini-4-carbon` par `gemini-4-hydrogen`. Cela dit, validez toujours avec de vraies requêtes : un prix unitaire plus bas ne veut pas dire que la qualité sera équivalente pour votre tâche.
Q4 : Pourquoi ne peut-on pas simplement changer le nom du modèle pour passer à Claude Fable ou GPT Astra ?
Parce que les endpoints recommandés diffèrent. `claude-fable-5-2` peut passer par chat ou messages ; pour les capacités natives, messages est plus complet. `gpt-6.2-astra` est recommandé via responses, et les paramètres de requête comme la structure de réponse ne sont pas les mêmes que pour chat. Si vous changez juste le nom du modèle, vous tomberez souvent sur des champs non reconnus ou des erreurs d’analyse.
Q5 : Sur quelle source se fier pour le prix de Gemini 4 Neon ?
La table récapitulative des modèles dans sa version du 2026-11-19 ne contient pas la ligne Neon, mais l’endpoint de tarification la propose. Une fois converti : entrée `3`, sortie `15`, lecture du cache `0.15`, ce qui correspond au tarif affiché par Google. Pour établir un budget, fiez-vous donc à l’endpoint de tarification ; l’endpoint reste chat ou Gemini natif.
Q6 : Comment comparer rapidement plusieurs modèles candidats avec une seule clé ?
Je recommande de passer par une plateforme d’agrégation d’API pour tester de manière unifiée :
1. Inscrivez-vous sur APIYI apiyi.com, récupérez une clé API et le quota d’essai gratuit
2. Configurez le `base_url` du client sur l’adresse unifiée, puis appelez chaque modèle via son endpoint recommandé
3. Notez la consommation de tokens et la qualité de sortie de chaque modèle, puis reportez ces valeurs dans le tableau de recalcul de cet article
Q7 : Quelles sont les limites de cette couche d’accès interchangeable ?
La couche d’accès permet seulement de réduire le coût des changements ; elle n’élimine pas les écarts de qualité. D’un modèle à l’autre, la compréhension d’une même invite, le respect du format et le comportement du niveau de réflexion peuvent changer. Après un changement, il faut donc refaire des tests de non-régression. Par ailleurs, les modèles à tarification par paliers (comme Astra au-delà de `272000` tokens) doivent être estimés séparément : une formule de coût unifiée sous-estimera les requêtes avec un contexte long.
Gemini 4 Carbon : fin du tarif de lancement — points clés
- Date de fin claire : le tarif de lancement est valable jusqu’au 2026-11-30 ; le tarif standard s’applique à partir du 1er décembre.
- Coût environ doublé : le tarif standard est le double du tarif de lancement sur les trois postes — entrée, sortie et lecture du cache.
- Le prix catalogue n’est pas un engagement : le tarif Carbon actuel d’APIYI correspond au tarif de lancement ; après l’expiration, c’est la liste des modèles qui fera foi.
- Des endpoints différents selon les modèles : Hydrogen et Neon passent par chat ou gemini ; Fable par chat ou messages ; pour Astra, responses est recommandé.
- Changer de modèle ne garantit pas de faire des économies : Hydrogen a un prix unitaire bas, Fable et Astra un prix unitaire élevé ; il faut arbitrer en tenant compte des résultats.
- La configuration est la clé : l’ID du modèle, l’endpoint et le prix unitaire entrent dans la configuration de routage ; le code métier ne connaît que le nom de la tâche.
- Un point d’entrée unifié facilite la validation : avec une seule clé APIYI, testez plusieurs modèles candidats de bout en bout avant de choisir le routage.
Résumé
La fin du tarif de lancement de Gemini 4 Carbon se résume en trois points essentiels :
- Faites d’abord vos calculs : appliquez à vos volumes réels le tarif de lancement, puis le tarif standard. À partir de décembre, un même volume d’usage coûtera environ deux fois plus cher.
- Vérifiez ensuite les endpoints : les endpoints recommandés pour les modèles de remplacement ne sont pas identiques. Avant de changer de modèle, vérifiez les formats de requête de chat, gemini, messages et responses.
- Configurez enfin : regroupez l’ID du modèle, le type d’endpoint et le prix unitaire dans la configuration de routage. La prochaine fois que les prix ou les fenêtres de contexte changeront, seule la configuration sera à modifier, pas le code.
Il reste 10 jours avant le 30 novembre : largement de quoi exporter vos volumes d’usage, recalculer avec les deux grilles tarifaires et tester les modèles candidats. Ne figez pas votre activité sur un seul modèle et un seul tarif ; prévoir dans la couche d’accès une possibilité de bascule est la préparation la plus sûre face à la prochaine évolution.
Pour une intégration unifiée, nous recommandons APIYI apiyi.com : avec une seule clé API, validez les résultats et comparez les coûts entre plusieurs modèles et endpoints.
📚 Références
-
Page développeurs Google – Tarification de Gemini : prix d’introduction et prix standard de Gemini 4 Carbon
- Lien :
ai.google.dev - Détails : date de fin du prix d’introduction et prix standard applicable à partir du 1er décembre
- Lien :
-
Tableau récapitulatif des modèles APIYI : prix unitaires d’entrée, de sortie et de lecture du cache pour chaque modèle
- Lien :
docs.apiyi.com/models.md - Détails : version vérifiée le 2026-11-20, mise à jour le 2026-11-19 à 10:59 (UTC+8)
- Lien :
-
API de tarification APIYI : prix en temps réel convertis selon un coefficient multiplicateur
- Lien :
api.apiyi.com/api/pricing - Détails : version
shell-api-modelmak-v1, adaptée à la lecture programmatique des prix unitaires
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI. Les points de terminaison et les descriptions des paramètres de chaque modèle sont disponibles dans le centre de documentation.