Résumé : l’expérience Saltline, racontée par son propre développeur, montre comment une génération de code de longue durée peut aboutir à un prototype jouable. Pour comprendre l’estimation du coût API, il faut tenir compte de la facturation du cache et de celle des tokens de sortie.
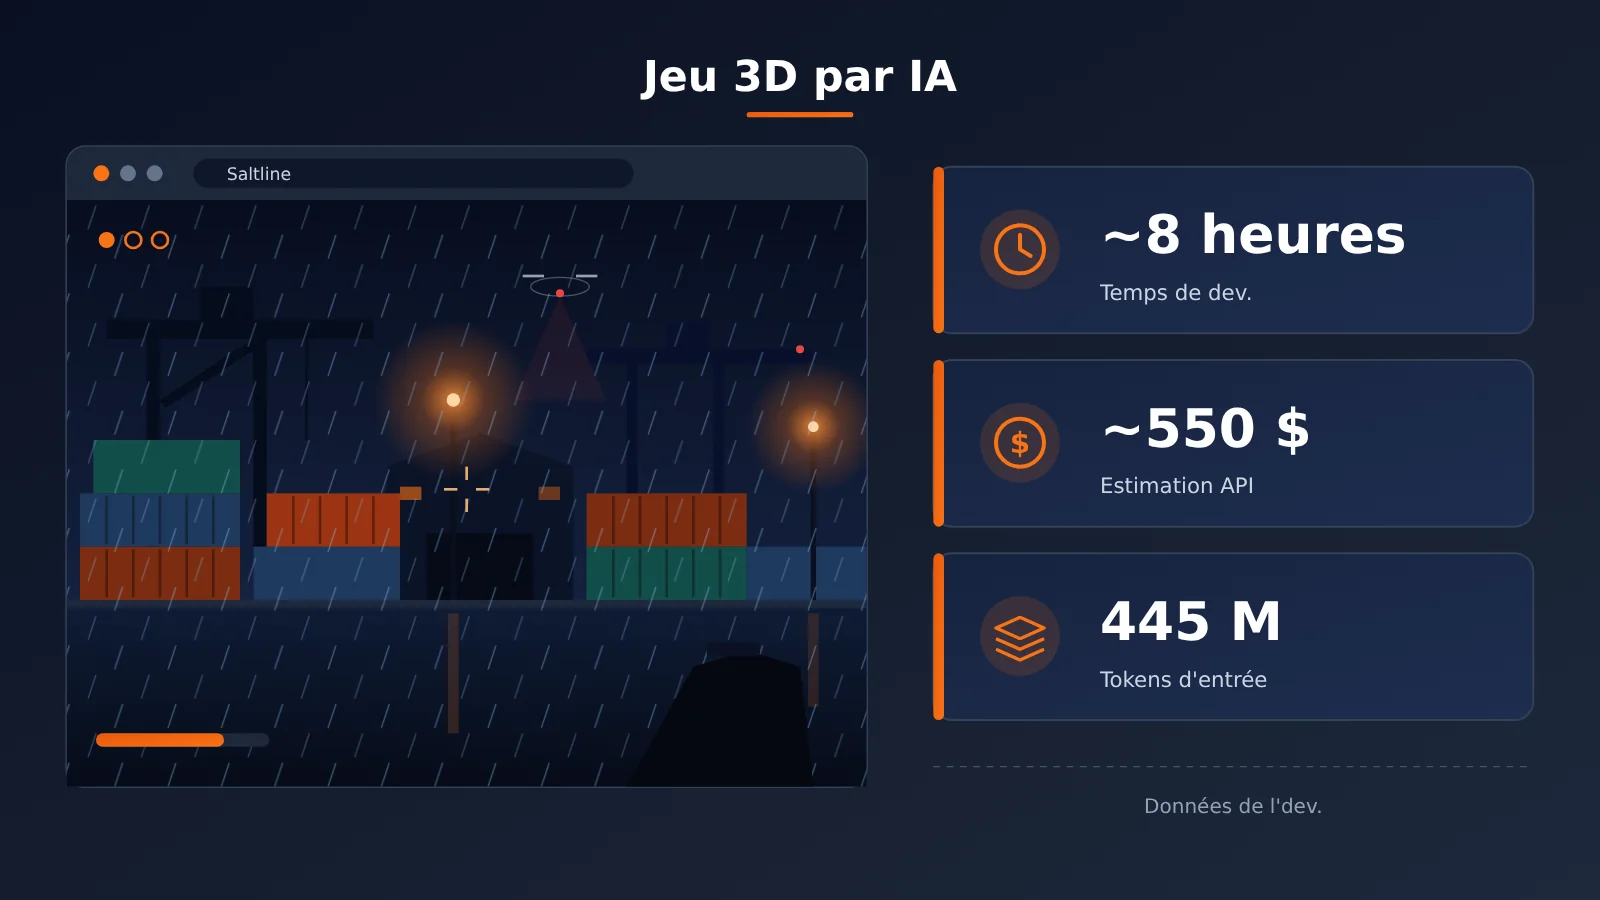
Le 9 novembre 2026, l’ingénieur d’Anthropic Felix Rieseberg a rendu publique une expérience. Il n’a donné à Claude Fable 5.2 qu’une seule invite, sans apporter ensuite le moindre retour humain, et a obtenu un jeu de tir à la première personne en 3D directement exécutable dans le navigateur, Saltline. Selon ses propres dires, cette génération a duré environ 8 heures, consommé environ 445 millions de tokens d’entrée et environ 2,7 millions de tokens de sortie, pour un coût estimé à environ 550 dollars aux tarifs de l’API.
Deux points méritent surtout l’attention dans cette expérience. Premièrement, le modèle a réuni dans une même tâche de génération de code de longue durée des travaux qui relèvent normalement de postes différents : construction des scènes, logique de jeu, modèles et textures, shaders, effets sonores et interactions avec le joueur — tout le contenu visuel existant sous forme de code et de fonctions. Deuxièmement, si les 445 millions de tokens d’entrée étaient facturés au tarif d’entrée standard, la note dépasserait 3 500 dollars, alors que l’estimation rapportée par le développeur n’est que d’environ 550 dollars ; l’écart provient principalement du mécanisme de cache. L’économie des tâches complexes de développement assisté par IA dépend du degré de réutilisation du contexte : conclure à partir des seuls prix unitaires d’entrée et de sortie donne une image très faussée.
La suite présente d’abord les données publiques et les conditions de l’expérience Saltline, puis décompose les étapes du développement d’un jeu que l’IA a réellement prises en charge, avant de recalculer à partir des tarifs officiels de Fable 5.2 l’origine des 550 dollars et les limites de ce qui reste reproductible. Elle propose ensuite un cadre de coûts qui distingue l’invocation du modèle, l’exécution du développement et l’exploitation du produit, et se termine par la distance entre ce type de développement IA autonome et un jeu commercial, du prototype jouable à la réalité du marché.
À savoir : comprendre la terminologie de l’expérience de jeu 3D par IA
| Terme | Explication |
|---|---|
| Token | Unité de mesure utilisée par le modèle pour traiter les entrées et les sorties ; l’API facture en fonction du nombre de tokens. |
| API | Interface permettant à une application d’appeler le service du modèle ; les développeurs l’utilisent pour intégrer le modèle à leur propre programme. |
| Cache d’entrée (Prompt Caching) | Conserve les résultats du traitement des contextes récurrents afin de les réutiliser directement lors des requêtes suivantes, ce qui réduit les coûts et la latence. |
| Écriture du cache | Enregistre pour la première fois un contexte réutilisable dans le cache ; le prix unitaire est généralement plus élevé que celui d’une entrée normale. |
| Lecture du cache | Les requêtes suivantes utilisent un cache existant et sont facturées à un prix bien inférieur à celui d’une entrée normale. |
| TTL | Durée de validité du cache ; une fois expiré, il faut le réécrire. Fable 5.2 propose deux durées : 5 minutes et 1 heure. |
| Batch API | Mode d’appel destiné aux tâches asynchrones par lots, adapté aux scénarios qui n’ont pas besoin d’une réponse immédiate et qui peuvent bénéficier d’une remise. |
| Agent | Application de modèle capable d’appeler des outils, de lire et d’écrire des fichiers et d’exécuter des tâches en plusieurs étapes. |
| Prototype jouable | Version initiale d’un jeu servant à valider la jouabilité et la faisabilité technique ; le contenu et le niveau de finition sont limités. |
| Shader | Petit programme exécuté sur le GPU, qui utilise des fonctions mathématiques pour déterminer les couleurs, l’éclairage et le rendu des matériaux. |
| Génération procédurale | Construction de modèles, textures, sons et autres contenus à l’exécution à l’aide de règles et d’algorithmes, au lieu de fichiers d’assets préparés à l’avance. |
| WebGL / Three.js | WebGL est l’interface de rendu 3D permettant au navigateur d’exploiter le GPU ; Three.js est une bibliothèque JavaScript de graphisme 3D basée sur WebGL. |
1 8 heures, 550 dollars : comment un jeu 3D généré par IA a vu le jour
1.1 Conditions de l’expérience : une seule invite, aucun retour humain
Felix Rieseberg avait fixé une mission claire au modèle : réaliser un petit jeu de tir à la première personne dont le rendu visuel s’approche autant que possible d’un jeu AAA, sans fournir ensuite le moindre retour humain. Au moment de publier son résultat, il a souligné que ce qu’il cherchait à mesurer, c’était précisément jusqu’où le modèle pouvait aller sans intervention humaine.
Le « 3A » dont il est question ici est un objectif d’expérience et une analogie visuelle. AAA désigne en général des jeux commerciaux haut de gamme, produits avec des moyens financiers et humains considérables ; Saltline, de son côté, est un prototype jouable de petite envergure, avec un seul niveau de mission et une expérience essentiellement solo.
1.2 Le contenu de jeu de Saltline
Saltline se déroule dans un port à conteneurs, par une nuit de pluie, avec des entrepôts, des quais et des piles de conteneurs. Le joueur doit désactiver trois relais de signal puis évacuer, en croisant sur sa route des drones de patrouille aériens et des chiens mécaniques au sol.
Le jeu gère le déplacement à la première personne, le contrôle de la caméra, le tir, les interactions et les objectifs de mission, et ajoute de la pluie, des éclairages, des sons d’ambiance et des effets d’armes. L’accès reste très léger : il suffit d’ouvrir le navigateur pour jouer, au clavier-souris ou au tactile ; la page propose des réglages de qualité graphique, et en cas de ralentissement on peut basculer en qualité basse.
1.3 Les chiffres publiés par le développeur
Toutes les données ci-dessous proviennent d’informations que Felix Rieseberg a lui-même publiées sur X ; le miroir GitHub précise également que ces chiffres n’ont pas fait l’objet d’un audit indépendant par un tiers.
| Élément | Valeur déclarée par le développeur |
|---|---|
| Modèle | Claude Fable 5.2 |
| Temps de développement | environ 8 heures |
| Tokens d’entrée | environ 445 millions (recours massif au cache) |
| Tokens de sortie | environ 2,7 millions |
| Coût estimé | environ 550 dollars (estimation d’après les tarifs de l’API) |
| Méthode de développement | une seule invite, sans itération avec retour humain |
| Taille du livrable | version HTML autonome d’environ 1.43MB (1,425,707 bytes) |
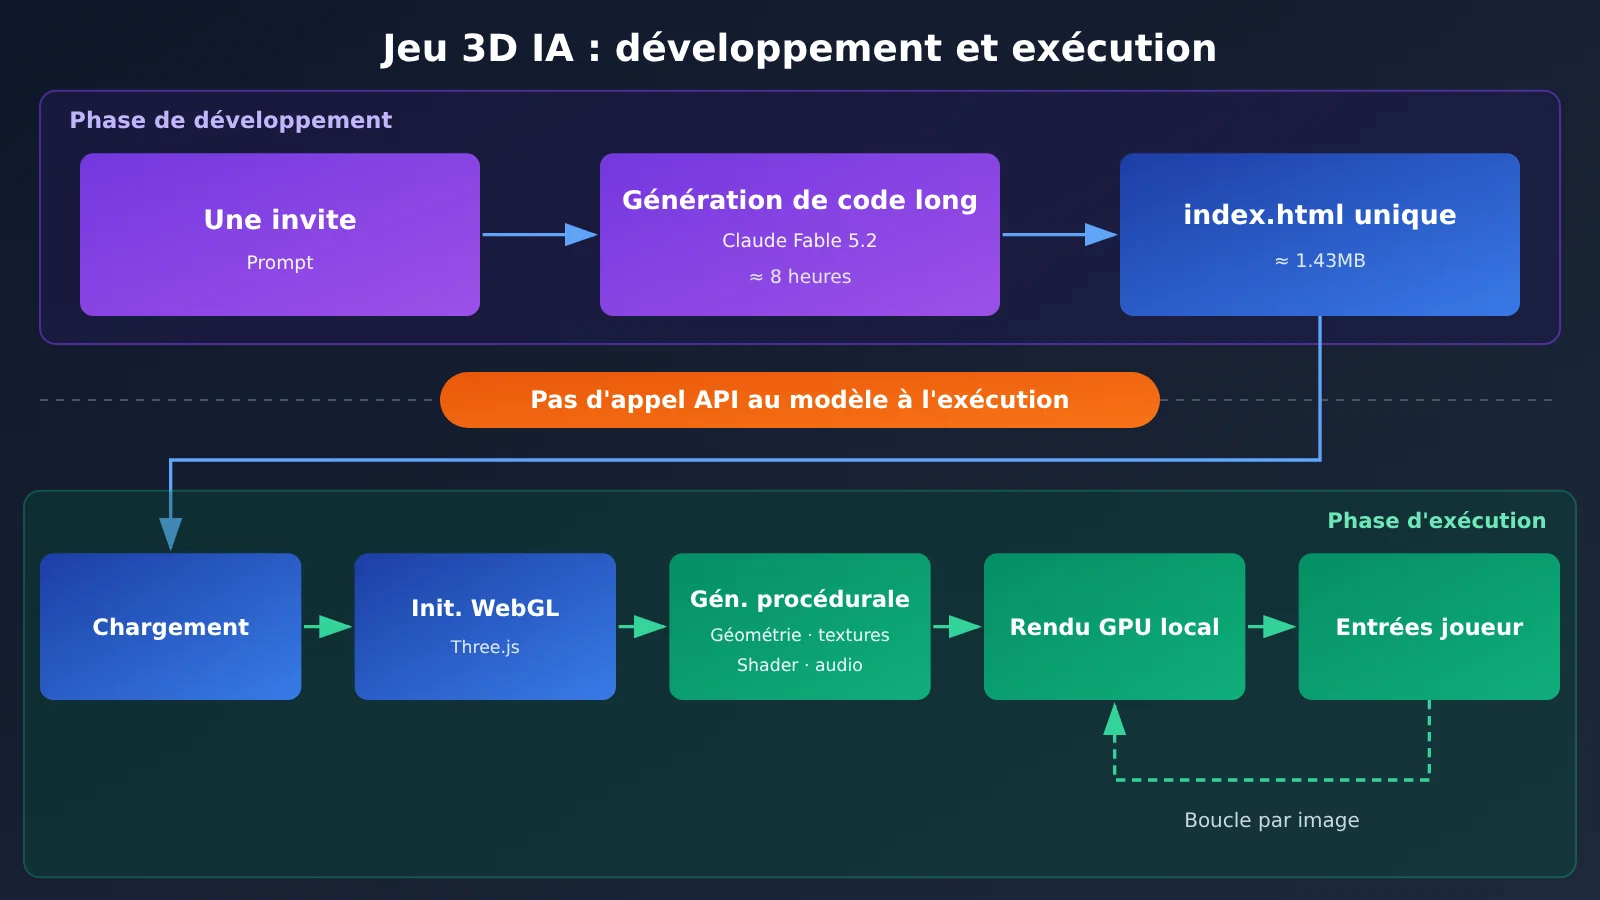
Les 550 dollars correspondent à une estimation de ce qu’a coûté cette expérience de génération par le modèle. Une fois le fichier du jeu produit, il tourne dans le navigateur du joueur sans déclencher de nouvel appel à l’API Claude : ce montant n’a donc aucun lien avec le nombre de joueurs.
2 Ce que l’IA a accompli dans le développement de ce jeu 3D
2.1 Tous les modèles et textures sont du code
Le 10 novembre, le développeur a précisé : les modèles, textures et autres éléments du jeu sont entièrement construits à partir de code et de shaders générés par Claude, et le projet ne contient aucun fichier image ou modèle 3D séparé. Pour le résumer avec ses propres mots : « tout est code, les textures et les modèles sont des fonctions ».
Cela explique pourquoi Saltline ne pèse qu’environ 1,43 Mo. Un jeu traditionnel doit distribuer un grand nombre de modèles, textures et fichiers audio déjà fabriqués ; Saltline, lui, distribue les règles mathématiques qui génèrent ces contenus, et le navigateur lit le code puis construit la scène en temps réel à l’exécution.
2.2 Six étapes intégrées dans une seule tâche de génération
Le développement classique d’un jeu 3D implique généralement des rôles distincts : design, modélisation, matériaux, programmation, audio, etc. Dans Saltline, le modèle a traité successivement, au sein d’un même projet, les travaux suivants :
- Construction de la scène : construction procédurale des ports, entrepôts, conteneurs et autres structures à partir de sommets et de paramètres géométriques.
- Logique de jeu : objectifs de mission, comportement des ennemis, détection des tirs et procédure d’extraction.
- Modèles et textures : génération de surfaces métalliques, de salissures et de variations de couleur à l’aide de bruit et de fonctions mathématiques.
- Shaders : calcul sur le GPU de l’éclairage, des matériaux, des reflets d’une nuit de pluie et autres effets visuels.
- Effets sonores : les sons d’ambiance et les sons d’armes sont eux aussi générés par le programme.
- Interaction avec le joueur : entrées clavier/souris et tactiles, contrôle de la caméra, réglages de qualité graphique.
Dans un flux de travail traditionnel, ces étapes exigent des passages entre outils et entre personnes ; dans Saltline, elles deviennent des modules différents d’une même base de code. La capacité de contexte long du modèle lui permet de relire en continu le code et les solutions techniques déjà en place, garantissant la cohérence entre les modules.
2.3 Comment le navigateur fait tourner ce jeu
Saltline suit la voie du rendu local dans le navigateur : l’image est générée sur l’appareil du joueur. Le déroulement est approximativement le suivant :
- Le navigateur lit le fichier HTML et commence à exécuter le JavaScript.
- Initialisation de l’environnement de rendu Three.js et WebGL.
- Le programme génère la géométrie de la scène, les matériaux, les textures et les sons à partir du code.
- Le GPU se charge du rendu graphique ; le joueur contrôle le personnage via le clavier, la souris ou l’écran tactile.
- La logique de jeu se met à jour en continu et le navigateur rafraîchit l’image.
Fichier léger et exécution légère sont deux choses différentes. Un code de 1,43 Mo peut créer à l’exécution une grande quantité de géométries et de matériaux, et la charge mémoire comme celle du GPU dépend de la complexité de la scène. La page de démonstration indépendante le signale également : l’initialisation peut être lente ; si l’écran reste bloqué sur l’attente, il faut vérifier WebGL 2 et l’accélération matérielle du navigateur, et en cas de saccades, on peut passer à une qualité graphique inférieure.
3 Pourquoi un jeu 3D IA de 445 millions de tokens n’a coûté que 550 dollars
3.1 Le tarif officiel de Claude Fable 5.2
Fable 5.2 est sorti le 9 novembre 2026, avec une fenêtre de contexte de 1M tokens et une sortie maximale de 128K tokens. Voici le tarif officiel standard :
| Élément facturé | Prix par million de tokens | Par rapport à l’entrée standard |
|---|---|---|
| Entrée standard | 8 $ | 100 % |
| Sortie | 40 $ | 500 % |
| Écriture de cache 5 minutes | 10 $ | 125 % |
| Écriture de cache 1 heure | 16 $ | 200 % |
| Lecture de cache | 0,20 $ | 2,5 % |
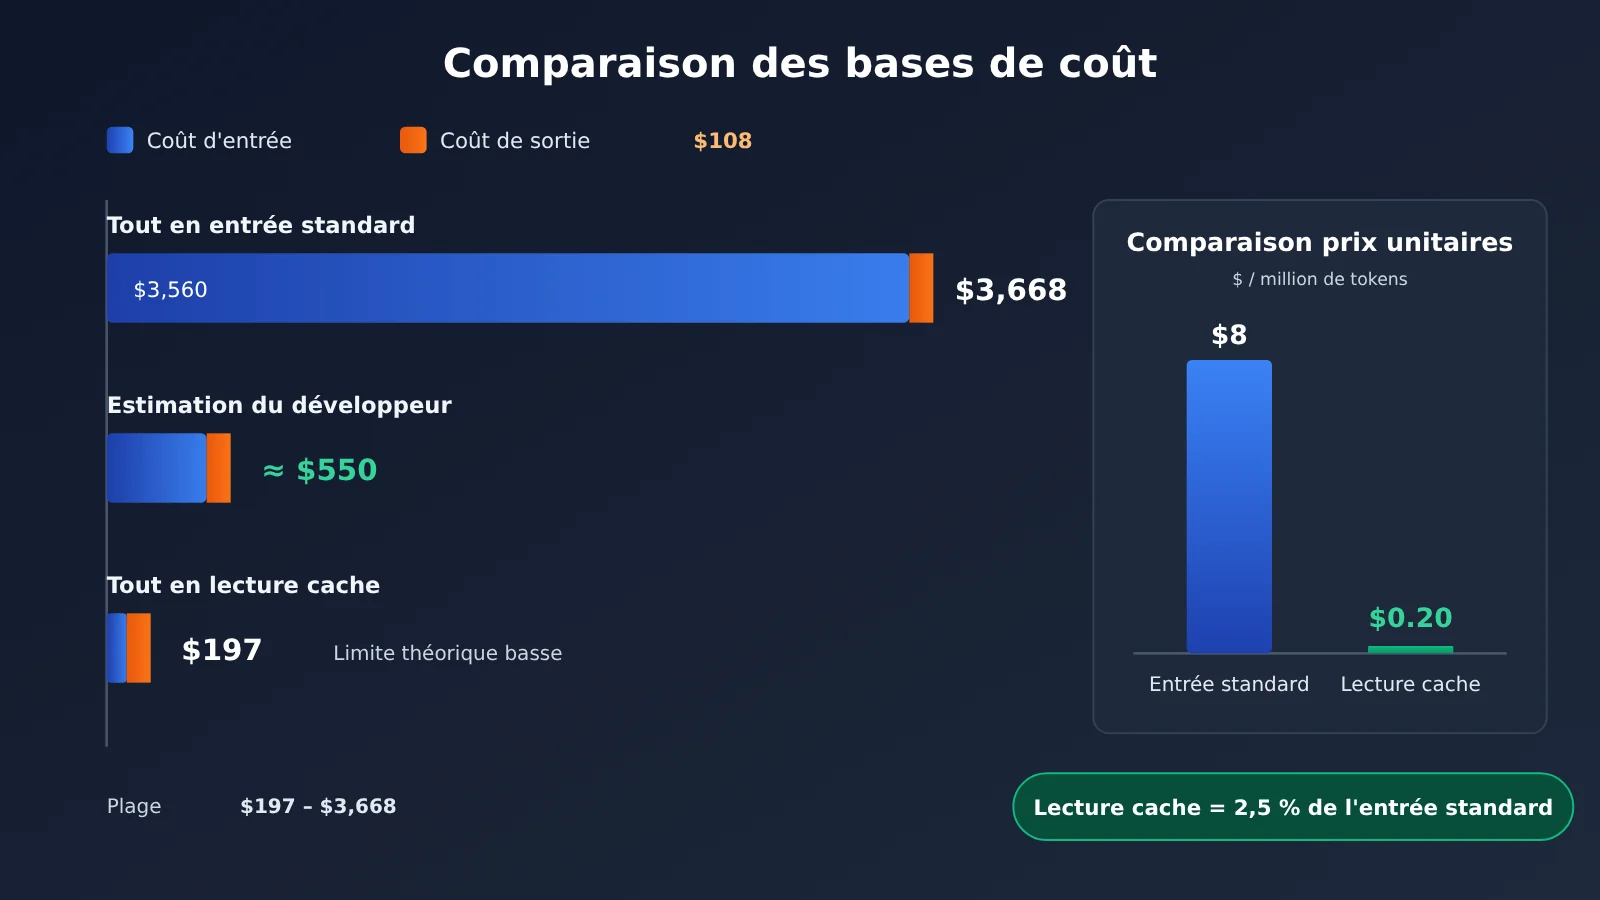
De plus, en Fast Mode, le tarif d’entrée est de 16 $ et celui de sortie de 80 $ (par million de tokens), et l’entreprise indique que la vitesse de sortie peut être multipliée par 2,5 au maximum. Le prix de lecture du cache ne représente que 2,5 % du tarif d’entrée standard : c’est la clé pour comprendre les 550 dollars.
3.2 Coût théorique si tout est facturé comme une entrée standard
Si l’on ignore complètement le cache et que l’on multiplie directement le nombre de tokens publié par le développeur par le tarif standard, le résultat est très éloigné des 550 dollars :
| Mode de calcul | Coût d’entrée | Coût de sortie | Total |
|---|---|---|---|
| Tout facturé comme entrée standard | 445 × $8 = $3,560 | 2.7 × $40 = $108 | $3,668 |
| Tout facturé comme lecture de cache (borne basse théorique, hors écriture de cache) | 445 × $0.20 = $89 | 2.7 × $40 = $108 | $197 |
| Estimation déclarée par le développeur | — | — | environ $550 |
Les deux modes de calcul extrêmes délimitent un intervalle : une borne haute d’environ 3668 dollars et une borne basse d’environ 197 dollars. L’estimation d’environ 550 dollars rapportée par le développeur tombe dans cet intervalle, et se situe clairement près de la borne basse, ce qui indique qu’une part importante de l’entrée est facturée au tarif de lecture du cache.
Un autre détail mérite attention : au tarif standard, 2,7 millions de tokens de sortie représentent environ 108 dollars, soit à peu près un cinquième de l’estimation à 550 dollars. Le volume d’entrée est plus de cent fois supérieur au volume de sortie, mais avec le mécanisme de cache, le coût de sortie pèse encore lourd dans la facture.
La comparaison des prix unitaires ci-dessus peut être transposée directement à tes propres tâches d’agent pour faire une estimation. Si tu veux d’abord vérifier sur une petite tâche l’impact des hits de cache sur la facture, tu peux appeler Claude et plusieurs autres modèles avec la même clé API sur APIYI apiyi.com, puis comparer le détail d’utilisation pour observer l’évolution des coûts selon les différentes stratégies de contexte.
3.3 Pourquoi la mise en cache réduit fortement le coût d’une programmation sur longue durée
Dans une session de programmation IA longue et à plusieurs tours, le modèle doit relire à chaque tour un volumineux contenu identique : contexte du projet, arborescence des fichiers, code déjà écrit, conventions de développement, choix techniques arrêtés plus tôt. Huit heures de génération, cela veut dire que ce contexte est soumis encore et encore, et c’est bien de là que vient l’échelle de 445 millions de tokens d’entrée.
Le Prompt Caching conserve ces préfixes répétés et, lorsqu’il y a un hit, facture au tarif de lecture du cache. La facture de cache complète se joue sur trois éléments :
- Écriture de cache (Cache Write) : la première écriture coûte plus cher qu’une entrée normale, soit 1,25 fois le prix sur le palier de 5 minutes et 2 fois sur celui d’une heure.
- Lecture de cache (Cache Read) : lors des hits suivants, il ne reste que 2,5 % du prix.
- Expiration du cache (TTL) : une fois le délai de validité dépassé, il faut réécrire le cache et repayer les frais d’écriture.
Le choix du palier de TTL, la stabilité de la structure du contexte et l’écart entre deux requêtes pèsent donc tous sur le coût final. Modifier souvent le début du contexte fait tomber le cache en invalidité et, au contraire, fait grimper les frais d’écriture.
3.4 Jusqu’où peut-on recalculer les coûts à partir des données publiques
Les documents publics fournissent actuellement le total d’entrée, le total de sortie et un prix total estimé, mais pas de facture détaillée. Les données clés suivantes ne sont pas rendues publiques :
- le nombre de tokens pour l’entrée standard, l’écriture en cache et la lecture du cache ;
- l’utilisation respective du cache de 5 minutes et du cache de 1 heure ;
- l’existence éventuelle d’autres frais d’appel API.
Comme l’écriture en cache a deux niveaux de prix, les inconnues sont plus nombreuses que les données connues : ces trois chiffres ne suffisent pas à retrouver un taux de réussite du cache unique. La conclusion qu’on peut affirmer est la suivante : 550 dollars se situent dans l’intervalle théorique mentionné ci-dessus, et le cache a joué un rôle majeur dans la réduction des coûts lors de cette expérience.
4 Comment calculer le coût réel des tâches de programmation par IA
4.1 Un cadre de coûts à trois niveaux
Quand on parle de « combien coûte la création d’un jeu avec l’IA », il faut d’abord préciser de quel niveau de coût on parle. Les 550 dollars de Saltline ne couvrent que le premier niveau.
| Niveau de coût | Contenu inclus | Pris en compte par Saltline |
|---|---|---|
| Coût d’invocation du modèle | entrées, sorties, écriture et lecture du cache, remise pour traitement par lots, appels d’outils | Oui (environ 550 dollars, estimation du développeur) |
| Coût d’exécution du développement | conception des tâches, débogage et tests, environnement d’exécution, dépôt de code, ressources externes, temps humain | Non communiqué |
| Coût d’exploitation du produit | hébergement, trafic CDN, base de données, services en ligne, maintenance ultérieure | Non inclus |
La structure d’un jeu web local détermine où se concentrent ses coûts d’IA : ils se situent au stade du développement, le rendu étant pris en charge par l’appareil du joueur. À l’inverse, le cloud gaming et les modèles de monde en temps réel génèrent en continu des coûts de calcul serveur à chaque session de jeu. Les courbes de coûts de ces deux types de produits sont donc totalement différentes.
4.2 Quelles étapes se prêtent au Batch API
L’API officielle de Claude propose un Batch API : les entrées et sorties par lots admissibles bénéficient d’une remise de 50 %. Il est adapté à la génération de code non temps réel, au traitement de contenu en masse et aux évaluations hors ligne — par exemple générer d’un coup les configurations de plusieurs niveaux, ou lancer un audit de code par lots.
Un développement de type Agent comme Saltline doit décider de l’action suivante en fonction du résultat de l’étape précédente : c’est un flux séquentiel fortement interactif, difficile à faire entrer directement dans le cadre d’une remise par lots. Dans un projet réel, l’approche la plus viable consiste à découper : la boucle de développement principale s’appuie sur le cache pour réduire les coûts, tandis que les sous-tâches hors ligne parallélisables sont confiées au Batch API.
4.3 Estimer votre facture de programmation assistée par IA avec du code
L’exemple minimal ci-dessous montre comment lancer un appel via l’interface compatible OpenAI et lire les champs d’utilisation renvoyés — le point de départ pour comptabiliser les coûts :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_NAME",  # Remplacez par un nom de modèle comme Claude, issu de la liste de modèles de la plateforme
    messages=[{"role": "user", "content": "用 Three.js 写一个旋转的立方体"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # Notez prompt_tokens / completion_tokens pour le calcul des coûts
Voir l’implémentation complète : un estimateur de coût intégrant les tarifs de cache
import openai
from dataclasses import dataclass

# Tarifs officiels standard de Claude Fable 5.2 (USD / million de tokens)
PRICE = {
    "input": 8.0,
    "output": 40.0,
    "cache_write_5m": 10.0,
    "cache_write_1h": 16.0,
    "cache_read": 0.20,
}

@dataclass
class Usage:
    input_tokens: float = 0        # entrée normale
    cache_write_5m: float = 0      # écriture de cache 5 minutes
    cache_write_1h: float = 0      # écriture de cache 1 heure
    cache_read: float = 0          # lecture de cache
    output_tokens: float = 0       # sortie

def estimate_cost(u: Usage) -> float:
    """Additionne chaque poste de facturation séparément, en USD"""
    m = 1_000_000
    return (
        u.input_tokens / m * PRICE["input"]
        + u.cache_write_5m / m * PRICE["cache_write_5m"]
        + u.cache_write_1h / m * PRICE["cache_write_1h"]
        + u.cache_read / m * PRICE["cache_read"]
        + u.output_tokens / m * PRICE["output"]
    )

# Reproduit les deux bornes théoriques de l'article (total de tokens déclaré par le développeur)
upper = estimate_cost(Usage(input_tokens=445e6, output_tokens=2.7e6))
lower = estimate_cost(Usage(cache_read=445e6, output_tokens=2.7e6))
print(f"Tout en entrée normale : ${upper:,.0f}")   # environ $3,668
print(f"Tout en lecture de cache : ${lower:,.0f}")   # environ $197

# Cumulez l'usage réel dans votre propre projet
client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def run_step(messages, model="YOUR_MODEL_NAME"):
    resp = client.chat.completions.create(model=model, messages=messages)
    usage = resp.usage
    print("prompt:", usage.prompt_tokens, "completion:", usage.completion_tokens)
    return resp.choices[0].message.content
L’estimateur additionne séparément les cinq postes de facturation, ce qui permet d’y injecter directement le détail d’usage de votre propre projet. Les plateformes peuvent renvoyer les champs de cache de manières différentes : au moment de l’intégration, fiez-vous à la structure usage de la réponse réelle.
🚀 Conseil pour démarrer vite : avant de lancer une tâche d’agent à long horizon en développement réel, récupérez d’abord le crédit de test gratuit pour les nouveaux utilisateurs via APIYI apiyi.com, faites tourner une petite scène Three.js pour boucler le cycle « génération — exécution — correction », en relevant la consommation de tokens à chaque tour, puis utilisez l’estimateur ci-dessus pour évaluer le budget du projet complet.
5 Où se situent les limites du développement autonome de jeux 3D par l’IA
5.1 Prototypes jouables et jeux commerciaux aboutis
Saltline a prouvé qu’un modèle pouvait livrer, sans intervention humaine, un petit jeu complet et jouable : scènes, ennemis, quêtes, rendu visuel et audio. Un jeu commercial abouti exige encore une grande quantité de contenu de niveaux, un équilibrage sur la durée, une adaptation multiplateforme, de la localisation, de l’anti-triche et des tests à grande échelle ; rien de tout cela n’était couvert dans cette expérience unique.
Sur les réseaux sociaux chinois, le « Jimao · blockbuster 3A chinois » qui circule est en réalité la version chinoise, ou une version reconditionnée, de Saltline. « Blockbuster 3A chinois » est le nom utilisé pour sa diffusion ; le développement reste attribué à cette expérience Fable 5.2.
5.2 Génération unique et maintenance continue
La génération en une seule fois répond au « de zéro à un ». Après la mise en ligne, les itérations de version, les corrections de bugs et les ajouts de contenu obligent le modèle ou les développeurs à modifier plusieurs fois le code existant. Le contexte à maintenir sur la durée ne cesse de grossir, et les stratégies de cache comme l’organisation du code pèseront de plus en plus sur les coûts futurs.
5.3 Fonctionnalités terminées et optimisation des performances
Fonctionnel et fluide sont deux objectifs d’ingénierie distincts. La page de démonstration de Saltline propose une option de qualité graphique basse et invite à vérifier WebGL 2 et l’accélération matérielle, ce qui montre bien que les performances restent tributaires de l’appareil du joueur et des capacités du navigateur. La documentation officielle d’Unity rappelle elle aussi que la plateforme Web a des limites en matière de système de fichiers, de threads, de mémoire et de prise en charge des appareils mobiles ; l’optimisation des performances dans le navigateur pour des jeux complexes reste difficile.
5.4 Considérer Saltline comme une expérience représentative
L’intérêt de Saltline est de fournir un point de référence clair : avec un grand modèle de langage à longue fenêtre de contexte suffisamment performant, un usage raisonnable du cache et un objectif unique bien défini, le coût d’invocation du modèle pour générer en une seule passe un prototype de jeu 3D pour navigateur se situe de l’ordre de quelques centaines de dollars. Ses 8 heures et 550 dollars sont issus d’une expérience unique rapportée par le développeur ; les résultats d’autres développeurs varieront selon la conception des invites, la complexité de la tâche, la stratégie de cache et la version du modèle.
La plateforme tierce AI8Games recense un ensemble de jeux pour navigateur générés avec la participation de modèles tels que Claude Fable 5.2 ; lors de la recherche, elle affichait 62 jeux jouables et 27 œuvres de démonstration en vidéo. Il s’agit de données compilées par un tiers, qui montrent que ce type d’expérience se multiplie, sans constituer une statistique officielle.
💡 Conseil de sélection : Les différents modèles présentent des écarts sensibles en matière de génération de code sur de longues séquences, de prix du cache et de prix de sortie. Pour une même tâche de prototype de jeu, la facture totale peut varier de plusieurs fois d’un modèle à l’autre. Je vous conseille de comparer, sur APIYI (apiyi.com), la qualité des résultats et la consommation de tokens de plusieurs modèles courants avec la même invite, avant de choisir celui à utiliser pour le développement final.
6. Questions fréquentes sur l’expérience de jeu 3D par IA
Q1 : Les 550 dollars de Saltline correspondent-ils à une facture réellement payée ?
Il s’agit d’une estimation faite par Felix Rieseberg à partir des tarifs de l’API, sans audit d’un tiers. Les informations publiques ne détaillent pas non plus la consommation séparée des entrées standards, des écritures de cache et des lectures de cache ; impossible donc de reconstituer précisément la structure de la facture.
Q2 : Pourquoi 445 millions de tokens d’entrée n’ont-ils coûté si peu ?
La programmation au long cours soumet répétitivement le même contexte de projet ; une fois ce contenu touché par le cache, il est facturé 0,20 $ par million de tokens, soit seulement 2,5 % du tarif de 8 $ des entrées standards. Tout calculé au tarif standard donnerait environ 3 668 dollars ; le développeur estime la facture à environ 550 dollars, la différence venant principalement du cache.
Q3 : Chaque partie jouée génère-t-elle des frais d’appel IA ?
Non. Une fois généré, Saltline est un fichier HTML d’environ 1,43 Mo : le jeu tourne localement dans le navigateur du joueur, rendu par le GPU de son appareil, sans appel à l’API du modèle pendant l’exécution. Les 550 dollars correspondent à un coût unique, engagé pendant la phase de développement.
Q4 : Comment réutiliser ce type de génération de code au long cours dans son propre projet ?
L’essentiel est de faire travailler le modèle de façon continue sur une structure de contexte stable : placer les spécifications, la conception technique et la structure des fichiers au début fixe de l’invite, pour faciliter l’atteinte du cache ; enregistrer l’usage à chaque tour, pour estimer le budget. On peut d’abord lancer un petit scénario avec le quota gratuit d’APIYI apiyi.com, vérifier que le cache et le comptage d’usage correspondent aux attentes, puis élargir l’échelle de la tâche.
Q5 : Un développeur peut-il reproduire un jeu similaire avec le même budget ?
Le résultat varie selon l’invite, la complexité visée, la stratégie de cache et le choix du modèle. Saltline est une expérience unique réussie, utile comme référence d’ordre de grandeur. Pour un budget réel, mieux vaut extrapoler à partir de l’usage réel d’un essai à petite échelle ; grâce à l’interface unifiée d’APIYI apiyi.com, on peut changer de modèle dans le même code, ce qui facilite la comparaison des coûts.
Q6 : Quelle différence entre Saltline et les jeux générés par IA comme Genie 3 ?
Saltline, c’est l’IA qui écrit le code et le navigateur qui l’exécute : les règles du jeu sont écrites à l’avance, et l’image est rendue par le GPU local. Les modèles du monde comme Genie 3, Muse ou Oasis, eux, prédisent en temps réel la frame suivante à partir de l’état courant et des entrées du joueur ; ils demandent une inférence continue, et chaque session génère un coût de calcul. Les structures de coût et les limites techniques des deux approches sont complètement différentes.
7 Conclusion : comment interpréter ces 550 dollars et ces 8 heures
L’expérience Saltline démontre trois choses :
- L’IA peut intégrer plusieurs étapes du développement d’un jeu dans une seule génération de code : scènes, logique, modèles, textures, shaders, effets sonores et interactions sont livrés sous forme de code, pour aboutir à un jeu de navigateur monofichier d’environ 1,43 MB.
- Le cache détermine la rentabilité du codage assisté par IA sur la durée : 445 millions de tokens d’entrée coûteraient environ 3 668 dollars au tarif normal, contre une estimation d’environ 550 dollars citée par le développeur, la lecture du cache à 2,5 % du prix unitaire étant la variable clé.
- Ces 550 dollars ne couvrent que le coût des invocations de modèle : l’exécution du développement, le fonctionnement du produit et la maintenance ultérieure s’ajoutent à ce chiffre. Saltline reste une expérience représentative de prototype jouable.
Si vous envisagez de confier à un agent des tâches de développement longues du même type, la préparation la plus utile consiste d’abord à prendre l’habitude de comptabiliser les coûts : enregistrez séparément les volumes d’entrée, de cache et de sortie, puis estimez votre budget à partir de données réelles. Je vous recommande de vérifier rapidement le résultat via APIYI apiyi.com : la plateforme propose une interface compatible OpenAI, l’appel unifié de plusieurs modèles et un crédit de test gratuit pour les nouveaux utilisateurs.
Références
- Page de démonstration autonome de Saltline : essai du jeu et FAQ
- Lien :
saltline.games -
Description : contient les informations d’expérience (initialisation, réglages de qualité graphique, commandes) ; la version chinoise se trouve sur
saltline.games/zh -
Publication originale de Felix Rieseberg : source des données sur la durée de développement, les tokens et les coûts
- Lien :
x.com/felixrieseberg/status/2119925633564463609 -
Description : données de première main rapportées par le développeur
-
Miroir du code de Saltline et README : données sur les fichiers et attribution des données
- Lien :
github.com/realcodebear/saltline-fable-5.2 -
Description : précise que les chiffres concernés n’ont pas fait l’objet d’un audit indépendant par un tiers
-
Dépôt GitHub de la version chinoise de Jimao : archive de la version diffusée localement
- Lien :
github.com/Megasu/jimao-3a-game -
Description : fournit la taille du fichier index.html et les instructions pour une exécution hors ligne
-
Spécifications et tarifs du modèle Claude Fable 5.2 : documentation officielle d’Anthropic
- Lien :
platform.claude.com/docs/en/models/fable-5-2/overview -
Description : prix unitaires officiels pour l’entrée, la sortie, l’écriture et la lecture du cache
-
Documentation officielle de Three.js : bibliothèque graphique 3D pour navigateur
- Lien :
threejs.org/docs -
Description : ressources de base pour comprendre la construction des scènes de Saltline
-
Aperçu technique d’Unity WebGL : limitations de la plateforme Web
- Lien :
docs.unity.cn/6000.0/Documentation/Manual/webgl-technical-overview.html - Description : limitations des jeux de navigateur en matière de threads, de mémoire et de mobile
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI apiyi.com ; d’autres ressources d’intégration sont disponibles dans le centre de documentation docs.apiyi.com