Note de l’auteur : le 2 novembre 2026, OpenAI a présenté Pando, son backend Git interne. À partir de sa mise en production en 10 semaines, cet article analyse la répartition du travail entre humains et agents, le dispositif de test et la migration, puis en tire des pratiques d’ingénierie des agents applicables à d’autres équipes.
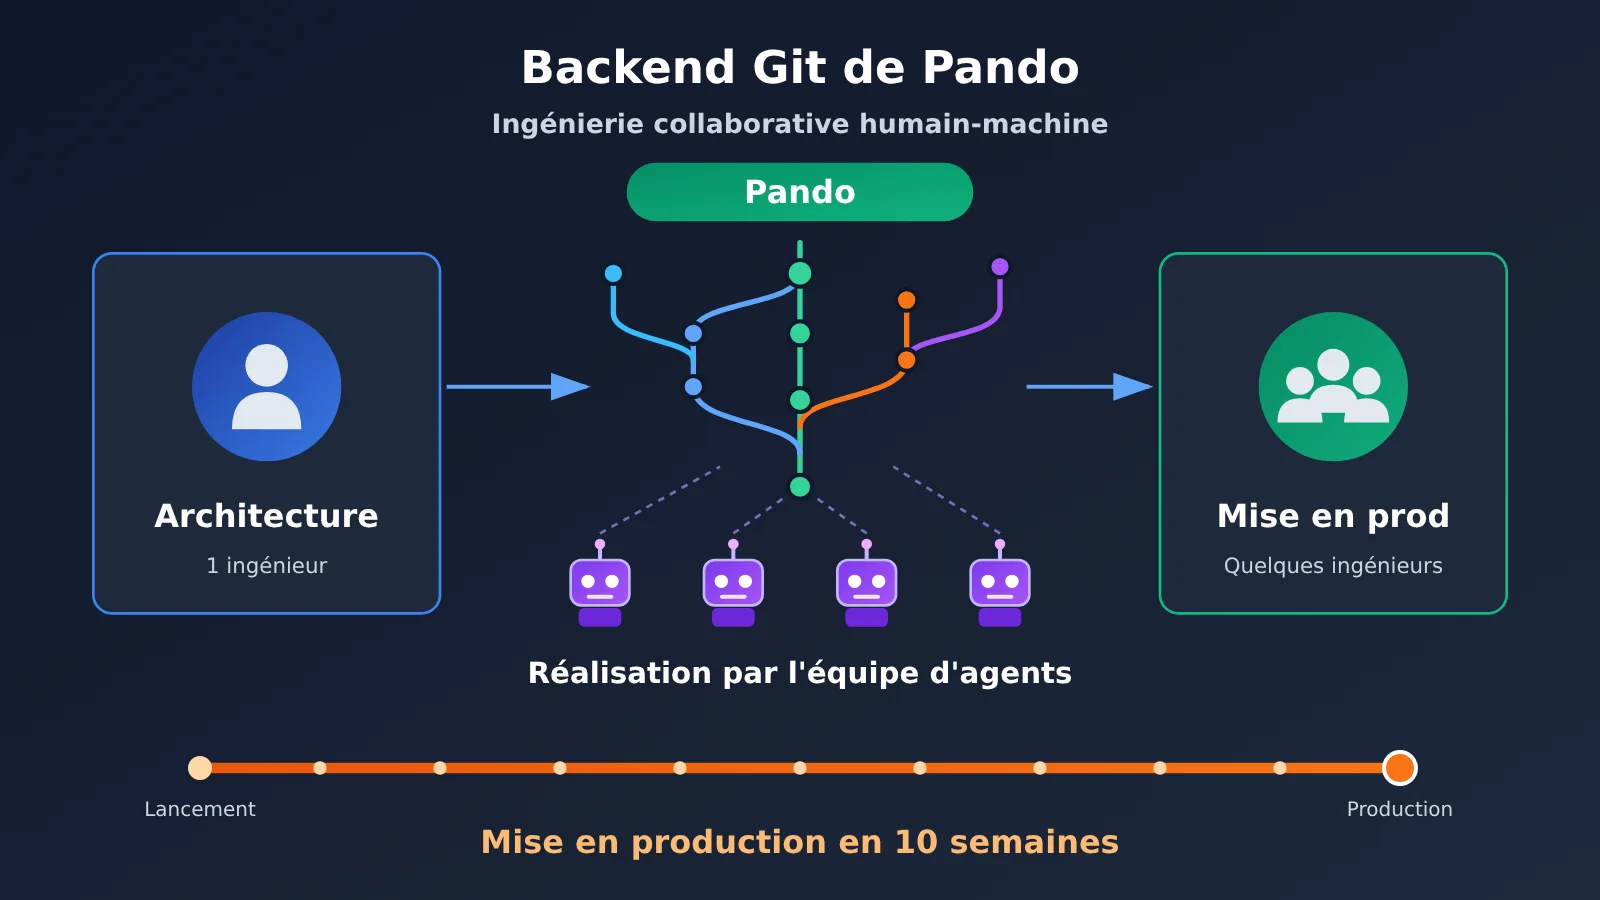
Le 2 novembre 2026, OpenAI a publié l’article technique « Scaling Git at OpenAI », dans lequel l’entreprise présente le nouveau backend Git qui prend en charge toutes les activités de développement de son dépôt monolithique : Pando. Environ 10 semaines se sont écoulées entre le lancement du projet et la prise en charge du trafic de production. Un ingénieur a conçu l’architecture principale, plusieurs équipes d’agents se sont chargées de l’implémentation, puis un petit nombre d’ingénieurs a assuré le déploiement. On pourrait facilement y voir l’histoire d’une personne dirigeant l’IA pour construire une infrastructure. Mais les détails communiqués par OpenAI montrent que le résultat repose avant tout sur un ensemble de contraintes d’ingénierie et de mécanismes de validation.
Cet article ne raconte pas un mythe de la programmation par IA. Il s’appuie sur les informations officielles d’OpenAI et distingue les faits publiés des éléments encore inconnus. La taille des équipes, le coût en tokens, l’historique des tâches et la proportion de code modifiée manuellement n’ont notamment pas été communiqués.
Ce que vous allez retenir : pourquoi Pando a été créé, ce que les équipes d’agents Codex ont concrètement pris en charge, quelles méthodes de validation ont permis aux agents de participer au développement de l’infrastructure et comment appliquer ces pratiques à vos propres projets.
Pando en bref : qu’a livré l’équipe Codex Agent ?
Voici les informations confirmées par OpenAI. À noter : Pando est un backend serveur compatible avec Git. Ce n’est ni un nouveau protocole de contrôle de version ni un remplacement direct de GitHub.
| Élément | Détails |
|---|---|
| Date de publication | 2 novembre 2026, article officiel « Scaling Git at OpenAI » |
| Auteurs | Aaron Friel, Taylor Blau et Ted Nyman (équipe technique d’OpenAI) |
| Durée du projet | Environ 10 semaines du lancement à la mise en production ; trafic de production pris en charge à partir d’avril 2026 |
| Langage d’implémentation | Serveur principalement développé en Rust, à partir de zéro pour éviter de reprendre les dépendances de l’ancien système |
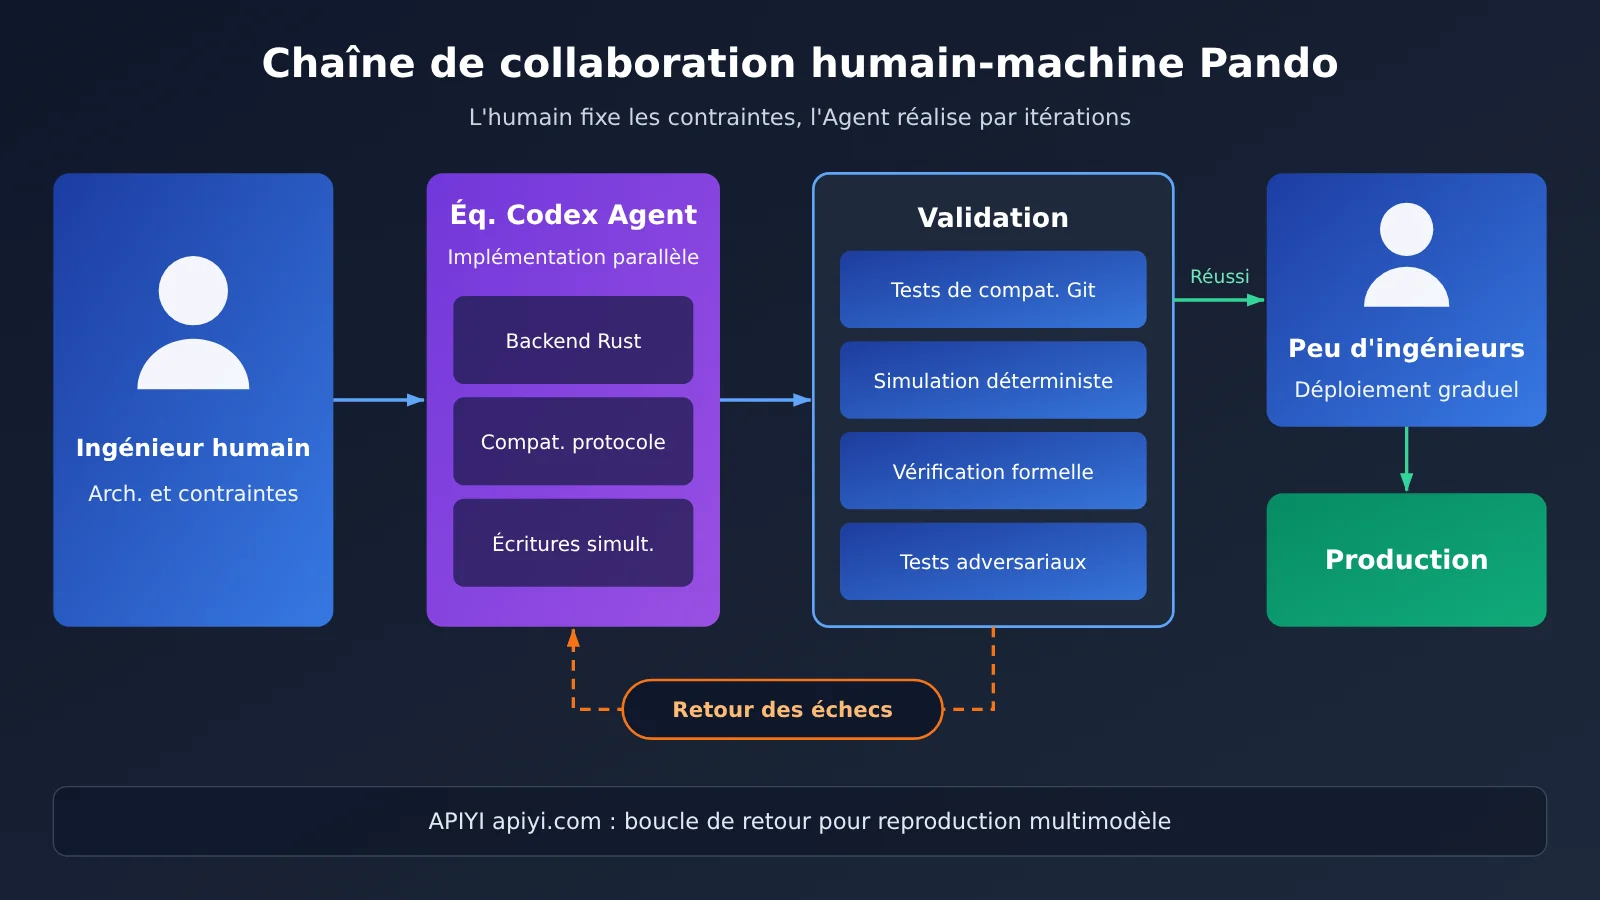
| Répartition du travail | Un ingénieur a conçu l’architecture centrale, plusieurs équipes d’agents l’ont implémentée et un petit nombre d’ingénieurs l’ont déployée |
| Résultats en production | Latence médiane des Push réduite de près de 80 %, près de 1 PB de données Git transférées chaque jour |
| Disponibilité | Au 2026-11-03, aucun serveur, aucune API ni aucun tarif public |
Pourquoi OpenAI avait besoin de reconstruire son backend Git avec Codex Agent
Pando est né de l’explosion du nombre de commits. Le graphique officiel prend comme référence le nombre de commits fusionnés dans la branche principale au premier trimestre 2024, puis mesure sa croissance au fil des trimestres. Voici quelques points de repère.
| Trimestre | Croissance des commits par rapport à 2024 Q1 | Précision |
|---|---|---|
| 2024 Q4 | +98% | Près du double |
| 2025 Q4 | +264% | L’ancien système commence à peiner à suivre la demande |
| 2026 Q1 | +432% | Phase de développement du projet Pando |
| 2026 Q3 | +1,378% | Environ 14,78 fois le niveau de référence |
| 2026 Q4 | +2,442% | Prévision officielle, pas le résultat d’un trimestre achevé |
Il faut garder une distinction essentielle à l’esprit : le nombre de commits ne correspond ni au nombre de lignes de code, ni au nombre de PR, ni à la productivité des équipes. On ne peut donc pas en conclure que « le volume de code a été multiplié par 25 » ou que « Codex a rendu les ingénieurs 25 fois plus productifs ». Selon OpenAI, Codex permet aux ingénieurs de faire avancer davantage de tâches simultanément, ce qui entraîne une multiplication des branches parallèles, des Push, des fusions, des tâches CI et des requêtes Fetch et Clone.
Vers le quatrième trimestre 2025, l’ancien système connaissait des ralentissements des Push et des Fetch, ainsi que des échecs de fusion. Sa fiabilité descendait parfois sous les 90 %. OpenAI n’a pas précisé comment cet indicateur était calculé ni publié son évolution dans le temps : on ne peut donc pas non plus en déduire que « plus de 10 % des commits ont échoué ».
Les 4 choix clés de l’architecture technique de Pando
Pando n’abandonne pas Git : il repense le stockage côté serveur, la mise à jour des références et la distribution des données. Comprendre ces choix permet de voir les compromis que les humains ont dû faire.
- Mise à jour indépendante des branches : Pando renonce à maintenir un instantané cohérent du dépôt entier à un instant donné. Chaque branche gère ses propres versions : seules les requêtes qui modifient la même référence doivent être coordonnées, selon un modèle de cohérence causale. En contrepartie, lors d’une lecture portant sur plusieurs branches, celles-ci peuvent correspondre à des instants différents.
- Conservation et réutilisation des Packfiles : chaque Packfile reçu lors d’un Push est enregistré comme donnée immuable dans un Blob Store. Lors d’un Fetch, Pando sélectionne les Packfiles existants selon les indications have/want du client et transmet les adresses de téléchargement via le mécanisme packfile-uri de Git. Il évite ainsi de reconstruire et de compresser les fichiers pour chaque client.
- Cache régional Express : des clusters et des caches locaux sont déployés dans plusieurs régions, et les requêtes sont réparties par hachage cohérent. Le taux de succès du cache des Packfiles dépasse 99 %. Il s’agit d’un cache de données Git, à ne pas confondre avec le Prompt Caching des API de grands modèles de langage.
- Compaction hiérarchisée en arrière-plan : à la manière d’un LSM Tree, les petits Packfiles sont fusionnés par niveaux pour former de grands ensembles couvrant des plages de versions continues. Le dépôt monolithique utilise actuellement jusqu’au niveau L4.
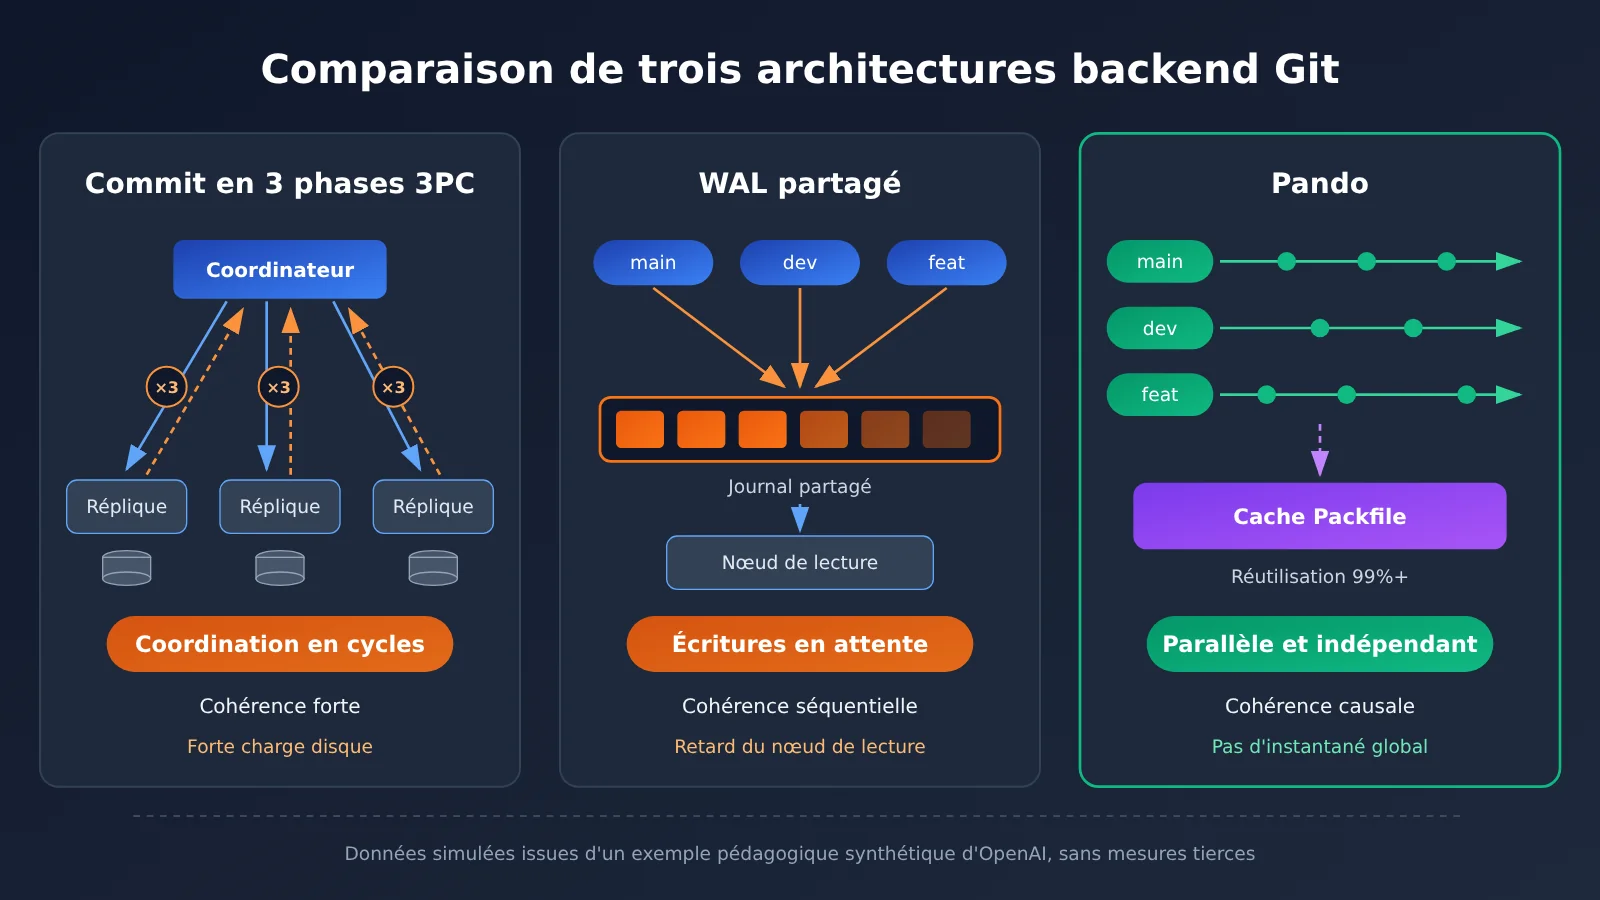
OpenAI a aussi comparé trois types d’architectures dans une simulation de 1 000 clients effectuant 10 000 Push au total. Il s’agit d’une simulation pédagogique synthétique créée par OpenAI, et non d’un benchmark indépendant réalisé par un tiers.
| Architecture | Mode d’écriture | Cohérence | Principal goulot d’étranglement |
|---|---|---|---|
| Commit en trois phases 3PC | Écriture coordonnée entre plusieurs répliques complètes | Assez forte | Les multiples tours de coordination et la charge disque ralentissent les écritures concurrentes |
| WAL partagé | Toutes les mises à jour se disputent l’accès au même journal | Cohérence séquentielle | Les nœuds de lecture prennent du retard lorsque les écritures arrivent plus vite qu’elles ne sont appliquées |
| Pando | Transactions atomiques indépendantes pour chaque Ref | Cohérence causale | Renoncement à un instantané du dépôt entier à un même instant |
Les données de production publiées par OpenAI indiquent aussi un pic de livraison de Packfiles supérieur à 57 TB en une heure, dont plus de 99 % des octets provenaient du cache sur disque local. Sur des machines virtuelles cloud standard, Clone et Fetch peuvent saturer une liaison de 10 Gbps. Les lectures et écritures de métadonnées pour Push sont en O(1), et les lectures de métadonnées nécessaires à la planification de Fetch en O(log Δ). Ces complexités concernent les opérations sur les métadonnées, pas la durée réseau de bout en bout.
Comment l’équipe d’agents Codex s’est réparti le travail sur Pando
« Un ingénieur a conçu le cœur du système » ne signifie pas qu’une seule personne a travaillé sur le projet. De même, « une équipe d’agents l’a réalisé » ne veut pas dire que chaque ligne de code a été écrite par l’IA. D’après les informations publiées officiellement, on peut résumer la répartition des tâches comme suit. OpenAI n’a toutefois pas dévoilé la liste précise des missions de chaque agent.
| Rôle | Travail effectué | Pourquoi ce rôle |
|---|---|---|
| Ingénieur en architecture (humain) | Identifier les limites de l’ancien système, maintenir la compatibilité avec le protocole Git, choisir la mise à jour indépendante des branches et la réutilisation des Packfiles, renoncer à une cohérence forte à l’échelle du dépôt | Ces choix techniques irréversibles définissent les limites du système |
| Équipe d’agents Codex et autres | Implémenter le backend en Rust, assurer la compatibilité avec les protocoles Push/Fetch, gérer les écritures concurrentes, optimiser les performances et corriger les cas limites | Le volume de travail est important et les résultats peuvent être vérifiés par des tests répétés : un bon terrain pour des itérations en parallèle |
| Agents de validation | Exécuter de longues sessions pour repérer les cas limites ; des modèles dotés des capacités Daybreak réalisent des tests adversariaux en continu | Ce travail exige une continuité qu’il serait difficile pour des humains de maintenir au même rythme |
| Ingénieur de déploiement (humain) | Organiser le basculement progressif du trafic, synchroniser l’ancien et le nouveau système, migrer plusieurs centaines d’intégrations | Les risques en production et la coordination entre équipes nécessitent une responsabilité humaine |
L’essentiel à retenir : les humains définissent l’architecture, les contraintes et les critères d’acceptation ; les agents prennent en charge une grande partie de l’implémentation et des itérations ; les ingénieurs restent responsables de la migration en production et de la fiabilité du système. Aucune comparaison officielle avec un développement entièrement humain n’a été fournie : il est donc impossible de calculer de combien Codex a accéléré le projet.
Le dispositif de test de Pando : pourquoi Codex Agent peut participer au développement d’infrastructures
Pando est un logiciel d’infrastructure : en cas d’erreur, une branche peut pointer vers le mauvais commit, un Push peut perdre des objets ou un Fetch récupérer un historique incomplet. Une page web défectueuse peut être rechargée ; un backend Git défectueux risque de paralyser le développement de toute une entreprise. OpenAI n’a donc pas simplement fourni à l’Agent une invite plus longue, mais un système de vérification exécutable.
Tests de compatibilité Git : vérifier le comportement, pas seulement la compilation
OpenAI a créé la Git Conformance Test Suite pour permettre à l’Agent, après avoir modifié l’implémentation côté serveur, de vérifier lui-même que son comportement correspond à celui attendu de Git standard. Les contrôles portent sur la mise à jour des Ref, Push, Fetch, le transfert de Packfile et la compatibilité des protocoles. L’essentiel est que le critère soit « se comporter comme Git », et pas seulement « compiler et réussir les tests unitaires ». OpenAI n’a pas communiqué le nombre de cas de test.
Simulation déterministe de la concurrence : rendre les conditions de course reproductibles
Dans les systèmes distribués, les erreurs les plus difficiles surviennent souvent lorsque plusieurs opérations s’entremêlent. OpenAI utilise des Deterministic Simulation Harnesses pour simuler de manière reproductible l’état du système et les événements concurrents. Ces outils aident à détecter les conditions de course, les problèmes de négociation Git, les erreurs de planification des Packfile et les régressions. Par exemple, si deux Agents modifient simultanément la même branche, deux mises à jour conflictuelles ne doivent pas être toutes deux considérées comme réussies ; avant de mettre à jour le pointeur de branche, le nouvel objet commit doit déjà être accessible en lecture. Ces exemples illustrent les objectifs des tests : OpenAI n’a pas publié officiellement chaque cas.
Vérification formelle avec Lean et TLA+ : attention à la chronologie
OpenAI indique avoir utilisé GPT-6 Astra pour aider les Agents à rédiger des descriptions formelles en Lean et TLA+, constituant ce qu’elle appelle la « Theory of Pando ». Celle-ci sert à vérifier des invariants, à détecter et corriger des erreurs et à démontrer certaines propriétés. Deux limites sont à retenir : d’une part, seules les propriétés définies sont vérifiées, ce qui ne signifie pas que tous les chemins d’exécution du système ont fait l’objet d’une preuve mathématique ; d’autre part, OpenAI précise que les nouveaux modèles ont été utilisés au fur et à mesure de leur apparition pour améliorer les performances et la fiabilité. On ne peut donc pas attribuer toutes ces pratiques aux 10 premières semaines.
Sessions d’Agent prolongées et tests de sécurité adversariaux
OpenAI mentionne également plusieurs sessions d’Agent consécutives ayant duré des centaines d’heures pour rechercher et corriger des cas limites. Des modèles dotés des capacités Daybreak ont aussi testé Git et Pando en continu selon une approche adversariale. OpenAI n’a communiqué ni le nombre d’Agents, ni la durée de chaque session, ni la consommation de tokens, ni le nombre de bugs corrigés, ni la fréquence de la supervision humaine. On ne peut donc pas en déduire qu’un « Agent a écrit du code sans surveillance pendant des centaines d’heures ». Le point intéressant est le changement d’approche : l’Agent sert à vérifier le système en continu, et pas seulement à générer le code initial.
Le fork de Git publié par OpenAI témoigne aussi indirectement de cette amélioration continue. On y trouve par exemple des correctifs pour le hachage parallèle dans index-pack en août 2026, puis pour les nouvelles tentatives après limitation de débit et la réutilisation des Pack terminés en octobre. Mais ces commits sont tous postérieurs à la première mise en production d’avril 2026 : ils ne peuvent donc pas non plus être comptés parmi les livrables des 10 premières semaines.
Migration progressive de Pando : le code écrit par un agent Codex n’est pas nécessairement prêt pour la production
Les 10 semaines couvrent la période entre le lancement du projet et sa mise en production, pas l’ensemble du travail nécessaire pour atteindre sa pleine maturité. Pando a été déployé selon une approche classique de « migration progressive sans interruption ». Voici les grandes étapes du processus décrites par l’équipe :
- Placer Pando devant l’ancien système comme proxy transparent pour les lectures et les écritures, afin de maintenir les deux backends synchronisés.
- Regrouper les requêtes identiques et mettre en cache les données Git pour le trafic réel. Le transfert d’une partie du trafic a ainsi allégé la charge de l’ancien système.
- Migrer les clients de développement par lots à l’aide d’un wrapper interne autour de la CLI Git.
- Migrer des centaines d’intégrations qui dépendaient de l’ancienne API, des webhooks et des méthodes de téléchargement des dépôts, ainsi que les workflows Review et Change Request.
- Fournir des Codex Skills dédiés à la migration, pour que les développeurs puissent demander directement à Codex de les aider à préparer leurs dépôts locaux et leur environnement de migration.
- Déployer un client Git amélioré sur les appareils des ingénieurs et dans l’application de bureau ChatGPT.
Selon l’équipe, la migration n’a pas interrompu le développement, mais aucun taux de retour arrière, aucune répartition des incidents ni aucun cas d’échec n’ont été publiés. Pour les responsables techniques, cette partie mérite plus d’attention que les « 10 semaines » : préserver la compatibilité avec les workflows existants, migrer les intégrations et basculer le trafic par étapes sont souvent des tâches aussi complexes que la création du nouveau système lui-même.
Analyse de l’impact de Pando : ce que cela signifie pour les développeurs d’Agents et les équipes techniques
Pour les développeurs d’Agents
- La capacité de vérification détermine les limites d’un Agent : Pando permet aux Agents de participer à l’implémentation des composants essentiels, à condition qu’ils disposent de retours fiables grâce à des tests de compatibilité, des simulations déterministes et des spécifications formelles.
- Le rôle des Agents s’élargit : ils ne se limitent plus à écrire du code, mais peuvent aussi rechercher en continu les cas limites, effectuer des tests adversariaux et aider les utilisateurs à migrer.
Pour les responsables techniques
- Le développement assisté par IA augmente la charge en aval : la hausse du nombre de commits se répercute sur la CI, la revue de code et l’hébergement du code. Dans un autre article publié en juillet 2026, OpenAI indique que le nombre hebdomadaire de PR en interne a plus que doublé par rapport au trimestre précédent, faisant de la revue de code l’un des nouveaux goulots d’étranglement.
- Pas besoin de recréer Pando à tout prix : les problèmes d’échelle des grands monorepos ne datent pas de l’ère de l’IA. La grande majorité des équipes n’a pas besoin de reconstruire le backend Git.
Comparaison avec le cas du Harness Engineering
En février 2026, OpenAI a présenté un autre projet indépendant : parti d’un dépôt vide, il a produit environ un million de lignes de code applicatif écrites par Codex et quelque 1 500 PR en cinq mois, sous l’impulsion initiale de trois ingénieurs. Ce projet et Pando ne partagent ni la même équipe ni les mêmes processus : leurs chiffres ne doivent donc pas être mélangés. Ils illustrent toutefois une même tendance : les ingénieurs prennent de plus en plus en charge la conception des systèmes, des environnements de test et des workflows d’Agents. Parmi les enseignements du projet : découper le travail en petites tâches, fournir un environnement d’exécution indépendant pour chaque branche, donner à l’Agent accès aux journaux et aux métriques, et utiliser AGENTS.md pour le guider plutôt que d’inclure toute la base de connaissances dans l’invite.
Sur Hacker News, les avis sont partagés : certains estiment que l’augmentation du nombre de commits ne signifie pas une amélioration de la qualité, tandis que d’autres considèrent que la baisse du coût d’écriture du code rend davantage de petits projets réalisables. Il s’agit de points de vue de la communauté, pas de conclusions statistiques.
S’inspirer de l’équipe Codex Agent : une boucle de rétroaction pilotée par les tests
Ce qu’on peut le plus facilement reprendre de Pando, ce n’est pas son échelle, mais sa façon de fournir aux agents des retours exploitables. Voici une boucle minimale pilotée par les tests : le modèle génère un correctif, puis reçoit les résultats des tests pour poursuivre ses modifications.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d’APIYI
)

resp = client.chat.completions.create(
    model="YOUR_CODING_MODEL",  # Remplacez par le modèle de programmation à tester
    messages=[{"role": "user", "content": "根据以下失败测试修复函数:..."}]
)
print(resp.choices[0].message.content)
Voir l’implémentation complète de la boucle de rétroaction
import subprocess
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM = (
    "你是严格遵守约束的工程 Agent。"
    "只修改指定文件,不得改动测试;输出完整的新文件内容。"
)

def run_tests() -> tuple[bool, str]:
    """Exécute les vérifications, comme les tests de compatibilité de Pando"""
    r = subprocess.run(["pytest", "-q", "tests/"], capture_output=True, text=True)
    return r.returncode == 0, r.stdout[-3000:] + r.stderr[-1000:]

def agent_loop(target: str, spec: str, max_rounds: int = 5) -> bool:
    for i in range(max_rounds):
        ok, log = run_tests()
        if ok:
            print(f"第 {i} 轮:测试全部通过,等待人工审核")
            return True
        source = open(target, encoding="utf-8").read()
        resp = client.chat.completions.create(
            model="YOUR_CODING_MODEL",
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content":
                    f"需求与约束:\n{spec}\n\n当前代码:\n{source}\n\n测试输出:\n{log}"}
            ],
        )
        with open(target, "w", encoding="utf-8") as f:
            f.write(resp.choices[0].message.content)
    print("达到轮次上限,转交人类工程师处理")
    return False

agent_loop("src/ref_store.py", "同一分支的并发更新必须只有一个成功")
🚀 Pour commencer : pour mettre en place ce type de boucle, vous pouvez obtenir un crédit de test gratuit sur APIYI apiyi.com. Une même clé API vous permet d’essayer différents modèles de programmation et de comparer leur taux de correction sur votre jeu de tests.
Le tableau ci-dessous transpose l’approche de Pando en un cadre applicable par une équipe classique. Ces suggestions s’appuient sur les informations communiquées officiellement ; il ne s’agit pas d’un workflow propre à Pando publié par OpenAI.
| Étape | Actions clés | Pratique correspondante dans Pando | Outils possibles |
|---|---|---|---|
| Définir les objectifs et les limites | Préciser les protocoles à prendre en charge et les critères non négociables | Maintien de la compatibilité avec le protocole Git | Documents de conception, AGENTS.md |
| Créer l’environnement de validation | Tests de compatibilité, simulation de concurrence, détection des régressions | Tests de conformité et simulation déterministe | pytest, tests de propriétés, TLA+ |
| Répartir le travail entre les agents | Petites tâches, branches indépendantes, exécution automatique des tests | Implémentation par plusieurs équipes d’agents | Invocation de plusieurs modèles, par exemple via APIYI apiyi.com |
| Faire une revue humaine | Examiner les choix importants, les dépendances entre modules et les effets sur la sécurité | Architecture supervisée par des ingénieurs humains | Règles de revue de code |
| Déployer progressivement | Commencer avec une faible part du trafic et maintenir la compatibilité avec l’ancien système | Proxy de lecture et d’écriture vers l’ancien système, migration par lots | Déploiement progressif, indicateurs de surveillance |
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que Pando ?
Pando est le backend serveur interne d’OpenAI compatible avec Git. Il prend en charge toutes les activités de développement de son monorepo. Il conserve le protocole et les clients Git standard, mais repense la mise à jour des références, la réutilisation du stockage des packfiles et la mise à disposition des données en cache. Son objectif : permettre à un grand nombre d’agents et d’ingénieurs de soumettre et de lire du code simultanément.
Q2 : Pando a-t-il été créé par une seule personne avec Codex ?
Non. Selon OpenAI, un ingénieur a conçu l’architecture centrale, plusieurs équipes d’agents l’ont implémentée et un petit nombre d’ingénieurs l’ont déployée. OpenAI n’a pas communiqué le nombre de participants, la proportion de code modifiée par des humains ni la configuration des agents. L’entreprise n’a pas non plus affirmé que tout le code avait été généré par Codex ou qu’il n’avait fait l’objet d’aucune revue humaine.
Q3 : Quand Pando a-t-il été mis en service et peut-on l’utiliser à l’extérieur d’OpenAI ?
Pando a commencé à traiter du trafic de production en avril 2026, et l’article technique a été publié le 2 novembre 2026. Au 3 novembre 2026, aucun serveur, aucune API, aucun tarif ni aucune date d’ouverture au public n’avaient été annoncés. Seuls le fork du client Git d’OpenAI et certains correctifs soumis au projet d’origine sont publics : cela ne signifie pas que le serveur Pando est open source.
Q4 : Tout le travail de validation a-t-il été réalisé en 10 semaines ?
Il ne faut pas le comprendre ainsi. Selon OpenAI, les nouveaux modèles ont été utilisés au fur et à mesure de leur apparition pour améliorer Pando. Rien ne permet de confirmer que les travaux de formalisation en Lean/TLA+ assistés par GPT-6 Astra, les centaines d’heures de sessions d’agents et les tests adversariaux se sont tous déroulés pendant les 10 premières semaines. La plupart des correctifs Git publics sont également postérieurs à la première mise en production.
Q5 : Comment mettre en place une boucle de test et de retour similaire pour des agents à l’aide d’une API ?
Mieux vaut commencer par un petit module :
1. Inscrivez-vous sur APIYI apiyi.com pour obtenir une clé API et un crédit d’essai gratuit
2. Préparez d’abord des tests exécutables ou des vérifications de compatibilité, puis demandez au modèle de modifier le code
3. Utilisez le code de cet article, définissez base_url sur `https://api.apiyi.com/v1`, puis répétez le cycle « génération — test — retour des journaux »
Comme l’interface est compatible avec OpenAI, il suffit de modifier le paramètre model pour changer de modèle et comparer l’efficacité des corrections.
Q6 : Quelles limites une équipe classique rencontrerait-elle en reprenant directement la méthode de Pando ?
Il y en a trois principales : d’abord, le coût est inconnu, car OpenAI n’a pas publié les dépenses liées aux tokens et à l’infrastructure ; ensuite, Pando repose sur un système de validation de grande qualité, et laisser les agents écrire beaucoup de code dans un projet sans tests présente davantage de risques ; enfin, le résultat obtenu en 10 semaines ne peut pas être généralisé à tous les projets de même ampleur. Commencez par une expérimentation à petit budget sur un module non critique avec APIYI apiyi.com, puis élargissez le périmètre une fois l’efficacité de la boucle de retour confirmée.
Pando et Codex Agent : points clés
- Qu’est-ce que Pando ? Un backend interne d’OpenAI compatible avec Git, mis en production en environ 10 semaines et non accessible au public.
- Pourquoi l’avoir créé ? Codex a entraîné une hausse des soumissions simultanées, provoquant des ralentissements et des échecs de fusion dans l’ancien système.
- Répartition entre humains et agents : les humains définissent l’architecture et les contraintes, les agents itèrent sur l’implémentation, et les ingénieurs assurent le déploiement.
- Clés de la réussite : les tests de compatibilité, la simulation déterministe et la vérification formelle fournissent un retour fiable.
- Limites de la chronologie : les nouveaux modèles et méthodes de vérification apparus par la suite ne peuvent pas tous être attribués aux 10 premières semaines.
- Mise en production : un proxy relayant les lectures et les écritures, associé à une migration progressive du trafic, a permis de poursuivre le développement sans interruption.
- Pour commencer : créez d’abord des tests, puis utilisez APIYI apiyi.com pour valider la boucle de feedback avec plusieurs modèles.
Conclusion
Les principaux enseignements du cas Pando :
- Le passage à l’échelle pousse l’infrastructure à évoluer : la hausse des soumissions liée au codage assisté par IA se répercute sur Git, la CI et la revue de code. Pando est une réponse technique à cette pression.
- La qualité du travail des agents dépend de la validation : les agents Codex ont pu contribuer à l’implémentation de l’infrastructure grâce à des tests de compatibilité exécutables, des simulations de concurrence et des descriptions formelles.
- Les décisions humaines restent essentielles : les ingénieurs sont responsables des compromis architecturaux, des limites de cohérence et de la migration en production.
Pour la plupart des équipes, ce n’est pas le chiffre de « 10 semaines » qu’il faut chercher à reproduire, mais cinq éléments : des contraintes claires, des tests exécutables, une répartition des tâches, un feedback continu et des décisions clés prises par des humains. Inutile de viser un développement entièrement automatisé : commencez par faire fonctionner la boucle de feedback avec un agent sur un petit module entièrement testé, puis élargissez progressivement le périmètre.
Pour évaluer rapidement les résultats, vous pouvez utiliser APIYI apiyi.com. La plateforme propose une interface compatible avec OpenAI et un crédit gratuit pour les nouveaux utilisateurs, ce qui facilite la comparaison de différents modèles de programmation dans une même boucle de feedback.
📚 Références
- Article technique officiel d’OpenAI, Scaling Git at OpenAI : principale source sur l’architecture, la migration et les performances de Pando
- Lien :
openai.com/index/scaling-git-at-openai -
À noter : publié le 02/11/2026, cet article constitue la source centrale des faits présentés ici
-
OpenAI Harness Engineering : un autre projet interne dont le développement a été piloté par Codex
- Lien :
openai.com/index/harness-engineering -
À noter : utile pour comprendre la méthodologie d’ingénierie des agents, mais ses données ne doivent pas être confondues avec celles de Pando
-
Custom Code Review Rules for Codex : les goulots d’étranglement dans la revue de code liés à l’AI Coding
- Lien :
developers.openai.com/blog/custom-code-review-rules-for-codex -
À noter : présente la croissance du nombre de PR hebdomadaires en interne et les règles de revue définies dans AGENTS.md
-
Fork Git public d’OpenAI : dépôt des améliorations apportées au client
- Lien :
github.com/openai/git -
À noter : contient des améliorations comme packfile-uri, mais pas le code source du serveur Pando
-
Suivi des correctifs Git d’OpenAI : historique des contributions au projet en amont
- Lien :
oai-git.openai.chatgpt.site - À noter : permet de vérifier les améliorations techniques continues après la mise en production
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI. Pour plus de ressources sur le développement d’agents, consultez le centre de documentation docs.apiyi.com.