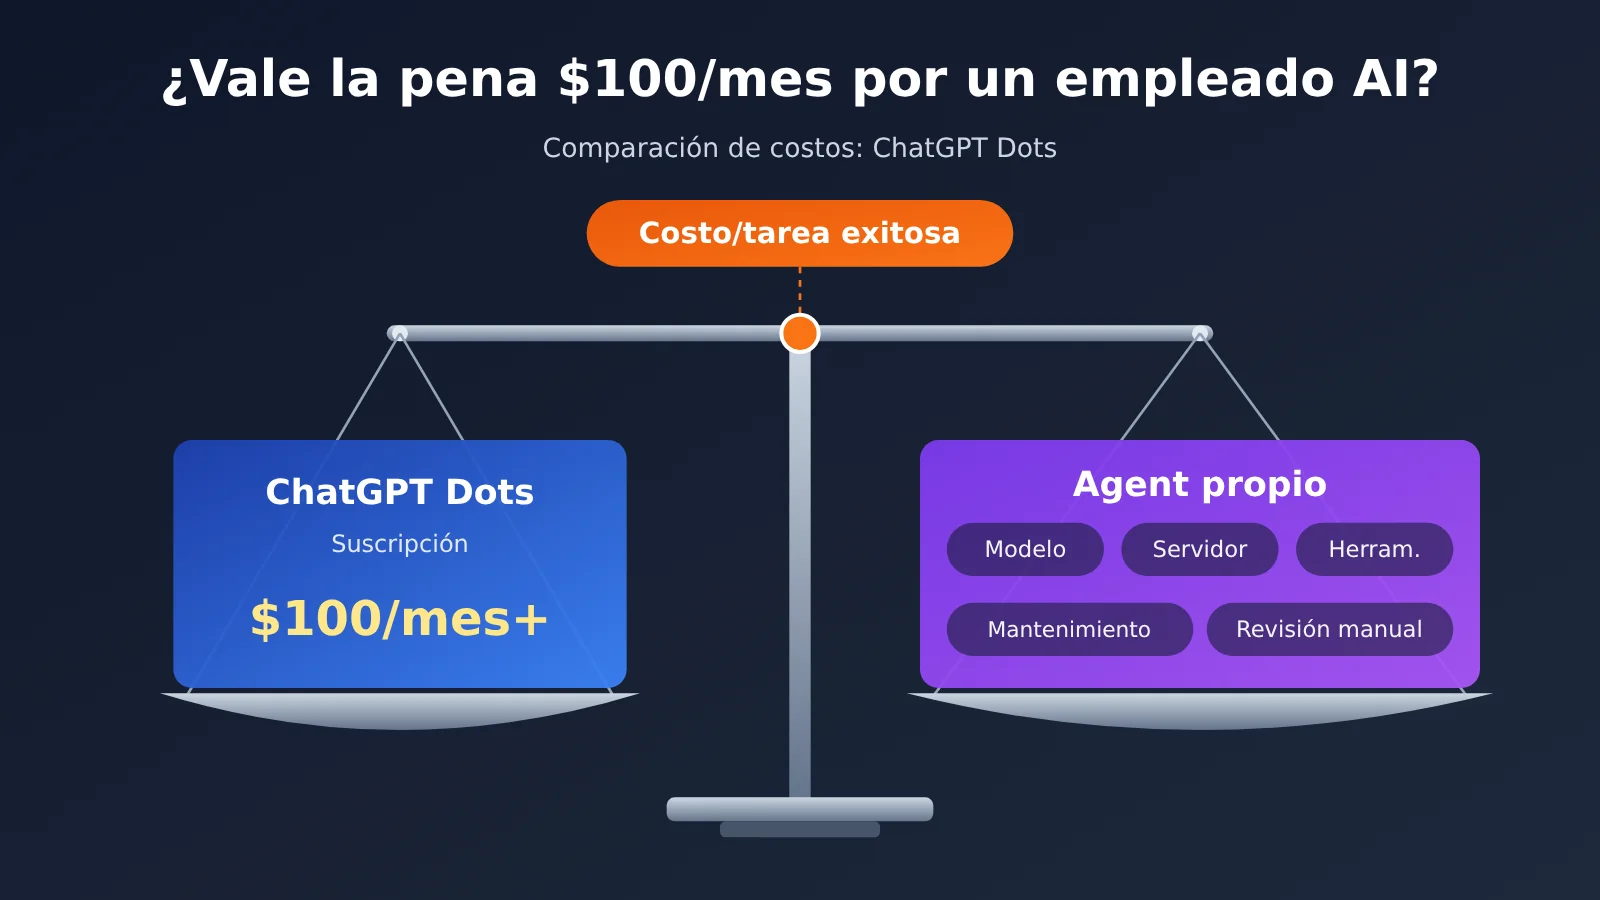
Nota del autor: compara, usando el costo de tarea exitosa bajo el mismo estándar de entrega, el gasto de la suscripción a ChatGPT Dots frente al de un Agent autoconstruido en modelo, infraestructura, mantenimiento y revisión humana.
Conclusión central: para saber si vale la pena «pagar $100 al mes por un empleado de IA», hay que mirar el costo total de completar una tarea que cumpla el estándar bajo un mismo criterio de entrega; la cuota mensual y el precio unitario por Token son solo una parte de ese total. Según la información oficial del 16 de noviembre de 2026, el punto de entrada para que un usuario individual use ChatGPT Dots es Pro 100 ($100/mes), y la suscripción incluye computadora en la nube, contexto de larga duración, coordinación de tareas y conexiones con aplicaciones. En una muestra hipotética, el costo de modelo de un Agent autoconstruido para 300 tareas al mes ronda entre $33 y $66, pero eso todavía no cuenta servidores, herramientas, desarrollo y mantenimiento, reintentos por fallo ni revisión humana. Qué ruta sale más barata solo se puede concluir después de medir con el mismo lote de tareas.
Este artículo primero desglosa los criterios de precio y el alcance de capacidades de la suscripción Dots; luego divide el costo de un Agent autoconstruido en cinco categorías —modelo, infraestructura, herramientas, desarrollo y mantenimiento— y usa los precios de Claude en APIYI para mostrar cómo se calcula el costo de Token por tarea. Después compara Dots, un Agent de un solo modelo y un Agent multimodelo en seis dimensiones, y propone un método de experimento comparativo centrado en el «costo de tarea exitosa». Por último, ofrece recomendaciones según tres tipos de necesidad —usuario individual, desarrollador de uso intensivo y empresa— y presenta formas de gestionar el costo combinando suscripción y API.
Para saber: 8 términos clave para entender el costo de un empleado de IA
| Término | Explicación |
|---|---|
| Suscripción Pro | Plan de ChatGPT con pago mensual, que incluye los beneficios y la cuota de uso correspondientes; Pro 100, Pro 200 y Pro 500 pueden usar Dots |
| Dot | Agente personal permanente dentro de ChatGPT Dots, con su propia computadora en la nube y navegador, capaz de seguir avanzando las tareas delegadas |
| Token | Unidad con la que el modelo mide el contenido de entrada y salida; la API se factura por cada millón de tokens |
| Lectura de caché | El contenido de prefijo repetido en la solicitud (como indicaciones del sistema o definiciones de herramientas) reutiliza resultados de procesamiento ya existentes, con un precio unitario muy inferior al de la entrada normal |
| Escritura de caché | La primera vez que se guarda un prefijo reutilizable para que lo lean solicitudes posteriores; las reglas de facturación se rigen por la consola de la plataforma |
| Costo de infraestructura | Gastos de servidores, contenedores, bases de datos, almacenamiento y entorno de ejecución necesarios para construir un Agente propio |
| Tasa de éxito de tareas | Proporción de tareas entregadas de forma aceptable, según un criterio de aceptación unificado, tras una o varias ejecuciones |
| Costo por tarea exitosa | Gasto total de todas las ejecuciones (incluidos reintentos fallidos), infraestructura y revisión humana, dividido entre el número de tareas entregadas de forma aceptable |
1 Qué se obtiene con ChatGPT Dots por 100 dólares al mes
1.1 Criterios de precios de ChatGPT Dots: Pro individual y empresa
OpenAI lanzó oficialmente ChatGPT Dots el 29 de septiembre de 2026. Su posicionamiento es el de un Agente de IA personal persistente: una vez que el usuario delega un objetivo, Dot puede seguir avanzando el trabajo en la nube mientras el usuario se ausenta o apaga el ordenador, y le devuelve el asunto cuando hace falta tomar una decisión.
Al hablar del precio de Dots, hay que distinguir claramente entre el Pro individual y el Dot empresarial. La siguiente tabla está elaborada a partir de la documentación oficial de ayuda de OpenAI, consultada el 16 de noviembre de 2026.
| Destinatario | Criterio de precio | Condiciones de aplicación | Parte facturada por separado |
|---|---|---|---|
| ChatGPT Pro 100 | $100/mes | Mayores de 18 años; excluye el Espacio Económico Europeo, Reino Unido y Suiza; despliegue gradual | Las tareas delegadas de Work/Codex consumen la cuota del producto correspondiente |
| ChatGPT Pro 200 | $200/mes | Igual que arriba | Igual que arriba |
| ChatGPT Pro 500 | $500/mes | Igual que arriba | Igual que arriba |
| Espacio de trabajo Enterprise | Tarifa fija según el tipo de trabajo o facturación por uso; el importe se rige por el contrato o la cotización del espacio de trabajo | Del 2026-11-04 al 11-18 hay un periodo de vista previa gratuito para administradores; los Dots activados a partir del 11-18 empiezan a facturarse; cada miembro puede crear 1 Dot personal | Las tareas delegadas a Work o Codex se cobran por separado según la tarifa estándar correspondiente |
En las explicaciones sobre Dots para el Pro individual no se indica ninguna suscripción mensual independiente para Dots: la cuota mensual de Pro es el umbral de uso. La documentación oficial también aclara que las tareas de ChatGPT Work o Codex delegadas por Dot se calculan según las reglas de cuota del producto correspondiente, y que el consumo depende de factores como el modelo, el contexto, el razonamiento, las llamadas a herramientas y la recuperación de información. Por tanto, los $100/mes corresponden a un conjunto delimitado de cuotas de uso, y los materiales oficiales tampoco indican cuántas tareas de trabajo profundo equivale el Dot de un Pro individual.
1.2 Capacidades de empleado de IA incluidas en la suscripción a Dots
Cuando se compara Dots con las llamadas a API, es fácil fijarse solo en el apartado «modelo». En realidad, la suscripción incluye todo un entorno de ejecución que, si lo construyes por tu cuenta, tendrías que implementar tú mismo:
- Computadora y navegador en la nube: cada Dot tiene su propia computadora en la nube, puede abrir sitios web, organizar documentos y crear informes, y el usuario puede ver y tomar el control de la operación en cualquier momento.
- Contexto de largo plazo: combina ChatGPT Memory, las notas propias de Dot, los materiales de la tarea actual y los datos de las aplicaciones autorizadas.
- Coordinación de múltiples proyectos: divide tareas complejas, lanza agentes de investigación en segundo plano para procesarlas en paralelo, consolida los resultados y solicita la intervención del usuario cuando algo se bloquea.
- Modo de trabajo continuo: admite tareas programadas y monitoreo de eventos; por ejemplo, revisar a los competidores cada semana o vigilar los nuevos bugs que aparecen en Slack.
- Investigación proactiva: cuando no hay mensajes nuevos, investiga fuentes de datos autorizadas; este proceso es de solo lectura y las acciones posteriores deben pasar por la aprobación normal.
- Conexión de aplicaciones y canales de comunicación: en el lanzamiento, la descripción oficial menciona un ecosistema de plugins conectables de más de 4.000 aplicaciones, y se puede contactar a través de canales como ChatGPT, Slack, Microsoft Teams, etc.
- Mecanismos de permisos y seguridad: Custom Rules define los límites de ejecución, Auto-review revisa antes de operaciones como enviar correos, y operaciones como cambiar contraseñas o transferir fondos deben ser asumidas por el usuario.
Las pruebas de terceros sirven como referencia para los límites de capacidad. En una prueba de Axios del 20 de octubre de 2026, Dots creó un programa conmemorativo de la WNBA de 38 páginas y generó en 47 segundos un álbum de fotos conmemorativo de 12 páginas, pero en el programa aparecieron estadísticas cuestionables, y la parte de compras también requirió que el usuario fuera a la aplicación Target para completarla por su cuenta. La conclusión del autor es que este tipo de agentes sirven para asumir investigación y preparación, pero los resultados aún necesitan edición humana y verificación de hechos. Esta conclusión determina directamente que el modelo de costos que veremos más adelante debe incluir revisión humana.
2 Costo completo de construir tu propio agente de IA como empleado
2.1 Los cinco tipos de costos de un agente autoconstruido
Si construyes con API un agente capaz de trabajar de forma continua, la factura va mucho más allá de la invocación del modelo. Puedes desglosar el costo en cinco categorías:
- Costo de modelo: entrada, salida, lectura y escritura de caché y consumo de inferencia; varía linealmente con el volumen de tareas.
- Costo de infraestructura: servidores en la nube, contenedores, bases de datos y almacenamiento; una parte es alquiler mensual fijo y otra varía con la carga.
- Costo de herramientas: API de búsqueda, navegador headless e interfaces de datos de terceros; normalmente se factura por número de llamadas.
- Costo de desarrollo: desarrollo inicial, integración de sistemas y diseño de permisos; la inversión se concentra al principio.
- Costo de mantenimiento: monitorización y alertas, resolución de incidencias y pruebas de regresión tras actualizar el modelo; ocurre de forma continua.
Escrito como fórmula:
$$C_{self}=C_{API}+C_{infra}+C_{tools}+C_{dev}+C_{maintenance}$$
La estructura de costos de la ruta de suscripción es:
$$C_{subscription}=C_{plan}+C_{extra\ usage}+C_{human\ review}$$
En ambas rutas hay que contabilizar el tiempo humano. En la ruta autoconstruida, el tiempo humano se reparte entre desarrollo, mantenimiento y revisión; en la ruta de suscripción, se concentra sobre todo en delegar tareas, revisar resultados y aprobar.
2.2 Un diseño para un agente de IA como empleado autoconstruido
A continuación presentamos un diseño para estimar costos, que sirve para explicar qué componentes necesita un agente autoconstruido. Introduce el costo de cada componente según la cotización real del servicio en la nube que elijas; este artículo no ha realizado una prueba de despliegue de este diseño.
- Capa de programación: disparadores temporizados o colas de mensajes, responsables de tareas periódicas como «generar el informe de inteligencia cada día a las 8:00».
- Capa de orquestación: el framework del agente se encarga de planificar pasos, invocar herramientas y guardar estados intermedios (como el Checkpointer de LangGraph o los flujos de trabajo del OpenAI Agents SDK).
- Capa de modelo: invoca modelos mediante una interfaz compatible con OpenAI y enruta a distintos modelos según la dificultad de la tarea.
- Capa de herramientas: búsqueda, scraping web, navegador headless y generación de archivos.
- Capa de estado: la base de datos guarda registros de tareas, notas a largo plazo e información de deduplicación.
- Capa de aprobación: las operaciones que impliquen envío externo, pagos o eliminación entran en una cola de aprobación humana.
- Capa de observabilidad: registra los tokens, el tiempo de ejecución y la causa de los fallos de cada invocación, como fuente de datos para calcular costos.
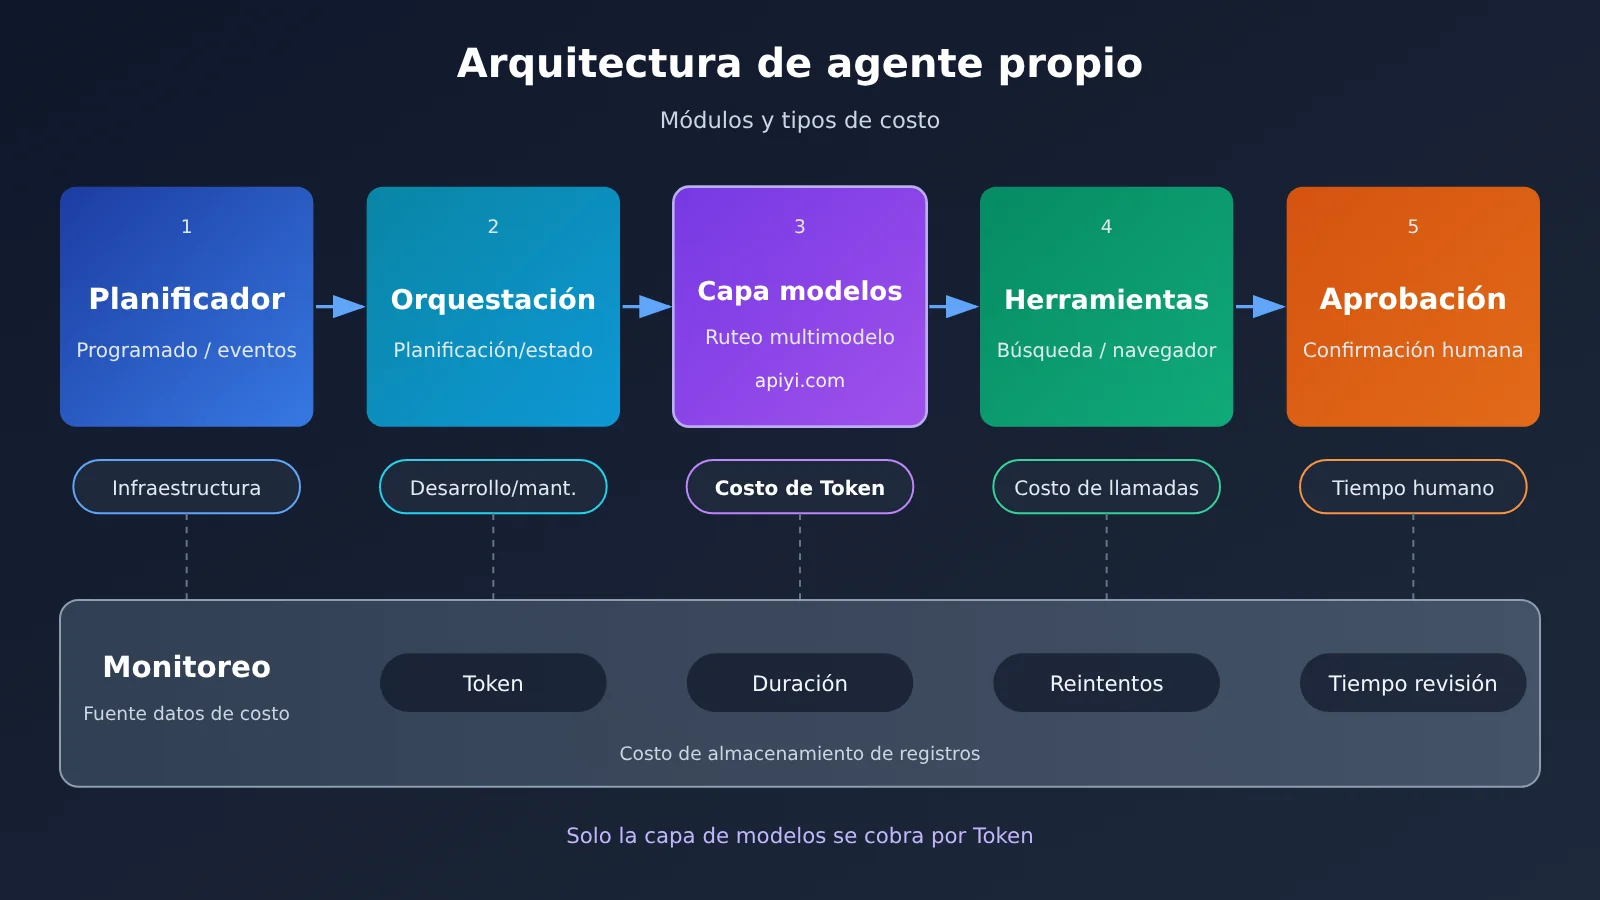
De los siete componentes de este diagrama, solo el costo de la capa de modelo puede calcularse directamente con el precio por token; el costo de los demás componentes depende de la arquitectura elegida y de la capacidad del equipo. Esa es la razón por la que el costo de tokens solo representa una parte del costo de la vía autoconstruida.
3 Cuántos tokens consume una tarea de un empleado de IA
3.1 Diferencias de facturación entre entrada, salida y caché
Una tarea de un Agent normalmente incluye varias rondas de invocación del modelo: una para planificar, otra para razonar después de cada llamada a herramienta y una última para resumir. En cada ronda, la indicación del sistema, las definiciones de herramientas y los pasos anteriores se vuelven a enviar como entrada, por lo que los tokens de entrada del Agent suelen ser mucho mayores que los de salida.
Aquí es donde entra en juego la caché. La indicación del sistema y las definiciones de herramientas permanecen iguales a lo largo de varias rondas; cuando se acierta la caché, se factura al precio de lectura de caché, que es aproximadamente una vigésima parte del precio de la entrada normal. La escritura en caché se produce la primera vez que se guarda el prefijo; su precio depende de lo que indique la consola de la plataforma y no se ha incluido en los ejemplos de este artículo.
3.2 Cálculo del costo del modelo por tarea con los precios de APIYI
Los siguientes precios provienen de los precios de los modelos Claude publicados por APIYI el 13 de noviembre de 2026; en la práctica, prevalecen la consola y la lista de modelos en el momento de la invocación. El uso por tarea es una muestra hipotética utilizada para demostrar el algoritmo: cada tarea tiene 30,000 tokens de entrada y 5,000 tokens de salida, con 300 tareas al mes. Esta muestra no tiene relación con el consumo promedio real de Dots ni de ninguna otra plataforma.
| Concepto de cálculo | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Precio de entrada / salida / lectura de caché (por millón de tokens) | $4 / $20 / $0.20 | $2 / $10 / $0.10 |
| Costo por tarea (sin caché) | 30,000×$4/10⁶ + 5,000×$20/10⁶ = $0.22 | 30,000×$2/10⁶ + 5,000×$10/10⁶ = $0.11 |
| Costo mensual de 300 tareas (sin caché) | $66 | $33 |
| Costo por tarea (suponiendo que 20,000 tokens de entrada acceden a lectura de caché) | $0.04 + $0.004 + $0.10 = $0.144 | $0.02 + $0.002 + $0.05 = $0.072 |
| Costo mensual de 300 tareas (con la suposición de lectura de caché) | $43.2 | $21.6 |
| Plataformas disponibles | APIYI, API oficial | APIYI, API oficial |
Con esta suposición, el costo puro del modelo es inferior a la tarifa mensual de $100 de Pro 100. Este resultado solo indica que la capa del modelo es económica; no incluye infraestructura, herramientas, desarrollo y mantenimiento, ni revisión humana, y tampoco considera reintentos tras fallos.
3.3 Registrar con código el uso real de tokens en tareas de empleados de IA
Para calcular el costo hay que reemplazar los valores supuestos por el uso real. El siguiente ejemplo minimalista llama al modelo una vez y lee el campo usage de la respuesta:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

resp = client.chat.completions.create(
    model="claude-sonnet-5.5",  # Usa el nombre real exacto de la lista de modelos de APIYI
    messages=[{"role": "user", "content": "Resume los puntos clave de las noticias de IA de hoy"}]
)
print(resp.usage)  # Número de tokens de entrada y salida, para el cálculo de costos
Ver la implementación completa: registrar cada ejecución y calcular el costo por tarea exitosa
import time
import openai
from dataclasses import dataclass, field

# Precio por millón de tokens (USD), según la consola en el momento de la llamada
PRICES = {
    "claude-opus-5.5":   {"input": 4.0, "output": 20.0, "cache_read": 0.20},
    "claude-sonnet-5.5": {"input": 2.0, "output": 10.0, "cache_read": 0.10},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class RunRecord:
    task_id: str
    model: str
    input_tokens: int
    output_tokens: int
    cached_tokens: int
    seconds: float
    cost: float
    passed: bool = False          # Determinación manual según criterio de aceptación unificado
    review_minutes: float = 0.0   # Tiempo de revisión y corrección humana

@dataclass
class Ledger:
    runs: list = field(default_factory=list)

    def call(self, task_id: str, model: str, messages: list) -> str:
        start = time.time()
        resp = client.chat.completions.create(model=model, messages=messages)
        usage = resp.usage
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        p = PRICES[model]
        uncached_input = usage.prompt_tokens - cached
        cost = (uncached_input * p["input"]
                + cached * p["cache_read"]
                + usage.completion_tokens * p["output"]) / 1_000_000
        self.runs.append(RunRecord(task_id, model, usage.prompt_tokens,
                                   usage.completion_tokens, cached,
                                   time.time() - start, cost))
        return resp.choices[0].message.content

    def cost_per_success(self, hourly_rate: float, fixed_cost: float = 0.0) -> float:
        """(costo total de ejecuciones + costo fijo + revisión humana) / número de tareas aprobadas"""
        api = sum(r.cost for r in self.runs)
        review = sum(r.review_minutes for r in self.runs) / 60 * hourly_rate
        passed_tasks = {r.task_id for r in self.runs if r.passed}
        if not passed_tasks:
            return float("inf")
        return (api + fixed_cost + review) / len(passed_tasks)

ledger = Ledger()
text = ledger.call("news-1116", "claude-sonnet-5.5",
                   [{"role": "user", "content": "Resume los puntos clave de las noticias de IA de hoy"}])
ledger.runs[-1].passed = True
ledger.runs[-1].review_minutes = 8
print(ledger.cost_per_success(hourly_rate=30, fixed_cost=0))
🚀 Consejo para empezar rápido: cuando hagas experimentos de comparación de costos, primero puedes llamar por separado a Opus y Sonnet desde APIYI apiyi.com con la misma clave API, conectar el
Ledgerde arriba a tu Agent, dejarlo correr una semana completa de tareas reales y después revisar el libro de cuentas. La plataforma cobra por uso y los usuarios nuevos tienen crédito de prueba gratuito, así que resulta ideal para obtener datos reales de tokens antes de meterte de lleno en el desarrollo.
Por qué el costo de los empleados de IA se diferencia tanto según el modelo
En el ejemplo hipotético de la sección 3, el costo de modelo por tarea de Opus 5.5 es el doble del de Sonnet 5.5. Si solo se mira esa columna, Sonnet ahorra $33 al mes. Pero el costo final de las tareas de agentes también depende de la tasa de éxito y de la revisión humana. A continuación, se muestra este efecto con un conjunto de parámetros hipotéticos.
Supongamos que Opus tiene una tasa de aprobación del 90% en una ejecución y Sonnet del 60%, y que las tareas no aprobadas se vuelven a ejecutar hasta que pasen. Calculado por valor esperado, el costo de modelo por tarea aprobada sería aproximadamente $0.22÷0.9 ≈ $0.24 y $0.11÷0.6 ≈ $0.18, respectivamente. La diferencia en las tasas de éxito ya se lleva buena parte de la ventaja en el precio unitario.
El impacto del tiempo humano es aún mayor. Supongamos que la tarifa horaria del revisor equivale a $30, es decir, unos $0.5 por minuto de trabajo humano. Con que la salida de Sonnet requiera en promedio solo 1 minuto adicional de corrección por tarea, el aumento de $0.5 ya supera toda la diferencia de precio unitario entre los dos modelos. En tareas de inteligencia y elaboración de informes que exigen verificar los datos uno por uno, el tiempo de revisión suele medirse en minutos; en esos casos, elegir el modelo más estable termina reduciendo el costo total.
Por el contrario, en tareas simples con formato fijo y fáciles de validar automáticamente (como clasificación, resumen o extracción de campos), la tasa de éxito del modelo económico puede acercarse a la del modelo más caro; para este tipo de tareas, usar Sonnet o un modelo más barato es más razonable. Las decisiones en ambos sentidos solo se pueden aplicar después de medir la tasa de éxito con tareas reales.
5. Comparación de seis dimensiones de empleados de IA: Dots, Agent de un solo modelo y Agent de múltiples modelos
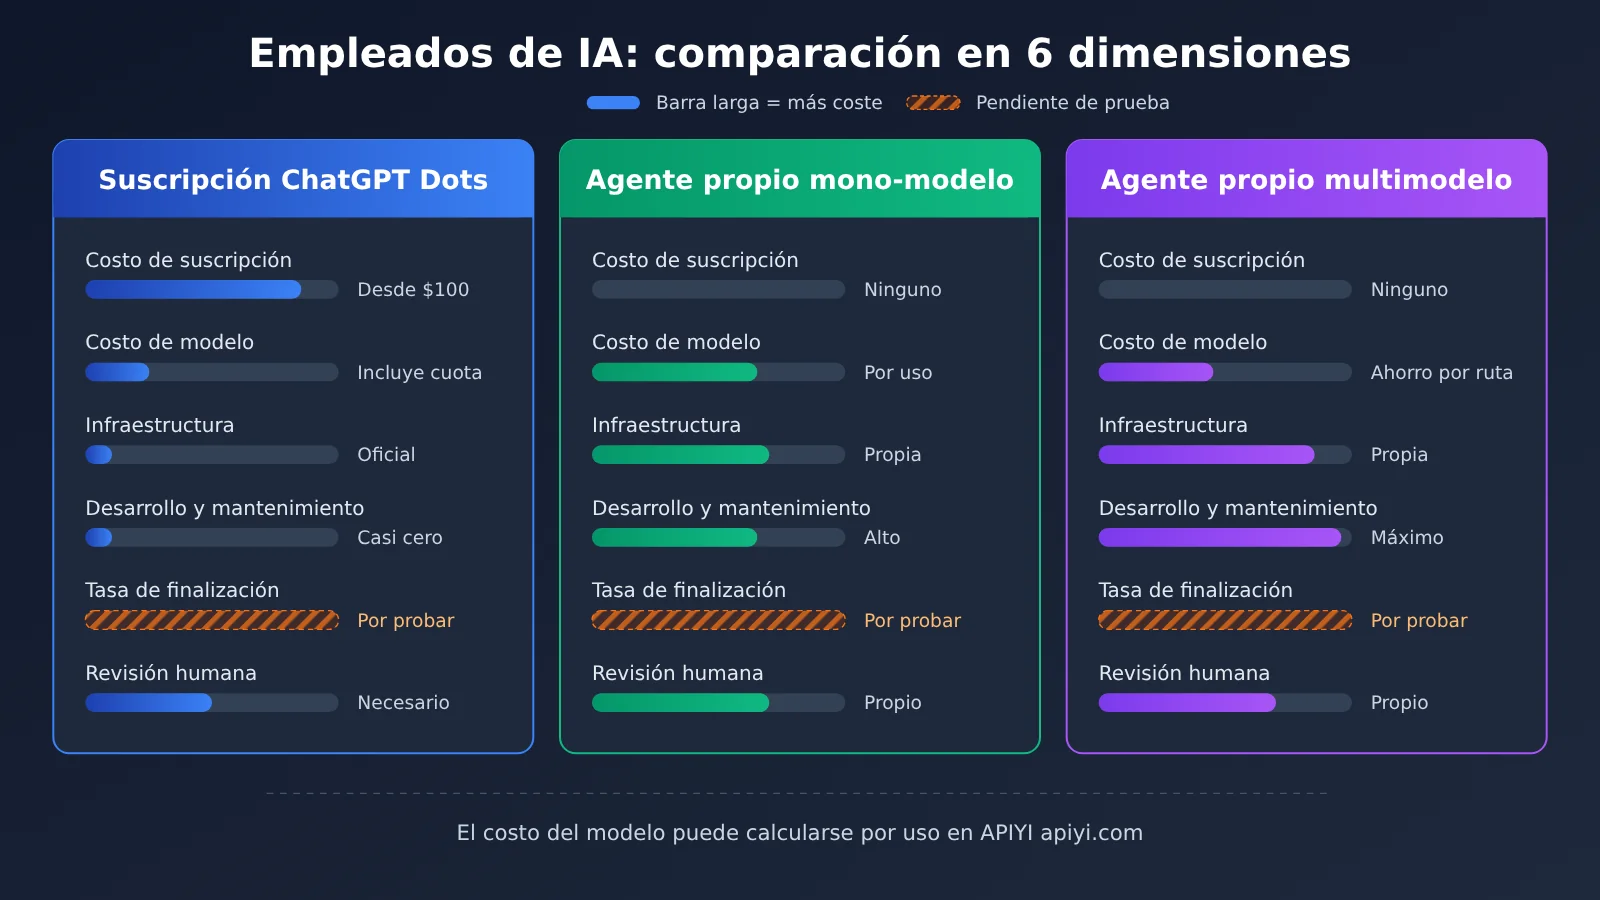
| Dimensión | ChatGPT Dots | Agent de un solo modelo (autoconstruido) | Agent de múltiples modelos (autoconstruido) |
|---|---|---|---|
| Costo de suscripción | Pro personal desde $100/mes; empresa según contrato | Ninguno | Ninguno |
| Costo del modelo | Incluido en la cuota de suscripción; delegar a Work/Codex consume cuota adicional | Facturación por Token, crece linealmente con el volumen de tareas | Facturación por Token; el enrutamiento por dificultad permite bajar el precio medio |
| Infraestructura | Ordenador en la nube y navegador proporcionados oficialmente | Servidor, base de datos y entorno de navegador propios | Igual que el de un solo modelo, más lógica de enrutamiento y evaluación |
| Desarrollo y mantenimiento | Prácticamente cero desarrollo; sobre todo configurar reglas y permisos | Mayor inversión de desarrollo inicial; mantenimiento continuo | La mayor complejidad de desarrollo y mantenimiento |
| Tasa de finalización de tareas | Requiere medirla con tus propias tareas; las pruebas de terceros indican que aún hace falta verificación manual | Depende del modelo y de la calidad de la ingeniería; requiere medición | Depende de la estrategia de enrutamiento; requiere medición |
| Revisión manual | Necesaria; se apoya en Auto-review y en mecanismos de aprobación | Necesaria; el flujo de aprobación debe construirse por cuenta propia | Necesaria; el flujo de aprobación debe construirse por cuenta propia |
| Integración de modelos | Integrada en los productos OpenAI | Mediante la interfaz unificada de APIYI | Llamar a modelos de varios proveedores con una sola Key a través de APIYI |
Análisis comparativo de Dots: Dots tiene ventajas claras en uso inmediato, colaboración entre aplicaciones y contexto a largo plazo; el ordenador en la nube, el ecosistema de más de 4.000 aplicaciones y la comunicación multicanal no requieren desarrollo. Sus límites: las reglas de cuota no son transparentes hasta el número de tareas, la lógica de ejecución no se puede personalizar en profundidad, y el Pro personal aún tiene restricciones de región y edad.
Análisis comparativo del Agent de un solo modelo: La estructura de costos del Agent de un solo modelo es la más clara: los Token y el costo de cada invocación se pueden registrar con precisión, y la lógica de ejecución es totalmente controlable. El precio a pagar es construir por cuenta propia el navegador, la orquestación, el estado y la aprobación; la tasa de finalización de tareas depende por completo de la capacidad de ingeniería del equipo.
Análisis comparativo del Agent de múltiples modelos: El Agent de múltiples modelos asigna los pasos simples a modelos económicos y la推理 clave a modelos potentes; con un volumen de tareas alto es el que tiene más oportunidades de reducir el costo por tarea exitosa. Es el que exige más del sistema de evaluación: hay que monitorear de forma continua la tasa de éxito de cada modelo en cada tipo de paso.
6 Medir si un empleado de IA vale la pena mediante el costo por tarea exitosa
6.1 Costo por tarea exitosa y fórmula de ROI
El criterio unificado de medición es:
$$C_{successful\ task}=\frac{C_{all\ runs}+C_{infrastructure}+C_{review}}{N_{successfully\ completed\ tasks}}$$
El numerador incluye todas las ejecuciones (incluidas las fallidas y los reintentos), la infraestructura prorrateada para ese periodo y la revisión humana; el denominador solo cuenta las tareas entregadas que cumplen los criterios. En el caso de Dots, el «costo de ejecución» del numerador se sustituye por la cuota mensual de suscripción y el consumo adicional.
Sobre esta base, se puede calcular el retorno de la inversión:
$$ROI=\frac{V_{time\ saved}-C_{total}}{C_{total}}$$
Para calcular el tiempo ahorrado, hay que partir del tiempo real que una persona habría necesitado para completar esa tarea y multiplicarlo por un costo de mano de obra razonable. El hecho de que el modelo genere un documento en decenas de segundos solo refleja la velocidad de generación; al tiempo de trabajo humano ahorrado hay que restarle la parte correspondiente a revisión y corrección.
6.2 Experimento comparativo de costos de empleados de IA en tres tipos de tareas
Se recomienda seleccionar tres tareas recurrentes representativas: inteligencia diaria de noticias de IA, monitoreo semanal de la competencia e informes mensuales de análisis documental. Con los mismos materiales de entrada y el mismo estándar de entrega, asignarlas por separado a ChatGPT Dots, APIYI + agente de un solo modelo y APIYI + agente multimodelo, y registrar en cada ejecución los siguientes elementos:
| Elemento registrado | Método de registro | Uso |
|---|---|---|
| Hora de inicio y finalización | Marcas de tiempo del registro de tareas | Calcular el ciclo real de entrega |
| Número de invocaciones del modelo | Recuento de la capa de orquestación | Identificar bucles y llamadas excesivas |
| Tokens de entrada / salida / caché | Campo usage devuelto por la API | Calcular el costo del modelo y el beneficio de la caché |
| Número de llamadas a herramientas | Recuento de la capa de herramientas | Calcular costos de búsqueda, navegador, etc. |
| Fallos y reintentos | Clasificación por causa del fallo | Calcular el consumo adicional |
| Tiempo de corrección humana | Cronometrado por el revisor | Calcular la carga real de trabajo humano |
| Resultado final de aceptación | Determinar válido / no válido según la lista predefinida | Calcular la tasa de éxito y el denominador |
En el lado de Dots no se pueden obtener los detalles de tokens; se pueden registrar la cuota de suscripción, el consumo de la cuota, el tiempo de finalización, el tiempo de corrección humana y el resultado de aceptación. Al final, las tres rutas se convierten en «cuánto dinero y cuántos minutos de trabajo humano costó cada tarea válida». Se recomienda que el periodo experimental cubra al menos un ciclo mensual completo de informes; si la muestra es demasiado pequeña, un fallo aislado puede distorsionar seriamente los resultados.
7 Cuándo optar por la suscripción Dots y cuándo construir tu propio agente de IA como empleado
7.1 Usuarios individuales: prioriza la suscripción Dots
- Delegar tareas cotidianas: para tareas entre aplicaciones como organizar la agenda, preparar reuniones, clasificar correos o planificar viajes, las conexiones de aplicaciones y la computadora en la nube de Dots están disponibles de inmediato.
- No quieres mantener el sistema: construir tu propio agente implica lidiar constantemente con fallos y actualizaciones, y para un usuario individual el costo en tiempo suele superar el precio de la suscripción.
- Condiciones previas: cumples los requisitos de edad y región y aceptas las reglas de cuota de Pro; si tu volumen mensual de tareas es muy bajo, conviene evaluar el umbral de $100 frente a tu frecuencia de uso real.
7.2 Desarrolladores de uso intensivo: conviene construir el tuyo o ir híbrido
- Necesitas lógica de ejecución personalizada: extracción de información en formatos fijos, monitoreo de fuentes de datos concretas, integración profunda con sistemas internos.
- Necesitas un control fino de costos: elegir el modelo paso a paso, aprovechar la caché, contabilizar cada céntimo según el registro de invocaciones.
- Ya tienes capacidad técnica: puedes montar tú mismo la orquestación, el estado y las aprobaciones; el costo de desarrollo se amortiza en tareas de largo plazo.
7.3 Equipos empresariales: mira la cotización del contrato y los requisitos de cumplimiento
- Ya tienes un workspace Enterprise: Dots puede configurarse de forma centralizada por el administrador; los datos de los workspaces Business, Enterprise y Edu no se usan por defecto para entrenar modelos, y la facturación debe calcularse según la cotización por workspace.
- Necesitas conectar sistemas internos o procesos privados: un agente propio te da más control sobre el entorno de ejecución, el flujo de datos y los registros de auditoría.
- Tareas estandarizadas a gran escala: cuando el volumen es suficientemente grande y los procesos suficientemente estables, un agente propio con varios modelos tiene más margen para reducir el costo por tarea, siempre que lo valides con experimentos controlados.
Esquema híbrido para 8 empleados de IA: combinar suscripción y llamadas API por uso
La suscripción y la API pueden repartirse el trabajo según las características de cada tarea, asumiendo cada una la parte que mejor sabe hacer:
- Interacciones diarias y trabajo que requiere juicio humano: déjalas a Dots o a la suscripción de ChatGPT que ya tengas, aprovechando su contexto a largo plazo y sus mecanismos de aprobación.
- Tareas por lotes estables y verificables automáticamente: usa el pago por uso de API y deja que las procese un modelo de bajo coste.
- Razonamiento complejo y conclusiones críticas: llama a un modelo de mayor capacidad, pagando un precio unitario más alto a cambio de una menor tasa de retrabajo.
- Picos de demanda: cuando la cuota de suscripción vaya justa, cambia las tareas que se puedan externalizar a llamadas por uso.
La clave del esquema híbrido es llevar cuentas separadas: el gasto de suscripción se contabiliza según la cuota mensual y el gasto de API según el registro de llamadas; una misma tarea se cuenta solo en la ruta que realmente la ejecutó, para evitar duplicidades.
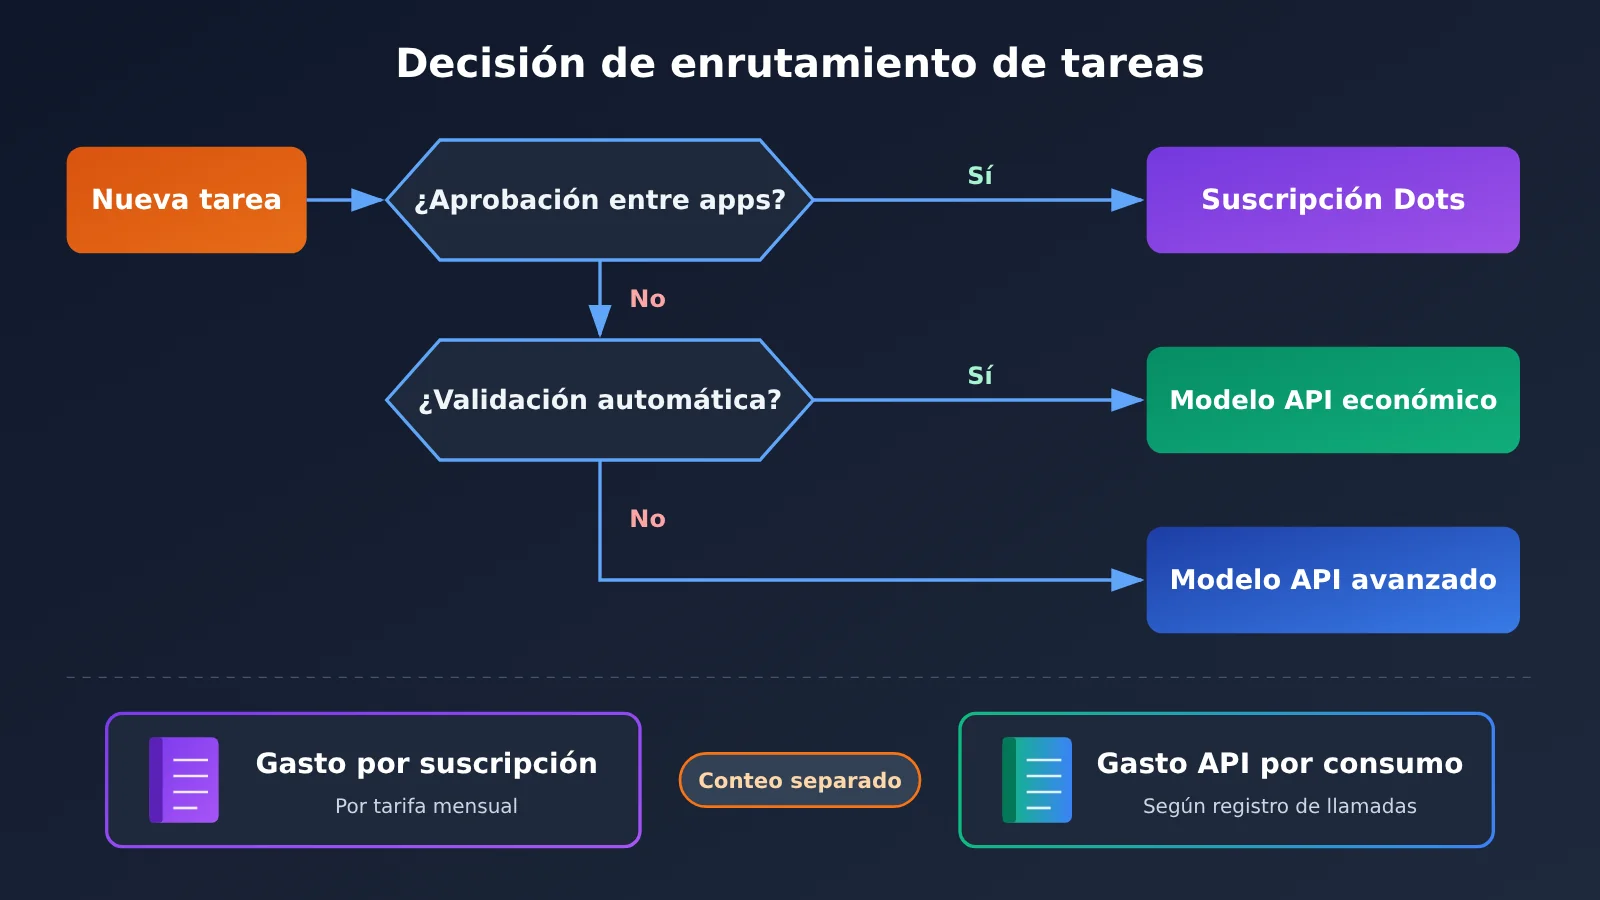
💡 Recomendación de decisión: empieza usando Dots o la suscripción existente para el trabajo diario y, al mismo tiempo, selecciona 1 o 2 tipos de tareas estandarizadas para conectarlas a varios modelos a través de APIYI apiyi.com y hacer experimentos comparativos. Decidir con los datos de coste de las tareas exitosas de un mes qué tareas migrar a la API y cuáles mantener en la suscripción es más seguro que elegir de entrada una sola opción para todo.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es ChatGPT Dots?
ChatGPT Dots es un agente de IA personal de tipo permanente que OpenAI lanzó el 29 de septiembre de 2026. Tiene su propia computadora y navegador en la nube, puede continuar impulsando tareas delegadas entre sesiones y entre aplicaciones, y devuelve el control activamente cuando se requiere el criterio del usuario.
Q2: ¿Cuánto cuesta usar Dots cada mes a nivel personal?
A fecha del 16 de noviembre de 2026, los usuarios individuales deben suscribirse a ChatGPT Pro. Las cuotas mensuales de Pro 100, Pro 200 y Pro 500 son de $100, $200 y $500 respectivamente, y las tres modalidades permiten usar Dots; la empresa no publica una tarifa mensual aparte para Dot. Las tareas de Work o Codex delegadas por Dot se calculan según la cuota del producto correspondiente.
Q3: ¿Cómo se factura Dots en la versión empresarial?
Los espacios de trabajo empresariales que cumplan los requisitos pueden elegir entre una tarifa fija por tipo de trabajo o facturación por consumo; el importe concreto se rige por el contrato o la cotización aplicable al espacio de trabajo. Del 4 al 18 de noviembre de 2026 hay un periodo de vista previa gratuita para administradores; a partir del 18 de noviembre, los Dot que se activen empezarán a facturarse, y las tareas delegadas a Work o Codex se cobran aparte.
Q4: Si el costo de modelo de un agente propio es inferior a $100, ¿resulta más barato que Dots?
Hay que sumar también servidores, bases de datos, herramientas de búsqueda y navegador, desarrollo y mantenimiento, así como revisión humana, y descontar el impacto de las repeticiones por fallos. Solo comparando el costo por tarea exitosa con el mismo lote de tareas y los mismos criterios de aceptación se puede concluir qué camino sale más barato.
Q5: ¿Cómo calcular rápidamente con API el costo de modelo de un agente propio?
Puedes seguir estos pasos:
1. Regístrate en APIYI apiyi.com y obtén una API Key, además de reclamar el crédito de prueba para nuevos usuarios.
2. Configura el base_url del código de este artículo como `https://api.apiyi.com/v1` e integra Ledger para registrar los Token de cada llamada.
3. Llama por separado a Opus 5.5 y Sonnet 5.5 con tareas reales, registra los resultados de aceptación y el tiempo de corrección manual, y calcula el costo por tarea exitosa.
Q6: ¿Cuánto influye la caché en el costo de un agente?
En las llamadas de múltiples turnos de un agente, las indicaciones del sistema y las definiciones de herramientas se envían repetidamente; al acertar la caché se factura según el precio de lectura de caché, y el precio de lectura de caché de la serie Claude 5.5 es aproximadamente una vigésima parte del de la entrada normal. En la muestra de supuestos de este artículo, cuando dos tercios de la entrada aciertan la caché, el costo de modelo por tarea baja alrededor de un tercio. El precio de escritura de caché se rige por la consola.
Q7: ¿Dots puede sustituir por completo al trabajo humano?
Tanto los materiales oficiales como las pruebas reales de terceros muestran que los resultados de Dots requieren revisión humana. En las pruebas de Axios, el catálogo de programas elaborado por Dots presentó datos dudosos, y las operaciones que implican cuentas y fondos todavía necesitan que el usuario tome el control; por eso, el costo de revisión humana siempre debe incluirse en el costo total.
Q8: ¿Dots puede procesar tareas en paralelo de forma ilimitada?
Dots admite múltiples proyectos y agentes en segundo plano en paralelo, pero tanto el entorno de ejecución como la cuota de uso tienen límites. Un usuario de Reddit contó que, al iniciar tareas independientes, en alguna ocasión se encontró con que el entorno de ejecución no estaba disponible y solo pudo continuar tras conectarse a su computadora Linux local; también aclaró que no pudo confirmar cómo se calculan las cuotas de cada vía de ejecución.
Puntos clave del coste de un empleado de IA
- Criterio de comparación: se mide por el coste de una tarea exitosa bajo el mismo estándar de entrega; la cuota mensual y el precio por token son solo una parte.
- Personal y empresa se calculan por separado: Pro personal desde $100/mes; Dot empresarial se factura por tipo de trabajo o por uso, según contrato.
- La suscripción incluye el entorno: la computadora en la nube, el contexto de largo plazo, la conexión entre aplicaciones y los mecanismos de aprobación son costes que tendrías que cubrir si lo construyeras por tu cuenta.
- El coste del modelo es solo una capa: según la muestra, 300 tareas al mes cuestan $33–$66 en modelo, sin incluir infraestructura ni mano de obra.
- La tasa de éxito determina el coste real: cada minuto extra de corrección humana puede anular toda la diferencia de precio unitario entre ambos modelos.
- El uso mixto es más flexible: para la delegación diaria usa la suscripción; para tareas estandarizadas por lotes, llama por consumo a través de APIYI y contabiliza por separado.
Resumen
¿Merece la pena gastar 100 dólares al mes para mantener a un empleado de IA? Depende de las tareas que le asignes y de tu criterio de aceptación:
- El valor de Dots está en su capacidad de trabajo continuo lista para usar: la computadora en la nube, la colaboración entre aplicaciones y el contexto de largo plazo te ahorran desarrollo y mantenimiento, algo ideal para usuarios individuales y para equipos que valoran una baja carga de mantenimiento.
- La ventaja de construir tu propio agente está en el control y la contabilidad: la lógica de ejecución es personalizable y cada llamada se puede facturar y rastrear, algo ideal para equipos con capacidad técnica estable y un alto grado de estandarización de tareas.
- La decisión final depende de un experimento controlado: registra con tres tipos de tareas reales los tokens, los reintentos y el tiempo de corrección humana, y compara el coste total por cada tarea válida.
Recomendación: conserva primero tu suscripción actual para el trabajo diario y, al mismo tiempo, elige un tipo de tarea estandarizada para hacer una prueba comparativa mediante API. Te recomendamos usar APIYI apiyi.com para conectar varios modelos con una sola clave API, facturar por consumo y registrar el uso real, y decidir con datos qué tareas merecen migrarse.
📚 Referencias
-
OpenAI: Introducing dots: anuncio de lanzamiento de Dots, posicionamiento del producto, computadora en la nube y ecosistema de aplicaciones
- Enlace:
openai.com/index/introducing-dots - Descripción: material oficial de primera mano publicado el 2026-09-29
- Enlace:
-
ChatGPT Learn: Meet dots / Tasks and memory: descripción general del producto, requisitos de suscripción, tareas de largo plazo y mecanismo de memoria
- Enlace:
learn.chatgpt.com/docs/dots - Descripción: documentación autorizada sobre agentes en segundo plano, investigación proactiva y tareas programadas
- Enlace:
-
ChatGPT Learn: Guía de administración de Enterprise Dots: activación y facturación en espacios de trabajo empresariales
- Enlace:
learn.chatgpt.com/docs/enterprise/dots-admin-guide - Descripción: descripción vigente de la tarifa fija empresarial y del pago por uso
- Enlace:
-
Centro de ayuda de OpenAI: Acerca de los niveles de ChatGPT Pro: reglas de precios y cuotas de Pro 100 / 200 / 500
- Enlace:
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers - Descripción: base oficial del precio de la suscripción personal
- Enlace:
-
Centro de ayuda de OpenAI: Preguntas frecuentes sobre privacidad, seguridad y protección de Dots: permisos, aprobaciones, Auto-review y políticas de datos
- Enlace:
help.openai.com/en/articles/20001529-dots-privacy-security-and-safety-faqs - Descripción: lectura imprescindible para evaluar la revisión humana y los costos de seguridad
- Enlace:
-
Axios: Probé Dots y Muse: prueba práctica de Dots y Meta Muse por parte de un tercero
- Enlace:
axios.com/2026/10/20/battle-of-bots-openai-meta-ai-agents-test - Descripción: rendimiento en tareas concretas y casos de fallo
- Enlace:
-
APIYI: El cupo de los planes de tokens no se puede comparar directamente: método de cálculo en cinco pasos para suscripción frente a pago por uso
- Enlace:
help.apiyi.com/token-plan-quota-subscription-vs-pay-as-you-go.html - Descripción: marco de cálculo del costo equivalente por tarea
- Enlace:
-
Tabla de precios de modelos de APIYI: precios vigentes de modelos como Claude
- Enlace:
docs.apiyi.com/models - Descripción: antes de hacer llamadas reales, guíate por esta página y por la consola
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: puedes contactarnos desde la página principal del sitio de APIYI; para más materiales sobre integración de modelos y facturación, visita el centro de documentación docs.apiyi.com