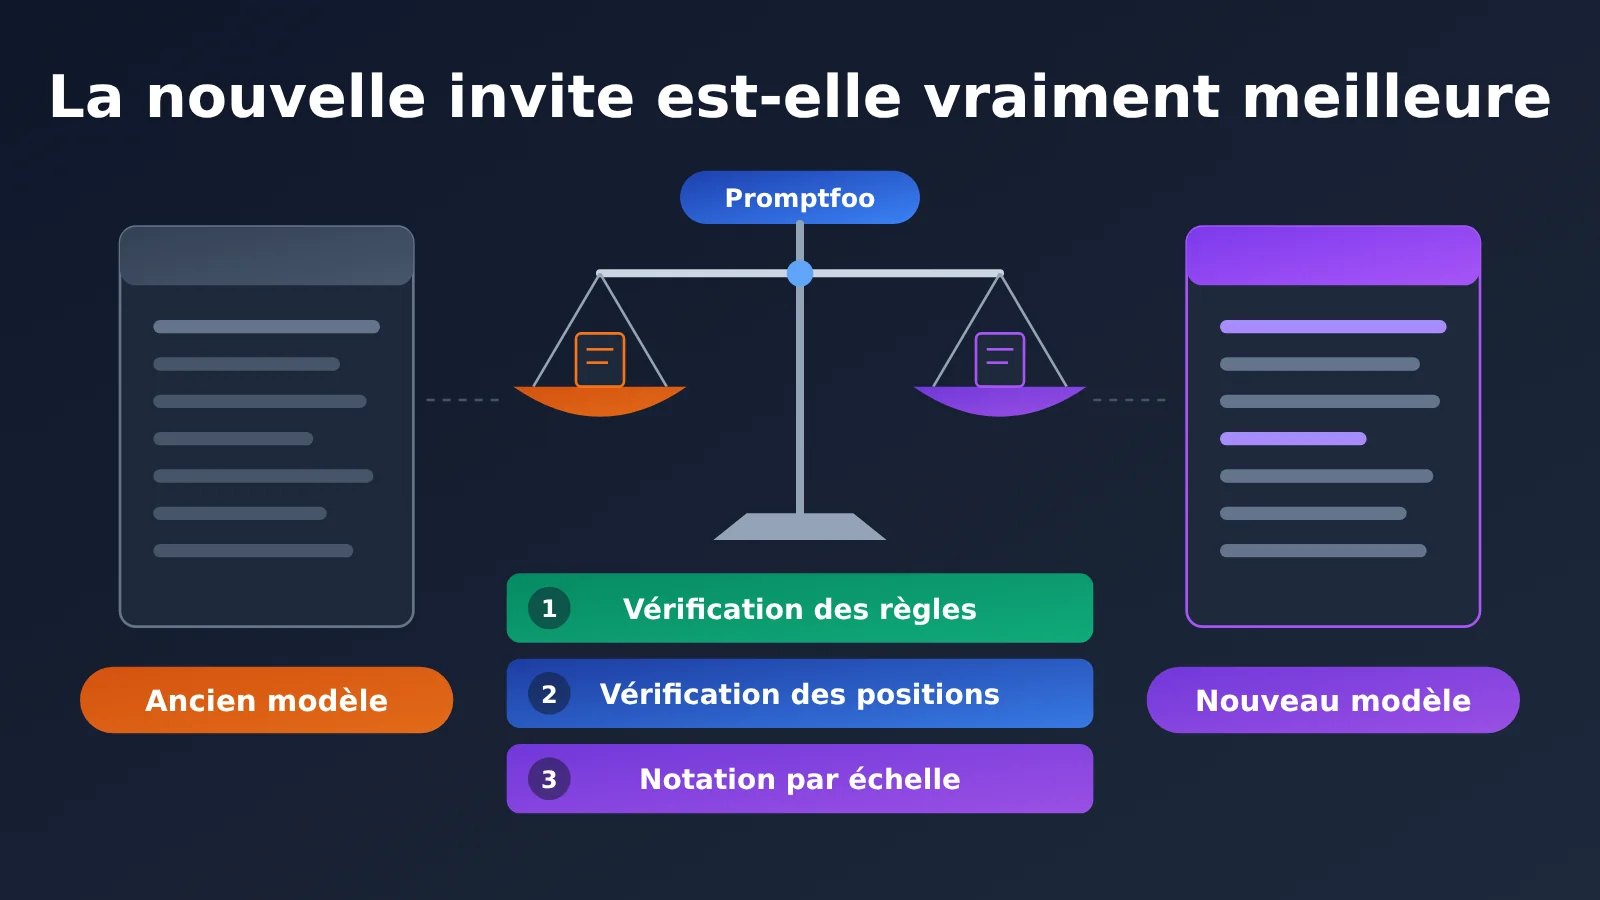
Réponse directe : une nouvelle invite n’est pas forcément meilleure, et « ça a l’air mieux » ne constitue pas une preuve. Pour savoir lequel de l’ancien et du nouveau gabarit d’article est le meilleur, il faut figer les sources, le modèle et les paramètres de génération, ne changer que le gabarit, puis utiliser les assertions de Promptfoo pour contrôler par couches la structure, l’ordre et la qualité du contenu. Il faut aussi présenter les résultats par dimension, sans laisser une note de style compenser une erreur factuelle. Cet article propose un protocole expérimental ; aucune véritable expérience A/B n’a été menée, donc aucun taux de victoire, score ni gain d’économie n’est donné ici.
À la lecture de cet article, vous découvrirez :
- Ce que les assertions
contains, JavaScript etllm-rubricde Promptfoo permettent de vérifier — et ce qu’elles ne prouvent pas. - Comment exécuter un fichier d’assertions seul sur des sorties de modèle déjà produites, pour éviter une régénération quand on ne change que les règles de notation.
- Un protocole d’expérience comparant ancien et nouveau gabarit d’article : contrôle des variables, vérification en trois couches et présentation par dimension.
- Les limites du juge-modèle et des assertions par règles, ainsi que le coût engendré par un modèle d’évaluation payant.
Sommaire : un tableau de concepts explique d’abord quelques termes clés de l’évaluation avec Promptfoo, puis nous verrons ce que cela implique pour les équipes de contenu, les développeurs et les responsables de l’évaluation. La partie « faits objectifs » du corps de l’article se limite à recenser les capacités d’assertion décrites dans la documentation et l’état des vérifications. La partie « analyse et jugement » propose des pistes de protocole expérimental, des exemples de configuration et une discussion des limites, en précisant point par point ce qui relève d’une recommandation et non d’un résultat mesuré.
Concepts à connaître avant de comparer des modèles d’invite avec Promptfoo
Les termes ci-dessous reviendront plusieurs fois dans la suite. La plupart proviennent de la documentation de configuration de Promptfoo ; quelques-uns sont des expressions courantes dans les expériences d’évaluation.
| Concept | Brève explication |
|---|---|
| Promptfoo | Un outil open source pour évaluer les invites et les sorties des grands modèles de langage ; on peut y définir des cas de test et des assertions dans un fichier de configuration |
| Assertion | Règle de vérification automatique appliquée à la sortie du modèle, qui détermine si celle-ci remplit une condition donnée |
| contains | Vérifie si le texte indiqué apparaît dans la sortie ; c’est une correspondance de chaîne déterministe |
| Assertion JavaScript | Utilise une expression ou une fonction JavaScript pour mettre en œuvre des conditions de jugement plus complexes |
| llm-rubric | Demande à un modèle de noter la sortie selon un barème personnalisé ; c’est une assertion de type « notation par modèle » |
| Fournisseur de notation (Grading Provider) | Le modèle qui exécute la notation llm-rubric ; il peut être configuré séparément |
| Barème (Rubric) | Les critères rédigés à l’intention du modèle de notation, qui précisent ce qui compte comme réussi et ce qui entraîne une pénalité |
| Juge LLM (LLM-as-a-Judge) | L’usage d’un grand modèle de langage pour remplacer l’évaluation humaine de la qualité des sorties |
| Contrôle des variables | Ne modifier qu’un seul facteur dans une expérience (ici, le modèle d’invite), en gardant tous les autres constants |
Aperçu des impacts de l’évaluation des modèles d’invite anciens et nouveaux
La valeur de ce type de méthode d’évaluation ne tient pas à la nouveauté de l’outil, mais au fait de transformer « je trouve le nouveau modèle meilleur » en un journal de vérification consultable. Les différents rôles n’en retirent pas la même chose.
| Publics concernés | Impact concret |
|---|---|
| Équipes de contenu et éditeurs | La refonte des modèles d’invite dispose de critères de recette vérifiables, ce qui permet de repérer des cas où « la structure est bonne, mais des suppositions se glissent dans la partie factuelle ». |
| Ingénieurs spécialisés dans les invites et développeurs | Ils peuvent décomposer les exigences du modèle en assertions de règles et en assertions de barème ; la modification du barème ne nécessite pas de régénérer toutes les sorties. |
| Responsables de l’évaluation | Ils doivent présenter les résultats par dimension et distinguer clairement la force de preuve de la notation par le modèle, des correspondances avec les règles et de la revue humaine. |
| Responsables budgétaires | Les assertions de règles n’ajoutent presque aucun coût d’appel ; si llm-rubric fait appel à un modèle payant, cela engendre des frais d’évaluation. |
Les capacités d’assertion de Promptfoo : ce que dit la documentation
Cette section se limite à énoncer les capacités décrites dans la documentation de Promptfoo. Nous avons vérifié les pages concernées le 2026-11-17, mais la date de première publication de ces fonctionnalités n’a pas été vérifiée ; cet article ne donne donc pas d’date de mise en ligne précise.
L’assertion contains de Promptfoo : vérifier la présence d’un texte
contains est le type d’assertion le plus élémentaire : il sert à vérifier si un fragment de texte donné apparaît dans la sortie du modèle. C’est une correspondance de chaînes déterministe : pour une même sortie, chaque exécution donne le même résultat.
Un point à souligner : le fait que contains réussisse indique seulement que « ce passage a été trouvé ». Cela ne dit rien de la qualité du paragraphe dans lequel il se trouve, ni de l’exactitude du contenu.
L’assertion JavaScript de Promptfoo : gérer des conditions complexes
Quand le critère de jugement va au-delà du simple « contient / ne contient pas », on peut écrire une logique personnalisée sous forme d’assertion JavaScript. Par exemple : comparer l’ordre d’apparition de deux titres, compter le nombre de sections, ou vérifier qu’un passage donné se situe bien à l’intérieur d’une section précise. Ce type d’assertion reste déterministe et le résultat est reproductible.
Évaluer des sorties Promptfoo existantes avec un fichier d’assertions autonome
Promptfoo permet d’exécuter un fichier d’assertions indépendant sur des sorties de modèle déjà générées, sans avoir à tout régénérer. C’est essentiel pour les itérations d’évaluation : les règles de notation demandent souvent plusieurs ajustements, alors que la génération elle-même prend du temps et coûte des appels.
Le llm-rubric de Promptfoo : faire noter par un modèle selon un barème
llm-rubric fait partie des assertions de notation par modèle. Il transmet la sortie et un barème personnalisé à un modèle évaluateur, qui décide si le critère est rempli et en donne la justification. La documentation précise que le fournisseur chargé de la notation peut être configuré séparément, et que l’invite utilisée pour la notation est également personnalisable.
| Type d’assertion | Mode de jugement | Résultat déterministe | Ce qu’elle prouve | Ce qu’elle ne prouve pas |
|---|---|---|---|---|
| contains | Correspondance de chaînes | Oui | Le texte indiqué est bien présent | La qualité du paragraphe, l’exactitude du contenu |
| JavaScript | Logique de code personnalisée | Oui | Les conditions codables : structure, ordre, comptage | La qualité sur le plan sémantique |
| llm-rubric | Notation par un modèle selon un barème | Dépend du modèle évaluateur | La sortie respecte le barème du point de vue du modèle évaluateur | L’exactitude factuelle, et ne remplace pas une vérification humaine |
Sources et état de la vérification
La partie factuelle de cet article s’appuie sur les pages de documentation Promptfoo suivantes, vérifiées le 2026-11-17 :
- Documentation Promptfoo sur les assertions et les métriques : promptfoo.dev/docs/configuration/expected-outputs/
- Documentation Promptfoo sur les assertions de notation par modèle : promptfoo.dev/docs/configuration/expected-outputs/model-graded/
- Documentation Promptfoo sur llm-rubric : promptfoo.dev/docs/configuration/expected-outputs/model-graded/llm-rubric/
Cet article n’a pas exécuté de véritable expérience A/B entre l’ancien et le nouveau template. Les configurations et procédures présentées plus loin sont des suggestions de conception et ne reflètent aucun résultat mesuré.
Comparer les anciens et nouveaux modèles d’article avec Promptfoo : analyse et interprétation
Ce qui suit est notre interprétation et nos recommandations fondées sur les faits exposés plus haut. Prenons l’exemple du « modèle d’article d’actualité » : supposons que le nouveau modèle exige que l’article comprenne deux sections, « faits objectifs » et « analyse et interprétation », que les faits précèdent l’analyse, et qu’aucune spéculation ne puisse s’immiscer dans la section des faits.
Conception de l’expérience : ne changer qu’une seule variable lors de la comparaison de modèles avec Promptfoo
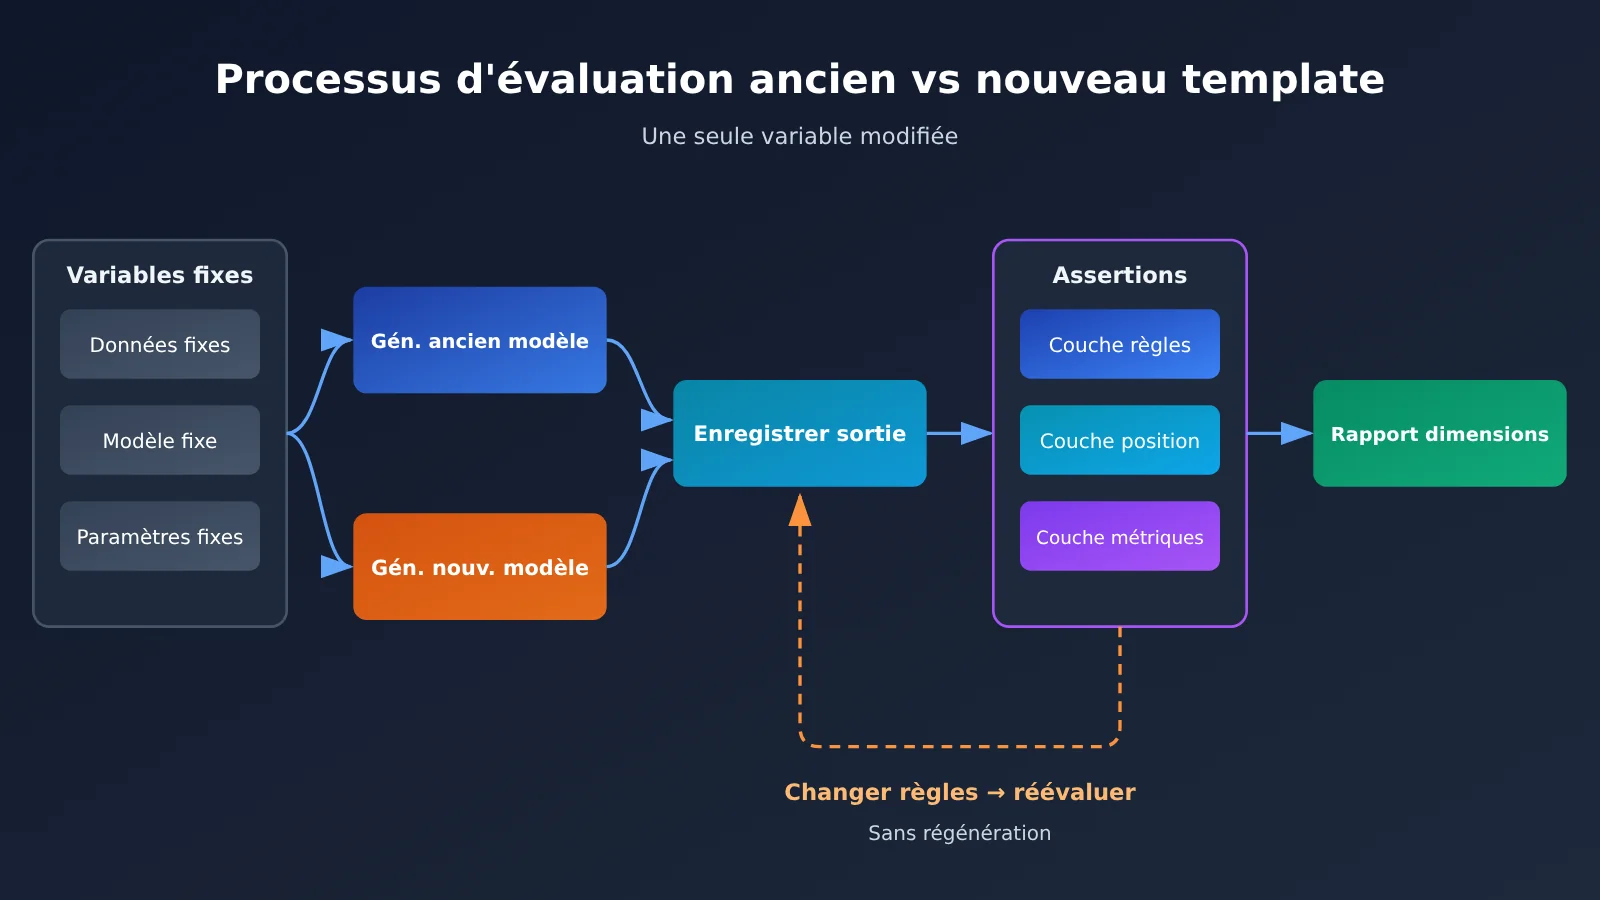
L’erreur la plus fréquente quand on compare des modèles d’article, c’est de changer de modèle tout en changeant aussi les données, le modèle de génération ou le paramètre de température. Même si le résultat s’améliore, impossible de dire si c’est grâce au modèle ou à l’influence d’autres facteurs. La première étape consiste donc à verrouiller toutes les variables sauf celle qu’on veut tester.
| Variable | Traitement | Raison |
|---|---|---|
| Données d’entrée | Fixer le même lot, partagé entre l’ancien et le nouveau modèle | Des données différentes modifient directement le contenu factuel |
| Modèle de génération | Fixer le même modèle et la même version | Les écarts de style d’écriture entre modèles peuvent dépasser les écarts entre modèles d’article |
| Paramètres de génération | Fixer la température, la longueur maximale et autres réglages | Les paramètres influencent la stabilité et la longueur des sorties |
| Modèle d’invite (prompt) | La seule variable modifiée | C’est l’objet que l’on veut valider |
| Règles de notation | Les deux groupes, ancien et nouveau, utilisent le même jeu d’assertions | Garantir que les deux groupes passent les mêmes vérifications |
Promptfoo, couche règles et couche position : d’abord la structure, puis l’ordre
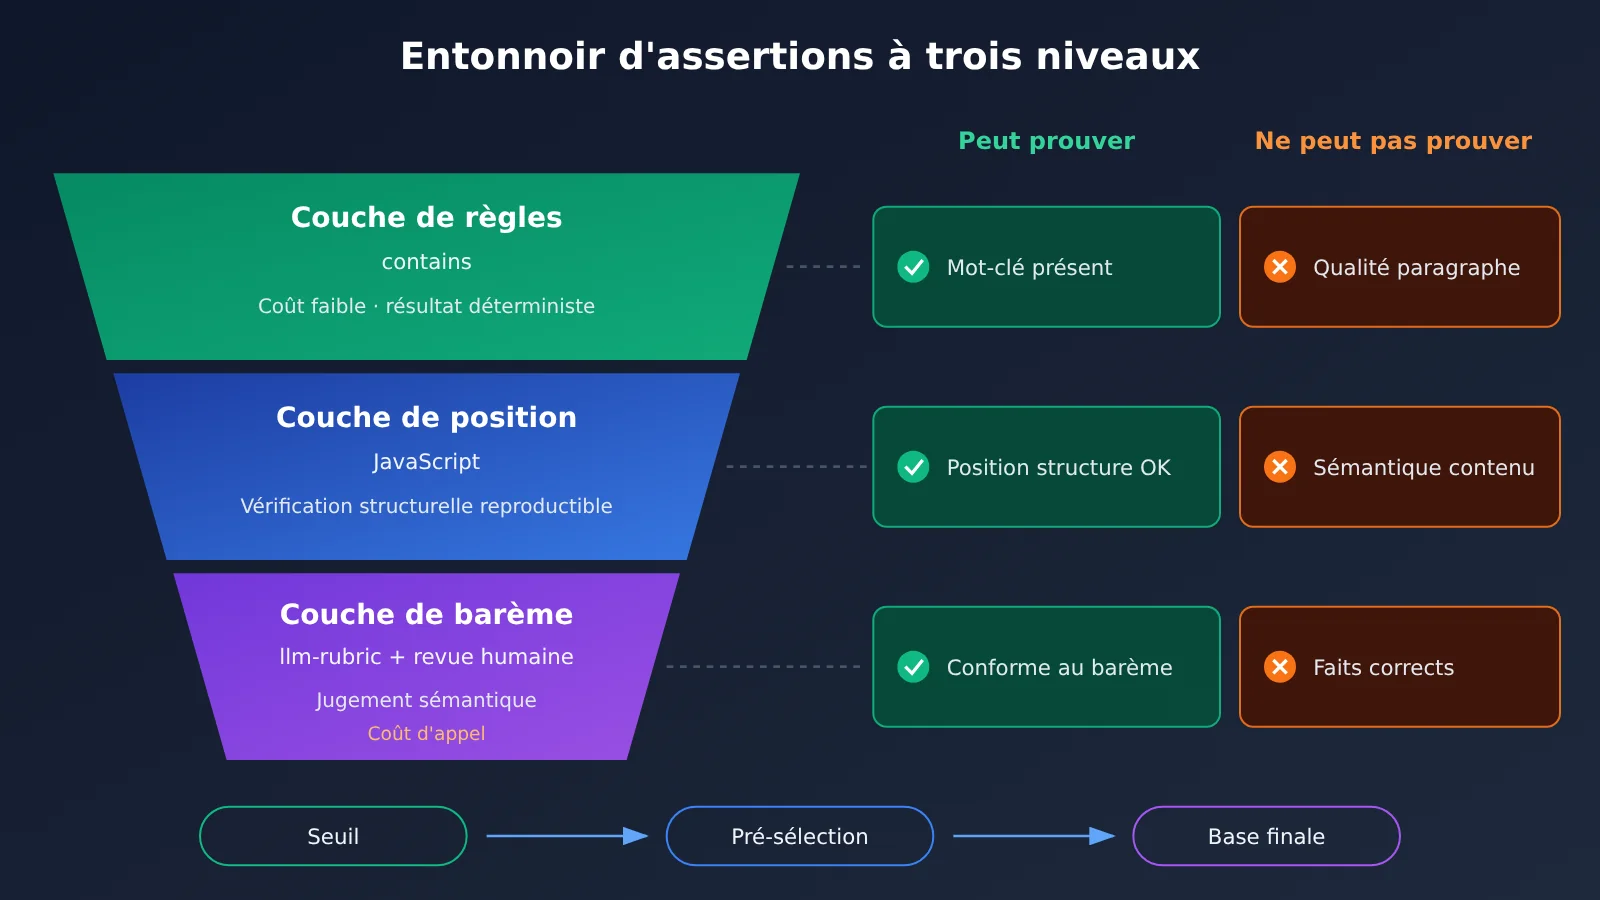
Le premier niveau est la vérification des règles : on utilise contains pour confirmer que les titres exigés par le template apparaissent bien. Le deuxième niveau est la comparaison de position : une assertion JavaScript vérifie que le titre « faits objectifs » précède le titre « analyse et jugement ». Ces deux couches sont des contrôles déterministes, peu coûteux et stables dans leurs résultats — parfait pour filtrer en amont les sorties manifestement non conformes.
Voici une écriture d’assertion à titre indicatif ; pour les noms de champs précis, référez-vous à la documentation officielle de Promptfoo :
# Configuration indicative : pour illustrer l'approche, vérifiez les détails des champs dans la documentation officielle
assert:
  # Couche règles : présence des titres
  - type: contains
    value: "## 客观事实"
  - type: contains
    value: "## 分析判断"

  # Couche position : la section des faits doit précéder la section d'analyse
  - type: javascript
    value: |
      const a = output.indexOf('## 客观事实');
      const b = output.indexOf('## 分析判断');
      return a >= 0 && b >= 0 && a < b;
Notez que dans l’écriture de la couche position, on vérifie d’abord que les deux titres sont présents. Si l’on écrivait seulement a < b, lorsque le titre « faits objectifs » manque, indexOf renvoie -1, ce qui satisfait tout de même la condition « inférieur à » et provoque un faux positif. C’est exactement pour cela que même les assertions déterministes demandent une rédaction rigoureuse.
Couche de barème Promptfoo : vérifier avec un barème explicite si le paragraphe factuel contient des suppositions
Avoir tous les titres et un ordre correct ne signifie pas pour autant que le paragraphe factuel est propre. Déterminer si « le paragraphe factuel contient des suppositions » relève d’un jugement sémantique, que des assertions fondées sur des règles couvrent difficilement : c’est typiquement le cas où llm-rubric est utile. Le barème doit être concret : dites au modèle de notation ce qui compte comme une violation, plutôt que de demander vaguement si « c’est bien écrit ».
# Configuration indicative : le fournisseur de notation et le contenu du barème sont des exemples
assert:
  - type: llm-rubric
    value: |
      Évaluez uniquement la section « faits objectifs ».
      Si cette section contient des prédictions, des jugements subjectifs ou des inférences sans source indiquée, considérez-le comme un échec et citez la phrase problématique.
      N'évaluez pas le style, ne jugez pas les autres sections.
    provider: your-grading-model   # Le fournisseur de notation peut être configuré séparément
Les conclusions de la couche barème demandent toujours une vérification manuelle par échantillonnage. Le modèle de notation peut passer à côté d’un problème, mais aussi prendre pour une supposition une affirmation factuelle parfaitement légitime. La méthode la plus sûre consiste à réexaminer un par un les échantillons en échec, puis à prélever au hasard une partie des échantillons validés pour une relecture humaine.
Présentation par dimension : empêcher la note de style de Promptfoo de compenser une erreur factuelle
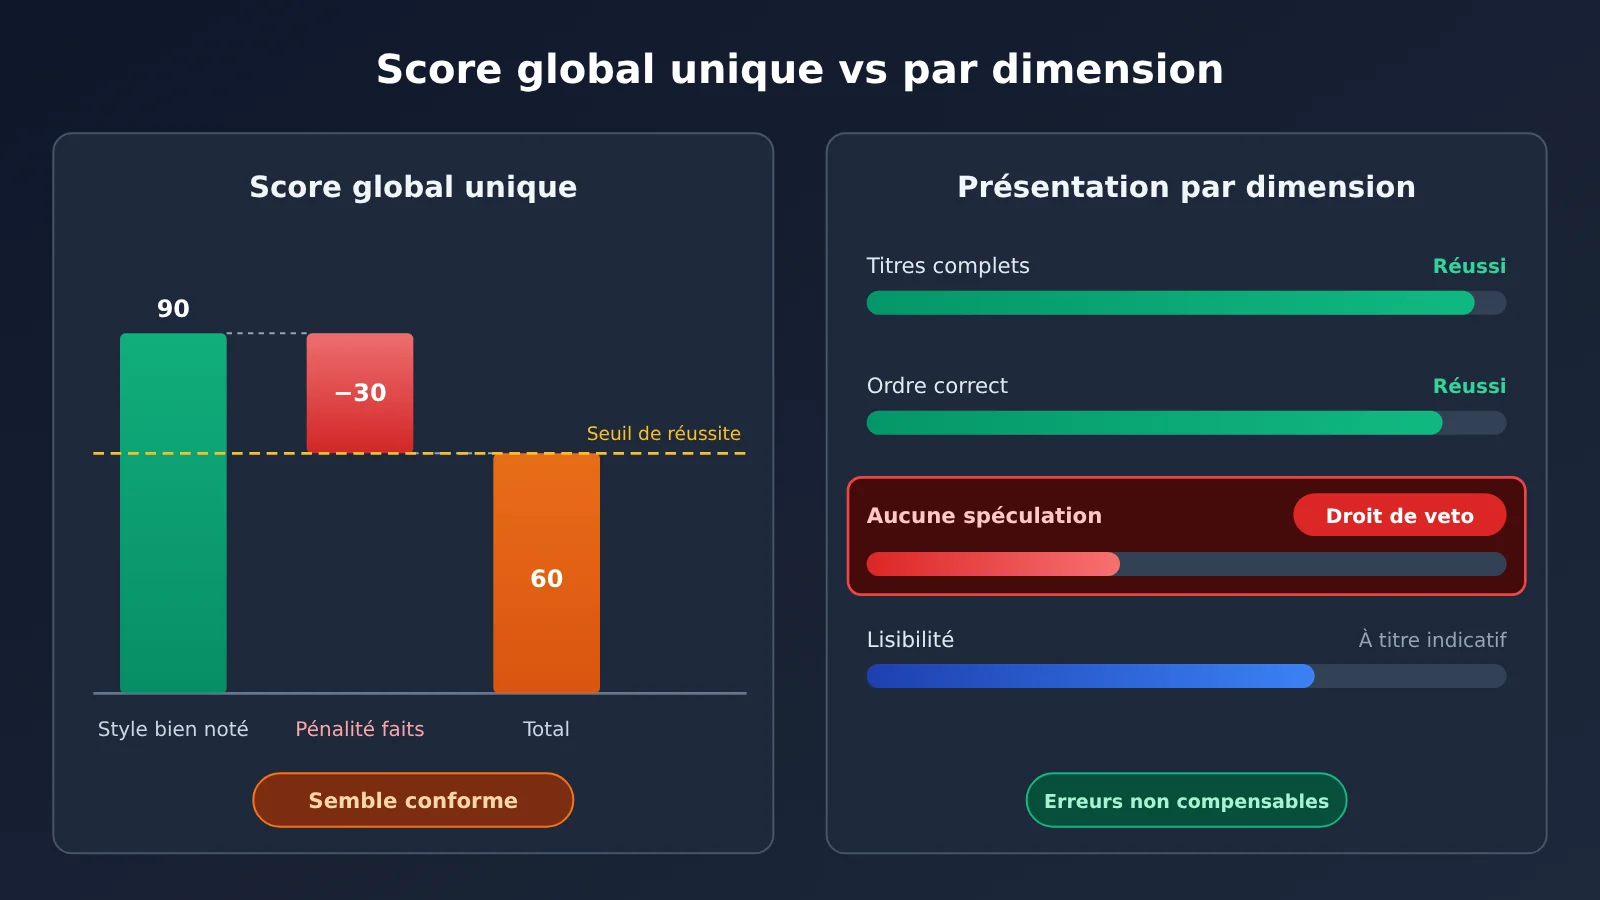
Si l’on agrège toutes les assertions en une note globale, un article au style fluide mais dont le paragraphe factuel contient des suppositions peut obtenir une note proche de celle d’un article rigoureux dans sa structure mais un peu terne. Pour du contenu journalistique, cette « compensation mutuelle » est dangereuse. Il est donc conseillé de présenter les résultats dimension par dimension, et de traiter les dimensions factuelles comme un veto.
| Dimension d’évaluation | Méthode de contrôle | Présentation | Peut-elle être compensée par une autre dimension ? |
|---|---|---|---|
| Titres obligatoires présents | contains | Taux de réussite | Non, exigence stricte |
| Ordre des sections correct | JavaScript | Taux de réussite | Non, exigence stricte |
| Aucune supposition dans le paragraphe factuel | llm-rubric + relecture humaine | Taux de réussite + liste des phrases problématiques | Non, veto absolu |
| Expression et lisibilité | llm-rubric | Présentée séparément | Indicative seulement, n’entre pas dans la compensation |
Quand on ne modifie que les règles de notation Promptfoo, réévaluer directement les anciennes sorties
Dans les itérations d’évaluation, ce qu’on ajuste le plus souvent, ce sont les règles de notation, pas le template lui-même. On s’aperçoit par exemple que la description de l’échelle n’est pas assez claire, ou qu’une assertion de position a oublié un cas limite. À ce stade, le template et les sorties n’ont pas bougé : inutile de tout régénérer.
La possibilité qu’offre Promptfoo d’exécuter un fichier d’assertions indépendant sur des sorties existantes permet de séparer complètement génération et notation : on génère une fois, on enregistre les sorties, puis chaque ajustement des règles ne relance que les assertions. On gagne du temps, et surtout on garantit que les deux tours de notation portent sur exactement les mêmes textes — c’est à cette condition que la comparaison a du sens.
Limites et coûts du juge modèle de Promptfoo
Trois points méritent d’être posés clairement, pour éviter de surinterpréter les résultats d’évaluation :
- Le score du juge modèle ne prouve pas l’exactitude factuelle. llm-rubric indique seulement que, du point de vue du modèle évaluateur, la sortie respecte l’échelle ; la vérification des faits doit toujours revenir aux sources originales.
- Un succès de contains signifie juste qu’on a touché le texte. Cela indique que le titre est présent, pas que la qualité du paragraphe qui le suit est satisfaisante.
- Une évaluation par un modèle payant a un coût. Les assertions de type règles ne déclenchent en général aucun appel de modèle supplémentaire, mais llm-rubric appelle un modèle de notation pour chaque sortie évaluée ; on ne peut donc pas qualifier l’ensemble de l’évaluation de « totalement gratuit ».
À partir de ces limites, notre position est la suivante : les assertions déterministes servent de « seuil », la notation par modèle sert de « premier filtrage », et c’est la revue humaine qui constitue la base finale des conclusions factuelles. Ces trois rôles sont distincts et ne se substituent pas les uns aux autres.
Pistes à suivre par la suite
Voici quelques directions d’observation qui n’ont pas encore été vérifiées, à prendre comme de simples suggestions pour de futures expérimentations :
- La cohérence du modèle d’évaluation. Les conclusions restent-elles stables lorsqu’on note plusieurs fois la même sortie, et basculent-elles si l’on change de modèle d’évaluation ? Si ce n’est pas stable, l’échelle de notation doit être formulée de façon plus précise.
- Le degré de concordance entre l’échantillonnage manuel et la notation par le modèle. Cela détermine dans quelle mesure on peut s’appuyer sur llm-rubric pour une pré-sélection.
- La taille de l’échantillon est-elle suffisante ? Lorsqu’on ne compare que quelques articles, des facteurs accidentels peuvent masquer les différences entre gabarits ; il faut suffisamment de documents d’entrée pour tirer des conclusions significatives.
Tant que ces questions n’auront pas donné lieu à des données mesurées, toute affirmation du type « le nouveau gabarit a tel taux de victoire » ou « le score progresse de tant » doit être traitée avec prudence. C’est précisément pour cette raison que cet article évite volontairement d’avancer de tels chiffres.
« Ce qu’on apprend sur le papier reste superficiel ; pour vraiment connaître une chose, il faut la pratiquer soi-même. » — Lu You, Lecture de nuit, instructions à mon fils Yu