Note de l’auteur : maintenant que les téléphones et les navigateurs savent synthétiser la voix en local, faut-il encore garder une API vocale dans le cloud ? Cet article tranche la question selon 4 critères : hors ligne, confidentialité, qualité sonore et longs contenus audio, choix d’un modèle précis et facturation unifiée.
De plus en plus de systèmes mobiles et de navigateurs lisent le texte à voix haute directement en local. Avec la voix sur l’appareil, faut-il encore garder une API vocale dans le cloud ? C’est devenu une question incontournable pour les équipes qui conçoivent des produits vocaux. Certains veulent tout basculer en local pour économiser les frais d’appel, d’autres craignent que les voix locales ne suffisent pas pour un produit en production.
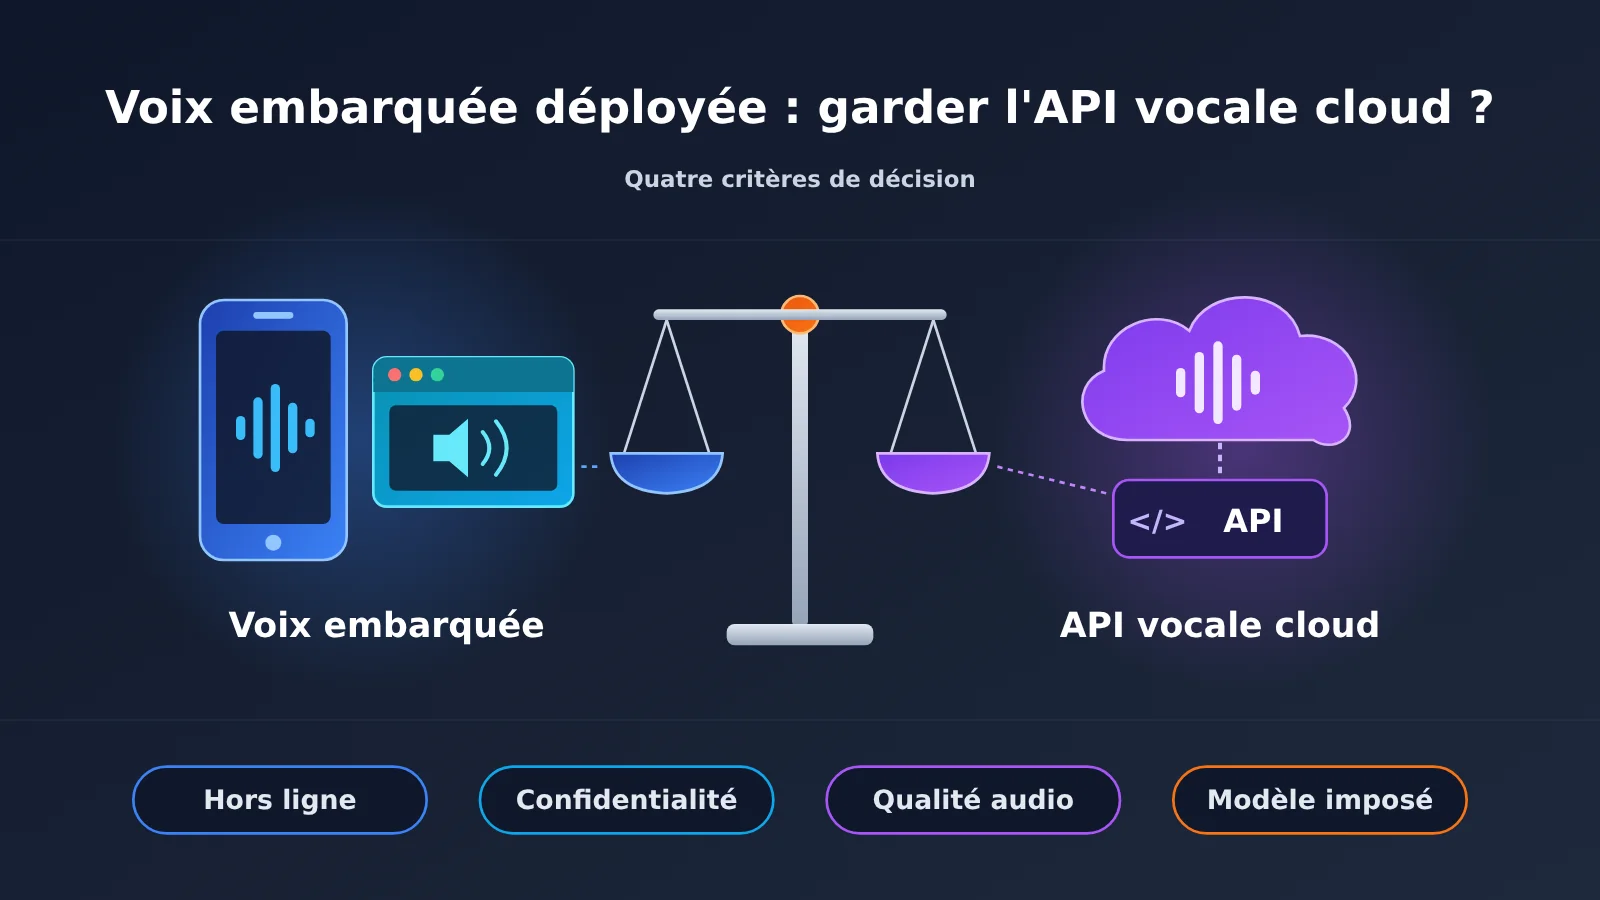
Ce n’est pas un choix binaire. L’appareil et le cloud ont chacun leurs limites, et tout dépend de ce dont votre produit a besoin : fonctionner hors ligne ou non, le niveau de sensibilité de vos données, vos exigences en matière de qualité sonore et de longs contenus audio, et la nécessité ou non d’imposer un modèle précis.
L’essentiel à retenir : après cette lecture, vous pourrez évaluer critère par critère (4 au total) comment répartir la voix entre l’appareil et le cloud pour votre produit, sans trancher à la hache.
La voix sur l’appareil arrive : l’essentiel en un coup d’œil
Commençons par séparer ce qui est confirmé de ce qui ne l’est pas. La tendance est claire, mais pour un modèle local donné, il n’existe pas assez de chiffres publics comparables sur la latence et la qualité sonore. Cet article ne fait aucune supposition et classe ces points comme inconnus.
| Élément | Détails |
|---|---|
| Ce qui change | Les systèmes mobiles et les navigateurs peuvent faire la synthèse vocale en local, sans connexion |
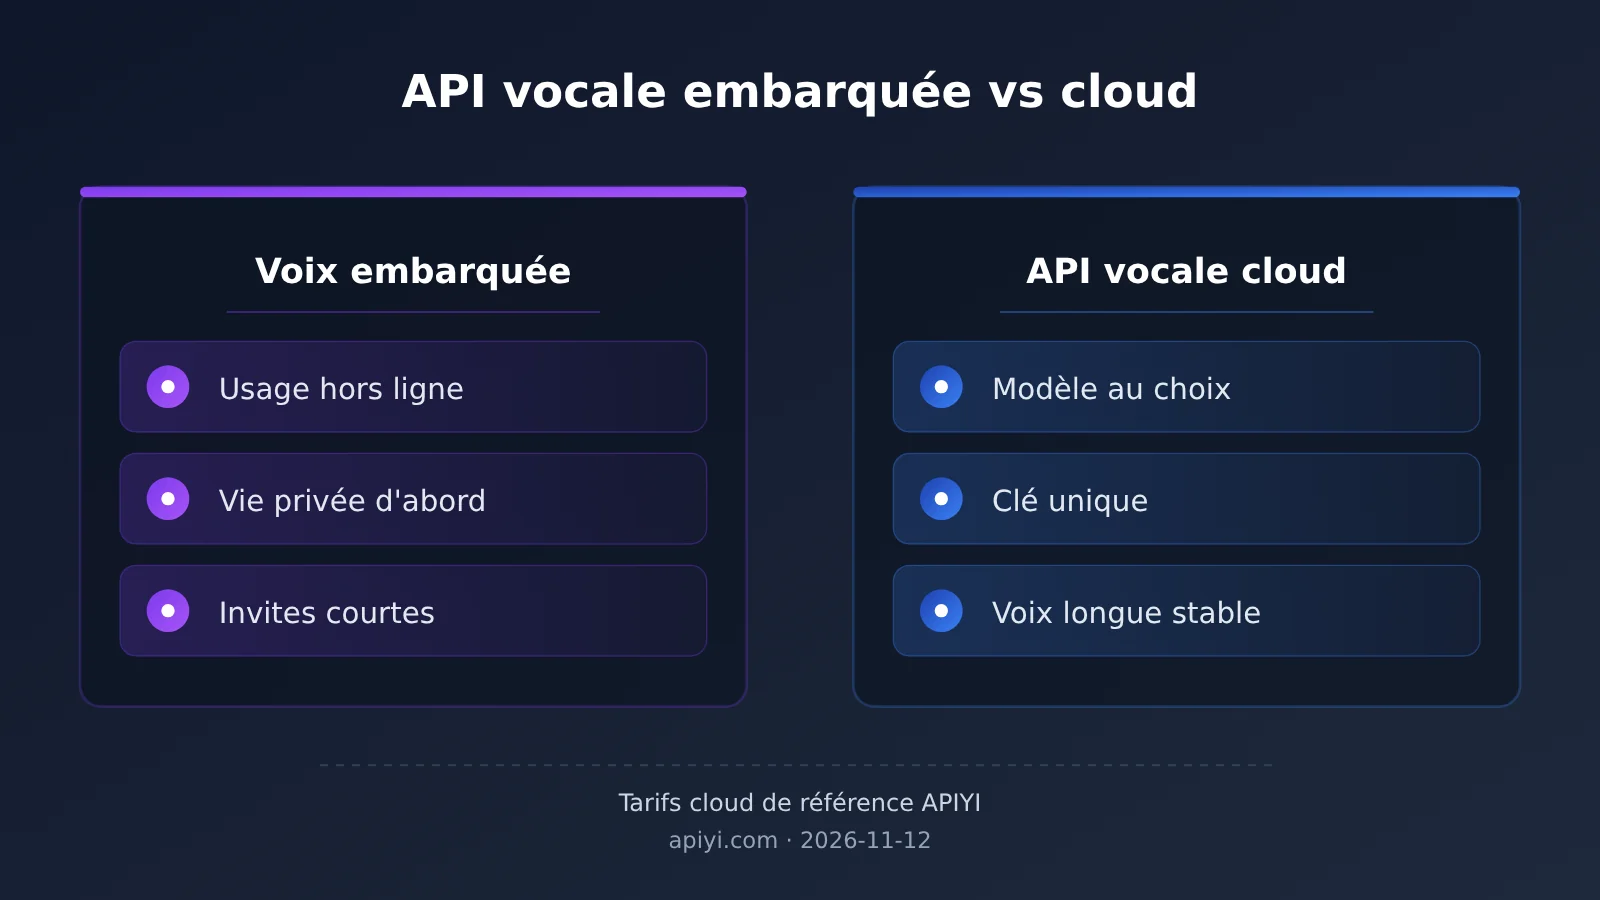
| Points forts de l’embarqué | Fonctionne hors ligne, les données ne quittent pas l’appareil, adapté aux annonces courtes |
| Inconnues de l’embarqué | Il n’existe pas de données publiques unifiées sur la latence et la qualité sonore des différentes solutions : à considérer comme inconnues |
| Points forts du cloud | Choix d’un modèle précis, une seule clé API partagée avec les modèles de texte, plus de stabilité sur les longs audios |
| Modèles cloud disponibles | Au 2026-11-12, la grille tarifaire d’APIYI propose toujours tts-1, tts-1-hd, gpt-realtime-2.1 et gpt-realtime-2.1-mini |
| Qui est concerné | Les équipes produit qui font de l’annonce vocale, des assistants vocaux ou du dialogue vocal en temps réel |
Ce que la voix embarquée sait faire, et ce qu’elle ne garantit pas
Le bénéfice le plus direct de la voix embarquée, c’est que « ça parle même sans réseau ». Pour les instructions de navigation, l’aide à la lecture ou les courts messages sonores dans une app, les phrases sont brèves et fréquentes : la synthèse locale suffit, et elle évite un aller-retour réseau. Comme les données restent sur l’appareil, la pression réglementaire est aussi bien moindre pour les produits qui manipulent des textes sensibles (santé, finance, etc.).
En revanche, les voix et la qualité disponibles en embarqué dépendent de l’appareil de l’utilisateur. Un même produit peut produire des voix totalement différentes selon la marque du téléphone ou la version du système, et il est difficile pour un développeur de garantir une expérience homogène. Quant à savoir de combien un modèle embarqué est plus lent ou moins bon qu’un modèle cloud, il n’existe pour l’instant aucun chiffre public fiable. Le mieux est de tester un échantillon d’appareils réels de votre produit.
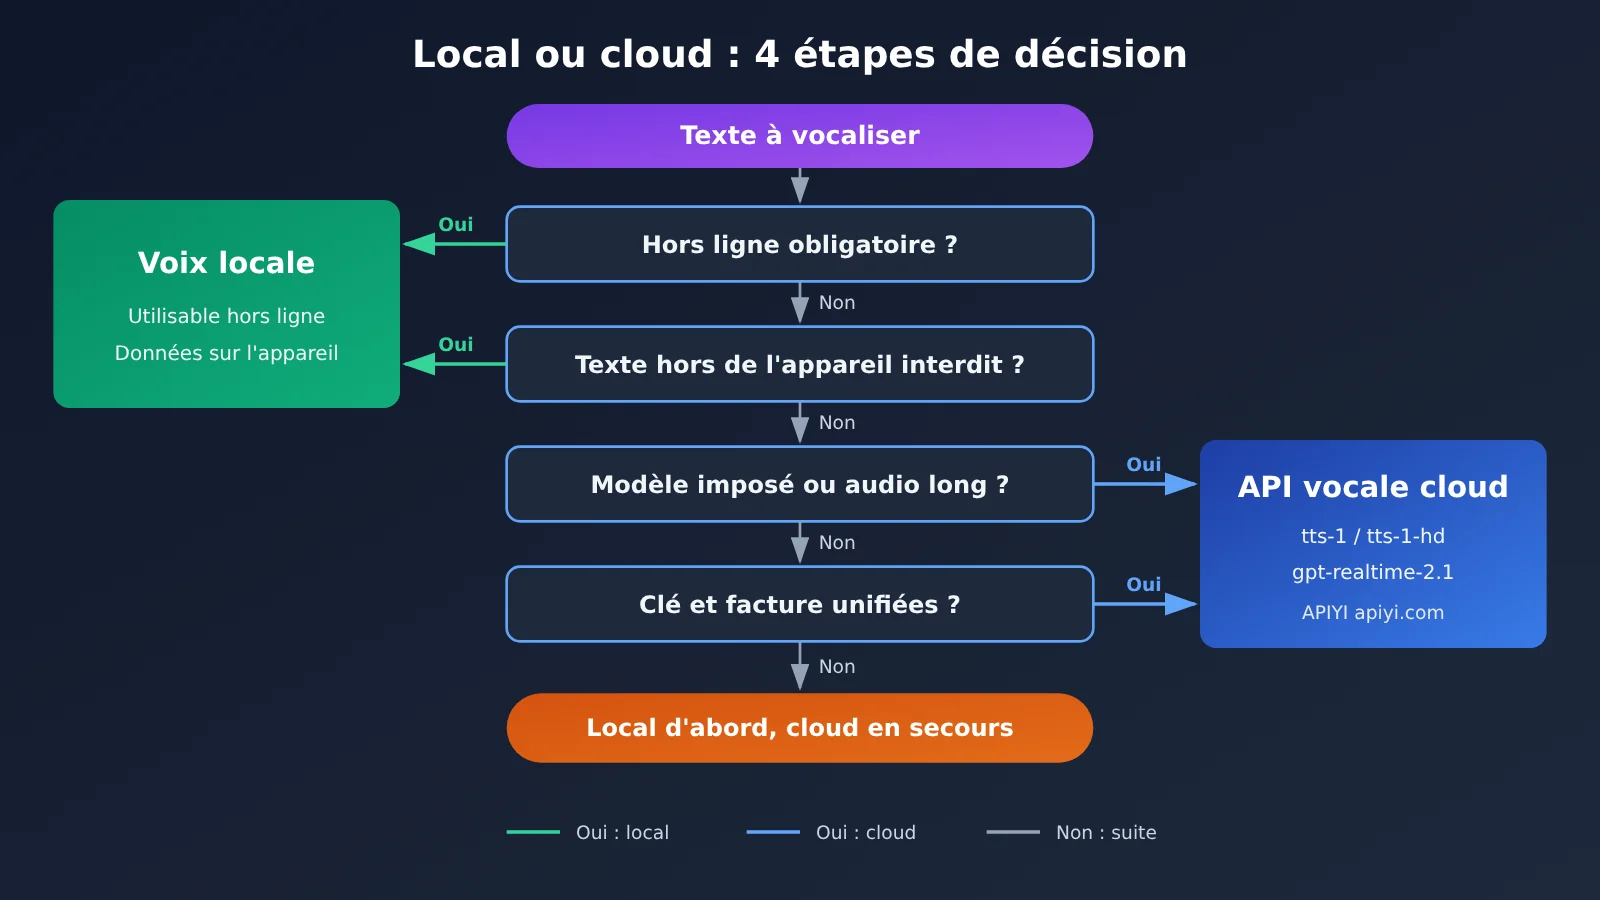
Répartition des rôles entre la voix embarquée et l’API vocale cloud
Découper la question en 4 dimensions est bien plus efficace que de débattre du « faut-il garder le cloud ou non ». Le tableau ci-dessous indique, pour chaque dimension, le côté le plus adapté, ainsi que la question à vous poser pour trancher.
| Dimension | Plutôt voix embarquée | Plutôt API vocale cloud | Question à se poser |
|---|---|---|---|
| Hors ligne | La voix doit sortir même sans réseau ou avec un réseau faible | Les utilisateurs sont presque toujours connectés | Le produit doit-il continuer à lire à voix haute quand la connexion tombe ? |
| Confidentialité | Texte sensible, interdiction de sortir de l’appareil | Texte pouvant être envoyé pour traitement | Les exigences de conformité interdisent-elles que les données quittent le terminal ? |
| Qualité sonore et voix longue | Phrases courtes, sons de notification, exigences modestes sur le timbre | Lecture de longs textes, forte exigence de cohérence du timbre | Est-il acceptable que chaque appareil lise avec une voix différente ? |
| Modèle imposé et facturation unifiée | Aucun besoin de ce type | Besoin de verrouiller un modèle et d’utiliser la même clé que pour les modèles de texte | Faut-il figer un modèle précis comme tts-1-hd ou gpt-realtime-2.1 ? |
Hors ligne et confidentialité : le terrain de jeu de la voix embarquée
Si votre produit est souvent utilisé dans le métro, en montagne ou en avion, le hors ligne est une exigence incontournable, et c’est la voix embarquée qui doit assurer l’essentiel de la lecture. De même, si votre activité interdit d’envoyer le texte saisi par l’utilisateur vers un serveur, la voix embarquée est quasiment la seule option. Sur ces deux dimensions, l’API vocale cloud joue plutôt le rôle de « renfort quand le réseau est là » que celui de moteur principal.
Qualité sonore, voix longue et modèle imposé : le terrain de jeu de l’API vocale cloud
Dès que le produit a besoin d’un timbre de marque uniforme, d’une lecture stable de longs articles ou d’un dialogue vocal en temps réel, le cloud devient très difficile à remplacer. Il permet de choisir explicitement le modèle : par exemple tts-1 pour la lecture courante, tts-1-hd pour une meilleure qualité sonore, gpt-realtime-2.1 ou gpt-realtime-2.1-mini pour le dialogue en temps réel. Tous les utilisateurs entendent ainsi la sortie du même modèle.
Autre point souvent oublié : la facturation et la gestion des clés. Au-delà de la voix, la plupart des produits appellent aussi un grand modèle de langage pour la compréhension, le résumé ou la génération de dialogues. Si la voix et le texte passent par la même clé et la même facture, l’exploitation et le rapprochement comptable deviennent beaucoup plus simples.
Comment intégrer l’API vocale cloud : garder un canal stable
Même si vous décidez de miser surtout sur le traitement embarqué, il reste judicieux de conserver un canal cloud en secours et pour les cas où il faut un meilleur rendu. APIYI propose une interface compatible OpenAI : l’intégration est quasiment identique à l’appel du SDK officiel, il suffit de remplacer base_url.
Les étapes se résument ainsi :
- Initialiser le client :
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - Appeler la synthèse vocale :
client.audio.speech.create(model="tts-1", voice="alloy", input="您的订单已发货") - Pour une meilleure qualité audio, remplacez le modèle par
tts-1-hdet gardez tous les autres paramètres tels quels - Le modèle de texte pointe lui aussi vers
https://api.apiyi.com/v1: la voix et le texte partagent la même clé API
La connexion pour le dialogue vocal en temps réel (série gpt-realtime-2.1) fonctionne différemment d’une requête HTTP classique. Pour les paramètres d’intégration précis, reportez-vous à la documentation d’APIYI.
| Modèle | Type | Usage typique | Plateforme disponible |
|---|---|---|---|
| tts-1 | Synthèse vocale (texte vers parole) | Annonces courantes, lecture de notifications | APIYI apiyi.com |
| tts-1-hd | Synthèse vocale (haute qualité) | Lecture de textes longs, voix de marque | APIYI |
| gpt-realtime-2.1 | Dialogue vocal en temps réel | Assistants vocaux, interactions en direct | APIYI |
| gpt-realtime-2.1-mini | Dialogue vocal en temps réel (léger) | Scénarios temps réel plus sensibles au coût | APIYI |
🚀 Pour démarrer rapidement : si vous hésitez à garder une voix cloud, créez un compte sur APIYI apiyi.com et profitez du crédit de test gratuit offert aux nouveaux utilisateurs. Envoyez le même texte à tts-1 puis à tts-1-hd, comparez avec la lecture locale de l’appareil, et voyez si l’écart justifie de payer.
Analyse de l’impact de la voix embarquée
Impact pour les développeurs
- Une architecture qui passe du choix unique au mode hybride : le module vocal a besoin d’une couche de routage qui décide, selon l’état du réseau, la sensibilité du texte et sa longueur, si on traite en local (embarqué) ou dans le cloud
- Des coûts de test en hausse : le rendu de la voix embarquée dépend de l’appareil de l’utilisateur, il faut donc échantillonner différents modèles d’appareils et de navigateurs, alors que la sortie du cloud reste relativement homogène
- Une logique de repli devenue indispensable : si le cloud échoue, on bascule sur la voix embarquée ; si la voix embarquée n’est pas disponible, on revient au cloud. Les deux chaînes se secourent mutuellement
Impact sur l’architecture produit
La façon la plus courante de mettre en place une architecture hybride consiste à définir, pour chaque type de tâche vocale, un canal par défaut et un canal de repli. Le tableau ci-dessous peut servir directement de point de départ pour votre conception.
| Tâche vocale | Canal par défaut | Canal de repli | Raison |
|---|---|---|---|
| Messages courts, annonces de navigation | Voix embarquée | Cloud tts-1 | Le local suffit pour les phrases courtes, et le mode hors ligne doit impérativement fonctionner |
| Lecture de texte sensible | Voix embarquée | Pas de repli vers le cloud | Les données ne doivent pas quitter l’appareil |
| Longs articles, contenus audio | Cloud tts-1-hd | Voix embarquée | Timbre homogène, voix longue plus stable |
| Dialogue vocal en temps réel | Cloud gpt-realtime-2.1 | gpt-realtime-2.1-mini | Il faut préciser le modèle, l’interaction en temps réel dépend du cloud |
Impact sur le calcul des coûts
La voix embarquée n’est pas facturée à l’appel, et c’est la raison pour laquelle beaucoup d’équipes veulent basculer toute leur voix en local. Mais attention : les frais d’appel économisés peuvent se transformer en coûts d’adaptation et de test, ainsi qu’en perte d’utilisateurs dont l’expérience se dégrade sur les appareils d’entrée de gamme. L’approche la plus raisonnable consiste à ne migrer vers l’embarqué que les phrases courtes à haute fréquence, et à laisser au cloud les tâches sensibles à la qualité. Le volume d’appels cloud diminue alors naturellement, sans toucher aux expériences clés.
Foire aux questions (FAQ)
Q1 : Maintenant que la voix embarquée est disponible, peut-on couper directement l’API vocale cloud ?
Pour la plupart des produits, on déconseille de la couper d’emblée. Le traitement embarqué règle les questions de mode hors ligne et de confidentialité, mais le choix d’un modèle précis, la stabilité sur les longs contenus audio et la cohérence des timbres de voix dépendent encore du cloud. L’approche la plus sûre consiste à faire de l’embarqué le moteur principal, et du cloud un filet de secours et un moyen d’enrichir le rendu.
Q2 : Quel est l’écart de qualité sonore et de latence entre la voix embarquée et l’API vocale cloud ?
Il n’existe pour l’instant aucun chiffre d’évaluation public et unifié que l’on puisse citer, et les performances des solutions embarquées varient selon l’appareil. On considère donc cet écart comme inconnu. Nous vous conseillons de faire des écoutes par échantillonnage sur quelques appareils couramment utilisés par vos utilisateurs cibles, puis de comparer le résultat avec les sorties cloud de tts-1 et tts-1-hd.
Q3 : À ce jour, quels modèles vocaux cloud peut-on encore appeler ?
Au 2026-11-12, la grille tarifaire d’APIYI propose toujours tts-1 et tts-1-hd, ainsi que gpt-realtime-2.1 et gpt-realtime-2.1-mini pour la voix en temps réel. La liste des modèles peut évoluer à tout moment : référez-vous à la grille tarifaire en direct de la plateforme.
Q4 : Comment appeler à la fois des modèles vocaux et des modèles de texte avec une seule clé ?
Demandez une clé API sur APIYI (apiyi.com), puis définissez `base_url` sur `https://api.apiyi.com/v1`. La synthèse vocale, la voix en temps réel et les modèles de texte comme GPT, Claude ou Gemini passent tous par le même point d’entrée, et la facturation est regroupée, ce qui simplifie le rapprochement des coûts à l’usage.
Q5 : Dans une architecture hybride, que faire si l’appel au cloud échoue ?
Ajoutez un mécanisme de repli dans votre couche de routage vocal : en cas de délai dépassé ou d’erreur côté cloud, les phrases courtes non sensibles peuvent basculer sur la lecture embarquée, et pour les contenus audio longs, vous pouvez inviter l’utilisateur à réessayer plus tard. Dans les scénarios de conversation en temps réel, il est possible de basculer entre gpt-realtime-2.1 et gpt-realtime-2.1-mini.
Points clés : voix embarquée vs API vocale dans le cloud (Key Takeaways)
- Ce n’est pas un choix exclusif : la voix embarquée et l’API vocale cloud se partagent le travail, on répartit les tâches selon le canal
- L’embarqué gère le hors ligne et la confidentialité : fonctionne sans réseau, les données ne quittent pas l’appareil, idéal pour les phrases courtes et les signaux sonores
- Le cloud gère la qualité et la cohérence : les voix longues, les timbres de marque et les conversations en temps réel nécessitent toujours des modèles cloud
- Choisir un modèle précis passe forcément par le cloud : pour verrouiller tts-1-hd ou gpt-realtime-2.1, il faut passer par l’API
- Performances embarquées inconnues : quand il n’existe aucun chiffre public, fiez-vous à un échantillonnage sur vos propres appareils
- Une clé unique réduit la charge d’exploitation : avec APIYI (apiyi.com), les modèles vocaux et textuels partagent la même clé API et la même facture
Conclusion
Maintenant que la voix embarquée existe, faut-il garder une API vocale dans le cloud ? Tout dépend de 4 critères :
- Hors ligne : les tâches qui doivent fonctionner sans connexion vont sur la voix embarquée
- Confidentialité : les tâches dont le texte ne doit pas quitter l’appareil passent uniquement par l’embarqué
- Qualité sonore et voix longues : les tâches exigeant cohérence et stabilité restent dans le cloud
- Modèle précis et facturation unifiée : les tâches qui demandent de verrouiller un modèle donné, ou de partager une même clé avec les modèles textuels, continuent d’utiliser l’API cloud
La conclusion est claire : l’embarqué résout le hors ligne et la confidentialité, tandis que le choix d’un modèle précis et la facturation unifiée restent du côté du cloud. Le plus simple : commencez par migrer vers l’embarqué les phrases courtes très fréquentes, puis gardez dans le cloud les voix longues et les conversations en temps réel. Avec APIYI (apiyi.com), vous appelez tts-1, tts-1-hd et la série gpt-realtime-2.1 depuis un point d’accès unique. Validez le rendu avec le crédit de test gratuit avant de décider de la répartition entre les canaux.
📚 Références
- Centre de documentation APIYI : guide de synthèse vocale et d’accès à la voix en temps réel
- Lien :
docs.apiyi.com -
Description : consultez les paramètres d’invocation et les modes d’intégration des modèles tts-1, gpt-realtime-2.1, etc.
-
Centre d’aide APIYI : tutoriels d’utilisation de la plateforme et questions fréquentes
- Lien :
help.apiyi.com - Description : idéal pour une première intégration, avec des infos sur la demande de clé API, la facturation et la liste des modèles
Auteur : l’équipe technique d’APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI (apiyi.com). Vous trouverez plus de ressources dans le centre de documentation docs.apiyi.com