Note de l’auteur : cet article s’appuie sur deux systèmes d’évaluation, l’indice composite AA et le benchmark professionnel MKA, pour comparer Gemini 4 Carbon, Claude Fable 5.2 et GPT-6 Astra sur leurs performances, leur durée d’exécution et leur coût. Il précise aussi les configurations testées et la portée des conclusions statistiques.
À savoir avant de lire : 7 termes utilisés dans la comparaison
- MKA (Multimodal Knowledge Agent) : benchmark qui évalue des tâches professionnelles multimodales. Il vérifie si un modèle sait lire des documents complexes (plans, scans, imagerie) et livrer un résultat professionnel complet.
- Climb WSR : taux de satisfaction pondéré, calculé uniquement sur les critères de notation les plus discriminants. Il sert à départager les meilleurs modèles.
- Regression WSR : indicateur pondéré qui mesure si les exigences de base sont remplies. C’est en quelque sorte la barre d’admissibilité d’une livraison professionnelle.
- Niveau de raisonnement : réglage de l’intensité de raisonnement dont un modèle dispose. Par exemple LOW, MEDIUM et HIGH pour Carbon, ou Max et Xhigh pour Fable et Astra dans le classement.
- Coût par tâche : somme de tous les frais d’invocation du modèle nécessaires pour accomplir une tâche donnée. Ce n’est pas le prix fixe d’une seule requête API.
- Lecture en cache : réutilisation d’un contenu d’entrée déjà mis en cache, facturée à un tarif unitaire plus bas.
- Significativité statistique : indicateur qui permet de juger si l’écart de score entre deux modèles repose sur des preuves statistiques suffisantes. Tant qu’un écart n’atteint pas le seuil de significativité, on ne peut pas le traiter comme une victoire ou une défaite établie.
La compétition entre les meilleurs modèles ne se résume plus à un seul classement général. Cet article compare Gemini 4 Carbon, Claude Fable 5.2 et GPT-6 Astra selon trois axes : capacité générale, livraison professionnelle et coût par tâche. Il propose ensuite des recommandations de choix selon le type de tâche.
Il ne s’agit pas d’une lecture de classement qui mélangerait tous les scores pour établir un palmarès. L’indice composite et le MKA sont deux systèmes d’évaluation distincts, et nous les analysons séparément. Nous indiquons aussi quels écarts reposent sur des preuves statistiques et lesquels manquent d’éléments probants.
L’essentiel : après cette lecture, vous saurez quel modèle privilégier selon vos exigences de qualité, de rapidité et de coût.
I. Gemini 4 Carbon, Claude Fable 5.2 et GPT-6 Astra : trois modèles sur la même ligne de départ
Les dates de cette nouvelle manche sont très rapprochées. Google a dévoilé Gemini 4 Carbon le 28 octobre 2026, puis Anthropic a lancé Claude Fable 5.2 le 9 novembre. Le 10 novembre, Carbon a été officiellement ouvert aux développeurs, aux entreprises et au grand public. Le même jour, Google DeepMind et Artificial Analysis ont lancé le benchmark MKA. Le 11 novembre, l’Artificial Analysis Intelligence Index v5.0.1 a été mis à jour et intègre désormais Fable 5.2.
Le positionnement public des trois modèles est assez différent. Carbon est construit sur Gemini 4 Argon et vise les agents à long horizon, le génie logiciel complexe et la recherche scientifique ; il accepte en entrée du texte, des images, de l’audio et de la vidéo. Fable 5.2 utilise l’Adaptive Thinking, avec une fenêtre de contexte de 1M tokens et une sortie maximale de 128K tokens. GPT-6 Astra obtient des résultats dans les deux évaluations citées ici, et sert souvent de référence en matière d’efficacité.
| Critère de comparaison | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra | Verdict actuel |
|---|---|---|---|---|
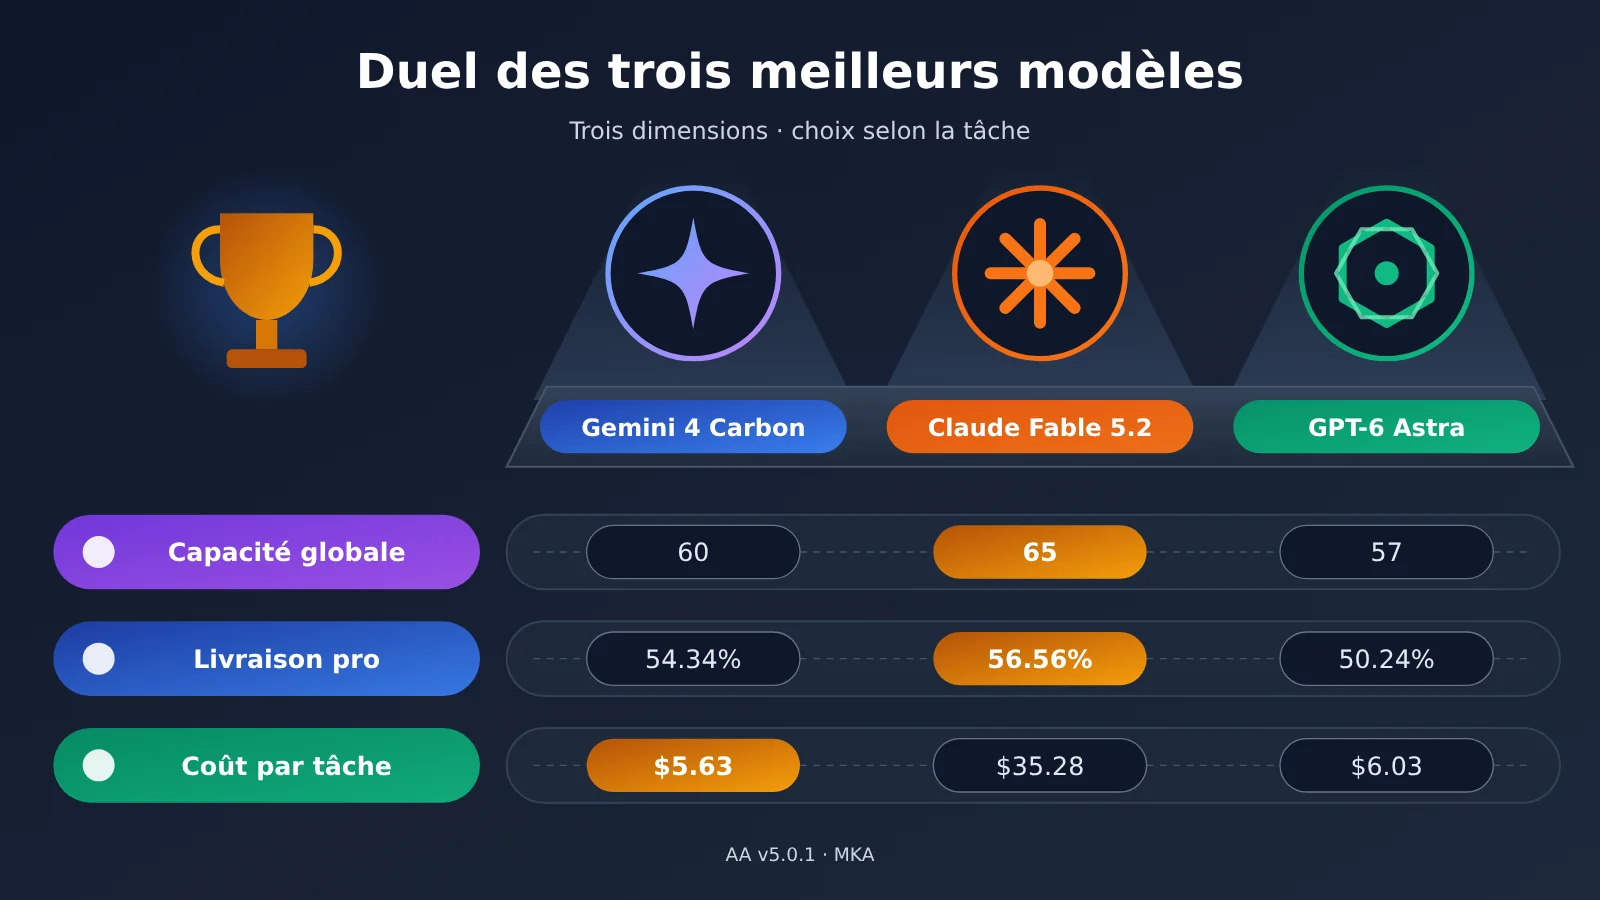
| Capacité globale (AA v5.0.1) | 65 (Max) | 60 (High) | 57 (Max) | Fable en tête |
| Livrables professionnels (MKA Climb-WSR) | 56,56 % | 54,34 % | 50,24 % | Fable et Carbon proches, tous deux devant Astra |
| Coût par tâche (MKA, tableau 4) | 35,28 $ | 5,63 $ | 6,03 $ | Carbon le moins cher |
| Temps d’exécution (MKA, tableau 4) | 83,2 minutes | 29,2 minutes | 18,5 minutes | Astra le plus rapide |
| Consommation de tokens (MKA, tableau 4) | 40,48M | 7,05M | 2,43M | Astra le plus économe |
La colonne « Verdict actuel » ne concerne que l’indicateur de la ligne correspondante. Aucun modèle n’arrive en tête sur tous les critères.
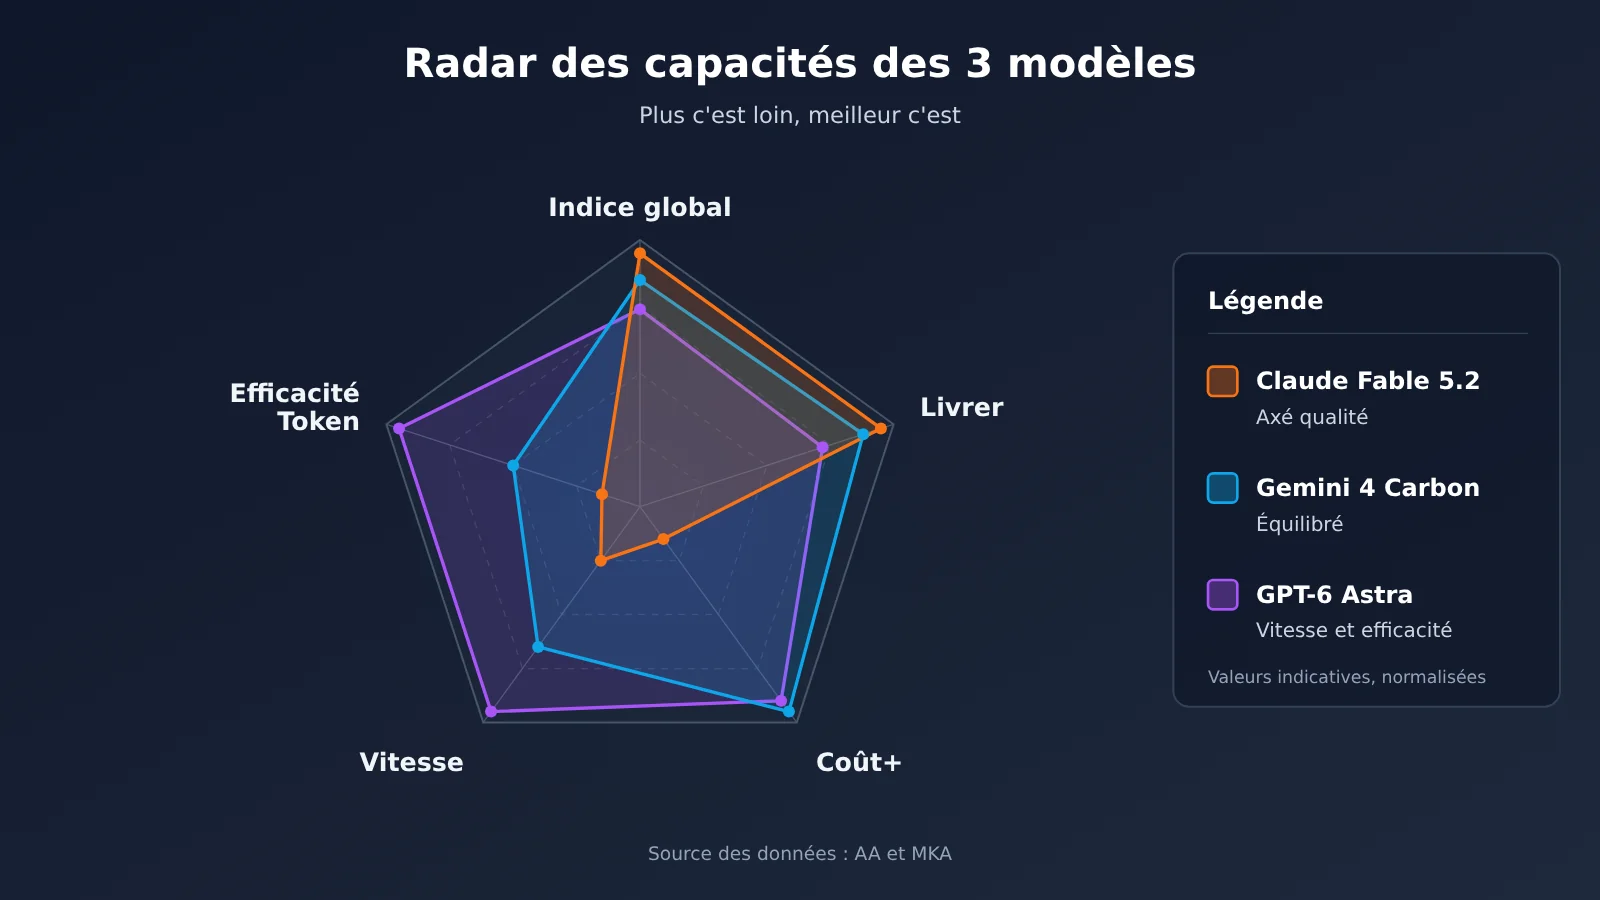
📊 À propos des données : les chiffres du tableau proviennent d’un côté du classement AA, de l’autre de l’article technique du MKA. Les deux méthodologies ne sont pas convertibles entre elles. Pour vérifier ce que ça donne dans votre cas d’usage, vous pouvez lancer un petit test comparatif avec APIYI (apiyi.com) en utilisant la même invite pour les trois modèles, et observer les écarts sous charge réelle.
II. Classement général AA : Claude Fable 5.2 en tête pour l’instant, Gemini 4 Carbon juste derrière
L’Artificial Analysis Intelligence Index v5.0.1 regroupe 9 évaluations : AA-Briefcase v1.1, AutomationBench-AA, Terminal-Bench 4.0, FrontierCode 2.0, AA-Omniscience v1.1, GDP.pdf, HLE-Diamond, CritPt v2 et Terminal-Bench-Science 0.1. Elles couvrent le travail de connaissance, l’automatisation, le code, le raisonnement scientifique et la fiabilité factuelle. La question à laquelle cet indice répond : « quel est le niveau global du modèle ? »
| Configuration du modèle | AA Index v5.0.1 | Coût par tâche d’évaluation | Durée par tâche |
|---|---|---|---|
| Claude Fable 5.2 Max | 65 | $26.54 | 44,4 minutes |
| Gemini 4 Carbon High | 60 | $7.76 | 24,9 minutes |
| GPT-6 Astra Max | 57 | $6.24 | 23,0 minutes |
Attention aux différences de configuration dans ce tableau. Les trois modèles utilisent respectivement les niveaux Max, High et Max, donc le budget de raisonnement n’est pas le même : on ne peut pas y voir une comparaison de capacités à conditions égales. Pour un même modèle, le score varie aussi selon le niveau choisi : Fable 5.2 obtient 62 points en Xhigh comme en High, tandis que Carbon obtient 58 en Medium et 54 en Low.
Les données internes de Carbon méritent qu’on s’y arrête. Dans les calculs d’AA, le coût par tâche en Medium est de $6.59, soit moins que les $7.19 de Low. Quant au niveau High, il a beau afficher le meilleur score, la latence avant le premier jeton de réponse atteint 67,54 secondes. Autrement dit, monter le niveau de raisonnement ne garantit pas un gain proportionnel. Le $7.76 du tableau correspond au coût moyen d’une tâche AA, calculé au tarif standard de Carbon ($4/$20), et non au prix d’une requête ordinaire.
III. Livraison professionnelle sur MKA : ce que les trois modèles savent vraiment accomplir
L’indice AA mesure la puissance globale. MKA, lui, mesure si un modèle est capable de mener à bien un vrai travail professionnel. Voici les paramètres décrits dans l’article technique de MKA :
- 200 tâches réelles et privées, couvrant 10 secteurs et 83 métiers. Chaque tâche correspond à environ 3 à 8 heures de travail pour un professionnel.
- Chaque tâche comporte environ 70 critères d’évaluation pondérés. 88 % des tâches exigent la production de fichiers autonomes, par exemple Word, Excel, PPT, PDF, HTML ou des images.
- Tous les modèles tournent dans le même Stirrup Agent Harness, avec le même environnement d’outils, un budget uniforme de 250 tours et une seule exécution par tâche.
| Modèle | Climb-WSR | Overall WSR | Regression-WSR |
|---|---|---|---|
| Claude Fable 5.2 | 56,56 % | 73,26 % | 95,71 % |
| Gemini 4 Carbon | 54,34 % | 71,89 % | 96,36 % |
| GPT-6 Astra | 50,24 % | 69,34 % | 95,17 % |
Chacun des trois indicateurs a sa signification. Le Regression-WSR reflète le respect des exigences de base : les trois modèles dépassent 95 %, avec un léger avantage pour Carbon. Le Climb-WSR ne compte que les critères très difficiles, et c’est lui qui départage vraiment les meilleurs modèles. L’Overall WSR est le taux de satisfaction pondéré sur l’ensemble des critères. Aucun de ces chiffres n’est un taux de bonnes réponses à des questions classiques, et on ne peut pas les comparer aux scores de l’indice AA (65, 60 et 57).
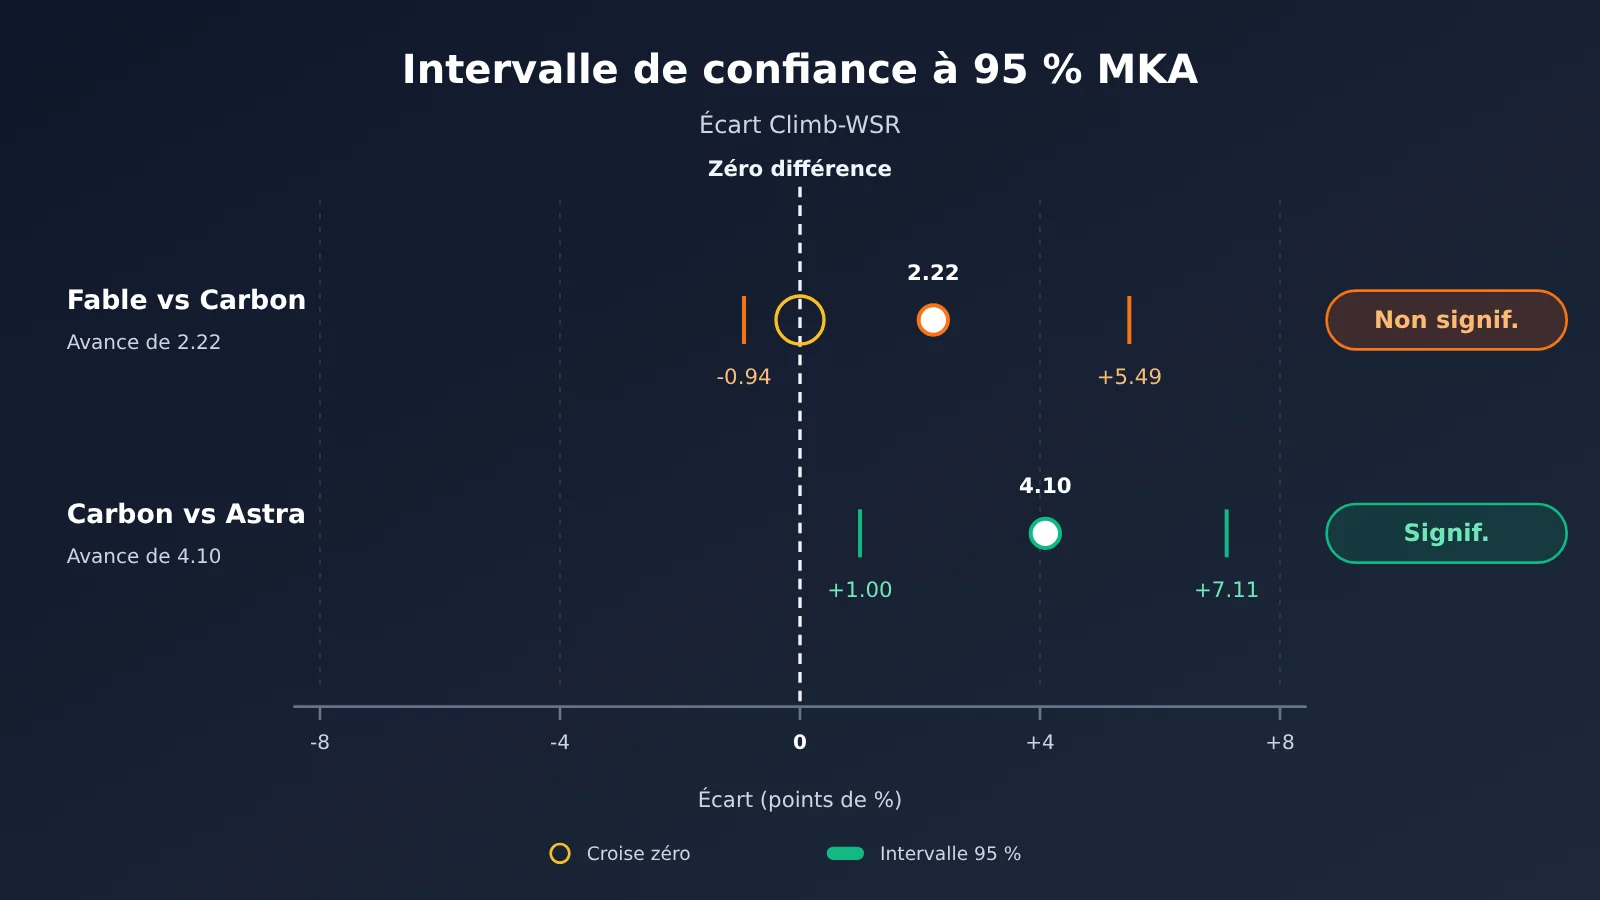
Significativité statistique : Claude Fable 5.2 contre Gemini 4 Carbon
La significativité statistique est le point le plus important à garder en tête pour interpréter MKA. Voici les données fournies par l’article :
- Fable contre Carbon : Fable devance Carbon de 2,22 points de pourcentage, avec un intervalle de confiance à 95 % allant de -0,94 à +5,49. L’intervalle contient 0, donc la différence n’est pas statistiquement significative.
- Carbon contre Astra : Carbon devance Astra de 4,10 points de pourcentage, avec un intervalle de confiance à 95 % allant de +1,00 à +7,11. L’intervalle est entièrement au-dessus de 0, donc la différence est statistiquement significative.
La formulation correcte est donc la suivante : sur MKA, Fable 5.2 et Carbon se situent à un niveau comparable, et les éléments dont on dispose ne suffisent pas à affirmer que Fable surpasse clairement Carbon. La conclusion de l’article est que ces deux modèles devancent significativement Astra.
Quatrièmement : comparaison des coûts, ce que coûte réellement la même tâche selon les trois modèles
Le tableau 4 de l’article MKA donne la consommation moyenne de ressources par tâche. Les coûts d’API sont estimés à partir des tarifs affichés par chaque éditeur, en tenant compte de la facturation du cache d’invites.
| Moyenne par tâche | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra |
|---|---|---|---|
| Total de tokens | 40,48 M | 7,05 M | 2,43 M |
| Tokens de sortie | 378,9 K | 129,5 K | 42,0 K |
| Nombre de tours de l’agent | 128,8 | 46,6 | 29,0 |
| Temps d’exécution | 83,2 minutes | 29,2 minutes | 18,5 minutes |
| Coût par tâche | 35,28 $ | 5,63 $ | 6,03 $ |
Ce tableau permet de tirer trois enseignements :
- Fable mobilise le plus de ressources : son total de tokens est 5,74 fois celui de Carbon, et son temps d’exécution environ 2,85 fois plus long. Ses bons résultats reposent sur de nombreux tours d’exploration et un grand nombre d’appels.
- Carbon offre le meilleur rapport qualité-prix : son coût par tâche représente environ un sixième de celui de Fable, pour un Climb-WSR inférieur de seulement 2,22 points de pourcentage, un écart qui n’est d’ailleurs pas significatif.
- Astra est le plus rapide et le plus économe en tokens : il affiche le temps d’exécution et la consommation de tokens les plus faibles, mais son coût par tâche reste légèrement supérieur à celui de Carbon, et son Climb-WSR est nettement en retrait par rapport à Carbon.
Prix unitaire du token, consommation de tokens et facture par tâche : trois notions différentes
On confond souvent ces trois notions. Côté prix unitaire, Fable 5.2 est facturé 8 $ par million de tokens en entrée et 40 $ en sortie. Carbon bénéficie d’un tarif de lancement de 2 $/10 $ jusqu’au 30 novembre, puis passe à 4 $/20 $ à partir du 1er décembre. Mais un prix unitaire bas ne garantit pas une facture basse. Astra consomme environ trois fois moins de tokens que Carbon, et pourtant son coût par tâche est légèrement plus élevé : la structure tarifaire propre à chaque modèle et le taux de succès du cache influencent tous deux la facture finale.
La lecture du cache est une variable souvent négligée dans les scénarios d’agents. À chaque tour, l’agent renvoie une grande quantité de contexte. Pour Carbon, le prix d’entrée en cache représente environ 5 % du prix d’entrée normal. Avec ses 40,48 M de tokens au total, Fable en compte une grande partie qui correspond à du contexte relu en boucle, d’où l’impact direct du mode de facturation sur la note finale. Par ailleurs, les tokens de réflexion de Carbon sont comptés dans les frais de sortie, et lorsqu’on utilise le Grounding, les requêtes de recherche sont facturées à part.
Les données de coût existent selon trois méthodes de calcul, qu’il faut citer séparément : le tableau 4 de l’article MKA (Carbon 5,63 $, Fable 35,28 $), le classement dynamique MKA (Carbon 6,29 $, Fable 31,97 $) et le coût par tâche de l’indice AA (7,76 $ et 26,54 $). Leurs périmètres de calcul diffèrent, il ne faut donc pas les mélanger.
V. Où se manifeste l’avantage multimodal de Gemini 4 Carbon ?
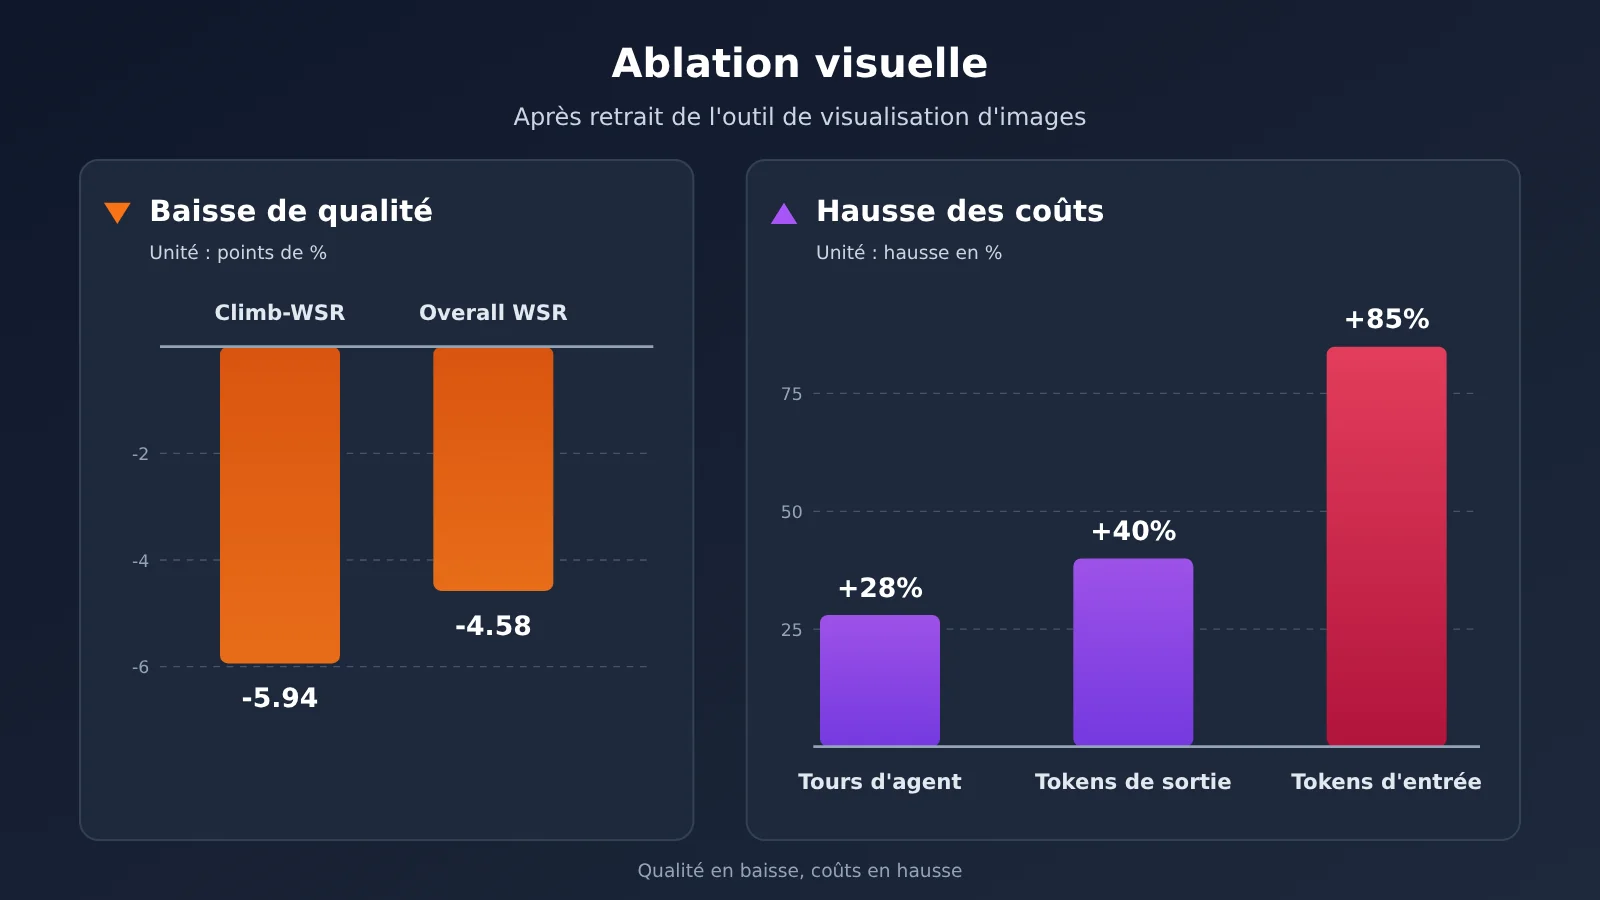
L’article MKA présente une expérience d’ablation : on retire à Carbon son outil de consultation d’images view_image, et on le force à travailler uniquement avec l’OCR, l’exécution de code et des méthodes classiques de vision par ordinateur. Voici les résultats :
- Le Climb-WSR baisse de 5,94 points de pourcentage, et le WSR global de 4,58 points.
- Le nombre de tours de l’agent augmente de 28 %, les tokens de sortie de 40 % et les tokens d’entrée de 85 %.
- Le modèle tente de compenser avec des images ASCII, du Braille Unicode ou OpenCV, mais il échoue encore souvent sur les photos réelles et l’imagerie médicale.
Ces chiffres montrent bien que, dans un contexte professionnel, la compréhension visuelle ne se remplace pas facilement par de l’extraction de texte. Les relations spatiales d’un plan d’architecte, la position d’une lésion sur une image médicale, l’encodage visuel d’un graphique : tout cela se perd en grande partie après un passage par l’OCR. Le modèle en est réduit à écrire du code en boucle pour deviner le contenu de l’image, avec à la clé une qualité en baisse et des coûts en hausse.
Les résultats par secteur du classement MKA vont dans le même sens. Carbon domine dans la santé et se distingue sur les livrables de type image, aux côtés d’Argon. Fable 5.2 est en tête dans le logiciel et les données, l’ingénierie, la logistique et la cartographie, le commerce et la finance, et prend l’avantage sur les livrables de type PDF, Word et Spreadsheet. Aucun modèle ne l’emporte sur l’ensemble des 10 secteurs, et les fichiers Word et texte brut restent les livrables les plus difficiles : aucun modèle ne dépasse 52 % sur ces deux catégories.
Six. Scénarios recommandés : les tâches adaptées à Gemini 4 Carbon, Claude Fable 5.2 et GPT-6 Astra
Quand choisir Claude Fable 5.2
- Livrables professionnels complexes où la qualité du résultat est prioritaire : par exemple des rapports d’analyse financière, des plans d’ingénierie ou des projets de données et de logiciels. Une erreur coûte cher dans ce genre de tâches, et on peut accepter un temps d’exécution plus long et une facture plus élevée.
- Livrables centrés sur des documents Office : les sorties PDF, Word et tableurs sont un point fort de Fable dans MKA.
Quand choisir Gemini 4 Carbon
- Travaux d’agent complexes qui exigent un bon équilibre entre qualité et coût : dans MKA, Carbon atteint un niveau statistiquement proche de celui de Fable pour environ un sixième du coût.
- Tâches qui reposent sur la compréhension visuelle : par exemple l’analyse de plans techniques, l’aide à l’analyse d’imagerie médicale et les livrables de type image. Pour le niveau de raisonnement, je vous conseille de commencer par MEDIUM : dans le test de fiabilité factuelle d’AA, ce niveau invente moins de réponses.
Quand choisir GPT-6 Astra
- Pipelines où la vitesse d’exécution compte : c’est le modèle le plus rapide dans MKA, avec le moins de tours d’agent, ce qui convient bien aux tâches nécessitant un retour rapide.
- Scénarios sensibles au budget de tokens ou à la pression sur la fenêtre de contexte : Astra a la consommation totale de tokens la plus faible, mais il faut accepter un écart sur la qualité des livrables professionnels.
| Type de tâche | Modèle recommandé | Modèle alternatif | Principale justification | Mode d’accès |
|---|---|---|---|---|
| Rapports professionnels à forte valeur | Claude Fable 5.2 | Gemini 4 Carbon | Meilleurs scores sur AA et MKA | API officielle, APIYI |
| Tâches d’agent complexes en volume | Gemini 4 Carbon | Claude Fable 5.2 | Qualité proche, coût environ six fois moindre | API officielle, APIYI |
| Analyse de plans et d’imagerie | Gemini 4 Carbon | Claude Fable 5.2 | Preuves issues de l’ablation visuelle, avance dans le domaine médical | API officielle, APIYI |
| Pipelines d’exécution rapide | GPT-6 Astra | Gemini 4 Carbon | Durée et consommation de tokens les plus faibles | API officielle, APIYI |
VII. Comment tester les trois modèles avec une interface unifiée
Les classements publics ne sont qu’un point de départ : au final, ce qui compte, c’est le comportement du modèle sur vos propres tâches. L’exemple ci-dessous utilise l’interface compatible OpenAI. Il suffit de changer le paramètre model pour appeler différents modèles avec le même code :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "用三点概括这份季度财报摘要的主要风险。"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # Enregistre la consommation de tokens, utile ensuite pour estimer le coût
Voir le code complet du test comparatif des trois modèles
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Les noms de modèles dépendent de la liste de la plateforme ; GPT-6 Astra n'est ici qu'un nom d'exemple
MODELS = ["claude-fable-5-2", "gemini-4-carbon", "gpt-6-astra"]

# Prix unitaire (dollars / million de tokens) à renseigner selon votre canal réel
# Exemple : Fable 5.2 au tarif officiel ; Carbon au prix de lancement valable jusqu'au 30 novembre
PRICES = {
    "claude-fable-5-2": {"input": 8.0, "output": 40.0},
    "gemini-4-carbon": {"input": 2.0, "output": 10.0},
    "gpt-6-astra": None,  # À compléter par vos soins
}

def build_messages(task, image_url=None):
    content = [{"type": "text", "text": task}]
    if image_url:
        content.append({"type": "image_url", "image_url": {"url": image_url}})
    return [{"role": "user", "content": content}]

def run_once(model, messages):
    start = time.time()
    resp = client.chat.completions.create(model=model, messages=messages)
    elapsed = time.time() - start
    usage = resp.usage
    cost = None
    price = PRICES.get(model)
    if price and usage:
        # Estimation approximative : la lecture du cache n'est pas distinguée ; les tokens de réflexion sont généralement comptés dans la sortie
        cost = (usage.prompt_tokens * price["input"]
                + usage.completion_tokens * price["output"]) / 1_000_000
    return {
        "model": model,
        "seconds": round(elapsed, 1),
        "prompt_tokens": usage.prompt_tokens if usage else None,
        "completion_tokens": usage.completion_tokens if usage else None,
        "est_cost_usd": round(cost, 4) if cost is not None else None,
        "answer": resp.choices[0].message.content[:200],
    }

if __name__ == "__main__":
    task = "根据这张户型图,列出各房间面积估算和三条改造建议。"
    msgs = build_messages(task, image_url="https://example.com/floor-plan.png")
    for m in MODELS:
        try:
            print(run_once(m, msgs))
        except Exception as e:
            print(m, "调用失败:", e)
Ce code mesure un seul appel. Pour une vraie tâche d’agent, il faut additionner le coût de tous les tours : c’est ce que cet article appelle le coût par tâche. Autre point à noter : Carbon ne prend pas en charge thinking_budget (le passer renvoie une erreur HTTP 400), et les paramètres d’échantillonnage comme temperature sont ignorés. Le niveau de raisonnement doit être réglé de la manière décrite dans la documentation de la plateforme.
🚀 Conseil pour démarrer vite : commencez par récupérer le crédit de test gratuit pour les nouveaux utilisateurs sur APIYI (apiyi.com), puis lancez le script comparatif ci-dessus sur 5 à 10 échantillons métier réels. Notez le temps de réponse, les tokens consommés et une note de qualité avant de choisir votre modèle principal. La plateforme donne accès à OpenAI, Claude, Gemini et d’autres modèles grand public avec une seule clé API, en facturation à l’usage : changer de modèle ne demande de modifier qu’un seul paramètre.
Recommandations : comment choisir entre les trois modèles
Pour faire votre choix, commencez par identifier la contrainte la plus importante de votre tâche, puis appuyez-vous sur l’indicateur correspondant :
- La qualité est une contrainte non négociable : prenez comme référence principale le Climb-WSR de MKA et départagez Fable 5.2 et Carbon. Comme l’écart entre les deux n’est pas significatif, mieux vaut valider avec vos propres échantillons.
- Le budget est une contrainte non négociable : regardez le coût par tâche du tableau 4 de MKA plutôt que le prix unitaire par token. Sur ce point, Carbon a un net avantage.
- Le délai est une contrainte non négociable : regardez le temps d’exécution et le nombre de tours de l’Agent. Astra est le plus rapide, mais il faut accepter qu’il soit nettement en retrait sur la qualité de livraison professionnelle.
💡 Conseil : vous pouvez vous inspirer de l’approche /swarm de Google, qui consiste à confier la planification et la revue à un modèle puissant, et l’exécution en masse à un modèle rapide. Grâce à l’interface unifiée d’APIYI (apiyi.com), vous pouvez attribuer différents modèles selon le rôle de chaque Agent au sein d’un même projet, sans avoir à maintenir plusieurs SDK.
Questions fréquentes (FAQ)
Q1 : Quel est le positionnement de Gemini 4 Carbon, Claude Fable 5.2 et GPT-6 Astra ?
Ce sont trois modèles de raisonnement haut de gamme sortis au second semestre 2026. Fable 5.2 est en tête pour la qualité globale et la qualité des livrables professionnels. Carbon offre un bon équilibre entre qualité, capacités multimodales et coût par tâche. Astra se distingue par sa vitesse d’exécution et son efficacité en Tokens.
Q2 : Dans MKA, Fable 5.2 devance Carbon de 2,22 points de pourcentage. Cela prouve-t-il que Fable est plus performant ?
Non. L’intervalle de confiance à 95 % de cet écart va de -0,94 à +5,49, il contient donc 0 : la différence n’est pas statistiquement significative. Il est plus juste de dire que les deux modèles sont à un niveau comparable, et que tous deux devancent nettement Astra.
Q3 : Peut-on comparer le score de 65 de l’indice AA et les 56,56 % de MKA ?
Non. L’indice AA est un score composite sur 9 évaluations, où chaque modèle utilise un niveau de raisonnement différent. MKA mesure un taux de satisfaction pondéré sur des livrables professionnels, dans un Harness unifié. Les deux ne portent pas sur les mêmes objets et ne se calculent pas de la même façon : impossible de convertir l’un en l’autre.
Q4 : Le prix unitaire des Tokens de Carbon est le quart de celui de Fable. Le coût par tâche est-il aussi divisé par quatre ?
Pas forcément. Pendant la période de lancement, le prix unitaire de Carbon correspond bien à 25 % de celui de Fable 5.2, puis il passera à 50 % à partir du 1er décembre. Mais la facture réelle dépend de la consommation de Tokens, des Tokens de réflexion, des succès de cache et des appels d’outils. Dans le tableau 4 de MKA, le coût par tâche des deux modèles diffère d’environ six fois, parce que Carbon consomme aussi beaucoup moins de Tokens.
Q5 : Comment tester soi-même les trois modèles à moindre coût ?
Le plus simple est de passer par une interface d’agrégation qui prend en charge plusieurs modèles :
1. Inscrivez-vous sur APIYI (apiyi.com) pour obtenir une clé API et un crédit de test gratuit ;
2. Réglez le `base_url` du code de cet article sur `https://api.apiyi.com/v1` ;
3. Lancez une comparaison avec vos vrais fichiers et vos vraies tâches métier, en notant la qualité, le temps de traitement et la consommation de Tokens.
Q6 : GPT-6 Astra est le plus économe en Tokens, alors pourquoi son coût par tâche n’est-il pas le plus bas ?
Moins de Tokens ne veut pas dire une facture plus basse. La structure des prix en entrée, en sortie et en cache diffère d’un modèle à l’autre, et le coût final est la somme des consommations multipliées par leurs prix unitaires respectifs. Dans le tableau 4 de MKA, Astra consomme environ un tiers des Tokens de Carbon, mais son coût est légèrement supérieur.
Q7 : Quelles sont les limites de ces résultats d’évaluation ?
Dans MKA, chaque tâche n’est exécutée qu’une seule fois. Le Judge est GPT-6 Luna Medium, avec un taux d’accord de 96 % avec les évaluateurs experts. Le classement AA est un instantané dynamique : après l’ajustement du prix de Carbon le 1er décembre, les coûts calculés au tarif standard changeront aussi. Pour suivre vos coûts sur la durée, vous pouvez consulter le détail d’utilisation sur APIYI (apiyi.com) et agréger vos dépenses réelles par modèle, afin de constituer vos propres données de coût.
Points clés de la comparaison des trois modèles Key Takeaways
- Capacité globale : dans AA v5.0.1, Fable 5.2 Max obtient 65 points, devant Carbon High (60) et Astra Max (57).
- Livraison professionnelle : dans MKA, l’écart entre Fable et Carbon n’est pas significatif, et les deux devancent nettement Astra.
- Coût par tâche : selon la méthode du tableau 4 de l’article, Carbon coûte 5,63 $ par tâche, soit environ un sixième du coût de Fable.
- Vitesse et efficacité : Astra met 18,5 minutes par tâche et consomme 2,43 M de tokens, ce qui en fait le meilleur sur la vitesse et l’efficacité en tokens.
- Valeur du multimodal : sans l’outil de visualisation d’images, la qualité de Carbon baisse et ses tokens d’entrée augmentent de 85 %.
- Limites de la méthode : le prix unitaire du token, la consommation de tokens et la facture par tâche sont trois notions distinctes.
- Pour démarrer : avec APIYI (apiyi.com), une seule clé suffit pour comparer les trois modèles sur un petit échantillon.
En résumé : aucun indicateur ne suffit à désigner le meilleur modèle
Pour revenir à la question du début, ces trois modèles de pointe se distinguent surtout par leurs arbitrages différents entre qualité, vitesse et coût :
- Claude Fable 5.2 : il est en tête à la fois sur l’indice global et sur la livraison professionnelle, mais au prix du temps d’exécution le plus long et du coût par tâche le plus élevé.
- Gemini 4 Carbon : sa qualité de livraison professionnelle est statistiquement proche de celle de Fable, son coût par tâche est le plus bas, et sa compréhension visuelle est son atout distinctif.
- GPT-6 Astra : c’est le plus rapide et le plus économe en tokens, mais sa qualité de livraison professionnelle est nettement en retrait par rapport aux deux autres.
Capacité globale, qualité des tâches, rapidité de réponse et coût par tâche sont à évaluer séparément. Plutôt que de vous fier uniquement au classement, le plus fiable reste de faire un test comparatif avec vos propres tâches. Nous vous conseillons de passer par APIYI (apiyi.com) pour vérifier rapidement comment les trois modèles se comportent dans votre contexte : la plateforme offre un crédit de test gratuit et une interface unifiée pour plusieurs modèles.
📚 Références
- Article technique MKA : MKA: Evaluating Multimodal Knowledge Agents on end-to-end professional tasks
- Lien :
storage.googleapis.com/deepmind-media/papers/mka_tech_paper.pdf -
Description : données d’origine sur le WSR des trois modèles, les intervalles de confiance, les coûts du tableau 4 et les expériences d’ablation visuelle
-
Classement des modèles d’Artificial Analysis : Intelligence Index v5.0.1
- Lien :
artificialanalysis.ai/leaderboards/models -
Description : instantané dynamique des scores globaux, du coût par tâche et de la durée
-
Classement d’évaluation MKA : classement des agents de connaissances multimodaux
- Lien :
artificialanalysis.ai/zh/evaluations/mka -
Description : résultats détaillés des modèles leaders du secteur, par type de fichier livré
-
Fiche du modèle Gemini 4 Carbon : documentation officielle de Google DeepMind
- Lien :
deepmind.google/models/model-cards/gemini-4-carbon -
Description : modalités, contexte, niveaux de raisonnement et limites connues
-
Page de tarification de l’API Gemini : tarif standard, tarif avec cache et tarif Batch de Carbon
- Lien :
ai.google.dev/gemini-api/docs/pricing -
Description : prix de lancement et ajustement tarifaire à partir du 1er décembre
-
Documentation de l’API Claude Fable 5.2 : présentation officielle du modèle par Anthropic
- Lien :
platform.claude.com/docs/en/models/fable-5-2/overview - Description : contexte, sortie maximale, prix par token et Fast Mode
Auteur : l’équipe technique d’APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI. Pour plus de ressources d’intégration, rendez-vous sur le centre de documentation docs.apiyi.com