Note de l’auteur : à partir des informations officielles, cet article analyse l’index de recherche juridique de 230 millions d’URL d’Astra for Law, ses résultats aux tests et sa tarification API, afin de comprendre d’où viennent ses compétences spécialisées.
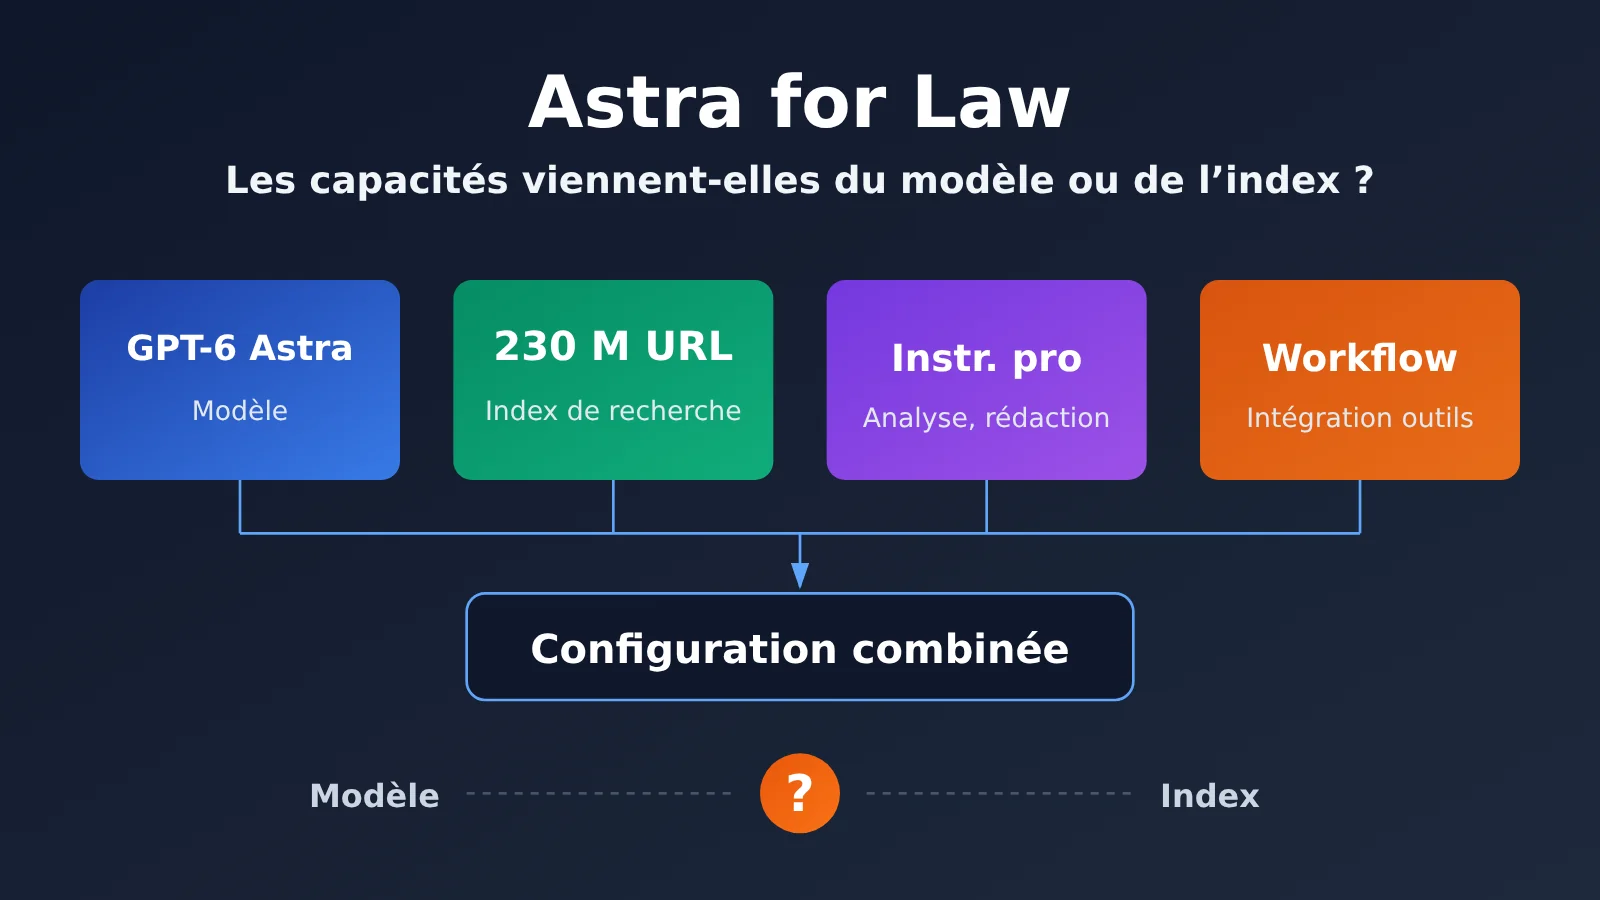
La page officielle des tarifs API d’OpenAI présente désormais une configuration juridique, gpt-6-astra-law, repérée par plusieurs médias technologiques le 31 octobre 2026. Un autre chiffre a également attiré leur attention : l’index de recherche juridique d’Astra for Law contient plus de 230 millions d’URL. Une question centrale se pose : ses compétences spécialisées viennent-elles du modèle ou de l’index ?
Ce n’est pas une rumeur : la description du produit, la taille de l’index et les prix sont vérifiables sur les pages officielles d’OpenAI. Mais les données publiées montrent seulement que la configuration complète surpasse la configuration généraliste. Elles ne permettent pas encore de déterminer quelle part de l’amélioration revient au modèle, à l’index ou aux instructions.
L’essentiel : en 3 minutes, découvrez ce qui compose réellement Astra for Law, ce que signifient les chiffres clés et ce que les développeurs peuvent faire dès aujourd’hui.
Astra for Law : l’essentiel sur les 230 millions d’URL
Au 2 novembre 2026, voici ce que l’on sait publiquement. Le point le plus facile à mal interpréter concerne l’API : ses tarifs sont publiés, mais cela ne signifie pas que tous les développeurs peuvent l’utiliser.
| Élément | Détails |
|---|---|
| Date de lancement | 17 septembre 2026 |
| Éditeur | OpenAI |
| Positionnement | Plateforme d’IA professionnelle destinée aux cabinets d’avocats et aux entreprises de technologie juridique |
| Composants | GPT-6 Astra, index de recherche juridique, instructions d’analyse et de rédaction juridiques, intégration d’outils et de workflows |
| Taille de l’index | Plus de 230 millions d’URL, avec de nouvelles sources ajoutées chaque jour |
| Accès | Initialement réservé aux cabinets d’avocats américains admissibles, via Trusted Access |
| Statut de l’API | OpenAI indique toujours qu’elle sera accessible à l’avenir, sans avoir annoncé de date officielle |
Que contient l’index de recherche juridique de 230 millions d’URL d’Astra for Law ?
Cet index couvre la jurisprudence américaine, les lois, les règlements administratifs, les règles de procédure des tribunaux et les décisions administratives. OpenAI s’est également associé à l’organisme à but non lucratif Free Law Project pour intégrer les données de jurisprudence américaine de CourtListener à l’environnement de recherche.
Une URL peut correspondre à une page, un document, un dossier ou une autre ressource juridique : « 230 millions d’URL » ne signifie donc pas « 230 millions de décisions de justice ». Les chiffres ci-dessous ne mesurent pas non plus la même chose : on ne peut ni les soustraire les uns des autres ni s’en servir pour déduire le nombre d’autres types de documents.
| Chiffre | Source | Signification exacte | Ce que cela ne signifie pas |
|---|---|---|---|
| Plus de 230 millions d’URL | OpenAI | Taille de l’index complet de recherche juridique | 230 millions de décisions de justice distinctes |
| Plus de 9 millions | Free Law Project | Nombre de décisions de justice répertoriées par CourtListener | Contenu complet de l’index d’OpenAI |
| Plus de 2 000 tribunaux | Free Law Project | Étendue des sources de données de CourtListener | Couverture des tribunaux du monde entier |
| Plus de 99,9 % | Free Law Project | Taux de couverture des décisions américaines publiées faisant jurisprudence | Couverture complète de tous les documents juridiques |
La couverture a aussi ses limites. L’index se concentre actuellement sur les documents juridiques américains. Aucun document officiel fiable ne démontre à ce jour une couverture spécialisée équivalente des lois et règlements chinois en vigueur, des décisions de justice et des interprétations judiciaires.
Les compétences d’Astra for Law viennent-elles du modèle ou de l’index de recherche juridique ?
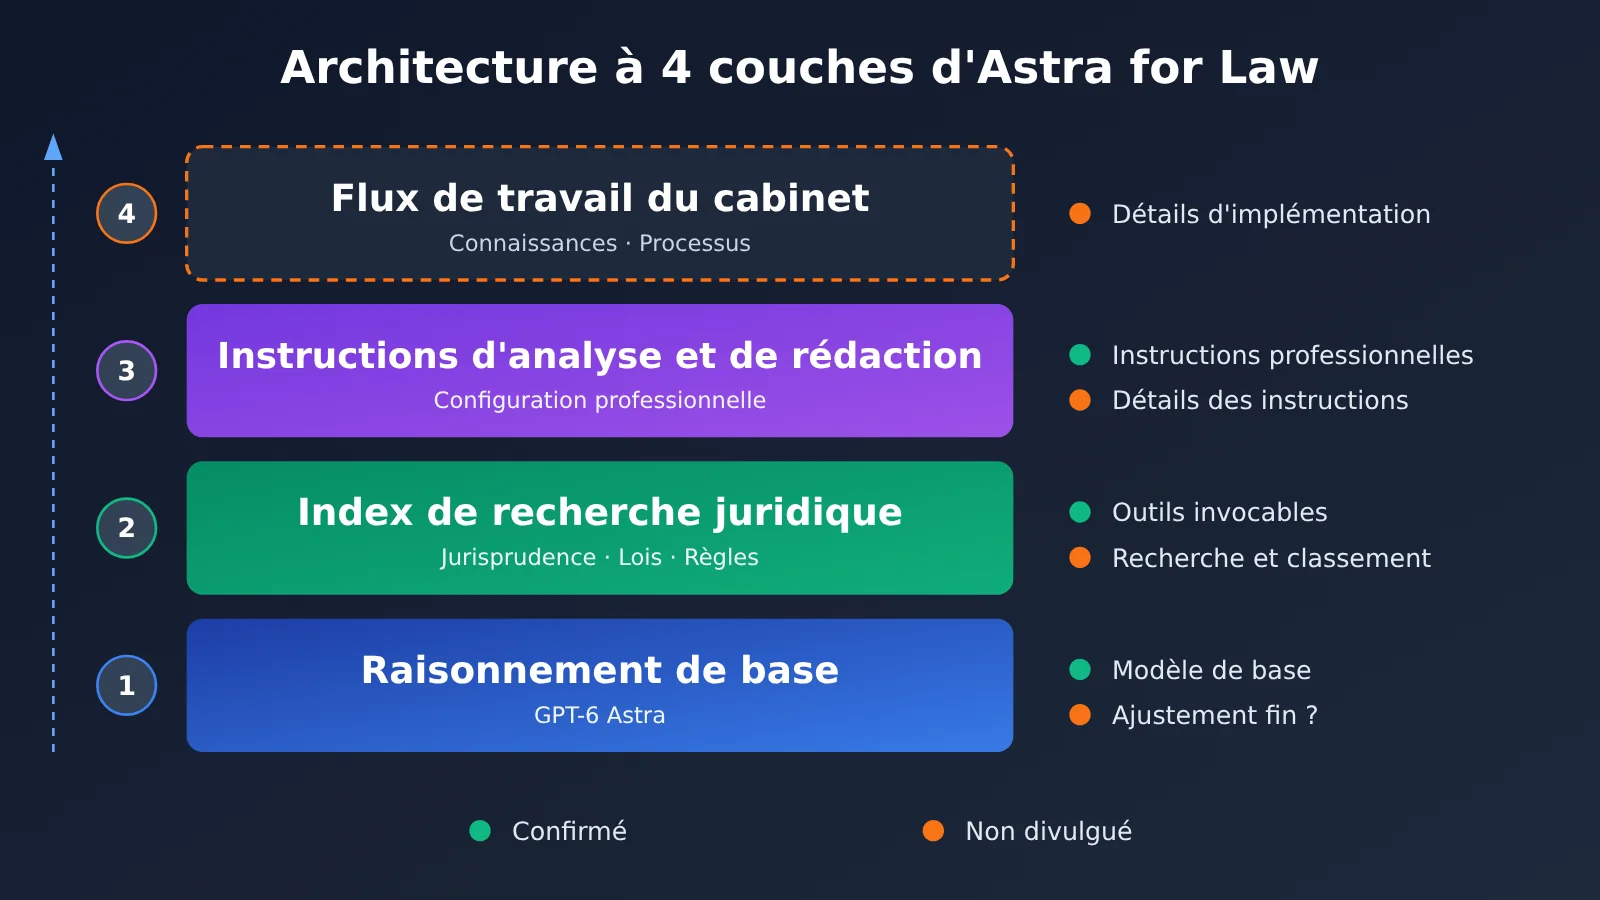
La réponse la plus juste, pour l’instant, est qu’elles viennent d’une combinaison des deux, sans que les données disponibles permettent de mesurer précisément la part de chacun. OpenAI présente Astra for Law comme une configuration spécialisée en droit, basée sur GPT-6 Astra, et désigne clairement l’index de recherche juridique comme l’un des outils qu’elle peut appeler. Les informations publiques mettent l’accent sur la configuration, la recherche, les outils et les instructions, mais ne confirment pas si le modèle a fait l’objet d’un ajustement fin juridique, d’une distillation ou d’un entraînement indépendant de ses paramètres.
Les données les plus convaincantes proviennent d’un test rapporté par OpenAI. Celui-ci compare deux configurations au niveau de raisonnement maximal, à partir de 200 questions de recherche en droit américain issues du jeu de validation privé Vals AI Legal Research Bench.
| Indicateur | Astra for Law | Astra généraliste + recherche Web | Écart |
|---|---|---|---|
| Taux de réussite au contrôle global d’exactitude | 54,0 % | 38,7 % | Hausse de 15,3 points de pourcentage, soit environ 40 % en valeur relative |
| Nombre de décisions de jurisprudence citées pour les questions correspondantes | Plus élevé | Référence | 24 % de plus |
| Passages pertinents dans les décisions de justice correctes, à niveau de raisonnement égal | Plus élevé | Référence | Jusqu’à 54 % de plus |
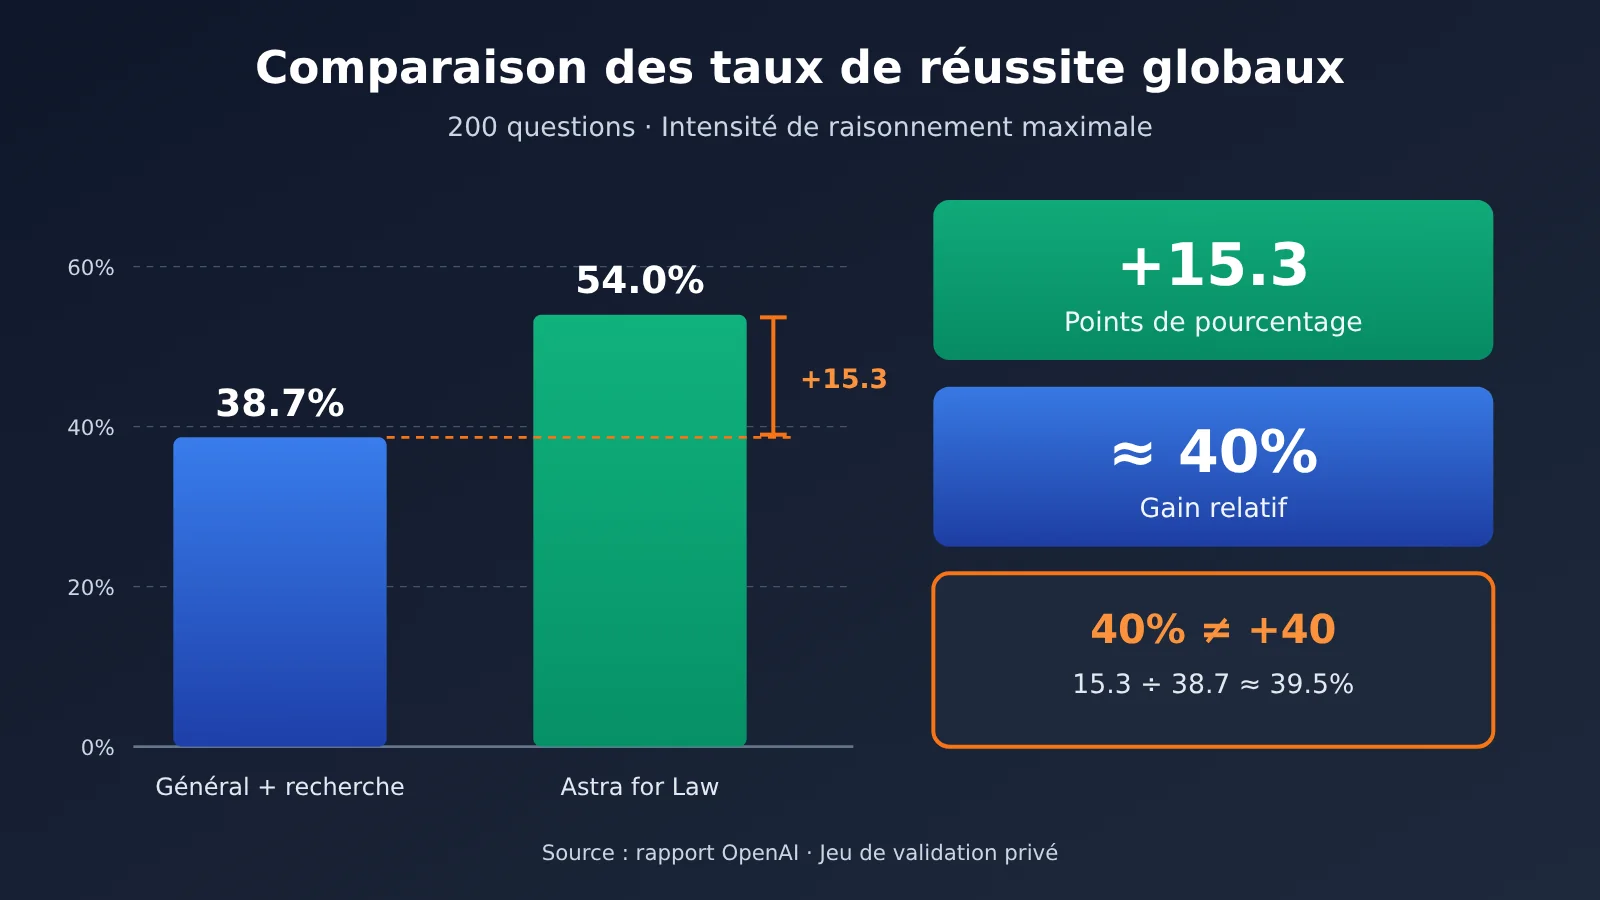
Ces résultats permettent de tirer trois conclusions :
- Le modèle de base reste le socle : la compréhension, le raisonnement et la génération après recherche documentaire reposent sur GPT-6 Astra, mais ce test ne mesure pas séparément la contribution du modèle lui-même.
- Les indicateurs de recherche progressent nettement : le nombre de décisions et les passages pertinents suggèrent que la recherche spécialisée est plus performante. Mais trouver plus de décisions ne garantit pas que l’avis juridique sera plus juste.
- On ne peut pas attribuer le résultat à un seul composant : le test compare des configurations complètes, dans lesquelles l’index, les instructions et d’autres paramètres changent en même temps. On ne peut donc pas dire que « l’index juridique, à lui seul, a amélioré les résultats de 40 % ».
Ces résultats ont aussi des limites claires. Ils ont été rapportés par OpenAI à partir d’un jeu de validation privé : cela ne signifie pas que Vals AI les a reproduits de façon indépendante, ni que les conseils juridiques, les prévisions de victoire ou les analyses de contrats atteignent un taux d’exactitude de 54 %. Les résultats des modèles généralistes dans le classement public reposent sur des configurations différentes et ne peuvent pas non plus être directement comparés à ceux de ce test.
Pourquoi la recherche sur le Web ne suffit pas à remplacer un index de recherche juridique
La recherche juridique ne consiste pas simplement à trouver des textes sémantiquement pertinents. Le niveau de la juridiction, le territoire concerné, le caractère contraignant d’un précédent et le fait qu’il ait été infirmé ou que son application ait été limitée influencent tous la valeur réelle d’une source. Un même litige contractuel peut aussi aboutir à des conclusions différentes selon le droit applicable dans chaque État.
Une recherche classique peut trouver des contenus pertinents, sans pour autant garantir que les sources juridiques citées s’appliquent réellement au cas étudié. C’est précisément le problème que l’index juridique spécialisé et les instructions professionnelles cherchent à résoudre ensemble. Cela ne signifie pas pour autant que la validité de toutes les citations a été automatiquement vérifiée.
🎯 Conseil technique : si vous créez une base de connaissances pour un domaine spécialisé, commencez par comparer trois configurations sur le même jeu de questions : « modèle seul », « modèle + recherche généraliste » et « modèle + base de connaissances spécialisée ». L’interface unifiée d’APIYI, sur apiyi.com, permet de changer de modèle sans devoir répéter le travail d’intégration.
Quel est le lien entre Astra for Law et une architecture RAG traditionnelle ?
Le processus RAG traditionnel suit ces étapes : l’utilisateur pose une question, le système interroge une base de connaissances et récupère des passages pertinents, puis le modèle génère une réponse à partir de ce contexte. L’idée derrière Astra for Law est similaire : dans les deux cas, on ne s’appuie pas uniquement sur les connaissances contenues dans les paramètres du modèle. Mais cette ressemblance reste conceptuelle : on ne peut pas en déduire que son fonctionnement interne correspond à celui d’une solution RAG classique.
| Question technique | État des informations publiques | Formulation correcte |
|---|---|---|
| Utilisation d’un index de recherche juridique | Confirmée | Fait partie des outils accessibles à Astra for Law |
| Types de contenus indexés | Confirmés | Jurisprudence, lois, règlements, règles de procédure des tribunaux, décisions administratives |
| Recherche vectorielle ou hybride | Non divulguée | Ne pas affirmer qu’une méthode précise est utilisée |
| Embedding et reranking | Non divulgués | Ne pas spéculer sur les modèles ou algorithmes utilisés |
| Stratégie de découpage et nombre de résultats récupérés | Non divulgués | Ne pas appliquer les paramètres génériques |
| Classement selon l’autorité juridique | Non divulgué | Décrire uniquement l’objectif, pas sa mise en œuvre |
Le service généraliste File Search d’OpenAI utilise bien un stockage vectoriel et combine recherche sémantique et recherche par mots-clés. Mais aucune information publique ne confirme actuellement qu’il partage la même implémentation sous-jacente que l’index juridique. On ne peut donc pas appliquer directement ses paramètres à la version juridique.
Reproduire les principes de base de la recherche juridique avec le RAG
L’exemple ci-dessous n’appelle pas gpt-6-astra-law et ne permet pas non plus de reproduire le Legal Search Index. Il illustre simplement une approche générale : rechercher des éléments pertinents, limiter les sources et demander des citations. Pour le nom du modèle, reportez-vous à la liste des modèles disponibles.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

context = "[DOC-1] 示例资料:此处放入检索到的法律片段"
response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[
        {"role": "system", "content": "仅依据给定资料回答,并标注来源编号。资料不足时明确说明。"},
        {"role": "user", "content": f"资料:{context}\n问题:该条款有哪些风险?"}
    ]
)
print(response.choices[0].message.content)
Voir l’exemple complet avec filtrage par métadonnées
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 以下均为虚构演示数据,不是真实法律资料
DOCS = [
    {
        "id": "DOC-1",
        "title": "示例判决 A",
        "jurisdiction": "示例州",
        "year": 2024,
        "text": "示例内容:合同终止条款需要事先书面通知。"
    },
    {
        "id": "DOC-2",
        "title": "示例判决 B",
        "jurisdiction": "其他州",
        "year": 2023,
        "text": "示例内容:合同终止通知可以采用电子方式。"
    }
]


def retrieve(keywords, jurisdiction, top_k=3):
    """按司法辖区过滤,再按关键词命中数和年份排序"""
    candidates = [d for d in DOCS if d["jurisdiction"] == jurisdiction]
    scored = []
    for doc in candidates:
        score = sum(keyword in doc["text"] for keyword in keywords)
        if score > 0:
            scored.append((score, doc["year"], doc))
    scored.sort(key=lambda item: (item[0], item[1]), reverse=True)
    return [item[2] for item in scored[:top_k]]


def answer(question, keywords, jurisdiction):
    docs = retrieve(keywords, jurisdiction)
    if not docs:
        return "未检索到符合司法辖区要求的资料,请人工复核。"

    context = "\n".join(
        f"[{d['id']}] {d['title']}({d['jurisdiction']},{d['year']}):{d['text']}"
        for d in docs
    )
    response = client.chat.completions.create(
        model="gpt-6.1-sol",  # 以平台实际可用模型为准
        messages=[
            {
                "role": "system",
                "content": (
                    "你是法律研究助手。仅依据给定资料回答,并标注来源编号。"
                    "指出不确定性和缺失信息。输出仅供专业人员复核,不构成法律意见。"
                )
            },
            {
                "role": "user",
                "content": f"资料:\n{context}\n\n问题:{question}"
            }
        ]
    )
    return response.choices[0].message.content


print(answer("终止合同是否需要书面通知?", ["合同", "通知"], "示例州"))
Conseil : vous pouvez obtenir un crédit d’essai gratuit sur APIYI apiyi.com pour évaluer les performances de différents modèles avec vos propres questions. Lors de l’évaluation, vérifiez aussi l’exactitude des citations et la pertinence des sources, au lieu de vous fier uniquement à la fluidité des réponses.
Ce que la tarification de l’API Astra for Law change pour les développeurs
La grille tarifaire révèle un point important : gpt-6-astra-law affiche le même prix de base par token que le modèle généraliste gpt-6-astra, sans surcoût pour le moment. Voici les tarifs du mode standard publiés sur la page officielle. Les prix promotionnels sont valables au moins jusqu’au 31 décembre 2026.
| Modèle | Entrée / million de tokens | Entrée en cache / million de tokens | Sortie / million de tokens |
|---|---|---|---|
gpt-6-astra-law |
$10 | $1 | $50 |
gpt-6-astra |
$10 | $1 | $50 |
gpt-6.1-sol |
$2 | $0.10 | $10 |
gpt-6.1-terra |
$1 | $0.05 | $5 |
Sur cette base, 100 000 tokens d’entrée ordinaires et 10 000 tokens de sortie coûtent environ $1.50. Si tous les tokens d’entrée sont admissibles à la tarification en cache, le coût descend à environ $0.60. Il s’agit seulement d’un exemple : il ne comprend pas les éventuels frais liés aux outils, à la recherche ou à des traitements particuliers. Les modalités de facturation de l’index juridique dans l’API ne sont pas non plus entièrement confirmées : il ne faut donc pas supposer que les recherches sont gratuites.
💰 À savoir sur les coûts : le prix par token de la version juridique est cinq fois supérieur à celui de Sol, mais le coût réel d’une tâche dépend aussi de la longueur des réponses, des appels aux outils et du taux de réussite. Si votre budget est serré, vous pouvez d’abord tester le processus de recherche avec les modèles existants via APIYI apiyi.com, puis évaluer l’intérêt d’une mise à niveau en fonction du coût total des tâches.
Ce que cela change pour les développeurs
- De nouvelles priorités : dans l’IA spécialisée, la concurrence ne se joue pas seulement sur le choix du modèle, mais aussi sur la qualité des données, la traçabilité des sources et la conception de règles propres au domaine.
- Une évaluation à revoir : comparez les configurations complètes sur le même jeu de questions, en intégrant parmi les critères la précision des citations et leur pertinence pour la juridiction concernée.
- Une marge à prévoir pour le lancement : la date d’ouverture, les limites de débit et les paramètres des outils ne sont pas confirmés. Mieux vaut donc ne pas en faire l’unique élément dont dépend le lancement d’un produit.
Ce que cela change pour l’IA juridique
- La concurrence s’intensifie : Anthropic, Google, Thomson Reuters, Harvey et Legora développent tous des produits ou des fonctionnalités d’IA juridique.
- Concurrence et collaboration coexistent : Harvey et Legora peuvent être des concurrents, mais OpenAI les cite aussi parmi ses futurs clients API.
- Les connaissances des cabinets restent précieuses : l’analyseur de contrats de Sullivan & Cromwell utilise des guides de négociation internes et des contrats antérieurs comme références. Cela montre qu’un index juridique public ne remplace pas les connaissances propres à une organisation. Les collaborations avec Ropes & Gray et Cooley présentent des caractéristiques similaires, mais elles ne peuvent pas toutes être considérées comme des tests en production de la version finale de l’API.
Questions fréquentes (FAQ)
Q1 : Astra for Law est-il un modèle juridique entraîné de manière indépendante ?
Rien ne permet actuellement de l’affirmer. Officiellement, il s’agit d’une configuration spécialisée en droit basée sur GPT-6 Astra, qui comprend un index juridique, des instructions spécialisées et des outils. Aucun élément public ne confirme un éventuel ajustement fin ou un entraînement supplémentaire des paramètres sur des données juridiques.
Q2 : Le chiffre de 54,0 % représente-t-il la précision des conseils juridiques ?
Non. Il s’agit du taux global de réussite aux contrôles d’exactitude dans un test précis de recherche juridique. Ce chiffre ne s’applique pas à toutes les situations juridiques et ne représente ni un taux de succès devant les tribunaux ni une précision de révision des contrats. Les réponses du produit doivent toujours être vérifiées par un avocat.
Q3 : Peut-on dès maintenant appeler gpt-6-astra-law ?
Rien ne permet de conclure que tous les développeurs y ont déjà accès. Le centre d’aide officiel indique toujours que le produit est initialement destiné aux cabinets d’avocats américains admissibles et que l’API sera ouverte ultérieurement. La publication de l’identifiant du modèle et des tarifs ne signifie pas que toutes les clés API y donnent accès.
Q4 : Les 230 millions d’URL conviennent-elles aux usages juridiques en Chine ?
Il est impossible de le confirmer pour l’instant. Cet index est clairement centré sur les sources juridiques américaines, et aucune source officielle fiable ne démontre qu’il couvre le droit chinois au même niveau. Pour les usages en Chine, il faut intégrer des sources de données locales conformes et réaliser des tests distincts.
Q5 : Comment évaluer une solution RAG juridique similaire à ce stade ?
Vous pouvez procéder en trois étapes :
1. Inscrivez-vous sur APIYI apiyi.com pour obtenir une clé API et un crédit de test gratuit.
2. Utilisez l’exemple de cet article pour intégrer vos propres documents juridiques conformes.
3. Créez un jeu de questions avec des réponses de référence pour comparer différents modèles et solutions de recherche documentaire.
Q6 : Quelles sont les limites actuelles d’Astra for Law ?
Les principales limites sont l’accès restreint, l’absence de détails publics sur l’API et le manque de tests indépendants à grande échelle. Les données sur la latence, le débit, le taux d’erreur réel et le coût par dossier restent également insuffisantes. Les contrôles de confidentialité n’éliminent pas non plus les hallucinations ni les citations erronées : les conclusions finales doivent toujours être vérifiées par un humain. Pour commencer à comparer les performances de modèles généralistes, vous pouvez effectuer des tests à petite échelle via APIYI apiyi.com.
Astra for Law : les points clés
- Nature du produit : Astra for Law est une configuration de GPT-6 Astra adaptée aux professionnels du droit. Il n’est pas confirmé qu’il s’agisse d’un modèle indépendant.
- Taille de l’index : les 230 millions correspondent à des URL, pas à des décisions de justice. L’index couvre principalement les sources juridiques américaines.
- Origine des capacités : les performances spécialisées viennent de la combinaison du modèle, de l’index, des instructions et du flux de travail. Les données disponibles ne permettent pas de mesurer précisément la contribution de chaque élément.
- Résultats des tests : les scores de 54,0 % contre 38,7 % proviennent du rapport officiel, soit une amélioration relative d’environ 40 %.
- Tarification : la version juridique et Astra généraliste ont les mêmes tarifs unitaires de base, mais les frais liés aux outils de recherche ne sont pas encore entièrement confirmés.
- Disponibilité de l’API : les tarifs sont publics, mais la date d’ouverture et les conditions d’accès pour les développeurs ne sont pas encore confirmées.
- Mise en pratique : vous pouvez commencer par tester des modèles généralistes via APIYI apiyi.com, afin de valider votre propre base de connaissances et votre processus de recherche.
Conclusion : que retenir des 230 millions d’URL d’Astra for Law ?
Pour revenir à la question de départ, on ne peut pas attribuer les capacités spécialisées d’Astra for Law au seul modèle ou au seul index. Le modèle assure la compréhension, le raisonnement et la génération, tandis que l’index de recherche juridique fournit des sources vérifiables. Les instructions spécialisées encadrent l’analyse et la rédaction, et les connaissances du cabinet permettent d’intégrer ces capacités aux flux de travail concrets.
Les tests officiels montrent que la configuration complète est plus performante sur certaines tâches de recherche juridique, sans préciser la contribution de chaque composant. Pour les développeurs, l’approche la plus pratique consiste à mettre d’abord en place leurs propres données et systèmes de recherche et d’évaluation, tout en suivant les annonces officielles sur l’ouverture de l’API.
Si vous envisagez de créer une application fondée sur une base de connaissances spécialisée, vous pouvez comparer plusieurs modèles via l’interface unifiée d’APIYI apiyi.com et vérifier d’abord la faisabilité de votre solution à moindre coût.
📚 Ressources
- OpenAI : lancement d’Astra for Law : positionnement du produit, taille de l’index, résultats des tests et exemples de collaboration
- Lien :
openai.com/index/astra-for-law -
À retenir : principale source des informations techniques et des données de test officielles présentées dans cet article
-
Page des tarifs de l’API OpenAI : identifiant du modèle pour la configuration juridique et prix des tokens
- Lien :
developers.openai.com/api/docs/pricing -
À retenir : permet de vérifier les tarifs et la durée des promotions ; consultez-la à nouveau avant toute invocation
-
Centre d’aide OpenAI : Astra for Law : conditions d’accès et disponibilité de l’API
- Lien :
help.openai.com/en/articles/20001528-astra-for-law -
À retenir : c’est la première ressource à consulter pour savoir si le service est actuellement accessible
-
Free Law Project : couverture des données de CourtListener : sources et couverture des données de jurisprudence américaine
- Lien :
wiki.free.law/c/courtlistener/help/data-coverage/case-law -
À retenir : aide à comprendre ce que recouvre précisément le taux de couverture de 99,9 %
-
Vals AI Legal Research Bench : méthodologie de test en recherche juridique et classement public
- Lien :
www.vals.ai/benchmarks/legal_research -
À retenir : utile pour définir les critères d’évaluation d’une IA juridique
-
Documentation technique OpenAI sur File Search : fonctionnement de l’outil de recherche documentaire généraliste
- Lien :
developers.openai.com/api/docs/guides/tools-file-search -
À retenir : peut servir de référence technique pour le RAG, sans pour autant décrire le fonctionnement interne de l’index juridique
-
Reuters : article sur le lancement de l’activité juridique d’OpenAI : contexte concurrentiel du marché de l’IA juridique
- Lien :
www.reuters.com/legal/litigation/openai-launches-legal-focused-ai-platform-escalating-race-law-firm-users-2026-09-17 - À retenir : aide à comprendre le paysage concurrentiel du secteur
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI. Pour plus de ressources, consultez le centre de documentation sur docs.apiyi.com