Un ordinateur portable s’allume. À l’écran, ni Windows ni une distribution Linux, mais un système conçu par une IA à partir d’un dossier vide. Le 9 novembre 2026, à l’occasion de la sortie de Claude Fable 5.2, Anthropic a révélé cette expérience interne : Fable 5.2 a coordonné plus de 1 000 sous-agents, qui ont travaillé sans interruption pendant 8 jours pour créer un prototype de système d’exploitation capable de démarrer sur un véritable ordinateur portable.
L’essentiel : à travers cette expérience sur un système d’exploitation, cet article explique où se situe la véritable avancée de Claude Fable 5.2, comment interpréter ces 1 000 agents IA et à quel point le prototype est encore loin d’un produit abouti. Enfin, du point de vue des développeurs, il examine les exigences que les flux de travail des agents sur de longues durées imposent aux infrastructures API.
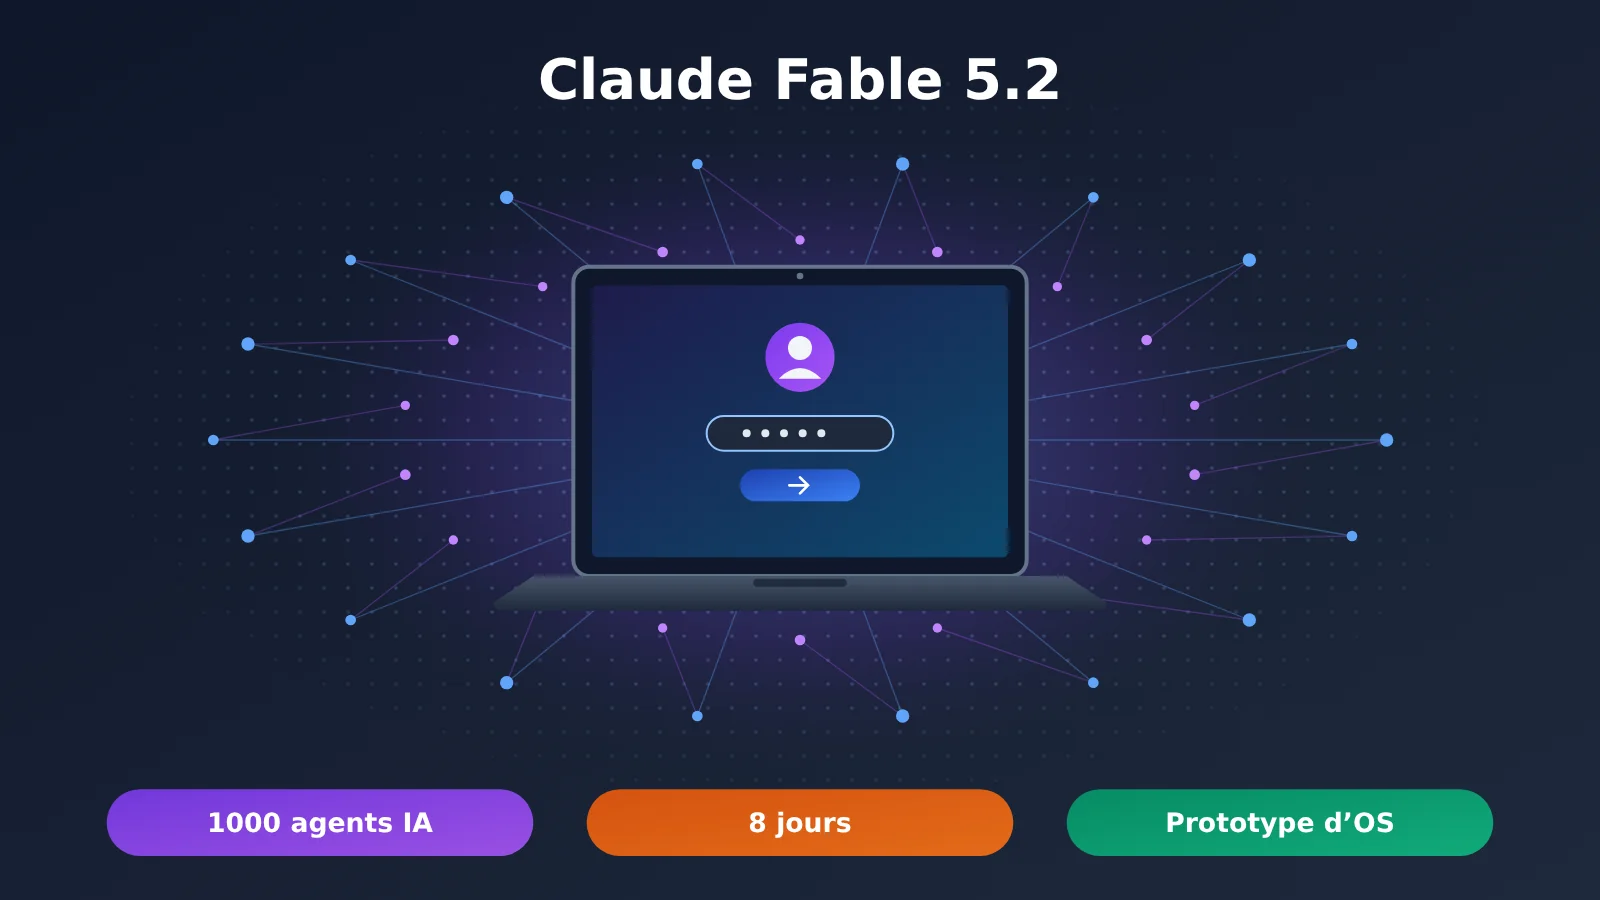
Informations clés sur l’expérience de création d’un système d’exploitation avec Claude Fable 5.2
Commençons par les faits officiellement communiqués. Le tableau ci-dessous ne reprend que les éléments confirmés dans l’annonce d’Anthropic.
| Élément | Détails |
|---|---|
| Date de publication | 9 novembre 2026, à l’occasion de la sortie de Claude Fable 5.2 |
| Équipe à l’origine du projet | Anthropic (expérience d’ingénierie interne) |
| Point de départ | Un ingénieur a donné la consigne suivante : concevoir et réaliser un prototype de système d’exploitation en partant d’un dossier vide |
| Ampleur de l’exécution | Plus de 1 000 sous-agents ont travaillé sans interruption pendant 8 jours |
| Principales activités | Écriture de code, test des composants, revue de code et correction des problèmes |
| Fonctionnalités finales | Noyau, pilotes de disque, de clavier et de réseau, stockage permanent des fichiers, système de fenêtres, écran de connexion, programme d’installation et fonctionnalités Claude intégrées |
| Validation clé | Le système a pu démarrer sur un véritable ordinateur portable |
| Informations non publiées | Code source et processus de compilation, documentation de l’architecture, nombre de lignes de code, architecture de communication entre les agents, consommation de tokens, coût de l’expérience, tests de compatibilité avec différents matériels et audit de sécurité indépendant |
Quels modules comprend le système d’exploitation créé par 1 000 agents IA ?
Voici le rôle de quelques modules clés. Le noyau est le logiciel central qui gère le matériel et les ressources du système : il planifie les processus, alloue la mémoire et traite les interruptions. Les pilotes permettent au système d’exploitation de communiquer avec le matériel, comme les disques, les claviers et les cartes réseau. Sans pilotes, le noyau ne peut pas « voir » les périphériques.
Le stockage permanent des fichiers signifie que les données restent disponibles après un redémarrage. Le système doit donc disposer d’un véritable système de fichiers, et non se contenter d’une démonstration exécutée en mémoire.
Le système de fenêtres, l’écran de connexion et le programme d’installation sont, eux, des éléments visibles par l’utilisateur. La présence d’un programme d’installation mérite d’être soulignée : elle indique que le système a au moins parcouru tout le processus, de l’écriture sur le disque au démarrage depuis ce même disque.
C’est en réunissant tous ces modules qu’on comprend pourquoi le fait de « pouvoir démarrer sur un ordinateur portable » est un résultat important. Plusieurs sous-systèmes doivent fonctionner ensemble, et pas seulement produire chacun quelques lignes de code qui semblent correctes.
Cela nous amène à la question centrale de cet article : comment plus de 1 000 agents ont-ils pu collaborer pour mener à bien un projet d’ingénierie complet ?
La percée de Claude Fable 5.2 : l’IA commence à orchestrer l’ingénierie
Fable 5.2 a nettement progressé sur les benchmarks de programmation. Anthropic a publié un score de 49,1 % à FrontierCode 2.0, contre 32,4 % pour la génération précédente, Fable 5.1. À FrontierSWE v2, le score atteint 69,9 %, contre 56,3 % auparavant.
Ces résultats portent toutefois sur des benchmarks généralistes de programmation, et non sur des tests réalisés dans le cadre de l’expérience sur le système d’exploitation. Ce qui mérite le plus d’attention dans cette expérience, ce n’est pas tant la qualité du code produit que l’évolution de l’organisation du travail d’ingénierie.
La différence entre un assistant de programmation IA traditionnel et un projet d’ingénierie mené par des agents sur le long terme
Un assistant de programmation IA traditionnel fonctionne sur le mode « question-réponse » : l’utilisateur formule une demande, l’IA écrit un morceau de code, puis l’utilisateur le vérifie et demande des modifications. Le cycle recommence. Dans ce modèle, la décomposition des tâches, le suivi de l’avancement et l’intégration d’ensemble restent à la charge d’une personne. L’IA n’est qu’un exécutant très efficace.
Dans un projet d’ingénierie mené par des agents sur le long terme, davantage de responsabilités sont confiées au modèle. Le tableau ci-dessous compare les deux approches :
| Dimension | Assistant de programmation IA traditionnel | Projet d’ingénierie mené par des agents sur le long terme |
|---|---|---|
| Granularité des tâches | Une fonction, un fichier ou une fonctionnalité | Un projet complet, à découper soi-même en sous-tâches |
| Durée d’exécution | Une conversation, de quelques minutes à quelques heures | Plusieurs heures à plusieurs jours sans interruption |
| Mode d’exécution | Un seul fil d’exécution, en attente des retours humains | Plusieurs sous-agents travaillent en parallèle sur différents modules |
| Assurance qualité | Repose principalement sur une vérification humaine | Tests automatiques, revues croisées et planification des corrections en cas de problème |
| Travail d’intégration | Réalisé par une personne | Le coordinateur rassemble les résultats et vérifie la compatibilité des modules |
| Rôle humain | Donner des instructions étape par étape | Fixer les objectifs, superviser le déroulement et valider le résultat final |
Pour un projet comme un système d’exploitation, c’est la colonne de droite qui représente le véritable défi. Le noyau, les pilotes et le système de fichiers s’appuient sur de nombreuses conventions d’interface. Une modification dans un module peut faire échouer les tests d’un autre.
Réussir, pendant huit jours, à détecter les problèmes, à planifier les corrections et à faire avancer les éléments inachevés témoigne d’une capacité de « gestion de projet », et pas seulement d’une capacité à « écrire du code ».
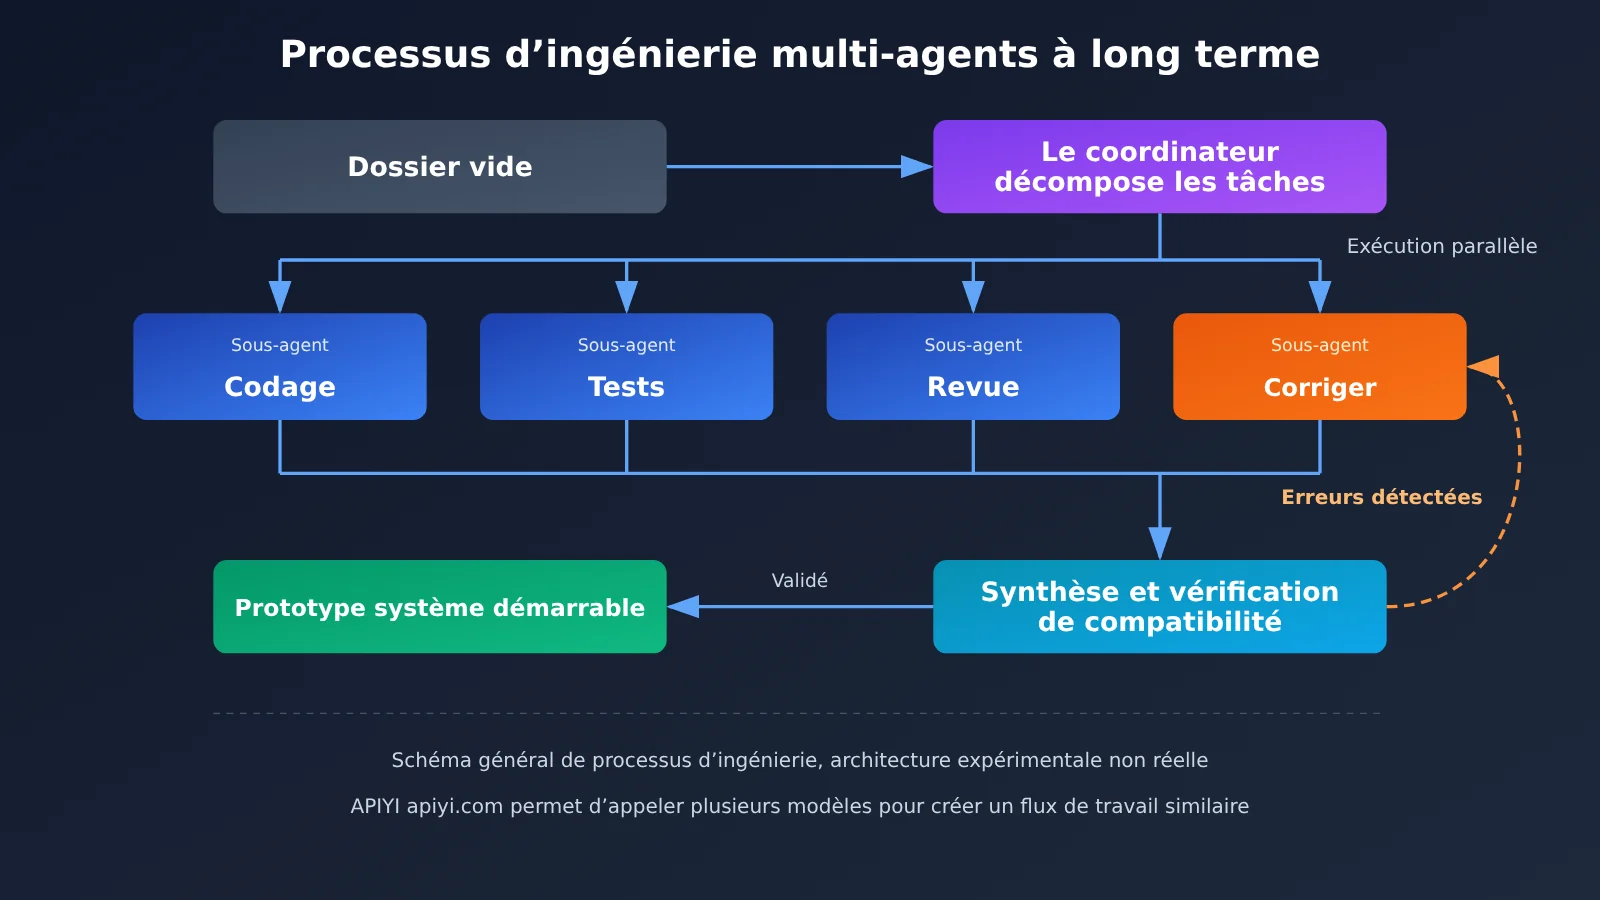
Il faut préciser que le schéma ci-dessus présente une analyse générale des processus suivis dans les grands projets d’ingénierie. Anthropic n’a pas rendu publics la répartition précise des tâches dans l’expérience sur le système d’exploitation, le Harness, le protocole de communication ni le langage de programmation utilisés.
Une autre expérience, menée à la même période sur le dernier théorème de Fermat, a révélé des détails d’architecture tels que « 1 Lead + 999 Helper ». Mais il s’agissait d’une expérience distincte : on ne peut pas transposer directement cette architecture au projet de système d’exploitation.
Le rôle de « coordinateur » vu par les premiers testeurs en entreprise
Lors du lancement, Anthropic a publié les retours de plusieurs partenaires de test en phase précoce. Il s’agit de témoignages concrets d’ingénieurs en entreprise, et non d’essais à l’aveugle indépendants. Ils pointent néanmoins tous vers la même tendance : le modèle commence à prendre en charge des tâches de planification et de coordination.
- Vercel : Joe Haddad (membre de l’équipe technique) explique qu’un projet qui aurait pris plusieurs semaines avec d’autres modèles a été achevé en quelques jours avec Fable 5.2, puis validé par l’équipe. Les relecteurs de code ont aussi eu moins de modifications à demander.
- Shopify : Tom Pritchard (ingénieur principal) estime que le modèle peut partir d’une idée assez générale, élaborer une solution au fil de quelques échanges, puis mener la suite du travail de façon autonome. L’expérience se rapproche de celle d’une collaboration avec un autre ingénieur principal.
- Datadog : Matt Lee (ingénieur principal senior) le compare à un commandant d’incident (Incident Commander). Face à un système qu’il ne connaît pas, le modèle fait appel à des modèles plus rapides pour recueillir des informations, puis coordonne différentes tâches, ce qui allège la charge de coordination des opérateurs humains.
- Uber : Andrew Mager (ingénieur principal, systèmes agentiques) a décrit un audit de sécurité mené en continu pendant 10—12 heures. Le modèle a délégué le travail à environ 170 agents de revue et a finalement livré un rapport d’audit, des pull requests de correction et une recommandation stratégique. Il souligne en particulier que le modèle poursuit son travail jusqu’à ce que la tâche soit réellement terminée, au lieu de s’arrêter après avoir obtenu un résultat intermédiaire qui semble plausible.
Le cas d’Uber est celui qui ressemble le plus, dans sa forme, à l’expérience menée sur le système d’exploitation : dans les deux cas, un modèle délègue le travail à de nombreux agents secondaires pour accomplir une tâche de longue durée. Il s’agit toutefois de projets totalement indépendants.
Claude Fable 5.2 est déjà utilisé en production
Si l’on ne disposait que de l’expérience sur le système d’exploitation, on pourrait croire à une démonstration soigneusement préparée. Mais les deux séries de données internes publiées en parallèle par Anthropic montrent que ces capacités d’ingénierie sont déjà mises à profit dans le développement logiciel au quotidien.
La première concerne la part de code produite par le modèle. Anthropic indique que Claude a écrit plus de 90 % des modifications finalement fusionnées dans son dépôt de code principal, avec l’accompagnement de personnes. Ce chiffre correspond à la proportion de modifications fusionnées écrites par Claude. Il ne signifie ni que 90 % du travail de développement a été effectué sans intervention humaine, ni que tout ce code a été produit par Fable 5.2.
La deuxième concerne la migration d’un service en production. Une équipe d’agents utilisant une première version de Fable 5.2 a migré un service de production essentiel de Python vers Rust. Cette migration a amélioré l’efficacité et la fiabilité du service, et multiplié sa vitesse de démarrage par environ 26. La migration d’un langage est un travail typique de longue haleine, qui exige de nombreuses vérifications. Pour garantir un comportement identique, les tests et les corrections comptent souvent davantage que la traduction du code elle-même.
Ces exemples ne sont pas tous de même nature. Le tableau ci-dessous les distingue :
| Cas | Nature | Source des éléments | Ce que cela montre | Ce que cela ne montre pas |
|---|---|---|---|---|
| Prototype de système d’exploitation | Expérience interne d’Anthropic | Annonce et démonstration officielles | Le modèle peut organiser un projet d’ingénierie de longue haleine, avec de nombreux modules | Qu’il a atteint le niveau d’un système d’exploitation commercial ou que des tiers ont reproduit le résultat |
| 90 % du code fusionné écrit par Claude | Données internes de production | Annonce officielle | L’IA participe déjà activement à la production quotidienne de code | Que le code n’a pas besoin d’être vérifié par des personnes |
| Migration de Python vers Rust | Cas d’usage interne en production | Annonce officielle | L’ingénierie par agents peut servir à optimiser des infrastructures réelles | Que les mêmes méthodes ont été utilisées pour l’expérience sur le système d’exploitation |
| Retours de Vercel, Shopify, Datadog et Uber | Expérience de testeurs précoces | Témoignages cités dans l’annonce officielle | Des ingénieurs en entreprise constatent les capacités de coordination du modèle dans leur travail concret | Qu’il peut remplacer des benchmarks indépendants |
Pris ensemble, ces exemples témoignent d’une « extension des capacités d’exécution en ingénierie ». Cela ne signifie pas que tous les projets d’ingénierie peuvent se passer de supervision.
Que signifie vraiment « 1 000 agents » ?
« 1 000 agents » est le chiffre le plus frappant de cette expérience, mais aussi celui qui prête le plus facilement à confusion.
Le nombre total d’agents ne correspond pas au nombre d’agents exécutés simultanément
Tout d’abord, Anthropic indique que « plus de 1 000 sous-agents ont participé », sans préciser s’ils ont fonctionné simultanément. Sur une période de huit jours, il est tout à fait possible que les sous-agents aient été créés par vagues, qu’ils aient terminé leur tâche puis se soient arrêtés, avant que de nouveaux agents prennent le relais.
Ensuite, 1 000 agents ne signifie pas 1 000 ingénieurs aux capacités identiques et totalement indépendants. L’efficacité réelle dépend de plusieurs facteurs : la possibilité de paralléliser les tâches, les coûts de coordination, l’état partagé, les conflits de code, la couverture des tests et le coût des appels.
Prenons un exemple simple : tant que la gestion de la mémoire du noyau n’est pas définie, il est difficile de faire avancer réellement le système de fichiers et les pilotes. Ce type de dépendance montre qu’un grand projet ne peut pas être découpé à l’infini en tâches parallèles.
Deux modes d’orchestration dans Managed Agents
La documentation de Managed Agents d’Anthropic, destinée aux développeurs, offre un aperçu des systèmes multi-agents conçus pour être utilisés en production. Elle présente deux modes d’orchestration.
Mode Subagent : l’agent principal peut créer des sous-agents, chacun disposant de son propre fil de session et de son propre historique de contexte. L’agent principal peut leur envoyer des tâches supplémentaires. Une session peut compter jusqu’à 25 fils enfants directs simultanés, et la délégation directe ne fonctionne que sur un seul niveau.
Mode Dynamic Workflow : conçu pour les tâches de plus grande ampleur. L’agent principal commence par rédiger un programme de workflow, qui crée plusieurs agents exécutés en parallèle, rassemble les résultats de chaque étape, puis détermine la suite à partir des résultats de l’étape précédente. En général, le serveur réessaie une fois les agents qui échouent, dans un nouveau fil. La documentation officielle indique les limites suivantes :
| Indicateur | Limite officielle |
|---|---|
| Fils exécutés simultanément dans un workflow | 64 (plafond configurable du produit, sans garantie de l’atteindre) |
| Agents lancés au cours du cycle de vie d’un workflow | 1 000 |
| Durée de vie par défaut d’un workflow | 24 heures |
| Workflows ouverts simultanément par session, par défaut | 10 |
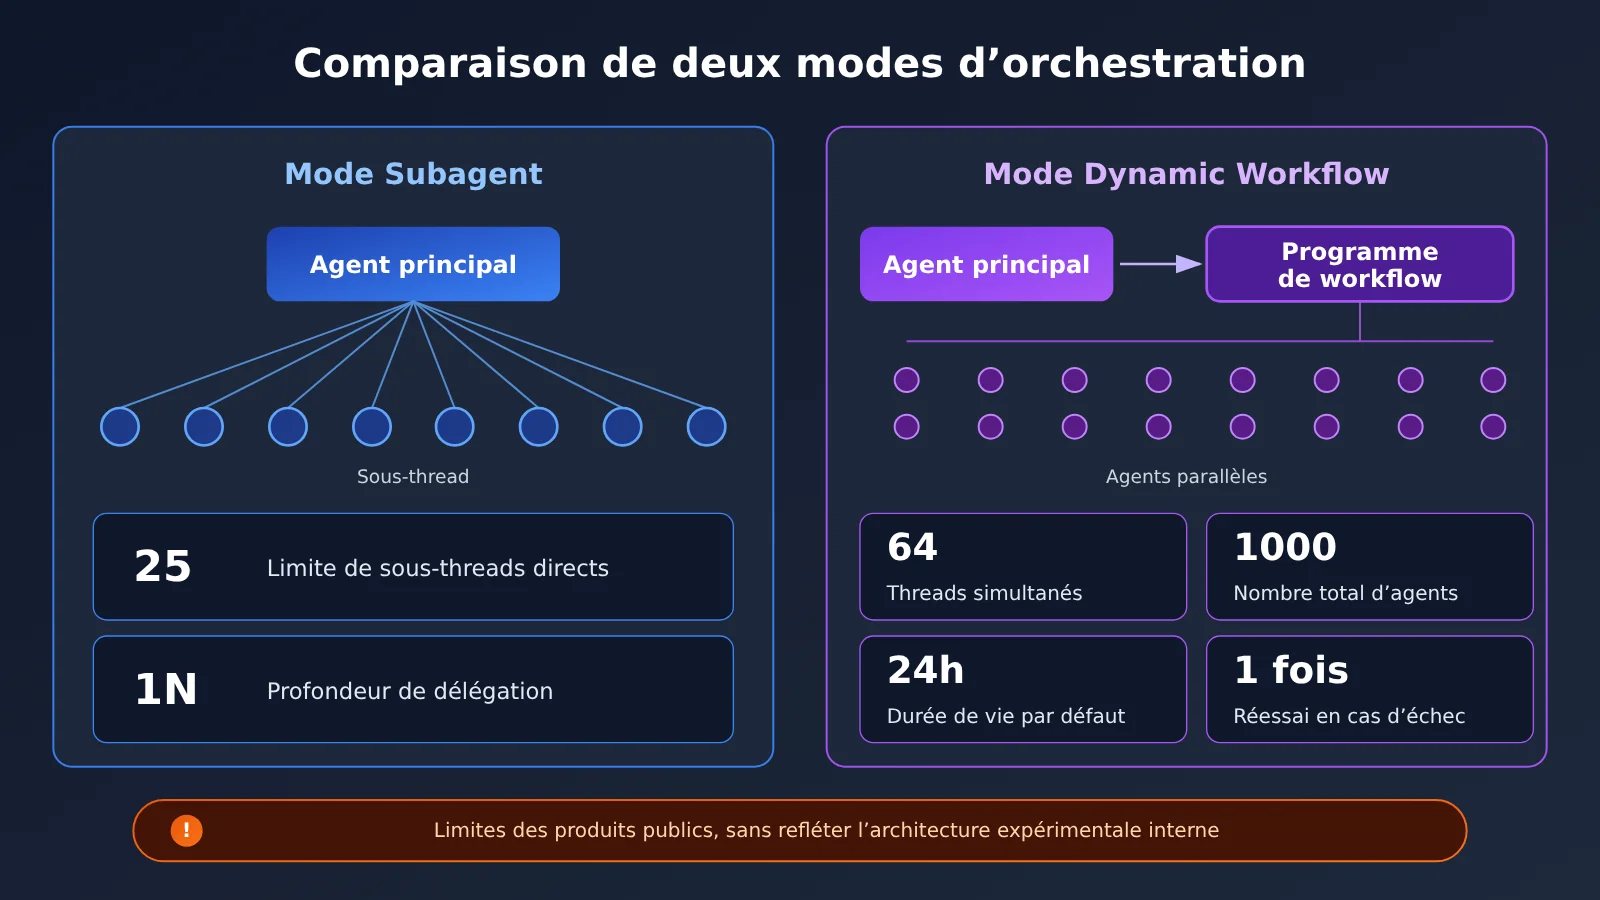
Il faut le souligner : l’expérience sur le système d’exploitation est un projet d’ingénierie interne à Anthropic, tandis que Managed Agents est un service conçu pour être utilisé en production. On ne peut pas en conclure que l’expérience a été réalisée avec Managed Agents, ni appliquer à cette expérience la limite de 64 fils simultanés. Ces chiffres montrent toutefois une chose : l’orchestration d’un grand nombre d’agents ne repose pas uniquement sur le modèle. Elle nécessite aussi un ordonnanceur, la gestion de l’état des tâches, le contrôle de la concurrence, des mécanismes de nouvelle tentative et un système de gestion du budget. Derrière le chiffre « 1 000 », l’infrastructure joue un rôle tout aussi important que le modèle.
Les limites du prototype de système d’exploitation Claude Fable 5.2
« Démarrer » est une étape importante, mais le chemin reste long avant d’arriver à un système « prêt pour la production ». Des systèmes bien établis comme Windows, Linux et macOS s’appuient sur des décennies d’adaptation matérielle, de renforcement de la sécurité et de maintenance par leurs communautés.
| Exigence d’ingénierie | Prototype qui démarre (informations communiquées à ce jour) | Système d’exploitation commercial mature |
|---|---|---|
| Compatibilité matérielle | Démarre sur un ordinateur portable réel | Prend en charge un grand nombre de combinaisons de puces, de périphériques et de micrologiciels |
| Sécurité | Aucun audit de sécurité indépendant par un tiers n’a été signalé | Réponse continue aux vulnérabilités, cloisonnement des permissions et mécanismes de mise à jour |
| Fiabilité à long terme | Aucun test de fonctionnement prolongé n’a été communiqué | Éprouvé par un grand nombre d’utilisateurs et sur de longues périodes |
| Maintenance du système | Code source et processus de compilation non publiés | Gestion des versions, calendrier de publication et support à long terme |
| Audit du code | Nombre de lignes de code et documentation de l’architecture non publiés | Code auditable et documentation complète de l’architecture |
| Reproductibilité | Aucune reproduction indépendante par un tiers à ce jour | Processus de compilation public et reproductible |
Ce tableau ne vise pas à dénigrer l’expérience, mais à préciser ce qu’elle démontre. Elle montre qu’un modèle peut coordonner un projet logiciel composé de plusieurs modules sur une période assez longue et livrer un résultat dont les sous-systèmes sont réellement interconnectés. Elle ne prouve pas qu’un système d’exploitation écrit par une IA peut remplacer directement les produits existants.
Les ingénieurs humains restent essentiels dans ce type de projet. La définition des objectifs, les choix d’architecture, les limites de sécurité et la validation finale relèvent toujours de leur responsabilité. Anthropic le formule d’ailleurs avec prudence : Claude a écrit 90 % du code fusionné, mais « sous la direction d’humains ».
La conclusion la plus raisonnable est que l’IA a montré sa capacité à coordonner des projets logiciels complexes, sans que cela signifie qu’une équipe d’ingénierie logicielle expérimentée puisse désormais se passer d’humains.
L’impact de Claude Fable 5.2 sur les développeurs
Des appels ponctuels aux workflows d’agents de longue durée
La plupart des développeurs ne vont pas créer un système d’exploitation dans l’immédiat. Mais les méthodes de travail mises en évidence par cette expérience vont peu à peu s’intégrer aux projets du quotidien : revues de code par lots, refactorisations à l’échelle d’un dépôt, migrations de langage et audits de sécurité.
Dans ce contexte, les développeurs ne se demanderont plus seulement « cette réponse est-elle bonne ? ». Ils devront aussi se pencher sur des enjeux plus proches de l’ingénierie :
- Gestion des tâches : comment découper le travail, suivre l’état de chaque sous-tâche et reprendre là où l’on s’est arrêté après un échec.
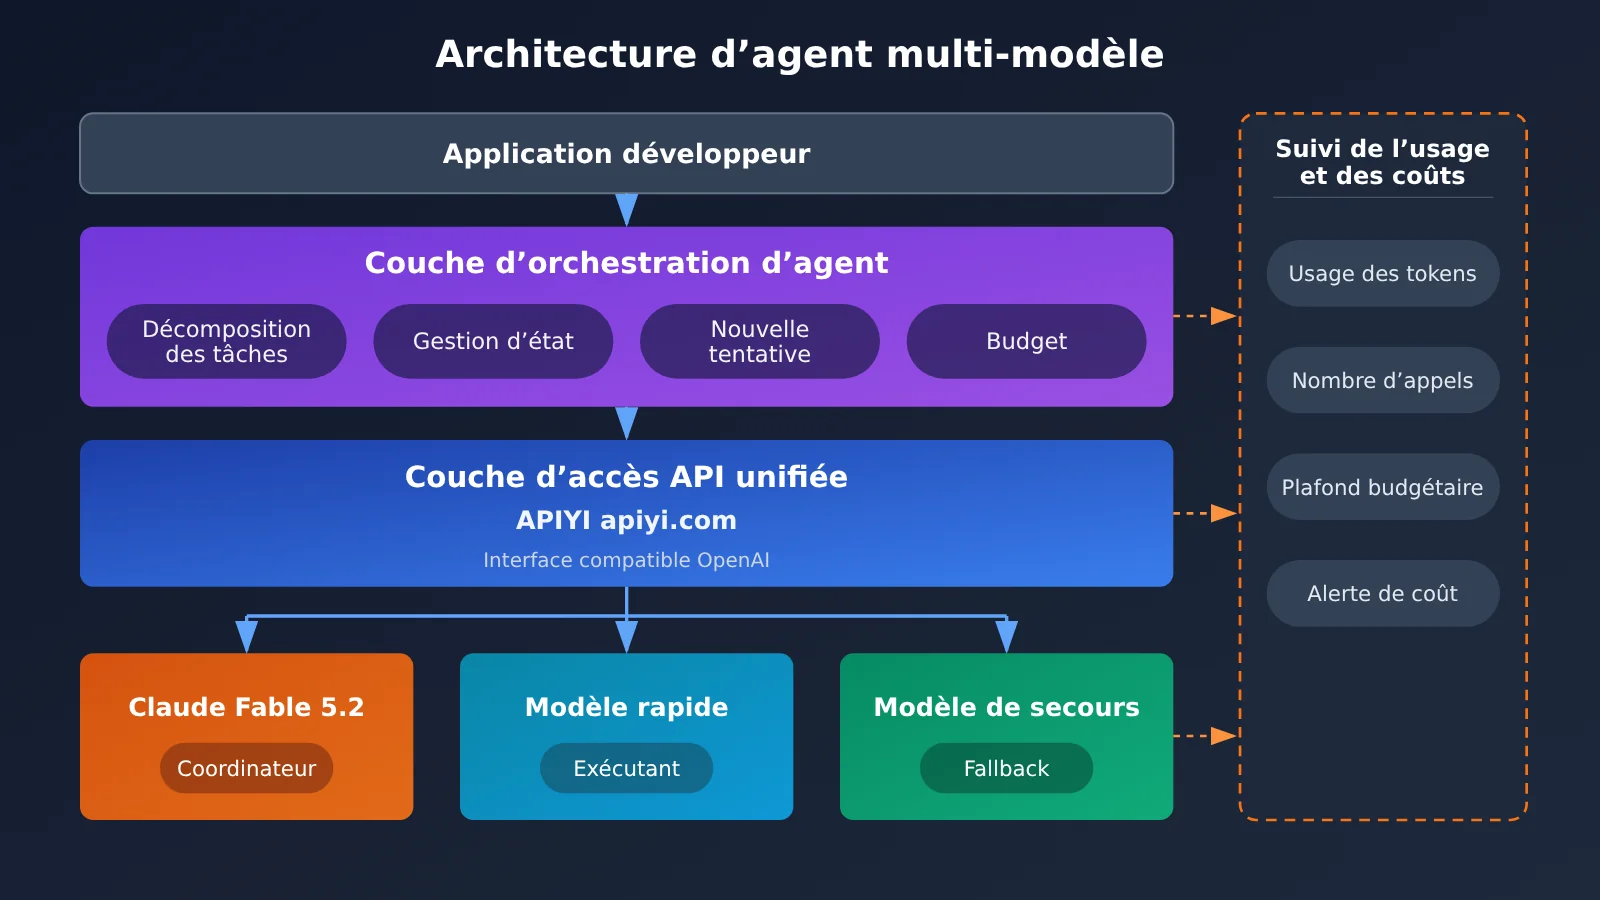
- Répartition du travail entre modèles : dans le cas de Datadog, Fable 5.2 fait appel à des « modèles plus rapides » pour recueillir des informations. Confier la coordination à un modèle puissant et l’exécution à des modèles plus rapides ou moins chers est une stratégie courante pour maîtriser les coûts.
- Fiabilité des appels : un workflow peut comporter des centaines, voire des milliers d’appels. Même un faible taux d’échec par appel peut provoquer de fréquentes interruptions une fois les échecs cumulés. Il faut donc prévoir des mécanismes de nouvelle tentative et de basculement.
- Maîtrise du budget : le tarif public de l’API de Fable 5.2 est de 8 dollars par million de jetons en entrée et de 40 dollars par million de jetons en sortie. Le mode Fast Mode coûte deux fois plus cher. Anthropic n’a pas communiqué le coût réel de l’expérience sur le système d’exploitation, mais on peut imaginer que les dépenses liées aux tâches de longue durée faisant intervenir plusieurs agents doivent être surveillées en continu.
- Suivi des tâches : il faut savoir ce que fait chaque agent, combien il consomme et où il est bloqué.
Le même jour, Vercel a annoncé la prise en charge de Fable 5.2 dans AI Gateway, avec le basculement entre fournisseurs, des modèles de secours, des statistiques d’utilisation et de coûts, ainsi que des règles de budget et de nouvelle tentative. Cela montre que l’infrastructure nécessaire aux appels de modèles dans les applications complexes reposant sur des agents est en train de se mettre en place.
Comment appeler Claude Fable 5.2 avec une interface compatible avec OpenAI
L’ID de modèle officiel de Fable 5.2 est claude-fable-5-2. Il prend en charge une fenêtre de contexte de 1M tokens et peut générer jusqu’à 128K tokens. Pour l’appeler avec une interface compatible avec OpenAI, voici la méthode la plus simple (le nom du modèle dépend de la liste affichée dans la console de la plateforme) :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée d’APIYI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "把这个 Python 模块的迁移计划拆成可并行的子任务"}]
)
print(resp.choices[0].message.content)
Voir l’exemple complet : coordinateur, exécutants en parallèle, nouvelles tentatives et contrôle du budget
Voici un exemple simplifié où un coordinateur répartit les tâches entre plusieurs exécutants qui les traitent en parallèle. Il comprend des tentatives de relance en cas d’échec et un contrôle approximatif du budget de tokens. Il illustre des principes d’ingénierie généraux et ne correspond pas à l’implémentation réelle de l’expérience sur les systèmes d’exploitation d’Anthropic.
import json
import openai
from concurrent.futures import ThreadPoolExecutor, as_completed

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée d’APIYI, avec possibilité de basculer entre plusieurs fournisseurs de modèles
)

PLANNER_MODEL = "claude-fable-5-2"   # Coordinateur : chargé de la décomposition et de la synthèse
WORKER_MODEL = "gpt-4o-mini"         # Exécutant : remplacez-le par le modèle rapide que vous utilisez réellement
TOKEN_BUDGET = 200_000               # Budget de tokens pour l’ensemble du flux de travail
MAX_WORKERS = 8                      # Limite de tâches simultanées, à ajuster selon les besoins
used_tokens = 0


def chat(model, prompt, max_tokens=2000):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,停止派发新任务")
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    used_tokens += resp.usage.total_tokens
    return resp.choices[0].message.content


def plan(goal):
    prompt = (
        f"目标:{goal}\n"
        "请拆成 3-6 个可以独立完成的子任务,"
        '只输出 JSON 数组,格式为 [{"id": 1, "task": "..."}]'
    )
    return json.loads(chat(PLANNER_MODEL, prompt))


def run_task(item, retries=1):
    for attempt in range(retries + 1):
        try:
            return item["id"], chat(WORKER_MODEL, item["task"])
        except Exception as e:
            if attempt == retries:
                return item["id"], f"失败:{e}"


def workflow(goal):
    tasks = plan(goal)
    results = {}
    with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
        futures = [pool.submit(run_task, t) for t in tasks]
        for f in as_completed(futures):
            tid, out = f.result()
            results[tid] = out
    summary_prompt = "汇总以下子任务结果,检查相互之间是否冲突:\n" + json.dumps(
        results, ensure_ascii=False
    )
    return chat(PLANNER_MODEL, summary_prompt, max_tokens=4000)


if __name__ == "__main__":
    print(workflow("为一个小型 Web 服务设计从 Python 迁移到 Rust 的方案"))
    print(f"累计消耗 Token:{used_tokens}")
🚀 Conseil pour démarrer rapidement : dans un flux de travail multi-modèles avec des agents, le coordinateur et les exécutants proviennent souvent de fournisseurs différents. Avec APIYI (apiyi.com), une seule clé API suffit pour appeler les principaux modèles de Claude, OpenAI, Gemini et d’autres. La facturation se fait à l’usage et les nouveaux utilisateurs disposent d’un crédit d’essai gratuit : pratique pour tester la logique d’orchestration et les coûts à petite échelle.
Questions fréquentes (FAQ)
Q1 : Qu’a réellement accompli l’expérience de création d’un système d’exploitation avec Claude Fable 5.2 ?
D’après les informations communiquées par Anthropic, Fable 5.2 est parti d’un dossier vide et a coordonné plus de 1 000 sous-agents qui ont travaillé en continu pendant 8 jours. Le résultat : un prototype de système d’exploitation capable de démarrer sur un véritable ordinateur portable. Il comprend un noyau, des pilotes de disque, de clavier et de réseau, un système de stockage permanent des fichiers, un environnement de fenêtres, une interface de connexion, un programme d’installation et des fonctionnalités Claude intégrées.
Q2 : Les 1 000 agents IA fonctionnaient-ils tous en même temps ?
Les informations officielles ne le précisent pas. Dire que « plus de 1 000 sous-agents ont participé » ne signifie pas que 1 000 agents ont fonctionné simultanément pendant toute l’expérience, ni qu’il s’agissait de 1 000 ingénieurs indépendants. Pour les flux de travail Managed Agents publics, la limite de concurrence d’un flux est de 64 threads, avec un maximum de 1 000 agents lancés au cours de son cycle de vie. Il s’agit toutefois d’une limite du produit, qu’on ne peut pas appliquer à l’expérience interne.
Q3 : Ce système d’exploitation créé par l’IA peut-il remplacer Windows ou Linux ?
Non. Il est officiellement présenté comme un « prototype fonctionnel ». À ce jour, il n’y a ni code source public, ni documentation sur l’architecture, ni tests de compatibilité avec différents matériels, ni audit de sécurité indépendant. Personne ne l’a non plus reproduit de façon indépendante. Cette expérience démontre la capacité de l’IA à organiser un projet d’ingénierie complexe, pas la maturité d’un produit.
Q4 : Quels sont le prix et les caractéristiques de l’API Claude Fable 5.2 ?
Le tarif public est de 8 dollars par million de jetons en entrée et de 40 dollars par million de jetons en sortie, soit 20 % de moins que le mode standard de Fable 5.1. Le Fast Mode coûte deux fois plus cher, mais peut atteindre une vitesse de génération 2,5 fois supérieure à celle du mode standard. La fenêtre de contexte est de 1 million de jetons et la sortie maximale, de 128 000 jetons. L’API Batch propose une réduction de 50 % sur les entrées comme sur les sorties. Ces tarifs sont les prix publics, pas le montant réellement facturé pour l’expérience de création du système d’exploitation.
Q5 : Comment les développeurs peuvent-ils rapidement utiliser Claude Fable 5.2 pour expérimenter avec des agents ?
Vous pouvez commencer par tester la logique d’orchestration sur une tâche de petite envergure :
1. Inscrivez-vous sur APIYI apiyi.com pour obtenir une clé API et un crédit d’essai gratuit.
2. Dans l’exemple de cet article, définissez `base_url` sur `https://api.apiyi.com/v1`. Le nom du modèle est indiqué dans la liste de la console.
3. Commencez par valider le cycle minimal « décomposer les tâches → exécuter en parallèle → synthétiser », puis ajoutez progressivement les relances et le contrôle du budget.
Q6 : Quels sont les principaux points de défaillance des flux de travail multi-agents de longue durée ?
Les problèmes les plus fréquents se répartissent en trois catégories. Premièrement, les coûts peuvent rapidement déraper : le nombre d’appels augmente avec le nombre d’agents, d’où la nécessité de fixer un plafond budgétaire. Deuxièmement, les échecs s’accumulent : une erreur occasionnelle lors d’un appel peut se répercuter dans une longue chaîne de traitement. Il faut donc prévoir des relances et un modèle de secours. Troisièmement, la coordination peut devenir coûteuse : si les dépendances entre les tâches sont mal définies, le travail en parallèle risque de provoquer des conflits dans le code. En passant par APIYI apiyi.com pour accéder à plusieurs modèles, vous pouvez configurer plus facilement un modèle de secours et consulter l’utilisation depuis un seul endroit.
Claude Fable 5.2 et 1 000 agents IA : points clés
- Faits de l’expérience : plus de 1 000 sous-agents, 8 jours de travail, et un prototype de système d’exploitation démarrable créé à partir d’un dossier vide.
- La véritable avancée : le modèle commence à prendre en charge la décomposition des tâches, leur exécution en parallèle, les corrections successives et l’intégration des résultats.
- Un signal pour la production : plus de 90 % du code fusionné chez Anthropic est écrit par Claude, et la migration vers Rust a accéléré le démarrage d’environ 26 fois.
- Les limites des chiffres : 1 000 agents ne signifient pas 1 000 ingénieurs indépendants travaillant en parallèle du début à la fin.
- Les limites du prototype : sans audit ni reproduction par un tiers, il reste encore un long chemin à parcourir avant d’obtenir un système d’exploitation commercial mature.
- À retenir pour les développeurs : l’orchestration, les nouvelles tentatives, la gestion du budget et la supervision sont aussi importantes que les capacités du modèle. APIYI (apiyi.com) permet de connecter plusieurs modèles depuis un point d’accès unique.
En résumé
L’information à retenir de cette histoire — 1 000 agents IA qui créent un système d’exploitation en 8 jours — ne tient pas tant aux chiffres qu’à trois constats :
- La nature des capacités évolue : Claude Fable 5.2 montre qu’un modèle peut organiser un projet d’ingénierie, et pas seulement générer du code.
- Les preuves doivent être évaluées séparément : l’expérience sur le système d’exploitation, les données internes de production et les premiers retours des entreprises sont des éléments de nature différente.
- L’humain reste le dernier maillon : le prototype peut démarrer, mais les ingénieurs restent responsables des choix d’architecture, de la sécurité et de la validation.
Pour les développeurs, l’étape suivante consiste à passer de « l’appel unique » aux « workflows de longue durée » et à anticiper la répartition du travail entre plusieurs modèles, la fiabilité des appels et la maîtrise des coûts. APIYI (apiyi.com) permet de connecter plusieurs modèles de premier plan avec une seule clé API. Vous pouvez commencer par valider le tout sur des tâches d’agent à petite échelle.
📚 Références
- Annonce officielle d’Anthropic : Claude Fable 5.2 and Mythos 5.2 (2026-11-09)
- Lien :
anthropic.com/claude-fable-and-mythos-5-2 -
Présentation : source directe sur les expériences menées sur les systèmes d’exploitation, les données de production internes et les retours des entreprises
-
Documentation des spécifications des modèles de Claude Platform : Fable 5.2 Overview
- Lien :
platform.claude.com/docs/en/models/fable-5-2/overview -
Présentation : paramètres tels que la fenêtre de contexte, la longueur maximale des réponses et l’ID du modèle
-
Documentation sur l’orchestration multi-agent de Managed Agents : Subagent et Dynamic Workflow
- Lien :
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
Présentation : limites de concurrence, du nombre d’agents et du cycle de vie dans le produit public
-
Annonce de l’intégration à Vercel AI Gateway : Claude Fable 5.2 now available on AI Gateway
- Lien :
vercel.com/changelog/claude-fable-5-2-now-available-on-ai-gateway -
Présentation : capacités de basculement, de gestion des budgets et de nouvelle tentative des passerelles API tierces
-
Article de The Verge : Anthropic launches new Claude Fable and Mythos 5.2 models
- Lien :
theverge.com/ai-artificial-intelligence/1030005/anthropic-claude-fable-mythos-5-2 - Présentation : couverture de cette annonce par un média tiers
Auteur : l’équipe technique d’APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site officiel d’APIYI. Pour plus d’informations sur l’intégration, consultez le centre de documentation à l’adresse docs.apiyi.com.