Um notebook liga, e o que aparece na tela não é o Windows nem alguma distribuição Linux, mas um sistema criado por uma IA a partir de uma pasta vazia. Em 9 de novembro de 2026, ao lançar o Claude Fable 5.2, a Anthropic revelou esse experimento interno: o Fable 5.2 coordenou mais de 1.000 subagentes, trabalhou sem parar por 8 dias e criou um protótipo de sistema operacional capaz de iniciar em um notebook real.
Principal contribuição: este artigo usa o experimento com o sistema operacional como ponto de partida para explicar qual é o verdadeiro avanço do Claude Fable 5.2, como devemos entender esses 1.000 agentes de IA e quanto falta para esse protótipo se tornar um produto maduro. No fim, pela perspectiva de quem desenvolve, discutimos quais requisitos os fluxos de trabalho com agentes de longa duração impõem à infraestrutura de API.
Principais informações sobre o experimento de sistema operacional do Claude Fable 5.2
Vamos começar pelos fatos confirmados oficialmente. A tabela abaixo inclui apenas informações confirmadas no anúncio da Anthropic.
| Item | Detalhes |
|---|---|
| Data de lançamento | Revelado em 9 de novembro de 2026, junto com o lançamento do Claude Fable 5.2 |
| Anunciado por | Anthropic (experimento interno de engenharia) |
| Ponto de partida da tarefa | Um engenheiro propôs a tarefa: projetar e implementar um protótipo de sistema operacional a partir de uma pasta vazia |
| Escala de execução | Mais de 1.000 subagentes, em operação contínua por 8 dias |
| Principais atividades | Escrever código, testar componentes, revisar código e corrigir problemas |
| Funcionalidades finais | Kernel, drivers de disco / teclado / rede, armazenamento permanente de arquivos, sistema de janelas, interface de login, instalador e recursos do Claude integrados |
| Validação principal | Capaz de iniciar (boot) em um notebook real |
| Ainda não divulgado | Código-fonte e processo de compilação, documentação da arquitetura, número de linhas de código, arquitetura de comunicação entre agentes, uso de tokens, custo do experimento, testes de compatibilidade com vários hardwares e auditoria de segurança independente |
Quais módulos compõem o sistema operacional criado por 1.000 agentes de IA
Veja a função de alguns módulos importantes. O kernel é o software central que gerencia o hardware e os recursos do sistema. Ele é responsável por escalonar processos, alocar memória e tratar interrupções. Os drivers permitem que o sistema operacional se comunique com hardwares como discos, teclados e placas de rede. Sem eles, o kernel não consegue “enxergar” os periféricos.
O armazenamento permanente de arquivos significa que os dados continuam disponíveis após a reinicialização. Para isso, o sistema precisa ter um sistema de arquivos de verdade, e não apenas executar uma demonstração na memória.
Já o sistema de janelas, a interface de login e o instalador são partes visíveis para o usuário. O instalador merece atenção: ele mostra que o sistema percorreu, pelo menos, todo o caminho de “gravar no disco e depois iniciar a partir dele”.
Só quando juntamos esses módulos fica claro por que “iniciar em um notebook” é um resultado significativo. Isso exige que vários subsistemas estejam realmente conectados, em vez de cada um apenas produzir trechos de código que parecem corretos isoladamente.
Isso nos leva à pergunta central deste artigo: como mais de 1.000 agentes conseguiram colaborar para concluir um projeto de engenharia completo?
O avanço do Claude Fable 5.2: a IA começa a organizar projetos de engenharia
O Fable 5.2 apresentou um avanço significativo em benchmarks de programação. A Anthropic divulgou uma pontuação de 49,1% no FrontierCode 2.0, enquanto a versão anterior, Fable 5.1, marcou 32,4%. No FrontierSWE v2, o resultado foi de 69,9%, contra 56,3% da versão anterior.
Esses são benchmarks gerais de programação, não resultados de testes do próprio experimento com o sistema operacional. O aspecto mais interessante dessa experiência não é a qualidade do código escrito, mas a mudança na forma de organizar o trabalho de engenharia.
A diferença entre assistentes tradicionais de programação com IA e projetos de engenharia com agentes de longa duração
Os assistentes tradicionais de programação com IA seguem um modelo de colaboração de “pergunta e resposta”: o usuário apresenta uma necessidade, a IA escreve um trecho de código e, depois de conferir o resultado, o usuário pede alterações. O ciclo se repete. Nesse modelo, a divisão das tarefas, o acompanhamento do progresso e a integração do conjunto ficam a cargo das pessoas. A IA é apenas uma executora muito eficiente.
Já os projetos de engenharia com agentes de longa duração transferem mais responsabilidades para o modelo. A tabela abaixo compara os dois modelos:
| Dimensão | Assistente tradicional de programação com IA | Projeto de engenharia com agentes de longa duração |
|---|---|---|
| Granularidade das tarefas | Uma função, arquivo ou funcionalidade | Projeto completo, com divisão autônoma em subtarefas |
| Duração da execução | Uma conversa, de alguns minutos a algumas horas | Várias horas ou até dias seguidos |
| Forma de execução | Uma única linha de execução, aguardando o retorno de uma pessoa | Vários subagentes trabalham em paralelo em módulos diferentes |
| Garantia de qualidade | Principalmente por meio de revisão manual | Testes automatizados, revisão cruzada e correções programadas quando surgem problemas |
| Trabalho de integração | Feito por uma pessoa | Um agente coordenador reúne os resultados e verifica a compatibilidade entre módulos |
| Papel das pessoas | Orientar passo a passo | Definir o objetivo, supervisionar o processo e fazer a aprovação final |
Em projetos como um sistema operacional, o desafio está justamente na coluna da direita. O kernel, os drivers e o sistema de arquivos dependem de muitos contratos de interface, e uma alteração em um módulo pode fazer os testes de outro falharem.
Identificar problemas, organizar correções e avançar nas partes pendentes ao longo de oito dias demonstra capacidade de “gerenciamento de projetos”, não apenas de “escrever código”.
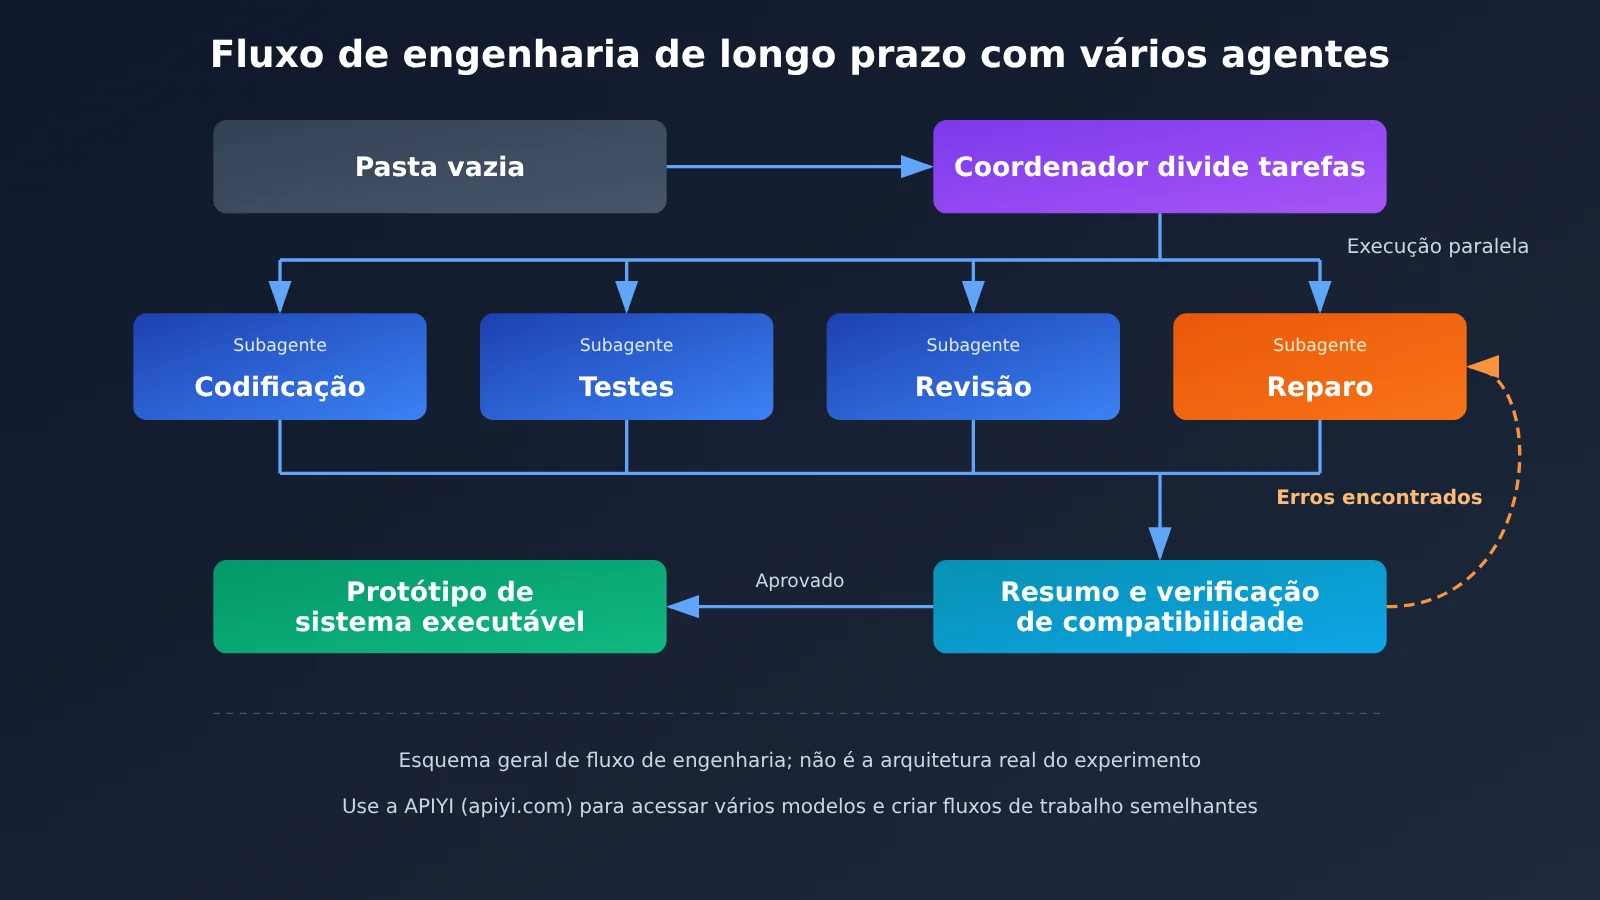
Vale esclarecer que o diagrama acima é uma análise de um fluxo geral para projetos de engenharia de grande porte. A Anthropic não divulgou a estrutura específica de divisão de tarefas, o Harness, o protocolo de comunicação nem a linguagem de programação usados no experimento com o sistema operacional.
Outro experimento realizado no mesmo período, sobre o Último Teorema de Fermat, revelou detalhes de uma arquitetura com “1 Lead + 999 Helpers”. Mas esse foi um experimento independente, e essa estrutura não pode ser aplicada diretamente ao projeto do sistema operacional.
O papel de “coordenador” visto pelos primeiros testadores corporativos
No lançamento, a Anthropic divulgou depoimentos de alguns parceiros dos primeiros testes. São relatos de experiências reais de engenheiros de empresas, não de testes cegos independentes, mas todos apontam para a mesma tendência: os modelos começam a assumir tarefas de planejamento e coordenação.
- Vercel: Joe Haddad (membro da equipe técnica) afirmou que um projeto que, com outros modelos, levaria semanas para avançar foi concluído em poucos dias com o Fable 5.2 e aprovado pela equipe. Os revisores de código também tiveram menos alterações a sugerir.
- Shopify: Tom Pritchard (engenheiro sênior) avaliou que o modelo consegue receber uma ideia relativamente ampla, transformá-la em um plano após algumas rodadas de conversa e executar o trabalho seguinte de forma autônoma. A experiência se aproxima da colaboração com outro engenheiro sênior.
- Datadog: Matt Lee (engenheiro sênior) comparou o modelo a um comandante de incidentes (Incident Commander): ao lidar com sistemas desconhecidos, ele aciona modelos mais rápidos para coletar informações e, depois, coordena diferentes tarefas, reduzindo o esforço de coordenação exigido dos operadores humanos.
- Uber: Andrew Mager (engenheiro sênior de sistemas agênticos) relatou uma auditoria de segurança que durou de 10 a 12 horas. O modelo distribuiu o trabalho entre cerca de 170 agentes de revisão e entregou um relatório de auditoria, Pull Requests com correções e uma recomendação de política. Ele destacou especialmente que o modelo continua trabalhando até concluir a tarefa de fato, em vez de parar ao chegar a um resultado intermediário que apenas parece razoável.
O caso da Uber é, em termos de formato, o mais parecido com o experimento do sistema operacional: em ambos, um modelo distribui tarefas entre muitos agentes para concluir um trabalho de longa duração. Mas os dois projetos são totalmente independentes.
Claude Fable 5.2 já está em produção de verdade
Se houvesse apenas o experimento com o sistema operacional, as pessoas poderiam considerá-lo uma demonstração cuidadosamente preparada. Os dois conjuntos de dados internos divulgados pela Anthropic mostram que esse tipo de capacidade de engenharia já é usado no desenvolvimento cotidiano de software.
O primeiro conjunto diz respeito à proporção de código produzido. Segundo a Anthropic, mais de 90% das alterações de código que acabam sendo integradas à sua base de código principal são escritas pelo Claude, com orientação humana. Esse número se refere à proporção das alterações integradas que foram escritas pelo Claude. Não significa que 90% do trabalho de desenvolvimento seja feito sem participação humana, nem que todo esse código tenha sido produzido pelo Fable 5.2.
O segundo conjunto trata da migração de um serviço de produção. Uma equipe de agentes que usava uma versão inicial do Fable 5.2 migrou um serviço essencial de produção de Python para Rust. Após a migração, a eficiência e a confiabilidade do serviço melhoraram, e a velocidade de inicialização aumentou cerca de 26 vezes. A migração entre linguagens é um trabalho típico de longa duração, que exige validações repetidas. Para garantir que o comportamento permaneça consistente, os testes e as correções costumam dar mais trabalho do que a própria tradução.
Esses casos têm naturezas diferentes. A tabela abaixo destaca essas diferenças:
| Caso | Natureza | Fonte das evidências | O que demonstra | O que não demonstra |
|---|---|---|---|---|
| Protótipo de sistema operacional | Experimento interno da Anthropic | Anúncio oficial e demonstração | O modelo consegue coordenar projetos de engenharia de longa duração, com grande escala e vários módulos | Que já alcançou o nível de um sistema operacional comercial ou que foi reproduzido por terceiros |
| 90% do código integrado escrito pelo Claude | Dados internos de produção | Anúncio oficial | A IA já participa profundamente da produção diária de código | Que o código dispensa revisão humana |
| Migração de Python para Rust | Caso interno de produção | Anúncio oficial | A engenharia com agentes pode ser aplicada à otimização de infraestrutura real | Que tenha sido usado o mesmo método do experimento com o sistema operacional |
| Feedback da Vercel / Shopify / Datadog / Uber | Experiência de quem testou o modelo em fase inicial | Relatos citados no anúncio oficial | Engenheiros de empresas perceberam a capacidade de coordenação durante o trabalho real | Que possa substituir benchmarks independentes |
Vistos em conjunto, esses casos mostram uma expansão da capacidade de execução de tarefas de engenharia. Isso não significa que todo projeto de engenharia possa ser feito sem supervisão.
O que significa, afinal, ter 1.000 agentes de IA?
“1.000 agentes” é o número mais chamativo deste experimento — e também o mais fácil de interpretar mal.
O número total de agentes não é o mesmo que o número de agentes em execução simultânea
Para começar, a Anthropic informou que “mais de 1.000 subagentes participaram”, mas não disse se eles foram executados ao mesmo tempo. Ao longo dos oito dias, é provável que os subagentes tenham sido criados em etapas, encerrados após concluir suas tarefas e substituídos por novos agentes.
Além disso, 1.000 agentes não equivalem a 1.000 engenheiros com as mesmas habilidades, trabalhando de forma totalmente independente. A eficiência real depende de vários fatores: o quanto as tarefas podem ser executadas em paralelo, o custo de coordenação, o compartilhamento de estado, os conflitos no código, a cobertura de testes e o custo das chamadas.
Um exemplo simples: enquanto o gerenciamento de memória do kernel não estiver definido, é difícil avançar de verdade no sistema de arquivos e nos drivers. Dependências desse tipo mostram por que um projeto grande não pode ser dividido indefinidamente em tarefas paralelas.
Dois modos de orquestração no Managed Agents público
A documentação do Managed Agents da Anthropic, voltada a desenvolvedores, permite observar como um sistema multiagente é transformado em produto. Ela apresenta dois modos de orquestração.
Modo Subagent: o agente principal pode criar subagentes. Cada subagente tem seu próprio Session Thread e histórico de contexto, e o agente principal pode enviar tarefas adicionais para eles. Uma única Session pode ter até 25 threads filhos diretos ativos ao mesmo tempo, e a delegação direta só permite um nível.
Modo Dynamic Workflow: voltado a tarefas de maior escala. Primeiro, o agente principal escreve um programa de fluxo de trabalho, que cria vários agentes para serem executados em paralelo. Depois, reúne os resultados de cada etapa e decide o que fazer a seguir com base nos resultados da etapa anterior. Em geral, se um agente falhar, o servidor tenta executá-lo novamente uma vez, em uma nova thread. A documentação oficial informa os seguintes limites:
| Métrica | Limite oficial |
|---|---|
| Threads executadas simultaneamente em um fluxo de trabalho | 64 (configuração do limite do produto; a documentação oficial não garante que esse número será atingido) |
| Agentes iniciados durante o ciclo de vida de um fluxo de trabalho | 1.000 |
| Ciclo de vida padrão de um fluxo de trabalho | 24 horas |
| Fluxos de trabalho abertos simultaneamente em uma única Session, por padrão | 10 |
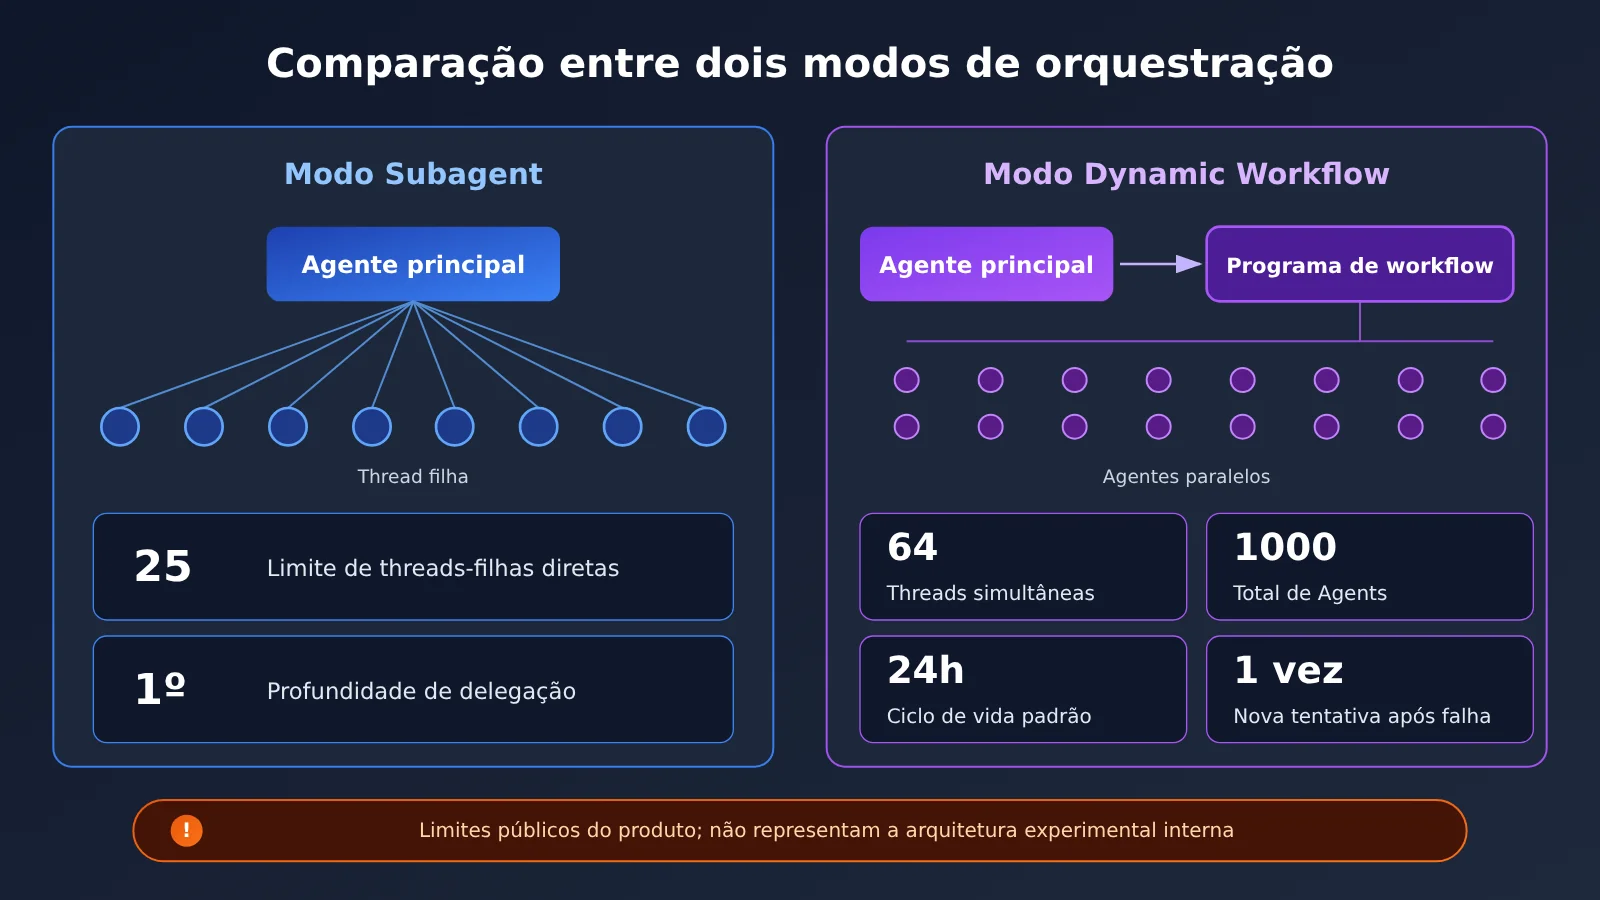
É importante destacar: o experimento com o sistema operacional foi um projeto interno de engenharia da Anthropic; o Managed Agents público é um serviço oferecido como produto. Não dá para concluir que o experimento foi feito com o Managed Agents, nem aplicar a ele o limite de 64 threads simultâneas. Ainda assim, esses números mostram algo importante: orquestrar agentes em grande escala depende não só do modelo, mas também de um escalonador, do gerenciamento do estado das tarefas, do controle de simultaneidade, de mecanismos de repetição e de um sistema de orçamento. Por trás do número “1.000”, o trabalho da infraestrutura é tão importante quanto o do modelo.
Limites do protótipo de sistema operacional Claude Fable 5.2
“Conseguir inicializar” é um marco importante, mas ainda há uma longa distância entre isso e estar pronto para produção. Sistemas consolidados como Windows, Linux e macOS são resultado de décadas de compatibilidade com hardware, reforço de segurança e manutenção comunitária.
| Requisito de engenharia | Protótipo inicializável (informações divulgadas até agora) | Sistema operacional comercial consolidado |
|---|---|---|
| Compatibilidade com hardware | Inicializa em um notebook real | Compatível com uma grande variedade de combinações de chips, periféricos e firmware |
| Segurança | Não há registro de auditoria independente de segurança por terceiros | Resposta contínua a vulnerabilidades, isolamento de permissões e mecanismo de aplicação de patches |
| Confiabilidade de longo prazo | Não foram divulgados testes de execução prolongada | Validado por um enorme número de usuários e por longos períodos de operação |
| Manutenção do sistema | Código-fonte e processo de compilação não foram divulgados | Conta com controle de versões, ciclo de lançamentos e suporte de longo prazo |
| Auditoria do código | Não foram divulgados o número de linhas de código nem a documentação da arquitetura | Código passível de auditoria e documentação completa da arquitetura |
| Reprodutibilidade | Ainda não houve reprodução independente por terceiros | Processo de compilação público e reproduzível |
Esta tabela não pretende menosprezar o experimento, mas deixar claro o que ele demonstra. O experimento mostra que um modelo consegue organizar um projeto de engenharia de software com vários módulos ao longo de um período prolongado e entregar um resultado em que os subsistemas estão realmente conectados. Ele não prova que um sistema operacional escrito por IA pode substituir diretamente os produtos existentes.
Engenheiros humanos continuam sendo essenciais nesse tipo de projeto. A definição de objetivos, as decisões de arquitetura, os limites de segurança e a validação final ainda são responsabilidades humanas. A própria Anthropic é cautelosa ao descrever o trabalho: 90% do código incorporado foi escrito pelo Claude, mas “com orientação humana”.
A conclusão mais prudente é que a IA já demonstrou capacidade de organizar projetos complexos de engenharia de software, mas isso não significa que equipes experientes de engenharia de software possam dispensar as pessoas.
O impacto do Claude Fable 5.2 para desenvolvedores
Da chamada única aos fluxos de trabalho de Agent de longa duração
A maioria dos desenvolvedores não vai criar um sistema operacional tão cedo. Mas a forma de trabalhar revelada por este experimento deve, aos poucos, chegar aos projetos do dia a dia, como revisão de código em lote, refatoração de repositórios inteiros, migração entre linguagens e auditorias de segurança.
Nesse contexto, o foco dos desenvolvedores deixa de ser “a resposta desta chamada foi boa?” e passa a incluir questões mais ligadas à engenharia:
- Gerenciamento de tarefas: como dividir as tarefas, registrar o status de cada subtarefa e retomar o trabalho do ponto em que parou após uma falha.
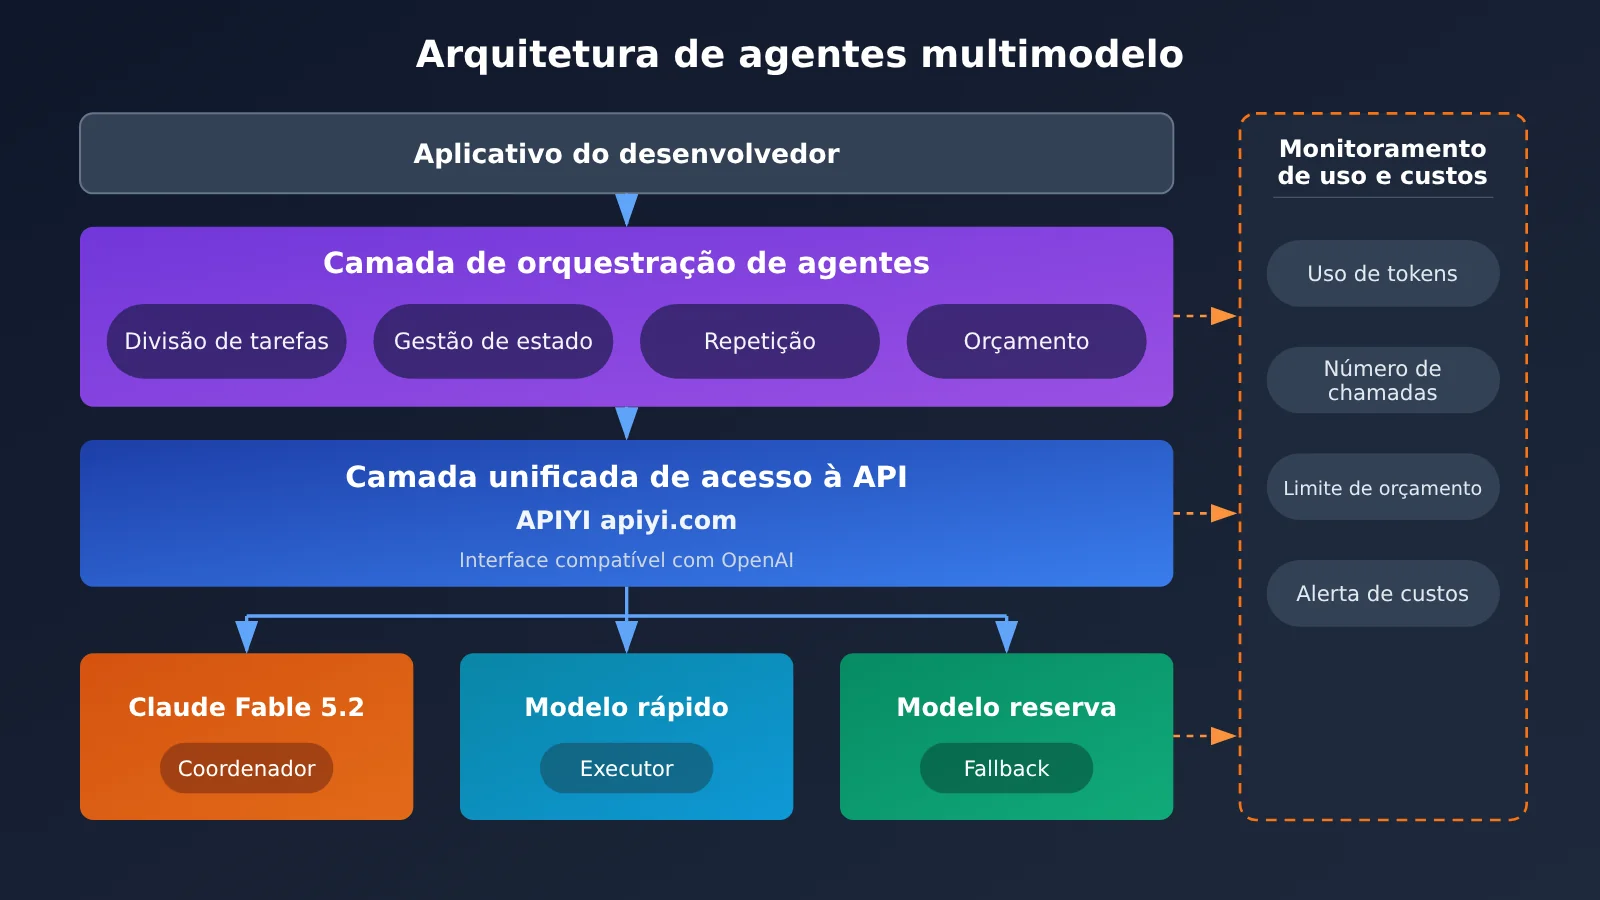
- Divisão de tarefas entre modelos: no caso da Datadog, o Fable 5.2 chama um “modelo mais rápido” para coletar informações. Usar um modelo mais potente como coordenador e modelos mais rápidos ou baratos para executar tarefas é uma estrutura de custos comum.
- Estabilidade das chamadas: um fluxo de trabalho pode incluir centenas ou milhares de chamadas. Mesmo que a taxa de falha de cada chamada seja baixa, as falhas acumuladas podem causar interrupções frequentes — por isso, são necessários mecanismos de nova tentativa e failover.
- Controle de orçamento: o preço público da API do Fable 5.2 é de US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de tokens de saída. O Fast Mode custa o dobro. A Anthropic não divulgou o custo real do experimento com o sistema operacional, mas é fácil imaginar que os custos de tarefas longas com vários Agents precisem de monitoramento contínuo.
- Monitoramento de tarefas: é preciso saber o que cada Agent está fazendo, quanto está consumindo e onde está travado.
No mesmo dia, a Vercel anunciou a integração do Fable 5.2 ao AI Gateway, com failover entre fornecedores, modelos de fallback, estatísticas de uso e custos, além de regras de orçamento e novas tentativas. Isso mostra que a infraestrutura para chamadas de modelos em aplicações complexas com Agents está começando a se consolidar.
Como chamar o Claude Fable 5.2 usando uma API compatível com OpenAI
O ID oficial do modelo na API do Fable 5.2 é claude-fable-5-2. Ele oferece suporte a uma janela de contexto de 1M tokens e a uma saída de até 128K tokens. Para chamá-lo por uma API compatível com OpenAI, use esta forma básica (confirme o nome do modelo na lista do console da plataforma):
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "把这个 Python 模块的迁移计划拆成可并行的子任务"}]
)
print(resp.choices[0].message.content)
Ver exemplo completo: coordenador + executores paralelos + controle de novas tentativas e orçamento
A seguir, mostramos uma implementação simplificada em que um coordenador divide o trabalho e os executores processam as tarefas em paralelo. Ela inclui novas tentativas em caso de falha e um controle aproximado do orçamento de tokens. O exemplo serve apenas para ilustrar uma abordagem geral de engenharia; não é uma implementação real do experimento de sistema operacional da Anthropic.
import json
import openai
from concurrent.futures import ThreadPoolExecutor, as_completed

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI, compatível com modelos de vários provedores
)

PLANNER_MODEL = "claude-fable-5-2"   # Coordenador: responsável por dividir e consolidar as tarefas
WORKER_MODEL = "gpt-4o-mini"         # Executor: substitua pelo modelo rápido que você realmente usa
TOKEN_BUDGET = 200_000               # Orçamento de tokens para todo o fluxo de trabalho
MAX_WORKERS = 8                      # Limite de tarefas paralelas; ajuste conforme necessário
used_tokens = 0


def chat(model, prompt, max_tokens=2000):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,停止派发新任务")
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    used_tokens += resp.usage.total_tokens
    return resp.choices[0].message.content


def plan(goal):
    prompt = (
        f"目标:{goal}\n"
        "请拆成 3-6 个可以独立完成的子任务,"
        '只输出 JSON 数组,格式为 [{"id": 1, "task": "..."}]'
    )
    return json.loads(chat(PLANNER_MODEL, prompt))


def run_task(item, retries=1):
    for attempt in range(retries + 1):
        try:
            return item["id"], chat(WORKER_MODEL, item["task"])
        except Exception as e:
            if attempt == retries:
                return item["id"], f"失败:{e}"


def workflow(goal):
    tasks = plan(goal)
    results = {}
    with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
        futures = [pool.submit(run_task, t) for t in tasks]
        for f in as_completed(futures):
            tid, out = f.result()
            results[tid] = out
    summary_prompt = "汇总以下子任务结果,检查相互之间是否冲突:\n" + json.dumps(
        results, ensure_ascii=False
    )
    return chat(PLANNER_MODEL, summary_prompt, max_tokens=4000)


if __name__ == "__main__":
    print(workflow("为一个小型 Web 服务设计从 Python 迁移到 Rust 的方案"))
    print(f"累计消耗 Token:{used_tokens}")
🚀 Dica para começar: em fluxos de trabalho com agentes e vários modelos, o coordenador e os executores costumam ser de provedores diferentes. Com a APIYI em apiyi.com, você pode usar uma única chave API para chamar Claude, OpenAI, Gemini e outros modelos populares. O pagamento é por uso, e novos usuários recebem créditos grátis para testes — uma boa opção para validar a orquestração e os custos com tarefas pequenas.
Perguntas frequentes
Q1: O que o experimento de sistema operacional com Claude Fable 5.2 realmente conseguiu fazer?
Segundo informações divulgadas pela Anthropic, Fable 5.2 começou com uma pasta vazia e coordenou mais de 1000 subagentes trabalhando continuamente por 8 dias para criar um protótipo de sistema operacional capaz de iniciar em um notebook real. Ele inclui kernel, drivers de disco / teclado / rede, armazenamento permanente de arquivos, sistema de janelas, tela de login, instalador e recursos integrados do Claude.
Q2: Os 1000 agentes de IA estavam todos em execução ao mesmo tempo?
A empresa não divulgou essa informação. “Mais de 1000 subagentes participaram” não significa que 1000 agentes tenham funcionado simultaneamente durante todo o processo, nem que fossem 1000 engenheiros independentes. O limite público de concorrência de um fluxo de trabalho do Managed Agents é de 64 threads, com até 1000 agentes iniciados ao longo do ciclo de vida. Mas esse é um limite do produto e não pode ser aplicado ao experimento interno.
Q3: O sistema operacional criado pela IA pode substituir o Windows ou o Linux?
Não. A definição oficial é “um protótipo funcional”. Até o momento, não há código-fonte público, documentação da arquitetura, testes de compatibilidade com diferentes hardwares nem auditoria de segurança de terceiros. Também não houve uma reprodução independente. O experimento demonstra a capacidade da IA de organizar projetos complexos de engenharia, não a maturidade de um produto.
Q4: Qual é o preço da API e quais são as especificações do Claude Fable 5.2?
O preço público é de 8 dólares por milhão de Token de entrada e 40 dólares por milhão de Token de saída, uma redução de 20% em relação ao modo normal do Fable 5.1. O Fast Mode custa o dobro e pode atingir uma velocidade de saída de até 2.5 vezes a do modo normal. A janela de contexto é de 1M Token, o limite máximo de saída é de 128K Token e a Batch API oferece 50% de desconto tanto na entrada quanto na saída. Esses são os preços públicos, não o custo real do experimento do sistema operacional.
Q5: Como desenvolvedores podem chamar rapidamente a API do Claude Fable 5.2 para fazer experimentos com Agent?
Você pode começar validando a lógica de orquestração com tarefas pequenas:
1. Cadastre-se em APIYI apiyi.com e obtenha uma chave API e créditos gratuitos para testes;
2. Defina `base_url` como `https://api.apiyi.com/v1` no exemplo deste artigo. Consulte a lista no painel para confirmar o nome do modelo;
3. Primeiro, faça funcionar o ciclo mínimo de “dividir tarefas → executar em paralelo → consolidar” e, depois, adicione gradualmente novas tentativas e controle de orçamento.
Q6: Onde os fluxos de trabalho de longa duração com vários agentes costumam apresentar problemas?
Os problemas mais comuns se concentram em três pontos. Primeiro, custos fora de controle: o número de chamadas cresce com a quantidade de agentes, por isso é necessário definir um limite de orçamento. Segundo, falhas acumuladas: erros ocasionais em uma chamada podem se amplificar ao longo de uma cadeia extensa, então são necessárias novas tentativas e um modelo de fallback. Terceiro, custos de coordenação: se as dependências entre as tarefas não estiverem claras, o processamento em paralelo pode gerar conflitos no código. Com APIYI apiyi.com, você pode integrar modelos de vários provedores em um só lugar, configurar modelos de fallback com mais facilidade e consultar o uso de forma centralizada.
Claude Fable 5.2 e 1000 agentes de IA: principais conclusões
- Fatos do experimento: mais de 1000 subagentes, 8 dias e um protótipo de sistema operacional inicializável criado do zero.
- A verdadeira mudança: o modelo começa a assumir a decomposição de tarefas, a execução paralela, os reparos contínuos e a integração dos resultados.
- Sinais de uso em produção: mais de 90% do código integrado na Anthropic foi escrito pelo Claude, e a migração para Rust acelerou a inicialização em cerca de 26 vezes.
- Limite dos números: 1000 agentes não significam 1000 engenheiros independentes trabalhando em paralelo o tempo todo.
- Limites do protótipo: sem auditoria e reprodução por terceiros, ainda há uma longa distância até um sistema operacional comercial maduro.
- O que importa para desenvolvedores: orquestração, novas tentativas, orçamento e monitoramento são tão importantes quanto a capacidade do modelo. Você pode usar a APIYI apiyi.com para integrar vários modelos em um só lugar.
Resumo
A notícia de que 1000 agentes de IA criaram um sistema operacional em 8 dias merece atenção não tanto pelos números, mas por três motivos:
- A natureza da capacidade mudou: o Claude Fable 5.2 demonstra capacidade de organizar o trabalho de engenharia, não apenas de gerar código.
- As evidências precisam ser analisadas por categoria: o experimento com o sistema operacional, os dados internos de produção e os primeiros relatos de empresas são tipos diferentes de evidência e devem ser avaliados separadamente.
- As pessoas ainda são a última etapa: o protótipo consegue iniciar, mas as decisões de arquitetura, a segurança e a validação continuam sob a responsabilidade de engenheiros humanos.
Para quem desenvolve, o próximo passo é deixar de pensar em “uma única chamada” e passar a planejar “fluxos de trabalho de longa duração”, definindo desde cedo a divisão de tarefas entre modelos, a estabilidade das chamadas e o controle de custos. Recomendamos usar a APIYI apiyi.com para acessar os principais modelos de vários provedores com uma única chave API e começar validando tarefas de agentes em pequena escala.
📚 Referências
- Anúncio oficial da Anthropic: Claude Fable 5.2 and Mythos 5.2 (2026-11-09)
- Link:
anthropic.com/claude-fable-and-mythos-5-2 -
Descrição: fonte primária sobre experimentos com sistemas operacionais, dados internos de produção e feedback de empresas
-
Documentação de especificações dos modelos da Claude Platform: Fable 5.2 Overview
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview -
Descrição: especificações como janela de contexto, saída máxima e Model ID
-
Documentação de orquestração multiagente do Managed Agents: Subagent e Dynamic Workflow
- Link:
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
Descrição: limites de threads simultâneas, número de agentes e ciclo de vida do produto público
-
Anúncio de integração do Vercel AI Gateway: Claude Fable 5.2 now available on AI Gateway
- Link:
vercel.com/changelog/claude-fable-5-2-now-available-on-ai-gateway -
Descrição: recursos de failover, orçamento e novas tentativas de gateways de API de terceiros
-
Reportagem do The Verge: Anthropic launches new Claude Fable and Mythos 5.2 models
- Link:
theverge.com/ai-artificial-intelligence/1030005/anthropic-claude-fable-mythos-5-2 - Descrição: cobertura simultânea do lançamento por um veículo de imprensa independente
Autor: Equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site da APIYI. Para consultar mais materiais de integração, acesse a central de documentação em docs.apiyi.com