ノートパソコンの電源が入り、画面に現れたのは Windows でも Linux ディストリビューションでもありません。空のフォルダーから AI が作り上げたシステムでした。2026 年 11 月 9 日、Anthropic は Claude Fable 5.2 の発表にあわせて、この社内実験を明らかにしました。Fable 5.2 は 1000 を超えるサブ Agent を統括し、8 日間にわたって連続稼働。実際のノートパソコンで起動できる OS のプロトタイプを作り上げました。
この記事のポイント:OS 実験を軸に、Claude Fable 5.2 の本当のブレークスルーはどこにあるのか、1000 の AI Agent をどう捉えるべきか、そしてこのプロトタイプが成熟した製品になるまでにどれほどの距離があるのかを解説します。最後に、開発者の視点から、長期にわたる Agent ワークフローが API インフラに求める要件について考えます。
Claude Fable 5.2のOS実験:概要
まずは、公式に明らかにされている事実を確認しましょう。以下の表には、Anthropicの発表で確認できる内容のみをまとめています。
| 項目 | 詳細 |
|---|---|
| 発表日 | 2026年11月9日、Claude Fable 5.2の発表にあわせて公開 |
| 発表元 | Anthropic(社内エンジニアリング実験) |
| タスクの開始点 | エンジニアが「空のフォルダーから、OSのプロトタイプを設計・実装する」というタスクを提示 |
| 実行規模 | 1000を超えるサブ Agentが8日間、休みなく稼働 |
| 主な作業 | コードの作成、コンポーネントのテスト、コードレビュー、問題の修正 |
| 最終的な機能 | カーネル、ディスク/キーボード/ネットワークドライバー、永続的なファイル保存、ウィンドウシステム、ログイン画面、インストーラー、Claudeの組み込み機能 |
| 重要な検証結果 | 実際のノートパソコンで起動(Boot)できる |
| 未公開の情報 | ソースコードとビルド手順、アーキテクチャ文書、コード行数、Agentの通信アーキテクチャ、トークン使用量、実験コスト、複数のハードウェアでの互換性テスト、第三者によるセキュリティ監査 |
1000のAI Agentが作ったOSには、どんなモジュールが含まれるのか
主なモジュールの役割を見ていきましょう。カーネルは、ハードウェアとシステムリソースを管理する中核的なソフトウェアです。プロセスのスケジューリング、メモリの割り当て、割り込み処理などを担います。ドライバーは、OSがディスクやキーボード、ネットワークカードといったハードウェアと通信できるようにします。ドライバーがなければ、カーネルは外部機器を「認識」できません。
永続的なファイル保存とは、再起動後もデータが保持されることです。そのためには、メモリ上で一度だけ動くデモではなく、実際に機能するファイルシステムが必要です。
ウィンドウシステム、ログイン画面、インストーラーは、ユーザーから見える部分です。インストーラーが含まれている点は注目に値します。このシステムが少なくとも、「ディスクへの書き込みから、ディスクからの起動まで」という一連の流れを実現できたことを示しているからです。
こうしたモジュールをあわせて考えると、「ノートパソコンで起動できる」ことがなぜ重要なのかが見えてきます。複数のサブシステムが実際につながって機能する必要があり、それぞれが一見正しそうなコードを個別に書くだけでは実現できません。
ここで、この記事の中心となる疑問が浮かびます。1000を超える Agent は、どのように連携して一つの大規模なプロジェクトを完成させたのでしょうか?
Claude Fable 5.2のブレークスルー:AIがエンジニアリングを組織し始めた
Fable 5.2は、プログラミングベンチマークで明らかな進歩を遂げています。Anthropicが公表したFrontierCode 2.0のスコアは49.1%で、前世代のFable 5.1の32.4%を上回りました。FrontierSWE v2では69.9%を記録し、前世代の56.3%から向上しています。
ただし、これらは汎用プログラミングのベンチマークであり、OS実験そのものの成績ではありません。今回の実験で注目すべきなのは、コードの出来栄えよりも、エンジニアリングの進め方が変わったことです。
従来のAIプログラミングアシスタントと長期的なAgentエンジニアリングの違い
従来のAIプログラミングアシスタントは、「質問と回答」を繰り返す協業スタイルです。ユーザーが要望を伝え、AIがコードを書き、ユーザーが確認して修正を依頼する——というサイクルで進みます。この方式では、タスクの分解、進捗管理、全体の統合を人間が担い、AIは効率の高い実行役にとどまります。
一方、長期的なAgentエンジニアリングでは、より多くの役割をモデルに任せます。次の表で、2つの方式の違いを比較します。
| 項目 | 従来のAIプログラミングアシスタント | 長期的なAgentエンジニアリング |
|---|---|---|
| タスクの粒度 | 単一の関数、ファイル、機能 | 完全なプロジェクト。サブタスクへの分解も自律的に行う |
| 実行時間 | 1回の会話で数分から数時間 | 数時間から数日間、継続して実行 |
| 実行方式 | 単一スレッドで、人間のフィードバックを待つ | 複数のサブAgentが異なるモジュールを並行して処理 |
| 品質保証 | 主に人間が確認 | 自動テスト、相互レビュー、問題の検出後に修正を手配 |
| 統合作業 | 人間が実施 | 調整役が成果を集約し、モジュール間の互換性を確認 |
| 人間の役割 | 段階的に指示する | 目標を設定し、進行を監督して、最終的に受け入れを判断 |
OSのようなプロジェクトで難しいのは、まさに右側の列にある内容です。カーネル、ドライバー、ファイルシステムの間には多くのインターフェース上の取り決めがあり、あるモジュールの変更によって別のモジュールのテストが失敗することもあります。
8日間にわたって問題を見つけ、修正を手配し、未完了の作業を進められたことは、「コードを書く」能力だけでなく、「プロジェクトを管理する」能力を示しています。
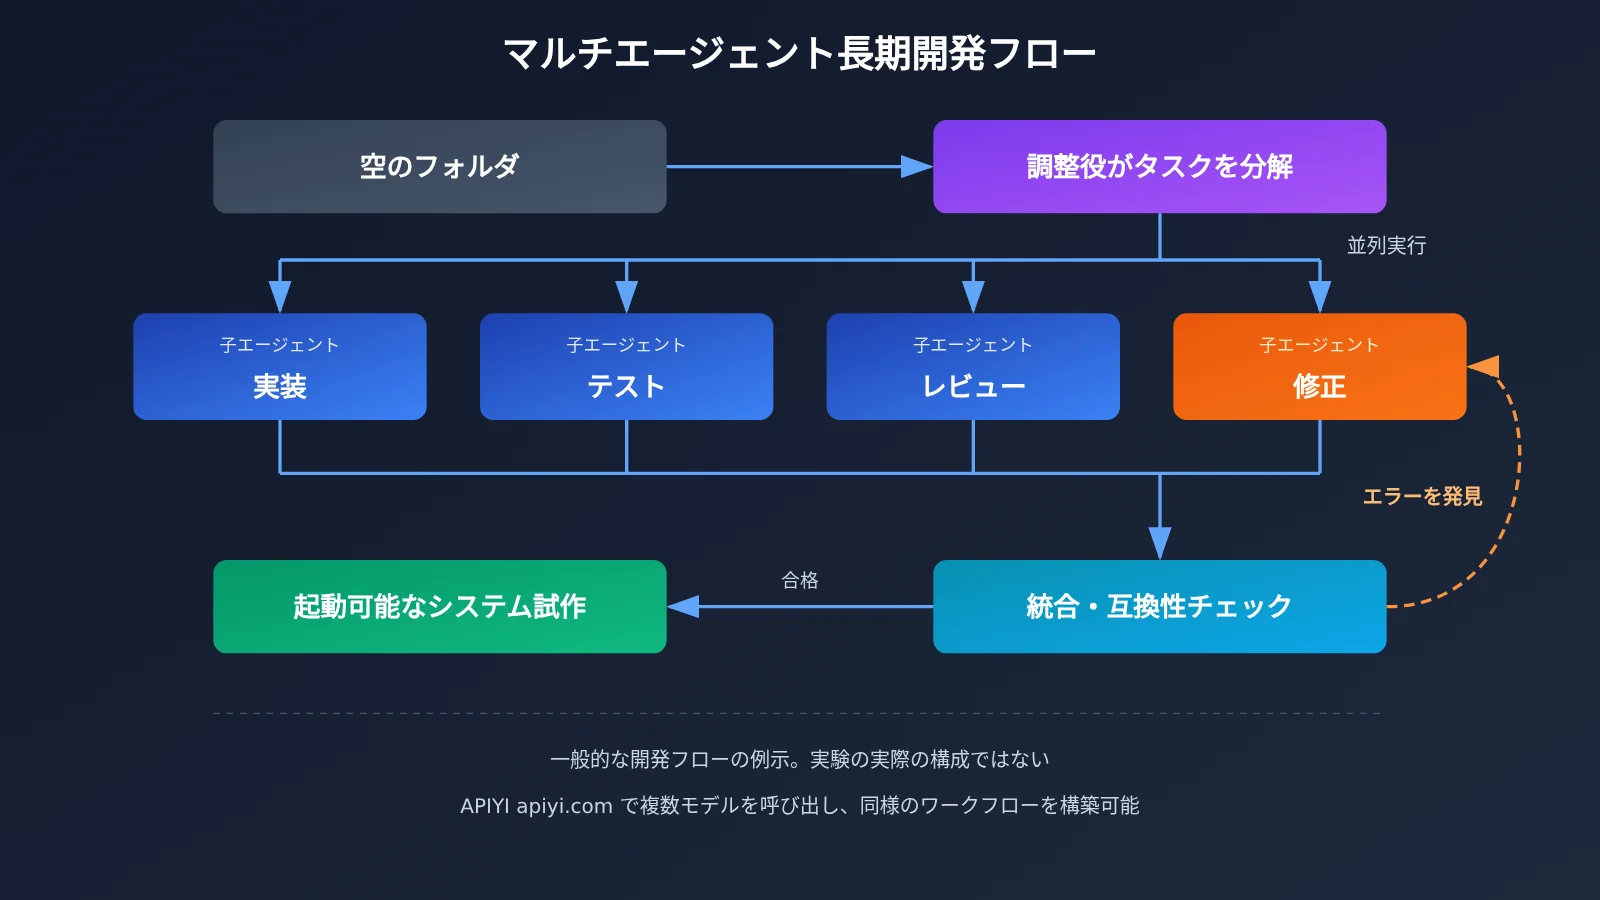
なお、上図は大規模なエンジニアリングプロジェクトで一般的な工程を分析したものです。Anthropicは、OS実験における具体的な役割分担、Harness、通信プロトコル、プログラミング言語を公開していません。
同時期に行われたフェルマーの最終定理に関する別の実験では、「1名のLead+999名のHelper」といったアーキテクチャの詳細が明かされました。しかし、これは独立した実験であり、その内容をOSプロジェクトにそのまま当てはめることはできません。
企業の早期テスターが見た「コーディネーター」の役割
Anthropicはリリース時に、複数の早期テストパートナーから寄せられたフィードバックを公開しました。企業のエンジニアによる実体験であり、独立したブラインドテストではありませんが、いずれも同じ傾向を示しています。モデルが計画や調整を担い始めているということです。
- Vercel:Member of Technical StaffのJoe Haddad氏によると、これまで他のモデルでは完了まで数週間かかっていたプロジェクトが、Fable 5.2では数日で完了し、チームのレビューも通過しました。コードレビューで指摘される修正点も少なくなったといいます。
- Shopify:Staff EngineerのTom Pritchard氏は、モデルに大まかなアイデアを伝えると、数回のやり取りで計画をまとめ、その後の作業を自律的に完了できると評価しています。別のStaff Engineerと協力しているような感覚に近いそうです。
- Datadog:Senior Staff EngineerのMatt Lee氏は、モデルをインシデントコマンダー(Incident Commander)になぞらえています。未知のシステムに直面すると、より高速なモデルを呼び出して情報を集め、異なるタスクを調整するため、人間のオペレーターの調整負担が軽減されるといいます。
- Uber:Agentic Systems担当のStaff Engineer、Andrew Mager氏は、10—12時間にわたって連続稼働したセキュリティ監査の事例を明かしました。モデルは約170のレビュー用エージェントを派遣し、最終的に監査レポート、修正用のPull Request、ポリシー提案書を作成しました。特に強調したのは、もっともらしい中間結果を出して止まるのではなく、タスクが本当に完了するまで実行を続ける点です。
Uberの事例は、形式としてはオペレーティングシステムの実験に最も近く、どちらも1つのモデルが多数のサブエージェントを派遣して長時間のタスクを完了させます。ただし、両者は完全に独立したプロジェクトです。
Claude Fable 5.2は実際の本番環境で活用されている
OSの実験だけであれば、入念に準備されたデモにすぎないと思われるかもしれません。しかし、Anthropicが同時に公開した2つの社内データからは、こうしたエンジニアリング能力が日々のソフトウェア開発ですでに活用されていることがわかります。
1つ目は、コードの作成割合です。Anthropicによると、同社の主要なコードベースで最終的にマージされたコード変更のうち、90%を超える部分が人間の指導のもとでClaudeによって書かれました。この数字が示すのは、マージされた変更のうちClaudeが書いた割合です。開発作業の90%が人間の関与なしに行われたという意味でも、これらのコードがすべてFable 5.2によって書かれたという意味でもありません。
2つ目は、本番サービスの移行です。初期版のFable 5.2を使うAgentチームが、重要な本番サービスをPythonからRustに移行しました。移行後、サービスの効率と信頼性が向上し、起動速度は約26倍になりました。言語の移行は、「長期間にわたり、繰り返し検証が必要な」典型的な作業です。動作の一貫性を保つには、コードの書き換えそのものより、テストと修正に多くの労力がかかることも少なくありません。
これらの事例はそれぞれ性質が異なります。違いを以下の表にまとめました。
| 事例 | 性質 | 根拠となる情報 | 示していること | 示していないこと |
|---|---|---|---|---|
| OSのプロトタイプ | Anthropic社内の実験 | 公式発表とデモ | モデルが複数モジュールにまたがる大規模で長期的なエンジニアリング作業を進められる | 商用OSと同等の水準に達していること、第三者による再現が確認されていること |
| マージされたコードの90%をClaudeが作成 | 社内の本番データ | 公式発表 | AIが日常のコード開発に深く関わっている | 人によるコードレビューが不要であること |
| PythonからRustへの移行 | 社内の本番事例 | 公式発表 | Agentを活用したエンジニアリングが、実際のインフラ最適化に使える | OSの実験と同じ手法が使われていること |
| Vercel / Shopify / Datadog / Uberからのフィードバック | 初期テスターの体験 | 公式発表での引用 | 企業のエンジニアが、実務で調整能力を実感している | 独立したベンチマークの代わりになること |
これらを総合すると、共通して示されているのは「エンジニアリングを実行する能力の拡大」です。だからといって、すべてのエンジニアリング作業を人間の監督なしで進められるというわけではありません。
1000個のAI Agentが意味すること
「1000個のAgent」は、今回の実験で最も目を引く数字であると同時に、最も誤解されやすい数字でもあります。
Agentの総数は同時稼働数ではない
まず、Anthropicが公表したのは「1000個を超えるサブAgentが参加した」という情報であり、それらが同時に稼働していたかどうかは明らかにされていません。8日間の期間中、サブAgentは順次作成され、タスクを終えると終了し、その後は新しいAgentが引き継いでいた可能性があります。
また、1000個のAgentが、能力も同じで完全に独立したエンジニア1000人を意味するわけではありません。実際の効率は、タスクをどれだけ並列化できるか、調整にかかるオーバーヘッド、共有状態、コードの競合、テストカバレッジ、呼び出しコストなど、複数の要因に左右されます。
わかりやすい例を挙げると、カーネルのメモリ管理の方針が固まるまでは、ファイルシステムやドライバーの開発を本格的に進めるのは困難です。こうした依存関係があるため、大規模なエンジニアリング作業を無制限に並列化することはできません。
公開されているManaged Agentsの2つのオーケストレーション方式
Anthropicが開発者向けに公開しているManaged Agentsのドキュメントからは、製品化されたマルチAgentシステムの仕組みをうかがい知ることができます。そこでは、2つのオーケストレーション方式が紹介されています。
Subagent方式:メインAgentがサブAgentを作成できます。各サブAgentは独立したSession Threadとコンテキスト履歴を持ち、メインAgentは後から追加のタスクを送ることもできます。1つのSessionで同時に存在できる直接の子スレッドは最大25個で、直接委譲できるのは1階層のみです。
Dynamic Workflow方式:より大規模なタスクを対象としています。メインAgentが最初にワークフロープログラムを作成し、そのプログラムが複数のAgentを並列で実行します。各段階の結果を集約し、前段階の結果をもとに次の処理を決定します。失敗したAgentは通常、サーバーによって新しいスレッドで1回再試行されます。公式ドキュメントに記載されている制限は以下のとおりです。
| 指標 | 公式の制限 |
|---|---|
| 1つのワークフローで同時に実行できるスレッド数 | 64(製品上の上限設定。必ずこの数に到達するとは限りません) |
| 1つのワークフローのライフサイクル中に起動できるAgent数 | 1000 |
| ワークフローのデフォルトのライフサイクル | 24時間 |
| 1つのSessionで同時に開けるワークフロー数(デフォルト) | 10 |
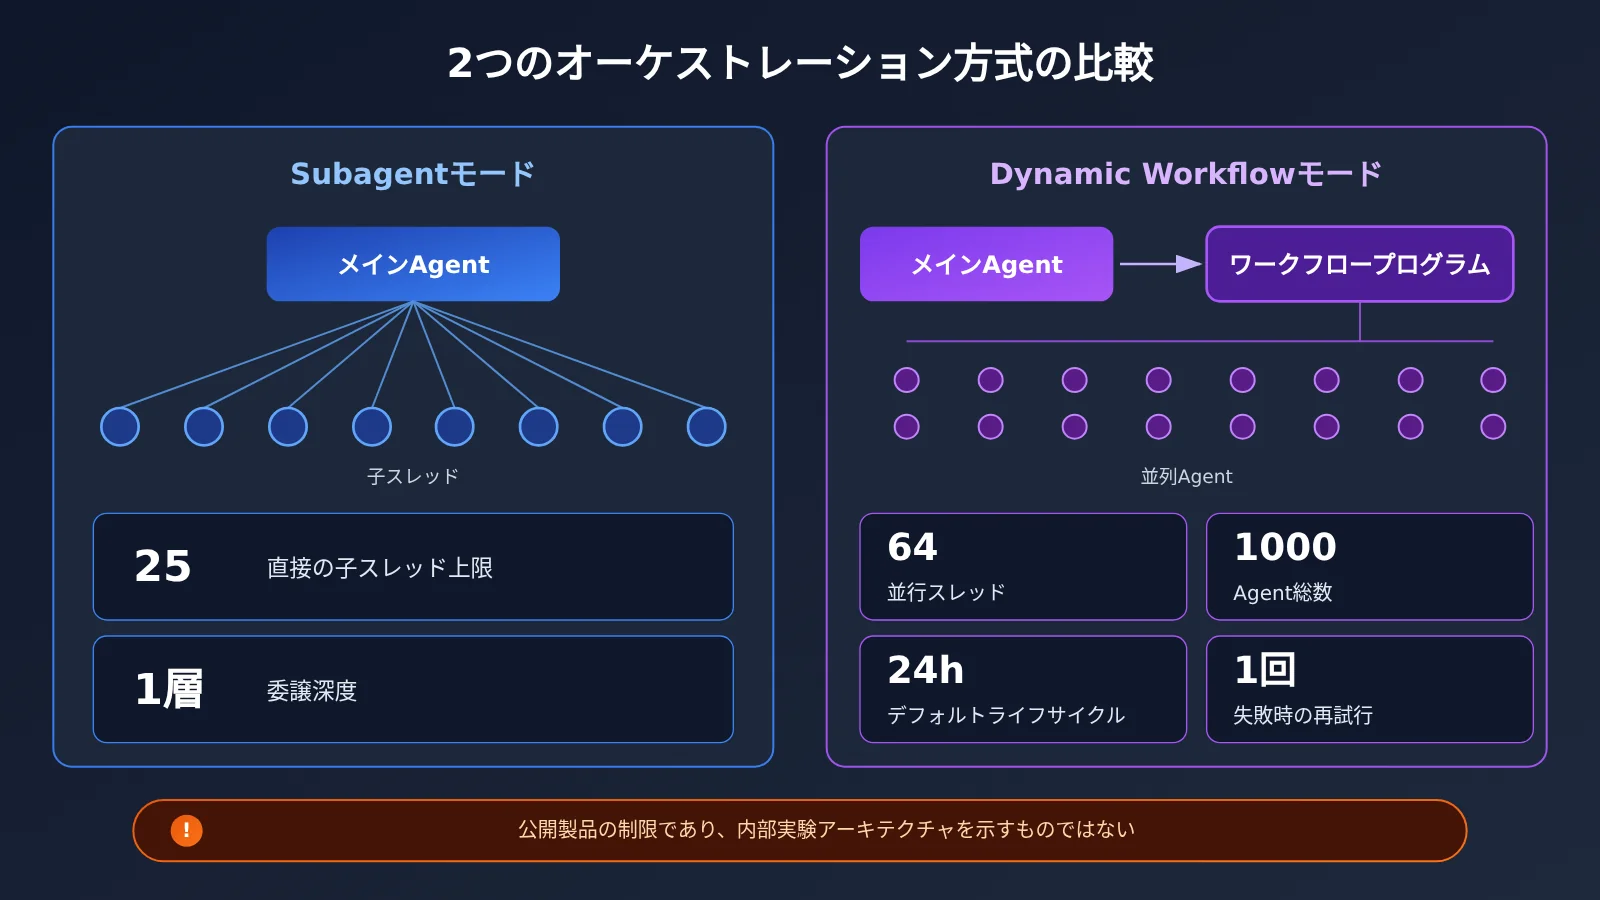
強調しておきたいのは、OS実験はAnthropic社内のエンジニアリング実験であり、公開されているManaged Agentsは製品化されたサービスだという点です。この情報だけをもとに、実験がManaged Agentsを使って行われたと断定することはできません。また、同時実行数の上限である64スレッドを実験に当てはめることもできません。
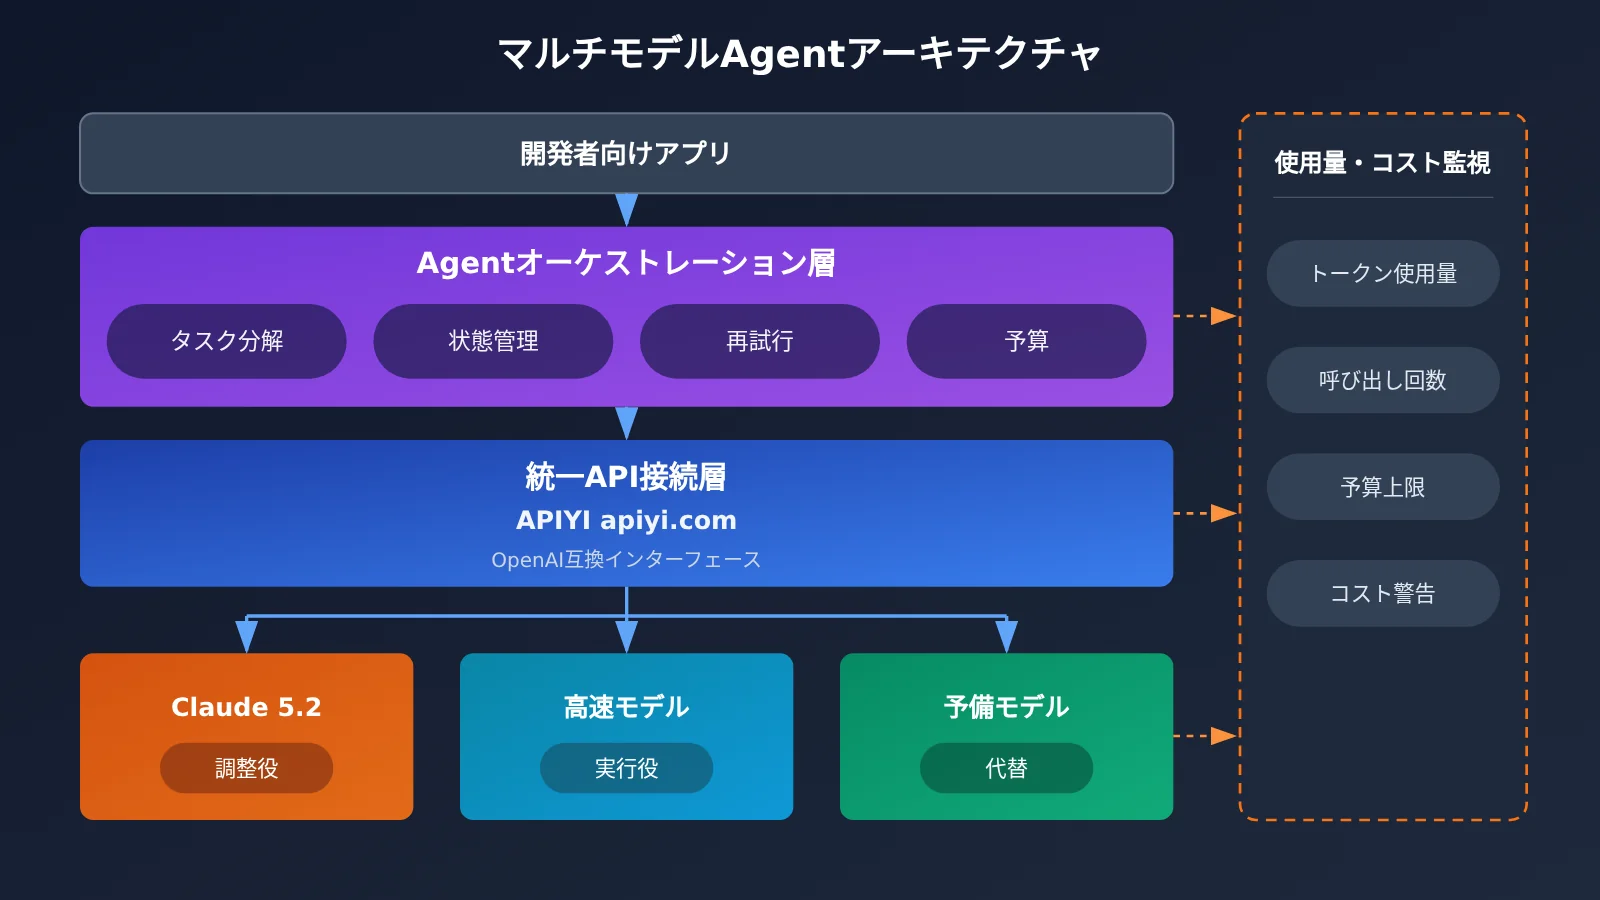
ただし、これらの数字からわかることがあります。大規模なAgentのオーケストレーションには、モデルそのものだけでなく、スケジューラー、タスク状態の管理、並行処理の制御、再試行の仕組み、予算管理システムも必要です。「1000」という数字の背後では、インフラもモデルと同じくらい重要な役割を担っています。
Claude Fable 5.2のOSプロトタイプが示す限界
「起動できる」ことは大きな節目ですが、「本番環境で使える」ようになるまでには、まだ長い道のりがあります。Windows、Linux、macOSのような成熟したOSは、数十年にわたるハードウェア対応、セキュリティ強化、コミュニティによる保守の積み重ねによって成り立っています。
| 工学上の要件 | 起動可能なプロトタイプ(現時点で公開されている情報) | 成熟した商用OS |
|---|---|---|
| ハードウェア互換性 | 実機のノートPC 1台で起動 | 多数のチップ、周辺機器、ファームウェアの組み合わせに対応 |
| セキュリティ | 独立した第三者によるセキュリティ監査は確認されていない | 継続的な脆弱性対応、権限分離、パッチ適用の仕組み |
| 長期的な信頼性 | 長時間稼働テストの情報は未公開 | 大規模なユーザー数と長期運用による検証 |
| システム保守 | ソースコードとビルド手順は未公開 | バージョン管理、リリースサイクル、長期サポート |
| コード監査 | コード行数とアーキテクチャ文書は未公開 | コードを監査でき、アーキテクチャ文書も充実 |
| 再現性 | 第三者による独立した再現はまだ確認されていない | ビルド手順が公開され、再現可能 |
この表は実験を貶めるためのものではなく、何が証明されたのかを明確にするためのものです。今回の実験が示したのは、モデルが長期にわたって複数のモジュールからなるソフトウェア開発を進め、各サブシステムが実際に連携する成果物を作り上げられるということです。AIが作成したOSが、既存製品をそのまま置き換えられると証明されたわけではありません。
この種の開発では、今なお人間のエンジニアが重要な役割を担っています。目標の設定、アーキテクチャ上の判断、安全性の境界設定、最終的な受け入れ確認は、引き続き人間が責任を負う必要があります。Anthropic自身も、「マージされたコードの90%をClaudeが書いた」としつつ、「人間の指導のもとで」と慎重に説明しています。
妥当な結論は、AIが複雑なソフトウェア開発を組織する能力を示し始めている一方で、成熟したソフトウェア開発チームに人間が不要になったわけではない、ということです。
Claude Fable 5.2が開発者に与える影響
単発の呼び出しから長期的なAgentワークフローへ
多くの開発者は、短期的にOSを作ることはないでしょう。しかし、今回の実験で明らかになった作業スタイルは、コードレビューの一括処理、リポジトリ全体のリファクタリング、言語の移行、セキュリティ監査など、日々のプロジェクトにも徐々に取り入れられていくはずです。
こうした場面では、開発者の関心は「今回の呼び出しの回答はよかったか」から、よりエンジニアリングに関わる次の点へと移っていきます。
- タスク管理:タスクをどう分割し、各サブタスクの状態をどう記録するか。失敗した場合に、中断したところから再開できるか。
- 複数モデルの役割分担:Datadogの事例では、Fable 5.2が「より高速なモデル」を呼び出して情報を収集します。コーディネーターには高性能なモデル、実行役には高速または低コストのモデルを使うのが、一般的なコスト構成です。
- 呼び出しの安定性:1つのワークフローに数百から数千回の呼び出しが含まれる場合、1回ごとの失敗率が低くても、累積すると頻繁な中断につながります。そのため、リトライやフェイルオーバーが必要です。
- 予算管理:Fable 5.2の公開API価格は、入力が100万Tokenあたり8ドル、出力が100万Tokenあたり40ドルです。Fast Modeでは価格が2倍になります。AnthropicはOS実験の実際の費用を公表していませんが、長期間にわたるマルチAgentタスクのコストを継続的に監視する必要があることは想像に難くありません。
- タスクのモニタリング:各Agentが何をしているのか、どれだけ消費しているのか、どこで行き詰まっているのかを把握する必要があります。
Vercelは同日、AI GatewayがFable 5.2に対応したと発表しました。プロバイダーの障害時の切り替え、フォールバックモデル、使用量とコストの集計、予算管理、リトライルールを提供します。これは、複雑なAgentアプリケーションを支えるモデル呼び出しのインフラが整いつつあることを示しています。
OpenAI互換インターフェースでClaude Fable 5.2を呼び出す方法
Fable 5.2の公式API Model IDはclaude-fable-5-2です。1M Tokenのコンテキストと、最大128K Tokenの出力に対応しています。OpenAI互換インターフェースから呼び出す場合の最もシンプルな書き方は、次のとおりです(モデル名はプラットフォームのコンソールに表示されるモデル一覧を確認してください)。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 統一インターフェース
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "把这个 Python 模块的迁移计划拆成可并行的子任务"}]
)
print(resp.choices[0].message.content)
完全なサンプルを見る:調整役 + 並列実行役 + リトライと予算管理
以下は、「調整役がタスクを分割し、実行役が並行して処理する」構成を簡略化して示した実装例です。失敗時のリトライと、概算のToken予算管理を含みます。一般的なエンジニアリングの考え方を説明するためのもので、Anthropicのオペレーティングシステム実験の実装そのものではありません。
import json
import openai
from concurrent.futures import ThreadPoolExecutor, as_completed

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 統一インターフェース。複数のモデルプロバイダーに切り替え可能
)

PLANNER_MODEL = "claude-fable-5-2"   # 調整役:タスクの分割と結果の集約を担当
WORKER_MODEL = "gpt-4o-mini"         # 実行役:実際に使用する高速モデルに置き換えてください
TOKEN_BUDGET = 200_000               # ワークフロー全体のToken予算
MAX_WORKERS = 8                      # 同時実行数の上限。必要に応じて調整してください
used_tokens = 0


def chat(model, prompt, max_tokens=2000):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,停止派发新任务")
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    used_tokens += resp.usage.total_tokens
    return resp.choices[0].message.content


def plan(goal):
    prompt = (
        f"目标:{goal}\n"
        "请拆成 3-6 个可以独立完成的子任务,"
        '只输出 JSON 数组,格式为 [{"id": 1, "task": "..."}]'
    )
    return json.loads(chat(PLANNER_MODEL, prompt))


def run_task(item, retries=1):
    for attempt in range(retries + 1):
        try:
            return item["id"], chat(WORKER_MODEL, item["task"])
        except Exception as e:
            if attempt == retries:
                return item["id"], f"失败:{e}"


def workflow(goal):
    tasks = plan(goal)
    results = {}
    with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
        futures = [pool.submit(run_task, t) for t in tasks]
        for f in as_completed(futures):
            tid, out = f.result()
            results[tid] = out
    summary_prompt = "汇总以下子任务结果,检查相互之间是否冲突:\n" + json.dumps(
        results, ensure_ascii=False
    )
    return chat(PLANNER_MODEL, summary_prompt, max_tokens=4000)


if __name__ == "__main__":
    print(workflow("为一个小型 Web 服务设计从 Python 迁移到 Rust 的方案"))
    print(f"累计消耗 Token:{used_tokens}")
🚀 すぐに始めるためのヒント:複数モデルを使うAgentワークフローを構築する場合、調整役と実行役には異なるプロバイダーのモデルを使うことがよくあります。APIYI(apiyi.com)なら、1つのAPIキーでClaude、OpenAI、Geminiなどの主要モデルを従量課金で利用できます。新規ユーザー向けの無料テスト枠もあるため、まずは小規模なタスクでワークフローの構成やコストを検証するのに適しています。
よくある質問(FAQ)
Q1:Claude Fable 5.2によるOS実験では、何が実現したのですか?
Anthropicの発表によると、Fable 5.2は空のフォルダからスタートし、1,000を超えるサブエージェントを連携させて8日間連続で作業し、実際のノートPCで起動できるOSのプロトタイプを作り上げました。カーネル、ディスク・キーボード・ネットワークの各ドライバー、永続ファイルストレージ、ウィンドウシステム、ログイン画面、インストーラー、Claudeの組み込み機能が含まれています。
Q2:1,000個のAIエージェントは同時に動作していたのですか?
公式からは明らかにされていません。「1,000を超えるサブエージェントが参加した」という説明は、1,000個のエージェントが全期間を通じて同時に稼働していたことや、1,000人の独立したエンジニアがいたことを意味しません。公開されているManaged Agentsの単一ワークフローでは、同時実行数の上限は64スレッド、ライフサイクル中に起動できるエージェント数は最大1,000個です。ただし、これは製品上の制限であり、社内実験にそのまま当てはめることはできません。
Q3:AIが作ったこのOSは、WindowsやLinuxに取って代われますか?
いいえ。公式の位置づけは「動作するプロトタイプ」です。現時点では、ソースコードやアーキテクチャ文書、複数のハードウェアでの互換性テスト、第三者によるセキュリティ監査は公開されておらず、独立した再現も行われていません。この実験が示したのは、AIが複雑なエンジニアリングを組織して進める能力であり、製品としての成熟度ではありません。
Q4:Claude Fable 5.2のAPI料金と仕様を教えてください。
公開価格は、入力が100万トークンあたり8ドル、出力が100万トークンあたり40ドルです。Fable 5.1の通常モードと比べて20%安くなっています。Fast Modeの料金は2倍ですが、出力速度は通常モードの最大2.5倍です。コンテキストウィンドウは100万トークン、最大出力は12万8,000トークンで、Batch APIでは入力・出力ともに50%の割引が適用されます。これらは公開価格であり、OS実験にかかった実際の費用ではありません。
Q5:開発者がClaude Fable 5.2を使って、手早くエージェント実験を行うにはどうすればよいですか?
まずは小規模なタスクで、オーケストレーションのロジックを検証するとよいでしょう。
1. APIYI(apiyi.com)に登録し、APIキーと無料のテスト用クレジットを取得します。
2. この記事のサンプルで`base_url`を`https://api.apiyi.com/v1`に設定します。モデル名はコンソールの一覧で確認してください。
3. まずは「タスク分割 → 並列実行 → 結果の集約」という最小限の一連の流れを動かし、その後、リトライや予算管理を段階的に追加します。
Q6:長期間にわたるマルチエージェントのワークフローでは、どこで問題が起きやすいですか?
よくある問題は主に3つあります。1つ目はコストの増大です。呼び出し回数はエージェント数に応じて増えるため、予算の上限を設定する必要があります。2つ目は失敗の累積です。1回ごとの呼び出しで起きる偶発的なエラーも、長い処理の中では影響が大きくなるため、リトライや代替モデルが必要です。3つ目は調整コストです。タスク間の依存関係が整理されていないと、並列化によってかえってコードの競合が起きます。APIYI(apiyi.com)を使って複数のモデルをまとめて利用すれば、代替モデルを設定しやすくなり、使用量も一元的に確認できます。
Claude Fable 5.2と1000個のAI Agent:押さえておきたいポイント
- 実験で確認されたこと:1000を超えるサブエージェントが8日間で、空のフォルダーから起動可能なOSのプロトタイプを作成しました。
- 本当のブレークスルー:モデルがタスクの分解、並列実行、継続的な修正、結果の統合まで担うようになりました。
- 実用化の兆し:Anthropicでは、マージされたコードの90%以上をClaudeが記述しています。また、Rustへの移行により起動速度が約26倍になりました。
- 数字の捉え方:1000個のAgentは、1000人の独立したエンジニアが最初から最後まで並列で作業したことを意味するわけではありません。
- プロトタイプとしての限界:第三者による監査や再現検証がないため、成熟した商用OSとはまだ大きな隔たりがあります。
- 開発者が注目すべき点:スケジューリング、リトライ、予算管理、監視もモデルの能力と同じくらい重要です。APIYI(apiyi.com)を利用すれば、複数のモデルをまとめて接続できます。
まとめ
1000個のAI Agentが8日でOSを作ったというニュースで、注目すべきなのは数字そのものではなく、次の3点です。
- 能力のあり方が変わった:Claude Fable 5.2が示したのは、コードを生成する能力だけでなく、開発工程を組織して進める能力です。
- 証拠は分けて捉える:OSの実験、社内の実績データ、企業からの初期フィードバックは、それぞれ性質の異なる証拠です。個別に評価する必要があります。
- 最後の役割を担うのは人間:プロトタイプは起動できますが、アーキテクチャの選択、安全性の確保、受け入れ判断は、引き続き人間のエンジニアが担う必要があります。
開発者にとって次の一歩は、考え方を「単発の呼び出し」から「長期的なワークフロー」へと切り替えることです。複数モデルの役割分担、呼び出しの安定性、コスト管理をあらかじめ検討しておきましょう。APIYI(apiyi.com)を利用すれば、1つのAPIキーで複数の主要モデルに接続できます。まずは小規模なAgentタスクから検証してみるのがおすすめです。
📚 参考資料
- Anthropic公式発表:Claude Fable 5.2 and Mythos 5.2(2026-11-09)
- リンク:
anthropic.com/claude-fable-and-mythos-5-2 -
説明:OSを使った実験、社内の本番データ、企業からのフィードバックを確認できる一次情報です。
-
Claude Platformモデル仕様ドキュメント:Fable 5.2 Overview
- リンク:
platform.claude.com/docs/en/models/fable-5-2/overview -
説明:コンテキストウィンドウ、最大出力、Model IDなどの仕様を確認できます。
-
Managed AgentsのマルチAgentオーケストレーションに関するドキュメント:SubagentとDynamic Workflow
- リンク:
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
説明:公開製品における並列スレッド、Agentの数、ライフサイクルの制限を確認できます。
-
Vercel AI Gatewayの接続に関する発表:Claude Fable 5.2 now available on AI Gateway
- リンク:
vercel.com/changelog/claude-fable-5-2-now-available-on-ai-gateway -
説明:サードパーティ製APIゲートウェイで利用できるフェイルオーバー、予算管理、リトライ機能について説明しています。
-
The Vergeの記事:Anthropic launches new Claude Fable and Mythos 5.2 models
- リンク:
theverge.com/ai-artificial-intelligence/1030005/anthropic-claude-fable-mythos-5-2 - 説明:今回の発表を伝えるサードパーティメディアの記事です。
著者: APIYI 技術チーム
技術に関するお問い合わせ: APIYI公式サイトのトップページからお気軽にお問い合わせください。接続に関する資料は、docs.apiyi.comのドキュメントセンターをご覧ください。