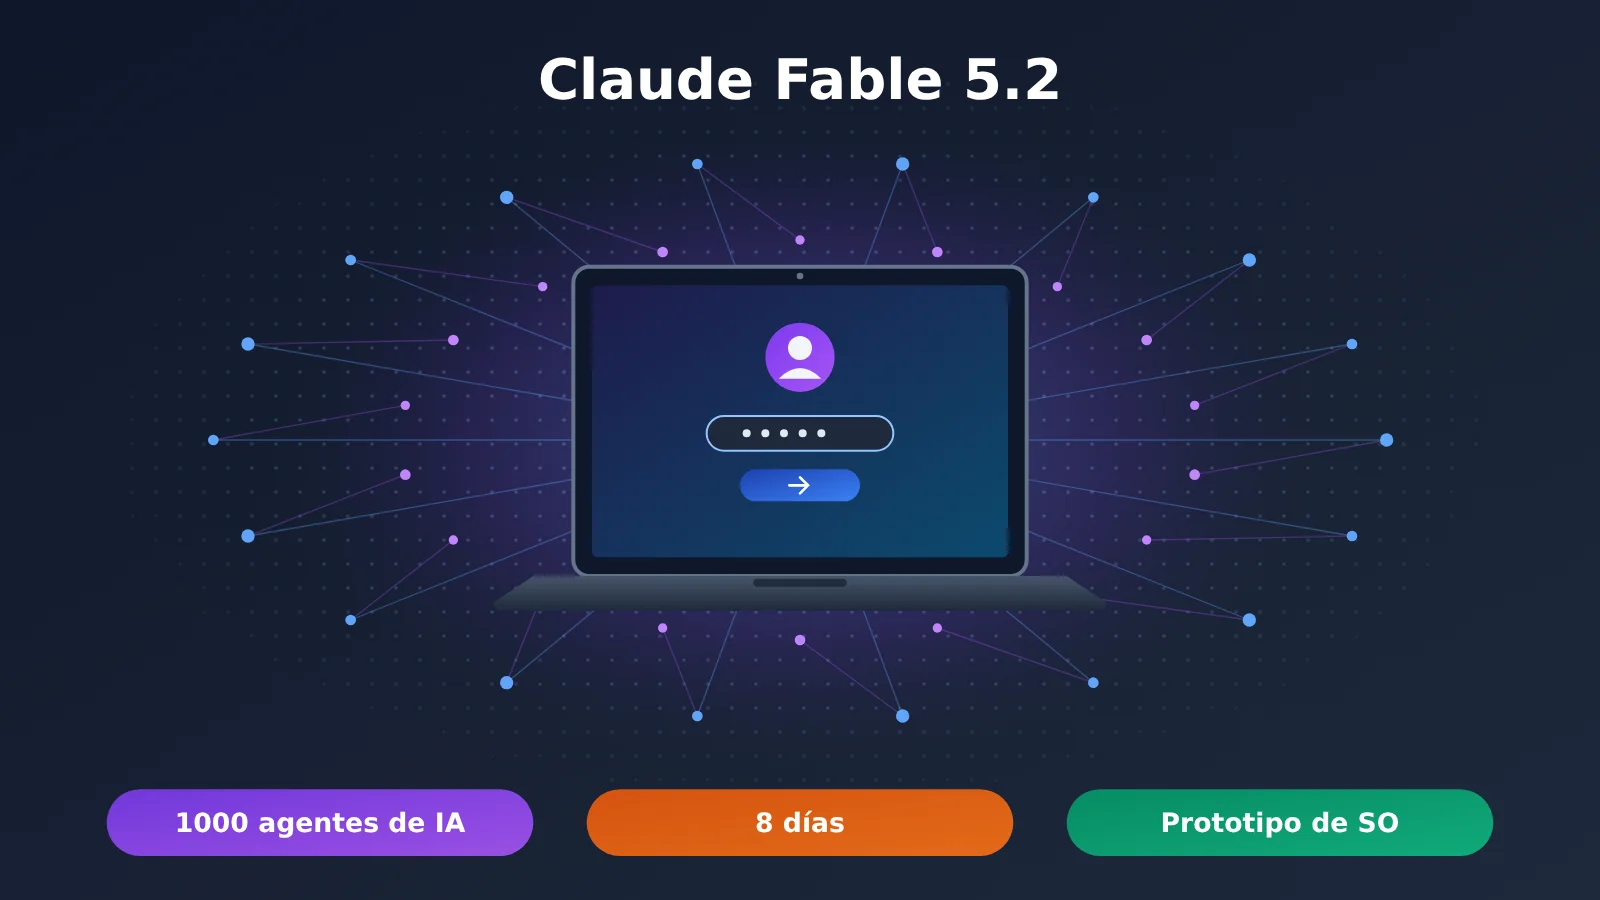
Una computadora portátil se enciende. En la pantalla no aparece Windows ni una distribución de Linux, sino un sistema que una IA construyó desde una carpeta vacía. El 9 de noviembre de 2026, al presentar Claude Fable 5.2, Anthropic dio a conocer este experimento interno: Fable 5.2 coordinó a más de 1000 subagentes, trabajó sin parar durante 8 días y creó un prototipo de sistema operativo capaz de arrancar en una computadora portátil real.
Valor principal: Este artículo toma el experimento con el sistema operativo como hilo conductor para explicar en qué consiste el verdadero avance de Claude Fable 5.2, cómo debemos entender a estos 1000 agentes de IA y cuánto le falta al prototipo para convertirse en un producto maduro. Al final, desde la perspectiva de los desarrolladores, analiza qué requisitos plantean los flujos de trabajo con agentes de larga duración para la infraestructura de API.
Datos clave del experimento de Claude Fable 5.2 con un sistema operativo
Empecemos por los hechos confirmados oficialmente. La tabla recoge solo la información que Anthropic ha confirmado en su anuncio.
| Elemento | Detalles |
|---|---|
| Fecha de publicación | 9 de noviembre de 2026; se dio a conocer junto con el lanzamiento de Claude Fable 5.2 |
| Responsable | Anthropic (experimento interno de ingeniería) |
| Punto de partida de la tarea | Un ingeniero asignó la tarea: diseñar e implementar un prototipo de sistema operativo desde una carpeta vacía |
| Escala de ejecución | Más de 1000 subagentes, en funcionamiento continuo durante 8 días |
| Actividades principales | Escribir código, probar componentes, revisar código y corregir problemas |
| Funcionalidades finales | Kernel, controladores de disco, teclado y red, almacenamiento permanente de archivos, sistema de ventanas, pantalla de inicio de sesión, instalador y funciones de Claude integradas |
| Verificación clave | Puede arrancar (boot) en una computadora portátil real |
| Información aún no publicada | Código fuente y proceso de compilación, documentación de arquitectura, número de líneas de código, arquitectura de comunicación entre agentes, uso de tokens, costo del experimento, pruebas de compatibilidad con distintos equipos y auditoría de seguridad externa |
Qué módulos incluye el sistema operativo creado por 1000 agentes de IA
Estos son algunos de los módulos clave y sus funciones. El kernel es el software central que administra el hardware y los recursos del sistema: programa los procesos, asigna memoria y gestiona interrupciones. Los controladores permiten que el sistema operativo se comunique con componentes como el disco, el teclado y la tarjeta de red. Sin ellos, el kernel no puede «ver» los periféricos.
El almacenamiento permanente de archivos significa que los datos se conservan después de reiniciar. Para ello, el sistema necesita un sistema de archivos real, no una demostración que solo se ejecuta en memoria.
Por su parte, el sistema de ventanas, la pantalla de inicio de sesión y el instalador son elementos visibles para el usuario. El instalador merece atención: indica que el sistema completó, al menos, todo el proceso de «escribir en el disco y luego arrancar desde él».
Solo al considerar todos estos módulos en conjunto se entiende por qué poder «arrancar en una computadora portátil» es un resultado significativo. Para lograrlo, varios subsistemas tienen que estar realmente conectados; no basta con que cada uno produzca fragmentos de código que parezcan correctos.
Esto nos lleva a la pregunta central del artículo: ¿cómo colaboraron más de 1000 agentes para completar un proyecto de ingeniería?
El avance de Claude Fable 5.2: la IA empieza a organizar proyectos de ingeniería
Fable 5.2 ha mejorado claramente en las pruebas de programación. Anthropic anunció una puntuación del 49,1 % en FrontierCode 2.0, frente al 32,4 % de la versión anterior, Fable 5.1. En FrontierSWE v2 obtuvo un 69,9 %, frente al 56,3 % de su predecesor.
Sin embargo, estas son pruebas generales de programación, no resultados de la propia prueba de sistemas operativos. Lo más interesante de este experimento no es cuánto mejor escribe código la IA, sino cómo ha cambiado la forma de organizar el trabajo de ingeniería.
Diferencias entre un asistente de programación tradicional y un agente de ingeniería de larga duración
Un asistente de programación tradicional sigue un modelo de colaboración de «pregunta y respuesta»: el usuario plantea una necesidad, la IA escribe un fragmento de código y, después de revisarlo, el usuario pide cambios. Y así sucesivamente. En este modelo, las personas se encargan de desglosar las tareas, gestionar el progreso e integrar el conjunto; la IA es solo una herramienta de ejecución muy eficiente.
En un proyecto de ingeniería con agentes de larga duración, se delegan más responsabilidades en el modelo. La tabla siguiente compara ambos enfoques:
| Dimensión | Asistente de programación tradicional | Proyecto de ingeniería con agentes de larga duración |
|---|---|---|
| Tamaño de las tareas | Una función, un archivo o una funcionalidad | Un proyecto completo que requiere desglosar las tareas |
| Duración | Una conversación, de unos minutos a unas horas | Varias horas o incluso días de trabajo continuo |
| Ejecución | Un solo hilo, a la espera de comentarios humanos | Varios subagentes trabajan en paralelo en distintos módulos |
| Garantía de calidad | Principalmente mediante revisión manual | Pruebas automáticas, revisiones cruzadas y tareas de reparación al detectar problemas |
| Integración | La realizan las personas | Una persona coordinadora reúne los resultados y comprueba la compatibilidad entre módulos |
| Papel de las personas | Dar instrucciones paso a paso | Definir objetivos, supervisar el proceso y hacer la revisión final |
En un proyecto como un sistema operativo, la columna de la derecha es la que representa el verdadero reto. El núcleo, los controladores y el sistema de archivos dependen de numerosos contratos de interfaz; un cambio en un módulo puede hacer que fallen las pruebas de otro.
Detectar problemas, organizar reparaciones y seguir avanzando en las partes pendientes durante ocho días demuestra capacidad de «gestión de proyectos», no solo de «escritura de código».
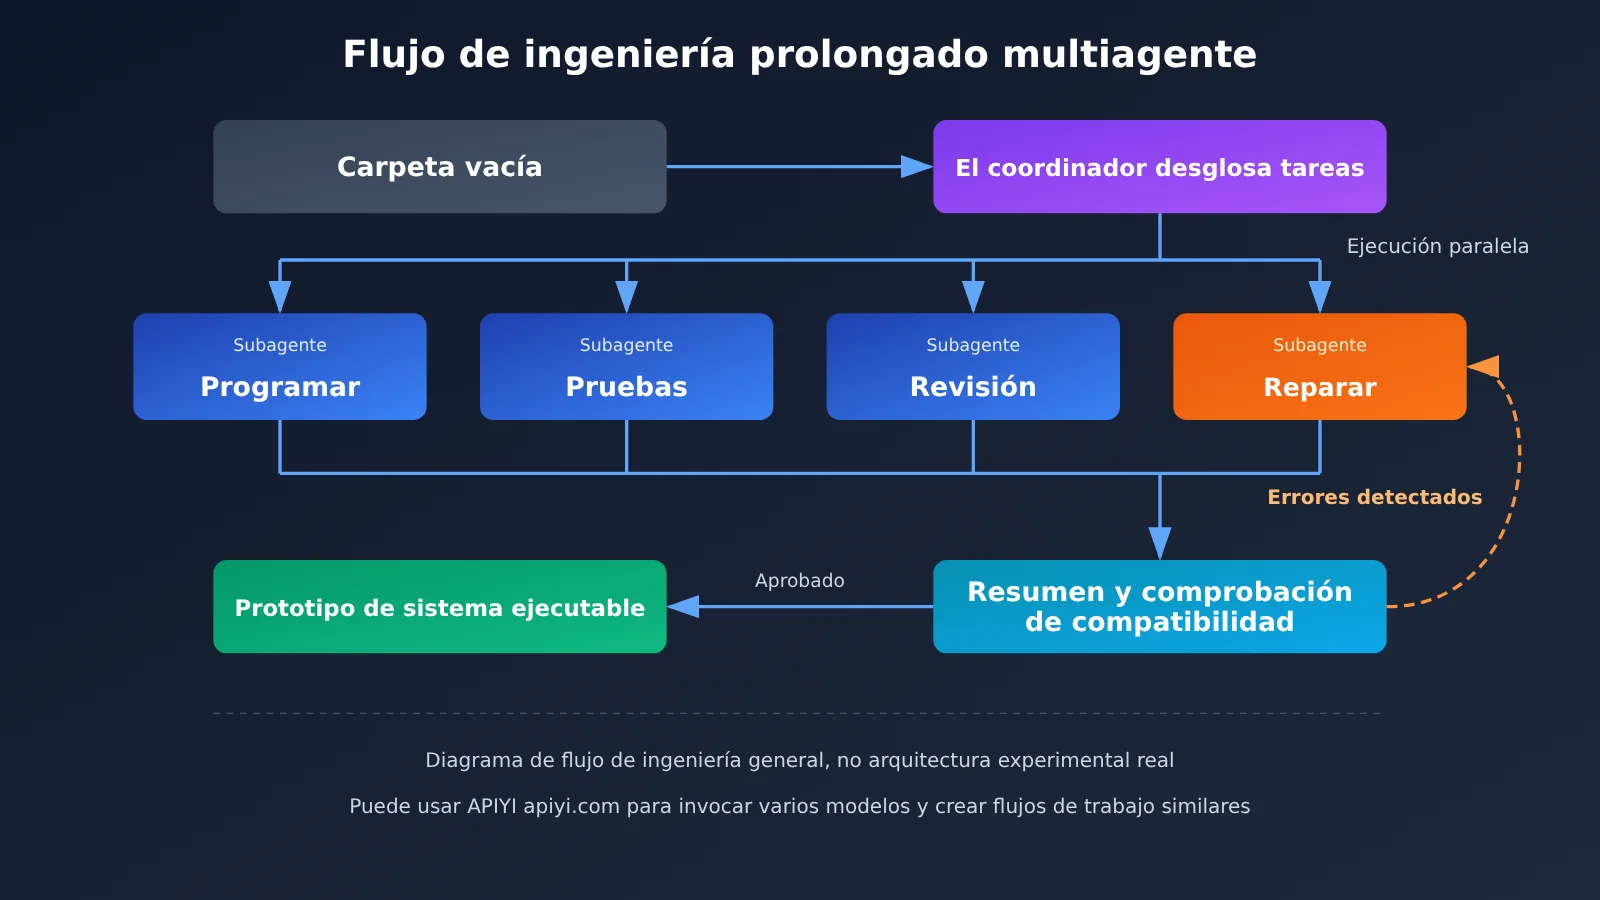
Hay que tener en cuenta que el diagrama anterior analiza un flujo general para proyectos de ingeniería a gran escala. Anthropic no ha hecho públicos la distribución concreta del trabajo, el Harness, los protocolos de comunicación ni los lenguajes de programación del experimento del sistema operativo.
En otro experimento realizado en el mismo periodo sobre el último teorema de Fermat, sí se revelaron detalles de la arquitectura, como «1 Lead + 999 Helpers». Sin embargo, se trató de un experimento independiente y no se pueden extrapolar esos datos al proyecto del sistema operativo.
El papel de «coordinador» visto por los primeros evaluadores empresariales
Al anunciar el lanzamiento, Anthropic compartió los comentarios de varios socios que participaron en las primeras pruebas. Son experiencias reales de ingenieros de empresas, no pruebas ciegas independientes, pero todas apuntan a la misma tendencia: los modelos empiezan a asumir tareas de planificación y coordinación.
- Vercel: Joe Haddad (miembro del equipo técnico) señaló que un proyecto que con otros modelos habría tardado semanas en avanzar se completó en unos días con Fable 5.2 y superó la revisión del equipo. Además, los revisores de código tuvieron que pedir menos cambios.
- Shopify: Tom Pritchard (ingeniero sénior) considera que el modelo puede partir de una idea general, convertirla en un plan tras varias rondas de conversación y encargarse por sí solo del trabajo posterior. La experiencia se parece a colaborar con otro ingeniero sénior.
- Datadog: Matt Lee (ingeniero sénior de nivel avanzado) lo comparó con un comandante de incidentes (Incident Commander): ante un sistema desconocido, recurre a modelos más rápidos para recopilar información y después coordina distintas tareas, lo que reduce la carga de coordinación de los operadores humanos.
- Uber: Andrew Mager (ingeniero sénior, sistemas agénticos) describió una auditoría de seguridad que se ejecutó de forma continua durante entre 10 y 12 horas. El modelo asignó tareas a unos 170 agentes de revisión y, al final, entregó un informe de auditoría, solicitudes de cambios (Pull Requests) con correcciones y una recomendación de políticas. Mager destacó especialmente que el modelo siguió trabajando hasta completar realmente la tarea, en lugar de detenerse al obtener un resultado parcial que solo parecía razonable.
El caso de Uber es, en cuanto a su formato, el más parecido al experimento con el sistema operativo: en ambos, un modelo asigna tareas a numerosos agentes secundarios para completar trabajos largos. Sin embargo, se trata de proyectos totalmente independientes.
Claude Fable 5.2 ya se utiliza en entornos de producción reales
Si solo se hubiera presentado el experimento con el sistema operativo, algunos podrían haberlo tomado por una demostración cuidadosamente preparada. Los dos conjuntos de datos internos que Anthropic dio a conocer al mismo tiempo muestran que estas capacidades de ingeniería ya se aplican en el desarrollo de software del día a día.
El primer dato es la proporción de código producido. Anthropic afirma que Claude escribió, con orientación humana, más del 90 % de los cambios de código que acabaron fusionándose en su repositorio principal. Esta cifra se refiere a la proporción de cambios fusionados escritos por Claude: no significa que el 90 % del trabajo de desarrollo se hiciera sin participación humana ni que todo ese código proceda de Fable 5.2.
El segundo dato es la migración de un servicio en producción. Un equipo de agentes que utilizaba una versión anterior de Fable 5.2 migró un servicio crítico de producción de Python a Rust. Tras la migración, mejoraron la eficiencia y la fiabilidad del servicio, y la velocidad de arranque aumentó unas 26 veces. La migración entre lenguajes es un trabajo típico de largo recorrido que exige verificaciones repetidas: garantizar que el comportamiento siga siendo el mismo suele requerir más esfuerzo en pruebas y correcciones que en la propia traducción del código.
Estos casos son de distinta naturaleza. La tabla siguiente los distingue:
| Caso | Naturaleza | Fuente de evidencia | Qué demuestra | Qué no demuestra |
|---|---|---|---|---|
| Prototipo de sistema operativo | Experimento interno de Anthropic | Anuncio y demostración oficiales | El modelo puede coordinar proyectos de ingeniería de gran escala, con varios módulos y de larga duración | Que ya esté al nivel de un sistema operativo comercial o que terceros lo hayan reproducido |
| Claude escribió el 90 % del código fusionado | Datos internos de producción | Anuncio oficial | La IA ya participa de forma profunda en la producción diaria de código | Que el código no necesite revisión humana |
| Migración de Python a Rust | Caso interno de producción | Anuncio oficial | La ingeniería con agentes puede aplicarse a la optimización de infraestructura real | Que se haya seguido el mismo método que en el experimento del sistema operativo |
| Comentarios de Vercel / Shopify / Datadog / Uber | Experiencias de los primeros evaluadores | Citas recogidas en el anuncio oficial | Los ingenieros de empresas perciben estas capacidades de coordinación en su trabajo real | Que puedan sustituir a benchmarks independientes |
En conjunto, estos casos muestran una ampliación de la capacidad para ejecutar tareas de ingeniería. Eso no significa que todos los proyectos puedan llevarse a cabo sin supervisión.
Qué significan realmente 1000 agentes de IA
«1000 agentes» es la cifra más llamativa de este experimento, pero también la que más fácilmente se puede malinterpretar.
El número total de agentes no equivale al número de agentes activos a la vez
En primer lugar, Anthropic reveló que participaron «más de 1000 subagentes», pero no especificó si funcionaron todos al mismo tiempo. A lo largo de los 8 días, es probable que se crearan subagentes por tandas: unos terminaban sus tareas y otros los reemplazaban.
En segundo lugar, 1000 agentes no equivalen a 1000 ingenieros con las mismas capacidades que trabajen de forma totalmente independiente. La eficiencia real depende de varios factores: cuánto se pueden paralelizar las tareas, los costes de coordinación, el estado compartido, los conflictos en el código, la cobertura de las pruebas y el coste de las invocaciones.
Un ejemplo sencillo: mientras no esté definida la gestión de memoria del kernel, es difícil que los sistemas de archivos y los controladores avancen de verdad. Dependencias como esta hacen que los proyectos grandes no puedan dividirse en tareas paralelas de manera ilimitada.
Dos modos de orquestación en Managed Agents
La documentación de Managed Agents de Anthropic, dirigida a desarrolladores, ofrece una ventana a los sistemas multiagente listos para producción. Incluye dos modos de orquestación.
Modo Subagent: el agente principal puede crear subagentes. Cada uno tiene su propio Session Thread y su propio historial de contexto, y el agente principal puede enviarles tareas adicionales. En una sola sesión pueden existir como máximo 25 hilos secundarios directos al mismo tiempo; la delegación directa solo admite un nivel.
Modo Dynamic Workflow: está pensado para tareas de mayor escala. El agente principal primero escribe un programa de flujo de trabajo. Ese programa crea varios agentes que trabajan en paralelo, reúne los resultados de cada etapa y decide el siguiente paso a partir de los resultados de la etapa anterior. Si un agente falla, el servidor suele volver a intentarlo una vez en un hilo nuevo. La documentación oficial establece los siguientes límites:
| Indicador | Límite oficial |
|---|---|
| Hilos activos al mismo tiempo en un flujo de trabajo | 64 (límite de configuración del producto; el uso oficial no garantiza que se alcance) |
| Agentes iniciados durante el ciclo de vida de un flujo de trabajo | 1000 |
| Duración predeterminada del ciclo de vida de un flujo de trabajo | 24 horas |
| Flujos de trabajo activos al mismo tiempo por sesión, de forma predeterminada | 10 |
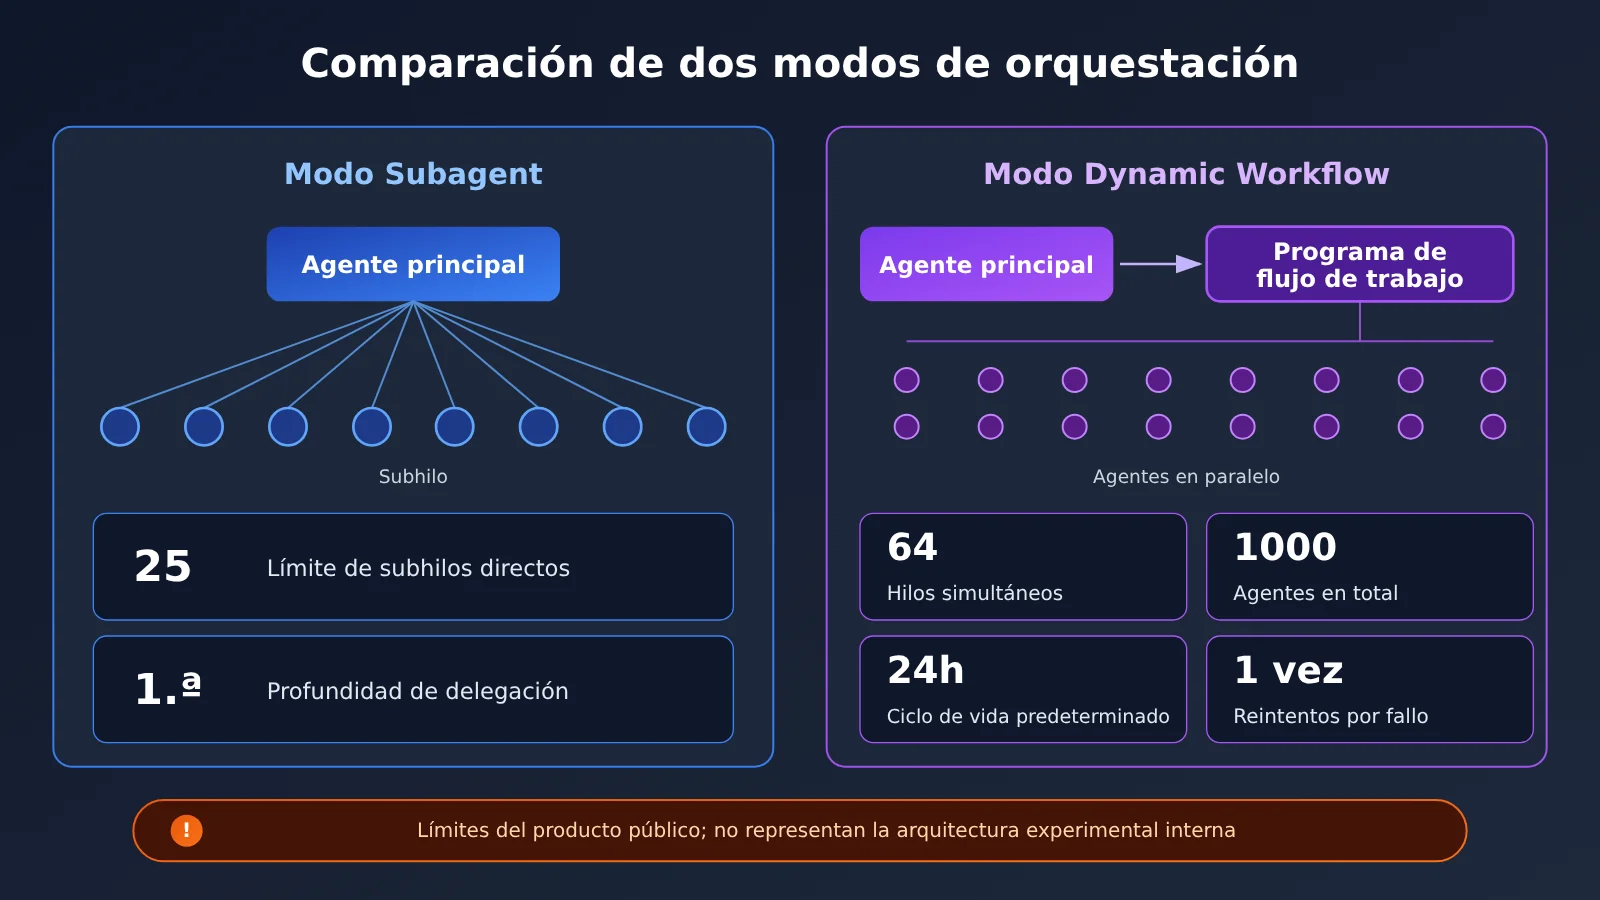
Hay que subrayar que el experimento del sistema operativo fue un proyecto de ingeniería interno de Anthropic, mientras que Managed Agents es un servicio diseñado para su uso como producto. No se puede afirmar, basándose en esto, que el experimento se llevara a cabo con Managed Agents, ni aplicar al experimento el límite de 64 hilos simultáneos. Aun así, estas cifras dejan algo claro: la orquestación de agentes a gran escala no depende solo del modelo, sino también de un planificador, la gestión del estado de las tareas, el control de concurrencia, los mecanismos de reintento y el sistema de presupuestos. Detrás de la cifra de «1000», el trabajo que asume la infraestructura es tan importante como el del modelo.
Límites del prototipo de sistema operativo Claude Fable 5.2
«Que pueda arrancar» es un hito importante, pero todavía queda mucho para que pueda usarse en producción. Sistemas consolidados como Windows, Linux y macOS son el resultado de décadas de adaptación al hardware, refuerzo de la seguridad y mantenimiento por parte de sus comunidades.
| Requisito de ingeniería | Prototipo arrancable (lo que se ha divulgado hasta ahora) | Sistema operativo comercial consolidado |
|---|---|---|
| Compatibilidad con el hardware | Arranca en una computadora portátil real | Compatible con una gran variedad de combinaciones de chips, periféricos y firmware |
| Seguridad | No consta que haya pasado una auditoría de seguridad independiente | Respuesta continua a vulnerabilidades, aislamiento de permisos y mecanismos de parches |
| Fiabilidad a largo plazo | No se han divulgado pruebas de funcionamiento prolongado | Probado por una gran cantidad de usuarios y durante largos periodos |
| Mantenimiento del sistema | No se han publicado el código fuente ni el proceso de compilación | Gestión de versiones, ciclos de lanzamiento y soporte a largo plazo |
| Auditoría del código | No se han publicado la cantidad de líneas de código ni la documentación de arquitectura | Código auditable y documentación de arquitectura completa |
| Reproducibilidad | Todavía no hay una reproducción independiente de terceros | Proceso de compilación público y reproducible |
El objetivo de esta tabla no es restar valor al experimento, sino aclarar qué demuestra. El experimento demuestra que un modelo puede coordinar un proyecto de ingeniería de software con varios módulos durante un periodo prolongado y entregar un resultado cuyos subsistemas funcionan realmente en conjunto. No demuestra que un sistema operativo escrito por IA pueda sustituir directamente a los productos existentes.
Los ingenieros humanos siguen siendo fundamentales en proyectos de este tipo. La definición de objetivos, las decisiones de arquitectura, los límites de seguridad y la aceptación final siguen siendo responsabilidad de las personas. La propia Anthropic lo expresa con cautela: Claude escribió el 90 % del código fusionado, pero lo hizo «con orientación humana».
La conclusión más prudente es que la IA ya ha demostrado su capacidad para coordinar proyectos de software complejos, pero eso no significa que los equipos de ingeniería de software consolidados puedan prescindir de las personas.
El impacto de Claude Fable 5.2 en los desarrolladores
De las llamadas puntuales a los flujos de trabajo de agentes de larga duración
La mayoría de los desarrolladores no se pondrá a crear un sistema operativo a corto plazo. Sin embargo, la forma de trabajar que revela este experimento irá incorporándose poco a poco a proyectos cotidianos, como revisiones de código por lotes, refactorizaciones a nivel de repositorio, migraciones entre lenguajes y auditorías de seguridad.
En estos casos, la atención de los desarrolladores pasará de «¿qué tal ha sido la respuesta de esta llamada?» a varias cuestiones más propias de la ingeniería:
- Gestión de tareas: cómo dividir las tareas, registrar el estado de cada subtarea y reanudarlas desde el punto en que fallaron.
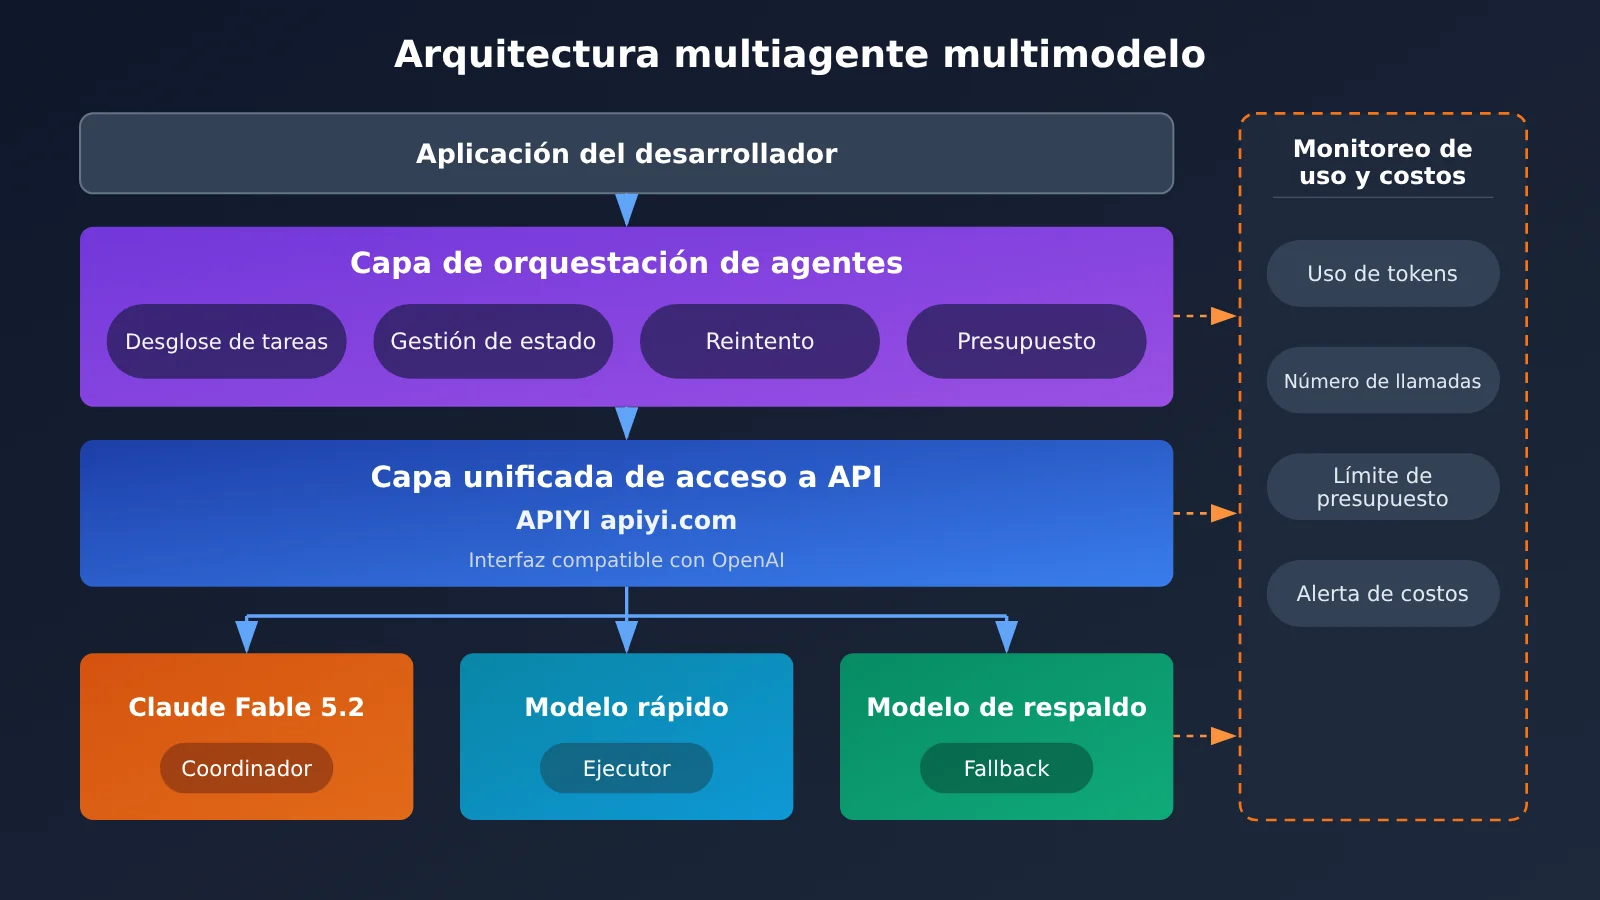
- Reparto del trabajo entre modelos: en el caso de Datadog, Fable 5.2 recurre a un «modelo más rápido» para recopilar información. Usar un modelo potente como coordinador y modelos más rápidos o económicos para ejecutar tareas es una estructura de costos habitual.
- Estabilidad de las llamadas: un flujo de trabajo puede incluir cientos o miles de llamadas. Aunque la tasa de fallos de cada llamada sea baja, los errores se acumulan y pueden provocar interrupciones frecuentes, por lo que hacen falta mecanismos de reintento y conmutación por error.
- Control del presupuesto: la tarifa pública de la API de Fable 5.2 es de 8 dólares por millón de tokens de entrada y 40 dólares por millón de tokens de salida. El precio de Fast Mode se duplica. Anthropic no ha publicado el costo real del experimento del sistema operativo, pero es fácil imaginar que el gasto de las tareas de agentes múltiples y larga duración deberá supervisarse de forma continua.
- Supervisión de tareas: hace falta saber qué está haciendo cada agente, cuánto consume y dónde se ha quedado atascado.
Ese mismo día, Vercel anunció la integración de Fable 5.2 en AI Gateway, con conmutación por error entre proveedores, modelos de respaldo, estadísticas de uso y costos, además de reglas para presupuestos y reintentos. Esto demuestra que la infraestructura para invocar modelos en aplicaciones complejas con agentes está empezando a tomar forma.
Cómo llamar a Claude Fable 5.2 con una interfaz compatible con OpenAI
El ID oficial del modelo en la API de Fable 5.2 es claude-fable-5-2. Admite una ventana de contexto de 1M tokens y genera hasta 128K tokens. Esta es la forma más sencilla de llamarlo mediante una interfaz compatible con OpenAI (usa el nombre del modelo que aparece en la lista de modelos de la consola de la plataforma):
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "把这个 Python 模块的迁移计划拆成可并行的子任务"}]
)
print(resp.choices[0].message.content)
Ver el ejemplo completo: coordinador + ejecutores en paralelo + reintentos y control del presupuesto
A continuación se muestra una implementación simplificada en la que un coordinador divide las tareas y varios ejecutores las procesan en paralelo. Incluye reintentos en caso de error y un control aproximado del presupuesto de tokens. Es solo un ejemplo de un enfoque de ingeniería general; no es la implementación real del experimento de Anthropic sobre sistemas operativos.
import json
import openai
from concurrent.futures import ThreadPoolExecutor, as_completed

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI para cambiar entre modelos de distintos proveedores
)

PLANNER_MODEL = "claude-fable-5-2"   # Coordinador: se encarga de dividir y resumir las tareas
WORKER_MODEL = "gpt-4o-mini"         # Ejecutor: sustitúyelo por el modelo rápido que uses
TOKEN_BUDGET = 200_000               # Presupuesto de tokens para todo el flujo de trabajo
MAX_WORKERS = 8                      # Límite de concurrencia; ajústalo según tus necesidades
used_tokens = 0


def chat(model, prompt, max_tokens=2000):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,停止派发新任务")
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    used_tokens += resp.usage.total_tokens
    return resp.choices[0].message.content


def plan(goal):
    prompt = (
        f"目标:{goal}\n"
        "请拆成 3-6 个可以独立完成的子任务,"
        '只输出 JSON 数组,格式为 [{"id": 1, "task": "..."}]'
    )
    return json.loads(chat(PLANNER_MODEL, prompt))


def run_task(item, retries=1):
    for attempt in range(retries + 1):
        try:
            return item["id"], chat(WORKER_MODEL, item["task"])
        except Exception as e:
            if attempt == retries:
                return item["id"], f"失败:{e}"


def workflow(goal):
    tasks = plan(goal)
    results = {}
    with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
        futures = [pool.submit(run_task, t) for t in tasks]
        for f in as_completed(futures):
            tid, out = f.result()
            results[tid] = out
    summary_prompt = "汇总以下子任务结果,检查相互之间是否冲突:\n" + json.dumps(
        results, ensure_ascii=False
    )
    return chat(PLANNER_MODEL, summary_prompt, max_tokens=4000)


if __name__ == "__main__":
    print(workflow("为一个小型 Web 服务设计从 Python 迁移到 Rust 的方案"))
    print(f"累计消耗 Token:{used_tokens}")
🚀 Consejo para empezar rápido: al crear flujos de trabajo multiagente con varios modelos, el coordinador y los ejecutores suelen ser de distintos proveedores. Con APIYI en apiyi.com puedes usar una misma clave API para llamar a modelos populares de Claude, OpenAI, Gemini y otros. El cobro es por uso y los nuevos usuarios reciben crédito gratuito para hacer pruebas, así que puedes validar la orquestación y los costos con tareas pequeñas.
Preguntas frecuentes
P1: ¿Qué logró exactamente el experimento del sistema operativo de Claude Fable 5.2?
Según la información publicada por Anthropic, Fable 5.2 partió de una carpeta vacía y coordinó el trabajo continuo de más de 1000 subagentes durante 8 días para crear un prototipo de sistema operativo capaz de arrancar en una computadora portátil real. Incluye un kernel, controladores de disco, teclado y red, almacenamiento permanente de archivos, un sistema de ventanas, una interfaz de inicio de sesión, un instalador y funciones integradas de Claude.
P2: ¿Los 1000 agentes de IA funcionaban al mismo tiempo?
La empresa no ha publicado esa información. Que «participaran más de 1000 subagentes» no significa que los 1000 agentes estuvieran activos al mismo tiempo durante todo el proceso, ni que fueran 1000 ingenieros independientes. El límite de concurrencia publicado para un flujo de trabajo individual de Managed Agents es de 64 procesos simultáneos, con un máximo de 1000 agentes iniciados a lo largo de su ciclo de vida. Sin embargo, se trata de un límite del producto y no se puede extrapolar al experimento interno.
P3: ¿Este sistema operativo creado por IA puede sustituir a Windows o Linux?
No. La descripción oficial lo presenta como un «prototipo funcional». Por ahora, no se han publicado el código fuente, la documentación de arquitectura, las pruebas de compatibilidad con distintos equipos ni una auditoría de seguridad independiente. Tampoco hay una reproducción independiente del experimento. Lo que demuestra es la capacidad de la IA para organizar proyectos de ingeniería complejos, no la madurez de un producto.
P4: ¿Cuáles son el precio y las especificaciones de la API de Claude Fable 5.2?
El precio público es de 8 dólares por millón de tokens de entrada y 40 dólares por millón de tokens de salida, un 20 % menos que el modo normal de Fable 5.1. El modo rápido duplica el precio y alcanza una velocidad de salida de hasta 2,5 veces la del modo normal. La ventana de contexto es de 1 M de tokens y el máximo de salida es de 128 K tokens. Batch API ofrece un descuento del 50 % tanto en la entrada como en la salida. Estos son los precios públicos, no el costo real del experimento del sistema operativo.
P5: ¿Cómo pueden los desarrolladores empezar rápidamente a usar la API de Claude Fable 5.2 para hacer experimentos con agentes?
Puedes empezar validando la lógica de orquestación con una tarea pequeña:
1. Regístrate en APIYI apiyi.com y obtén una clave API y crédito gratuito para pruebas.
2. En el ejemplo de este artículo, configura `base_url` como `https://api.apiyi.com/v1`. Consulta la lista de modelos en la consola para confirmar el nombre del modelo.
3. Primero completa el ciclo mínimo de «descomponer tareas → ejecutarlas en paralelo → resumir los resultados» y luego añade poco a poco los reintentos y el control del presupuesto.
P6: ¿Dónde suelen fallar con más facilidad los flujos de trabajo prolongados con varios agentes?
Los problemas suelen concentrarse en tres áreas. La primera es la falta de control de los costos: el número de llamadas aumenta con la cantidad de agentes, así que es necesario fijar un límite de presupuesto. La segunda son los errores acumulados: los fallos ocasionales de una llamada se amplifican en una cadena larga, por lo que hacen falta reintentos y modelos de respaldo. La tercera es el costo de coordinación: si no se aclaran las dependencias entre tareas, el trabajo en paralelo puede provocar conflictos en el código. Con APIYI apiyi.com puedes acceder a varios modelos desde un único punto, configurar modelos de respaldo con más facilidad y consultar el uso de forma centralizada.
Claude Fable 5.2 y 1000 agentes de IA: puntos clave
- Hechos del experimento: más de 1000 subagentes, 8 días y un prototipo de sistema operativo que pasó de una carpeta vacía a poder arrancar.
- El verdadero avance: el modelo empieza a hacerse cargo de desglosar tareas, ejecutarlas en paralelo, corregir problemas de forma continua e integrar resultados.
- Señales de uso en producción: Claude escribe más del 90 % del código que se fusiona en Anthropic, y la migración a Rust aceleró el arranque unas 26 veces.
- Límites de la cifra: 1000 agentes no equivalen a 1000 ingenieros independientes trabajando en paralelo durante todo el proceso.
- Límites del prototipo: sin una auditoría ni una reproducción independientes, todavía queda mucho camino para llegar a un sistema operativo comercial maduro.
- Lo importante para los desarrolladores: la planificación, los reintentos, el presupuesto y la supervisión son tan importantes como las capacidades del modelo. Puedes usar APIYI (apiyi.com) para conectar varios modelos desde un mismo lugar.
Resumen
La noticia de que 1000 agentes de IA crearon un sistema operativo en 8 días merece atención no tanto por la cifra, sino por tres motivos:
- Ha cambiado el tipo de capacidad: Claude Fable 5.2 demuestra capacidad para organizar el trabajo de ingeniería, no solo para generar código.
- Hay que evaluar las pruebas por separado: el experimento del sistema operativo, los datos internos de producción y las primeras opiniones de empresas son pruebas de distinta naturaleza.
- Las personas siguen siendo la última pieza: el prototipo puede arrancar, pero las decisiones de arquitectura, la seguridad y la aceptación final siguen siendo responsabilidad de los ingenieros.
Para los desarrolladores, el siguiente paso es pasar de las «invocaciones puntuales» a los «flujos de trabajo de larga duración» y pensar de antemano en cómo repartir las tareas entre modelos, garantizar la estabilidad de las invocaciones y controlar los costos. Puedes conectar varios modelos líderes con una sola clave API a través de APIYI (apiyi.com) y empezar validando tareas de agentes a pequeña escala.
📚 Referencias
- Anuncio oficial de Anthropic: Claude Fable 5.2 and Mythos 5.2 (2026-11-09)
- Enlace:
anthropic.com/claude-fable-and-mythos-5-2 -
Descripción: fuente de primera mano sobre los experimentos con sistemas operativos, los datos internos de producción y los comentarios de empresas
-
Documentación de especificaciones de modelos de Claude Platform: Fable 5.2 Overview
- Enlace:
platform.claude.com/docs/en/models/fable-5-2/overview -
Descripción: especificaciones como la ventana de contexto, la salida máxima y el ID del modelo
-
Documentación de orquestación multiagente de Managed Agents: Subagent y Dynamic Workflow
- Enlace:
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
Descripción: límites públicos de concurrencia de hilos, número de agentes y ciclo de vida
-
Anuncio de integración de Vercel AI Gateway: Claude Fable 5.2 now available on AI Gateway
- Enlace:
vercel.com/changelog/claude-fable-5-2-now-available-on-ai-gateway -
Descripción: capacidades de conmutación por error, presupuestos y reintentos de una puerta de enlace API de terceros
-
Artículo de The Verge: Anthropic launches new Claude Fable and Mythos 5.2 models
- Enlace:
theverge.com/ai-artificial-intelligence/1030005/anthropic-claude-fable-mythos-5-2 - Descripción: cobertura del lanzamiento publicada por un medio independiente
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes contactar con nosotros desde la página de inicio del sitio web de APIYI. Encontrarás más información de integración en el centro de documentación docs.apiyi.com.