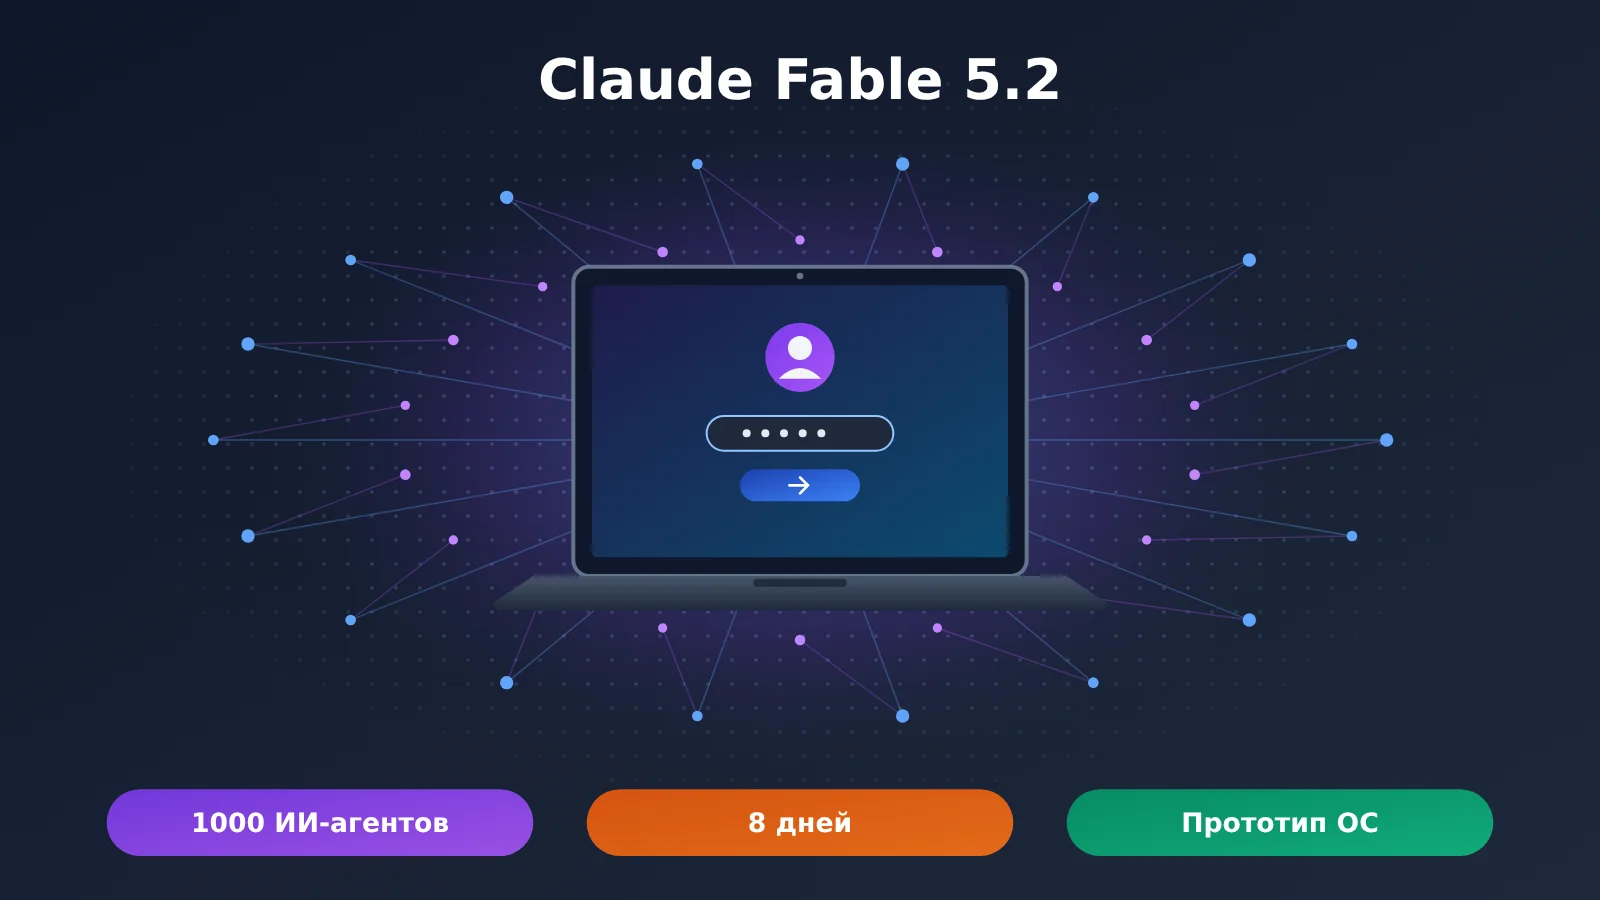
На ноутбуке загорается экран, и на нём появляется не Windows и не какой-нибудь дистрибутив Linux, а система, которую ИИ собрал с нуля, начав с пустой папки. 9 ноября 2026 года Anthropic рассказала об этом внутреннем эксперименте, выпуская Claude Fable 5.2: Fable 5.2 координировала работу более 1000 дочерних Agent, которые без перерыва трудились 8 дней и создали прототип операционной системы, способный загружаться на настоящем ноутбуке.
Главное: на примере эксперимента с операционной системой мы разберём, в чём заключается настоящий прорыв Claude Fable 5.2, как понимать работу этих 1000 AI Agent и насколько прототип далёк от готового продукта. В заключение посмотрим с точки зрения разработчика, каких требований к инфраструктуре API требуют длительные рабочие процессы с Agent.
Ключевые факты об эксперименте с операционной системой Claude Fable 5.2
Начнём с фактов, которые официально подтвердила Anthropic. В таблице собраны только сведения из её анонса.
| Пункт | Подробности |
|---|---|
| Дата публикации | 9 ноября 2026 года, объявление вышло вместе с Claude Fable 5.2 |
| Кто проводил | Anthropic (внутренний инженерный эксперимент) |
| Начало задачи | Инженер поставил задачу: с нуля, начиная с пустой папки, спроектировать и реализовать прототип операционной системы |
| Масштаб работы | Более 1000 субагентов работали круглосуточно в течение 8 дней |
| Основные действия | Написание кода, тестирование компонентов, проверка кода и исправление ошибок |
| Итоговые возможности | Ядро, драйверы диска / клавиатуры / сети, постоянное файловое хранилище, оконная система, экран входа, установщик, встроенные функции Claude |
| Ключевая проверка | Систему удалось запустить на настоящем ноутбуке |
| Пока не опубликовано | Исходный код и процесс сборки, документация по архитектуре, количество строк кода, архитектура взаимодействия агентов, расход токенов, стоимость эксперимента, результаты тестирования на совместимость с разным оборудованием, независимый аудит безопасности |
Из каких модулей состоит операционная система, созданная 1000 AI-агентами
Кратко разберём назначение нескольких ключевых модулей. Ядро — центральная часть ПО, которая управляет оборудованием и системными ресурсами: планирует выполнение процессов, распределяет память и обрабатывает прерывания. Драйверы обеспечивают связь операционной системы с оборудованием — дисками, клавиатурами и сетевыми картами. Без драйверов ядро просто «не увидит» периферийные устройства.
Постоянное файловое хранилище означает, что данные сохраняются после перезагрузки. Для этого системе нужна настоящая файловая система, а не демонстрация, которая работает только в памяти.
Оконная система, экран входа и установщик — это уже части, с которыми взаимодействует пользователь. На установщик стоит обратить особое внимание: он показывает, что системе удалось пройти весь путь — «записать данные на диск, а затем загрузиться с него».
Только рассмотрев все эти модули вместе, можно понять, почему возможность «загрузиться на ноутбуке» — серьёзный результат. Для этого подсистемы должны действительно работать сообща, а не просто содержать несколько фрагментов кода, которые выглядят правильными сами по себе.
Так мы подходим к главному вопросу статьи: как более 1000 агентов смогли вместе создать полноценный программный продукт?
Прорыв Claude Fable 5.2: ИИ начинает организовывать разработку
Fable 5.2 заметно улучшила результаты на тестах по программированию. По данным Anthropic, результат на FrontierCode 2.0 составил 49,1% против 32,4% у предыдущей версии Fable 5.1. На FrontierSWE v2 модель набрала 69,9%, тогда как предыдущая версия — 56,3%.
Однако это общие тесты по программированию, а не результаты самого эксперимента с операционной системой. В эксперименте важнее не то, насколько хорошо модель пишет код, а то, как изменился подход к организации разработки.
Чем традиционный ИИ-помощник по программированию отличается от долгосрочной разработки с агентами
Традиционный ИИ-помощник по программированию работает в режиме «вопрос — ответ»: пользователь формулирует задачу, ИИ пишет фрагмент кода, пользователь проверяет его и просит внести изменения — и так по кругу. В этой модели человек разбивает задачу на части, следит за ходом работы и собирает всё воедино, а ИИ выступает лишь очень эффективным исполнителем.
В долгосрочной разработке с агентами модели передаётся больше ответственности. В таблице ниже сравниваются эти два подхода:
| Параметр | Традиционный ИИ-помощник по программированию | Долгосрочная разработка с агентами |
|---|---|---|
| Размер задачи | Отдельная функция, файл или возможность | Целый проект, который нужно самостоятельно разбить на подзадачи |
| Продолжительность работы | Один диалог — от нескольких минут до нескольких часов | Непрерывная работа в течение нескольких часов или дней |
| Способ выполнения | Один поток, ожидание обратной связи от человека | Несколько субагентов параллельно работают над разными модулями |
| Контроль качества | В основном ручная проверка | Автоматические тесты, перекрёстная проверка и постановка задач на исправление обнаруженных проблем |
| Интеграция | Выполняется человеком | Координатор собирает результаты и проверяет совместимость модулей |
| Роль человека | Поэтапно направляет работу | Ставит цель, следит за процессом и принимает итоговый результат |
Для таких проектов, как операционная система, именно правая колонка и представляет собой главную сложность. Между ядром, драйверами и файловой системой существует множество интерфейсных соглашений, и изменение одного модуля может привести к сбою тестов другого.
Способность в течение 8 дней находить проблемы, организовывать их исправление и продвигать незавершённые задачи показывает умение «управлять проектом», а не просто «писать код».
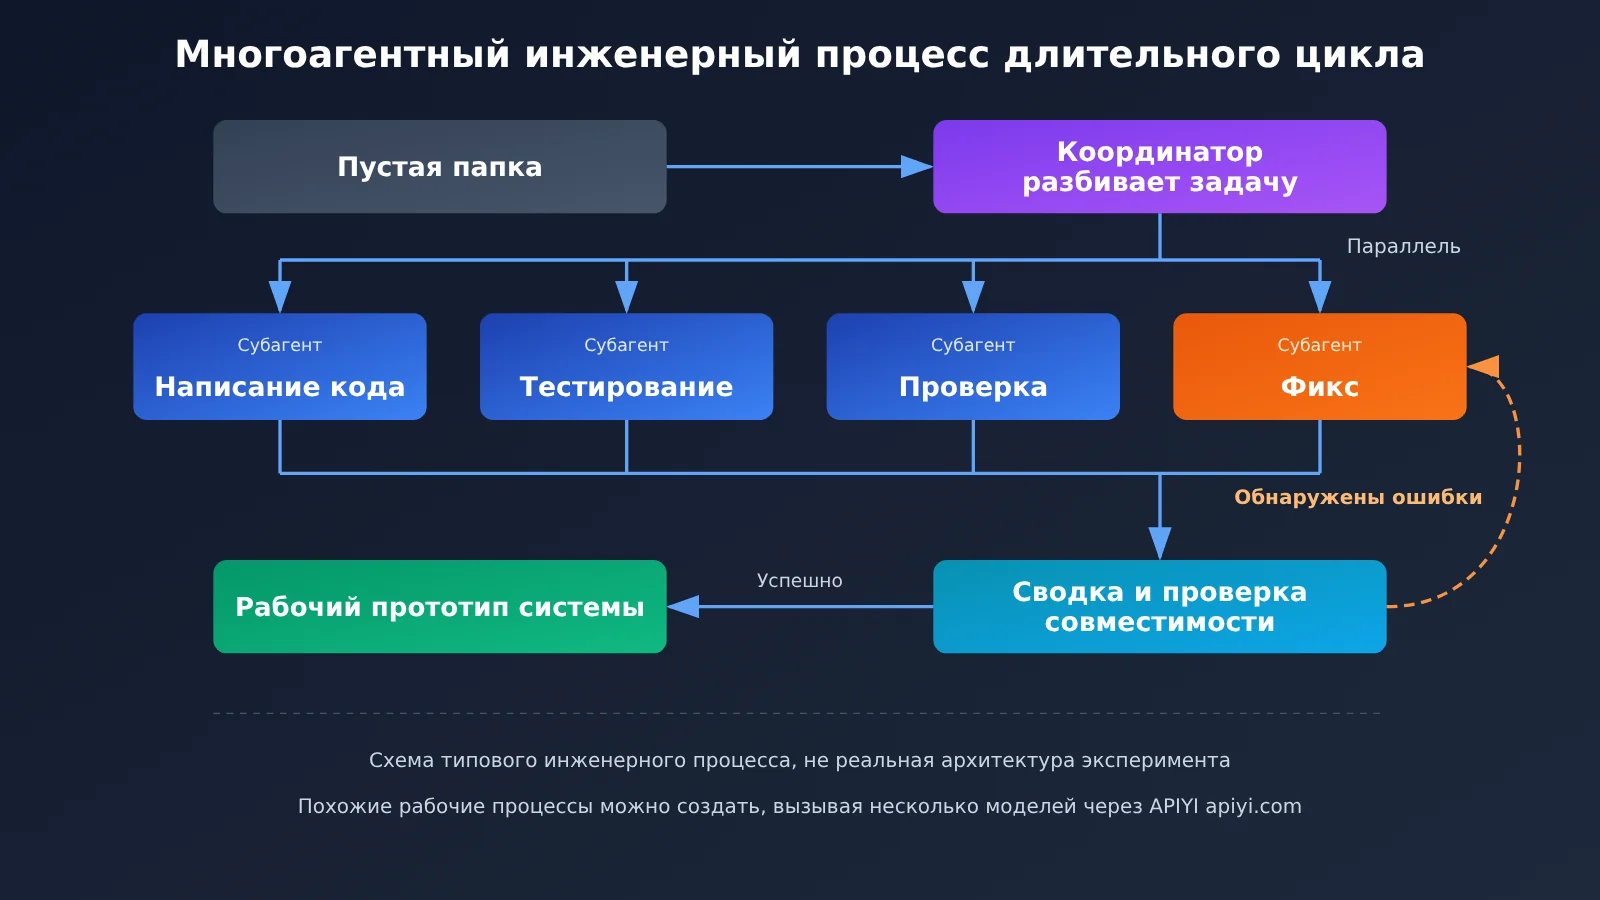
Важно отметить, что схема выше — это анализ общего процесса крупных инженерных проектов. Anthropic не раскрывала подробности распределения задач, Harness, протоколов взаимодействия или языков программирования, использованных в эксперименте с операционной системой.
В другом эксперименте того же периода, посвящённом Великой теореме Ферма, сообщалось о таких деталях архитектуры, как «1 ведущий + 999 помощников». Но это был отдельный эксперимент, и его результаты нельзя напрямую переносить на проект операционной системы.
Роль «координатора» в глазах первых корпоративных тестировщиков
При запуске Anthropic опубликовала отзывы нескольких первых партнёров по тестированию. Это практический опыт корпоративных инженеров, а не результаты независимого слепого тестирования, но все отзывы указывают на одну тенденцию: модель начинает брать на себя планирование и координацию.
- Vercel: Джо Хаддад (технический специалист) рассказал, что проект, на который с другими моделями ушло бы несколько недель, удалось завершить за несколько дней с помощью Fable 5.2 и пройти командную проверку. Ревьюерам кода также пришлось предложить меньше доработок.
- Shopify: Том Притчард (ведущий инженер) отметил, что модель может принять достаточно общую идею, в ходе нескольких раундов общения сформировать план и самостоятельно выполнить последующую работу. По ощущениям это похоже на сотрудничество с другим ведущим инженером.
- Datadog: Мэтт Ли (старший ведущий инженер) сравнил модель с командиром, координирующим устранение инцидента (Incident Commander). При работе с незнакомой системой она обращается к более быстрым моделям за информацией, а затем координирует выполнение разных задач, снижая нагрузку на оператора.
- Uber: Эндрю Мейджер (ведущий инженер по агентным системам) рассказал о проверке безопасности, которая непрерывно шла 10–12 часов. Модель распределила работу между примерно 170 агентами-проверяющими и подготовила отчёт об аудите, pull request’ы с исправлениями и рекомендации по политике безопасности. Он отдельно подчеркнул, что модель продолжает работу, пока задача действительно не будет завершена, а не останавливается, получив промежуточный результат, который лишь выглядит убедительно.
Случай Uber по форме больше всего напоминает эксперимент с операционной системой: в обоих случаях одна модель распределяла работу между большим числом субагентов, чтобы выполнить длительную задачу. Однако это совершенно независимые проекты.
Claude Fable 5.2 уже работает в реальной production-среде
Если бы речь шла только об эксперименте с операционной системой, его можно было бы принять за тщательно подготовленную демонстрацию. Но две группы внутренних данных, которые Anthropic опубликовала одновременно, показывают: такие инженерные возможности уже применяются в повседневной разработке ПО.
Первый показатель — доля кода, написанного моделью. По словам Anthropic, Claude написал более 90% изменений кода, которые в итоге попали в основную кодовую базу компании. При этом модель работала под руководством человека. Речь именно о доле изменений, написанных Claude, а не о том, что 90% разработки проходило без участия людей. И это не значит, что весь этот код написала Fable 5.2.
Второй пример — перенос production-сервиса. Команда агентов, использовавшая раннюю версию Fable 5.2, перенесла критически важный сервис из Python на Rust. После миграции повысились эффективность и надёжность сервиса, а запуск ускорился примерно в 26 раз. Перенос на другой язык — типичная задача, которая занимает много времени и требует постоянных проверок. Чтобы обеспечить такое же поведение, тестирование и исправление ошибок часто важнее самого перевода кода.
Эти примеры относятся к разным категориям — ниже они разделены по типам:
| Пример | Тип | Источник данных | Что показывает | Чего не доказывает |
|---|---|---|---|---|
| Прототип операционной системы | Внутренний эксперимент Anthropic | Официальный анонс и демонстрация | Модель может организовать длительную разработку сложного проекта с множеством модулей | Что прототип уже соответствует уровню коммерческой ОС или воспроизведён независимой третьей стороной |
| 90% кода в принятых изменениях написано Claude | Внутренние данные о production-разработке | Официальный анонс | ИИ глубоко вовлечён в повседневное написание кода | Что код не нуждается в проверке человеком |
| Перенос с Python на Rust | Внутренний production-кейс | Официальный анонс | Инженерия с использованием агентов может помогать оптимизировать реальную инфраструктуру | Что при этом применялись те же методы, что и в эксперименте с ОС |
| Отзывы Vercel / Shopify / Datadog / Uber | Опыт участников раннего тестирования | Цитаты из официального анонса | Инженеры компаний оценили способность модели координировать работу на практике | Что такие отзывы могут заменить независимые бенчмарки |
Если рассматривать эти примеры вместе, они показывают, как расширяются возможности ИИ в инженерной работе. Но это не значит, что любой проект можно вести без контроля человека.
Что на самом деле означает «1000 AI-агентов»
«1000 агентов» — самая заметная и в то же время самая легко поддающаяся неверной трактовке цифра в этом эксперименте.
Общее число агентов — не то же самое, что число одновременно работающих
Прежде всего, Anthropic сообщила, что в эксперименте участвовало «более 1000 субагентов», но не уточнила, работали ли они одновременно. За 8 дней субагенты, скорее всего, запускались партиями: выполняли задачи и завершали работу, после чего их сменяли новые агенты.
Кроме того, 1000 агентов — это не 1000 одинаково способных и полностью независимых инженеров. Реальная эффективность зависит от того, насколько задачи можно распараллелить, а также от накладных расходов на координацию, общего состояния системы, конфликтов в коде, покрытия тестами и стоимости вызовов.
Наглядный пример: пока не определена система управления памятью ядра, продвинуться в работе над файловой системой и драйверами будет сложно. Именно такие зависимости не позволяют бесконечно разбивать крупный проект на параллельные задачи.
Два режима оркестрации в публичном Managed Agents
Документация Anthropic по Managed Agents для разработчиков позволяет заглянуть в то, как устроена готовая к использованию мультиагентная система. В ней описаны два режима оркестрации.
Режим Subagent: главный агент может создавать субагентов. У каждого из них есть отдельный поток сессии и история контекста, а главный агент может отправлять им новые задачи. В одной сессии может одновременно существовать не более 25 прямых дочерних потоков; прямая делегация поддерживает только один уровень вложенности.
Режим Dynamic Workflow: предназначен для более масштабных задач. Сначала главный агент пишет программу рабочего процесса. Она запускает несколько агентов параллельно, собирает результаты каждого этапа и определяет дальнейшие шаги на основе предыдущих результатов. Если агент завершился с ошибкой, сервер обычно повторно запускает его один раз в новом потоке. Официальная документация устанавливает следующие ограничения:
| Показатель | Официальное ограничение |
|---|---|
| Число потоков, одновременно работающих в одном рабочем процессе | 64 (настраиваемый лимит продукта; Anthropic не гарантирует, что он всегда будет достигнут) |
| Число агентов, запускаемых за весь жизненный цикл рабочего процесса | 1000 |
| Жизненный цикл рабочего процесса по умолчанию | 24 часа |
| Число рабочих процессов, которые могут одновременно работать в одной сессии по умолчанию | 10 |
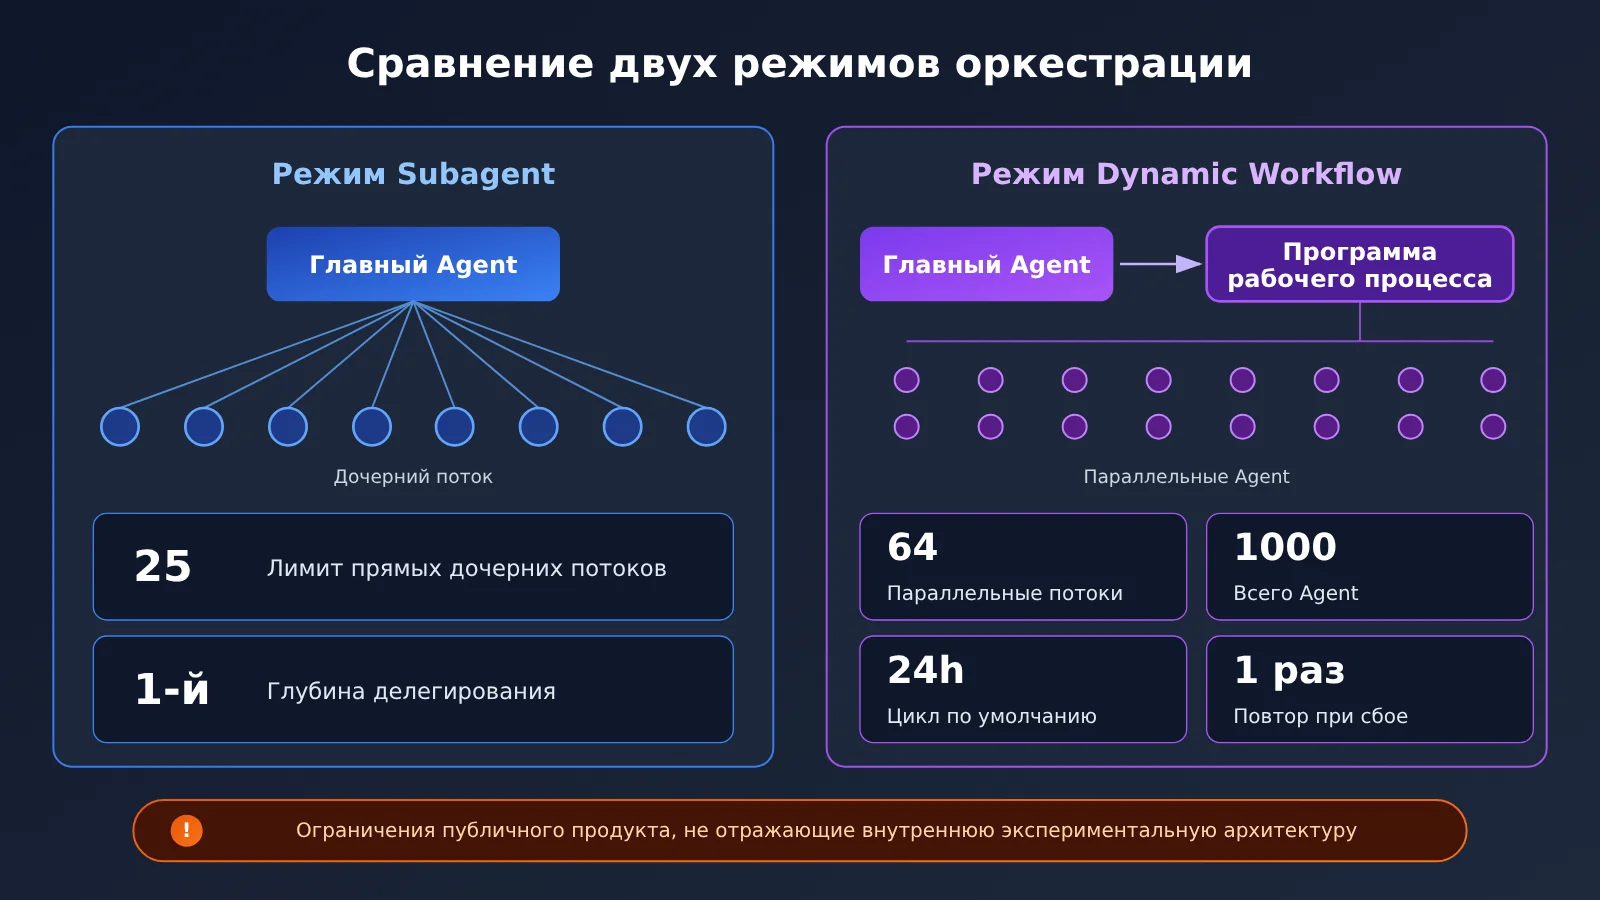
Важно подчеркнуть: эксперимент с операционной системой — это внутренний инженерный проект Anthropic, а Managed Agents — публичный продукт. Нельзя утверждать, что эксперимент проводился с помощью Managed Agents, или переносить на него лимит в 64 параллельных потока. Но эти цифры показывают: масштабная оркестрация агентов зависит не только от самих моделей — нужны планировщик, управление состоянием задач, контроль параллельного выполнения, механизм повторных попыток и система управления бюджетом. За цифрой «1000» стоят инфраструктурные решения, не менее важные, чем сами модели.
Границы прототипа операционной системы Claude Fable 5.2
«Запускается» — важный этап, но между ним и «готово к промышленной эксплуатации» ещё большая дистанция. За зрелыми системами вроде Windows, Linux и macOS стоят десятилетия работы над поддержкой оборудования, усилением безопасности и поддержкой сообщества.
| Требование к разработке | Запускаемый прототип (известно на данный момент) | Зрелая коммерческая операционная система |
|---|---|---|
| Совместимость с оборудованием | Запускается на одном реальном ноутбуке | Поддерживает множество сочетаний чипов, периферийных устройств и прошивок |
| Безопасность | Нет данных о независимом аудите безопасности | Постоянная работа с уязвимостями, изоляция прав доступа и механизм установки исправлений |
| Долговременная надёжность | Не сообщалось о тестах длительной работы | Проверена огромным числом пользователей и длительной эксплуатацией |
| Поддержка системы | Исходный код и процесс сборки не опубликованы | Есть управление версиями, цикл выпуска и долгосрочная поддержка |
| Аудит кода | Не опубликованы объём кода и документация по архитектуре | Код доступен для проверки, архитектура подробно документирована |
| Воспроизводимость | Пока никто из сторонних специалистов не повторил эксперимент независимо | Процесс сборки открыт и воспроизводим |
Эта таблица нужна не для того, чтобы принизить эксперимент, а чтобы чётко обозначить, что именно он доказывает. Эксперимент показал, что модель способна на протяжении длительного времени организовывать разработку многокомпонентного программного обеспечения и создавать результат, в котором подсистемы действительно взаимодействуют друг с другом. Но он не доказал, что операционная система, написанная ИИ, может прямо сейчас заменить существующие продукты.
Инженеры по-прежнему играют ключевую роль в таких проектах. Постановка целей, архитектурные компромиссы, определение границ безопасности и окончательная приёмка — ответственность за эти этапы остаётся на людях. Сама Anthropic тоже формулирует вывод осторожно: 90% принятого в проект кода написал Claude, но «под руководством человека».
Самый взвешенный вывод таков: ИИ уже продемонстрировал способность организовывать сложную разработку программного обеспечения, но это не значит, что зрелые команды инженеров могут обходиться без людей.
Как Claude Fable 5.2 повлияет на разработчиков
От разовых вызовов к долгосрочным агентным процессам
Большинство разработчиков в ближайшее время не станет создавать операционную систему. Но подходы к работе, которые показал этот эксперимент, постепенно войдут в повседневную практику — например, при массовом код-ревью, рефакторинге целых репозиториев, миграции на другой язык и аудите безопасности.
В таких задачах разработчики будут думать уже не столько о том, «насколько хорош ответ на этот вызов», сколько о более практических инженерных вопросах:
- Управление задачами: как разбивать работу на этапы, отслеживать статус каждого подзадания и продолжать с контрольной точки после сбоя.
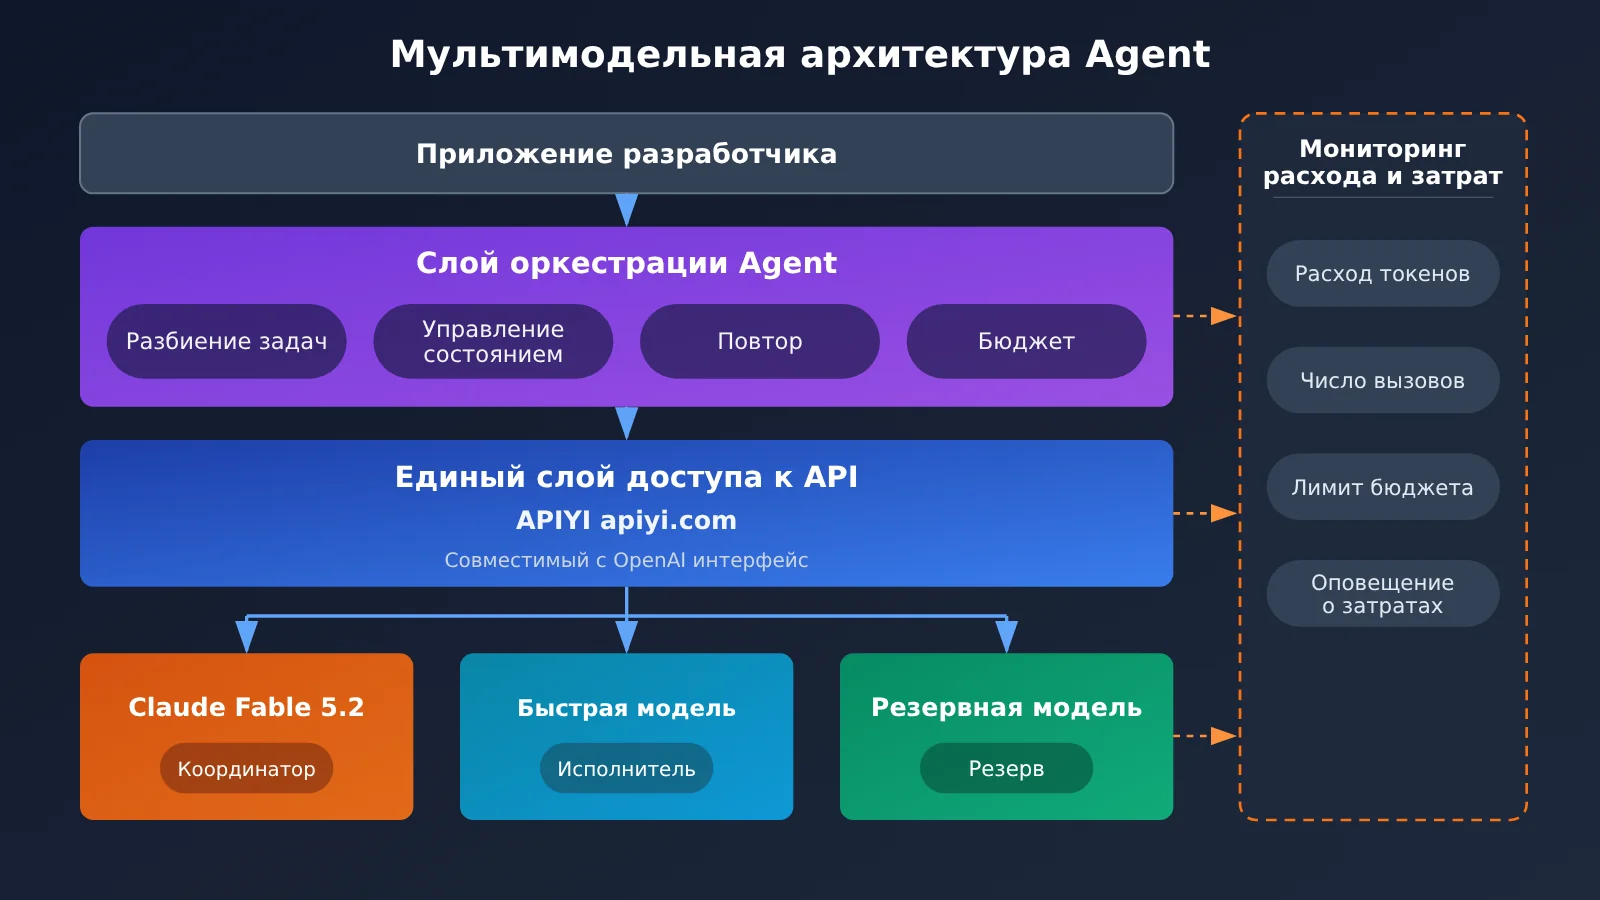
- Распределение задач между моделями: в кейсе Datadog Fable 5.2 обращалась к «более быстрой модели» для сбора информации. Частая схема с точки зрения затрат — поручать координацию мощной модели, а выполнение задач — быстрой или более дешёвой.
- Надёжность вызовов: рабочий процесс может включать сотни и даже тысячи вызовов. Даже при низком проценте сбоев отдельного вызова они будут накапливаться и часто прерывать работу. Поэтому нужны повторные попытки и переключение на резервные варианты.
- Контроль бюджета: в открытом прайс-листе API для Fable 5.2 указана стоимость 8 долларов за миллион входных токенов и 40 долларов за миллион выходных. В Fast Mode цена удваивается. Anthropic не раскрыла фактические расходы на эксперимент с операционной системой, но очевидно, что затраты на долгосрочные задачи с участием нескольких агентов нужно постоянно отслеживать.
- Мониторинг задач: важно понимать, чем занят каждый агент, сколько ресурсов он расходует и где остановился.
В тот же день Vercel объявила о подключении Fable 5.2 к AI Gateway. Сервис поддерживает переключение при сбое поставщика, резервные модели, статистику использования и затрат, а также правила для бюджета и повторных попыток. Это показывает, что инфраструктура для вызова моделей в сложных агентных приложениях постепенно формируется.
Как вызывать Claude Fable 5.2 через совместимый с OpenAI интерфейс
Официальный Model ID для Fable 5.2 — claude-fable-5-2. Модель поддерживает контекстное окно на 1M токенов и вывод объёмом до 128K токенов. Минимальный пример вызова через совместимый с OpenAI интерфейс выглядит так (точное название модели смотрите в списке моделей в консоли платформы):
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "把这个 Python 模块的迁移计划拆成可并行的子任务"}]
)
print(resp.choices[0].message.content)
Посмотреть полный пример: координатор, параллельные исполнители, повторные попытки и контроль бюджета
Ниже приведён упрощённый пример, в котором координатор разбивает задачу на части, а исполнители обрабатывают их параллельно. В нём предусмотрены повторные попытки при ошибках и приблизительный контроль бюджета токенов. Это иллюстрация общего инженерного подхода, а не фактическая реализация эксперимента Anthropic с операционной системой.
import json
import openai
from concurrent.futures import ThreadPoolExecutor, as_completed

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI с возможностью переключаться между моделями разных поставщиков
)

PLANNER_MODEL = "claude-fable-5-2"   # Координатор: разбивает задачи и подводит итоги
WORKER_MODEL = "gpt-4o-mini"         # Исполнитель: замените на используемую вами быструю модель
TOKEN_BUDGET = 200_000               # Бюджет токенов на весь рабочий процесс
MAX_WORKERS = 8                      # Максимальное число параллельных задач; при необходимости измените
used_tokens = 0


def chat(model, prompt, max_tokens=2000):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,停止派发新任务")
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    used_tokens += resp.usage.total_tokens
    return resp.choices[0].message.content


def plan(goal):
    prompt = (
        f"目标:{goal}\n"
        "请拆成 3-6 个可以独立完成的子任务,"
        '只输出 JSON 数组,格式为 [{"id": 1, "task": "..."}]'
    )
    return json.loads(chat(PLANNER_MODEL, prompt))


def run_task(item, retries=1):
    for attempt in range(retries + 1):
        try:
            return item["id"], chat(WORKER_MODEL, item["task"])
        except Exception as e:
            if attempt == retries:
                return item["id"], f"失败:{e}"


def workflow(goal):
    tasks = plan(goal)
    results = {}
    with ThreadPoolExecutor(max_workers=MAX_WORKERS) as pool:
        futures = [pool.submit(run_task, t) for t in tasks]
        for f in as_completed(futures):
            tid, out = f.result()
            results[tid] = out
    summary_prompt = "汇总以下子任务结果,检查相互之间是否冲突:\n" + json.dumps(
        results, ensure_ascii=False
    )
    return chat(PLANNER_MODEL, summary_prompt, max_tokens=4000)


if __name__ == "__main__":
    print(workflow("为一个小型 Web 服务设计从 Python 迁移到 Rust 的方案"))
    print(f"累计消耗 Token:{used_tokens}")
🚀 Совет для быстрого старта: При создании рабочих процессов с несколькими моделями координатор и исполнители часто работают на платформах разных поставщиков. Через APIYI apiyi.com можно вызывать Claude, OpenAI, Gemini и другие популярные модели с помощью одного API-ключа и платить по факту использования. Новым пользователям доступен бесплатный тестовый лимит — удобно сначала проверить логику оркестрации и расходы на небольших задачах.
Часто задаваемые вопросы
Вопрос 1. Что удалось сделать в эксперименте с операционной системой на Claude Fable 5.2?
По данным Anthropic, Fable 5.2 начал работу с пустой папки и в течение 8 дней координировал более 1000 дочерних агентов. В результате получился прототип операционной системы, который запускается на обычном ноутбуке. В него входят ядро, драйверы диска, клавиатуры и сети, постоянное хранилище файлов, оконная система, экран входа, установщик и встроенные функции Claude.
Вопрос 2. Все 1000 ИИ-агентов работали одновременно?
Официальных данных об этом нет. Формулировка «участвовали более 1000 дочерних агентов» не означает, что все они работали одновременно на протяжении всего эксперимента, и тем более не означает, что это были 1000 отдельных инженеров. Для одного рабочего процесса в публичном Managed Agents установлен лимит в 64 параллельных потока и до 1000 запускаемых агентов за весь срок его работы. Но это ограничение продукта, и переносить его на внутренний эксперимент нельзя.
Вопрос 3. Сможет ли эта операционная система, созданная ИИ, заменить Windows или Linux?
Нет. Официально это «работающий прототип». Исходный код и документация по архитектуре не опубликованы, тестов совместимости с разным оборудованием и независимого аудита безопасности нет. Независимого воспроизведения эксперимента тоже не проводилось. Он показывает, что ИИ способен организовать сложную инженерную работу, но не говорит о зрелости продукта.
Вопрос 4. Сколько стоит API Claude Fable 5.2 и каковы его характеристики?
Публичная цена составляет 8 долларов за миллион входных токенов и 40 долларов за миллион выходных. Это на 20% дешевле обычного режима Fable 5.1. Fast Mode стоит вдвое дороже, но выдаёт результат со скоростью до 2,5 раза выше, чем обычный режим. Контекстное окно — 1 млн токенов, максимальный объём вывода — 128 тыс. токенов. На входные и выходные данные в Batch API действует скидка 50%. Это публичные цены, а не фактические расходы на эксперимент с операционной системой.
Вопрос 5. Как разработчику быстро вызвать Claude Fable 5.2 для экспериментов с агентами?
Начните с небольшой задачи, чтобы проверить логику оркестрации:
1. Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ и бесплатный тестовый лимит;
2. В примере из статьи укажите для base_url значение `https://api.apiyi.com/v1`, а точное название модели проверьте в списке в консоли;
3. Сначала проверьте минимальный цикл: «разбить задачу → выполнить параллельно → собрать результаты». Затем постепенно добавляйте повторные попытки и контроль бюджета.
Вопрос 6. Где чаще всего возникают проблемы в длительных рабочих процессах с несколькими агентами?
Обычно проблемы связаны с тремя вещами. Во-первых, расходы могут выйти из-под контроля: число вызовов растёт вместе с количеством агентов, поэтому нужно установить лимит бюджета. Во-вторых, накапливаются ошибки: случайные сбои отдельных вызовов усугубляются в длинной цепочке, поэтому нужны повторные попытки и резервная модель. В-третьих, возникают накладные расходы на координацию: если не разобраться в зависимостях между задачами, параллельная работа может привести к конфликтам в коде. Подключив несколько моделей через APIYI apiyi.com, можно удобнее настроить резервные модели и централизованно отслеживать расход.
Claude Fable 5.2 и 1000 AI-агентов: главное
- Факты эксперимента: более 1000 субагентов, 8 дней — и от пустой папки до запускаемого прототипа операционной системы.
- Главный прорыв: модель начинает брать на себя декомпозицию задач, параллельное выполнение, непрерывное исправление ошибок и объединение результатов.
- Сигналы для продакшена: Claude пишет более 90% кода, который Anthropic принимает в основную ветку; переход на Rust ускорил запуск примерно в 26 раз.
- Ограничения цифр: 1000 агентов — это не 1000 независимых инженеров, которые всё время работают параллельно.
- Ограничения прототипа: без независимого аудита и возможности воспроизвести результат до зрелой коммерческой операционной системы ещё далеко.
- Что важно разработчикам: планирование, повторные попытки, контроль бюджета и мониторинг не менее важны, чем возможности модели. Для единого доступа к нескольким моделям можно использовать APIYI — apiyi.com.
Итоги
В новости о том, как 1000 AI-агентов за 8 дней создали операционную систему, важнее всего не сами цифры, а три вывода:
- Изменился характер возможностей: Claude Fable 5.2 демонстрирует способность организовывать разработку, а не просто генерировать код.
- Доказательства нужно оценивать отдельно: эксперимент с операционной системой, внутренние данные о продакшене и первые отзывы компаний — это доказательства разного типа.
- За человеком остаётся последнее слово: прототип запускается, но архитектурные решения, безопасность и приёмка по-прежнему требуют участия инженеров.
Разработчикам стоит перейти от «одиночных вызовов» к «долгосрочным рабочим процессам» и заранее продумать распределение задач между моделями, стабильность вызовов и контроль затрат. APIYI — apiyi.com — позволяет подключить несколько ведущих моделей с помощью одного API-ключа. Начать можно с небольших задач для агентов, чтобы проверить подход на практике.
📚 Справочные материалы
- Официальный анонс Anthropic: Claude Fable 5.2 and Mythos 5.2 (2026-11-09)
- Ссылка:
anthropic.com/claude-fable-and-mythos-5-2 -
Описание: первоисточник об экспериментах с операционными системами, внутренних производственных данных и отзывах компаний
-
Документация со спецификациями моделей Claude Platform: Fable 5.2 Overview
- Ссылка:
platform.claude.com/docs/en/models/fable-5-2/overview -
Описание: технические характеристики, включая контекстное окно, максимальный объём вывода и Model ID
-
Документация по оркестрации нескольких агентов в Managed Agents: Subagent и Dynamic Workflow
- Ссылка:
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
Описание: ограничения публичного продукта на число параллельных потоков и агентов, а также на время их работы
-
Анонс интеграции с Vercel AI Gateway: Claude Fable 5.2 now available on AI Gateway
- Ссылка:
vercel.com/changelog/claude-fable-5-2-now-available-on-ai-gateway -
Описание: возможности стороннего API-шлюза — переключение при сбоях, управление бюджетом и повторные попытки
-
Материал The Verge: Anthropic launches new Claude Fable and Mythos 5.2 models
- Ссылка:
theverge.com/ai-artificial-intelligence/1030005/anthropic-claude-fable-mythos-5-2 - Описание: оперативный репортаж стороннего СМИ об этом запуске
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами на главной странице сайта APIYI. Дополнительные материалы по интеграции доступны в центре документации docs.apiyi.com