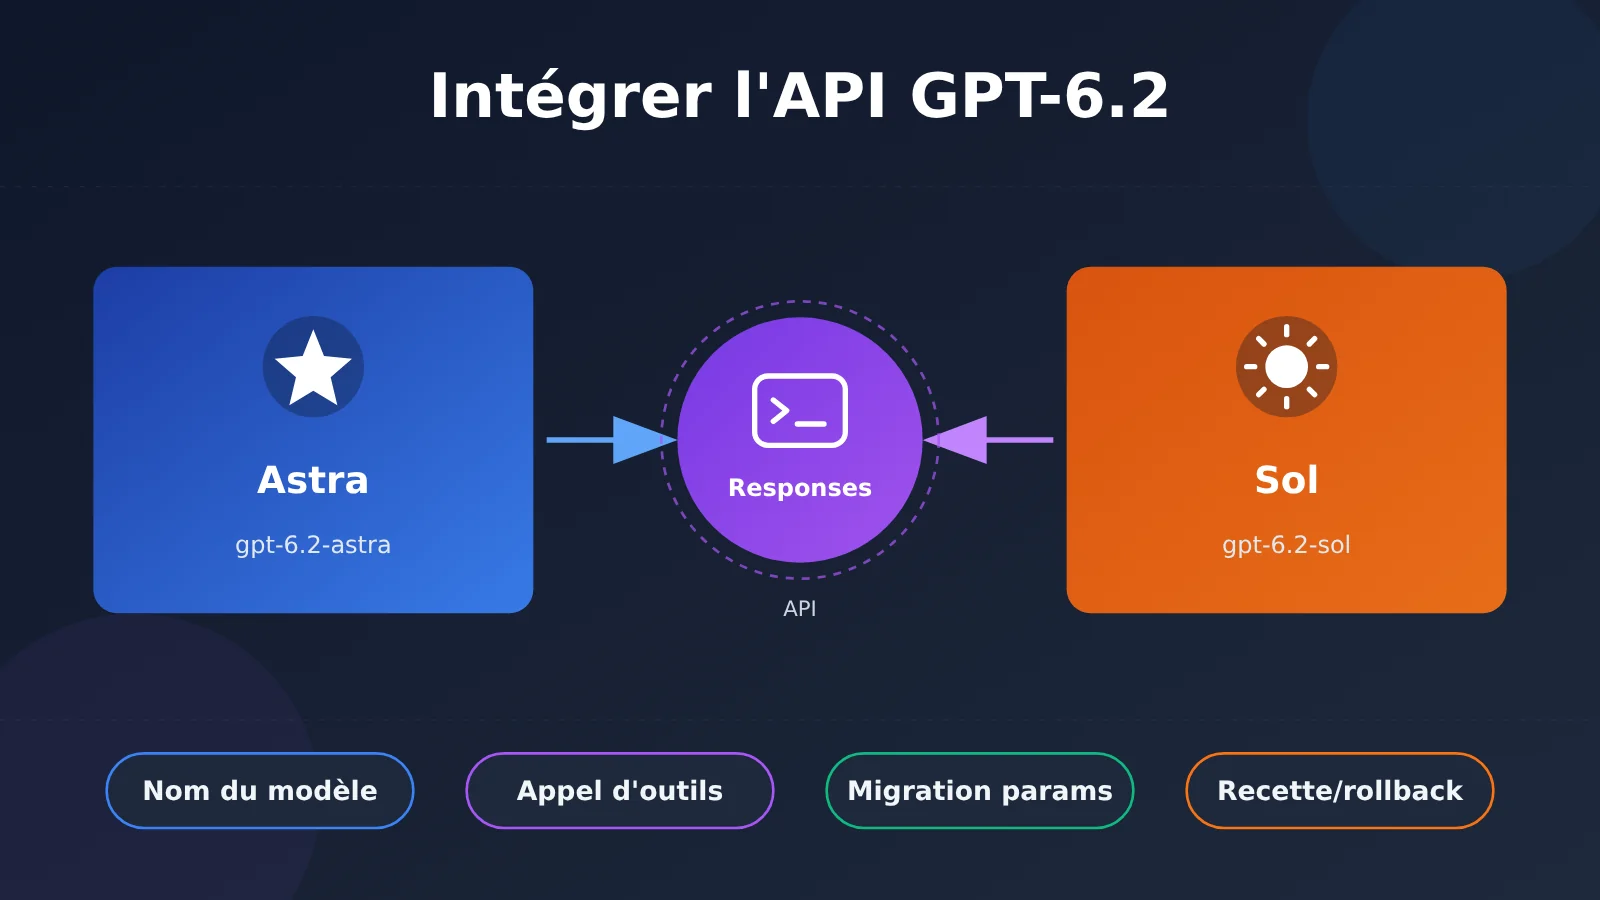
Réponse directe : Pour intégrer l’API GPT-6.2, remplacez le nom du modèle par gpt-6.2-astra ou gpt-6.2-sol. Pour une nouvelle intégration, je recommande de choisir medium comme intensité de raisonnement ; les valeurs none ou minimal présentes dans votre code existant doivent être remplacées par low. Les requêtes purement textuelles peuvent toujours utiliser Chat Completions, mais dès qu’il s’agit d’appels d’outils, vous devez passer à l’API Responses. Il faut aussi supprimer les paramètres d’échantillonnage tels que temperature et top_p. En cas de migration depuis GPT-5.5 ou une version antérieure, remplacez également le paramètre de cache par prompt_cache_options.ttl="30m". Le point le plus souvent négligé dans une migration reste le préfixe d’historique : les nouvelles instructions doivent être ajoutées à la suite de l’historique existant, sans le réécrire.
Que retiendrez-vous de cet article ?
- Quelles informations précises entourent la sortie de GPT-6.2 Astra et Sol par OpenAI le 17 novembre 2026, et quels éléments relèvent de la communication officielle des benchmarks.
- Le tarif standard de l’API pour les deux modèles, ainsi que le facteur de facturation applied lorsque les entrées dépassent 272K.
- Une checklist de migration des paramètres, classée par version : quels changements concernent toutes les migrations GPT-6.2, et lesquels ne s’appliquent qu’à GPT-5.5 et aux versions antérieures.
- Un exemple de boucle d’appel d’outils via Responses API, réécrit à partir du format officiel.
- Une démarche de diagnostic des erreurs fréquentes, ainsi qu’une checklist de validation sur petit trafic et de rollback.
Index : Commencez par « To Know » et « Aperçu des impacts » pour harmoniser le vocabulaire et comprendre comment les différents rôles sont affectés. La première partie, « Faits objectifs », compile les informations de publication, les benchmarks officiels, la tarification et les points clés du guide de migration original. La deuxième partie, « Pratique de migration et analyse », couvre successivement la sélection du modèle, les exemples minimaux, la checklist des paramètres, la boucle d’outils, le diagnostic des erreurs, puis la validation et le rollback ; cette partie relève du jugement éditorial et des recommandations opérationnelles.
GPT-6.2 API To Know : explication des concepts
| Concept | Brève explication |
|---|---|
| GPT-6.2 Astra / Sol | Les deux modèles publiés par OpenAI dans cette vague. Leurs noms d’API sont respectivement gpt-6.2-astra et gpt-6.2-sol ; Astra est plus cher, Sol moins cher |
| Responses API | Une interface unifiée plus récente d’OpenAI. Les appels d’outils de GPT-6.2 doivent obligatoirement passer par cette interface |
| Chat Completions | L’interface classique de complétion de conversation. GPT-6.2 permet toujours d’y envoyer des requêtes en texte brut |
| reasoning effort | Niveau d’intensité du raisonnement. La documentation officielle recommande d’utiliser medium pour les nouvelles intégrations |
| Éléments de raisonnement (reasoning items) | Les éléments de sortie liés au raisonnement que le modèle renvoie dans sa réponse. Dans les conversations multi-tours et les boucles d’outils, il faut les renvoyer tels quels |
| Préfixe d’historique | La séquence d’entrée déjà envoyée dans une conversation multi-tours ; la maintenir inchangée favorise les succès de cache et la continuité du raisonnement |
| prompt caching | La mise en cache des invites. Les préfixes répétés peuvent être facturés selon un tarif réduit de lecture du cache |
| GDPval v2 / ALE / FrontierCode 2.0 | Noms de benchmarks cités par OpenAI dans ses supports de lancement ; les scores des trois ne peuvent pas être comparés entre eux |
Aperçu rapide des impacts de l’API GPT-6.2
- Développeurs ayant déjà des applications basées sur l’API OpenAI : changer le nom du modèle n’est pas compliqué, l’essentiel du travail réside dans le nettoyage des paramètres et la bascule de l’interface. Les applications Chat Completions qui utilisent le function calling doivent migrer vers Responses API, et c’est là que se concentre le gros du travail de migration.
- Applications qui dépendent des paramètres d’échantillonnage : les systèmes qui contrôlent le style de sortie via
temperatureettop_p, ou qui s’appuient surlogprobspour estimer la confiance, ces capacités ont été supprimées sur GPT-6.2. Il faut donc trouver une autre approche. - Responsables des coûts : le prix unitaire d’Astra et de Sol présente un écart de 4x. Au-delà de 272K pour une requête à contexte long, la facturation de l’ensemble de la requête augmente. Il faut donc recalculer le budget en se basant sur la distribution réelle des longueurs de requêtes.
- Utilisateurs lambda de ChatGPT : le périmètre ouvert cette fois-ci concerne ChatGPT Work, Codex et l’API. Le Chat standard n’est pas inclus dans cette vague de lancement.
I. Faits objectifs sur l’API GPT-6.2
Cette section se contente de rassembler les informations issues des documents officiels d’OpenAI, avec une date de vérification fixée au 18 novembre 2026. Les données d’évaluation citées dans le texte proviennent toutes des rapports officiels d’OpenAI, et non de tests réalisés par notre équipe.
1.1 Date de sortie de l’API GPT-6.2, noms des modèles et périmètre de disponibilité
OpenAI a publié GPT-6.2 Astra et GPT-6.2 Sol le 17 novembre 2026. Les noms de modèles côté API sont respectivement gpt-6.2-astra et gpt-6.2-sol. Les deux modèles acceptent du texte et des images en entrée, produisent du texte en sortie et ne disposent pas de génération vidéo native.
Le déploiement se fait par étapes successives, et couvre ChatGPT Work, Codex et l’API ; le ChatGPT Chat classique n’entre pas dans le périmètre de cette vague. Résultat : pendant un certain temps, certains comptes ou organisations peuvent encore ne pas pouvoir appeler ces deux modèles. Avant de basculer officiellement, mieux vaut donc vérifier leur disponibilité au sein de sa propre organisation.
1.2 Données d’évaluation officielles de l’API GPT-6.2 (chiffres de communication d’OpenAI)
OpenAI a présenté les résultats d’évaluation suivants dans ses supports de lancement. Chaque chiffre ne vaut que dans son propre benchmark :
- GDPval v2 : GPT-6.2 Astra dépasse GPT-6 Astra de 6,2 points de pourcentage, avec 22 % de tokens de sortie en moins. GPT-6.2 Sol dépasse GPT-6.1 Sol de 5,3 points de pourcentage.
- Agents’ Last Exam (ALE) : GPT-6.2 Astra gagne 5,2 points par rapport à GPT-6 Astra.
- FrontierCode 2.0 : au niveau de raisonnement max, Sol et Astra sont séparés par 0,5 point, pour un coût par tâche d’environ 1/5 de celui d’Astra. Ce n’est là qu’une conclusion propre à ce test, qui ne peut pas être généralisée en constat universel sur les coûts.
Ces trois séries de chiffres reposent sur des unités et des bases de comparaison différentes : on ne peut ni les additionner, ni les classer les unes par rapport aux autres. Par exemple, les « 6,2 points de pourcentage » de GDPval v2 et les « 5,2 points » d’ALE ne se situent pas sur la même échelle.
1.3 Tarification standard de l’API GPT-6.2
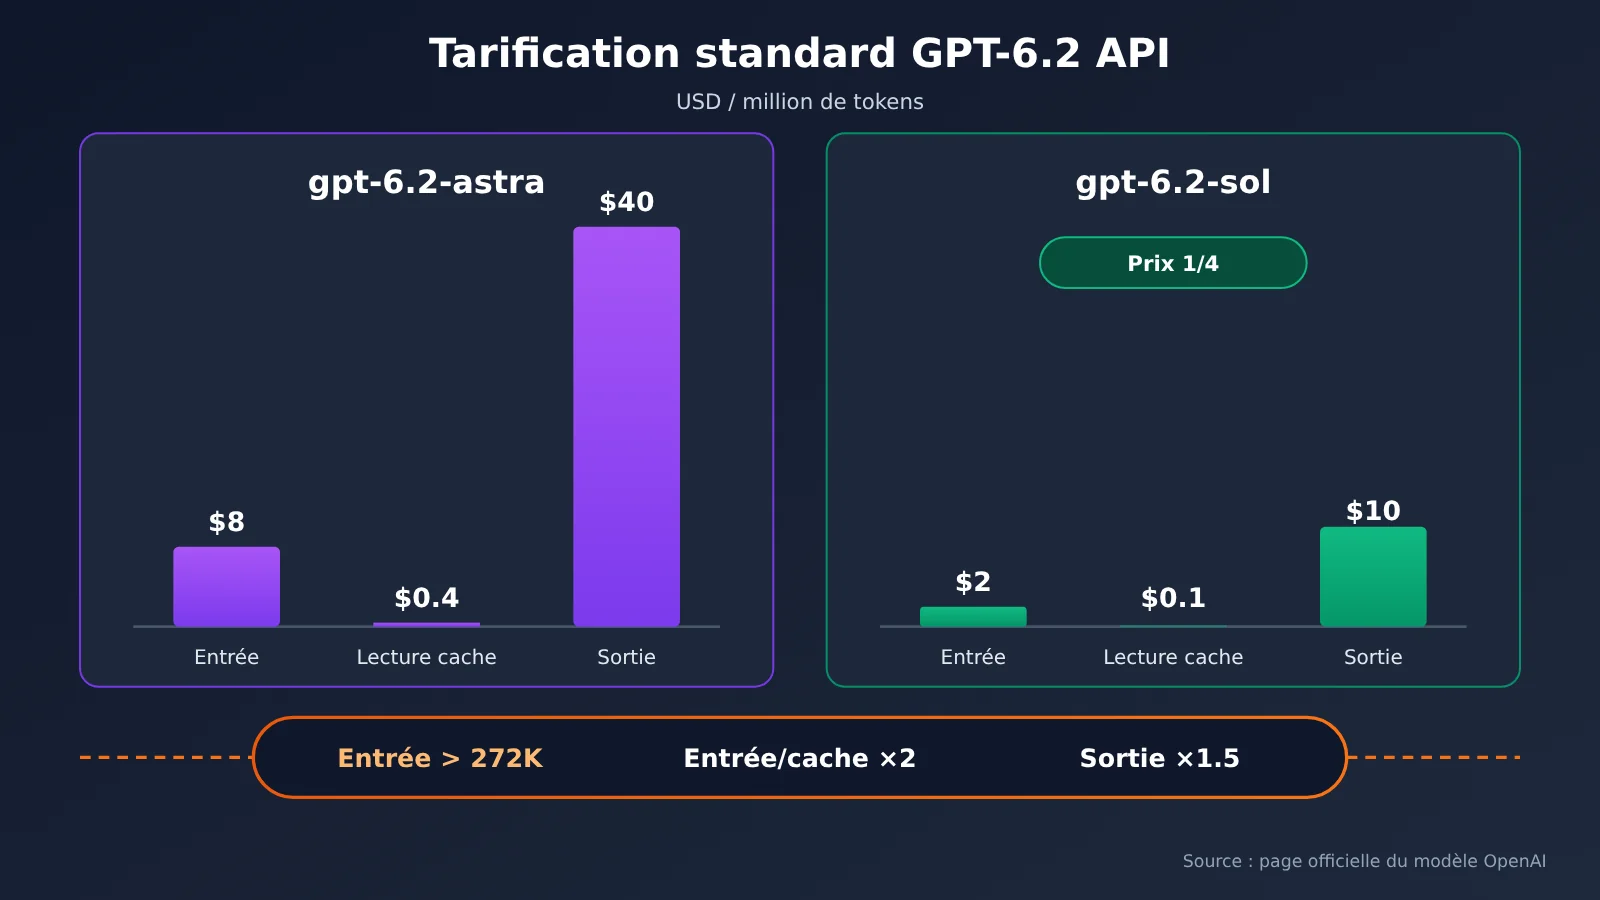
Le tableau ci-dessous présente les tarifs standard officiels de l’API, exprimés en dollars par million de tokens :
| Modèle | Entrée non mise en cache | Lecture du cache | Sortie | Lorsque l’entrée dépasse 272K |
|---|---|---|---|---|
gpt-6.2-astra |
$8 | $0.4 | $40 | Tarif d’entrée et de lecture du cache pour la requête entière ×2, sortie ×1.5 |
gpt-6.2-sol |
$2 | $0.1 | $10 | Tarif d’entrée et de lecture du cache pour la requête entière ×2, sortie ×1.5 |
Deux points méritent également votre attention. Premièrement, l’écriture dans le cache est facturée séparément ; elle n’apparaît pas dans le tableau. Deuxièmement, la majoration pour contexte long s’applique à « toute la requête » : dès que l’entrée d’une requête dépasse 272K, l’ensemble de l’entrée de cette requête est facturé au double, et non uniquement la partie qui dépasse le seuil.
1.4 Points clés du guide officiel de migration de l’API GPT-6.2
Le dernier guide de migration de modèles d’OpenAI (page latest-model) liste les ajustements suivants :
| Élément | Chat Completions | Responses API | Périmètre d’application |
|---|---|---|---|
| Appels d’outils | Non pris en charge ; vous devez utiliser Responses | Pris en charge | Toutes les applications migrées vers GPT-6.2 |
| Paramètres d’échantillonnage | Suppression de temperature, top_p |
Suppression de temperature, top_p |
Toutes les migrations |
| Sorties de probabilité | Suppression de logprobs, top_logprobs |
Suppression de top_logprobs, et retrait de message.output_text.logprobs de include |
Toutes les migrations |
| Niveau de raisonnement | Pour les nouveaux raccordements, utilisez medium ; none, minimal deviennent low |
Idem | Toutes les migrations |
| Rétention du cache | prompt_cache_retention devient prompt_cache_options.ttl="30m" |
Idem | Migration depuis GPT-5.5 et versions antérieures |
Concernant les conversations multi-tours, le guide précise aussi : il faut conserver le préfixe d’historique existant, ajouter les nouvelles instructions à la suite, sans réécrire. En cas de rétrogradation du modèle, ou de changement d’utilisateur ou d’organisation, des éléments de raisonnement peuvent être perdus.
II. Migration vers l’API GPT-6.2 : mise en pratique et clés d’analyse
Cette section présente les analyses et recommandations opérationnelles de la rédaction, fondées sur les informations officielles ci-dessus. Le code a été adapté au format de la documentation officielle et n’a pas été validé par exécution ; avant toute intégration, vérifiez chaque point par rapport à la documentation officielle.
2.1 Choix du modèle pour l’API GPT-6.2 : Sol d’abord, Astra ensuite
Si l’on s’en tient aux tarifs officiels, les prix d’entrée et de sortie de Sol correspondent tous deux à 1/4 de ceux d’Astra. Dans FrontierCode 2.0, le résultat selon lequel « Sol et Astra ont 0.5 point d’écart pour un coût d’environ 1/5 » indique que Sol peut afficher un rapport qualité-prix particulièrement intéressant sur certaines tâches de programmation. Ce constat ne provient toutefois que d’une seule évaluation ; pour savoir s’il tient dans votre contexte métier, il faudra le vérifier avec vos propres données.
La stratégie par défaut recommandée par la rédaction est la suivante : commencez par exécuter gpt-6.2-sol sur l’ensemble de régression, identifiez les types de tâches pour lesquels Sol n’atteint pas le niveau de qualité requis, puis évaluez Astra sur ce périmètre. Autre point d’attention : dans GDPval v2, le fait qu’Astra « génère 22 % de tokens de sortie en moins » résulte d’une comparaison avec GPT-6 Astra ; on ne peut pas s’en servir directement pour compenser l’écart de prix unitaire entre Astra et Sol.
💡 Recommandation de choix : pour comparer Astra et Sol, utilisez le même jeu de régression et le même niveau de raisonnement, puis relevez séparément la qualité, la latence et la consommation de tokens. Si vous souhaitez comparer plusieurs modèles derrière une même interface, vérifiez d’abord dans la liste des modèles sur APIYI apiyi.com si la série GPT-6.2 est disponible ; dans le cas contraire, utilisez directement l’API officielle OpenAI.
2.2 Exemple minimal de Responses avec l’API GPT-6.2
Voici l’exemple le plus simple d’un appel textuel pur, utilisant l’API Responses avec le niveau de raisonnement medium. Commencez par installer ou mettre à jour le SDK Python officiel : python -m pip install --upgrade openai. Configurez OPENAI_API_KEY dans l’environnement d’exécution et ne placez jamais une vraie clé dans le code, un article ou un dépôt de version. L’exemple ci-dessous appelle par défaut l’API officielle OpenAI.
import os
from openai import OpenAI

# Adapté du format de la documentation officielle, non vérifié par exécution
client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])  # Appelle l'API officielle OpenAI par défaut

response = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "medium"},
    input="用三句话说明什么是提示词缓存。"
)
print(response.output_text)
L’exemple omet volontairement temperature et top_p, car GPT-6.2 a supprimé ces deux paramètres. Si votre fonction d’encapsulation les ajoute par défaut, il faut les filtrer de manière uniforme au niveau de l’appel.
🎯 Conseil technique : avant d’intégrer un service tiers comme APIYI apiyi.com, vérifiez d’abord sa documentation officielle, sa liste de modèles, sa prise en charge de Responses et ses tarifs réels, puis configurez son adresse et la clé dédiée qu’il émet. N’envoyez pas une clé officielle OpenAI à une adresse tierce. Cet article ne vérifie pas la compatibilité des interfaces tierces.
2.3 Liste de migration des paramètres de l’API GPT-6.2
La liste de migration est divisée en deux groupes selon la version d’origine, pour éviter d’appliquer à tous les projets des modifications qui ne concernent que les anciennes versions.
2.3.1 À faire pour tous les projets migrant vers GPT-6.2
- Remplacer le nom du modèle par
gpt-6.2-astraougpt-6.2-sol, et le gérer de façon centralisée dans le centre de configuration, pour faciliter un retour arrière ultérieur. - Supprimer
temperatureettop_p. Si vous utilisiez une température basse pour rendre les sorties plus stables, remplacez-la par des instructions plus explicites, un format de sortie structuré ou une logique de validation. - Les projets utilisant Chat Completions doivent supprimer
logprobsettop_logprobs. Les projets utilisant Responses doivent supprimertop_logprobset retirermessage.output_text.logprobsdu tableauinclude. - Niveau de raisonnement : pour une nouvelle intégration, utilisez
mediumpar défaut ; si la configuration étaitnoneouminimal, passez àlow. - Toute requête comportant
toolsdoit passer à l’API Responses.
2.3.2 À faire uniquement lors d’une migration depuis GPT-5.5 ou une version antérieure
- Remplacer
prompt_cache_retentionparprompt_cache_options.ttl="30m". - Après la migration, vérifier que le taux de réussite du cache est normal. Le prix d’une lecture de cache ne représente qu’un vingtième d’une entrée non mise en cache : une baisse du taux de réussite fait grimper les coûts directement.
Si vous migrez depuis GPT-6 ou GPT-6.1, les points de la liste 2.3.1 doivent tout de même être vérifiés un par un. Le code d’appel d’outils déjà en Responses doit aussi être contrôlé pour s’assurer qu’aucun paramètre supprimé ne subsiste.
2.4 Boucle d’outils et préfixe d’historique de l’API GPT-6.2
L’appel d’outils est la partie la plus risquée de cette migration. Dans l’API Responses, une boucle d’outils complète se déroule en quatre étapes : le modèle renvoie un élément function_call ; votre code exécute la fonction correspondante ; vous ajoutez le résultat à l’entrée sous forme de function_call_output ; puis vous interrogez à nouveau le modèle. Le modèle peut continuer à demander des outils : on ne peut pas partir du principe que la deuxième réponse sera forcément la réponse finale.
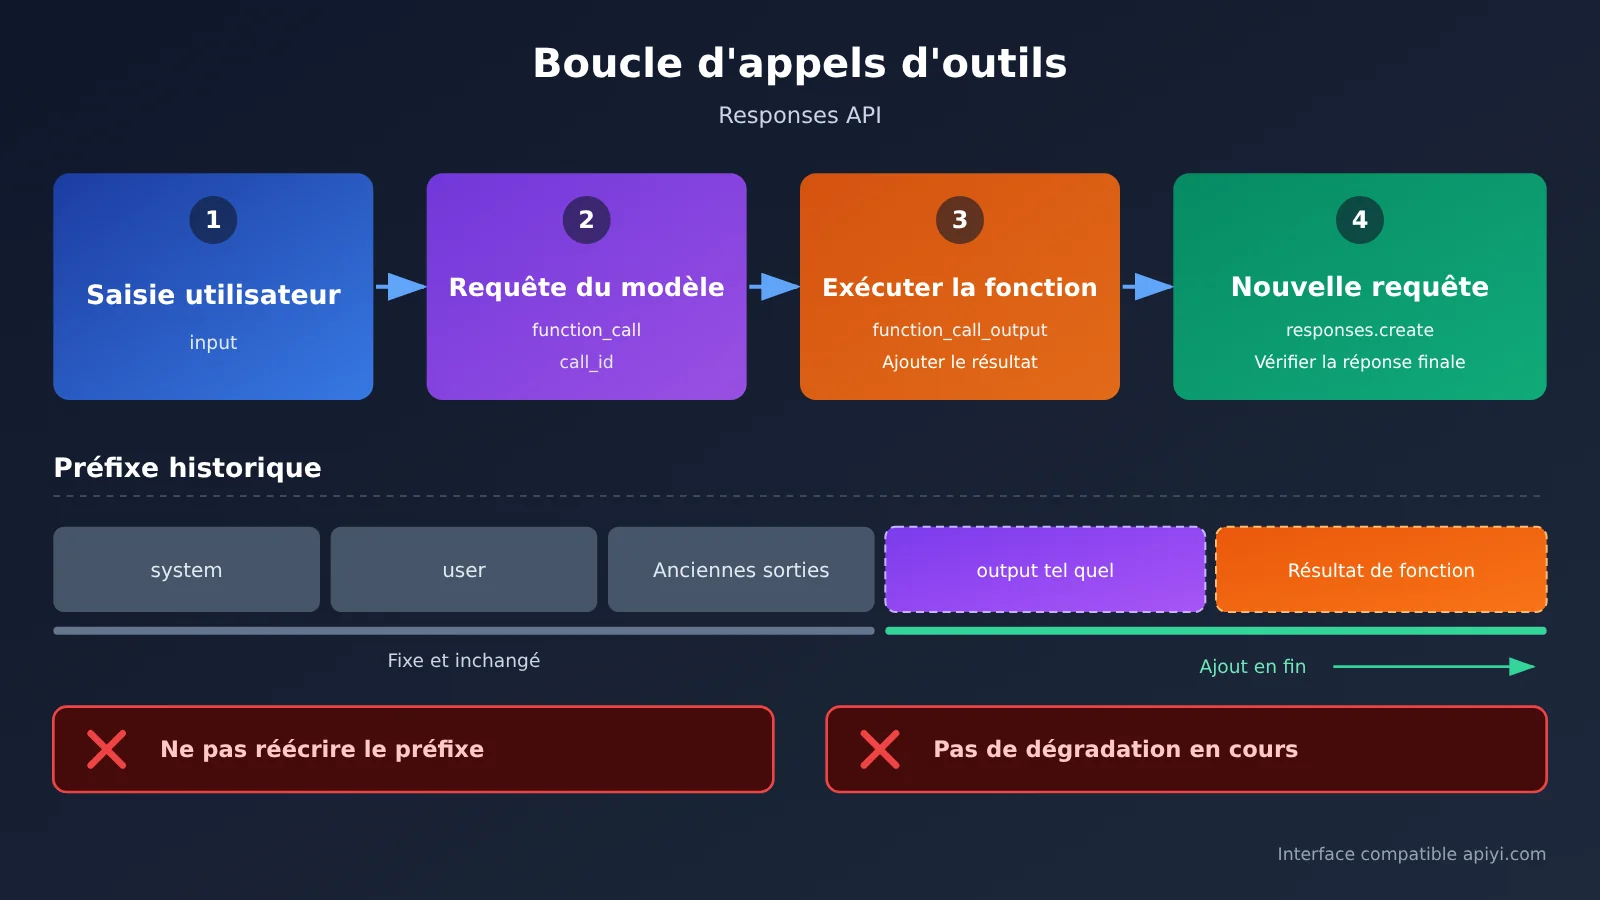
Le principe clé : ajoutez tel quel l’output renvoyé par le modèle à l’historique, sans filtrage ni recomposition. Les éléments de raisonnement font partie de ces sorties. Si vous ne conservez que la partie texte, ou si vous réécrivez en cours de route les instructions system précédentes, les tours suivants risquent de perdre la continuité du raisonnement, et le préfixe du cache devient invalide.
Voir un exemple d’appel de fonction sur un seul tour (adapté du format officiel, non testé)
import os
import json
from openai import OpenAI

client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])  # Appelle par défaut l'API officielle OpenAI

MODEL = "gpt-6.2-sol"

tools = [{
    "type": "function",
    "name": "get_order_status",
    "description": "根据订单号查询订单状态",
    "parameters": {
        "type": "object",
        "properties": {"order_id": {"type": "string"}},
        "required": ["order_id"],
        "additionalProperties": False
    },
    "strict": True
}]

def get_order_status(order_id: str) -> dict:
    # Remplacez par votre vraie logique métier
    return {"order_id": order_id, "status": "shipped"}

# Préfixe d'historique existant : à conserver tel quel, on ajoute seulement à la fin
history = [
    {"role": "user", "content": "帮我查一下订单 A1024 的状态"}
]

first = client.responses.create(
    model=MODEL,
    input=history,
    tools=tools,
    reasoning={"effort": "medium"}
)

# Ajouter tel quel la sortie du modèle (éléments de raisonnement et function_call compris)
history += first.output

for item in first.output:
    if item.type == "function_call" and item.name == "get_order_status":
        args = json.loads(item.arguments)
        result = get_order_status(**args)
        history.append({
            "type": "function_call_output",
            "call_id": item.call_id,
            "output": json.dumps(result, ensure_ascii=False)
        })

final = client.responses.create(
    model=MODEL,
    input=history,
    tools=tools,
    reasoning={"effort": "medium"}
)
if final.status != "completed":
    raise RuntimeError(f"响应未完成:{final.status}")
if any(item.type == "function_call" for item in final.output):
    raise RuntimeError("模型仍请求工具;请按相同流程继续处理,不能当作最终答复")
print(final.output_text)
La fonction ci-dessus renvoie des données de démonstration, pas une vraie requête de commande ; l’exemple ne montre qu’un seul tour d’appel de fonction. En production, il faut encore valider le nom de l’appel et les arguments, vérifier les permissions de requête, gérer les erreurs des outils, prévoir une boucle avec un plafond pour les demandes d’outils suivantes, et gérer les délais d’attente ainsi que les réponses incomplètes.
Pour ajouter une nouvelle contrainte, par exemple « réponds désormais en anglais », il faut l’ajouter comme une nouvelle entrée à la fin de history, sans revenir modifier l’instruction du début. Au sein d’une même conversation, ne passez pas à un modèle de version inférieure et ne migrez pas la conversation entre utilisateurs ou organisations. La documentation officielle précise que ces changements peuvent entraîner la perte des éléments de raisonnement.
2.5 Diagnostic des erreurs de l’API GPT-6.2
Le tableau ci-dessous rassemble les pistes de dépannage à partir des points de migration officiels. Les « causes possibles » sont des déductions de la rédaction ; le texte exact des erreurs dépend des réponses réelles :
| Symptôme | Cause possible | Traitement |
|---|---|---|
| Requête rejetée, paramètre non pris en charge | Paramètres supprimés encore présents comme temperature, top_p, logprobs |
Filtrer uniformément dans la couche d’encapsulation des appels |
Échec de Chat Completions avec tools |
L’appel d’outils de GPT-6.2 ne prend en charge que Responses | Migrer vers responses.create |
| Erreur sur le niveau de raisonnement | none ou minimal encore utilisé |
Remplacer par low |
| Configuration du cache inefficace ou taux de succès en chute brutale | prompt_cache_retention encore utilisé, ou préfixe d’historique réécrit |
Remplacer par prompt_cache_options.ttl="30m" et garder le préfixe stable |
| Baisse nette de qualité en seconde moitié d’un dialogue multitour | Éléments de raisonnement non renvoyés, changement de modèle ou d’organisation en cours de route | Ajouter output tel quel et fixer le modèle pour la même conversation |
| Facture bien au-delà de l’estimation | Certaines requêtes dépassent 272K en entrée, déclenchant une majoration sur l’ensemble de la facture | Analyser la distribution des longueurs d’entrée et tronquer ou résumer les longues requêtes |
| Nom de modèle inexistant ou accès refusé | Ouverture progressive côté officiel, ou modèle pas encore proposé par l’interface tierce | Vérifier les permissions de l’organisation ; pour une interface tierce, se référer à la liste des modèles de la plateforme |
🛠 Conseil de dépannage : si le problème n’apparaît que sur une interface tierce, envoyez d’abord la même requête via l’API officielle pour comparer. Vous pourrez ainsi déterminer si le problème vient de votre code ou de la couche de compatibilité de l’interface. En cas de problème de compatibilité sur APIYI apiyi.com, vous pouvez contacter le support technique de la plateforme en fournissant l’ID de la requête.
2.6 Acceptation et rollback du trafic réduit de l’API GPT-6.2
Pour l’édition, mieux vaut éviter un basculement global et plutôt procéder en trois étapes : « test en miroir → déploiement progressif à petite échelle → montée en charge ». Chaque étape doit avoir des critères d’acceptation et des conditions de rollback clairement définis :
| Phase | Trafic recommandé | Critères d’acceptation | Conditions de déclenchement du rollback |
|---|---|---|---|
| Test en miroir | Dupliquer les requêtes de production, sans renvoyer le résultat aux utilisateurs | Qualité du jeu de régression, taux de succès des appels d’outils, taux de parsing des sorties structurées | Qualité des tâches critiques nettement inférieure à l’ancien modèle |
| Déploiement progressif à petite échelle | Un petit nombre d’utilisateurs réels | Taux d’erreur, latence P95, nombre de tokens par requête, taux de succès du cache | Taux d’erreur ou coût dépassant les seuils définis |
| Montée en charge | Augmentation progressive de la proportion | Part des requêtes à contexte long, coût quotidien, retours des utilisateurs | Apparition d’un grand nombre de requêtes dépassant 272K, entraînant une explosion des coûts |
La conception du rollback repose sur deux points. Premièrement, le nom du modèle, le type d’interface et le niveau de raisonnement doivent tous être placés dans des commutateurs de configuration : lors du rollback, on ne modifie que la configuration, sans redéployer une nouvelle version. Deuxièmement, le rollback se fait par nouvelle session : les sessions déjà en cours sur GPT-6.2 doivent, autant que possible, se terminer sur le modèle d’origine, afin qu’une rétrogradation en cours de route ne fasse pas perdre les éléments de raisonnement.
🚀 Démarrage rapide : lors du déploiement progressif, vous pouvez, sur APIYI apiyi.com, appeler en parallèle l’ancien modèle et le modèle candidat avec la même clé API pour comparer — à condition que la plateforme propose bien le modèle concerné. Ce point est à vérifier dans la console de la plateforme ; le présent article ne peut rien garantir.
Pour cette migration vers GPT-6.2, le véritable travail ne tient pas au changement de nom du modèle, mais à trois choses : migrer les appels d’outils vers Responses, éliminer les paramètres supprimés et maintenir la stabilité du préfixe historique. Les évaluations officielles donnent des pistes à suivre, notamment le rapport qualité/prix de Sol sur certaines tâches. Mais savoir si ces chiffres se vérifient dans votre activité, c’est à votre propre jeu de régression et à vos données de déploiement progressif de le dire.
Ce qu’on tire du papier paraît toujours superficiel ; pour vraiment connaître une chose, il faut la pratiquer soi-même. — Lu You, « Veillée d’hiver, lecture pour instruire mon fils »
Références
Pour la structure du code, consultez également OpenAI Quickstart et le guide Function calling. Cet article se contente de vérifier la documentation et la structure du code, sans effectuer de test réel sur l’API payante.
-
Annonce OpenAI : Introducing GPT-6.2 Astra and Sol
- Lien : documentation officielle
- Description : date de publication, données d’évaluation et périmètre de disponibilité
-
Page modèle OpenAI : GPT-6.2 Astra
- Lien : documentation officielle
- Description : nom du modèle, modalités et tarification standard
-
Page modèle OpenAI : GPT-6.2 Sol
- Lien : documentation officielle
- Description : nom du modèle, modalités et tarification standard
-
Guide de migration OpenAI : Latest model
- Lien : documentation officielle
- Description : suppression de paramètres, niveaux de raisonnement, configuration du cache et exigences sur les préfixes historiques
-
Centre d’aide OpenAI : ChatGPT Work and Codex
- Lien : documentation officielle
- Description : explications sur la disponibilité côté ChatGPT Work et Codex
Auteur : équipe technique APIYI
Échanges techniques : si vous rencontrez des problèmes de compatibilité d’interface lors de la migration, contactez-nous via la page d’accueil d’APIYI apiyi.com. Pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com