Nota del autor: Alphabet reveló que las API de sus modelos propios procesan cerca de 32.000 millones de tokens por minuto. En este artículo comparamos Gemini 4 Argon, 3.8 Flash y 3.5 Flash-Lite desde tres perspectivas —precios oficiales, evaluaciones independientes y simulaciones de costos— para ayudarte a calcular el «costo total por tarea que cumple los requisitos».
El 28 de octubre de 2026, Sundar Pichai, CEO de Alphabet, anunció en la presentación de resultados del tercer trimestre que las API de sus modelos propios procesan actualmente cerca de 32.000 millones de tokens por minuto, más de cuatro veces la cifra del año anterior. Este dato refleja el uso generalizado de la API de Gemini entre desarrolladores y empresas, no el rendimiento individual de un modelo concreto.
Este no es otro artículo que recomienda elegir el modelo más potente sin pensarlo. A medida que aumenta el volumen de llamadas, los problemas de costos y selección se multiplican. Elegir la categoría equivocada puede hacer que la factura mensual se multiplique o que tengas que repetir las tareas por falta de capacidad, lo que termina saliendo aún más caro.
Qué te aporta este artículo: conocerás las diferencias entre los tres modelos de Gemini —Argon, Flash y Flash-Lite— en capacidades, precio, velocidad y casos de uso. También encontrarás un método de prueba que puedes aplicar directamente a tu negocio para hacer una selección inicial.
El uso de la API de Gemini se dispara: datos clave
| Dato | Detalle |
|---|---|
| Fecha del anuncio | 28 de octubre de 2026 (resultados del tercer trimestre de 2026 de Alphabet) |
| Anunciado por | Sundar Pichai, CEO de Alphabet |
| Dato principal | La API de modelos propios procesa casi 32.000 millones de tokens por minuto, un aumento de aproximadamente el 40 % frente a la cifra comunicada el trimestre anterior y más de cuatro veces la cifra de hace un año |
| Principales modelos disponibles a través de la API | Gemini 4 Argon, Gemini 3.8 Flash, Gemini 3.5 Flash-Lite |
| A quién afecta | A todos los desarrolladores y empresas que crean aplicaciones con Gemini Developer API |
Qué significan 32.000 millones de tokens por minuto para los desarrolladores de la API de Gemini
El fuerte aumento del uso indica que los modelos ya se utilizan a gran escala en entornos de producción, pero eso no significa que todos los proyectos deban usar el modelo estrella más caro. Para elegir un modelo hay que tener en cuenta, como mínimo, la complejidad de la tarea, la calidad de salida necesaria, el volumen de solicitudes, la velocidad de respuesta, el consumo de tokens, la tolerancia a errores del negocio, la necesidad de una ventana de contexto amplia y de invocar herramientas, así como los posibles cambios de precio.
Es importante tener en cuenta que, en este artículo, Flash se refiere a Gemini 3.8 Flash y Flash-Lite a Gemini 3.5 Flash-Lite. No deben confundirse con la antigua serie Gemini 2.5 Flash. Además, por muy grande que sea el volumen global de invocaciones, eso no significa que los desarrolladores individuales tengan una cuota ilimitada. Más adelante hablaremos por separado de los límites de uso.
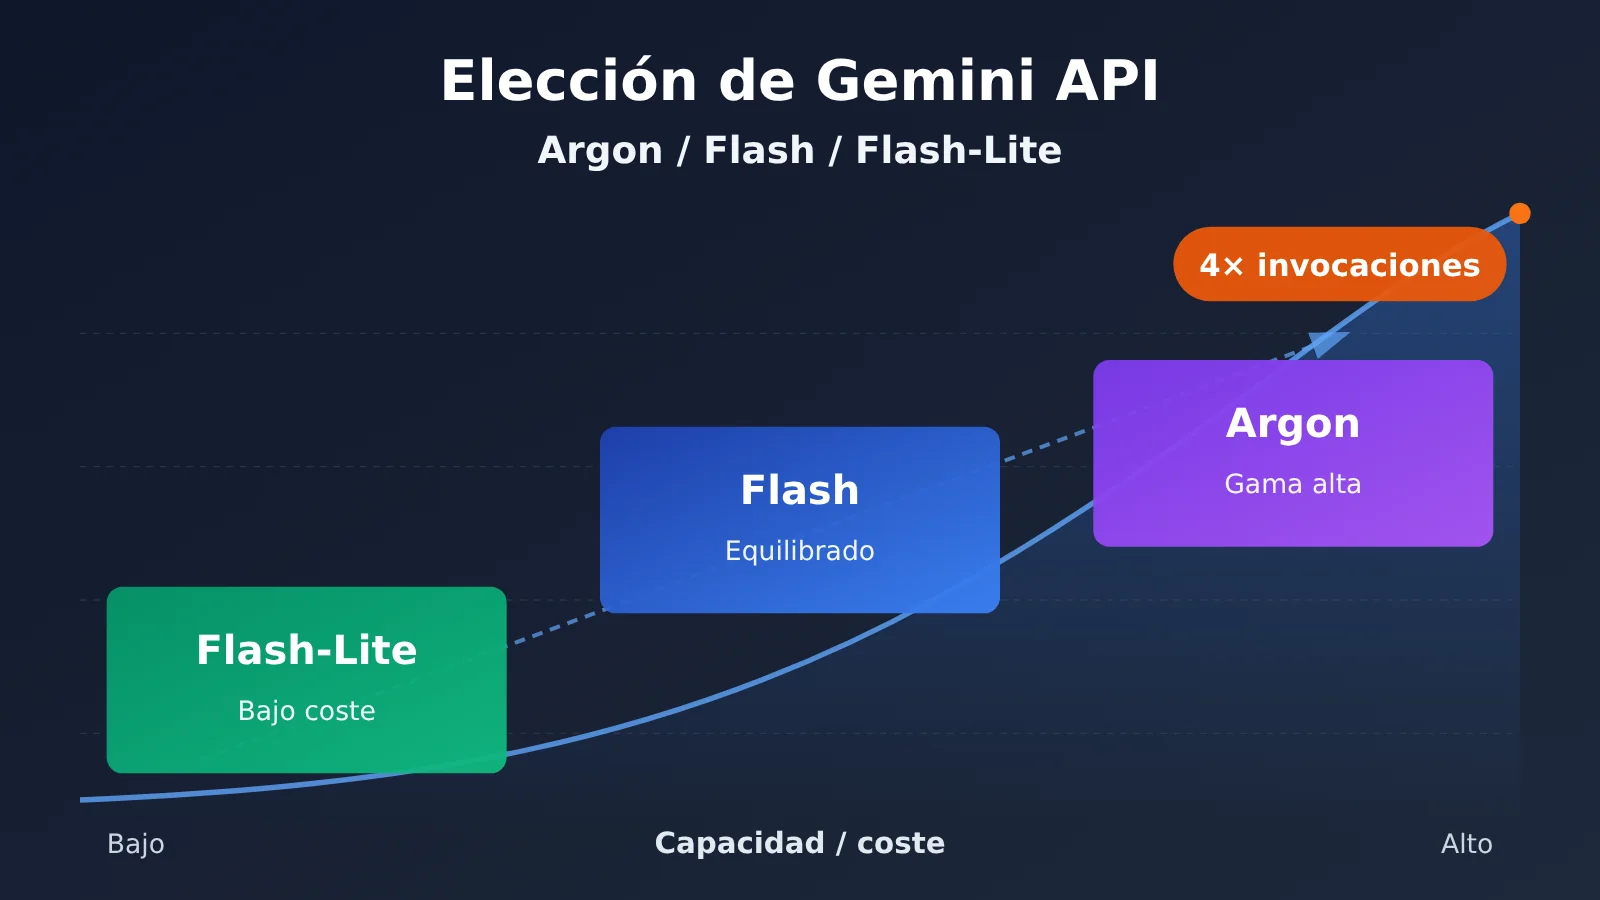
Posicionamiento de los tres modelos Gemini: Argon, Flash y Flash-Lite
Google ofrece actualmente tres niveles de modelos para cubrir distintas necesidades de costo y capacidad. La siguiente tabla se basa en las páginas oficiales de especificaciones:
| Característica | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| ID de API | gemini-4-argon |
gemini-3.8-flash |
gemini-3.5-flash-lite |
| Posicionamiento oficial | Modelo insignia de razonamiento | Equilibrio entre eficiencia y capacidad | Baja latencia, bajo costo y alto rendimiento |
| Contexto | Aproximadamente 1 millón de tokens | Entrada de 1048576 tokens | Entrada de 1048576 tokens |
| Límite de salida predeterminado | 65536 tokens (ampliable mediante un mecanismo de salida larga) | 65536 tokens | 65536 tokens |
| Niveles de razonamiento | low / medium / high; predeterminado: medium | low / medium / high; predeterminado: medium | minimal / low / medium / high; predeterminado: minimal |
| Herramientas | Llamada a funciones, salida estructurada, Search Grounding, ejecución de código | Llamada a funciones, salida estructurada, ejecución de código, búsqueda de archivos, Search Grounding | Salida estructurada, llamada a funciones, caché |
| Modalidades de entrada | Texto, imágenes, audio, video, PDF | Texto, imágenes, audio, video, PDF | Texto, imágenes, audio, video, PDF |
| Nivel gratuito de API | No disponible | Nivel gratuito limitado | Nivel gratuito limitado |
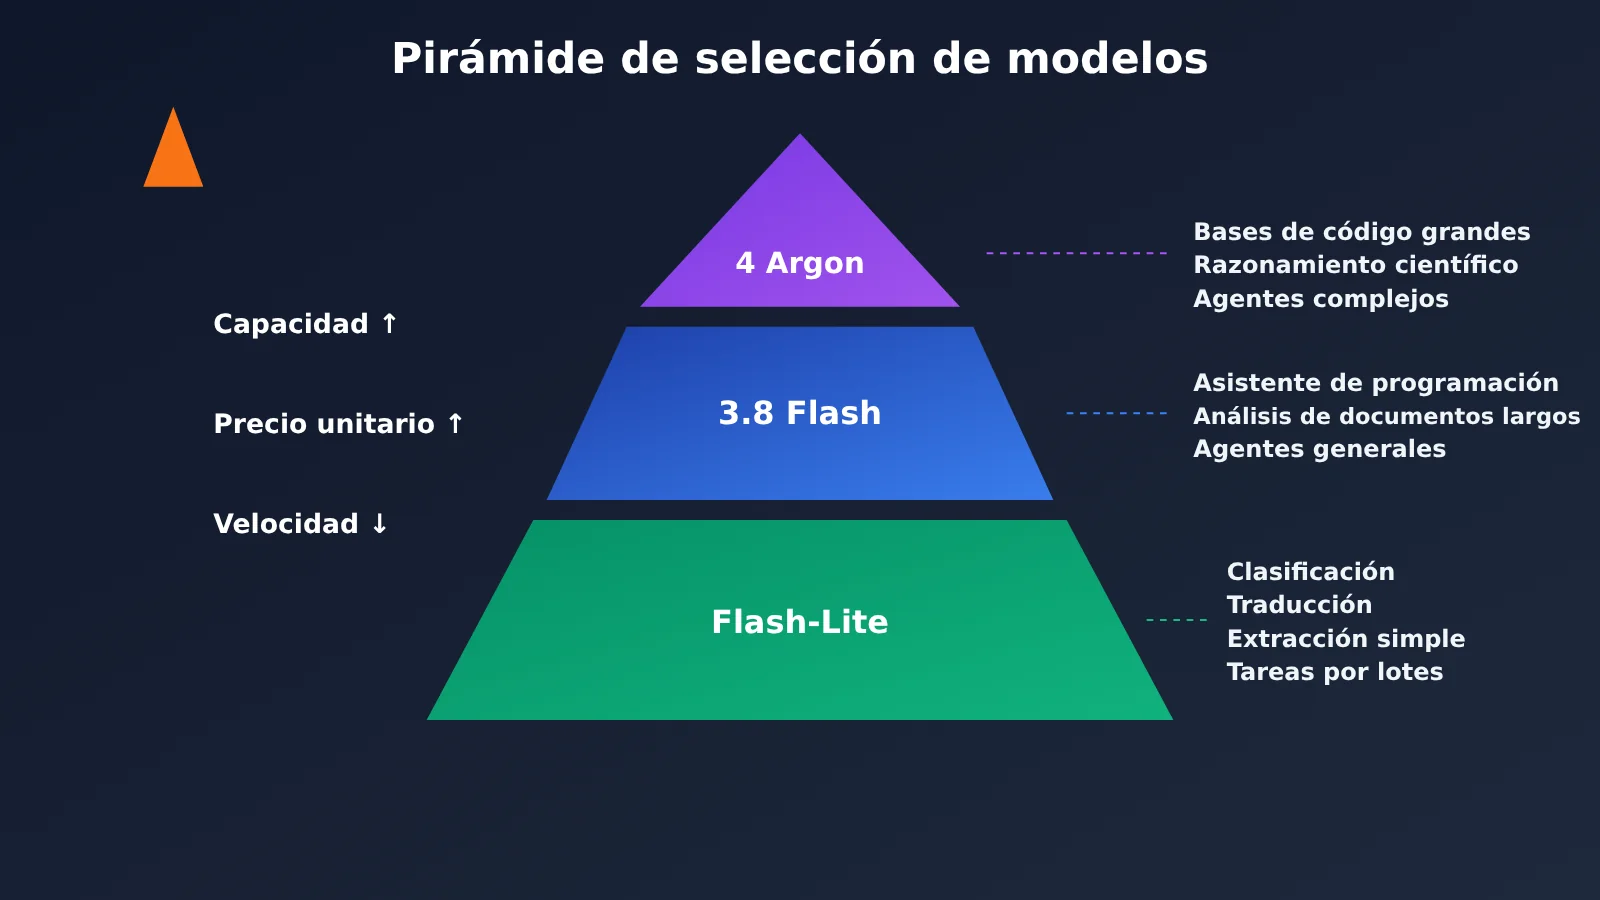
Límites de capacidad de los tres modelos Gemini
Argon se lanzó oficialmente el 13 de octubre de 2026 y está orientado principalmente a la ingeniería de software compleja, el razonamiento matemático y científico, los agentes autónomos de varios pasos y la generación de respuestas largas. Para aprovechar su capacidad de salida larga, necesita un mecanismo específico y una configuración de ejecución adecuada; no significa que pueda devolver directamente 1 millón de tokens en cada solicitud.
3.8 Flash también tiene capacidad de razonamiento: no es una «versión barata que no piensa». Es adecuado para asistentes de programación convencionales, análisis de documentos largos, redacción de contenido y flujos de trabajo con agentes de uso general. 3.5 Flash-Lite se lanzó el 21 de julio de 2026 y está optimizado para clasificación, traducción, extracción sencilla, procesamiento de documentos y subtareas simples dentro de agentes. También puede realizar ciertas tareas de programación y razonamiento; la diferencia frente a los modelos de gama alta está principalmente en la capacidad, la estabilidad y la relación costo-beneficio en tareas complejas.
Precios oficiales de la API de Gemini: escala de costes de Argon, Flash y Flash-Lite
Estos son los precios oficiales del nivel estándar de pago de Gemini Developer API (en dólares por millón de tokens). No incluyen recargos de plataformas de terceros, contratos empresariales ni costes de uso de herramientas:
| Modelo | Entrada | Salida | Entrada con acierto de caché | Vigencia del precio |
|---|---|---|---|---|
| Gemini 4 Argon (actual) | $2.00 | $10.00 | $0.10 | Hasta el 30-11-2026 |
| Gemini 4 Argon (ajustado) | $4.00 | $20.00 | $0.20 | Desde el 01-12-2026 |
| Gemini 3.8 Flash (actual) | $0.75 | $3.75 | $0.075 | Hasta el 31-12-2026 |
| Gemini 3.8 Flash (ajustado) | $1.50 | $7.50 | $0.15 | Desde el 01-01-2027 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | $0.03 | Google no indica una fecha para duplicar el precio |
Con los precios actuales, la entrada de Argon cuesta unas 2,67 veces más que la de Flash; la de Flash cuesta 2,5 veces más que la de Flash-Lite; y la salida de Argon cuesta 4 veces más que la de Flash-Lite. Los precios actuales de Argon y Flash son promocionales: terminan el 30 de noviembre y el 31 de diciembre de 2026, respectivamente, y después se duplican. Para calcular el presupuesto anual de proyectos a largo plazo, hay que usar los precios ajustados.
Hay otro detalle fácil de pasar por alto: Google factura los tokens de razonamiento interno del modelo como tokens de salida. La factura no depende solo de la extensión de la respuesta visible para el usuario: un nivel de razonamiento alto puede aumentar considerablemente el coste de salida. Si la tarea no necesita una respuesta en tiempo real, puedes usar la Batch API. Los precios de entrada y salida de los tres modelos son un 50 % más bajos que los estándar, aunque el modo de ejecución y los límites de cola son diferentes a los de las solicitudes en tiempo real.
Comparativa de las tres versiones de Gemini: pruebas independientes y velocidad
Los siguientes datos proceden de Artificial Analysis, una plataforma independiente de evaluación. Todos utilizan Intelligence Index v5.0 y no incluyen puntuaciones de la versión anterior v4.x:
| Indicador | Gemini 4 Argon(High) | Gemini 3.8 Flash(High) | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| Índice de capacidad general v5.0 | 50 | 31 | 12 |
| AutomationBench-AA | 78% | 60% | 25% |
| Terminal-Bench 4.0 | 57% | 20% | 1% |
| FrontierCode 2.0 | 26% | 19% | 6% |
| Velocidad de salida observada | Algo más de 80 tokens/s | Entre 120 y 140 tokens/s aprox. | Algo más de 400 tokens/s |
| Canales de acceso | API oficial de Google, APIYI apiyi.com | API oficial de Google, APIYI | API oficial de Google, APIYI |
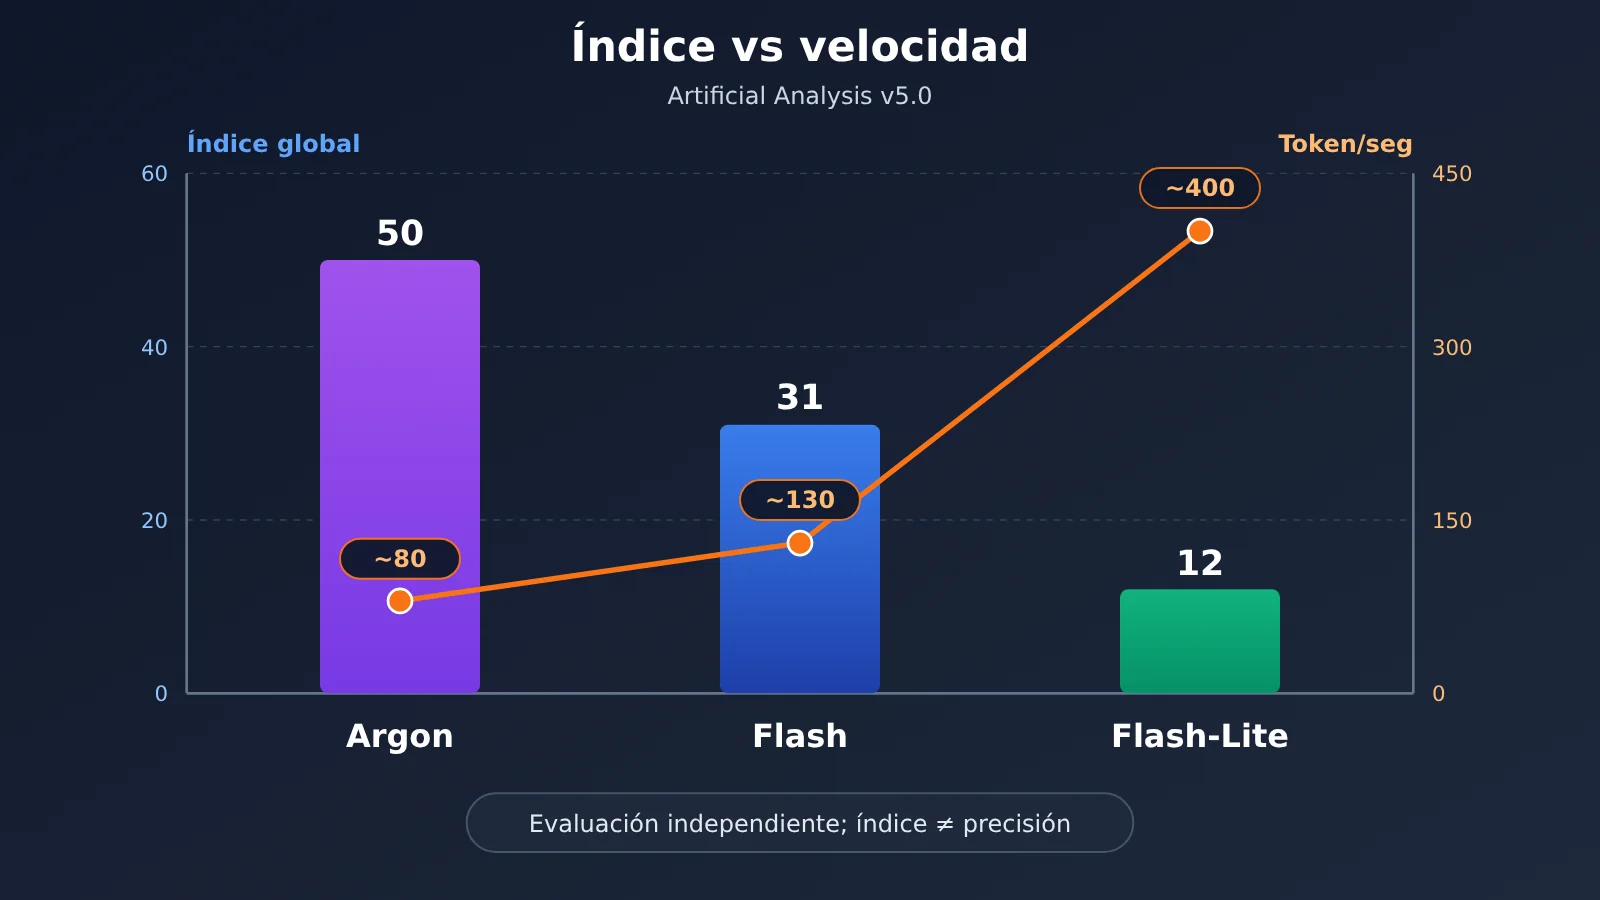
Para interpretar bien estos datos, conviene tener en cuenta tres puntos:
- El índice no es una tasa de aciertos: 50, 31 y 12 son puntuaciones del sistema de evaluación; no significan, por ejemplo, que el modelo «acierte el 50%».
- Las diferencias son claras en tareas complejas: en las pruebas de programación compleja y automatización, Argon es el más potente, Flash ocupa el punto intermedio y Flash-Lite queda por detrás. Pero esto no demuestra que Argon sea mejor para todas las tareas sencillas: en tareas como la clasificación o la organización de formatos, puede que cualquiera de los tres modelos sea suficiente.
- La velocidad no se traduce directamente en tiempo total: la velocidad de generación varía según el estado del servicio. El tiempo real también depende del tiempo de razonamiento, la latencia hasta el primer token, las llamadas a herramientas, las colas de espera y las fluctuaciones de la red.
💡 Sobre la comparación: las puntuaciones de las pruebas solo muestran una diferencia aproximada entre las capacidades de los modelos. El criterio final son los resultados en tu caso de uso. Con APIYI apiyi.com puedes alternar entre los tres modelos Gemini usando una misma clave API y repetir la comparación con tus propios datos.
Simulación de costos de la API de Gemini: cuánto cambia la factura entre Argon, Flash y Flash-Lite
El siguiente es un ejemplo teórico, no una factura real. Supongamos que los tokens de salida incluyen todos los tokens de razonamiento y que no se contabilizan los costos de caché, herramientas de búsqueda ni reintentos. Todos los cálculos usan los precios estándar de octubre de 2026:
| Escenario | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| A: 1000 solicitudes al día, con 5000 tokens de entrada y 1000 de salida por solicitud (costo diario) | $20.00 | $7.50 | $4.00 |
| A: lo mismo durante 30 días seguidos | Aprox. $600 | Aprox. $225 | Aprox. $120 |
| B: clasificación de 100 000 elementos, con 1000 tokens de entrada y 200 de salida por elemento | $400 | $150 | $80 |
| B con Batch API (precio unitario a la mitad) | Aprox. $200 | Aprox. $75 | Aprox. $40 |
El escenario B solo refleja la diferencia de precio para un mismo consumo de tokens. En la práctica, los tokens de razonamiento, la longitud de las respuestas y el número de reintentos varían de un modelo a otro. Por eso, no se puede dar por hecho que Flash-Lite ofrezca por $80 la misma calidad que Argon por $400. Además, cuando terminen los precios promocionales de Argon y Flash, las cifras de ambas columnas se duplicarán.
Análisis del impacto: por qué el precio por token no basta para evaluar la API de Gemini
Impacto para los desarrolladores
El «precio» de un modelo tiene al menos tres niveles. El primero es el precio por token. El segundo es el consumo real de tokens de una tarea, incluidos los de entrada, salida, razonamiento, repetición del contexto y reintentos. El tercero es el costo total de completar una tarea con un resultado aceptable: también hay que contar la tasa de éxito, la revisión humana, los reintentos tras fallos, el tiempo de ejecución y las pérdidas de negocio causadas por errores.
Si Flash-Lite ya cumple los requisitos de negocio en una tarea sencilla de clasificación, cambiar a Argon sería un gasto innecesario. En cambio, si Flash-Lite falla repetidamente en una tarea compleja de programación y Argon puede completarla con menos reintentos, Argon podría ofrecer una mejor relación costo-beneficio global. Esta es una conclusión hipotética sobre cómo elegir un modelo, no una conclusión estadística sobre las tasas de éxito reales de los tres modelos.
Los comentarios de la comunidad también ilustran este punto. Un usuario de Reddit utilizó Argon High en el entorno OpenCode para hacer ingeniería inversa: una sola ejecución consumió aproximadamente 900.000 tokens y, aun así, la tarea no se completó. Es una prueba individual y no puede tomarse como el promedio del sector, pero nos recuerda que los flujos de trabajo complejos con agentes pueden consumir muchísimos tokens sin garantía de éxito. Otro usuario comentó que Argon alcanzó rápidamente el límite de uso de una suscripción de consumo. Esa experiencia corresponde a los productos de suscripción de Gemini y no puede equipararse a los límites de la Developer API.
Impacto en el sector
- La arquitectura multinivel con varios modelos se convierte en la opción por defecto: Google Cloud ya ha presentado públicamente la orquestación de múltiples modelos y Smart Routing para reducir los costos empresariales mediante la distribución de tareas.
- La evaluación pasa del «precio unitario» al «costo por tarea completada con un resultado aceptable»: cuanto mayor sea el volumen de invocaciones, más importante será elegir el modelo con conjuntos de pruebas propios del negocio, en vez de guiarse por las clasificaciones.
- Los ciclos presupuestarios se acortan: a medida que vencen los precios promocionales, los equipos necesitan revisar trimestralmente su combinación de modelos y su presupuesto.
Cómo elegir entre Argon, Flash y Flash-Lite
Estas recomendaciones dependen del contexto: no hay un modelo que sea el mejor para todos los casos.
- Clasificación de datos a gran escala (por ejemplo, dividir 100.000 noticias sobre IA en categorías como lanzamientos, actualizaciones, precios y políticas): empieza con Flash-Lite. Comprueba que la precisión y el cumplimiento del formato alcancen los niveles necesarios en una muestra; si no es así, pasa a 3.8 Flash.
- Estructuración de documentos extensos (convertir informes financieros o documentación técnica en tablas de datos): empieza con 3.8 Flash. Tiene mayor capacidad de comprensión que Lite y es más económico que Argon. Para detectar contradicciones entre documentos o resolver problemas de razonamiento difíciles, recurre a Argon de forma puntual.
- Proyectos de código complejos (comprensión de bases de código grandes o refactorización en varias etapas): empieza con Argon. Tanto su posicionamiento oficial como sus resultados en pruebas independientes de programación son más sólidos, pero debes comprobar la tasa de éxito, la ejecución de herramientas y el costo en proyectos reales.
- Traducción sencilla en grandes volúmenes: empieza con Flash-Lite. Para contenidos muy especializados, como los legales o médicos, es imprescindible añadir controles de calidad; no los uses sin revisión humana solo porque el modelo sea barato.
- Agentes empresariales: no conviene usar un solo modelo. Flash-Lite puede encargarse de la clasificación, la extracción y la normalización de formatos; 3.8 Flash, de la planificación general y los flujos de trabajo de varios pasos; y Argon, del razonamiento difícil y la resolución de problemas complejos. Esta es una estrategia de ingeniería recomendada, no un requisito obligatorio de Google.
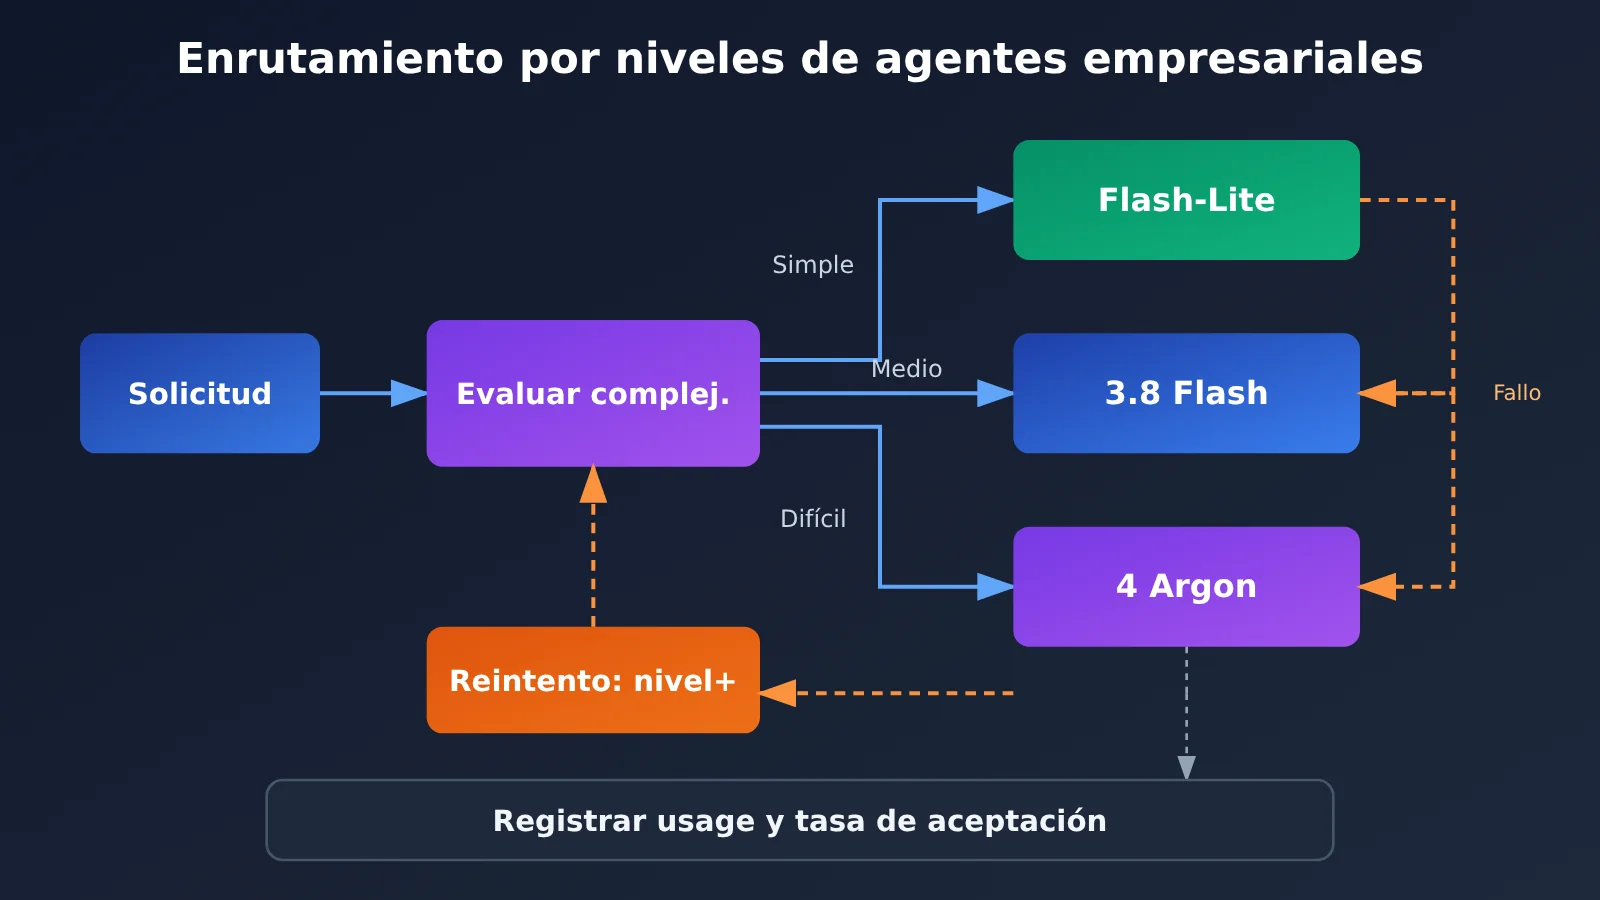
🎯 Consejo para elegir: la clave del enrutamiento por niveles es poder cambiar entre los tres modelos a bajo costo. APIYI apiyi.com ofrece una interfaz compatible con OpenAI: basta con cambiar el parámetro
modelpara pasar de un nivel a otro, lo que facilita las pruebas comparativas a pequeña escala.
Primeros pasos: invocar los tres modelos Gemini mediante la API
Ejemplo mínimo
Puedes usar el SDK de OpenAI y cambiar model para alternar entre Argon, Flash y Flash-Lite:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",
    messages=[{"role": "user", "content": "把这条新闻分类为:模型发布/产品更新/价格变化/行业政策"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # 以实际计费 Token 为准,而非可见字数
Ver el código completo de enrutamiento por niveles y estimación de costos
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Google 官方标准价(美元/100万Token,2026年10月),仅用于估算
PRICE = {
    "gemini-3.5-flash-lite": (0.30, 2.50),
    "gemini-3.8-flash": (0.75, 3.75),    # 2027-01-01 起翻倍
    "gemini-4-argon": (2.00, 10.00),     # 2026-12-01 起翻倍
}
TIERS = ["gemini-3.5-flash-lite", "gemini-3.8-flash", "gemini-4-argon"]

def estimate_cost(model: str, usage) -> float:
    pin, pout = PRICE[model]
    # completion_tokens 应包含思考 Token,具体以返回字段为准
    return usage.prompt_tokens / 1e6 * pin + usage.completion_tokens / 1e6 * pout

def run(prompt: str, start_tier: int = 0, validator=None):
    """从低档模型开始,不合格则升级一档,记录每次成本"""
    total = 0.0
    for model in TIERS[start_tier:]:
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
        )
        text = resp.choices[0].message.content
        cost = estimate_cost(model, resp.usage)
        total += cost
        print(f"{model}: tokens={resp.usage.total_tokens}, cost≈${cost:.5f}")
        if validator is None or validator(text):
            return {"model": model, "output": text, "total_cost": total}
    return {"model": None, "output": None, "total_cost": total}

result = run(
    "从以下文本抽取公司名和金额,输出JSON:...",
    validator=lambda t: t.strip().startswith("{"),
)
print(result)
🚀 Primeros pasos: te recomendamos obtener primero el crédito gratuito de prueba para nuevos usuarios en APIYI, apiyi.com. Compara los tres niveles de modelos con entre 100 y 300 muestras representativas antes de elegir el nivel predeterminado para producción. Ten en cuenta que los precios, los créditos y la compatibilidad con caché de las plataformas de terceros pueden diferir de los de la conexión directa con Google. Consulta las condiciones de cada plataforma.
Consideraciones antes de desplegar Gemini API
- Límites de uso: Gemini API aplica límites de RPM, TPM y RPD por proyecto, no por clave individual. Si superas cualquiera de ellos, recibirás un error.
- Tokens de razonamiento: el precio de salida incluye los tokens de razonamiento. Consulta los metadatos de uso y no estimes el costo según la longitud visible de la respuesta.
- Caché: Argon solo admite caché implícita, no explícita. Flash y Flash-Lite admiten caché, y la facturación depende de la configuración.
- Datos del nivel gratuito: los datos del nivel gratuito pueden utilizarse para mejorar el producto. No incluyas datos empresariales sensibles en ese nivel y revisa las condiciones del servicio antes del despliegue.
- Métricas de prueba: registra la tasa de éxito, la precisión factual, el cumplimiento de la estructura, el número de alucinaciones, la latencia media y de cola, los tokens reales, los reintentos y el costo de las tareas que cumplen los criterios. Los niveles de razonamiento predeterminados varían, así que indica en el informe la configuración utilizada.
Preguntas frecuentes sobre la elección de modelos de Gemini API
P1: ¿Qué son Gemini 4 Argon, 3.8 Flash y 3.5 Flash-Lite?
Son los tres modelos principales de Gemini API de Google, cada uno en una categoría distinta: Argon es el modelo insignia de razonamiento; 3.8 Flash equilibra capacidad y eficiencia; y 3.5 Flash-Lite está orientado a baja latencia, bajo costo y alto volumen de procesamiento. Los tres admiten una ventana de contexto de entrada de aproximadamente un millón de tokens y generan salida de texto.
P2: ¿Cuándo terminan los precios promocionales de Argon y Flash?
Los precios actuales de Argon están vigentes hasta el 30 de noviembre de 2026. A partir del 1 de diciembre, los precios unitarios de entrada, salida y caché se duplicarán. Los de 3.8 Flash estarán vigentes hasta el 31 de diciembre de 2026 y se duplicarán a partir del 1 de enero de 2027. Por ahora, Google no ha anunciado una fecha similar para Flash-Lite.
P3: ¿Una puntuación de 50 en Artificial Analysis significa que el modelo acierta el 50 % de las respuestas?
No. Las puntuaciones 50, 31 y 12 son resultados compuestos del Intelligence Index v5.0, no porcentajes de aciertos. Sirven para comparar aproximadamente los niveles de capacidad de los modelos, pero no se pueden convertir directamente en una tasa de éxito para tu caso de uso.
P4: ¿Cómo puedo comparar los tres modelos de Gemini a bajo costo?
Te recomendamos usar una interfaz compatible con OpenAI que admita varios modelos. Después de registrarte en APIYI apiyi.com y obtener una clave API y crédito gratuito, sustituye `model` en el ejemplo de este artículo por cada uno de los tres ID de API. Luego, registra el consumo y la tasa de resultados satisfactorios con el mismo conjunto de muestras.
P5: En Reddit dicen que Argon agota la cuota en unos pocos intercambios. ¿Pasa lo mismo con la API?
Ese comentario se refiere al producto de suscripción de Gemini para consumidores y no equivale a los límites de la Developer API. Las cuotas de la API dependen del nivel de pago, el estado del proyecto y el modelo, y se calculan en RPM/TPM/RPD. Si invocas los modelos a través de una plataforma agregadora, también debes tener en cuenta sus propias reglas de cuota. Puedes consultar los modelos disponibles y su facturación en la consola de APIYI apiyi.com.
P6: ¿Cuáles son las limitaciones conocidas de cada modelo?
Argon tiene el precio unitario más alto, es el más lento y no cuenta con un nivel gratuito estándar. Además, las tareas complejas de agentes pueden consumir muchos tokens. 3.8 Flash queda claramente por detrás de Argon en las pruebas más exigentes de terminal y programación. Flash-Lite tiene un rendimiento más débil en tareas complejas de programación y automatización, y sus traducciones en ámbitos especializados necesitan revisión humana.
Claves para elegir una API de Gemini
- Contexto: las API de modelos propios de Google procesan casi 32.000 millones de tokens por minuto. Es una cifra de crecimiento conjunto, no el logro de un solo modelo.
- Tres niveles: Argon se encarga del razonamiento complejo, 3.8 Flash es la opción equilibrada para el uso general y Flash-Lite cubre tareas ligeras de alto volumen.
- Precios escalonados: los precios actuales de entrada son de $2 / $0,75 / $0,30. Los de Argon y Flash se duplicarán cuando terminen sus promociones.
- Cómo interpretar las evaluaciones: las puntuaciones de AA v5.0 son 50 / 31 / 12. Se trata de un índice, no de un porcentaje de respuestas correctas; en tareas sencillas puede que las diferencias no sean tan grandes.
- Costes ocultos: los tokens de razonamiento cuentan como salida y, junto con la caché, los reintentos y las tarifas de herramientas, determinan la factura final.
- Cómo empezar: con APIYI apiyi.com puedes cambiar entre los tres modelos usando una sola clave API y compararlos con entre 100 y 300 muestras.
Resumen
El fuerte aumento del uso de la API de Gemini muestra que los Modelos de Lenguaje Grande ya han entrado en una etapa de producción a gran escala, pero la pregunta central a la hora de elegir modelo no ha cambiado:
- Divide las tareas por nivel: prueba primero Flash-Lite para clasificación y traducción, 3.8 Flash para estructurar documentos y Argon para código complejo y agentes con tareas exigentes.
- Calcula el coste por tarea completada correctamente: lo que hay que optimizar es el coste total de cada tarea que cumple los requisitos, no el precio más bajo por millón de tokens.
- Vigila las fechas límite de precios: la promoción de Argon termina el 30 de noviembre y la de Flash, el 31 de diciembre. Calcula tu presupuesto con los precios posteriores al ajuste.
Los desarrolladores no necesitan siempre el modelo más potente ni el más barato, sino una combinación de modelos capaz de completar las tareas de negocio de forma estable y a un coste aceptable. Una buena opción es usar primero la cuota gratuita de APIYI apiyi.com para comparar los tres niveles y, después, definir la estrategia de enrutamiento para producción.
📚 Referencias
- Mensaje del CEO en los resultados financieros de Alphabet del tercer trimestre de 2026: fuente del dato de 32.000 millones de tokens por minuto
- Enlace:
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q3-2026/ -
Descripción: contexto de la noticia y anuncio original del crecimiento del uso de la API
-
Precios oficiales de Gemini API: tarifas estándar, de caché y de Batch para los tres modelos
- Enlace:
ai.google.dev/gemini-api/docs/pricing -
Descripción: incluye la fecha de finalización de los precios promocionales y la facturación de tokens de razonamiento
-
Documentación de especificaciones de los modelos Gemini: Argon / 3.8 Flash / 3.5 Flash-Lite
- Enlace:
ai.google.dev/gemini-api/docs/models/gemini-4-argon -
Descripción: ventana de contexto, límite de salida, niveles de razonamiento y capacidades de uso de herramientas
-
Comparación de modelos de Artificial Analysis: evaluación independiente de terceros v5.0
- Enlace:
artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gemini-3-8-flash -
Descripción: índice general, pruebas de referencia específicas y mediciones de velocidad
-
Límites de uso y mecanismo de razonamiento de Gemini API: RPM/TPM/RPD y configuración del razonamiento
- Enlace:
ai.google.dev/gemini-api/docs/rate-limits -
Descripción: cuotas y reglas de tokens de razonamiento que conviene consultar antes del lanzamiento
-
Orquestación de múltiples modelos en Google Cloud: Smart Routing y gestión de costos de agentes
- Enlace:
cloud.google.com/blog/products/ai-machine-learning/welcome-to-gemini-at-work-2026 - Descripción: enfoque oficial para el enrutamiento por niveles en empresas
Autor: equipo técnico de APIYI
Consultas técnicas: puedes contactarnos desde la página principal del sitio oficial de APIYI. Para más recursos de integración, visita el centro de documentación en docs.apiyi.com