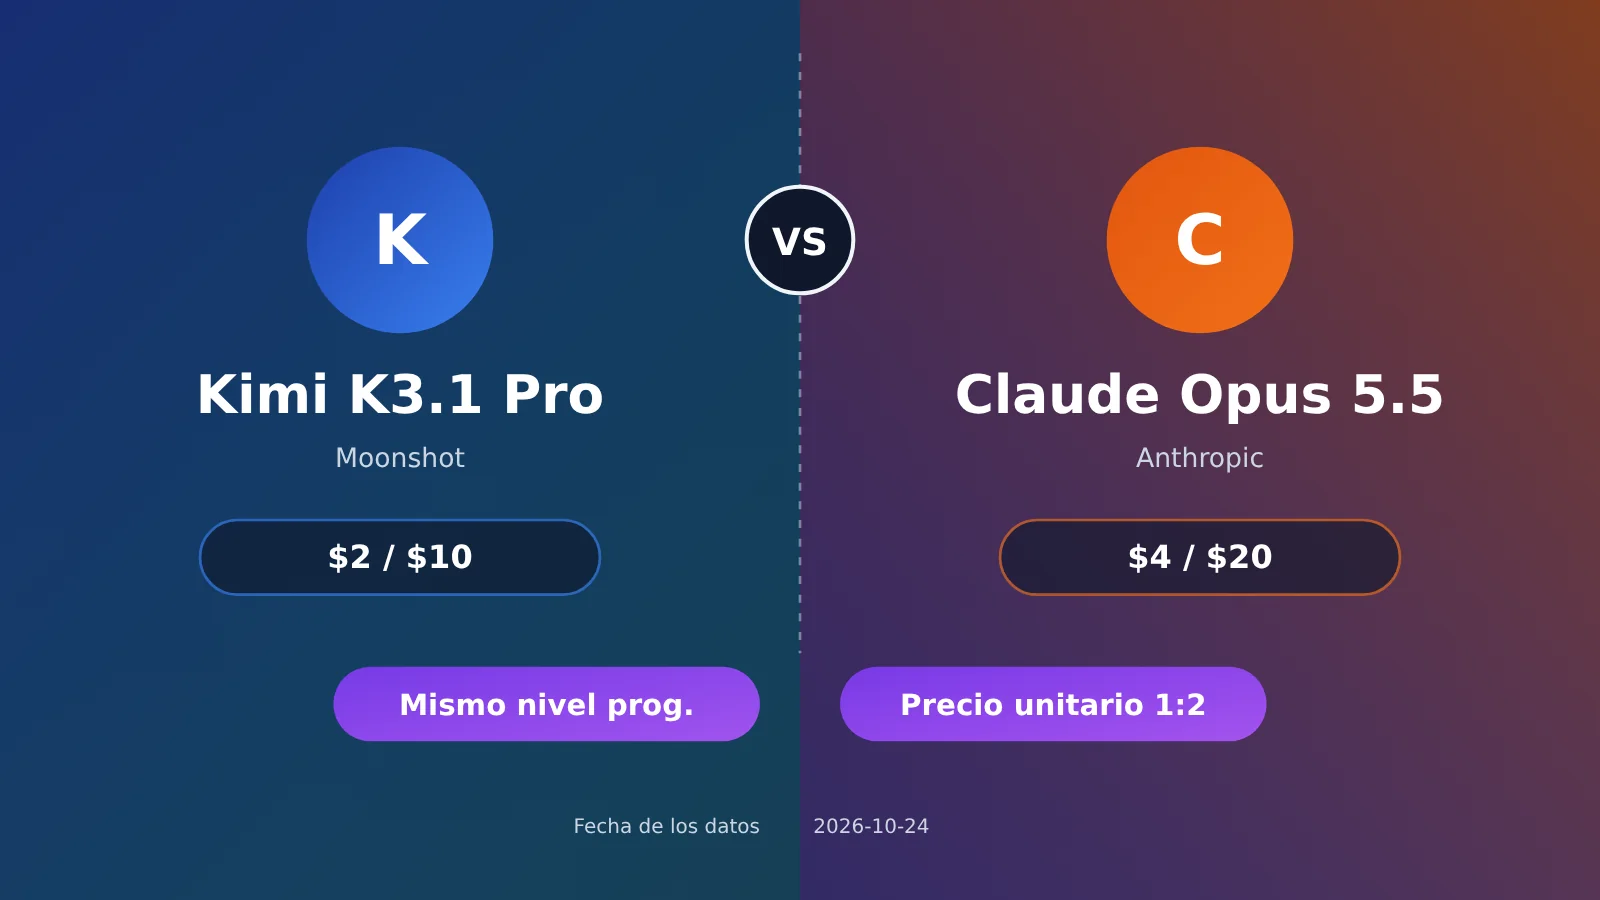
Conclusión de entrada: Kimi K3.1 Pro y Claude Opus 5.5 están al mismo nivel en programación. En los resultados de Terminal-Bench 4.0 publicados por Moonshot, K3.1 Pro obtuvo un 65,7 % y Opus 5.5, un 66,4 %: el primero quedó unos 0,7 puntos porcentuales por debajo. En cambio, si nos fijamos solo en Terminal-Bench 4.0, el análisis de terceros de Artificial Analysis sitúa a K3.1 Pro en primer lugar. En cuanto al precio, las tarifas de entrada y salida de K3.1 Pro son exactamente la mitad que las de Opus 5.5 (2/10 USD frente a 4/20 USD), mientras que el precio con aciertos de caché es el mismo en ambos. Sin embargo, K3.1 Pro necesita más tiempo para razonar y, según los cálculos de terceros, el costo real por tarea no llega a ser la mitad.
Todos los datos que aparecen a continuación incluyen su fuente y se clasifican en tres niveles: datos oficiales declarados por las propias empresas (blogs de Moonshot y documentación oficial de Kimi y Anthropic), terceros (Artificial Analysis, en adelante AA) y sin verificar (no hay datos públicos por ahora, así que solo podemos ofrecer una valoración orientativa). Puedes entender los tokens como las «unidades de texto» que se usan para calcular el costo del modelo: un carácter chino equivale aproximadamente a algo más de 1 token. Todos los precios se expresan en dólares por millón de tokens.
Este artículo no va de «quién aplasta a quién». Los dos modelos tienen puntos fuertes y débiles. Nos limitaremos a presentar los datos según cada criterio y, después, recomendaremos uno u otro según el caso de uso.
Lo más importante: al terminar de leer, podrás decidir si para tus tareas te conviene más Kimi K3.1 Pro o Claude Opus 5.5, y también conocerás la diferencia real entre sus costos.
1. Diferencias clave entre Kimi K3.1 Pro y Claude Opus 5.5
Empecemos con una tabla que resume las diferencias más importantes. En las siguientes secciones las veremos una por una. La columna «Nivel de la fuente» indica de dónde procede cada dato para que puedas comprobarlo por tu cuenta.
| Dimensión de comparación | Kimi K3.1 Pro | Claude Opus 5.5 | Nivel de la fuente |
|---|---|---|---|
| Terminal-Bench 4.0 (cifra oficial) | 65,7 % | 66,4 % | Datos publicados por la propia empresa (blog de Moonshot) |
| Terminal-Bench 4.0 (cifra de AA) | 67 %, la puntuación más alta entre los modelos evaluados por AA | No aparece en las fuentes consultadas | Terceros (AA) |
| Precio por entrada / salida | $2 / $10 | $4 / $20 | Precios oficiales |
| Precio con acierto de caché | $0,20 | $0,20 | Precios oficiales |
| Longitud del contexto | 1.048.576 tokens | Hasta 1 millón (varía según el modelo) | Documentación oficial |
| ¿Se puede desactivar el razonamiento? | No, solo se puede ajustar su intensidad | Consulta la documentación de Anthropic | Documentación oficial / sin verificar |
| Pesos abiertos | Se ha comprometido a publicarlos antes del 4 de noviembre de 2026 | No disponibles | Datos publicados por la propia empresa |
El «contexto» es la cantidad total de contenido que el modelo puede leer de una sola vez. Ambos modelos admiten alrededor de un millón de tokens, suficiente para incluir prácticamente todo un repositorio de código de tamaño medio. Por eso, este aspecto no será una diferencia decisiva a la hora de elegir.
2. Comparativa de precios de Kimi K3.1 Pro y Claude Opus 5.5: precios unitarios de los cinco niveles
Antes, aclaremos dos términos de facturación. Lectura desde caché: si envías repetidamente el mismo contenido inicial (por ejemplo, una indicación del sistema o un resumen de un repositorio de código), el proveedor del modelo lo guarda y cobra una tarifa mucho menor cuando vuelve a leerlo. Escritura en caché: es el costo de guardar ese contenido en la caché por primera vez. El precio varía según se conserve durante 5 minutos o 1 hora.
| Modelo | Entrada | Salida | Lectura desde caché | Escritura en caché (5 min) | Escritura en caché (1 h) |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Claude Opus 5.5 | $4.00 | $20.00 | $0.20 | $5.00 | $8.00 |
| Claude Sonnet 5.5 (referencia) | $2.00 | $10.00 | $0.10 | $2.50 | $4.00 |
Nota sobre los precios: datos consultados el 24 de octubre de 2026. Precios en dólares por millón de tokens, sin impuestos. Fuentes: precios oficiales de Kimi y Anthropic.
2.1 Diferencias de precio: el doble en entrada y salida, sin diferencia en lectura desde caché
En entrada y salida, Opus 5.5 cuesta exactamente el doble que K3.1 Pro. La tarifa de lectura desde caché es de $0.20 en ambos casos, así que no hay diferencia. Kimi es más barato en escritura en caché: $2 frente a $5 para el nivel de 5 minutos, y $4 frente a $8 para el de 1 hora.
Si tomamos Claude Sonnet 5.5 como referencia, su precio por entrada y salida es idéntico al de K3.1 Pro, pero la lectura desde caché cuesta la mitad ($0.10). Por eso, si solo buscas una opción «más económica dentro de la gama insignia», el modelo con el que realmente conviene comparar Kimi es Sonnet 5.5, no solo Opus 5.5.
2.2 Cada proveedor ofrece una versión de alta velocidad
Ambos proveedores tienen versiones más rápidas y más caras. Al elegir, asegúrate de comparar las versiones correctas:
kimi-k3.1-pro-highspeed: $4 / $20, lectura desde caché a $0.20, escritura en caché por 5 minutos a $4 y por 1 hora a $8 (precios oficiales).- Modo Claude Opus 5.5 Fast: $8 / $40, compatible con todo el contexto, incluidas las partes que superan los 200k (precios oficiales).
Como puedes ver, el precio por entrada y salida de la versión de alta velocidad de Kimi es el mismo que el de Opus 5.5 estándar, pero la escritura en caché por 5 minutos sigue siendo más barata.
3. Kimi K3.1 Pro vs Claude Opus 5.5 en pruebas de programación: dos métricas que conviene analizar por separado
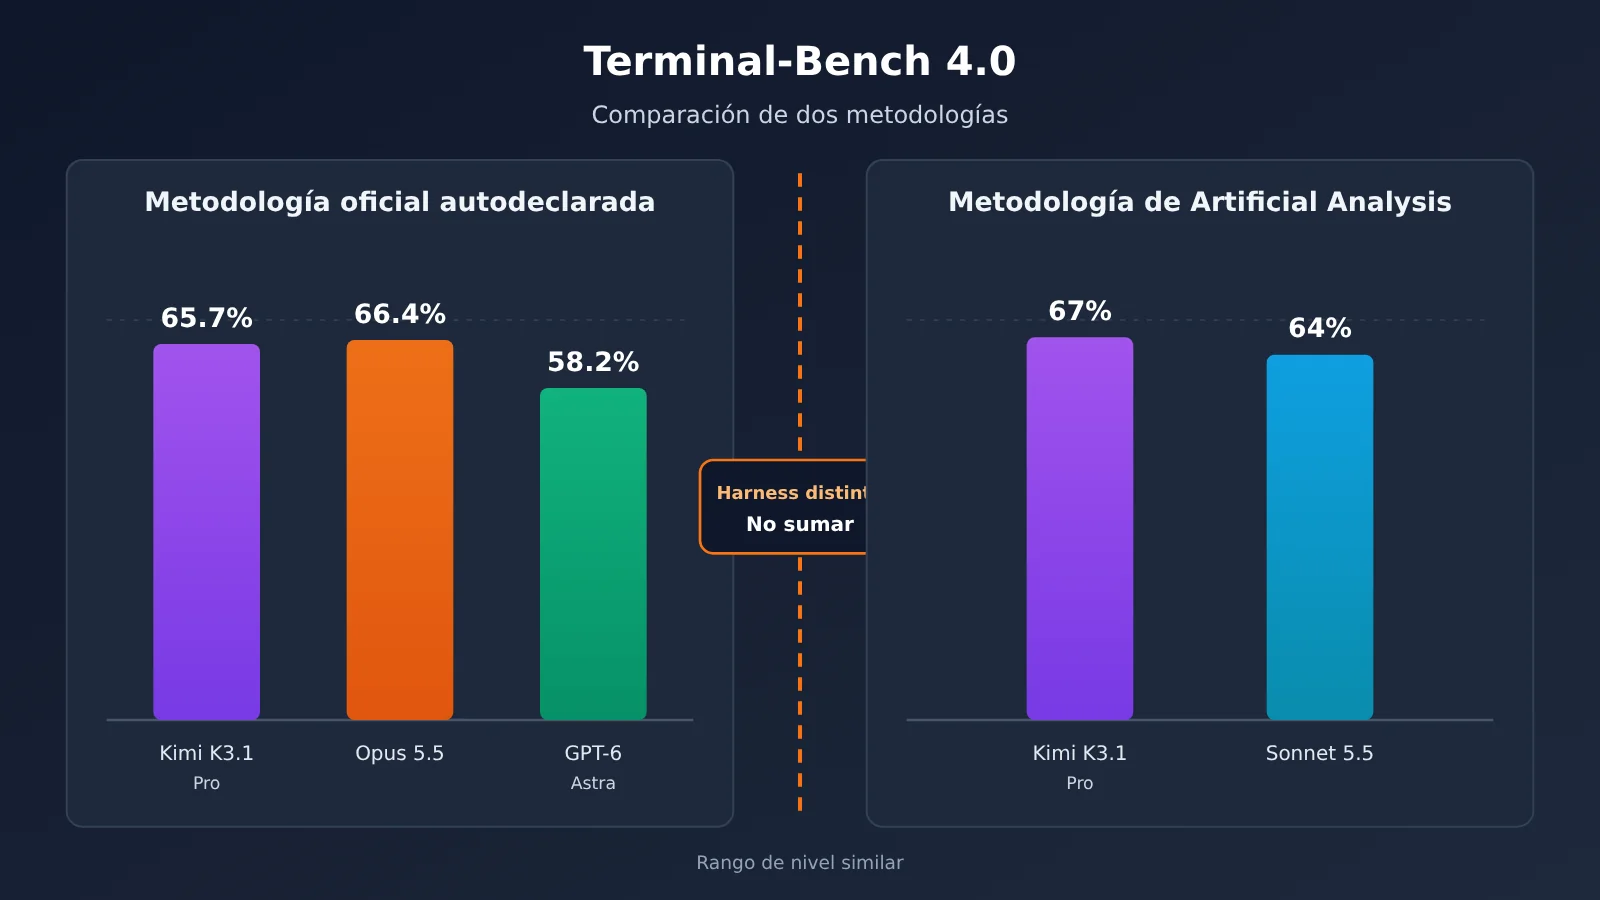
Terminal-Bench 4.0 es una batería de pruebas que evalúa tareas reales en la terminal, como instalar dependencias, corregir errores y ejecutar scripts. Para aprobar, hay que obtener el resultado final correcto. Las dos tablas siguientes proceden de instituciones distintas, así que sus cifras no se pueden comparar entre sí.
3.1 Métricas autodeclaradas por los modelos (blog de Moonshot)
| Prueba | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% |
| BenchCAD (reconstrucción 3D mediante código CAD generado a partir de múltiples vistas) | 92.7% (con herramientas) | 96.2% | — |
Las pruebas se realizaron con reasoning_effort configurado en max (es decir, con la intensidad de razonamiento al máximo), y K3.1 Pro se ejecutó con el harness de Claude Code. Moonshot afirma en su blog que K3.1 Pro está «ligeramente por detrás de Claude Opus 5.5».
3.2 Criterio de terceros (Artificial Analysis, 2026-10-23)
| Prueba | Kimi K3.1 Pro | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| Intelligence Index (índice de inteligencia general) | 55 (puesto 4) | 58 | 56 |
| Terminal-Bench 4.0 | 67 % (la puntuación más alta) | No aparece en las fuentes de referencia | 64 % |
| GDPval-AA (Elo) | 1846 (puesto 3) | 1866 | — |
| AA-Omniscience (fiabilidad del conocimiento) | Índice 30, tasa de alucinaciones del 44 % | No aparece en las fuentes de referencia | — |
La puntuación general de Opus 5.5 se obtuvo con la configuración «max with fallback». Muse Wonder Full también obtuvo 56 puntos en la misma clasificación. Elo es un sistema de puntuación similar al que se usa en el ajedrez: se calcula a partir de los resultados de enfrentamientos por parejas; cuanto más alta es la puntuación, mejor. La tasa de alucinaciones puede entenderse, a grandes rasgos, como la proporción de veces que el modelo inventa una respuesta cuando no sabe contestar. El 44 % de K3.1 Pro en este indicador merece atención.
3.3 Por qué no se deben mezclar los dos criterios
El 65,7 % oficial y el 67 % de AA son resultados de K3.1 Pro en Terminal-Bench 4.0, pero se obtuvieron con distintos harness de prueba. Un harness es, en esencia, el programa que envuelve el examen del modelo y determina qué herramientas puede usar, cómo lee y escribe archivos y cuánto tiempo tiene antes de que se agote el plazo. Si cambia ese entorno, también puede cambiar la puntuación del mismo modelo.
Por eso, no se puede afirmar que «K3.1 Pro obtuvo un 67 % en AA, por encima del 66,4 % de Opus en la evaluación oficial». La lectura correcta es que, según el criterio oficial, K3.1 Pro queda 0,7 puntos porcentuales por debajo; según el criterio de AA, es el modelo con la puntuación más alta entre los que ha evaluado esa organización. Ambas conclusiones son válidas por separado y, consideradas en conjunto, solo indican que los dos modelos están en un nivel similar.
3.4 ¿Qué significa en la práctica una diferencia de 1 punto?
Terminal-Bench 4.0 evalúa cada tarea de forma estricta: solo cuenta como aprobada o no aprobada. Un punto porcentual equivale aproximadamente a acertar una tarea más o menos por cada cien. Además, estas diferencias suelen aparecer en tareas poco frecuentes y de larga cola, como las que usan cadenas de herramientas poco comunes o configuraciones de entorno especiales. En el trabajo diario —crear interfaces, modificar código de negocio o añadir pruebas unitarias—, una diferencia tan pequeña apenas se nota.
Lo que de verdad afecta a la experiencia de desarrollo son dos diferencias de «personalidad». La primera es el estilo de razonamiento: K3.1 Pro razona siempre, y AA observó que sus respuestas son más largas en cada tarea (fuente externa). La segunda son sus hábitos al usar herramientas; por ejemplo, con qué frecuencia ejecuta comandos o si suele leer los archivos antes de modificarlos. Por ahora no hay datos públicos fiables para compararlos en este aspecto (sin verificar), así que lo recomendable es probarlos con algunas tareas reales en tu propio repositorio.
4. Ventajas y limitaciones de Kimi K3.1 Pro y Claude Opus 5.5
Ventajas de Kimi K3.1 Pro (documentación oficial):
- El precio por token de entrada y de salida es la mitad que el de Opus 5.5, y la escritura en caché también es más barata.
- Ventana de contexto de 1,048,576 tokens.
max_completion_tokenstiene un valor predeterminado de 131072 y puede llegar hasta 1048576. - Es compatible con los formatos de interfaz de OpenAI y Anthropic. La documentación oficial recomienda usarlo en agentes de programación como Kimi Code, Codex y Claude Code.
- Admite salida estructurada, llamadas a herramientas y continuación con
partial. Los clientes de la API pueden optar por la retención cero de datos, y la empresa se ha comprometido a publicar los pesos completos antes del 2026-11-04.
Limitaciones de Kimi K3.1 Pro (documentación oficial y fuentes externas):
- No se puede desactivar el razonamiento.
reasoning_effortsolo admitelow,highymax, y su valor predeterminado esmax. temperatureestá fijado en 1.0 ytop_p, en 0.95. No se pueden especificar otros valores para estos parámetros.- No admite imágenes mediante URL públicas: solo se pueden enviar codificadas en base64 (convertidas en una larga cadena de texto) o mediante
ms://file-id. - AA midió una tasa de alucinación del 44 % y respuestas relativamente largas por tarea.
Ventajas de Claude Opus 5.5: ocupa los primeros puestos tanto en las puntuaciones oficiales como en el índice general de AA. Aventaja a K3.1 Pro en unos 3,5 puntos porcentuales en BenchCAD y también obtiene una puntuación más alta en GDPval-AA. Además, ofrece una caché de 1 hora y el modo Fast, que permiten ajustar el equilibrio entre velocidad y costo según las necesidades. Su principal limitación es el precio: los tokens de entrada y salida cuestan el doble que en K3.1 Pro, y el modo Fast vuelve a duplicar ese costo.
5. Kimi K3.1 Pro vs. Claude Opus 5.5: qué modelo elegir para 6 tipos de tareas
Un «Agent» es una aplicación basada en un modelo que puede planificar pasos, usar herramientas y ejecutar tareas en varias rondas. Por ejemplo, un asistente de programación que modifica el código y luego ejecuta las pruebas automáticamente.
| Tipo de tarea | Recomendación | Conclusión en una frase |
|---|---|---|
| Tareas por lotes a gran escala | Kimi K3.1 Pro | Cuesta la mitad por unidad y también es más barato escribir en la caché, así que el ahorro es más notable al procesar tareas por lotes |
| Agents de programación con varias rondas | Ambos pueden funcionar; conviene probarlos | Sus puntuaciones están en un nivel similar. La elección depende sobre todo de si la longitud del razonamiento y la forma de usar las herramientas encajan con tu repositorio |
| Generación de código 3D / CAD | Claude Opus 5.5 | Según los resultados de BenchCAD publicados por la propia empresa, Opus 5.5 es más consistente: 96,2 % frente a 92,7 % |
| Comprensión de imágenes | Elige según la forma de integración | K3.1 Pro admite imágenes, pero no permite pasar directamente URL públicas. No hay datos comparables con el mismo criterio sobre la capacidad de ambos modelos para procesar imágenes (sin verificar) |
| Escenarios empresariales con requisitos de estabilidad y cumplimiento | Preferencia por Claude Opus 5.5; si necesitas controlar los datos, también puedes considerar Kimi | Opus 5.5 obtiene un índice general más alto. Kimi ofrece retención cero de datos y pronto abrirá los pesos |
| Escenarios de baja latencia que requieren desactivar el razonamiento | Claude | No se puede desactivar el razonamiento en K3.1 Pro. Para configurar el razonamiento de Claude, consulta la documentación de Anthropic; también puedes considerar el modo Fast |
6. Kimi K3.1 Pro vs Claude Opus 5.5: cuentas de costes; reducir el precio a la mitad no significa reducir el coste a la mitad
Hagamos un cálculo sencillo: una misma solicitud con 50.000 tokens de entrada y 5.000 tokens de salida.
- Kimi K3.1 Pro: 50.000 × $2 ÷ 1.000.000 + 5.000 × $10 ÷ 1.000.000 = $0.10 + $0.05 = $0.15
- Claude Opus 5.5: 50.000 × $4 ÷ 1.000.000 + 5.000 × $20 ÷ 1.000.000 = $0.20 + $0.10 = $0.30
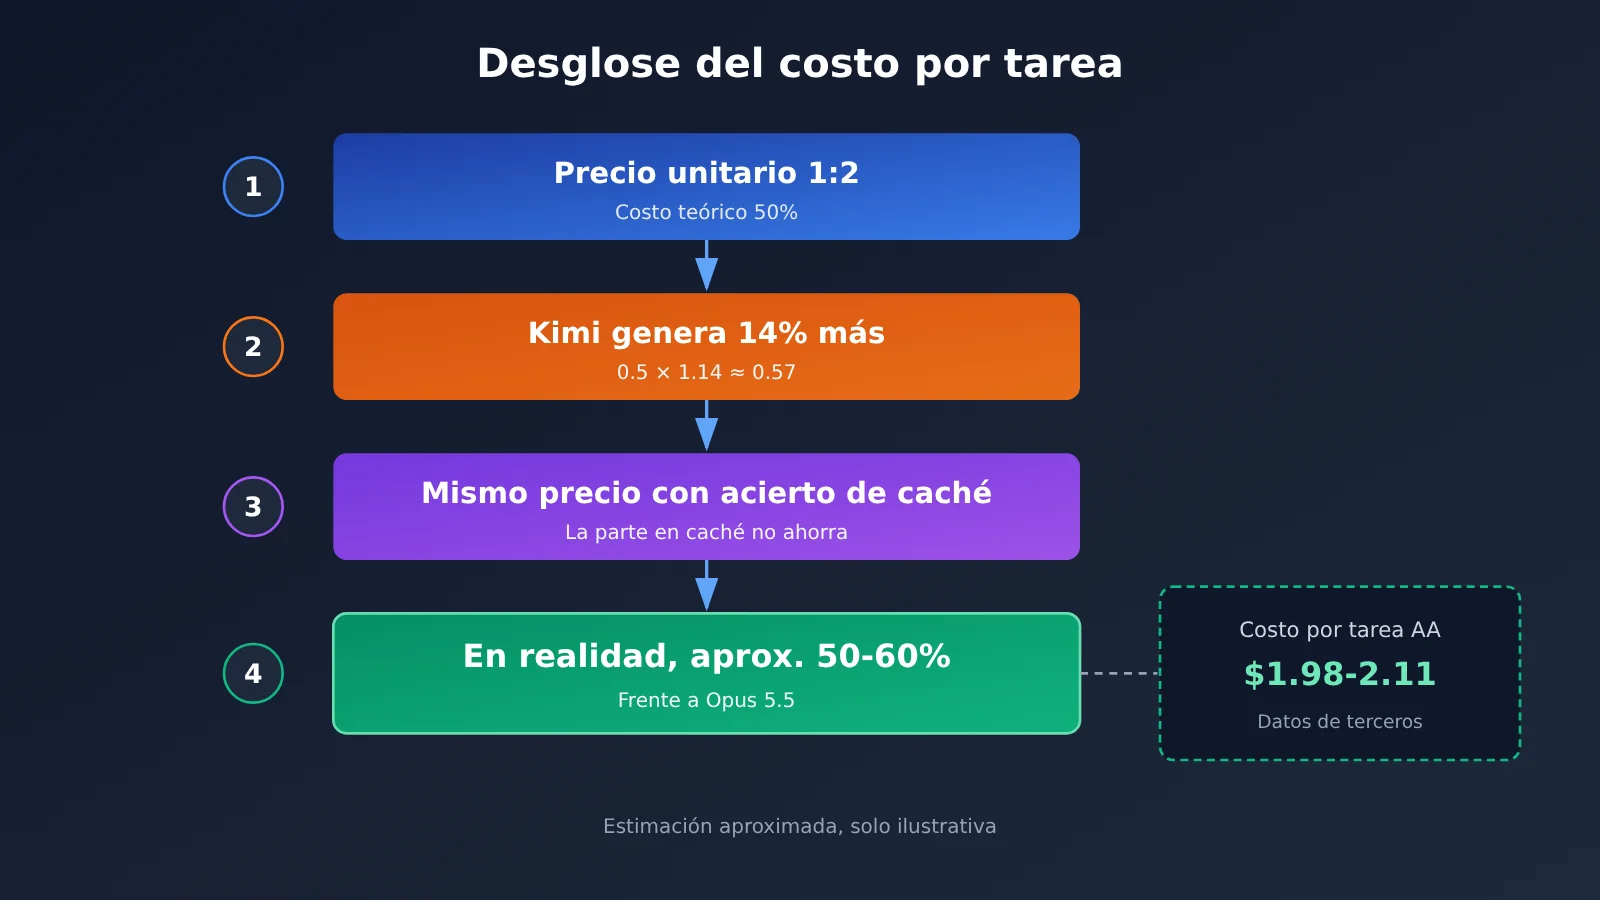
Según el precio por token, el coste es justo la mitad. Pero ese cálculo parte de una premisa: que ambos modelos generan la misma cantidad de texto. En la práctica, no es así. Los datos de AA indican que Kimi genera alrededor de un 14 % más de tokens de salida por tarea: una media de unos 55.000 tokens por tarea y un coste aproximado de $1.98 por tarea (en la página del modelo aparece $2.11) (tercero). La conclusión de AA es que, aunque el precio por token de Kimi es la mitad que el de Opus 5.5, su proceso de razonamiento es más prolijo, así que el coste real por tarea no llega a reducirse a la mitad.
Hagamos una estimación aproximada (sin verificar, solo a modo de ejemplo): en las tareas de agentes de programación, la mayor parte del coste suele venir de la salida. Si Kimi genera un 14 % más, el coste de la parte correspondiente a la salida sería aproximadamente el 57 % del de Opus 5.5 (1.14 × 0.5 ≈ 57 %). El ahorro sería de algo más del 40 %, no del 50 %. Sigue siendo un ahorro considerable, pero conviene no calcular el presupuesto suponiendo que será del 50 %.
7. Cómo usar Kimi K3.1 Pro y Claude Opus 5.5 desde China
Los desarrolladores de China que se conectan directamente a las API oficiales del extranjero suelen encontrarse con problemas de pago y de red. APIYI (apiyi.com) es una plataforma que reúne API de varios modelos. Con una sola clave API puedes usar distintos modelos; sus interfaces son compatibles con el formato de OpenAI y la facturación es por uso. Según la comprobación del 24 de octubre de 2026, los precios de claude-opus-5-5 en la plataforma son de $4 por entrada, $20 por salida y $0.2 por lectura de caché; los de claude-sonnet-5-5 son de $2 / $10 / $0.1. En ambos casos, coinciden con los precios oficiales de Anthropic. Los modelos de la serie Kimi disponibles actualmente son:
kimi-k3: $3 / $15, lectura de caché: $0.3kimi-k2.7-code: $0.95 / $3.99kimi-k2.6: $0.6 / $2.4kimi-k2.5: $0.6 / $3.15
Ese día, kimi-k3.1-pro aún no aparecía en la lista. Consulta en la lista de modelos de APIYI el nombre y el precio que tendrá en la plataforma. Lo incorporaremos lo antes posible. Así puedes empezar a usarlo:
- Formato compatible con OpenAI: configura
base_urlcomohttps://api.apiyi.com/v1 - Formato de Anthropic: configura la dirección base como
https://api.apiyi.com - Los agentes de programación (como Claude Code) suelen usar el formato de Anthropic; los SDK habituales, el formato de OpenAI
Recomendación para empezar: puedes aprovechar el crédito gratuito para nuevos usuarios en APIYI (apiyi.com) y probar
claude-opus-5-5yclaude-sonnet-5-5con algunas tareas reales en tu propio repositorio. Así tendrás una referencia para compararlos. Consulta la lista de modelos de la plataforma para conocer los nombres y precios concretos. Incorporaremos Kimi K3.1 Pro lo antes posible; cuando esté disponible, solo tendrás que cambiar el nombre del modelo para compararlo directamente.
8. Recomendaciones para elegir entre Kimi K3.1 Pro y Claude Opus 5.5
Si tienes un volumen de tareas alto, el presupuesto es ajustado y no te importa que el modelo esté siempre pensando, Kimi K3.1 Pro ofrece una mejor relación calidad-precio. Si priorizas la estabilidad general, necesitas generar contenido 3D/CAD o quieres desactivar el modo de pensamiento para reducir la latencia, te conviene más Claude (Opus 5.5 o Sonnet 5.5). En tareas de agentes de programación con varias rondas, ambos están al mismo nivel en las pruebas. En lugar de fijarte en las clasificaciones, te recomendamos probarlos durante una semana con tu propio código.
Hay otra opción que es fácil pasar por alto: si te interesa Kimi principalmente porque cuesta «la mitad», el precio por entrada y salida de Claude Sonnet 5.5 es exactamente el mismo, su precio por acierto de caché es más bajo y su índice general de AA es ligeramente superior. También puedes incluirlo en tu lista de candidatos.
Preguntas frecuentes (FAQ)
Q1: ¿Cuánta diferencia hay realmente entre Kimi K3.1 Pro y Claude Opus 5.5 en programación?
Según los datos publicados por Moonshot, K3.1 Pro queda 0,7 puntos porcentuales por detrás en Terminal-Bench 4.0 (65,7 % frente a 66,4 %). En las pruebas independientes de AA, K3.1 Pro obtuvo la puntuación más alta de todos los modelos evaluados en Terminal-Bench 4.0. Ambos están al mismo nivel, con una diferencia de aproximadamente 1-3 puntos porcentuales.
Q2: ¿Cuántas veces más caro es uno que otro?
El precio por entrada y salida es el doble, mientras que el precio por acierto de caché es el mismo (0,20 $ en ambos casos). La escritura en caché es más barata con Kimi. Como Kimi genera respuestas más largas, el coste real por tarea es aproximadamente entre el 50 % y el 60 % del de Opus 5.5 (estimación).
Q3: ¿Por qué el 65,7 % oficial y el 67 % de AA no coinciden?
Se basan en distintos entornos de prueba (harness). El dato oficial usa el harness de Claude Code. Las puntuaciones obtenidas con metodologías diferentes solo se pueden comparar dentro de cada una; no es válido compararlas directamente entre sí.
Q4: ¿Se puede desactivar el modo de pensamiento de Kimi K3.1 Pro?
No. Solo se puede reducir `reasoning_effort` a `low`. Los valores de `temperature` y `top_p` también son fijos. Para los casos en los que la latencia es muy importante, te recomendamos considerar los modelos de Claude.
Q5: ¿Cómo se pueden probar y comparar ambos modelos desde China?
Puedes usar APIYI apiyi.com para llamar a `claude-opus-5-5` con la misma clave. Solo tienes que configurar `base_url` como `https://api.apiyi.com/v1`. El nombre del modelo y el precio de Kimi K3.1 Pro dependen de la lista de modelos de la plataforma. Lo añadiremos lo antes posible; mientras tanto, puedes usar `kimi-k3` para hacer una comparación inicial.
Q6: Si estás empezando, ¿cuál conviene más para practicar?
Te recomendamos empezar con Claude Sonnet 5.5 para establecer una referencia, ya que su precio es el mismo que el de K3.1 Pro. Al registrarte en APIYI apiyi.com, recibirás crédito gratuito para pruebas. Consulta la lista de modelos de la plataforma para ver los modelos disponibles y sus precios. Añadiremos K3.1 Pro lo antes posible; cuando esté disponible, podrás cambiar directamente el nombre del modelo para compararlos.
Kimi K3.1 Pro vs. Claude Opus 5.5: puntos clave
- Programación, mismo nivel: según las cifras oficiales, K3.1 Pro queda 0,7 puntos porcentuales por debajo; en las pruebas de AA, obtiene la puntuación más alta de Terminal-Bench 4.0
- Precio por token, relación 1:2: $2/$10 frente a $4/$20; el precio con aciertos de caché es el mismo: $0.20
- El costo no se reduce a la mitad: Kimi genera alrededor de un 14 % más de tokens por tarea; AA midió un costo de $1.98-2.11 por tarea
- No mezcles métricas: el 65,7 % oficial y el 67 % de AA se obtuvieron con distintos entornos de evaluación
- Puntos fuertes de Opus: lidera en el índice general, BenchCAD y GDPval-AA
- Limitaciones de Kimi: no se puede desactivar el modo de razonamiento, no permite enviar imágenes mediante URL públicas y su tasa de alucinaciones es del 44 %
- Cómo empezar: puedes probar primero la serie Claude en APIYI apiyi.com. El modelo y el precio de K3.1 Pro dependerán de la lista de la plataforma; lo ofreceremos lo antes posible
Resumen
La comparación entre Kimi K3.1 Pro y Claude Opus 5.5 se resume en tres puntos:
- Capacidad: sus capacidades de programación y de agente están al mismo nivel; las diferencias de puntuación entran dentro del margen de error de las pruebas y de las diferencias entre criterios de evaluación.
- Precio: el precio por token es exactamente el doble, pero Kimi dedica más tiempo al razonamiento, por lo que el costo real se reduce en algo más del 40 %.
- Elección del modelo: Kimi es una opción a considerar para tareas por lotes y escenarios con presupuestos ajustados; Claude es preferible para 3D/CAD, baja latencia y situaciones que exigen una mayor estabilidad general.
La forma más fiable de decidir es probarlos con tus propias tareas. Puedes establecer primero una referencia con la serie Claude en APIYI apiyi.com. El modelo y el precio dependerán de la lista de modelos de la plataforma; Kimi K3.1 Pro estará disponible lo antes posible y, una vez lanzado, bastará con cambiar el nombre del modelo para compararlos.
Referencias
- Blog oficial de Moonshot y documentación de Kimi API: resultados de K3.1 Pro, límites de parámetros y precios
- Enlace:
platform.moonshot.cn/docs -
Descripción: resultados publicados por la propia empresa en Terminal-Bench 4.0 y BenchCAD, además de información sobre los parámetros
-
Precios oficiales de Anthropic: cinco niveles de precios para Claude Opus 5.5 / Sonnet 5.5
- Enlace:
anthropic.com/pricing -
Descripción: incluye el modo Fast y el nivel de caché de 1 hora
-
Artificial Analysis: índice comparativo de terceros y costo por tarea
- Enlace:
artificialanalysis.ai -
Descripción: datos del 23 de octubre de 2026, incluidos Terminal-Bench 4.0, GDPval-AA y AA-Omniscience
-
Lista de modelos de APIYI: modelos disponibles en la plataforma y sus precios
- Enlace:
docs.apiyi.com/models - Descripción: verificado el 24 de octubre de 2026; consulta la lista en tiempo real para obtener la información más actualizada
Autor: Equipo técnico de APIYI
Consultas técnicas: Para más información, visita el centro de documentación en docs.apiyi.com. Consulta la lista de modelos de la plataforma para ver los modelos y precios actualizados. Esperamos lanzar pronto el modelo Kimi K3.1 Pro.