Nota del autor: una guía práctica para entender cómo se calcula el precio de MiniMax M3.1 Flash, cómo ahorrar y si te conviene más pagar por uso o suscribirte a M Plan.
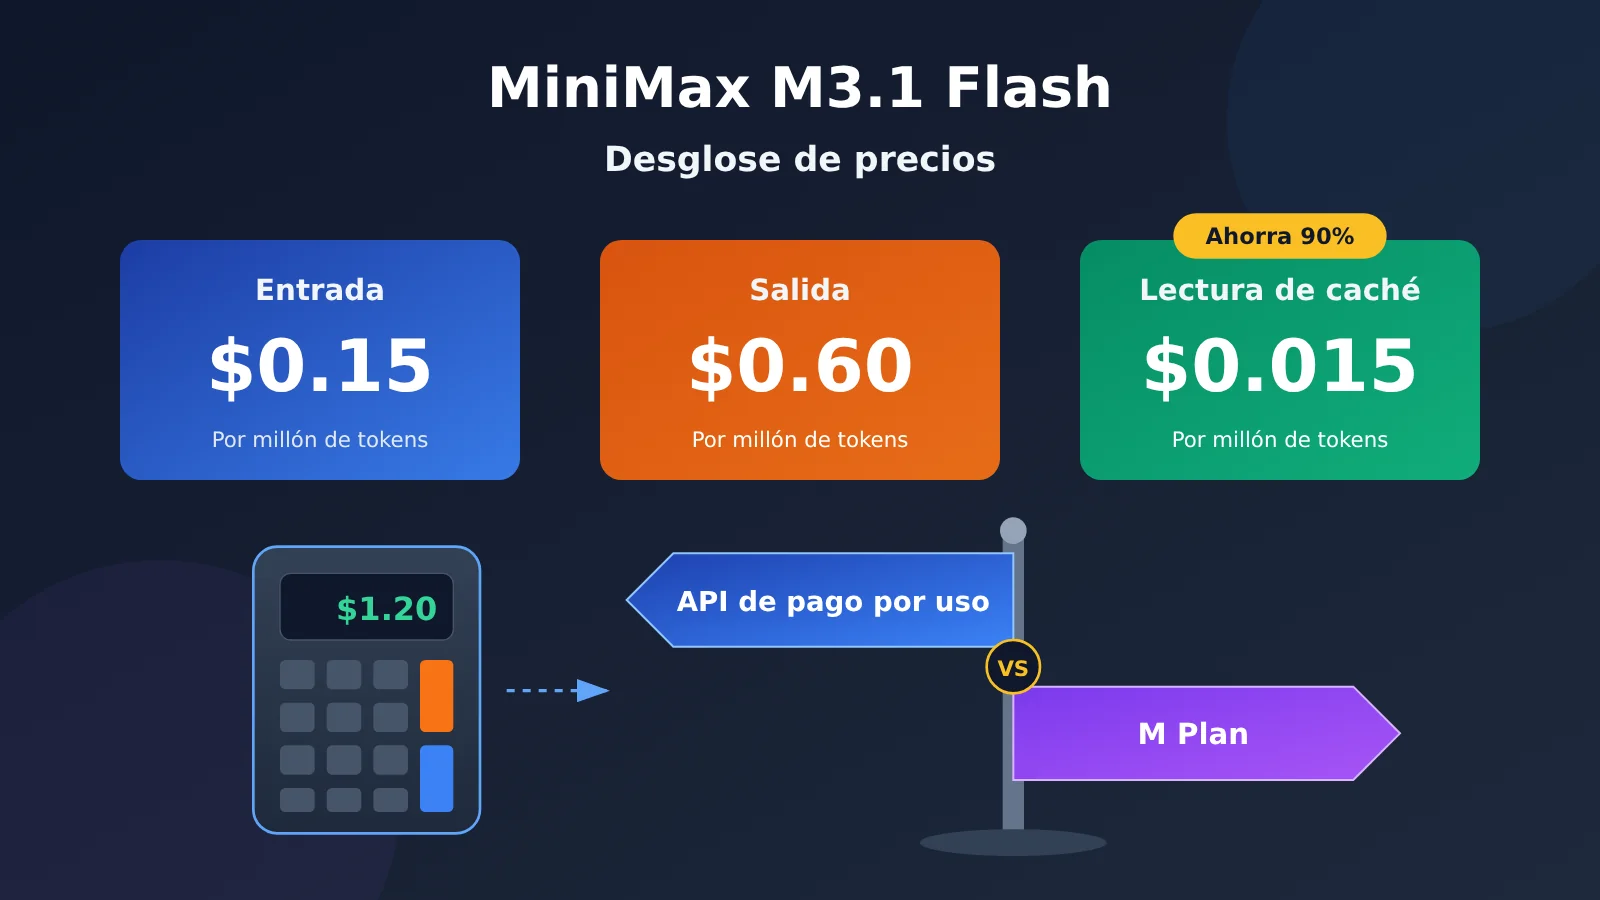
La conclusión, en pocas palabras: MiniMax M3.1 Flash cuesta $0.15 por cada millón de tokens de entrada, $0.60 por cada millón de tokens de salida y $0.015 por cada millón de tokens leídos de la caché. La mayor parte de la factura suele venir de la salida (incluido el proceso de razonamiento del modelo). Para ahorrar, puedes hacer dos cosas: bajar el nivel de esfuerzo o colocar el contenido fijo al principio de la solicitud para que se aproveche de la caché.
Esto no es otra noticia sobre el lanzamiento. Ya hablamos del lanzamiento en este sitio. Aquí nos centramos solo en el costo: cuáles son los tres precios por unidad, cuánto puede costar una conversación o una tarea de agente, en qué es más barato que M3 y cómo elegir entre el pago por uso y la suscripción mensual.
Qué te llevas: al terminar de leer, podrás calcular por tu cuenta el gasto mensual en MiniMax M3.1 Flash, evitar los dos errores de facturación más habituales y elegir la forma de pago que mejor se adapte a ti.
Puntos clave sobre el precio de MiniMax M3.1 Flash
Primero, aclaremos un término: token es la unidad mínima que se usa para calcular el costo del modelo. Puedes entenderlo como un «fragmento de texto». Según la conversión oficial, unos 750 términos en inglés equivalen a aproximadamente 1000 tokens. La página de precios no indica una equivalencia oficial para el chino; consulta el consumo real en la factura de la consola.
La siguiente tabla muestra todos los precios unitarios de MiniMax M3.1 Flash, según la página oficial de precios de MiniMax:
| Concepto de facturación | Precio (por millón de tokens) | Explicación sencilla | Contenido típico |
|---|---|---|---|
| Entrada | $0.15 | Todo lo que envías al modelo | Indicaciones del sistema, historial del chat, documentos, imágenes y videos que subes |
| Salida | $0.60 | Todo lo que el modelo genera, incluido el proceso de razonamiento | Respuesta final y contenido de razonamiento |
| Lectura de caché | $0.015 | La parte de la entrada que coincide con solicitudes anteriores y se recupera de la caché | La misma indicación del sistema en cada solicitud, documentos extensos que se vuelven a consultar |
| Adicional: web_search | $0.01 por consulta | Herramienta de búsqueda en Internet del servidor, con cobro por consulta | Búsquedas realizadas por un agente |
Hay dos puntos que conviene recordar. Primero, el precio de salida es 4 veces el de entrada, así que «cuánto escribe el modelo» influye más en la factura que «cuánto le envías». Segundo, la lectura de caché cuesta solo una décima parte del precio de entrada: la parte de la entrada que coincide con la caché permite ahorrar un 90 %.
Cómo entender la fórmula de facturación de MiniMax M3.1 Flash
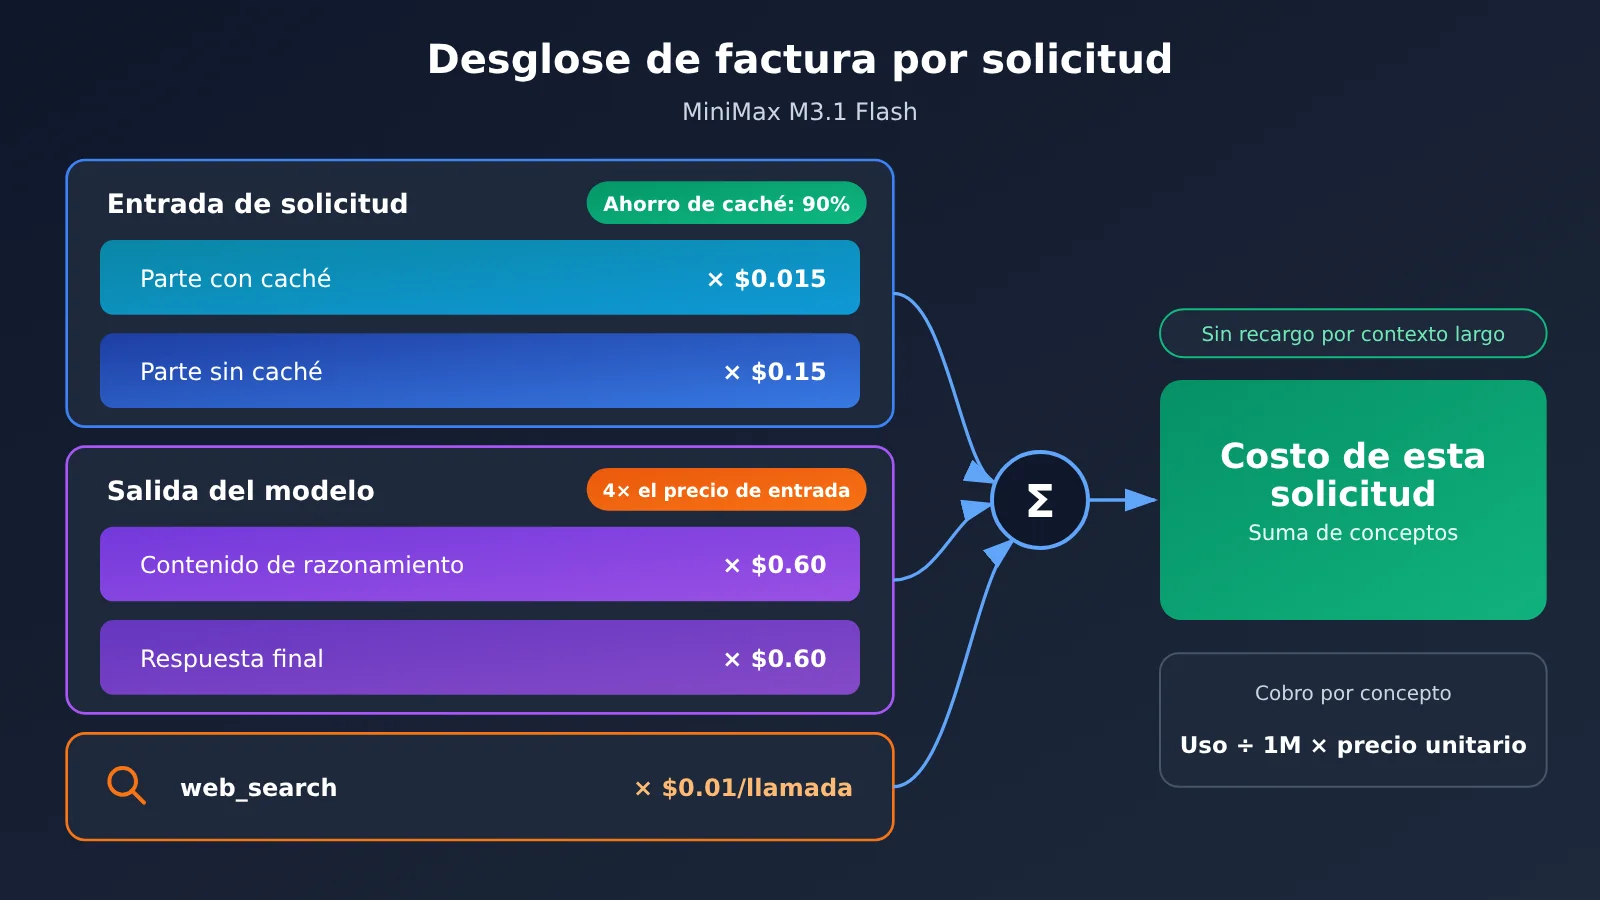
El cálculo oficial es sencillo: costo = consumo ÷ 1.000.000 × precio unitario. Se calcula cada concepto por separado y luego se suman los resultados; el importe se descuenta del saldo de la cuenta.
La factura de una solicitud se puede dividir en tres partes: entrada recuperada de la caché × $0.015, entrada que no coincide con la caché × $0.15 y salida (respuesta + razonamiento) × $0.60. Al final, se añade el número de consultas de búsqueda × $0.01.
Además, MiniMax M3.1 Flash tiene una ventana de contexto de 1.000.000 de tokens (es decir, el volumen máximo de contenido que el modelo puede «ver» de una sola vez). La página oficial de precios indica claramente que no hay recargo por contexto largo: da igual si incluyes 100.000 u 800.000 tokens, el precio unitario no cambia.
Cálculo del precio de MiniMax M3.1 Flash: 3 ejemplos
La cantidad de tokens de los siguientes ejemplos es hipotética y sirve únicamente para mostrar cómo hacer los cálculos; no son datos medidos. Puedes sustituirla por tus propias cifras y aplicar las mismas fórmulas.
Ejemplo 1: una conversación normal
Supongamos que hay 2,000 tokens de entrada (sin aciertos de caché) y 1,500 tokens de salida (incluido el razonamiento).
- Entrada: 2,000 ÷ 1,000,000 × $0.15 = $0.0003
- Salida: 1,500 ÷ 1,000,000 × $0.60 = $0.0009
- Total: $0.0003 + $0.0009 = $0.0012
Comprobación: si mantienes este ritmo durante 1,000 conversaciones, usarás 2 millones de tokens de entrada y 1.5 millones de salida. El cálculo es 2 × $0.15 + 1.5 × $0.60 = $0.30 + $0.90 = $1.20, que coincide con $0.0012 × 1,000.
Ejemplo 2: una tarea de agente (varias rondas)
Un agente es un sistema en el que el modelo divide una tarea en pasos, utiliza herramientas y completa el trabajo mediante varias rondas. En cada ronda, vuelve a enviar el contexto anterior, por lo que el volumen de entrada es elevado y la caché puede marcar una gran diferencia.
Supongamos que hay 20 rondas, con 30,000 tokens de entrada en cada una: 25,000 tienen acierto de caché y 5,000 son contenido nuevo. Cada ronda genera 2,000 tokens de salida.
- Lectura de caché: 25,000 × 20 = 500,000 tokens; 0.5 × $0.015 = $0.0075
- Entrada nueva: 5,000 × 20 = 100,000 tokens; 0.1 × $0.15 = $0.015
- Salida: 2,000 × 20 = 40,000 tokens; 0.04 × $0.60 = $0.024
- Total: $0.0075 + $0.015 + $0.024 = $0.0465
Como comparación, si no hubiera ningún acierto de caché, los 600,000 tokens de entrada costarían 0.6 × $0.15 = $0.09. Al sumar los $0.024 de salida, el total sería $0.114. La caché ahorra $0.114 − $0.0465 = $0.0675 en esta tarea, aproximadamente un 59 %.
Ejemplo 3: 1,000 invocaciones por lotes en un día
Supongamos que cada invocación incluye 1,000 tokens de una indicación fija del sistema (con acierto de caché), 500 tokens de contenido nuevo y 1,000 tokens de salida.
- Lectura de caché: 1,000 × 1,000 = 1 millón de tokens; 1 × $0.015 = $0.015
- Entrada nueva: 500 × 1,000 = 500,000 tokens; 0.5 × $0.15 = $0.075
- Salida: 1,000 × 1,000 = 1 millón de tokens; 1 × $0.60 = $0.60
- Total diario: $0.015 + $0.075 + $0.60 = $0.69; para 30 días, unos $20.70 al mes
Si configuras un nivel de esfuerzo alto y cada invocación genera 3,000 tokens de salida (también es una cifra hipotética), el coste de salida sube a 3 × $0.60 = $1.80 y el total diario alcanza $1.89. La entrada y la caché no cambian, pero la factura se multiplica por casi 2.7 ($1.89 ÷ $0.69 ≈ 2.74). Esto demuestra que la salida es el principal coste en las tareas por lotes.
🚀 Consejo para empezar: prueba primero con un lote pequeño de datos reales. Anota el promedio de tokens de entrada, los aciertos de caché y los tokens de salida; después, aplica las fórmulas anteriores para estimar el coste mensual. Así obtendrás una estimación más precisa que calculando a ojo. Si también quieres comparar el coste de modelos como MiniMax-M3 y Claude, puedes probarlos con la misma clave en APIYI apiyi.com.
Las dos trampas de facturación más comunes de MiniMax M3.1 Flash
Trampa 1: no se puede desactivar el razonamiento y el nivel de effort determina el costo
effort es el parámetro que controla la profundidad del razonamiento: cuanto más alto sea el nivel, más piensa el modelo. MiniMax M3.1 Flash tiene una particularidad frente a muchos otros modelos: no se puede desactivar el razonamiento. La documentación oficial indica que, si se envía thinking disabled o effort none, se devuelve directamente un error 400 con el mensaje de que el modelo «MiniMax-M3.1-Flash» requiere razonamiento adaptativo.
El razonamiento se factura como parte de la salida. Además, si no se especifica effort, el valor predeterminado es max, es decir, el nivel más caro. Para ahorrar, la única opción es reducir el nivel de forma explícita. El nombre del campo varía según el protocolo: el protocolo de Anthropic usa output_config.effort, el de OpenAI usa reasoning_effort y el protocolo Responses usa reasoning.effort.
| Nivel de effort | Cantidad de razonamiento | Impacto en la factura | Usos recomendados |
|---|---|---|---|
| low | Mínima | Menos salida, menor costo y latencia | Clasificación, extracción, reescritura y conversión de formatos |
| medium | Baja | Relativamente económico | Preguntas y respuestas cotidianas, resúmenes sencillos |
| high | Moderada | Relativamente caro | Programación general, razonamiento de varios pasos |
| xhigh | Alta | Caro | Análisis complejos, depuración de problemas difíciles |
| max (predeterminado) | Máxima | El más caro y con mayor latencia | Tareas realmente difíciles, agentes con flujos largos |
La documentación oficial no indica cuántos tokens adicionales consume de media cada nivel. La tabla solo muestra las diferencias relativas. También conviene tener en cuenta que tanto las pruebas de rendimiento oficiales como la evaluación de terceros de Vals usaron niveles altos (Vals especifica claramente effort max). Por ahora, no hay datos públicos sobre cuánto empeoran los resultados al reducir el nivel. Lo recomendable es probar primero con low o medium en un conjunto de ejemplos y subirlo si los resultados no son suficientemente buenos.
Hay otro cambio: el razonamiento ahora se devuelve por separado. En el protocolo compatible con OpenAI, se incluye en el campo reasoning_content, mientras que content contiene solo la respuesta final. Si antes extraías el razonamiento de las etiquetas de salida de M3, tendrás que actualizar esa lógica de análisis.
Trampa 2: las lecturas de caché cuestan solo una décima parte del precio de entrada y el orden del contenido importa
La caché funciona así: cuando el sistema detecta que una parte de la solicitud es exactamente igual a contenido enviado anteriormente, la cobra a la tarifa de lectura de caché. A $0.015, cuesta un 90 % menos que los $0.15 de la tarifa normal.
Para aprovechar mejor la caché, la clave es mantener sin cambios el inicio de la solicitud:
- Coloca la indicación fija del sistema al principio y evita incluir marcas de tiempo, números aleatorios o nombres de usuario.
- Añade justo después de la indicación del sistema el contenido que vayas a reutilizar, como documentos largos, bases de conocimiento e instrucciones de herramientas.
- Deja para el final el contenido que cambia en cada solicitud, como la pregunta del usuario y los datos de la ronda actual.
- En conversaciones de varios turnos, no elimines ni modifiques sin motivo el historial anterior. Si cambias una parte intermedia, será difícil que el contenido posterior vuelva a coincidir con la caché.
La documentación oficial solo publica el precio de las lecturas de caché. Para conocer las reglas concretas de la caché y otros detalles de facturación, consulta la página oficial de precios de MiniMax.
Comparación de precios de MiniMax M3.1 Flash y M3
Mucha gente pregunta cuánto cuesta MiniMax M3.1 Flash en comparación con la generación anterior, M3. La tabla siguiente recoge los precios de la página oficial. Para M3 se usan las tarifas estándar con el descuento permanente del 50 % (por millón de tokens):
| Modelo | Entrada | Salida | Lectura de caché | Recargo por contexto largo |
|---|---|---|---|---|
| MiniMax-M3.1-Flash | $0.15 | $0.60 | $0.015 | Ninguno |
| MiniMax-M3 (entrada ≤512K) | $0.30 | $1.20 | $0.06 | — |
| MiniMax-M3 (entrada >512K) | $0.60 | $2.40 | $0.12 | El precio unitario se duplica |
| MiniMax-M3, nivel Priority | Nivel estándar × 1.5 | Nivel estándar × 1.5 | — | — |
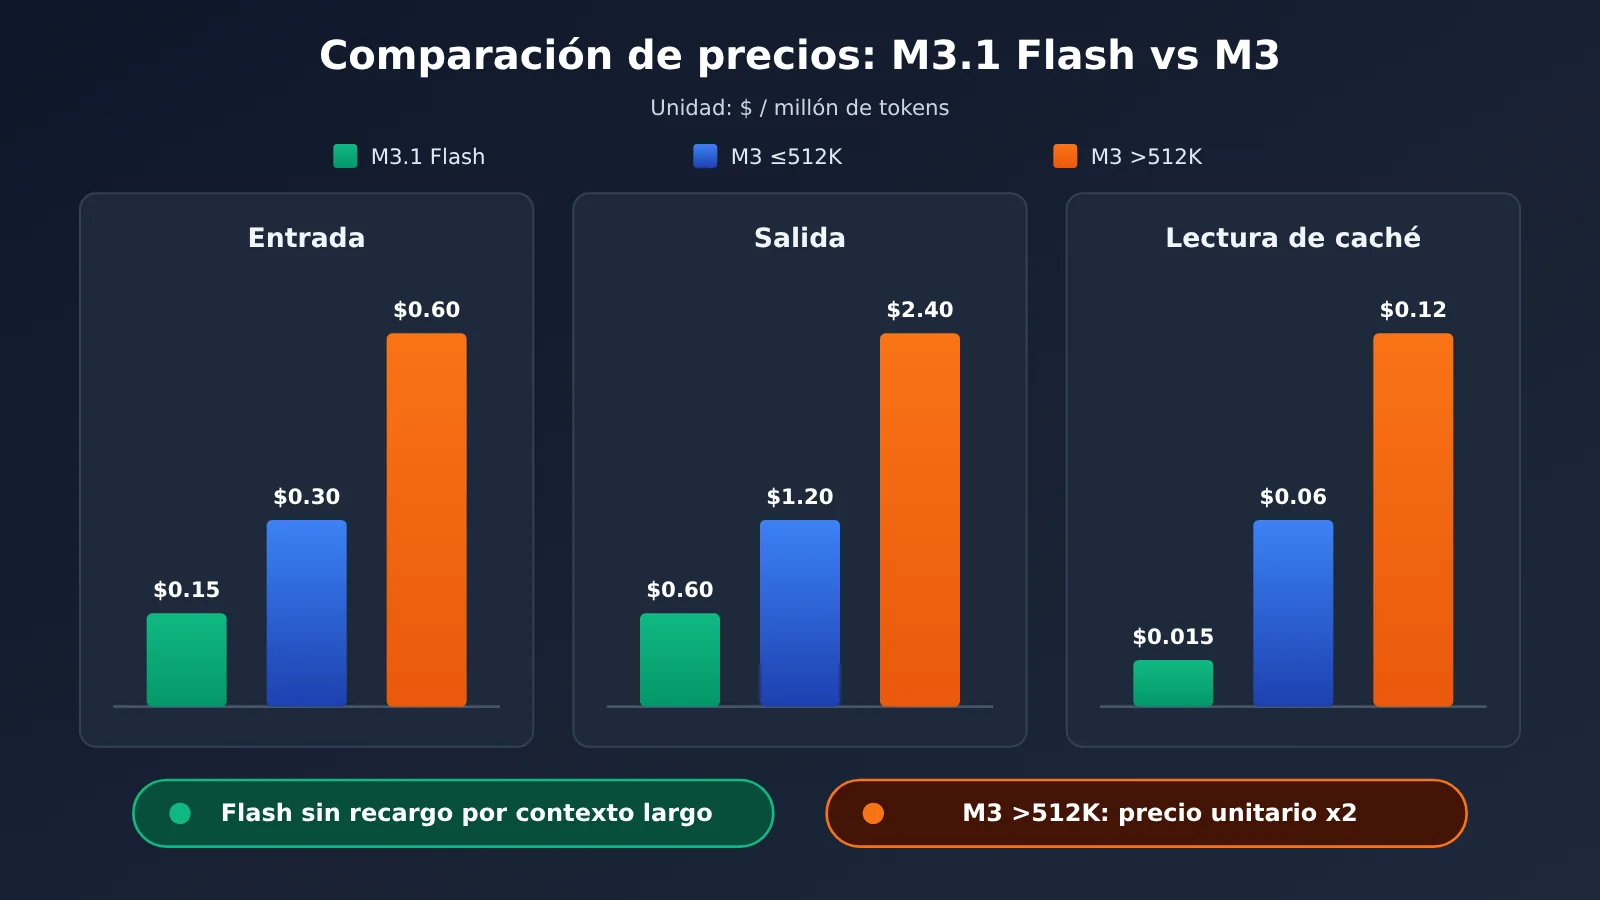
Nota del gráfico: los datos de precios proceden de la página oficial de precios de MiniMax. La facturación real en plataformas de terceros depende de los precios que publique cada una. Por ejemplo, si usas la serie MiniMax a través de APIYI (apiyi.com), consulta los precios que aparecen en su página.
De la tabla se desprenden tres cosas:
- Contexto de longitud normal: los precios unitarios de entrada y salida de Flash son la mitad que los de M3, y la lectura de caché cuesta solo una cuarta parte ($0.015 frente a $0.06). Hagamos la prueba con el caso de uso 3: con el mismo consumo, M3 cuesta 1 × $0.06 + 0.5 × $0.30 + 1 × $1.20 = $1.41 al día, mientras que Flash cuesta $0.69 al día, aproximadamente el 49 %.
- Contexto muy largo: cuando la entrada supera los 512K, el precio unitario de M3 se duplica. Flash no aplica recargo, así que sus precios de entrada y salida equivalen a una cuarta parte de los de M3.
- La caché sale más a cuenta: la lectura de caché en Flash cuesta una décima parte del precio de entrada, mientras que en M3 cuesta una quinta parte. Por eso, cuanto más dependa un caso de uso de la caché, mayor será la ventaja de Flash.
Si el precio unitario solo baja a la mitad, ¿por qué se dice oficialmente que el costo es 1/3?
No hay contradicción. La reducción a la mitad del precio unitario se calcula por token; el costo de 1/3 (según una publicación oficial en X) y la «reducción del 70 % en el costo total de las tareas de Agent» (según el blog oficial) se calculan sobre el gasto total para completar una tarea. En ambos casos, se trata de cifras declaradas por la empresa.
Costo total de una tarea = precio unitario × tokens consumidos. Si el nuevo modelo necesita menos rondas o tokens para completar la misma tarea, el costo de la tarea puede reducirse más que el precio unitario. Sin embargo, la empresa no ha publicado el método exacto para calcular ese 1/3. Además, en el gráfico oficial de costos, la cifra de Automation-Bench (62.8) no coincide con la de la tabla (62.2). Por eso, para hacer un presupuesto, es mejor calcularlo a partir del precio unitario y tomar la cifra de «1/3» solo como referencia.
Cómo elegir entre la API de pago por uso de MiniMax M3.1 Flash y la suscripción M Plan
MiniMax M3.1 Flash ofrece dos modalidades de pago. La API de pago por uso cobra según el uso y descuenta el importe del saldo de la cuenta. M Plan es una suscripción mensual con tres niveles: Go, Explore y Build. Todos incluyen el modelo de texto M3.1 Flash. Según la documentación oficial, Explore ofrece 3 veces el uso de Go y Build, 7,5 veces. Además, Explore y Build incluyen el modelo de vídeo H3. El precio mensual de cada nivel debe consultarse en el sitio web oficial. También hay un anuncio oficial de descuentos durante el primer mes al pagar mensualmente; los detalles de la promoción deben consultarse igualmente en el sitio web oficial.
| Criterio | Elige la API de pago por uso | Elige la suscripción M Plan |
|---|---|---|
| Cuánto la usas | El uso es irregular o muy bajo en general | La usas con frecuencia a diario y prefieres un gasto mensual fijo |
| Dónde la usas | En el backend de tu producto, scripts por lotes o procesamiento de datos | Para escribir código y como ayuda de IA en la programación diaria |
| Qué herramientas usas | Programas propios que llaman directamente a la URL de la API | MiniMax Code, Claude Code, Codex, Cursor u OpenCode |
| Si necesitas vídeo | Se calcula por separado según el uso | Los niveles Explore y Build incluyen el modelo de vídeo H3 |
| Control de costos | Puedes calcular el costo de cada solicitud y optimizar con precisión el parámetro effort y la caché | No tienes que calcular los tokens; consulta el sitio web oficial para conocer las reglas sobre el uso que exceda el límite del plan |
En pocas palabras: si es para un programa, elige el pago por uso; si es para una persona, elige la suscripción. Si principalmente escribes código con herramientas como Claude Code o Cursor, puedes conectar directamente la clave de suscripción de M Plan. Si estás desarrollando un producto o ejecutando tareas por lotes, la API de pago por uso ofrece más transparencia y puedes calcular los costos con el método de este artículo.
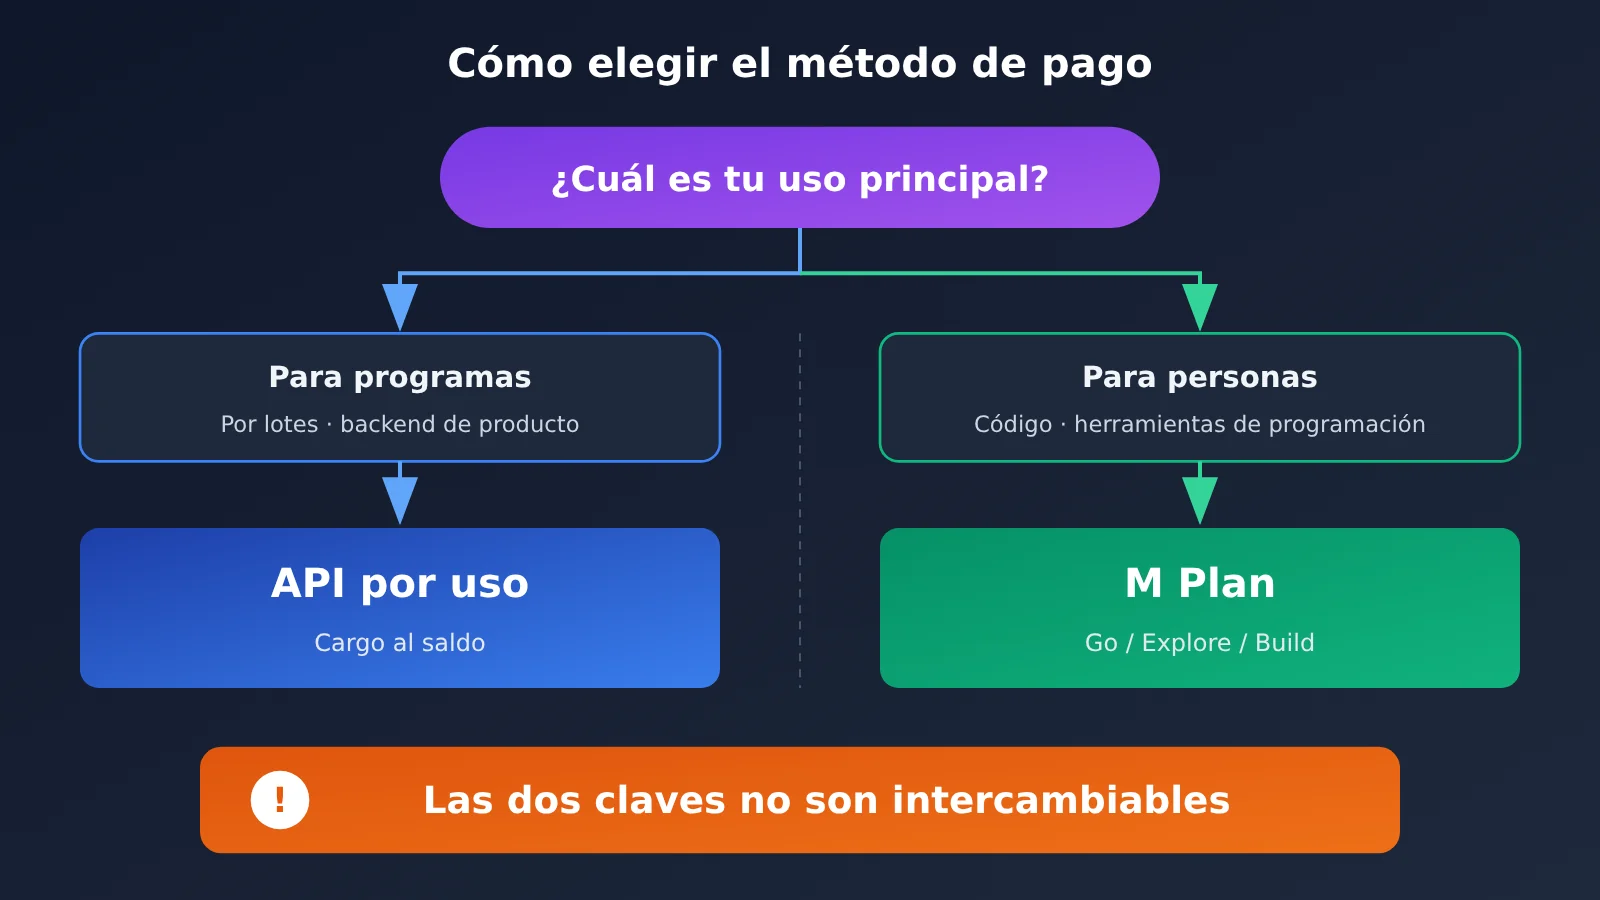
⚠️ Aviso importante: las dos claves no son intercambiables. Las preguntas frecuentes oficiales especifican que la clave API de pago por uso y la clave de suscripción de M Plan son diferentes y se obtienen en secciones distintas del panel de control. Si usas la clave de suscripción para llamar a la interfaz de pago por uso, o viceversa, tendrás problemas. Antes de configurar nada, comprueba cuál de las dos has copiado. Además, el nombre del modelo anterior, MiniMax-M3.1-Flash-Preview, ya está retirado; las solicitudes que se envíen con ese nombre ahora se procesarán con MiniMax-M3.1-Flash.
Cuándo no conviene usar MiniMax M3.1 Flash
Que sea barato no significa que sirva para cualquier tarea. En estos casos, es mejor no cambiar todavía o hacerlo solo en parte.
1. Agentes con flujos largos y tareas de uso de terminal. La evaluación de terceros de Vals AI muestra que M3.1 Flash obtiene un 25,25 % en Terminal-Bench 4.0 y ocupa el puesto 22 entre 51 modelos. En HLAB-Vals-1.1 obtiene un 7,50 % y queda en el puesto 17 entre 23 modelos. La cifra declarada por el fabricante para Terminal Bench 4.0 es de 38,1, también 13,7 puntos por debajo de los 51,8 de Claude Opus 5.
2. Refactorizaciones de código a gran escala. La cifra declarada por el fabricante para SWE Refactor Bench es de 23,0, frente a los 31,0 de Claude Opus 5.
3. Si necesitas desactivar el razonamiento y buscas una latencia muy baja. No se puede desactivar el razonamiento; el nivel mínimo disponible es low.
4. Si tus integraciones actuales dependen de interpretar las etiquetas de razonamiento. Antes de migrar desde M3, tendrás que modificar la lógica de análisis; de lo contrario, no podrás obtener el contenido del razonamiento.
5. Si quieres usarlo ya mismo en APIYI. A la fecha de publicación, MiniMax-M3.1-Flash todavía no aparece en la página de precios de APIYI. Comprueba allí si está disponible.
Veamos también la comparación con Claude. La tabla oficial compara el modelo con Claude Opus 5, no con Opus 5.5. Claude Opus 5.5 sigue siendo el modelo insignia más potente de Anthropic, y MiniMax no lo ha comparado punto por punto. Por eso, no se puede afirmar que Flash esté a la altura o supere a Opus 5.5. En la clasificación general, Vals Index sitúa a M3.1 Flash en el puesto 15 de 22 modelos (53,78 %) y en el quinto puesto entre los modelos de pesos abiertos.
| Modelo | Entrada / salida (por millón de tokens) | Comparación de puntuaciones | Más adecuado para | Canales de acceso |
|---|---|---|---|---|
| MiniMax-M3.1-Flash | $0.15 / $0.60 | Cifras declaradas por el fabricante + evaluación de Vals | Procesamiento por lotes, programación cotidiana y uso de herramientas | MiniMax oficial; APIYI, según la página de precios |
| claude-opus-5 | $5 / $25 (precio oficial) | Modelo de referencia en la tabla comparativa oficial | Tareas complejas | APIYI, apiyi.com, entre otros |
| claude-opus-5-5 | $4 / $20 (precio oficial) | El fabricante no lo ha usado para comparaciones | Planificación compleja, diseño de arquitectura y grandes refactorizaciones | APIYI, apiyi.com, entre otros |
Según el precio por unidad, la salida de Opus 5.5 cuesta unas 33 veces más que la de Flash ($20 ÷ $0.60 ≈ 33,3), y la entrada, unas 27 veces más ($4 ÷ $0.15 ≈ 26,7). Con una diferencia tan grande, lo más razonable es repartir el trabajo entre ambos, en lugar de elegir solo uno.
Cómo combinar MiniMax y Claude Opus 5.5 en APIYI
A fecha de 2026-10-22, en la página de precios de APIYI se pueden usar directamente los modelos MiniMax-M3 (compatible con los formatos de interfaz de OpenAI y Anthropic, y disponible en el grupo ClaudeCode), MiniMax-M2.7, MiniMax-M2.7-highspeed, MiniMax-M2.5, MiniMax-M2.5-lightning y el modelo de vídeo MiniMax-H3. MiniMax-M3.1-Flash todavía no aparece en la página de precios. Para saber si se puede invocar, consulta la página de precios de APIYI.
En cuanto a Claude, tanto claude-opus-5-5 como claude-opus-5 se pueden invocar directamente. La ventaja de APIYI es que una sola clave permite invocar tanto la serie MiniMax como Claude Opus 5.5, sin necesidad de registrarse ni recargar saldo por separado. Esta es una forma recomendada de repartir las tareas:
- Deja las tareas por lotes y de bajo costo a MiniMax: limpieza de datos, clasificación de contenido, reescritura por lotes y generación de código sencilla. Usa un modelo con buena relación calidad-precio, como MiniMax-M3, junto con el almacenamiento en caché y un nivel de razonamiento más bajo.
- Deja la planificación compleja y las refactorizaciones a Opus 5.5: diseño de arquitectura de sistemas, grandes refactorizaciones entre módulos y planificación general de tareas con múltiples etapas. Para ello, usa
claude-opus-5-5. - Planifica primero y ejecuta después: pídele a Opus 5.5 que proponga un plan y divida el trabajo en tareas; luego, encarga esas tareas más pequeñas a MiniMax para ejecutarlas por lotes y equilibrar calidad y costo.
💡 Recomendación: Si todavía no tienes claro qué tareas puedes delegar a un modelo más económico, prueba las mismas muestras con MiniMax-M3 y
claude-opus-5-5en APIYI apiyi.com. Compara los resultados y el costo antes de decidir cómo repartir el trabajo.
Preguntas frecuentes
Q1: ¿Cuál es exactamente el precio de MiniMax M3.1 Flash?
Según la página oficial de precios, cuesta $0.15 por cada millón de tokens de entrada, $0.60 por cada millón de tokens de salida y $0.015 por cada millón de tokens leídos de la caché. Son precios fijos, sin recargo por ventanas de contexto largas. La búsqueda web_search con conexión a internet desde el servidor cuesta $0.01 por consulta, aparte.
Q2: ¿Por qué la respuesta tiene tantos tokens si solo hice una pregunta?
Porque el proceso de razonamiento también cuenta como salida. Además, si no se especifica el parámetro effort, el valor predeterminado es max. No se puede desactivar el razonamiento; para reducir la salida, solo puedes ajustar effort a low o medium.
Q3: ¿Cuánto más barato es MiniMax M3.1 Flash que M3?
En cuanto al precio por unidad, los tokens de entrada y salida cuestan la mitad que con M3 estándar, y los tokens leídos de la caché, una cuarta parte. Cuando la entrada supera los 512K tokens, el precio por unidad de M3 se duplica, mientras que Flash no aplica ningún recargo. La cifra oficial de «un tercio del costo» es un dato declarado por la propia empresa y calculado por tarea; el método no se ha publicado.
Q4: ¿Puedo usar directamente una clave API de pago por uso en Claude Code con un plan M Plan?
No. Las claves API de pago por uso y las claves de suscripción M Plan son distintas, se obtienen en secciones diferentes del panel y no son intercambiables. Si vas a conectar la suscripción a una herramienta, debes copiar la clave de suscripción.
Q5: ¿Ya se puede invocar MiniMax M3.1 Flash desde APIYI?
En el momento de publicar este artículo, MiniMax-M3.1-Flash todavía no aparece en la página de precios de APIYI. Consulta esa página para confirmar si está disponible; intentaremos incorporarlo cuanto antes. Por ahora, puedes usar directamente en APIYI apiyi.com modelos como MiniMax-M3 y claude-opus-5-5, y cambiar entre ellos con una sola clave.
Q6: ¿Hay alguna forma de probarlo gratis?
La plataforma de terceros OpenRouter ofrece el endpoint gratuito minimax/minimax-m3.1-flash:free, con límites de velocidad, que sirve para probarlo. Para un uso regular, te recomendamos estimar los costos con pequeños lotes de datos siguiendo el método de este artículo.
Q7: ¿Qué limitaciones tiene MiniMax M3.1 Flash?
Las evaluaciones de terceros indican que flojea en tareas de Agent con cadenas de acciones largas y en tareas de terminal (en Vals Terminal-Bench 4.0 quedó en el puesto 22 de 51 modelos). Además, en las pruebas de refactorización cuyos resultados publicó la propia empresa, quedó por debajo de Claude Opus 5. MiniMax tampoco ha publicado un informe técnico que explique qué cambios incluye Flash.
Q8: Si quiero gastar lo menos posible, ¿por dónde empiezo?
Primero, baja effort del valor predeterminado max. Después, coloca al principio de la solicitud las indicaciones fijas del sistema y los documentos largos para aprovechar la caché. Por lo general, estos dos pasos tienen un efecto más inmediato que cambiar de modelo. Si quieres comparar el costo de varios modelos a la vez, puedes hacer pruebas centralizadas en APIYI apiyi.com.
Puntos clave sobre el precio de MiniMax M3.1 Flash
- Tres tarifas: $0.15 por la entrada, $0.60 por la salida y $0.015 por las lecturas de caché, por cada millón de tokens. No hay recargo por contextos largos.
- La salida concentra la mayor parte del costo: el razonamiento cuenta como salida y el nivel
max, que viene activado por defecto, es el más caro. Para ahorrar, baja primero el nivel deeffort. - No se puede desactivar el razonamiento: enviar
disabledononedevuelve un error 400. El nivel más bajo disponible eslow. - La caché ahorra un 90 %: coloca primero el contenido fijo y deja al final el contenido que cambia.
- La tarifa por token es la mitad que la de M3: la afirmación oficial de que el «costo es un tercio» se refiere a una estimación por tarea; ambas cifras no se contradicen.
- Para programas, pago por uso; para personas, suscripción: las claves de ambos planes no son intercambiables. Consulta el sitio oficial para conocer el precio mensual de M Plan.
- Combinar modelos puede salir más rentable: en APIYI, usa una sola clave para que MiniMax procese lotes y Opus 5.5 se encargue de la planificación.
Resumen
Puntos clave sobre el precio de MiniMax M3.1 Flash:
- Calcula el costo: costo = uso ÷ 1 millón × tarifa. Calcula por separado la entrada, las lecturas de caché y la salida, y luego suma los importes.
- Ahorra: baja el nivel de
effortpara controlar el volumen de salida del razonamiento y coloca primero el contenido fijo para aprovechar mejor la caché. - Elige bien: para programas, elige la API de pago por uso; para uso personal, M Plan. Para flujos de trabajo largos con agentes y refactorizaciones grandes, sigue siendo recomendable recurrir a modelos más potentes.
Te recomendamos empezar con un lote pequeño de datos reales para calcular el costo por operación en tu caso y, después, decidir el método de pago y cómo repartir el trabajo. Si necesitas comparar el rendimiento y el costo de varios modelos, puedes probarlos desde APIYI apiyi.com con una sola clave. Consulta la página de precios para confirmar si MiniMax-M3.1-Flash está disponible.
📚 Referencias
- Blog oficial de MiniMax: velocidad, costos y resultados de benchmarks publicados por la propia empresa para M3.1 Flash
- Enlace:
minimax.io/blog/minimax-m31f -
Nota: Fuente de los precios oficiales y de la afirmación de que el costo de las tareas de agentes se reduce un 70 %.
-
Página oficial de precios de MiniMax: precios unitarios completos de Flash y M3
- Enlace:
platform.minimax.io/docs/guides/pricing -
Nota: Fórmula de facturación, niveles para contextos largos y precio de
web_search. -
Documentación oficial de MiniMax: invocación del modelo: niveles de
efforty reglas de razonamiento - Enlace:
platform.minimax.io/docs/guides/text-generation -
Nota: El razonamiento no se puede desactivar y nombres de los campos
efforten cada protocolo. -
Información sobre las suscripciones M Plan de MiniMax: tres niveles: Go / Explore / Build
- Enlace:
platform.minimax.io/docs/m-plan/intro -
Nota: Multiplicadores de uso, herramientas compatibles e información sobre los modelos.
-
Preguntas frecuentes oficiales de MiniMax: diferencias entre la clave API y la clave de suscripción
- Enlace:
platform.minimax.io/docs/faq/about-apis -
Nota: Explicación oficial de que las dos claves no son intercambiables.
-
Página de evaluación de Vals AI: resultados de una evaluación externa
- Enlace:
vals.ai/models/minimax_MiniMax-M3.1-flash - Nota: Clasificación en Vals Index, fortalezas y debilidades.
Autor: Equipo técnico de APIYI
Intercambio técnico: Puedes contactarnos desde la página de inicio de APIYI, apiyi.com. Encontrarás más información sobre la integración en el centro de documentación, docs.apiyi.com.