作者注:一篇講清 MiniMax M3.1 Flash 怎麼計費、怎麼省錢、該買按量 API 還是 M Plan 訂閱的實用指南。
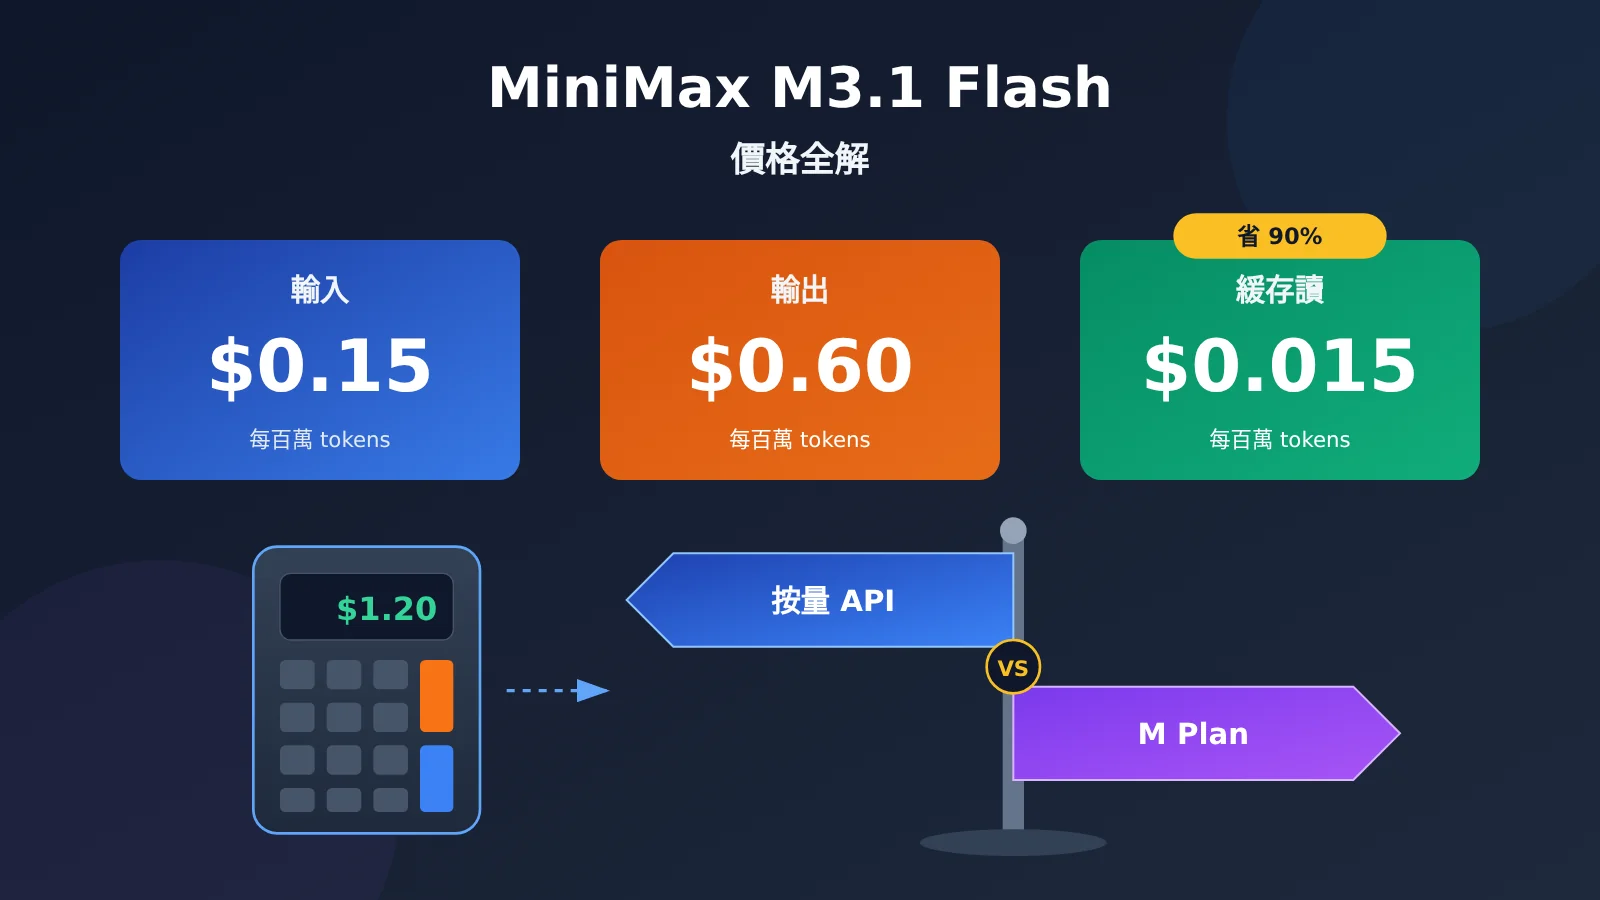
先給一句能帶走的結論:MiniMax M3.1 Flash 每百萬 token 輸入 $0.15、輸出 $0.60、緩存讀 $0.015。賬單的大頭通常是輸出(包含模型的思考過程),所以省錢有兩個辦法:一是調低 effort 檔位,二是把固定內容放在請求前面,讓它走緩存。
這不是又一篇發佈新聞。發佈本身本站已經報道過,這篇只講錢:三項單價分別是什麼、一次對話和一個 Agent 任務大概花多少、和 M3 比到底便宜在哪裏,以及按量付費和包月訂閱怎麼選。
核心價值:讀完本文,你可以自己估算 MiniMax M3.1 Flash 的月度花費,避開兩個最常見的計費坑,並選出適合自己的付費方式。
MiniMax M3.1 Flash 價格核心要點
先解釋一個詞:token 是模型計費的最小單位,可以理解爲“文字碎片”。官方給的換算是約 750 個英文單詞 ≈ 1000 tokens。中文的換算比例官方沒有在價格頁給出,實際用量以控制檯賬單爲準。
下面這張表是 MiniMax M3.1 Flash 的全部單價,來源是 MiniMax 官方價格頁(官方公佈的固定價):
| 計費項 | 單價(每百萬 tokens) | 大白話解釋 | 典型內容 |
|---|---|---|---|
| 輸入 | $0.15 | 你發給模型的所有內容 | 系統提示詞、聊天記錄、上傳的文檔、圖片和視頻 |
| 輸出 | $0.60 | 模型寫回來的所有內容,包括思考過程 | 最終答案、思考內容(reasoning) |
| 緩存讀 | $0.015 | 輸入裏和之前請求重複、被緩存命中的那部分 | 每次都一樣的系統提示詞、反覆引用的長文檔 |
| 附加:web_search | $0.01/次 | 服務端聯網搜索工具,按次收費 | Agent 調用搜索 |
這裏有兩點要記住。第一,輸出單價是輸入的 4 倍,所以“模型說了多少”比“你發了多少”更影響賬單。第二,緩存讀只要輸入價的 1/10,也就是命中緩存的那部分輸入能省 90%。
MiniMax M3.1 Flash 計費公式怎麼理解
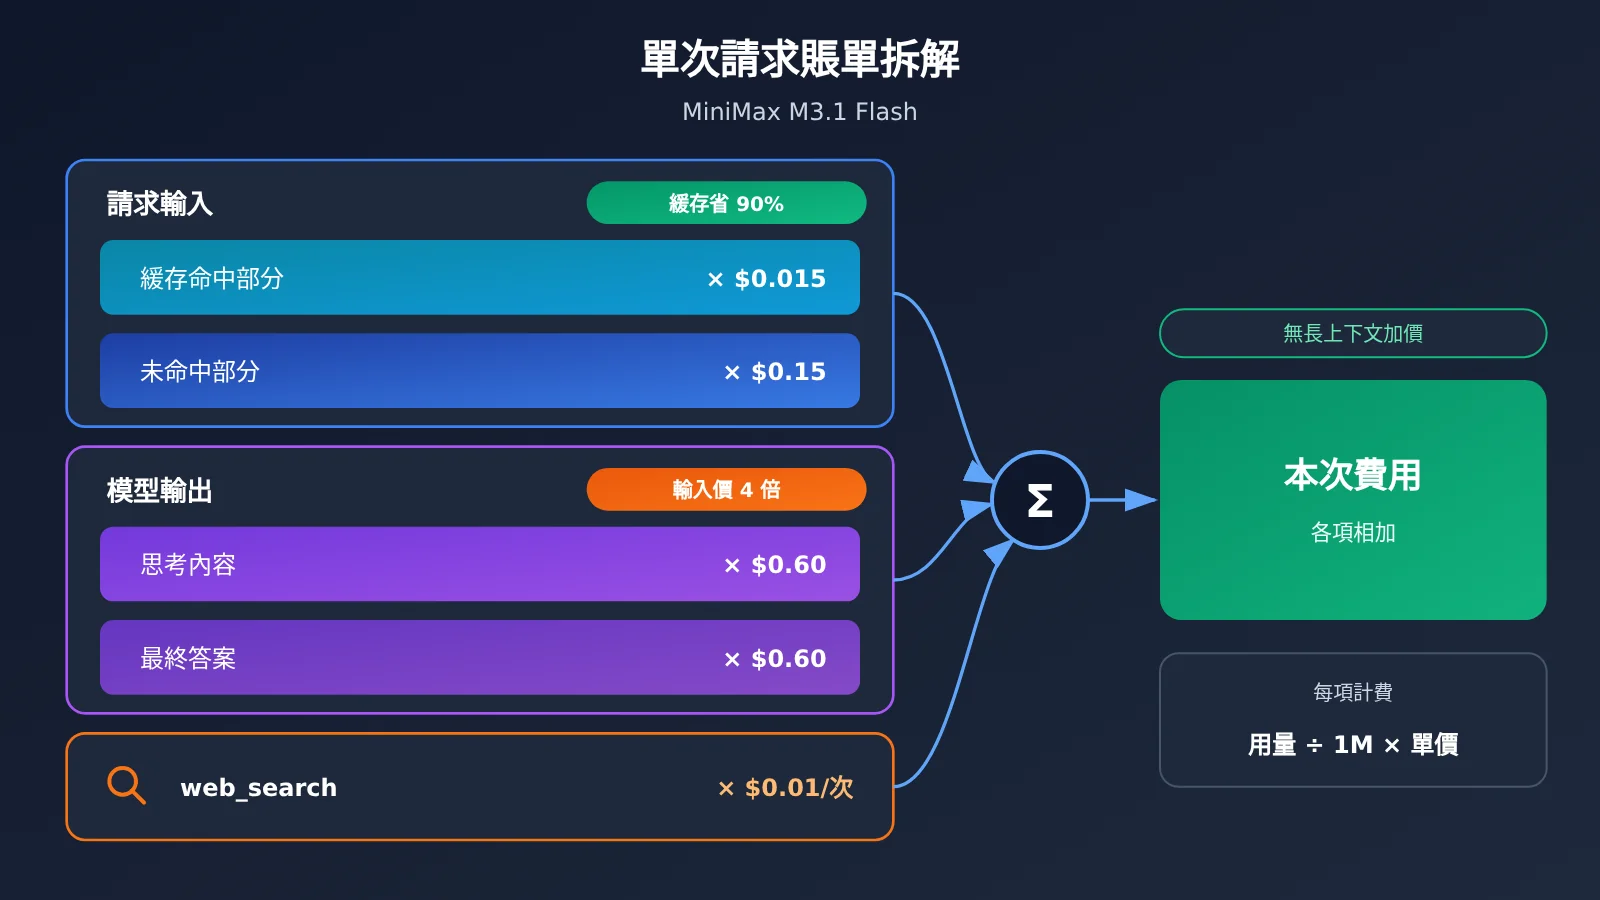
官方給的算法很簡單:費用 = 用量 ÷ 1,000,000 × 單價,多個計費項分別算完再相加,從賬戶餘額里扣。
一次請求的賬單可以拆成三塊:命中緩存的輸入 × $0.015,沒命中緩存的輸入 × $0.15,輸出(答案 + 思考)× $0.60,最後再加上搜索次數 × $0.01。
另外,MiniMax M3.1 Flash 的上下文窗口是 1,000,000 tokens(上下文窗口就是模型一次能“看”的最大內容量)。官方價格頁明確寫了它沒有長上下文加價:塞 10 萬還是 80 萬 tokens,單價都一樣。
MiniMax M3.1 Flash 價格算賬:3 個例子
下面三個例子裏的 token 數是爲了演示算法而假設的,不是實測數據,你可以換成自己的數字照着算。
例 1:一次普通對話
假設:輸入 2,000 tokens(沒命中緩存),輸出 1,500 tokens(含思考)。
- 輸入:2,000 ÷ 1,000,000 × $0.15 = $0.0003
- 輸出:1,500 ÷ 1,000,000 × $0.60 = $0.0009
- 合計:$0.0003 + $0.0009 = $0.0012
驗算:這樣的對話做 1,000 次,用量是輸入 200 萬、輸出 150 萬 tokens,2 × $0.15 + 1.5 × $0.60 = $0.30 + $0.90 = $1.20,和 $0.0012 × 1,000 一致。
例 2:一個 Agent 任務(多輪)
Agent 是指讓模型自己拆步驟、調工具、多輪循環完成任務。它的特點是每一輪都要把之前的上下文重新發一遍,所以輸入量很大,緩存的作用也最明顯。
假設:一共 20 輪,每輪輸入 30,000 tokens,其中 25,000 命中緩存、5,000 是新內容,每輪輸出 2,000 tokens。
- 緩存讀:25,000 × 20 = 500,000 tokens,0.5 × $0.015 = $0.0075
- 新輸入:5,000 × 20 = 100,000 tokens,0.1 × $0.15 = $0.015
- 輸出:2,000 × 20 = 40,000 tokens,0.04 × $0.60 = $0.024
- 合計:$0.0075 + $0.015 + $0.024 = $0.0465
對比一下:如果完全沒命中緩存,60 萬 tokens 輸入就要 0.6 × $0.15 = $0.09,再加輸出 $0.024,合計 $0.114。緩存幫這個任務省下 $0.114 − $0.0465 = $0.0675,約 59%。
例 3:一天 1,000 次批量調用
假設:每次帶 1,000 tokens 的固定系統提示詞(命中緩存)、500 tokens 的新內容,輸出 1,000 tokens。
- 緩存讀:1,000 × 1,000 = 100 萬 tokens,1 × $0.015 = $0.015
- 新輸入:500 × 1,000 = 50 萬 tokens,0.5 × $0.15 = $0.075
- 輸出:1,000 × 1,000 = 100 萬 tokens,1 × $0.60 = $0.60
- 每天合計:$0.015 + $0.075 + $0.60 = $0.69,按 30 天算約 $20.70/月
如果 effort 開得高,每次輸出變成 3,000 tokens(同樣是假設),輸出費就漲到 3 × $0.60 = $1.80,每天合計 $1.89。輸入和緩存一分沒變,賬單卻接近原來的 2.7 倍($1.89 ÷ $0.69 ≈ 2.74)。這說明輸出纔是批量任務裏的大頭。
🚀 快速上手建議:先用小批量真實數據跑一遍,記下平均輸入、緩存命中量和輸出量,再套用上面的公式估算月費,會比憑感覺準得多。如果你還想同時對比 MiniMax-M3、Claude 等模型的成本,可以在 API易 apiyi.com 用同一個 Key 切換模型測試。
MiniMax M3.1 Flash 最容易踩的兩個計費坑
坑一:思考關不掉,effort 檔位決定賬單
effort 是“思考深度”參數,檔位越高,模型想得越多。MiniMax M3.1 Flash 有一個和很多模型不同的設定:思考不能關閉。官方文檔寫明,傳 thinking disabled 或 effort none 會直接返回 400 錯誤,報錯信息是 model “MiniMax-M3.1-Flash” requires adaptive thinking。
思考內容按輸出計費,而且不傳 effort 時默認是 max,也就是最貴的一檔。想省錢,唯一的辦法是主動調低檔位。不同協議的字段名不一樣:Anthropic 協議用 output_config.effort,OpenAI 協議用 reasoning_effort,Responses 協議用 reasoning.effort。
| effort 檔位 | 思考量 | 對賬單的影響 | 建議場景 |
|---|---|---|---|
| low | 最少 | 輸出最少,最省錢、延遲最低 | 分類、抽取、改寫、格式轉換 |
| medium | 較少 | 偏省 | 日常問答、簡單總結 |
| high | 較多 | 偏貴 | 一般編程、多步推理 |
| xhigh | 很多 | 貴 | 複雜分析、難題調試 |
| max(默認) | 最多 | 最貴、延遲最高 | 真正的難任務、長鏈路 Agent |
官方沒有公佈每個檔位平均多用多少 token,上表只表示相對高低。另外要知道,官方跑分和 Vals 第三方測評用的都是高檔位(Vals 明確寫了 effort max),調低以後效果會差多少,目前沒有公開數據。建議先用 low 或 medium 跑一批樣本,結果不夠好再往上調。
還有一個改動:思考內容現在是單獨返回的。在 OpenAI 兼容協議裏,思考放在 reasoning_content 字段,content 裏只有最終答案。如果你以前從 M3 輸出的思考標籤裏拆內容,這部分解析邏輯需要改。
坑二:緩存讀只要輸入價的 1/10,內容順序很重要
緩存的意思是:請求裏和之前完全一樣的那部分內容,系統認出來以後按緩存讀價格收費,$0.015 比 $0.15 便宜 90%。
想多命中緩存,關鍵是讓請求開頭保持不變:
- 把固定的系統提示詞放在最前面,不要在裏面插時間戳、隨機數或用戶名。
- 長文檔、知識庫、工具說明這類反覆使用的內容緊跟在系統提示詞後面。
- 每次會變的內容(用戶問題、本輪數據)放在最後。
- 多輪對話不要隨意刪改前面的歷史,改了中間一段,後面的內容就很難命中了。
資料中官方只公佈了緩存讀的價格,緩存的具體規則和其他相關計費以 MiniMax 官方價格頁爲準。
MiniMax M3.1 Flash 和 M3 價格對比
很多人會問 MiniMax M3.1 Flash 和上一代 M3 差多少錢。下表來自官方價格頁,M3 用的是永久 5 折後的標準檔價格(每百萬 tokens):
| 模型 | 輸入 | 輸出 | 緩存讀 | 長上下文加價 |
|---|---|---|---|---|
| MiniMax-M3.1-Flash | $0.15 | $0.60 | $0.015 | 無 |
| MiniMax-M3(輸入 ≤512K) | $0.30 | $1.20 | $0.06 | — |
| MiniMax-M3(輸入 >512K) | $0.60 | $2.40 | $0.12 | 單價翻倍 |
| MiniMax-M3 Priority 檔 | 標準檔 × 1.5 | 標準檔 × 1.5 | — | — |
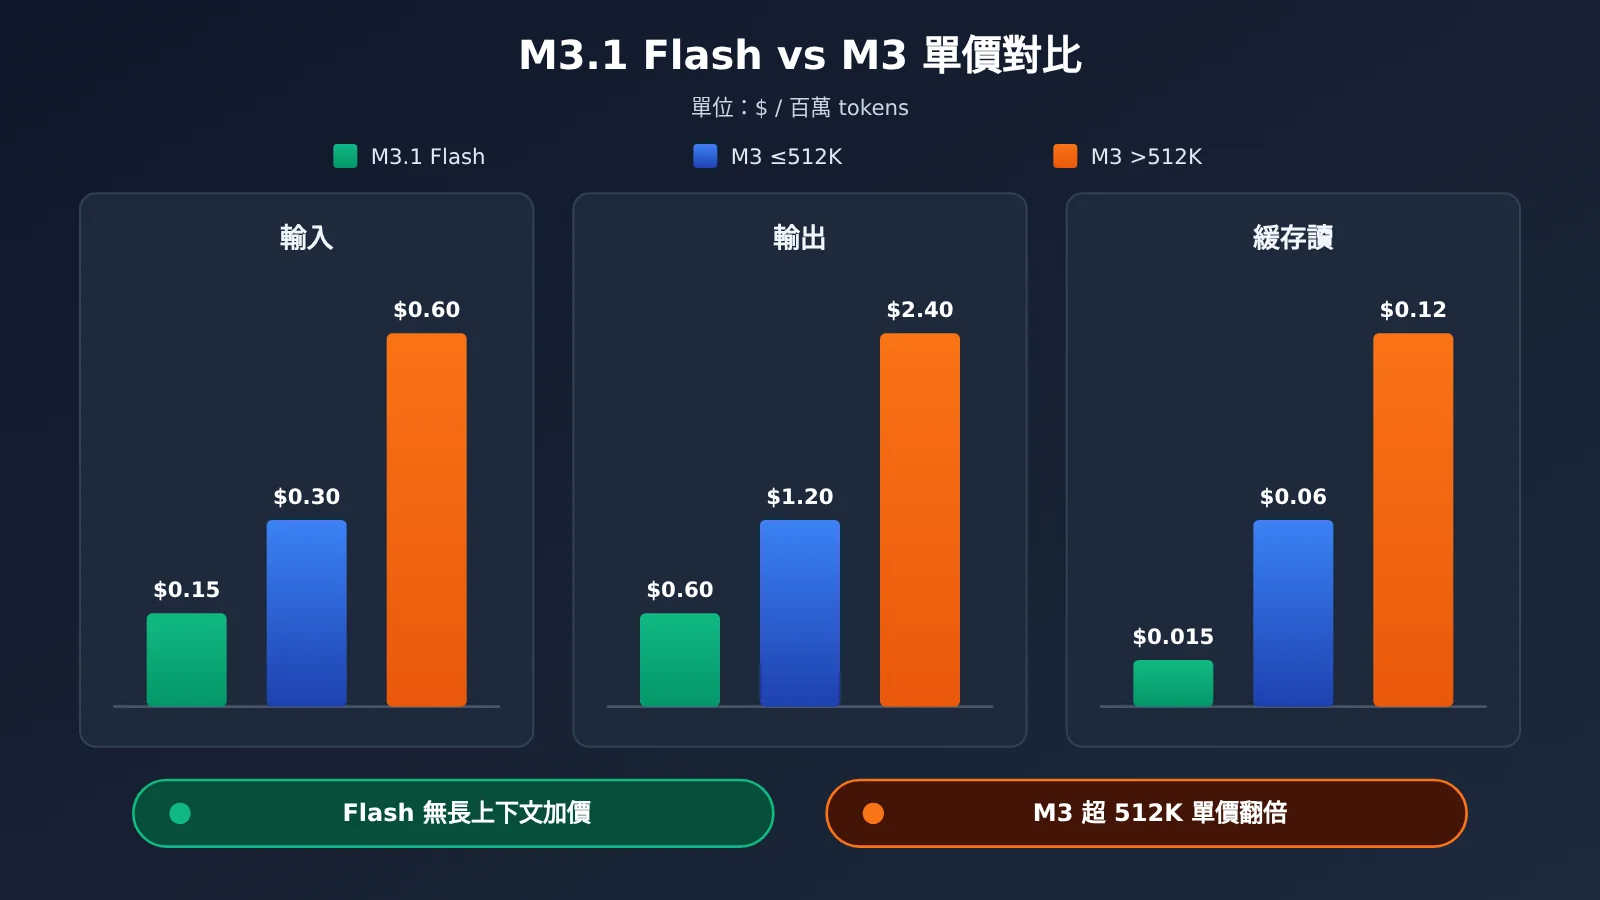
圖注:價格數據來自 MiniMax 官方價格頁;第三方平臺的實際計費以各自價格頁爲準,例如在 API易 apiyi.com 調用 MiniMax 系列時請以其價格頁顯示爲準。
從表裏能看出三件事:
- 普通長度:Flash 的輸入、輸出單價都是 M3 的一半,緩存讀只有 M3 的 1/4($0.015 對 $0.06)。用例 3 驗證一下:同樣的用量放在 M3 上是 1 × $0.06 + 0.5 × $0.30 + 1 × $1.20 = $1.41/天,Flash 是 $0.69/天,約爲 49%。
- 超長上下文:輸入超過 512K 時 M3 單價翻倍,Flash 不加價,輸入輸出都只有 M3 的 1/4。
- 緩存更划算:Flash 的緩存讀是輸入價的 1/10,M3 是 1/5,所以越依賴緩存的場景,Flash 的優勢越大。
官方說“成本 1/3”,爲什麼單價只便宜一半?
這兩個說法並不矛盾。單價減半是按每個 token 算的;成本 1/3(官方 X 帖)和“Agent 任務綜合成本降 70%”(官方博客)是按“完成一個任務的總花費”算的,都屬於官方自報。
完成一個任務的總花費 = 單價 × 用掉的 token 數。如果新模型完成同一個任務需要的輪數或 token 更少,任務成本就會比單價降得更多。但官方沒有公開這個 1/3 的具體算法,而且官方成本圖裏 Automation-Bench 的數字(62.8)和表格裏的(62.2)也對不上。所以做預算時建議按單價自己算,把“1/3”當參考。
MiniMax M3.1 Flash 按量 API 和 M Plan 訂閱怎麼選
MiniMax M3.1 Flash 有兩種付費方式。按量 API 是用多少扣多少,從賬戶餘額里扣;M Plan 是包月訂閱,分 Go、Explore、Build 三檔,文本模型都是 M3.1 Flash。官方文檔裏的用量是 Explore 爲 Go 的 3 倍、Build 爲 Go 的 7.5 倍,Explore 和 Build 還額外包含 H3 視頻模型。各檔月費以官網爲準,官方另有月付首月優惠的公告,活動細節同樣以官網爲準。
| 判斷維度 | 選按量 API | 選 M Plan 訂閱 |
|---|---|---|
| 用多少 | 用量不穩定,或者整體很少 | 每天高頻使用,想要固定月支出 |
| 用在哪裏 | 自己的產品後端、批量腳本、數據處理 | 自己寫代碼、日常 AI 編程輔助 |
| 用什麼工具 | 自研程序,通過 API 地址直接調用 | MiniMax Code、Claude Code、Codex、Cursor、OpenCode |
| 是否需要視頻 | 按需另算 | Explore / Build 檔含 H3 視頻模型 |
| 成本控制 | 可以精確到每次請求、用 effort 和緩存精細優化 | 不用算 token,超出套餐額度的規則以官網爲準 |
簡單來說:給程序用選按量,給人用選訂閱。如果你主要是在 Claude Code、Cursor 這類工具裏寫代碼,M Plan 的訂閱 Key 可以直接接入;如果你在做產品、跑批量任務,按量 API 配合本文的算賬方法更透明。
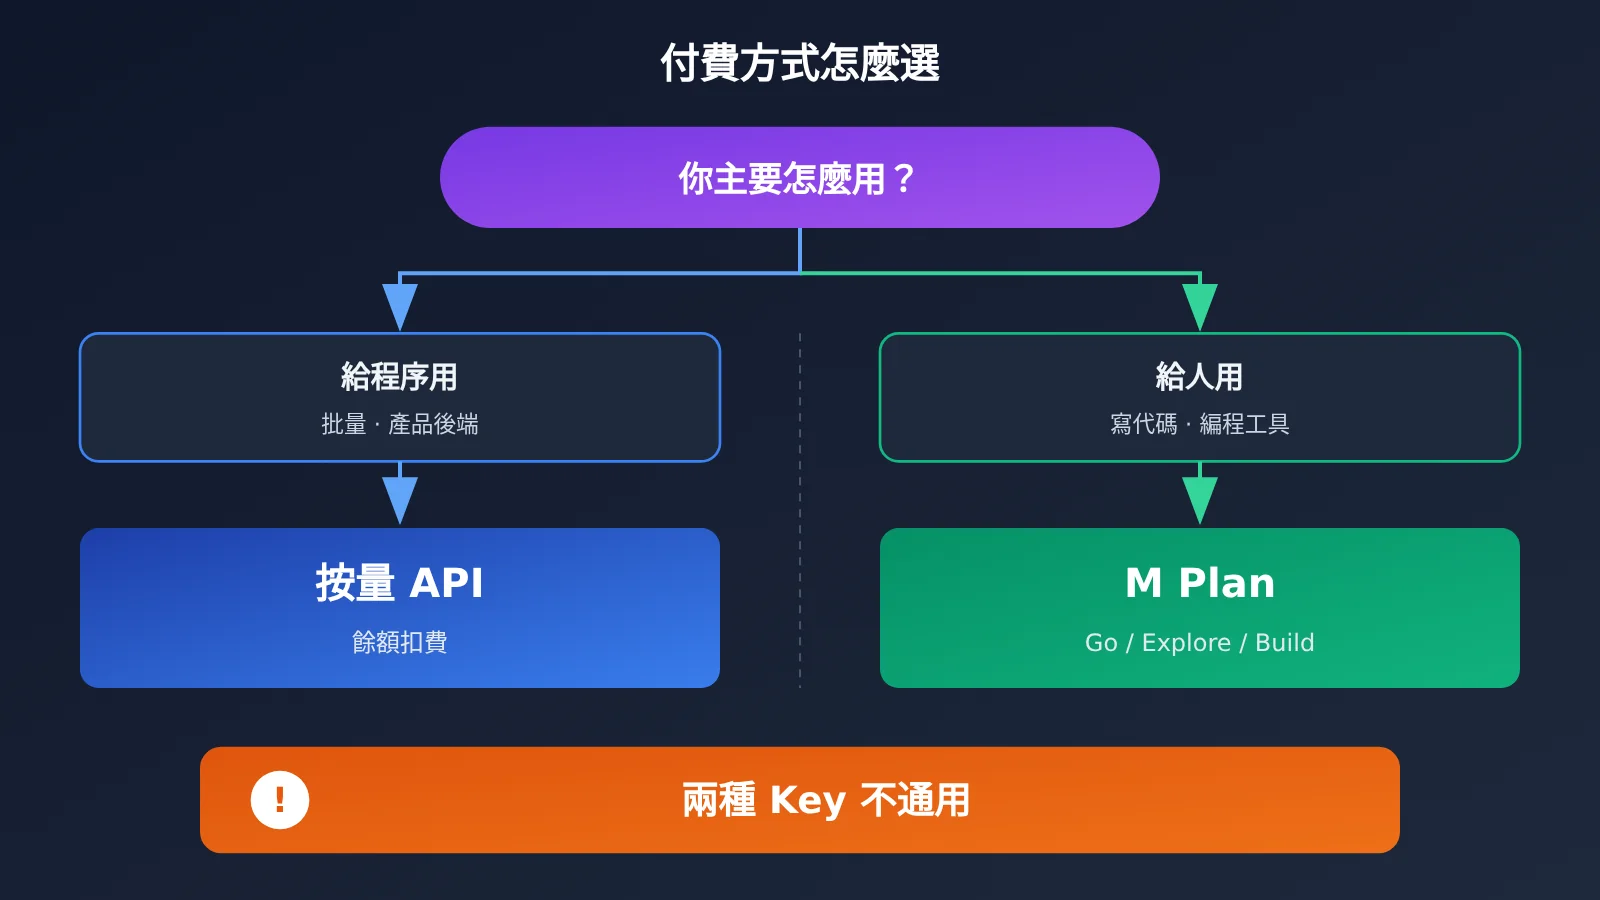
⚠️ 重要提醒:兩種 Key 不通用。官方 FAQ 明確說明,按量計費的 API Key 和 M Plan 的訂閱 Key 是兩種不同的 Key,在後臺的不同位置獲取。拿訂閱 Key 去調按量接口,或者反過來,都會出問題,配置前先確認你複製的是哪一個。另外,舊模型名 MiniMax-M3.1-Flash-Preview 已經退役,用舊名發的請求現在會由 MiniMax-M3.1-Flash 處理。
什麼時候不該用 MiniMax M3.1 Flash
便宜不等於什麼活都適合交給它。下面幾種情況建議先別換,或者只換一部分。
1. 長鏈路 Agent 和終端操作類任務。 第三方測評 Vals AI 顯示,M3.1 Flash 在 Terminal-Bench 4.0 上是 25.25%,在 51 個模型中排第 22;HLAB-Vals-1.1 是 7.50%,23 個模型中排第 17。官方自報的 Terminal Bench 4.0 是 38.1,也比 Claude Opus 5 的 51.8 低 13.7 分。
2. 大型代碼重構。 官方自報 SWE Refactor Bench 爲 23.0,Claude Opus 5 是 31.0。
3. 需要關閉思考、追求極低延遲。 思考關不掉,最低只能開到 low。
4. 現有集成依賴解析思考標籤。 從 M3 遷移過來要先改解析邏輯,否則會拿不到思考內容。
5. 現在就想在 API易 上調用。 截至發稿,API易 價格頁還沒有 MiniMax-M3.1-Flash,能否調用以價格頁爲準。
再說說和 Claude 的對比。官方對比表裏拿來對照的是 Claude Opus 5,不是 Opus 5.5。Claude Opus 5.5 仍然是 Anthropic 當前最強的旗艦模型,MiniMax 官方並沒有拿它逐項對比,所以不能說 Flash 追上或超過了 Opus 5.5。綜合排名方面,Vals Index 把 M3.1 Flash 排在 22 個模型中的第 15 名(53.78%),開源權重模型裏排第 5。
| 模型 | 輸入 / 輸出(每百萬 tokens) | 跑分對照情況 | 更適合的活 | 調用渠道 |
|---|---|---|---|---|
| MiniMax-M3.1-Flash | $0.15 / $0.60 | 官方自報 + Vals 測評 | 批量處理、日常編程、工具調用 | MiniMax 官方;API易 以價格頁爲準 |
| claude-opus-5 | $5 / $25(官方價) | 官方對比表的對照對象 | 複雜任務 | API易 apiyi.com 等 |
| claude-opus-5-5 | $4 / $20(官方價) | 官方未拿它對比 | 難的規劃、架構設計、大型重構 | API易 apiyi.com 等 |
按單價算,Opus 5.5 的輸出是 Flash 的約 33 倍($20 ÷ $0.60 ≈ 33.3),輸入約 27 倍($4 ÷ $0.15 ≈ 26.7)。差距這麼大,最合理的做法是分工,而不是二選一。
在 API易 上如何搭配 MiniMax 和 Claude Opus 5.5
截至 2026-10-22,API易 價格頁上可以直接使用的 MiniMax 模型有 MiniMax-M3(同時支持 OpenAI 和 Anthropic 兩種接口格式,並在 ClaudeCode 分組可用)、MiniMax-M2.7、MiniMax-M2.7-highspeed、MiniMax-M2.5、MiniMax-M2.5-lightning,以及視頻模型 MiniMax-H3。MiniMax-M3.1-Flash 目前還不在價格頁上,能否調用請以 API易 價格頁爲準。
Claude 這邊,claude-opus-5-5 和 claude-opus-5 都可以直接調用。API易 的好處是一個 Key 同時調用 MiniMax 系列和 Claude Opus 5.5,不需要分別註冊、分別充值。推薦的分工思路如下:
- 便宜的批量活交給 MiniMax:數據清洗、內容分類、批量改寫、簡單代碼生成,用 MiniMax-M3 這類性價比模型,配合緩存和較低的思考檔位。
- 難的規劃和重構交給 Opus 5.5:系統架構設計、跨模塊大重構、長鏈路任務的總體規劃,用 claude-opus-5-5。
- 先規劃後執行:讓 Opus 5.5 出方案、拆任務,再把拆好的小任務批量交給 MiniMax 執行,兼顧質量和成本。
💡 選擇建議:如果你還不確定哪些活可以降級給便宜模型,可以在 API易 apiyi.com 用同一批樣本分別跑 MiniMax-M3 和 claude-opus-5-5,對比效果和花費後再定分工比例。
常見問題 FAQ
Q1:MiniMax M3.1 Flash 的價格到底是多少?
按官方價格頁,每百萬 tokens 輸入 $0.15、輸出 $0.60、緩存讀 $0.015,是固定價,沒有長上下文加價。服務端聯網搜索 web_search 另外按 $0.01/次收費。
Q2:爲什麼我只問了一句話,輸出 token 卻很多?
因爲思考過程也算輸出,而且不傳 effort 時默認是 max 檔。思考關不掉,想減少輸出只能把 effort 調到 low 或 medium。
Q3:MiniMax M3.1 Flash 比 M3 便宜多少?
單價方面,輸入輸出是 M3 標準價的一半,緩存讀是 1/4;輸入超過 512K 時,M3 單價翻倍,Flash 不加價。官方說的“成本 1/3”是按任務算的官方自報數據,算法未公佈。
Q4:按量 API Key 能直接填進 Claude Code 用 M Plan 嗎?
不能。按量 API Key 和 M Plan 訂閱 Key 是兩種不同的 Key,在後臺不同位置獲取,互相不通用。用訂閱接工具時,要複製訂閱 Key。
Q5:現在能在 API易 上調用 MiniMax M3.1 Flash 嗎?
截至發稿,API易 價格頁還沒有 MiniMax-M3.1-Flash,能否調用以價格頁爲準,我們會盡快上架。目前可以在 API易 apiyi.com 直接使用 MiniMax-M3 和 claude-opus-5-5 等模型,一個 Key 就能切換。
Q6:有沒有免費試用的方式?
第三方平臺 OpenRouter 提供了帶限速的免費端點 minimax/minimax-m3.1-flash:free,適合先體驗效果。正式使用時,建議按本文方法用小批量數據估算成本。
Q7:MiniMax M3.1 Flash 有哪些不足?
第三方測評顯示,它在長鏈路 Agent 和終端任務上偏弱(Vals Terminal-Bench 4.0 排 51 個模型中第 22);官方自報的重構類跑分也低於 Claude Opus 5。此外,MiniMax 尚未發佈說明 Flash 改了什麼的技術報告。
Q8:想要最省錢,應該先做什麼?
第一步把 effort 從默認的 max 調低,第二步把固定的系統提示詞和長文檔放在請求最前面喫緩存。這兩步通常比換模型更立竿見影。如果想同時對比多個模型的花費,可以在 API易 apiyi.com 統一測試。
MiniMax M3.1 Flash 價格核心要點 Key Takeaways
- 三項單價:輸入 $0.15、輸出 $0.60、緩存讀 $0.015,每百萬 tokens,無長上下文加價。
- 賬單大頭是輸出:思考算輸出,默認 max 檔最貴,省錢先調低 effort。
- 思考關不掉:傳 disabled 或 none 會報 400,最低只能開到 low。
- 緩存省 90%:固定內容放最前面,變化內容放最後。
- 單價是 M3 一半:“成本 1/3”是官方按任務的自報口徑,兩者不矛盾。
- 程序用按量、人用訂閱:兩種 Key 不通用,M Plan 月費以官網爲準。
- 組合使用更划算:在 API易 用一個 Key 讓 MiniMax 跑批量、Opus 5.5 做規劃。
總結
MiniMax M3.1 Flash 價格的核心要點:
- 會算:費用 = 用量 ÷ 100 萬 × 單價,輸入、緩存讀、輸出分開算再相加。
- 會省:調低 effort 控制思考輸出,固定內容放前面多喫緩存。
- 會選:給程序用選按量 API,給人用選 M Plan,長鏈路 Agent 和大型重構仍建議交給更強的模型。
建議先用小批量真實數據跑一輪,算出你自己的單次成本,再決定付費方式和分工比例。需要在多個模型之間對比效果和花費時,推薦通過 API易 apiyi.com 用一個 Key 統一測試,MiniMax-M3.1-Flash 能否調用以價格頁爲準。
📚 參考資料
- MiniMax 官方發佈博客:M3.1 Flash 的速度、成本和官方自報跑分
- 鏈接:
minimax.io/blog/minimax-m31f -
說明: 官方價格和“Agent 任務成本降 70%”的出處
-
MiniMax 官方價格頁:Flash 與 M3 的完整單價
- 鏈接:
platform.minimax.io/docs/guides/pricing -
說明: 計費公式、長上下文分檔、web_search 價格
-
MiniMax 官方文檔:模型調用:effort 檔位與思考規則
- 鏈接:
platform.minimax.io/docs/guides/text-generation -
說明: 思考不能關閉、各協議 effort 字段名
-
MiniMax M Plan 訂閱說明:Go / Explore / Build 三檔
- 鏈接:
platform.minimax.io/docs/m-plan/intro -
說明: 用量倍數、支持的工具、模型說明
-
MiniMax 官方 FAQ:API Key 與訂閱 Key 的區別
- 鏈接:
platform.minimax.io/docs/faq/about-apis -
說明: 兩種 Key 不通用的官方說明
-
Vals AI 測評頁:第三方測評結果
- 鏈接:
vals.ai/models/minimax_MiniMax-M3.1-flash - 說明: Vals Index 排名、強項與弱項
作者:APIYI 技術團隊
技術交流:歡迎在 API易 apiyi.com 網站首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心