Catatan penulis: Panduan praktis yang menjelaskan biaya MiniMax M3.1 Flash, cara menghemat, dan pilihan yang tepat: API bayar sesuai pemakaian atau langganan M Plan.
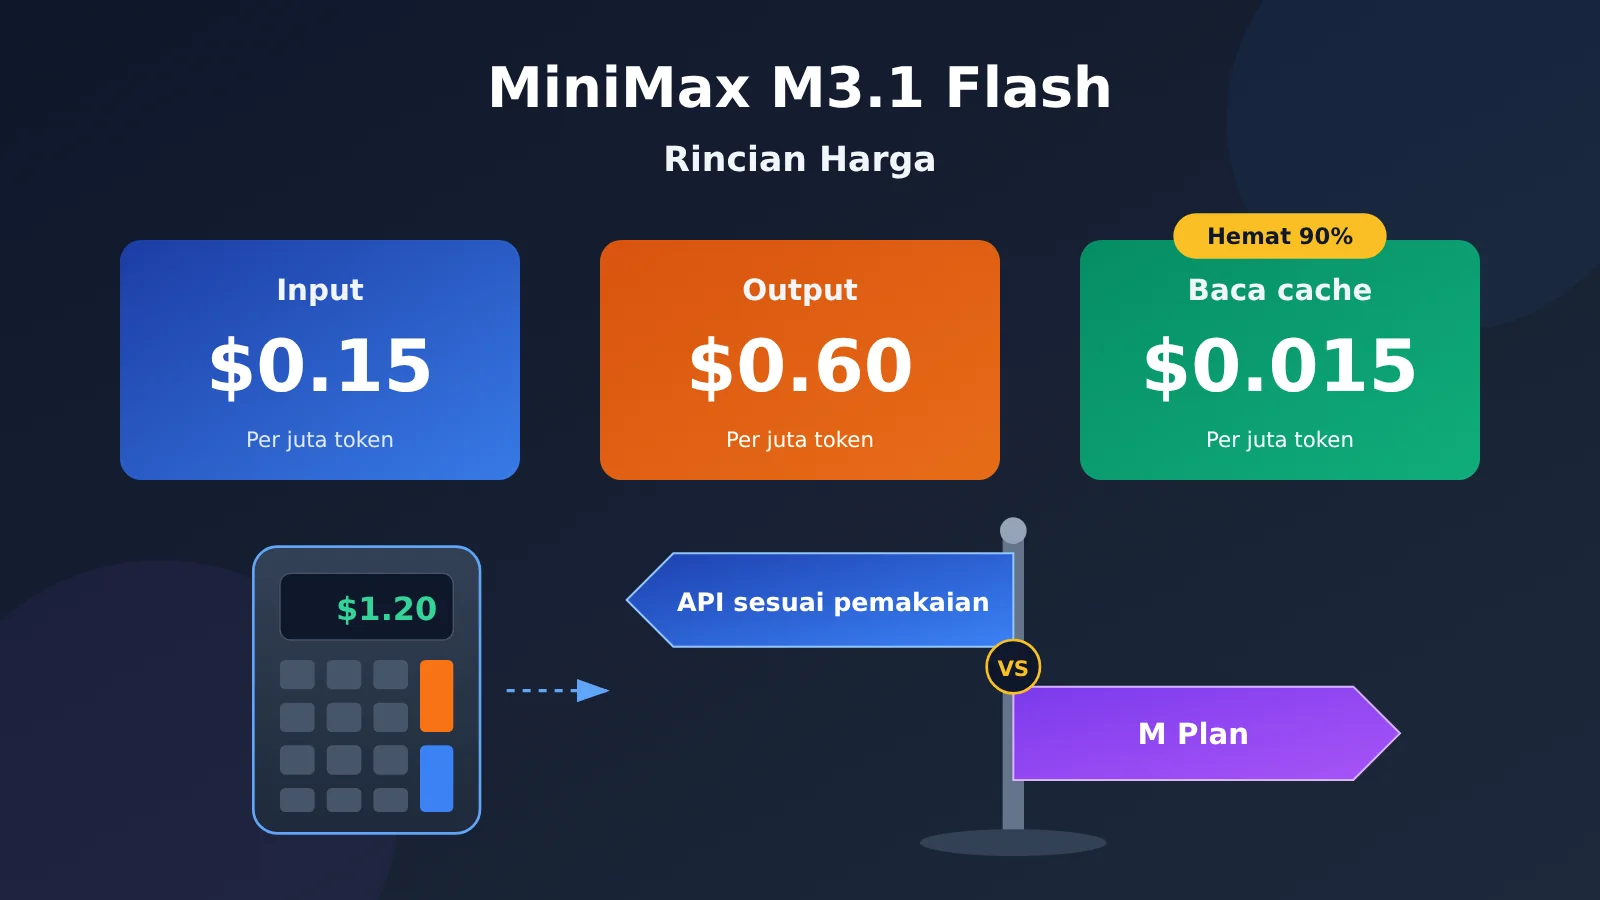
Kesimpulan singkatnya: Harga MiniMax M3.1 Flash per satu juta token adalah $0.15 untuk input, $0.60 untuk output, dan $0.015 untuk pembacaan cache. Porsi terbesar tagihan biasanya berasal dari output (termasuk proses berpikir model). Ada dua cara untuk menghemat: turunkan tingkat effort atau letakkan konten tetap di awal permintaan agar bisa menggunakan cache.
Ini bukan artikel berita peluncuran lainnya. Kami sudah membahas peluncurannya di situs ini. Artikel ini khusus membahas biaya: berapa harga per satuan untuk ketiga jenis token, perkiraan biaya satu percakapan dan satu tugas Agent, di mana letak penghematan dibandingkan M3, serta cara memilih antara bayar sesuai pemakaian dan langganan bulanan.
Manfaat utama: Setelah membaca artikel ini, Anda bisa memperkirakan pengeluaran bulanan untuk MiniMax M3.1 Flash, menghindari dua kesalahan penagihan yang paling umum, dan memilih cara pembayaran yang paling cocok.
Poin Utama Harga MiniMax M3.1 Flash
Pertama, mari jelaskan satu istilah: token adalah satuan terkecil yang digunakan untuk menghitung biaya model. Sederhananya, token bisa dianggap sebagai “potongan teks”. Menurut konversi resmi, sekitar 750 kata bahasa Inggris setara dengan 1.000 token. Halaman harga resmi tidak mencantumkan konversi untuk bahasa Mandarin, jadi gunakan tagihan di konsol sebagai acuan pemakaian sebenarnya.
Tabel berikut berisi semua tarif MiniMax M3.1 Flash, berdasarkan harga tetap yang dipublikasikan di halaman harga resmi MiniMax:
| Komponen biaya | Harga (per satu juta token) | Penjelasan sederhana | Contoh umum |
|---|---|---|---|
| Input | $0.15 | Semua konten yang kamu kirim ke model | Petunjuk sistem, riwayat percakapan, dokumen, gambar, dan video yang diunggah |
| Output | $0.60 | Semua konten yang dihasilkan model, termasuk proses berpikirnya | Jawaban akhir, isi penalaran (reasoning) |
| Pembacaan cache | $0.015 | Bagian input yang sama dengan permintaan sebelumnya dan berhasil ditemukan di cache | Petunjuk sistem yang selalu sama, dokumen panjang yang berulang kali dirujuk |
| Tambahan: web_search | $0.01/panggilan | Alat pencarian internet di sisi server, dikenakan biaya per panggilan | Agent menjalankan pencarian |
Ada dua hal yang perlu diingat. Pertama, tarif output 4 kali tarif input. Jadi, “seberapa banyak model berbicara” lebih memengaruhi tagihan daripada “seberapa banyak yang kamu kirim”. Kedua, biaya pembacaan cache hanya 1/10 dari harga input. Artinya, bagian input yang berhasil ditemukan di cache bisa menghemat 90%.
Cara Memahami Rumus Biaya MiniMax M3.1 Flash
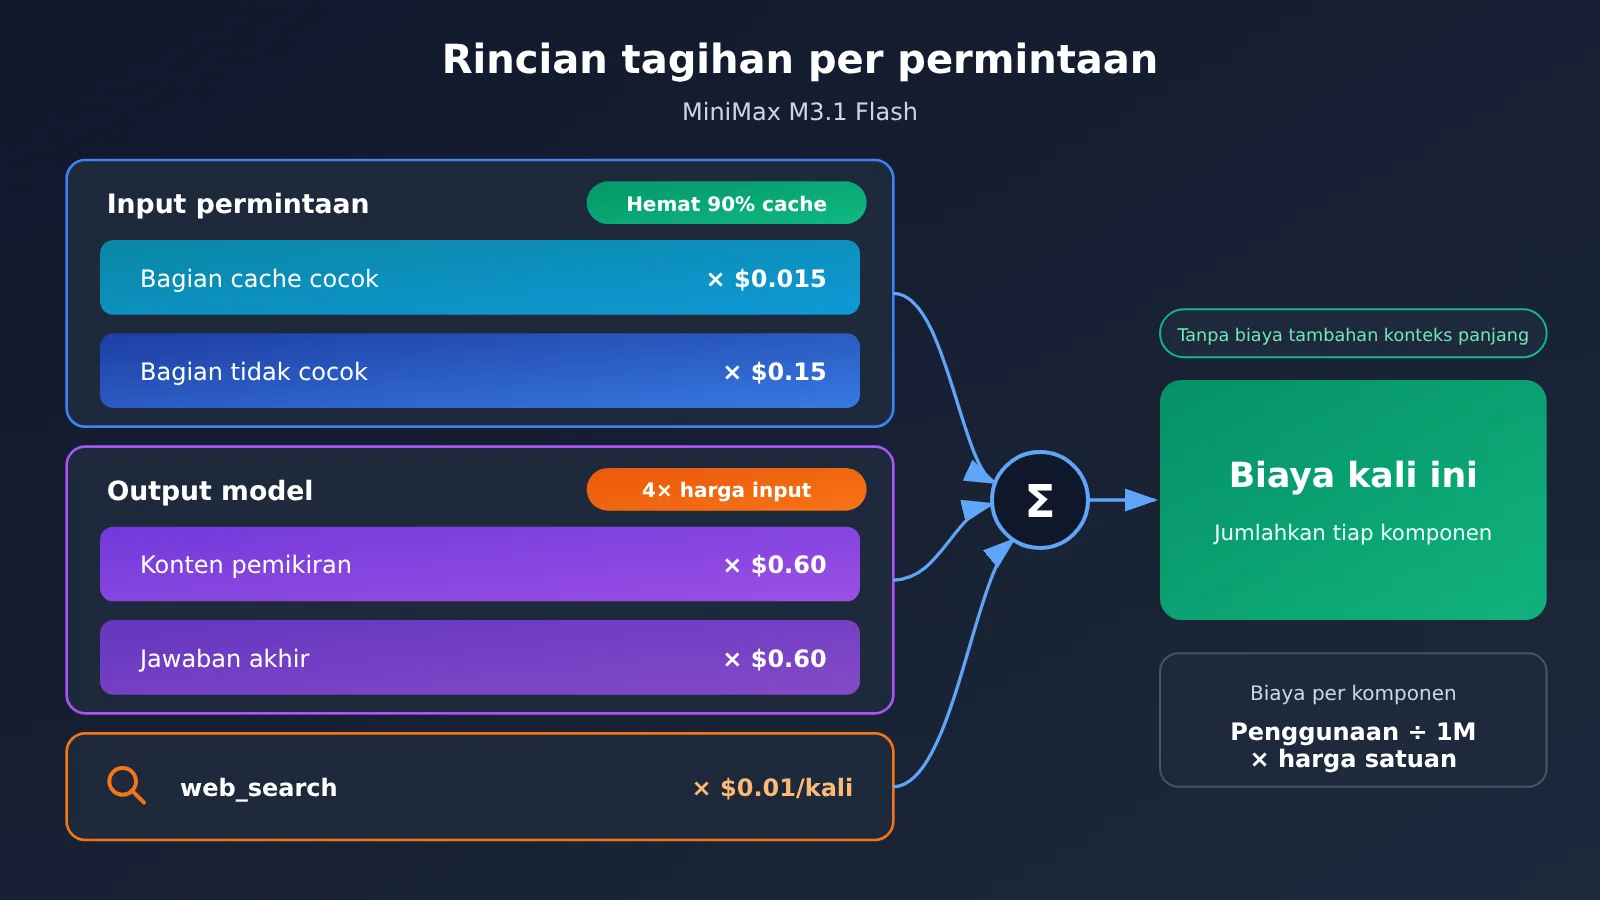
Rumus resmi yang digunakan cukup sederhana: biaya = jumlah pemakaian ÷ 1.000.000 × harga satuan. Hitung setiap komponen biaya secara terpisah, lalu jumlahkan semuanya. Total biaya akan dipotong dari saldo akun.
Tagihan untuk satu permintaan bisa dibagi menjadi tiga bagian: input yang ditemukan di cache × $0.015, input yang tidak ditemukan di cache × $0.15, serta output (jawaban + proses berpikir) × $0.60. Setelah itu, tambahkan jumlah pencarian × $0.01.
MiniMax M3.1 Flash memiliki jendela konteks sebesar 1.000.000 token. Jendela konteks adalah jumlah maksimum konten yang bisa “dilihat” model dalam satu waktu. Halaman harga resmi menyebutkan dengan jelas bahwa tidak ada biaya tambahan untuk konteks panjang. Jadi, baik kamu memasukkan 100.000 maupun 800.000 token, harga satuannya tetap sama.
Perhitungan Biaya MiniMax M3.1 Flash: 3 Contoh
Jumlah token dalam tiga contoh berikut hanya asumsi untuk mendemonstrasikan cara menghitung, bukan data hasil pengukuran. Anda bisa menggantinya dengan angka sendiri dan mengikuti perhitungannya.
Contoh 1: Satu percakapan biasa
Asumsi: input 2.000 token (tidak terkena cache), output 1.500 token (termasuk token untuk berpikir).
- Input: 2.000 ÷ 1.000.000 × $0.15 = $0.0003
- Output: 1.500 ÷ 1.000.000 × $0.60 = $0.0009
- Total: $0.0003 + $0.0009 = $0.0012
Cek perhitungan: jika percakapan seperti ini dilakukan 1.000 kali, pemakaiannya menjadi 2 juta token input dan 1,5 juta token output. Perhitungannya: 2 × $0.15 + 1.5 × $0.60 = $0.30 + $0.90 = $1.20, sama dengan $0.0012 × 1.000.
Contoh 2: Satu tugas agen (multi-putaran)
Agen adalah model yang menyusun langkah-langkah sendiri, menggunakan alat, lalu menyelesaikan tugas melalui beberapa putaran. Karena konteks dari putaran sebelumnya harus dikirim ulang setiap kali, jumlah inputnya besar dan manfaat cache paling terasa.
Asumsi: total 20 putaran, setiap putaran menggunakan 30.000 token input—25.000 terkena cache dan 5.000 merupakan konten baru—serta 2.000 token output.
- Pembacaan cache: 25.000 × 20 = 500.000 token, 0.5 × $0.015 = $0.0075
- Input baru: 5.000 × 20 = 100.000 token, 0.1 × $0.15 = $0.015
- Output: 2.000 × 20 = 40.000 token, 0.04 × $0.60 = $0.024
- Total: $0.0075 + $0.015 + $0.024 = $0.0465
Sebagai perbandingan: jika tidak ada input yang terkena cache, 600.000 token input akan dikenai biaya 0.6 × $0.15 = $0.09. Ditambah biaya output $0.024, totalnya menjadi $0.114. Cache menghemat $0.114 − $0.0465 = $0.0675 untuk tugas ini, atau sekitar 59%.
Contoh 3: 1.000 pemanggilan batch dalam sehari
Asumsi: setiap pemanggilan menyertakan petunjuk sistem tetap sebanyak 1.000 token (terkena cache), 500 token konten baru, dan menghasilkan 1.000 token output.
- Pembacaan cache: 1.000 × 1.000 = 1 juta token, 1 × $0.015 = $0.015
- Input baru: 500 × 1.000 = 500.000 token, 0.5 × $0.15 = $0.075
- Output: 1.000 × 1.000 = 1 juta token, 1 × $0.60 = $0.60
- Total per hari: $0.015 + $0.075 + $0.60 = $0.69, atau sekitar $20.70 per bulan jika dihitung untuk 30 hari
Jika tingkat effort disetel tinggi sehingga output setiap pemanggilan menjadi 3.000 token (ini juga hanya asumsi), biaya output naik menjadi 3 × $0.60 = $1.80 dan total biaya harian menjadi $1.89. Biaya input dan cache tidak berubah, tetapi tagihannya menjadi hampir 2,7 kali lipat dari semula ($1.89 ÷ $0.69 ≈ 2.74). Ini menunjukkan bahwa output menjadi komponen biaya terbesar dalam tugas batch.
🚀 Saran untuk mulai mencoba: Jalankan pengujian dengan batch kecil menggunakan data nyata. Catat rata-rata input, jumlah token yang terkena cache, dan output, lalu gunakan rumus di atas untuk memperkirakan biaya bulanan. Hasilnya akan lebih akurat daripada sekadar menebak. Jika Anda juga ingin membandingkan biaya MiniMax-M3, Claude, dan model lainnya, Anda bisa menggunakan kunci API yang sama di APIYI apiyi.com untuk menguji model yang berbeda.
Dua Jebakan Penagihan yang Paling Sering Terjadi pada MiniMax M3.1 Flash
Jebakan pertama: mode berpikir tidak bisa dimatikan, tingkat effort menentukan tagihan
effort adalah parameter “kedalaman berpikir”. Semakin tinggi tingkatnya, semakin banyak model berpikir. MiniMax M3.1 Flash punya pengaturan yang berbeda dari banyak model lain: mode berpikir tidak bisa dimatikan. Dokumentasi resmi menyebutkan bahwa mengirim thinking disabled atau effort none akan langsung menghasilkan error 400 dengan pesan bahwa model “MiniMax-M3.1-Flash” memerlukan adaptive thinking.
Konten pemikiran ditagihkan sebagai keluaran, dan jika effort tidak dikirim, nilai default-nya adalah max, yaitu tingkat dengan biaya paling tinggi. Untuk menghemat biaya, satu-satunya cara adalah menurunkan tingkatnya secara manual. Nama kolomnya berbeda-beda, tergantung protokol: protokol Anthropic menggunakan output_config.effort, protokol OpenAI menggunakan reasoning_effort, sedangkan protokol Responses menggunakan reasoning.effort.
| Tingkat effort | Jumlah pemikiran | Dampak pada tagihan | Skenario yang disarankan |
|---|---|---|---|
| low | Paling sedikit | Keluaran paling sedikit, paling hemat dan latensi terendah | Klasifikasi, ekstraksi, penulisan ulang, konversi format |
| medium | Relatif sedikit | Cenderung hemat | Tanya jawab sehari-hari, rangkuman sederhana |
| high | Relatif banyak | Cenderung mahal | Pemrograman umum, penalaran bertahap |
| xhigh | Banyak | Mahal | Analisis kompleks, debugging masalah sulit |
| max (default) | Paling banyak | Paling mahal, latensi tertinggi | Tugas yang benar-benar sulit, Agent dengan alur panjang |
Pihak resmi belum merilis rata-rata tambahan token untuk setiap tingkat. Tabel di atas hanya menunjukkan perbandingan relatif. Perlu diketahui juga, pengujian resmi dan evaluasi pihak ketiga oleh Vals sama-sama menggunakan tingkat tinggi (Vals secara eksplisit menyebutkan effort max). Belum ada data publik tentang seberapa besar penurunan kinerja setelah tingkatnya diturunkan. Sebaiknya mulai dengan low atau medium pada sejumlah sampel, lalu naikkan tingkatnya jika hasilnya kurang memuaskan.
Ada satu perubahan lagi: konten pemikiran kini dikembalikan secara terpisah. Dalam protokol yang kompatibel dengan OpenAI, pemikiran ditempatkan di kolom reasoning_content, sedangkan content hanya berisi jawaban akhir. Jika sebelumnya Anda memisahkan konten dari tag pemikiran yang dihasilkan M3, logika penguraian ini perlu diperbarui.
Jebakan kedua: biaya baca cache hanya 1/10 harga input, urutan konten sangat penting
Cache berarti sistem mengenali bagian dalam permintaan yang sama persis dengan permintaan sebelumnya, lalu menagihnya dengan harga baca cache. Biayanya $0.015, atau 90% lebih murah daripada $0.15.
Agar lebih banyak konten cocok dengan cache, kuncinya adalah menjaga bagian awal permintaan tetap sama:
- Letakkan petunjuk sistem yang tetap di bagian paling awal. Jangan sisipkan stempel waktu, angka acak, atau nama pengguna ke dalamnya.
- Letakkan konten yang sering digunakan, seperti dokumen panjang, basis pengetahuan, dan deskripsi alat, tepat setelah petunjuk sistem.
- Letakkan konten yang berubah setiap kali, seperti pertanyaan pengguna dan data untuk giliran saat ini, di bagian akhir.
- Dalam percakapan multi-giliran, jangan sembarangan menghapus atau mengubah riwayat sebelumnya. Jika satu bagian di tengah diubah, konten setelahnya akan sulit cocok dengan cache.
Dokumentasi resmi hanya mencantumkan harga baca cache. Untuk aturan cache secara terperinci dan biaya terkait lainnya, lihat halaman harga resmi MiniMax.
Perbandingan Harga MiniMax M3.1 Flash dan M3
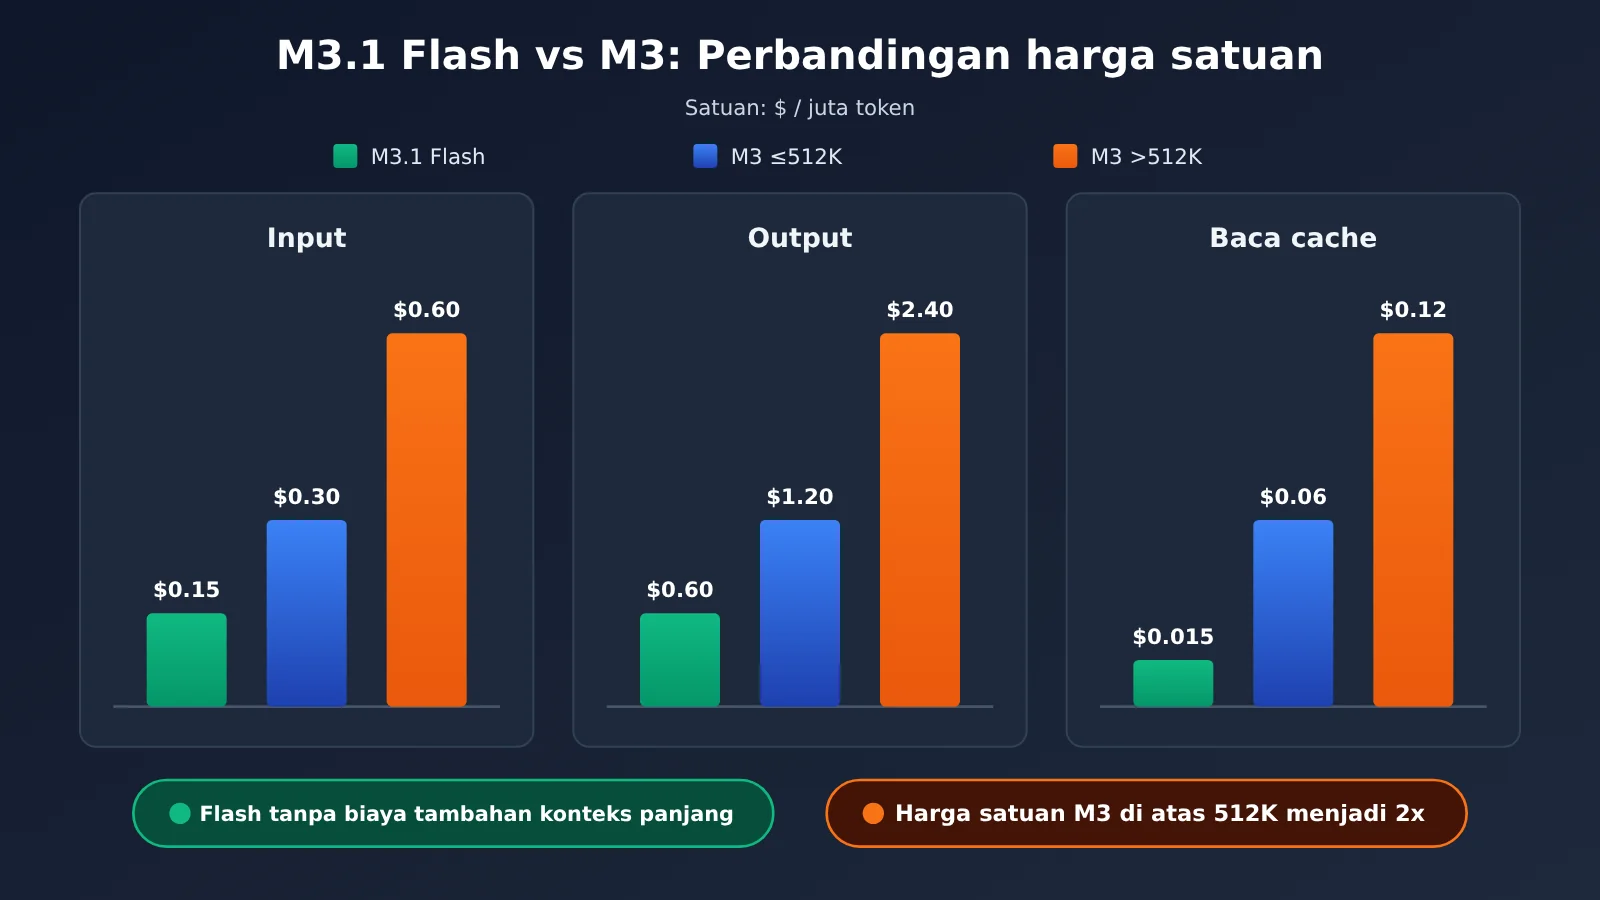
Banyak orang bertanya berapa selisih harga MiniMax M3.1 Flash dan M3 generasi sebelumnya. Tabel di bawah ini diambil dari halaman harga resmi. Harga M3 menggunakan tarif standar setelah diskon permanen 50% (per satu juta token):
| Model | Input | Output | Pembacaan cache | Biaya tambahan konteks panjang |
|---|---|---|---|---|
| MiniMax-M3.1-Flash | $0.15 | $0.60 | $0.015 | Tidak ada |
| MiniMax-M3 (input ≤512K) | $0.30 | $1.20 | $0.06 | — |
| MiniMax-M3 (input >512K) | $0.60 | $2.40 | $0.12 | Tarif per unit menjadi dua kali lipat |
| MiniMax-M3 Priority | Tarif standar × 1.5 | Tarif standar × 1.5 | — | — |
Keterangan gambar: Data harga berasal dari halaman harga resmi MiniMax. Biaya aktual di platform pihak ketiga mengikuti halaman harga masing-masing. Misalnya, saat menggunakan seri MiniMax melalui APIYI apiyi.com, silakan merujuk pada harga yang tertera di halaman harganya.
Dari tabel tersebut, ada tiga hal yang bisa disimpulkan:
- Konteks biasa: Harga satuan input dan output Flash masing-masing setengah dari M3, sedangkan biaya pembacaan cache hanya seperempatnya ($0.015 dibanding $0.06). Mari kita cek dengan kasus 3: untuk penggunaan yang sama, biayanya di M3 adalah 1 × $0.06 + 0.5 × $0.30 + 1 × $1.20 = $1.41/hari, sedangkan di Flash $0.69/hari, atau sekitar 49%.
- Konteks sangat panjang: Saat input melebihi 512K, harga satuan M3 menjadi dua kali lipat, sedangkan Flash tidak dikenai biaya tambahan. Harga input dan output Flash hanya seperempat dari M3.
- Cache lebih hemat: Biaya pembacaan cache Flash adalah 1/10 dari harga inputnya, sedangkan M3 adalah 1/5. Jadi, semakin bergantung suatu skenario pada cache, semakin besar keunggulan Flash.
Mengapa harga satuannya hanya setengah, padahal pihak resmi menyebut “biaya 1/3”?
Kedua pernyataan ini tidak bertentangan. Harga satuan turun setengah dihitung per token, sedangkan biaya 1/3 (dalam unggahan resmi di X) dan “total biaya tugas Agent turun 70%” (dalam blog resmi) dihitung berdasarkan “total biaya untuk menyelesaikan satu tugas”. Keduanya merupakan klaim dari pihak resmi.
Total biaya untuk menyelesaikan satu tugas = harga satuan × jumlah token yang digunakan. Jika model baru membutuhkan lebih sedikit giliran atau token untuk menyelesaikan tugas yang sama, biaya tugas bisa turun lebih besar daripada penurunan harga satuannya. Namun, pihak resmi tidak memublikasikan metode perhitungan angka 1/3 ini. Selain itu, angka Automation-Bench pada grafik biaya resmi (62.8) juga tidak cocok dengan angka di tabel (62.2). Jadi, untuk menyusun anggaran, sebaiknya hitung sendiri berdasarkan harga satuan dan jadikan klaim “1/3” sebagai referensi.
Cara Memilih antara API Bayar Sesuai Pemakaian dan Langganan M Plan MiniMax M3.1 Flash
MiniMax M3.1 Flash menawarkan dua cara pembayaran. API bayar sesuai pemakaian memotong saldo akun berdasarkan jumlah penggunaan. Sementara itu, M Plan adalah langganan bulanan dengan tiga paket: Go, Explore, dan Build. Semua paket menggunakan model teks M3.1 Flash. Menurut dokumentasi resmi, kuota Explore 3 kali kuota Go, sedangkan kuota Build 7,5 kali kuota Go. Explore dan Build juga mencakup model video H3. Biaya bulanan mengikuti harga yang tercantum di situs resmi. Ada juga pengumuman promo bulan pertama untuk pembayaran bulanan; detail promonya mengikuti informasi di situs resmi.
| Aspek pertimbangan | Pilih API bayar sesuai pemakaian | Pilih langganan M Plan |
|---|---|---|
| Jumlah penggunaan | Penggunaan tidak menentu atau secara keseluruhan sedikit | Digunakan dengan intensitas tinggi setiap hari dan ingin pengeluaran bulanan tetap |
| Penggunaan | Backend produk sendiri, skrip pemrosesan massal, pengolahan data | Menulis kode sendiri dan bantuan AI untuk pemrograman sehari-hari |
| Alat yang digunakan | Program buatan sendiri yang terhubung langsung melalui alamat API | MiniMax Code, Claude Code, Codex, Cursor, OpenCode |
| Perlu video atau tidak | Dihitung terpisah sesuai kebutuhan | Paket Explore / Build mencakup model video H3 |
| Kontrol biaya | Biaya dapat dihitung secara akurat untuk setiap permintaan, lalu dioptimalkan dengan pengaturan effort dan cache | Tidak perlu menghitung token; aturan penggunaan setelah kuota paket habis mengikuti informasi di situs resmi |
Singkatnya: API bayar sesuai pemakaian cocok untuk program, sedangkan langganan cocok untuk penggunaan pribadi. Jika Anda terutama menulis kode dengan alat seperti Claude Code atau Cursor, kunci langganan M Plan dapat langsung digunakan. Jika Anda sedang mengembangkan produk atau menjalankan tugas pemrosesan massal, biaya API bayar sesuai pemakaian lebih transparan jika dihitung dengan metode dalam artikel ini.
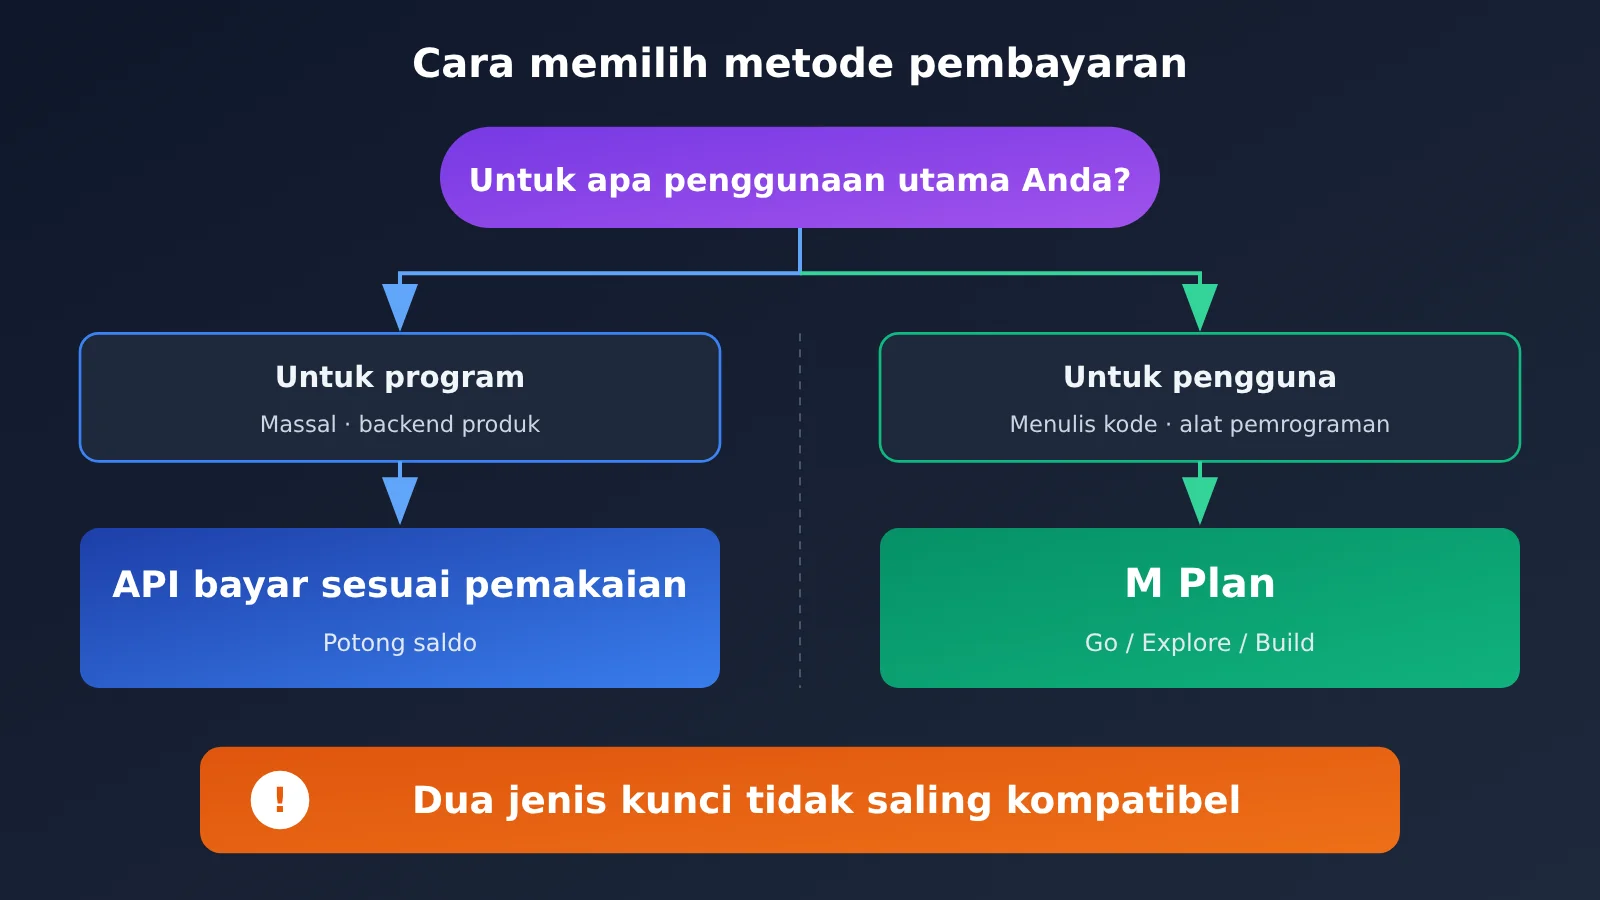
⚠️ Penting: Kedua jenis kunci tidak dapat digunakan secara bergantian. FAQ resmi menjelaskan bahwa kunci API untuk pembayaran sesuai pemakaian dan kunci langganan M Plan adalah dua jenis kunci yang berbeda, dan masing-masing diperoleh dari bagian yang berbeda di konsol. Menggunakan kunci langganan untuk memanggil endpoint bayar sesuai pemakaian, atau sebaliknya, akan menimbulkan masalah. Sebelum mengatur konfigurasi, pastikan Anda menyalin kunci yang benar. Selain itu, nama model lama MiniMax-M3.1-Flash-Preview sudah dihentikan. Permintaan yang menggunakan nama lama tersebut sekarang akan diproses oleh MiniMax-M3.1-Flash.
Kapan Sebaiknya Tidak Menggunakan MiniMax M3.1 Flash
Harganya murah bukan berarti semua pekerjaan cocok diserahkan kepadanya. Untuk beberapa situasi berikut, sebaiknya jangan langsung beralih, atau cukup alihkan sebagian pekerjaan saja.
1. Tugas Agent dengan alur panjang dan operasi terminal. Evaluasi pihak ketiga dari Vals AI menunjukkan bahwa M3.1 Flash meraih skor 25,25% di Terminal-Bench 4.0, menempati peringkat ke-22 dari 51 model. Di HLAB-Vals-1.1, skornya 7,50%, menempati peringkat ke-17 dari 23 model. Skor Terminal Bench 4.0 yang dilaporkan sendiri oleh pihak resmi adalah 38,1, masih 13,7 poin di bawah Claude Opus 5 yang meraih 51,8.
2. Refaktor kode berskala besar. Skor SWE Refactor Bench yang dilaporkan sendiri oleh pihak resmi adalah 23,0, sementara Claude Opus 5 meraih 31,0.
3. Perlu menonaktifkan mode berpikir dan mengutamakan latensi sangat rendah. Mode berpikir tidak bisa dinonaktifkan; opsi paling rendah yang tersedia adalah low.
4. Integrasi yang sudah ada bergantung pada penguraian tag berpikir. Jika bermigrasi dari M3, logika penguraian perlu diubah terlebih dahulu. Jika tidak, konten pemikiran tidak akan terbaca.
5. Ingin langsung menggunakannya melalui APIYI. Saat artikel ini ditulis, MiniMax-M3.1-Flash belum tercantum di halaman harga APIYI. Ketersediaannya bisa dipastikan melalui halaman harga tersebut.
Sekarang, mari kita bandingkan dengan Claude. Tabel perbandingan resmi menggunakan Claude Opus 5 sebagai pembanding, bukan Opus 5.5. Claude Opus 5.5 masih menjadi model flagship Anthropic yang paling kuat saat ini. MiniMax tidak membandingkannya secara langsung dalam setiap aspek, jadi kita tidak bisa menyimpulkan bahwa Flash sudah menyamai atau melampaui Opus 5.5. Dalam peringkat keseluruhan, Vals Index menempatkan M3.1 Flash di posisi ke-15 dari 22 model (53,78%), dan di posisi ke-5 di antara model dengan bobot terbuka.
| Model | Input / output (per satu juta token) | Perbandingan skor | Pekerjaan yang paling cocok | Kanal penggunaan |
|---|---|---|---|---|
| MiniMax-M3.1-Flash | $0.15 / $0.60 | Laporan resmi + evaluasi Vals | Pemrosesan batch, pemrograman sehari-hari, pemanggilan alat | Resmi MiniMax; ketersediaan di APIYI mengacu pada halaman harga |
| claude-opus-5 | $5 / $25 (harga resmi) | Model pembanding dalam tabel perbandingan resmi | Tugas kompleks | APIYI, apiyi.com, dan lainnya |
| claude-opus-5-5 | $4 / $20 (harga resmi) | Tidak dibandingkan oleh pihak resmi | Perencanaan sulit, desain arsitektur, refaktor berskala besar | APIYI, apiyi.com, dan lainnya |
Berdasarkan harga satuan, biaya output Opus 5.5 sekitar 33 kali lipat biaya Flash ($20 ÷ $0.60 ≈ 33,3), sedangkan biaya inputnya sekitar 27 kali lipat ($4 ÷ $0.15 ≈ 26,7). Dengan selisih sebesar itu, pilihan paling masuk akal adalah membagi tugas, bukan memilih salah satunya saja.
Cara memadukan MiniMax dan Claude Opus 5.5 di APIYI
Per 22 Oktober 2026, model MiniMax yang bisa langsung digunakan di halaman harga APIYI adalah MiniMax-M3 (mendukung format API OpenAI dan Anthropic, serta tersedia di grup ClaudeCode), MiniMax-M2.7, MiniMax-M2.7-highspeed, MiniMax-M2.5, MiniMax-M2.5-lightning, dan model video MiniMax-H3. MiniMax-M3.1-Flash belum tersedia di halaman harga. Untuk memastikan apakah model tersebut bisa dipanggil, silakan cek halaman harga APIYI.
Untuk Claude, claude-opus-5-5 dan claude-opus-5 sama-sama bisa langsung dipanggil. Keunggulan APIYI adalah satu kunci API bisa digunakan untuk memanggil model dari seri MiniMax dan Claude Opus 5.5, jadi Anda tidak perlu mendaftar dan mengisi saldo secara terpisah. Berikut pembagian tugas yang disarankan:
- Serahkan tugas massal yang sederhana kepada MiniMax: pembersihan data, klasifikasi konten, penulisan ulang secara massal, dan pembuatan kode sederhana. Gunakan model yang hemat biaya seperti MiniMax-M3, didukung cache dan tingkat penalaran yang lebih rendah.
- Serahkan perencanaan sulit dan refaktor besar kepada Opus 5.5: desain arsitektur sistem, refaktor besar lintas modul, dan perencanaan keseluruhan untuk tugas berantai panjang. Gunakan
claude-opus-5-5. - Rencanakan terlebih dahulu, lalu eksekusi: minta Opus 5.5 menyusun rencana dan memecah tugas, lalu serahkan tugas-tugas kecil hasil pemecahan itu kepada MiniMax untuk dikerjakan secara massal. Dengan begitu, Anda bisa menyeimbangkan kualitas dan biaya.
💡 Saran pemilihan: Jika belum yakin tugas mana yang bisa dialihkan ke model yang lebih murah, jalankan sampel yang sama dengan MiniMax-M3 dan
claude-opus-5-5di APIYI apiyi.com. Setelah membandingkan hasil dan biayanya, tentukan proporsi pembagian tugas.
Pertanyaan Umum (FAQ)
Q1: Berapa sebenarnya harga MiniMax M3.1 Flash?
Menurut halaman harga resmi, biayanya $0,15 per satu juta token input, $0,60 per satu juta token output, dan $0,015 per satu juta token untuk pembacaan cache. Harganya tetap, tanpa biaya tambahan untuk konteks panjang. Pencarian web_search melalui koneksi internet di sisi server dikenai biaya tambahan $0,01 per pencarian.
Q2: Kenapa output token-nya banyak, padahal saya hanya bertanya satu kalimat?
Karena proses berpikir juga dihitung sebagai output. Jika Anda tidak mengirimkan parameter effort, pengaturan default-nya adalah max. Proses berpikir tidak bisa dimatikan. Untuk mengurangi jumlah output, ubah effort ke low atau medium.
Q3: Berapa lebih murah MiniMax M3.1 Flash dibandingkan M3?
Untuk harga satuan, biaya input dan output-nya setengah dari harga standar M3, sedangkan biaya pembacaan cache-nya seperempat. Jika input melebihi 512K, harga satuan M3 menjadi dua kali lipat, sementara Flash tidak dikenai biaya tambahan. Klaim resmi bahwa “biayanya 1/3” didasarkan pada data yang dilaporkan sendiri untuk tugas tertentu, tetapi metode perhitungannya tidak dipublikasikan.
Q4: Bisakah kunci API bayar sesuai pemakaian langsung digunakan di Claude Code dengan M Plan?
Tidak bisa. Kunci API bayar sesuai pemakaian dan kunci langganan M Plan adalah dua jenis kunci yang berbeda. Keduanya diperoleh dari bagian yang berbeda di dasbor dan tidak bisa saling digunakan. Jika ingin menghubungkan langganan ke alat, salin kunci langganan.
Q5: Apakah MiniMax M3.1 Flash sudah bisa digunakan melalui APIYI?
Hingga artikel ini diterbitkan, MiniMax-M3.1-Flash belum tersedia di halaman harga APIYI. Periksa halaman harga untuk mengetahui ketersediaannya. Kami akan segera menghadirkannya. Saat ini, Anda bisa menggunakan model seperti MiniMax-M3 dan claude-opus-5-5 langsung di APIYI melalui apiyi.com, lalu beralih model dengan satu kunci API.
Q6: Apakah ada cara untuk mencobanya secara gratis?
Platform pihak ketiga OpenRouter menyediakan endpoint gratis dengan batas laju, yaitu minimax/minimax-m3.1-flash:free. Endpoint ini cocok untuk mencoba performanya terlebih dahulu. Untuk penggunaan resmi, sebaiknya ikuti metode dalam artikel ini dan perkirakan biaya menggunakan data dalam jumlah kecil.
Q7: Apa saja kekurangan MiniMax M3.1 Flash?
Menurut evaluasi pihak ketiga, performanya kurang baik untuk Agent dengan alur panjang dan tugas terminal. Di Vals Terminal-Bench 4.0, model ini berada di peringkat ke-22 dari 51 model. Skor yang dilaporkan sendiri oleh pihak resmi untuk tugas refaktorisasi juga lebih rendah daripada Claude Opus 5. Selain itu, MiniMax belum menerbitkan laporan teknis yang menjelaskan perubahan pada Flash.
Q8: Apa yang sebaiknya dilakukan lebih dulu untuk menghemat biaya semaksimal mungkin?
Pertama, turunkan effort dari pengaturan default max. Kedua, letakkan petunjuk sistem yang tetap dan dokumen panjang di awal permintaan agar bisa memanfaatkan cache. Biasanya, kedua langkah ini memberi dampak lebih cepat daripada berganti model. Jika ingin membandingkan biaya beberapa model sekaligus, Anda bisa melakukan pengujian terpusat melalui APIYI di apiyi.com.
Poin Penting Harga MiniMax M3.1 Flash
- Ada tiga tarif: input $0,15, output $0,60, dan pembacaan cache $0,015 per satu juta token. Tidak ada biaya tambahan untuk konteks panjang.
- Sebagian besar tagihan berasal dari output: token untuk proses berpikir dihitung sebagai output. Pengaturan max secara default paling mahal, jadi turunkan effort untuk menghemat biaya.
- Proses berpikir tidak bisa dimatikan: mengirim
disabledataunoneakan menghasilkan error 400. Pengaturan terendah yang bisa digunakan adalahlow. - Cache menghemat 90%: letakkan konten tetap di bagian awal dan konten yang berubah di bagian akhir.
- Tarifnya setengah dari M3: klaim “biaya 1/3” adalah pernyataan resmi berdasarkan tugas, jadi keduanya tidak bertentangan.
- Gunakan tarif berdasarkan pemakaian untuk program, dan langganan untuk pengguna: kedua jenis kunci tidak bisa dipertukarkan. Cek situs resmi untuk mengetahui biaya bulanan M Plan.
- Lebih hemat jika digunakan bersama: gunakan satu kunci di APIYI untuk menjalankan tugas batch dengan MiniMax dan membuat perencanaan dengan Opus 5.5.
Kesimpulan
Hal-hal penting tentang harga MiniMax M3.1 Flash:
- Pahami cara menghitungnya: biaya = pemakaian ÷ 1 juta × tarif. Hitung input, pembacaan cache, dan output secara terpisah, lalu jumlahkan.
- Ketahui cara menghematnya: turunkan effort untuk mengendalikan output proses berpikir, dan letakkan konten tetap di bagian awal agar lebih banyak memanfaatkan cache.
- Pilih sesuai kebutuhan: gunakan API dengan tarif berdasarkan pemakaian untuk program, dan M Plan untuk pengguna. Untuk alur kerja Agent yang panjang dan refaktor besar, sebaiknya gunakan model yang lebih mumpuni.
Sebaiknya mulai dengan menjalankan sejumlah kecil data nyata untuk menghitung biaya per pemanggilan, lalu tentukan metode pembayaran dan pembagian tugas yang sesuai. Jika ingin membandingkan performa dan biaya beberapa model, gunakan satu kunci melalui APIYI apiyi.com untuk melakukan pengujian terpadu. Untuk memastikan apakah MiniMax-M3.1-Flash bisa digunakan, cek halaman harga.
📚 Referensi
- Blog pengumuman resmi MiniMax: Kecepatan, biaya, dan skor benchmark yang dilaporkan MiniMax untuk M3.1 Flash
- Tautan:
minimax.io/blog/minimax-m31f -
Keterangan: Sumber informasi harga resmi dan klaim “biaya tugas Agent turun 70%”
-
Halaman harga resmi MiniMax: Harga lengkap Flash dan M3
- Tautan:
platform.minimax.io/docs/guides/pricing -
Keterangan: Rumus penagihan, tingkatan harga untuk konteks panjang, dan harga
web_search -
Dokumentasi resmi MiniMax: Pemanggilan model: Tingkatan
effortdan aturan berpikir - Tautan:
platform.minimax.io/docs/guides/text-generation -
Keterangan: Mode berpikir tidak bisa dinonaktifkan dan nama kolom
effortdi setiap protokol -
Informasi langganan MiniMax M Plan: Tiga paket Go / Explore / Build
- Tautan:
platform.minimax.io/docs/m-plan/intro -
Keterangan: Pengali kuota penggunaan, alat yang didukung, dan informasi model
-
FAQ resmi MiniMax: Perbedaan antara kunci API dan kunci langganan
- Tautan:
platform.minimax.io/docs/faq/about-apis -
Keterangan: Penjelasan resmi bahwa kedua jenis kunci tersebut tidak dapat digunakan secara bergantian
-
Halaman evaluasi Vals AI: Hasil evaluasi pihak ketiga
- Tautan:
vals.ai/models/minimax_MiniMax-M3.1-flash - Keterangan: Peringkat Vals Index serta kelebihan dan kekurangannya
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman beranda APIYI di apiyi.com. Materi integrasi lainnya tersedia di pusat dokumentasi docs.apiyi.com.