Autorenhinweis: Dieser praktische Leitfaden erklärt, wie MiniMax M3.1 Flash abgerechnet wird, wie Sie Kosten sparen und ob sich die nutzungsbasierte API oder ein M-Plan-Abonnement besser für Sie eignet.
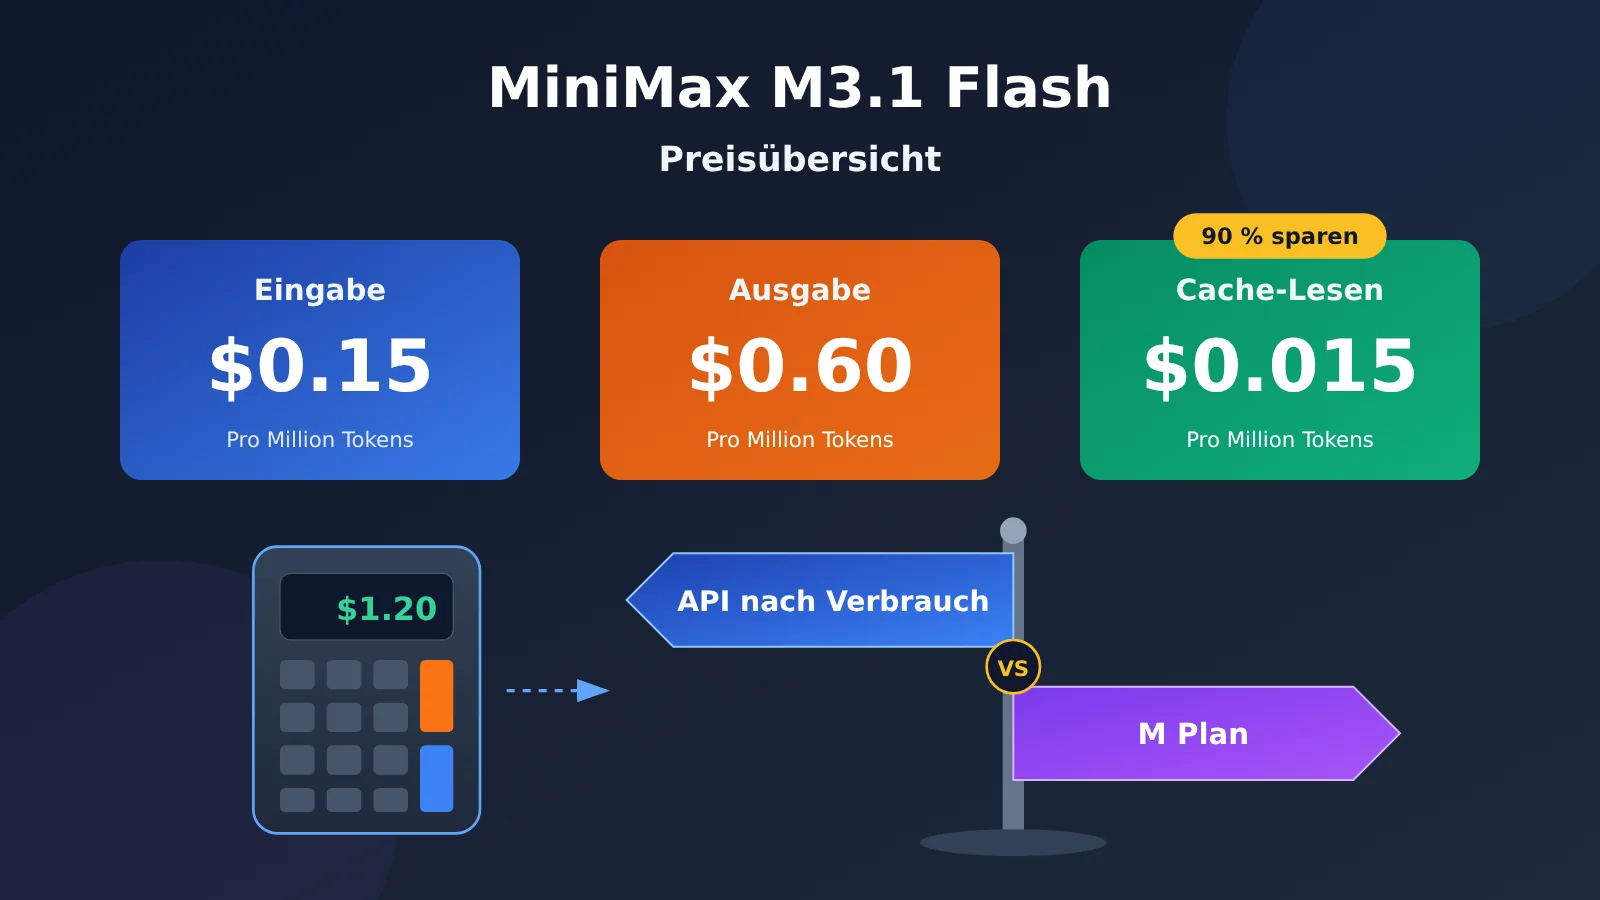
Das Wichtigste vorweg: MiniMax M3.1 Flash kostet pro Million Token 0,15 $ für Eingaben, 0,60 $ für Ausgaben und 0,015 $ für das Lesen aus dem Cache. Der größte Teil der Rechnung entfällt meist auf Ausgaben (einschließlich der Denkprozesse des Modells). Sparen können Sie also auf zwei Arten: Stellen Sie erstens eine niedrigere Effort-Stufe ein und platzieren Sie zweitens gleichbleibende Inhalte am Anfang der Anfrage, damit sie aus dem Cache abgerufen werden können.
Dies ist keine weitere Meldung zur Veröffentlichung. Darüber haben wir bereits berichtet. Hier geht es ausschließlich um die Kosten: Wie hoch sind die drei Preise pro Einheit? Was kostet ungefähr ein Gespräch oder eine Agent-Aufgabe? Wo genau ist M3.1 günstiger als M3? Und wann lohnt sich nutzungsbasierte Abrechnung, wann ein Monatsabo?
Der Mehrwert dieses Artikels: Danach können Sie Ihre monatlichen Kosten für MiniMax M3.1 Flash selbst einschätzen, die zwei häufigsten Abrechnungsfallen vermeiden und die passende Zahlungsoption auswählen.
Die wichtigsten Preisdetails zu MiniMax M3.1 Flash
Zunächst ein Begriff: Token ist die kleinste Einheit, nach der das Modell abgerechnet wird. Man kann sich Tokens als „Textbausteine“ vorstellen. Laut offizieller Umrechnung entsprechen etwa 750 englische Wörter ungefähr 1.000 Tokens. Auf der Preisseite gibt MiniMax keine Umrechnung für Chinesisch an. Maßgeblich ist daher der tatsächliche Verbrauch auf der Abrechnung in der Konsole.
Die folgende Tabelle enthält alle Preise für MiniMax M3.1 Flash. Die Angaben stammen von der offiziellen Preisseite von MiniMax und sind dort als Festpreise ausgewiesen:
| Abrechnungsposten | Preis (pro Million Tokens) | Einfach erklärt | Typische Inhalte |
|---|---|---|---|
| Eingabe | $0,15 | Alle Inhalte, die du an das Modell sendest | System-Eingabeaufforderung, Chatverlauf, hochgeladene Dokumente, Bilder und Videos |
| Ausgabe | $0,60 | Alle Inhalte, die das Modell zurückgibt, einschließlich des Denkprozesses | Endgültige Antwort, Denkprozess (Reasoning) |
| Cache-Lesezugriff | $0,015 | Der Teil der Eingabe, der sich mit früheren Anfragen überschneidet und im Cache gefunden wird | Gleichbleibende System-Eingabeaufforderungen, wiederholt referenzierte längere Dokumente |
| Zusatz: web_search | $0,01/Aufruf | Serverseitiges Suchwerkzeug mit Internetzugriff, Abrechnung pro Aufruf | Suchaufrufe durch einen Agenten |
Zwei Punkte solltest du dir merken. Erstens ist der Preis für Ausgaben viermal so hoch wie der für Eingaben. Deshalb wirkt sich „wie viel das Modell sagt“ stärker auf die Rechnung aus als „wie viel du sendest“. Zweitens kostet ein Cache-Lesezugriff nur ein Zehntel des Eingabepreises. Für den Teil der Eingabe, der im Cache gefunden wird, sparst du also 90 %.
So funktioniert die Abrechnung von MiniMax M3.1 Flash
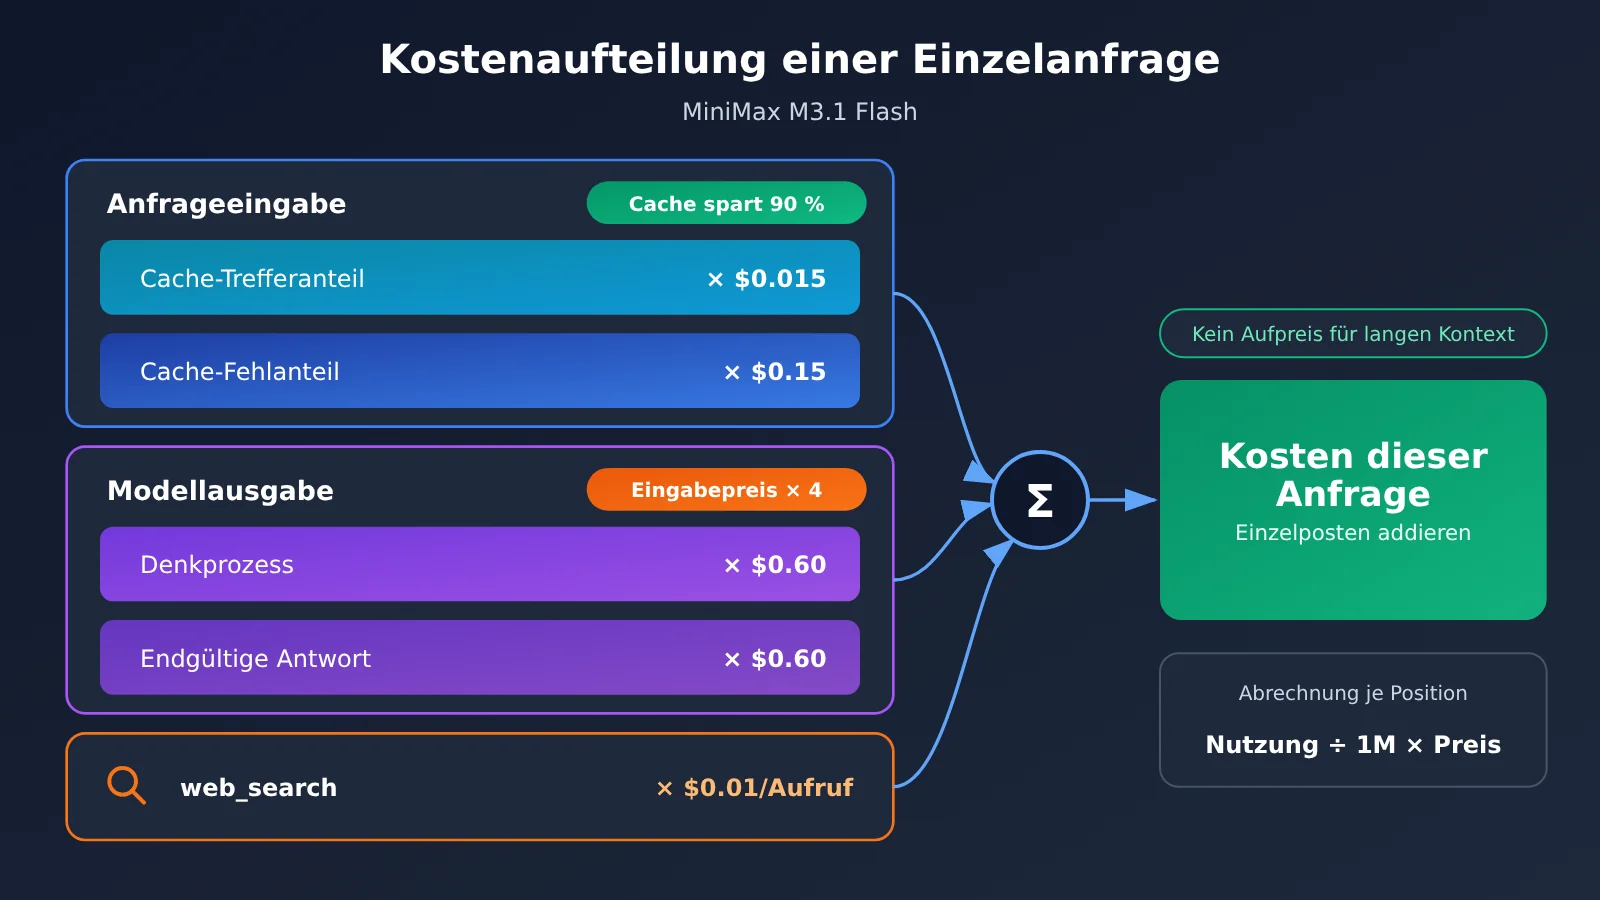
Die offizielle Berechnung ist ganz einfach: Kosten = Verbrauch ÷ 1.000.000 × Preis. Die einzelnen Abrechnungsposten werden jeweils separat berechnet und anschließend addiert. Der Gesamtbetrag wird vom Kontoguthaben abgezogen.
Die Rechnung für eine Anfrage besteht aus drei Teilen: Eingabe im Cache × $0,015, nicht im Cache gefundene Eingabe × $0,15 und Ausgabe (Antwort + Denkprozess) × $0,60. Dazu kommen die Anzahl der Suchaufrufe × $0,01.
Das Kontextfenster von MiniMax M3.1 Flash umfasst 1.000.000 Tokens. Das Kontextfenster bezeichnet die maximale Menge an Inhalten, die das Modell in einem Durchgang „sehen“ kann. Laut offizieller Preisseite gibt es keinen Aufpreis für lange Kontexte: Ob du 100.000 oder 800.000 Tokens eingibst, der Preis pro Token bleibt gleich.
MiniMax M3.1 Flash: Preise durchgerechnet – 3 Beispiele
Die Token-Zahlen in den folgenden drei Beispielen sind zur Veranschaulichung der Berechnung angenommen und stammen nicht aus Messungen. Sie können sie durch Ihre eigenen Werte ersetzen und genauso rechnen.
Beispiel 1: Ein normales Gespräch
Annahme: 2.000 Eingabe-Tokens (kein Cache-Treffer), 1.500 Ausgabe-Tokens (einschließlich Thinking).
- Eingabe: 2.000 ÷ 1.000.000 × $0.15 = $0.0003
- Ausgabe: 1.500 ÷ 1.000.000 × $0.60 = $0.0009
- Gesamt: $0.0003 + $0.0009 = $0.0012
Gegenprobe: Bei 1.000 solchen Gesprächen beträgt der Verbrauch 2 Millionen Eingabe- und 1,5 Millionen Ausgabe-Tokens. 2 × $0.15 + 1.5 × $0.60 = $0.30 + $0.90 = $1.20 – das stimmt mit $0.0012 × 1.000 überein.
Beispiel 2: Eine Agent-Aufgabe mit mehreren Runden
Ein Agent ist ein Modell, das selbstständig Arbeitsschritte aufteilt, Tools aufruft und die Aufgabe in mehreren Runden erledigt. Dabei wird der bisherige Kontext in jeder Runde erneut mitgesendet. Deshalb fällt die Eingabemenge groß aus, und der Cache macht sich besonders deutlich bemerkbar.
Annahme: insgesamt 20 Runden mit jeweils 30.000 Eingabe-Tokens. Davon werden 25.000 aus dem Cache gelesen, 5.000 sind neue Inhalte. Pro Runde kommen 2.000 Ausgabe-Tokens hinzu.
- Cache-Lesezugriffe: 25.000 × 20 = 500.000 Tokens, 0.5 × $0.015 = $0.0075
- Neue Eingaben: 5.000 × 20 = 100.000 Tokens, 0.1 × $0.15 = $0.015
- Ausgabe: 2.000 × 20 = 40.000 Tokens, 0.04 × $0.60 = $0.024
- Gesamt: $0.0075 + $0.015 + $0.024 = $0.0465
Zum Vergleich: Ohne Cache-Treffer würden 600.000 Eingabe-Tokens 0.6 × $0.15 = $0.09 kosten. Zusammen mit den Ausgabekosten von $0.024 wären das insgesamt $0.114. Durch den Cache spart diese Aufgabe $0.114 − $0.0465 = $0.0675, also etwa 59 %.
Beispiel 3: 1.000 Aufrufe am Tag
Annahme: Jeder Aufruf enthält eine feste System-Eingabeaufforderung mit 1.000 Tokens (Cache-Treffer), 500 Tokens mit neuen Inhalten und 1.000 Ausgabe-Tokens.
- Cache-Lesezugriffe: 1.000 × 1.000 = 1 Million Tokens, 1 × $0.015 = $0.015
- Neue Eingaben: 500 × 1.000 = 500.000 Tokens, 0.5 × $0.15 = $0.075
- Ausgabe: 1.000 × 1.000 = 1 Million Tokens, 1 × $0.60 = $0.60
- Gesamt pro Tag: $0.015 + $0.075 + $0.60 = $0.69; bei 30 Tagen etwa $20.70 pro Monat
Bei einem höheren effort steigt die Ausgabe auf 3.000 Tokens pro Aufruf – auch das ist nur eine Annahme. Die Ausgabekosten steigen dann auf 3 × $0.60 = $1.80, sodass sich die Gesamtkosten pro Tag auf $1.89 belaufen. Eingabe und Cache bleiben unverändert, trotzdem ist die Rechnung fast 2,7-mal so hoch wie zuvor ($1.89 ÷ $0.69 ≈ 2.74). Das zeigt: Bei Aufgaben in großer Stückzahl macht die Ausgabe den größten Teil der Kosten aus.
🚀 Tipp für den Einstieg: Testen Sie zunächst eine kleine Menge echter Daten und notieren Sie die durchschnittliche Eingabemenge, die Cache-Treffer und die Ausgabemenge. Mit diesen Werten lässt sich die Monatsgebühr anhand der obigen Formel deutlich genauer schätzen als nach Gefühl. Wenn Sie außerdem die Kosten von MiniMax-M3, Claude und anderen Modellen vergleichen möchten, können Sie bei APIYI unter apiyi.com mit demselben API-Schlüssel zwischen den Modellen wechseln und sie testen.
Die zwei häufigsten Kostenfallen bei MiniMax M3.1 Flash
Falle 1: Das Denken lässt sich nicht abschalten – die effort-Stufe bestimmt die Kosten
effort ist ein Parameter für die „Denktiefe“: Je höher die Stufe, desto mehr denkt das Modell nach. MiniMax M3.1 Flash unterscheidet sich in einem wichtigen Punkt von vielen anderen Modellen: Das Denken lässt sich nicht abschalten. Laut offizieller Dokumentation führt die Angabe von „thinking disabled“ oder „effort none“ direkt zu einem 400-Fehler. Die Fehlermeldung lautet: model „MiniMax-M3.1-Flash“ requires adaptive thinking.
Die Denkinhalte werden als Ausgabetokens abgerechnet. Außerdem gilt: Wenn Sie effort nicht angeben, ist der Standardwert max – also die teuerste Stufe. Wenn Sie Kosten sparen möchten, müssen Sie die Stufe aktiv herabsetzen. Je nach Protokoll unterscheidet sich der Feldname: Das Anthropic-Protokoll verwendet output_config.effort, das OpenAI-Protokoll reasoning_effort und das Responses-Protokoll reasoning.effort.
| effort-Stufe | Umfang des Denkens | Auswirkung auf die Kosten | Empfohlene Einsatzbereiche |
|---|---|---|---|
| low | Am geringsten | Wenigste Ausgabetokens, günstigste und niedrigste Latenz | Klassifizierung, Extraktion, Umschreiben, Formatkonvertierung |
| medium | Gering | Eher günstig | Alltagsfragen, einfache Zusammenfassungen |
| high | Größer | Eher teuer | Allgemeine Programmieraufgaben, mehrstufiges Schlussfolgern |
| xhigh | Sehr groß | Teuer | Komplexe Analysen, Fehlersuche bei schwierigen Problemen |
| max (Standard) | Am größten | Am teuersten, höchste Latenz | Wirklich schwierige Aufgaben, Agenten mit langen Verarbeitungsketten |
Der Anbieter hat nicht veröffentlicht, wie viele zusätzliche Tokens die einzelnen Stufen durchschnittlich verbrauchen. Die Tabelle zeigt daher nur die relativen Unterschiede. Wichtig ist auch: Bei den offiziellen Benchmarks und der unabhängigen Vals-Bewertung wurden hohe Stufen verwendet – Vals nennt ausdrücklich effort max. Wie stark die Leistung beim Herabsetzen der Stufe abnimmt, ist bislang nicht öffentlich bekannt. Testen Sie zunächst low oder medium mit einer Reihe von Beispielen und erhöhen Sie die Stufe, wenn die Ergebnisse nicht gut genug sind.
Eine weitere Änderung: Denkinhalte werden jetzt separat zurückgegeben. Im OpenAI-kompatiblen Protokoll stehen sie im Feld reasoning_content; content enthält nur die endgültige Antwort. Wenn Sie bisher Denkinhalte aus den Denk-Tags der M3-Ausgabe extrahiert haben, müssen Sie die entsprechende Parsing-Logik anpassen.
Falle 2: Das Lesen aus dem Cache kostet nur ein Zehntel des Eingabepreises – die Reihenfolge der Inhalte ist entscheidend
Beim Caching erkennt das System Inhalte in einer Anfrage wieder, die exakt mit vorherigen Inhalten übereinstimmen, und berechnet für sie den günstigeren Preis für das Lesen aus dem Cache. Mit $0.015 ist dieser Preis 90 % niedriger als der reguläre Preis von $0.15.
Damit möglichst viele Inhalte aus dem Cache abgerufen werden, sollten Sie den Anfang der Anfrage unverändert lassen:
- Platzieren Sie die feste System-Eingabeaufforderung ganz am Anfang. Fügen Sie darin keine Zeitstempel, Zufallszahlen oder Benutzernamen ein.
- Fügen Sie häufig verwendete Inhalte wie lange Dokumente, Wissensdatenbanken und Tool-Beschreibungen direkt nach der System-Eingabeaufforderung ein.
- Platzieren Sie veränderliche Inhalte wie die Benutzerfrage und die Daten der aktuellen Runde ganz am Ende.
- Ändern oder löschen Sie den bisherigen Gesprächsverlauf in mehrstufigen Dialogen nicht beliebig. Wenn Sie einen Abschnitt in der Mitte ändern, lassen sich die nachfolgenden Inhalte nur schwer aus dem Cache abrufen.
In den verfügbaren Unterlagen nennt der Anbieter nur den Preis für das Lesen aus dem Cache. Die genauen Cache-Regeln und weitere abrechnungsrelevante Angaben finden Sie auf der offiziellen Preisseite von MiniMax.
MiniMax M3.1 Flash und M3 im Preisvergleich
Viele fragen sich, wie viel günstiger MiniMax M3.1 Flash im Vergleich zum Vorgänger M3 ist. Die folgende Tabelle basiert auf der offiziellen Preisseite. Für M3 gilt der dauerhaft um 50 % reduzierte Standardtarif (pro Million Tokens):
| Modell | Eingabe | Ausgabe | Cache-Lesezugriffe | Aufpreis für langen Kontext |
|---|---|---|---|---|
| MiniMax-M3.1-Flash | 0,15 $ | 0,60 $ | 0,015 $ | keiner |
| MiniMax-M3 (Eingabe ≤512K) | 0,30 $ | 1,20 $ | 0,06 $ | — |
| MiniMax-M3 (Eingabe >512K) | 0,60 $ | 2,40 $ | 0,12 $ | doppelter Preis |
| MiniMax-M3 Priority-Tarif | Standardtarif × 1,5 | Standardtarif × 1,5 | — | — |
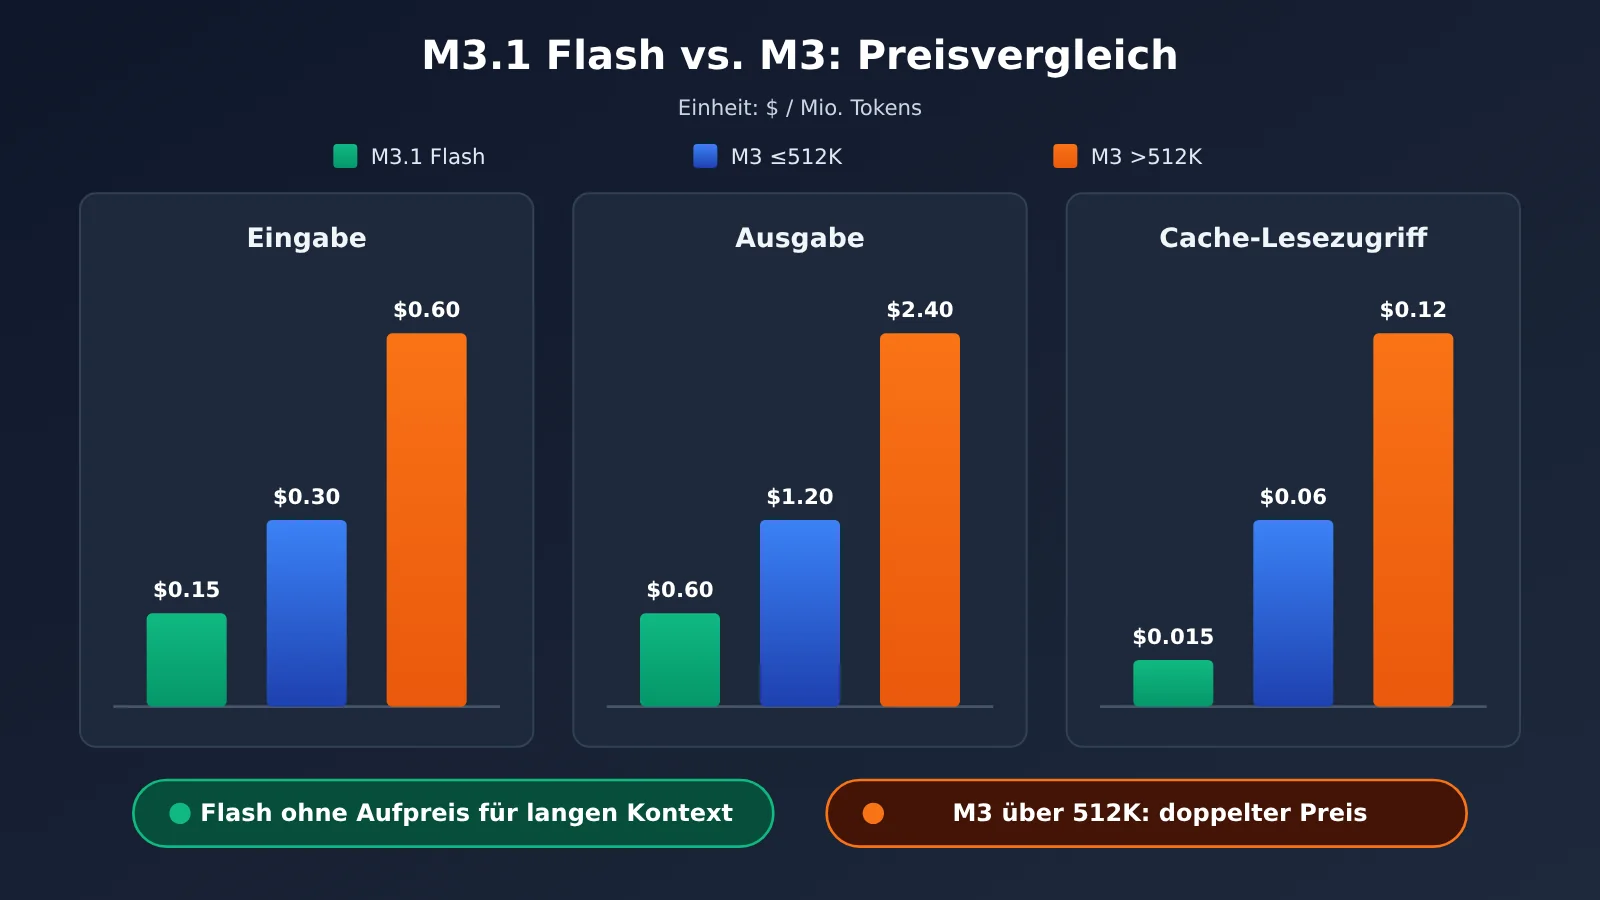
Bildunterschrift: Die Preisdaten stammen von der offiziellen MiniMax-Preisseite. Die tatsächliche Abrechnung auf Drittanbieterplattformen richtet sich nach deren jeweiligen Preisangaben. Wenn Sie beispielsweise die MiniMax-Modelle über APIYI unter apiyi.com nutzen, gelten die dort angezeigten Preise.
Aus der Tabelle lassen sich drei Dinge ablesen:
- Bei normalen Kontextlängen kostet die Ein- und Ausgabe mit Flash jeweils halb so viel wie mit M3. Cache-Lesezugriffe kosten nur ein Viertel (0,015 $ gegenüber 0,06 $). Zur Überprüfung anhand von Anwendungsfall 3: Bei gleicher Nutzung kostet M3 1 × 0,06 $ + 0,5 × 0,30 $ + 1 × 1,20 $ = 1,41 $ pro Tag. Mit Flash sind es 0,69 $ pro Tag – also etwa 49 % davon.
- Bei sehr langen Kontexten verdoppelt sich der M3-Preis, sobald die Eingabe 512K überschreitet. Bei Flash gibt es keinen Aufpreis; Ein- und Ausgabe kosten jeweils nur ein Viertel des M3-Preises.
- Beim Caching ist Flash noch günstiger: Cache-Lesezugriffe kosten bei Flash ein Zehntel des Eingabepreises, bei M3 ein Fünftel. Je stärker ein Szenario also auf Caching angewiesen ist, desto größer ist der Preisvorteil von Flash.
Warum spricht der Hersteller von „einem Drittel der Kosten“, obwohl der Stückpreis nur halb so hoch ist?
Das ist kein Widerspruch. Ein halbierter Stückpreis bezieht sich auf die Kosten pro Token. Die Angaben „ein Drittel der Kosten“ (im offiziellen X-Beitrag) und „70 % niedrigere Gesamtkosten für Agent-Aufgaben“ (im offiziellen Blog) beziehen sich dagegen auf die Gesamtkosten für die Erledigung einer Aufgabe. Beides sind Angaben des Herstellers.
Gesamtkosten pro Aufgabe = Stückpreis × Anzahl der verbrauchten Tokens. Wenn das neue Modell dieselbe Aufgabe mit weniger Runden oder Tokens erledigt, können die Aufgabenkosten stärker sinken als der Stückpreis. Der Hersteller hat die konkrete Berechnung für das Drittel jedoch nicht veröffentlicht. Außerdem stimmen die Zahlen für Automation-Bench in der offiziellen Kostengrafik (62,8) nicht mit denen in der Tabelle (62,2) überein. Für die Budgetplanung empfiehlt es sich daher, mit den Stückpreisen selbst zu rechnen und die Angabe „ein Drittel“ als Richtwert zu betrachten.
MiniMax M3.1 Flash: nutzungsbasierte API oder M-Plan-Abo?
Für MiniMax M3.1 Flash gibt es zwei Bezahlmodelle. Bei der nutzungsbasierten API zahlen Sie genau das, was Sie verbrauchen; die Kosten werden vom Kontoguthaben abgezogen. Der M Plan ist ein Monatsabo mit den drei Stufen Go, Explore und Build. Alle enthalten dasselbe Textmodell: M3.1 Flash. Laut offizieller Dokumentation bietet Explore das Dreifache und Build das 7,5-Fache des Go-Kontingents. Explore und Build beinhalten außerdem das Videomodell H3. Die aktuellen Monatspreise finden Sie auf der offiziellen Website. Dort gibt es auch eine Ankündigung zu einem Rabatt im ersten Monat bei monatlicher Zahlung. Die genauen Aktionsbedingungen finden Sie ebenfalls auf der offiziellen Website.
| Entscheidungskriterium | Nutzungsbasierte API | M-Plan-Abo |
|---|---|---|
| Nutzungsumfang | Unregelmäßige oder insgesamt geringe Nutzung | Häufige tägliche Nutzung und Wunsch nach festen monatlichen Kosten |
| Einsatzbereich | Backend des eigenen Produkts, Batch-Skripte, Datenverarbeitung | Selbst programmieren, KI-Unterstützung beim täglichen Coden |
| Verwendete Tools | Eigene Programme, die direkt die API-Adresse aufrufen | MiniMax Code, Claude Code, Codex, Cursor, OpenCode |
| Videobedarf | Wird nach Bedarf separat abgerechnet | H3-Videomodell in den Stufen Explore und Build enthalten |
| Kostenkontrolle | Präzise Kontrolle pro Anfrage; Optimierung mit effort und Caching |
Keine Token-Berechnung nötig; die Regeln für Nutzung über das Kontingent hinaus finden Sie auf der offiziellen Website |
Kurz gesagt: Für Programme eignet sich die nutzungsbasierte API, für Menschen das Abo. Wenn Sie hauptsächlich mit Tools wie Claude Code oder Cursor programmieren, können Sie den Abo-Schlüssel des M Plans direkt einbinden. Entwickeln Sie dagegen ein Produkt oder führen Batch-Aufgaben aus, ist die nutzungsbasierte API in Verbindung mit der Kostenberechnung in diesem Artikel transparenter.
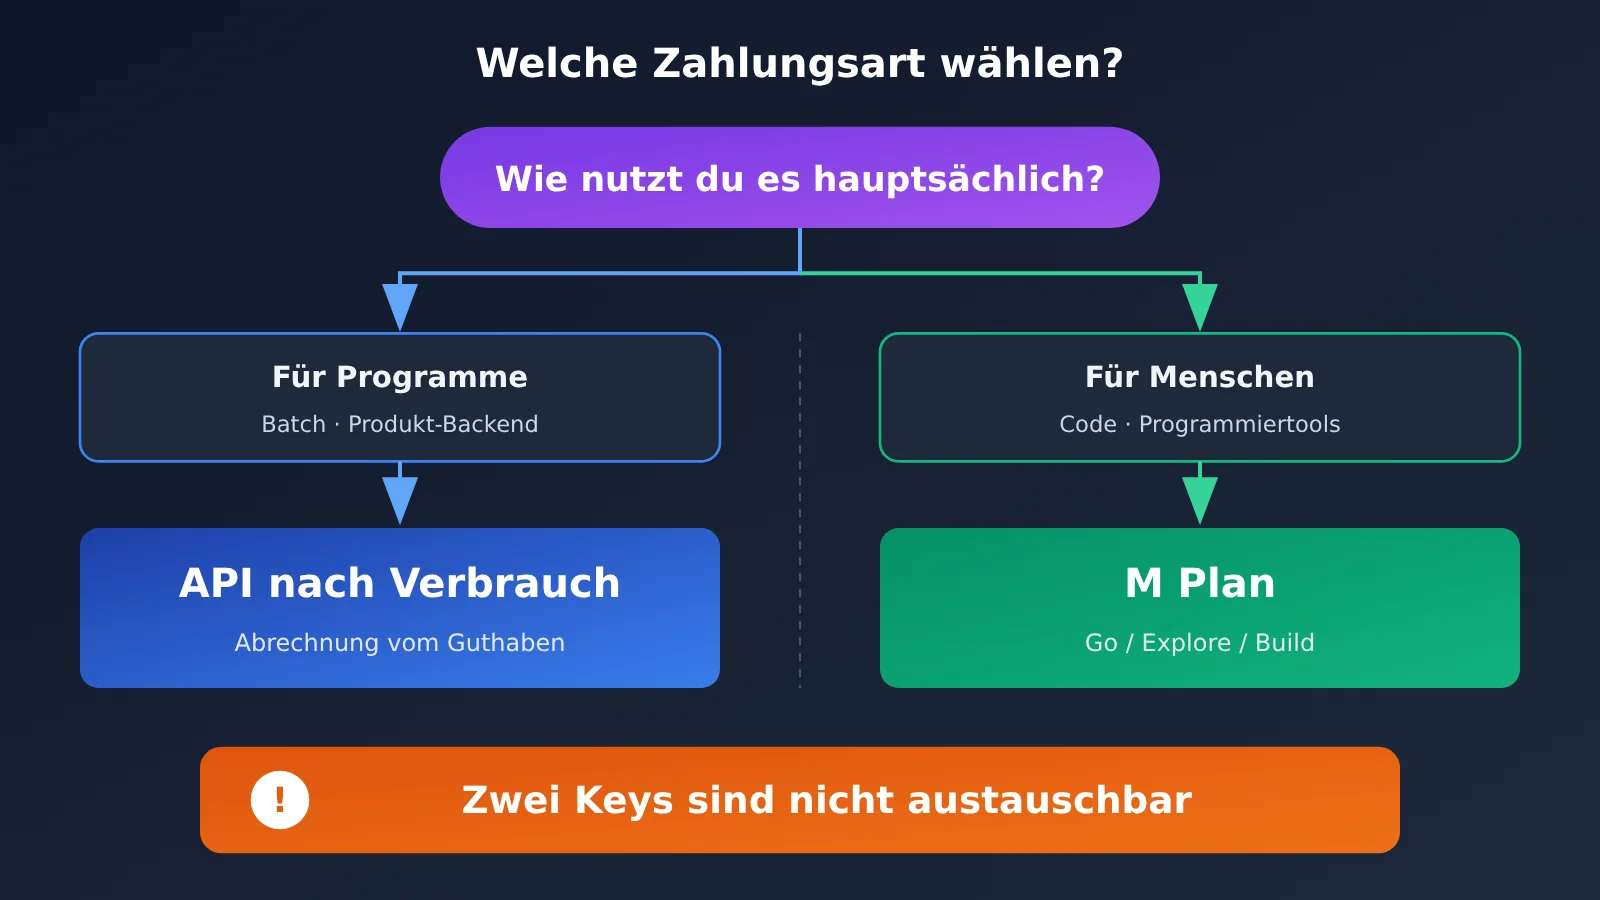
⚠️ Wichtiger Hinweis: Die beiden Schlüssel sind nicht austauschbar. In den offiziellen FAQ wird ausdrücklich darauf hingewiesen, dass der API-Schlüssel für die nutzungsbasierte Abrechnung und der Abo-Schlüssel des M Plans zwei verschiedene Schlüssel sind, die an unterschiedlichen Stellen im Backend abgerufen werden. Wenn Sie den Abo-Schlüssel für eine nutzungsbasierte API verwenden – oder umgekehrt –, funktioniert es nicht. Prüfen Sie deshalb vor der Einrichtung, welchen Schlüssel Sie kopiert haben. Der alte Modellname MiniMax-M3.1-Flash-Preview wurde inzwischen eingestellt. Anfragen mit diesem Namen werden jetzt von MiniMax-M3.1-Flash verarbeitet.
Wann Sie MiniMax M3.1 Flash nicht einsetzen sollten
Günstig heißt nicht, dass sich jede Aufgabe dafür eignet. In den folgenden Fällen sollten Sie besser nicht umsteigen – oder zunächst nur einen Teil Ihrer Aufgaben verlagern.
1. Agenten mit langen Abläufen und Aufgaben mit Terminalbefehlen. Laut der Drittanbieter-Evaluierung von Vals AI erreicht M3.1 Flash 25,25 % auf Terminal-Bench 4.0 und belegt damit Platz 22 von 51 Modellen. Auf HLAB-Vals-1.1 sind es 7,50 % und Platz 17 von 23 Modellen. Der vom Hersteller selbst angegebene Wert für Terminal Bench 4.0 liegt bei 38,1 und damit 13,7 Punkte unter dem Wert von Claude Opus 5 (51,8).
2. Große Code-Refactorings. Laut Hersteller erreicht das Modell 23,0 im SWE Refactor Bench; Claude Opus 5 kommt auf 31,0.
3. Wenn Sie das Reasoning deaktivieren und eine extrem niedrige Latenz erreichen möchten. Das Reasoning lässt sich nicht vollständig deaktivieren; die niedrigste verfügbare Stufe ist „low“.
4. Wenn Ihre bestehende Integration auf das Parsen von Reasoning-Tags angewiesen ist. Bei der Migration von M3 müssen Sie zunächst die Parsing-Logik anpassen, sonst erhalten Sie die Reasoning-Inhalte nicht.
5. Wenn Sie das Modell sofort über APIYI aufrufen möchten. Zum Zeitpunkt der Veröffentlichung ist MiniMax-M3.1-Flash noch nicht auf der Preisseite von APIYI aufgeführt. Ob das Modell verfügbar ist, entnehmen Sie bitte der Preisseite.
Ein Vergleich mit Claude lohnt sich ebenfalls. In der offiziellen Vergleichstabelle wird Claude Opus 5 als Vergleichsmodell herangezogen, nicht Opus 5.5. Claude Opus 5.5 ist nach wie vor das leistungsstärkste Flaggschiffmodell von Anthropic. MiniMax hat es nicht Punkt für Punkt mit seinem Modell verglichen. Daher lässt sich nicht behaupten, Flash habe Opus 5.5 eingeholt oder übertroffen. Im Gesamtranking belegt M3.1 Flash laut Vals Index mit 53,78 % Platz 15 von 22 Modellen und Platz 5 unter den Modellen mit Open Weights.
| Modell | Eingabe / Ausgabe (pro Million Tokens) | Benchmark-Ergebnisse | Besonders geeignet für | Zugang |
|---|---|---|---|---|
| MiniMax-M3.1-Flash | $0,15 / $0,60 | Herstellerangaben + Vals-Evaluierung | Massenverarbeitung, alltägliche Programmieraufgaben, Tool-Aufrufe | Offizieller MiniMax-Zugang; Verfügbarkeit bei APIYI laut Preisseite |
| claude-opus-5 | $5 / $25 (offizieller Preis) | Vergleichsmodell in der offiziellen Vergleichstabelle | Komplexe Aufgaben | APIYI apiyi.com usw. |
| claude-opus-5-5 | $4 / $20 (offizieller Preis) | Vom Hersteller nicht zum Vergleich herangezogen | Anspruchsvolle Planung, Architekturdesign, große Refactorings | APIYI apiyi.com usw. |
Beim Preis pro Token kostet die Ausgabe mit Opus 5.5 etwa 33-mal so viel wie mit Flash ($20 ÷ $0,60 ≈ 33,3), die Eingabe etwa 27-mal so viel ($4 ÷ $0,15 ≈ 26,7). Bei diesem großen Preisunterschied ist eine Aufgabenteilung sinnvoller, als sich für nur eines der Modelle zu entscheiden.
So kombinierst du MiniMax und Claude Opus 5.5 auf APIYI
Seit dem 22.10.2026 sind auf der Preisseite von APIYI folgende MiniMax-Modelle direkt verfügbar: MiniMax-M3 (unterstützt sowohl das OpenAI- als auch das Anthropic-Schnittstellenformat und ist in der Gruppe ClaudeCode verfügbar), MiniMax-M2.7, MiniMax-M2.7-highspeed, MiniMax-M2.5, MiniMax-M2.5-lightning sowie das Videomodell MiniMax-H3. MiniMax-M3.1-Flash steht derzeit noch nicht auf der Preisseite. Ob sich das Modell aufrufen lässt, entnimmst du bitte der Preisseite von APIYI.
Auf der Claude-Seite lassen sich claude-opus-5-5 und claude-opus-5 direkt aufrufen. Der Vorteil von APIYI: Mit einem einzigen API-Schlüssel kannst du sowohl Modelle der MiniMax-Reihe als auch Claude Opus 5.5 nutzen. Separate Registrierungen und Aufladungen sind nicht nötig. Eine sinnvolle Aufteilung sieht so aus:
- Günstige Aufgaben in großen Mengen an MiniMax übertragen: Datenbereinigung, Inhaltsklassifizierung, umfangreiche Überarbeitungen und einfache Codegenerierung lassen sich mit einem preiswerten Modell wie MiniMax-M3 erledigen – in Kombination mit Caching und einer niedrigeren Denkstufe.
- Anspruchsvolle Planung und Refactorings Opus 5.5 überlassen: Für Systemarchitektur, umfangreiche Refactorings über mehrere Module hinweg und die übergreifende Planung komplexer Aufgaben eignet sich
claude-opus-5-5. - Erst planen, dann ausführen: Lass Opus 5.5 einen Plan erstellen und die Aufgaben aufteilen. Anschließend kann MiniMax die kleineren Teilaufgaben in großen Mengen ausführen – so bleiben Qualität und Kosten im Gleichgewicht.
💡 Tipp zur Auswahl: Wenn du noch nicht sicher bist, welche Aufgaben ein günstigeres Modell übernehmen kann, führe mit denselben Beispielen auf APIYI unter apiyi.com jeweils MiniMax-M3 und
claude-opus-5-5aus. Vergleiche die Ergebnisse und Kosten und lege erst danach das Verhältnis der Aufgabenverteilung fest.
Häufig gestellte Fragen (FAQ)
F1: Was kostet MiniMax M3.1 Flash genau?
Laut offizieller Preisseite kostet eine Million Tokens 0,15 $ für Eingaben, 0,60 $ für Ausgaben und 0,015 $ für Cache-Lesezugriffe. Die Preise sind Festpreise, auch bei langen Kontexten. Die serverseitige Websuche `web_search` kostet zusätzlich 0,01 $ pro Suchanfrage.
F2: Warum erzeugt das Modell so viele Ausgabe-Tokens, obwohl ich nur eine Frage gestellt habe?
Weil auch der Denkprozess als Ausgabe zählt. Wenn du keinen `effort`-Wert übergibst, wird standardmäßig die Stufe `max` verwendet. Der Denkprozess lässt sich nicht deaktivieren. Um die Ausgabe zu reduzieren, kannst du `effort` auf `low` oder `medium` setzen.
F3: Wie viel günstiger ist MiniMax M3.1 Flash als M3?
Bei den Einzelpreisen kosten Eingaben und Ausgaben halb so viel wie beim Standardtarif von M3, Cache-Lesezugriffe ein Viertel. Bei M3 verdoppelt sich der Preis für Eingaben über 512K Tokens, während bei Flash kein Aufpreis anfällt. Die offizielle Angabe, die „Kosten lägen bei einem Drittel“, basiert auf internen Berechnungen pro Aufgabe. Die Berechnungsmethode wurde nicht veröffentlicht.
F4: Kann ich einen nutzungsbasierten API-Schlüssel direkt in Claude Code für den M Plan eintragen?
Nein. Nutzungsbasierte API-Schlüssel und Abonnement-Schlüssel für den M Plan sind zwei verschiedene Schlüsseltypen. Sie werden an unterschiedlichen Stellen im Backend erstellt und sind nicht untereinander austauschbar. Wenn du ein Tool mit deinem Abonnement verbinden möchtest, musst du den Abonnement-Schlüssel kopieren.
F5: Kann ich MiniMax M3.1 Flash bereits über APIYI aufrufen?
Zum Zeitpunkt der Veröffentlichung ist MiniMax-M3.1-Flash noch nicht auf der Preisseite von APIYI aufgeführt. Ob das Modell verfügbar ist, kannst du der Preisseite entnehmen. Wir werden es so bald wie möglich hinzufügen. Derzeit kannst du auf APIYI unter apiyi.com direkt MiniMax M3 und Modelle wie claude-opus-5-5 nutzen und mit einem einzigen Schlüssel zwischen ihnen wechseln.
F6: Gibt es eine kostenlose Testmöglichkeit?
Die Drittanbieterplattform OpenRouter bietet einen kostenlosen, ratenbegrenzten Endpunkt an: `minimax/minimax-m3.1-flash:free`. Damit kannst du das Modell zunächst ausprobieren. Für den produktiven Einsatz empfiehlt es sich, die Kosten mit kleinen Datenmengen nach der in diesem Artikel beschriebenen Methode zu schätzen.
F7: Welche Schwächen hat MiniMax M3.1 Flash?
Tests von Drittanbietern zeigen, dass das Modell bei längeren Agent-Aufgaben und Terminal-Aufgaben eher schwach abschneidet: Im Vals Terminal-Bench 4.0 belegt es Platz 22 von 51 Modellen. Auch bei den vom Hersteller selbst gemeldeten Benchmarks für Refactoring-Aufgaben liegt es hinter Claude Opus 5. Außerdem hat MiniMax bisher keinen technischen Bericht dazu veröffentlicht, welche Änderungen Flash genau enthält.
F8: Was sollte ich zuerst tun, wenn ich möglichst viel sparen möchte?
Senke zuerst den standardmäßigen `effort`-Wert `max`. Platziere anschließend feste System-Eingabeaufforderungen und lange Dokumente möglichst am Anfang der Anfrage, damit sie vom Cache profitieren. Diese beiden Schritte bringen in der Regel schneller eine spürbare Ersparnis als ein Modellwechsel. Wenn du die Kosten mehrerer Modelle gleichzeitig vergleichen möchtest, kannst du sie zentral auf APIYI unter apiyi.com testen.
Die wichtigsten Punkte zu den Preisen von MiniMax M3.1 Flash
- Drei Preise pro Einheit: 0,15 $ für Eingaben, 0,60 $ für Ausgaben und 0,015 $ für das Lesen aus dem Cache – jeweils pro Million Tokens. Für lange Kontexte gibt es keinen Aufpreis.
- Der größte Kostenfaktor sind die Ausgaben: Denkprozesse werden als Ausgaben berechnet. Die standardmäßige Einstellung „max“ ist am teuersten. Um Kosten zu sparen, sollten Sie zuerst den Effort-Wert senken.
- Das Denken lässt sich nicht abschalten: Die Werte
disabledodernoneführen zu einem 400-Fehler. Die niedrigste mögliche Einstellung istlow. - Mit dem Cache sparen Sie 90 %: Platzieren Sie feste Inhalte am Anfang und variable Inhalte am Ende.
- Der Einzelpreis beträgt die Hälfte des M3-Preises: Die Angabe „ein Drittel der Kosten“ bezieht sich auf die vom Anbieter selbst gemeldeten Kosten pro Aufgabe. Das widerspricht sich nicht.
- Für Programme eignet sich die nutzungsbasierte Abrechnung, für Menschen ein Abo: Die beiden Arten von API-Schlüsseln sind nicht austauschbar. Den monatlichen Preis für den M Plan finden Sie auf der offiziellen Website.
- Die Kombination ist oft günstiger: Verwenden Sie bei APIYI einen einzigen API-Schlüssel, um MiniMax für Batch-Aufgaben und Opus 5.5 für die Planung einzusetzen.
Zusammenfassung
Die wichtigsten Punkte zu den Preisen von MiniMax M3.1 Flash:
- Richtig berechnen: Kosten = Verbrauch ÷ 1 Million × Einzelpreis. Eingaben, Cache-Lesevorgänge und Ausgaben werden getrennt berechnet und anschließend addiert.
- Kosten senken: Begrenzen Sie die ausgegebenen Denkprozesse mit einem niedrigeren Effort-Wert. Platzieren Sie feste Inhalte am Anfang, damit sie häufiger aus dem Cache abgerufen werden.
- Das passende Modell wählen: Für Programme eignet sich die nutzungsbasierte API, für Menschen der M Plan. Für Agenten mit langen Abläufen und umfangreiche Refactorings empfiehlt sich weiterhin ein leistungsfähigeres Modell.
Führen Sie zunächst einen Test mit einer kleinen Menge echter Daten durch und berechnen Sie Ihre Kosten pro Vorgang. Entscheiden Sie dann über das passende Bezahlmodell und die Aufgabenverteilung. Wenn Sie Leistung und Kosten mehrerer Modelle vergleichen möchten, können Sie über APIYI auf apiyi.com alle Modelle mit einem einzigen API-Schlüssel testen. Ob MiniMax-M3.1-Flash aufrufbar ist, entnehmen Sie bitte der Preisseite.
📚 Quellen
- Offizieller Veröffentlichungsblog von MiniMax: Geschwindigkeit, Kosten und vom Unternehmen veröffentlichte Benchmark-Ergebnisse von M3.1 Flash
- Link:
minimax.io/blog/minimax-m31f -
Hinweis: Quelle für die offiziellen Preise und die Angabe, dass die Kosten für Agent-Aufgaben um 70 % sinken
-
Offizielle Preisseite von MiniMax: Vollständige Preise für Flash und M3
- Link:
platform.minimax.io/docs/guides/pricing -
Hinweis: Abrechnungsformel, Preisstaffelung für lange Kontexte und Preise für
web_search -
Offizielle MiniMax-Dokumentation: Modellaufruf: Effort-Stufen und Regeln für den Denkmodus
- Link:
platform.minimax.io/docs/guides/text-generation -
Hinweis: Der Denkmodus lässt sich nicht deaktivieren; Feldnamen für
effortin den verschiedenen Protokollen -
Informationen zu den MiniMax-M-Plan-Abos: Die drei Stufen Go / Explore / Build
- Link:
platform.minimax.io/docs/m-plan/intro -
Hinweis: Nutzungsfaktoren, unterstützte Tools und Informationen zu den Modellen
-
Offizielle MiniMax-FAQ: Unterschiede zwischen API-Schlüssel und Abo-Schlüssel
- Link:
platform.minimax.io/docs/faq/about-apis -
Hinweis: Offizielle Erklärung, dass die beiden Schlüsseltypen nicht austauschbar sind
-
Vals-AI-Bewertungsseite: Ergebnisse einer unabhängigen Bewertung
- Link:
vals.ai/models/minimax_MiniMax-M3.1-flash - Hinweis: Platzierung im Vals Index sowie Stärken und Schwächen
Autor: Technisches Team von APIYI
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite von APIYI unter apiyi.com. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com