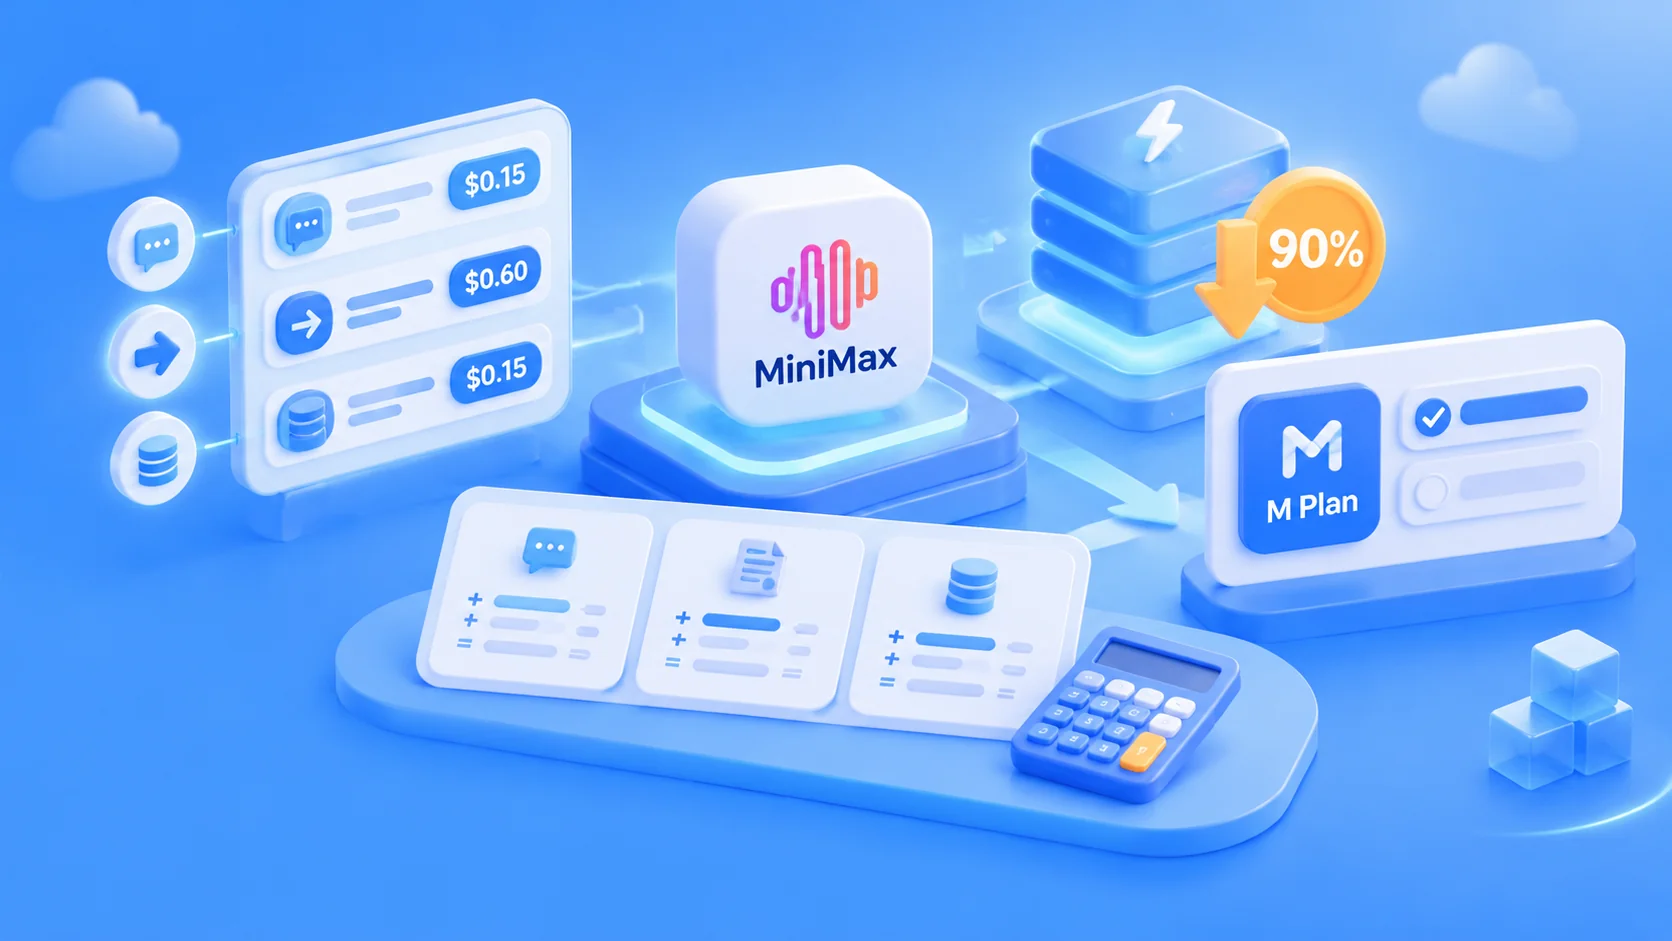
Note de l’auteur : un guide pratique pour comprendre la tarification de MiniMax M3.1 Flash, réduire les coûts et choisir entre l’API à l’usage et l’abonnement M Plan.
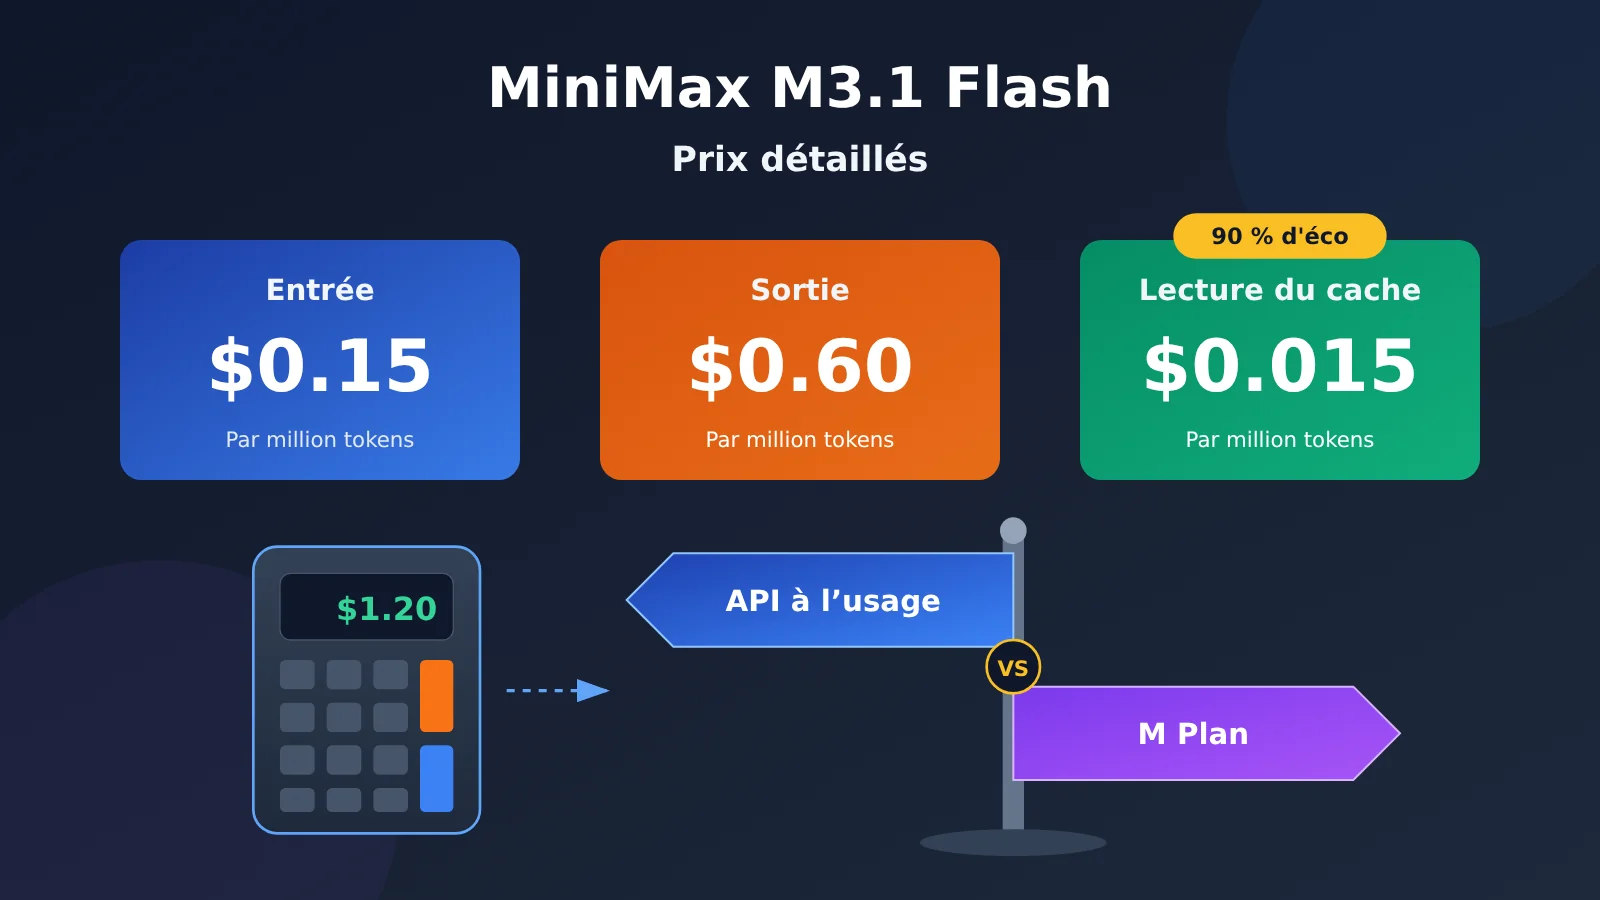
À retenir en une phrase : MiniMax M3.1 Flash coûte 0,15 $ par million de tokens en entrée, 0,60 $ en sortie et 0,015 $ pour la lecture du cache. La majeure partie de la facture vient généralement de la sortie (qui comprend le raisonnement du modèle). Pour réduire les coûts, deux solutions : diminuer le niveau d’effort ou placer le contenu fixe au début de la requête afin qu’il soit mis en cache.
Ce n’est pas un autre article sur son lancement. Nous avons déjà couvert l’annonce sur ce site. Ici, on parle uniquement de coûts : les trois tarifs unitaires, le coût approximatif d’une conversation ou d’une tâche d’agent, les économies réalisées par rapport à M3, et le choix entre le paiement à l’usage et l’abonnement mensuel.
L’essentiel : à la fin de cet article, vous saurez estimer vos dépenses mensuelles avec MiniMax M3.1 Flash, éviter les deux pièges de facturation les plus fréquents et choisir le mode de paiement qui vous convient.
Points essentiels sur le prix de MiniMax M3.1 Flash
Commençons par expliquer un terme : un token est l’unité minimale utilisée pour facturer le modèle. On peut le voir comme un « fragment de texte ». Selon la conversion officielle, environ 750 mots anglais correspondent à 1 000 tokens. La page des tarifs ne précise pas de taux de conversion pour le chinois ; pour connaître la consommation réelle, référez-vous à la facture dans la console.
Le tableau ci-dessous récapitule tous les tarifs unitaires de MiniMax M3.1 Flash, tels qu’ils sont publiés sur la page officielle de MiniMax :
| Poste de facturation | Tarif (par million de tokens) | Explication simple | Exemples de contenu |
|---|---|---|---|
| Entrée | $0.15 | Tout ce que vous envoyez au modèle | Invite système, historique de la conversation, documents, images et vidéos téléversés |
| Sortie | $0.60 | Tout ce que le modèle génère, y compris son processus de réflexion | Réponse finale, contenu de réflexion (raisonnement) |
| Lecture du cache | $0.015 | La partie de l’entrée qui a déjà été envoyée et qui est récupérée dans le cache | Invite système identique à chaque requête, longs documents cités à plusieurs reprises |
| En supplément : web_search | $0.01/par appel | Outil de recherche sur Internet côté serveur, facturé à l’appel | Recherche lancée par un agent |
Deux points sont à retenir. Premièrement, le tarif de sortie est quatre fois plus élevé que celui de l’entrée : le volume généré par le modèle a donc plus d’incidence sur la facture que le volume que vous lui envoyez. Deuxièmement, la lecture du cache ne coûte qu’un dixième du tarif d’entrée : la partie de l’entrée récupérée dans le cache permet donc d’économiser 90 %.
Comment comprendre la formule de facturation de MiniMax M3.1 Flash
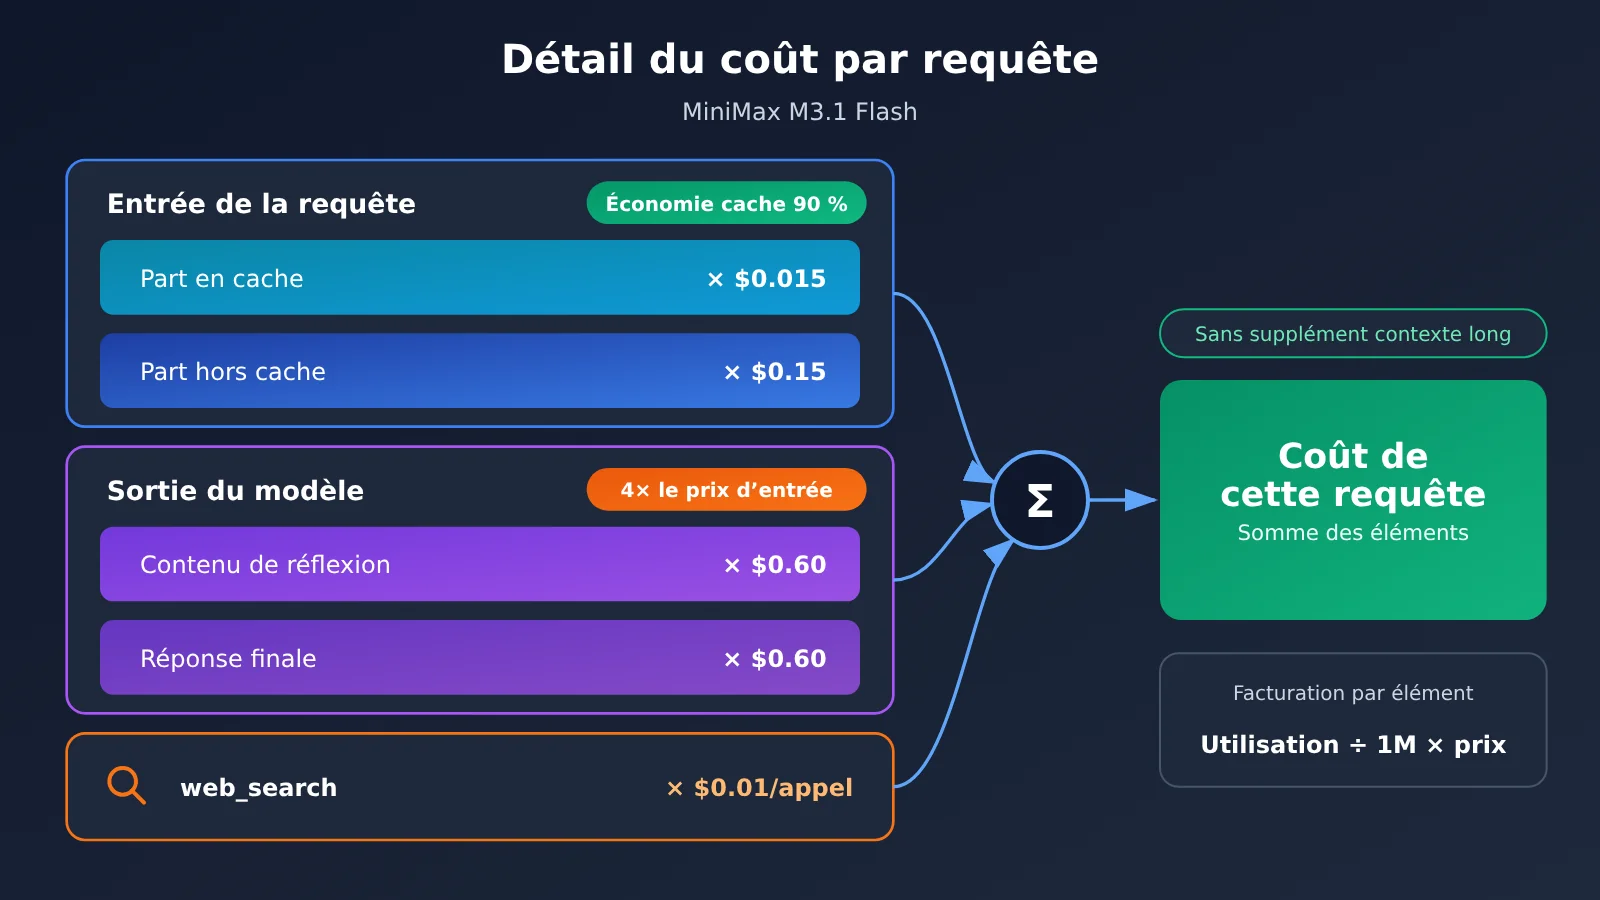
La formule officielle est simple : coût = consommation ÷ 1 000 000 × tarif. Chaque poste de facturation est calculé séparément, puis les montants sont additionnés et déduits du solde du compte.
La facture d’une requête se décompose en trois parties : les entrées récupérées dans le cache × $0.015, les entrées non récupérées dans le cache × $0.15, et la sortie (réponse + réflexion) × $0.60. Il faut ensuite ajouter le nombre de recherches × $0.01.
La fenêtre de contexte de MiniMax M3.1 Flash est de 1 000 000 tokens. Autrement dit, elle correspond à la quantité maximale de contenu que le modèle peut « lire » en une seule fois. La page officielle des tarifs précise qu’il n’y a pas de supplément pour les longs contextes : que vous envoyiez 100 000 ou 800 000 tokens, le tarif unitaire reste le même.
Calcul du prix de MiniMax M3.1 Flash : 3 exemples
Dans les trois exemples ci-dessous, le nombre de tokens est hypothétique et sert uniquement à illustrer le calcul. Il ne s’agit pas de données mesurées. Vous pouvez remplacer ces chiffres par les vôtres et appliquer la même méthode.
Exemple 1 : une conversation classique
Supposons que l’entrée contienne 2 000 tokens (sans cache) et la sortie 1 500 tokens (raisonnement compris).
- Entrée : 2 000 ÷ 1 000 000 × 0,15 $ = 0,0003 $
- Sortie : 1 500 ÷ 1 000 000 × 0,60 $ = 0,0009 $
- Total : 0,0003 $ + 0,0009 $ = 0,0012 $
Vérification : pour 1 000 conversations de ce type, le volume atteint 2 millions de tokens en entrée et 1,5 million en sortie. Le calcul donne 2 × 0,15 $ + 1,5 × 0,60 $ = 0,30 $ + 0,90 $ = 1,20 $, ce qui correspond bien à 0,0012 $ × 1 000.
Exemple 2 : une tâche d’agent (plusieurs tours)
Un agent est un modèle qui décompose une tâche en étapes, utilise des outils et boucle sur plusieurs tours pour la mener à bien. Comme il renvoie le contexte précédent à chaque tour, le volume d’entrée est important et le cache peut faire une vraie différence.
Supposons qu’il y ait 20 tours au total, avec 30 000 tokens en entrée par tour, dont 25 000 issus du cache et 5 000 nouveaux, et 2 000 tokens en sortie par tour.
- Lecture du cache : 25 000 × 20 = 500 000 tokens, soit 0,5 × 0,015 $ = 0,0075 $
- Nouvelle entrée : 5 000 × 20 = 100 000 tokens, soit 0,1 × 0,15 $ = 0,015 $
- Sortie : 2 000 × 20 = 40 000 tokens, soit 0,04 × 0,60 $ = 0,024 $
- Total : 0,0075 $ + 0,015 $ + 0,024 $ = 0,0465 $
À titre de comparaison, sans aucun cache, les 600 000 tokens en entrée coûteraient 0,6 × 0,15 $ = 0,09 $. En ajoutant les 0,024 $ de sortie, le total atteindrait 0,114 $. Le cache permet donc d’économiser 0,114 $ − 0,0465 $ = 0,0675 $, soit environ 59 %.
Exemple 3 : 1 000 appels par jour en traitement par lots
Supposons que chaque appel contienne 1 000 tokens d’invite système fixe (mis en cache), 500 tokens de nouveau contenu et 1 000 tokens en sortie.
- Lecture du cache : 1 000 × 1 000 = 1 million de tokens, soit 1 × 0,015 $ = 0,015 $
- Nouvelle entrée : 500 × 1 000 = 500 000 tokens, soit 0,5 × 0,15 $ = 0,075 $
- Sortie : 1 000 × 1 000 = 1 million de tokens, soit 1 × 0,60 $ = 0,60 $
- Total par jour : 0,015 $ + 0,075 $ + 0,60 $ = 0,69 $, soit environ 20,70 $ par mois sur 30 jours
Si vous réglez le niveau d’effort sur une valeur élevée et que chaque appel produit 3 000 tokens (toujours à titre d’hypothèse), le coût de sortie passe à 3 × 0,60 $ = 1,80 $, pour un total quotidien de 1,89 $. Le volume d’entrée et le cache restent inchangés, mais la facture est presque 2,7 fois plus élevée qu’au départ (1,89 $ ÷ 0,69 $ ≈ 2,74). Cela montre que la sortie représente la majeure partie du coût des traitements par lots.
🚀 Conseil pour démarrer rapidement : commencez par tester un petit lot de données réelles. Notez les volumes moyens d’entrée, de tokens lus dans le cache et de sortie, puis utilisez les formules ci-dessus pour estimer votre coût mensuel. Vous obtiendrez une estimation bien plus fiable qu’au jugé. Pour comparer aussi les coûts de modèles comme MiniMax-M3 ou Claude, vous pouvez tester différents modèles avec la même clé sur APIYI apiyi.com.
Les deux principaux pièges de facturation de MiniMax M3.1 Flash
Piège n° 1 : impossible de désactiver la réflexion, le niveau d’effort détermine la facture
Le paramètre effort définit la profondeur de réflexion : plus son niveau est élevé, plus le modèle réfléchit. MiniMax M3.1 Flash a une particularité qui le distingue de nombreux autres modèles : la réflexion ne peut pas être désactivée. La documentation officielle précise que demander thinking disabled ou effort none renvoie directement une erreur 400, avec le message suivant : model « MiniMax-M3.1-Flash » requires adaptive thinking.
Le contenu de réflexion est facturé comme une sortie. De plus, si vous ne précisez pas le paramètre effort, sa valeur par défaut est max, le niveau le plus coûteux. Pour réduire les coûts, la seule solution est de choisir un niveau inférieur. Le nom du champ varie selon le protocole : le protocole Anthropic utilise output_config.effort, le protocole OpenAI reasoning_effort et le protocole Responses reasoning.effort.
| Niveau d’effort | Quantité de réflexion | Impact sur la facture | Cas d’utilisation recommandé |
|---|---|---|---|
| low | Minimum | Sortie minimale, coût et latence les plus faibles | Classification, extraction, reformulation, conversion de format |
| medium | Faible | Plutôt économique | Questions-réponses courantes, résumés simples |
| high | Assez importante | Plutôt coûteux | Programmation courante, raisonnement en plusieurs étapes |
| xhigh | Importante | Coûteux | Analyses complexes, débogage de problèmes difficiles |
| max (par défaut) | Maximum | Le plus coûteux, latence la plus élevée | Tâches réellement difficiles, agents avec de longues chaînes d’étapes |
L’éditeur n’a pas publié le nombre moyen de tokens supplémentaires consommés à chaque niveau. Le tableau indique uniquement les différences relatives. Il faut aussi savoir que les évaluations de l’éditeur et les tests tiers de Vals ont été réalisés avec des niveaux élevés — Vals précise avoir utilisé effort max. Aucune donnée publique ne permet actuellement de savoir dans quelle mesure les résultats se dégradent quand on baisse le niveau. Nous vous conseillons de commencer par low ou medium sur un échantillon, puis de monter d’un cran si les résultats ne sont pas satisfaisants.
Autre changement : le contenu de réflexion est désormais renvoyé séparément. Avec le protocole compatible avec OpenAI, il se trouve dans le champ reasoning_content, tandis que le champ content ne contient que la réponse finale. Si vous extrayiez auparavant le contenu des balises de réflexion de M3, vous devrez adapter votre logique d’analyse.
Piège n° 2 : la lecture du cache ne coûte qu’un dixième du prix d’entrée, mais l’ordre du contenu compte
Le cache fonctionne ainsi : lorsque le système reconnaît dans une requête un contenu parfaitement identique à celui d’une requête précédente, il le facture au tarif de lecture du cache. À $0.015 au lieu de $0.15, c’est 90 % moins cher.
Pour augmenter les chances d’utiliser le cache, l’essentiel est de garder le début de la requête inchangé :
- Placez l’invite système fixe au début et évitez d’y insérer des horodatages, des nombres aléatoires ou des noms d’utilisateur.
- Placez juste après l’invite système les contenus réutilisés, comme les longs documents, les bases de connaissances et les descriptions des outils.
- Mettez à la fin les contenus susceptibles de changer à chaque requête, comme la question de l’utilisateur ou les données du tour en cours.
- Dans une conversation à plusieurs tours, évitez de supprimer ou de modifier l’historique précédent sans raison. Si vous modifiez une partie au milieu, il sera difficile d’obtenir des correspondances dans le contenu qui suit.
La documentation indique uniquement le tarif de lecture du cache. Pour connaître les règles précises du cache et les autres modalités de facturation, consultez la page officielle des tarifs de MiniMax.
Comparaison des prix de MiniMax M3.1 Flash et M3
On nous demande souvent quelle est la différence de prix entre MiniMax M3.1 Flash et son prédécesseur, M3. Le tableau ci-dessous reprend les tarifs officiels. Pour M3, il s’agit du tarif standard après la réduction permanente de 50 % (par million de tokens) :
| Modèle | Entrée | Sortie | Lecture du cache | Supplément pour long contexte |
|---|---|---|---|---|
| MiniMax-M3.1-Flash | $0.15 | $0.60 | $0.015 | Aucun |
| MiniMax-M3 (entrée ≤512K) | $0.30 | $1.20 | $0.06 | — |
| MiniMax-M3 (entrée >512K) | $0.60 | $2.40 | $0.12 | Tarif doublé |
| MiniMax-M3, offre Priority | Tarif standard × 1.5 | Tarif standard × 1.5 | — | — |
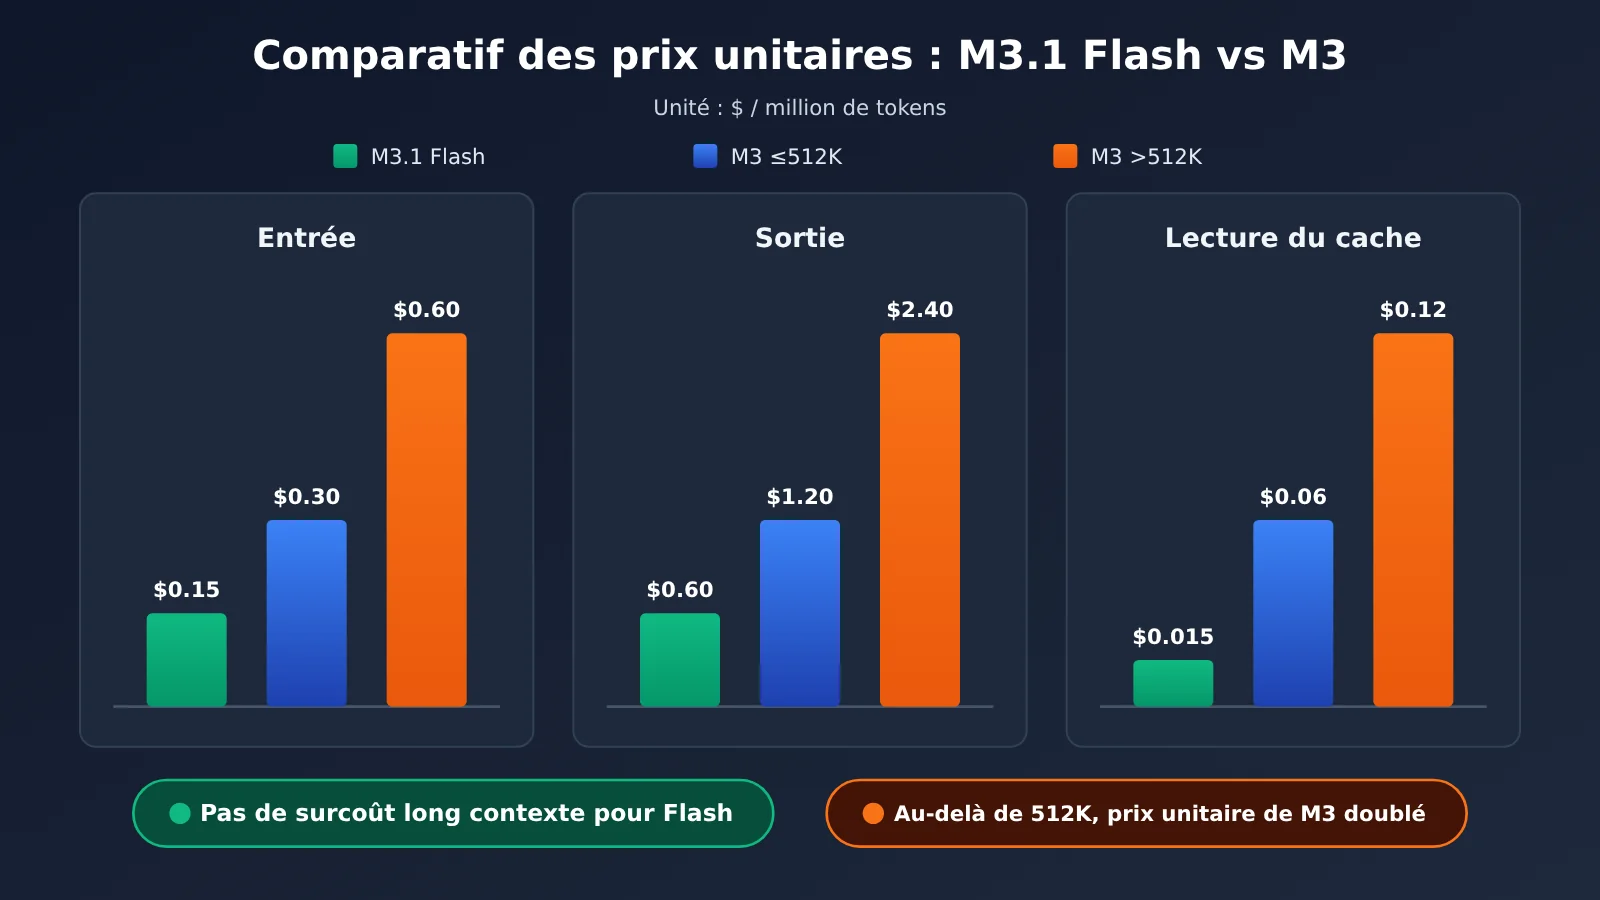
Légende : les tarifs proviennent de la page officielle de MiniMax. La facturation réelle sur les plateformes tierces dépend de leurs propres tarifs. Par exemple, pour utiliser la gamme MiniMax via APIYI (apiyi.com), référez-vous aux tarifs affichés sur cette plateforme.
Le tableau fait ressortir trois points :
- Contexte de longueur standard : les tarifs d’entrée et de sortie de Flash sont deux fois moins élevés que ceux de M3. La lecture du cache coûte quatre fois moins cher ($0.015 contre $0.06). Vérifions avec le cas d’usage 3 : pour la même utilisation, M3 revient à 1 × $0.06 + 0.5 × $0.30 + 1 × $1.20 = $1.41 par jour, contre $0.69 par jour pour Flash, soit environ 49 % du coût.
- Très long contexte : au-delà de 512K tokens en entrée, le tarif de M3 double, tandis que Flash n’applique aucun supplément. L’entrée et la sortie de Flash coûtent alors chacune un quart du tarif de M3.
- Un cache plus avantageux : pour Flash, la lecture du cache coûte un dixième du tarif d’entrée, contre un cinquième pour M3. Plus un scénario dépend du cache, plus l’avantage de Flash est marqué.
Pourquoi l’annonce officielle parle-t-elle d’un « coût divisé par trois » alors que le tarif unitaire baisse seulement de moitié ?
Ces deux affirmations ne sont pas contradictoires. La baisse de moitié du tarif unitaire se calcule par token. Le coût divisé par trois (dans un post officiel sur X) et la « baisse de 70 % du coût total des tâches d’agent » (dans le blog officiel) concernent le coût total pour réaliser une tâche. Ces chiffres sont tous deux avancés par MiniMax.
Coût total d’une tâche = tarif unitaire × nombre de tokens utilisés. Si le nouveau modèle accomplit la même tâche en moins d’étapes ou avec moins de tokens, le coût total peut baisser davantage que le tarif unitaire. Cependant, MiniMax n’a pas publié la méthode de calcul précise derrière le chiffre « divisé par trois ». De plus, le graphique officiel sur les coûts indique 62.8 pour Automation-Bench, contre 62.2 dans le tableau. Pour établir votre budget, mieux vaut donc faire vos propres calculs à partir des tarifs unitaires et considérer le chiffre « divisé par trois » comme une indication.
Comment choisir entre l’API à l’usage MiniMax M3.1 Flash et l’abonnement M Plan
MiniMax M3.1 Flash propose deux modes de paiement. Avec l’API à l’usage, vous ne payez que ce que vous consommez : le montant est déduit du solde de votre compte. M Plan est un abonnement mensuel qui se décline en trois formules : Go, Explore et Build. Toutes donnent accès au modèle de texte M3.1 Flash. Selon la documentation officielle, Explore inclut trois fois le volume de Go, et Build, 7,5 fois. Explore et Build incluent aussi le modèle vidéo H3. Le prix mensuel de chaque formule est à vérifier sur le site officiel. MiniMax a également annoncé une offre sur le premier mois pour les abonnements mensuels ; les détails de l’offre sont eux aussi à vérifier sur le site officiel.
| Critère | Choisir l’API à l’usage | Choisir l’abonnement M Plan |
|---|---|---|
| Volume d’utilisation | Votre utilisation est irrégulière ou globalement faible | Vous utilisez le service fréquemment au quotidien et souhaitez un budget mensuel fixe |
| Cas d’usage | Backend de votre produit, scripts de traitement par lots, traitement de données | Programmation, assistance IA au quotidien |
| Outils utilisés | Programme développé en interne, appels directs via l’adresse de l’API | MiniMax Code, Claude Code, Codex, Cursor, OpenCode |
| Besoin de vidéo | Facturation séparée selon l’utilisation | Le modèle vidéo H3 est inclus dans les formules Explore et Build |
| Maîtrise des coûts | Vous pouvez suivre chaque requête et optimiser finement avec le paramètre effort et le cache |
Pas besoin de calculer les tokens ; les règles applicables une fois le quota dépassé sont à vérifier sur le site officiel |
En bref : l’API à l’usage est faite pour les programmes, l’abonnement pour les personnes. Si vous programmez surtout avec des outils comme Claude Code ou Cursor, la clé d’abonnement M Plan peut s’y connecter directement. Pour un produit ou des tâches de traitement par lots, l’API à l’usage offre une facturation plus transparente, que vous pouvez estimer à l’aide de la méthode de calcul présentée dans cet article.
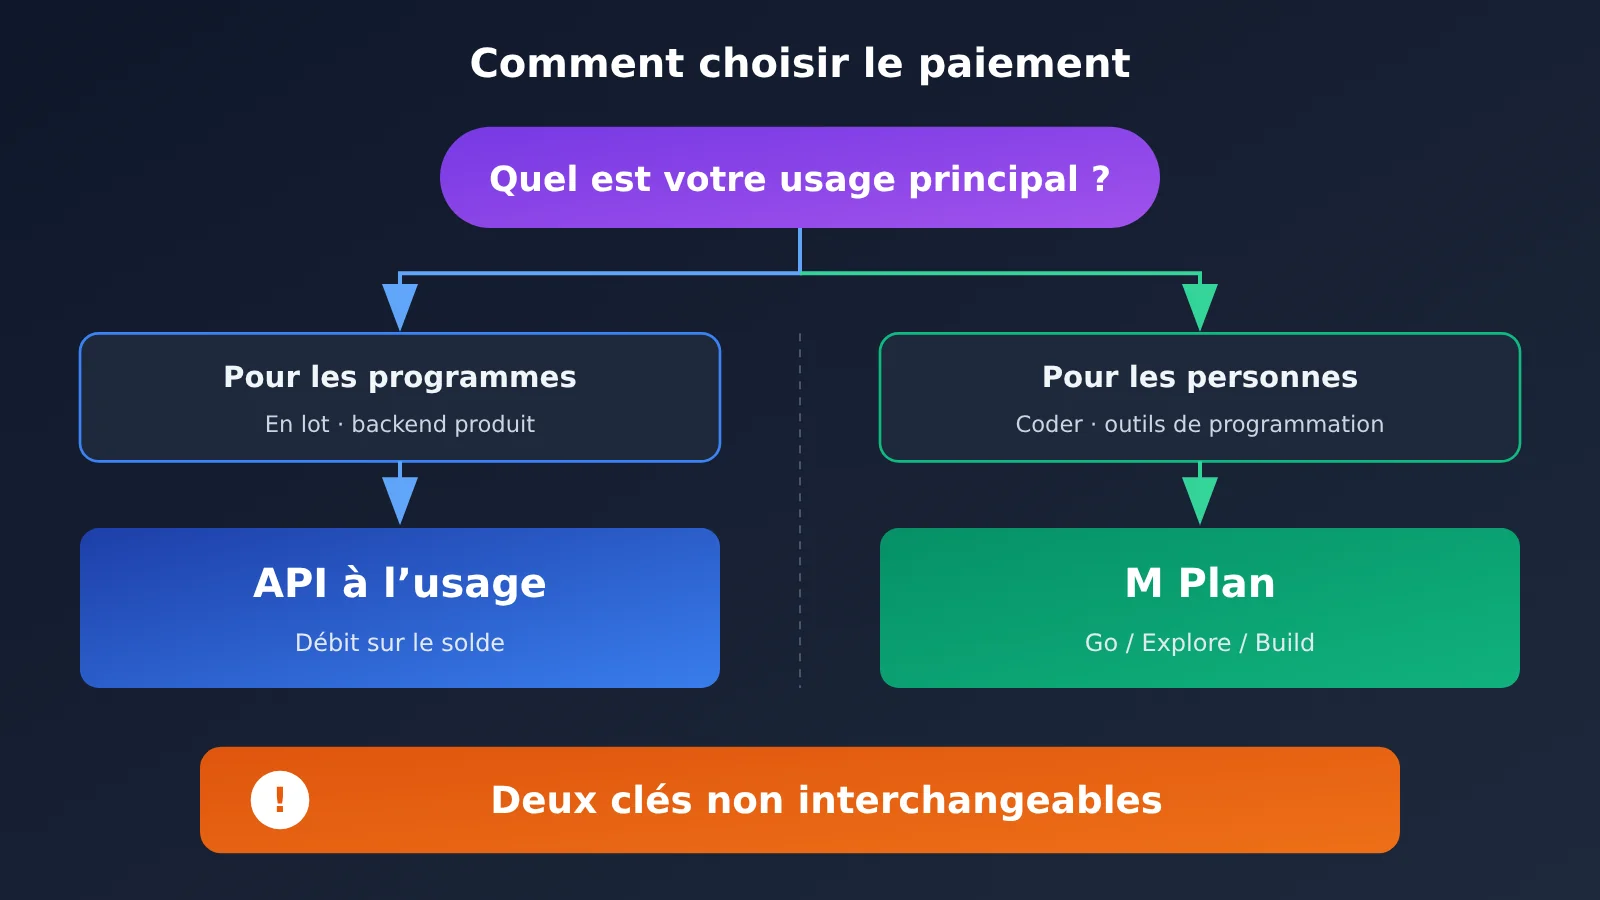
⚠️ Important : les deux clés ne sont pas interchangeables. La FAQ officielle précise que la clé API à l’usage et la clé d’abonnement M Plan sont différentes et qu’elles s’obtiennent à des endroits distincts de l’espace d’administration. Utiliser une clé d’abonnement pour appeler une API à l’usage, ou inversement, entraînera des problèmes. Avant de configurer votre accès, vérifiez donc bien quelle clé vous avez copiée. Par ailleurs, l’ancien nom de modèle MiniMax-M3.1-Flash-Preview a été retiré. Les requêtes qui utilisent encore cet ancien nom sont désormais traitées par MiniMax-M3.1-Flash.
Quand éviter MiniMax M3.1 Flash
Un prix bas ne signifie pas que le modèle convient à toutes les tâches. Dans les cas suivants, mieux vaut ne pas migrer tout de suite, ou ne le faire que partiellement.
1. Les agents à longues chaînes d’actions et les tâches qui impliquent le terminal. Selon l’évaluation indépendante de Vals AI, M3.1 Flash obtient 25,25 % sur Terminal-Bench 4.0, ce qui le place au 22ᵉ rang sur 51 modèles. Sur HLAB-Vals-1.1, il obtient 7,50 % et se classe 17ᵉ sur 23 modèles. Le score de 38,1 annoncé par le fabricant sur Terminal Bench 4.0 reste également inférieur de 13,7 points à celui de Claude Opus 5, qui atteint 51,8.
2. Les refactorisations de grandes bases de code. Le fabricant annonce un score de 23,0 sur SWE Refactor Bench, contre 31,0 pour Claude Opus 5.
3. Les cas où il faut désactiver le mode réflexion pour obtenir une latence minimale. Impossible de le désactiver : le niveau le plus bas disponible est « low ».
4. Les intégrations existantes qui analysent les balises de réflexion. Si vous migrez depuis M3, modifiez d’abord la logique d’analyse ; sinon, vous ne pourrez pas récupérer le contenu de la réflexion.
5. Les cas où vous voulez l’utiliser dès maintenant sur APIYI. À la date de publication, MiniMax-M3.1-Flash ne figure pas encore sur la page des tarifs d’APIYI. Consultez cette page pour vérifier sa disponibilité.
Comparons maintenant le modèle à Claude. Le tableau comparatif officiel prend Claude Opus 5 comme référence, et non Opus 5.5. Claude Opus 5.5 reste le modèle phare le plus puissant d’Anthropic, et MiniMax ne l’a pas comparé point par point. On ne peut donc pas affirmer que Flash a rattrapé ou dépassé Opus 5.5. Au classement général, Vals Index place M3.1 Flash au 15ᵉ rang sur 22 modèles, avec un score de 53,78 % ; parmi les modèles à poids ouverts, il se classe 5ᵉ.
| Modèle | Entrée / sortie (par million de tokens) | Comparaison des scores | Tâches les mieux adaptées | Canaux d’accès |
|---|---|---|---|---|
| MiniMax-M3.1-Flash | 0,15 $ / 0,60 $ | Scores annoncés par le fabricant et évaluations de Vals | Traitement par lots, programmation courante, appels d’outils | MiniMax officiel ; disponibilité sur APIYI à vérifier sur la page des tarifs |
| claude-opus-5 | 5 $ / 25 $ (tarifs officiels) | Modèle de référence du tableau comparatif officiel | Tâches complexes | APIYI, apiyi.com, etc. |
| claude-opus-5-5 | 4 $ / 20 $ (tarifs officiels) | Le fabricant ne l’a pas pris comme référence pour sa comparaison | Planification complexe, conception d’architecture, grandes refactorisations | APIYI, apiyi.com, etc. |
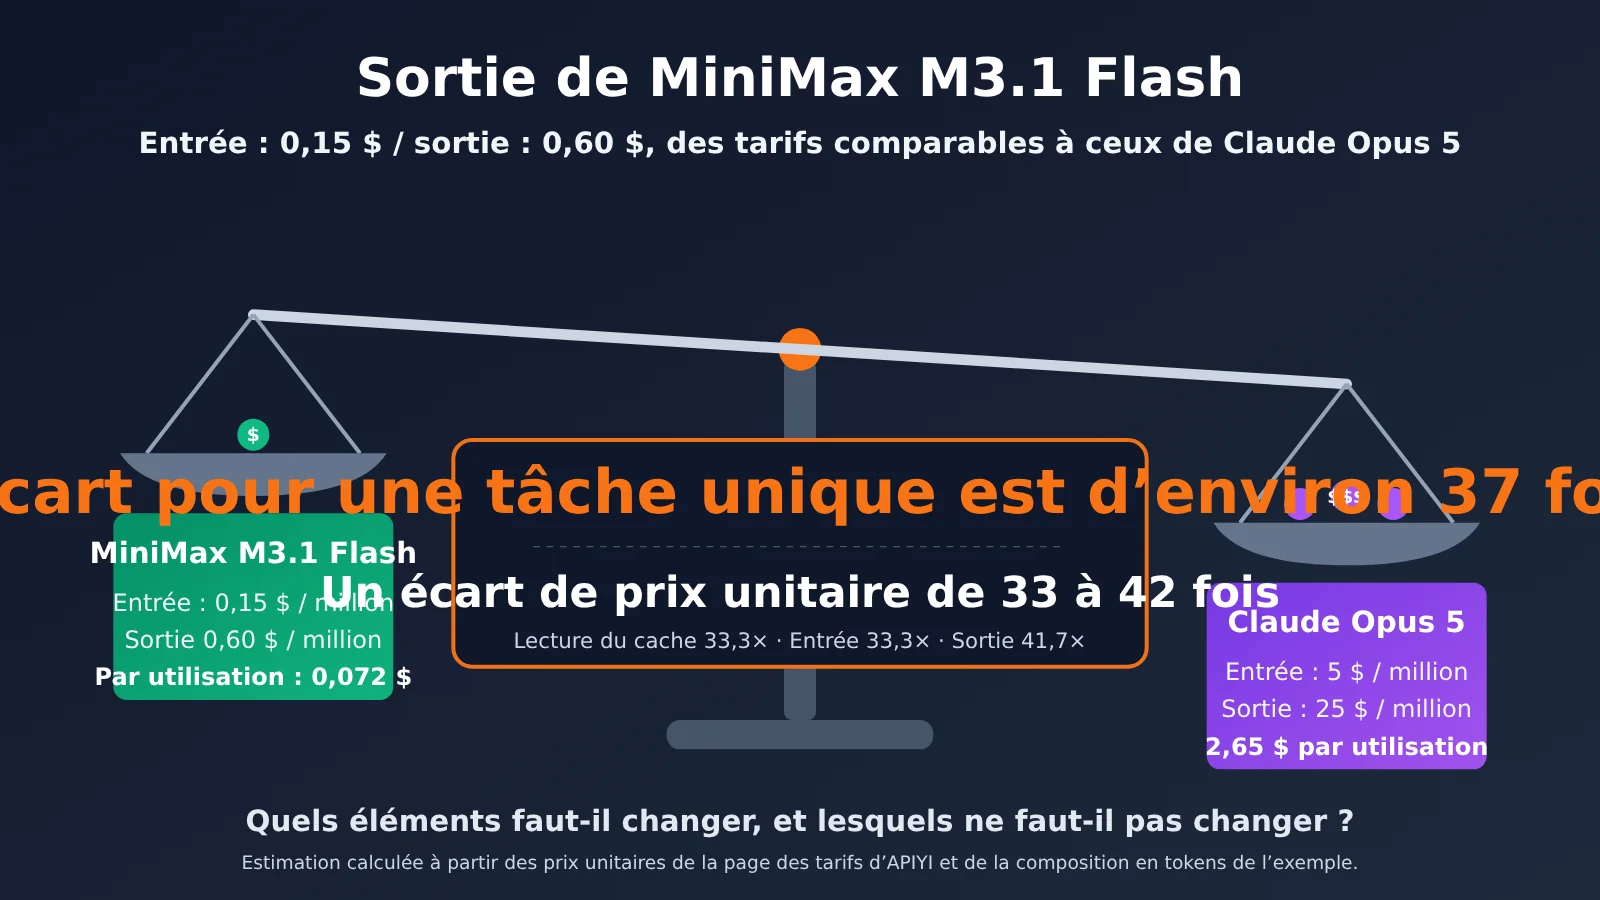
À tarif unitaire, la sortie d’Opus 5.5 coûte environ 33 fois plus cher que celle de Flash (20 $ ÷ 0,60 $ ≈ 33,3), et son entrée environ 27 fois plus cher (4 $ ÷ 0,15 $ ≈ 26,7). Avec un tel écart, le plus judicieux est de répartir les tâches entre les modèles plutôt que d’en choisir un seul.
Comment associer MiniMax et Claude Opus 5.5 sur APIYI
Au 22 octobre 2026, les modèles MiniMax directement disponibles sur la page des tarifs d’APIYI sont MiniMax-M3 (compatible avec les formats d’interface OpenAI et Anthropic, et disponible dans le groupe ClaudeCode), MiniMax-M2.7, MiniMax-M2.7-highspeed, MiniMax-M2.5, MiniMax-M2.5-lightning, ainsi que le modèle vidéo MiniMax-H3. MiniMax-M3.1-Flash ne figure pas encore sur la page des tarifs. Pour savoir s’il est disponible, consultez la page des tarifs d’APIYI.
Côté Claude, claude-opus-5-5 et claude-opus-5 sont tous deux disponibles directement. L’avantage d’APIYI, c’est qu’une seule clé permet d’utiliser les modèles MiniMax et Claude Opus 5.5 : pas besoin de créer plusieurs comptes ni de les recharger séparément. Voici comment répartir les tâches :
- Confiez les tâches répétitives et peu coûteuses à MiniMax : nettoyage de données, classification de contenu, réécritures en série et génération de code simple. Utilisez un modèle offrant un bon rapport qualité-prix, comme MiniMax-M3, avec la mise en cache et un niveau de réflexion moins élevé.
- Réservez la planification complexe et les refactorisations à Opus 5.5 : conception d’architecture système, refactorisations importantes entre plusieurs modules et planification générale de tâches longues, avec
claude-opus-5-5. - Planifiez d’abord, exécutez ensuite : demandez à Opus 5.5 de proposer un plan et de découper le travail en tâches, puis confiez ces petites tâches à MiniMax pour les traiter en série. Vous trouverez ainsi un bon équilibre entre qualité et coût.
💡 Conseil : si vous ne savez pas encore quelles tâches confier à un modèle moins coûteux, utilisez le même échantillon sur MiniMax-M3 et
claude-opus-5-5via APIYI, sur apiyi.com. Comparez les résultats et les coûts avant de décider comment répartir les tâches.
Questions fréquentes (FAQ)
Q1 : Quel est exactement le prix de MiniMax M3.1 Flash ?
Selon la page tarifaire officielle, le prix est fixe : 0,15 $ par million de jetons en entrée, 0,60 $ en sortie et 0,015 $ pour la lecture du cache, sans supplément pour les longs contextes. La recherche Web côté serveur, `web_search`, est facturée 0,01 $ par requête.
Q2 : Pourquoi ma réponse ne contenait-elle qu’une phrase, alors que le nombre de jetons en sortie est élevé ?
Parce que le processus de réflexion est également comptabilisé dans les jetons de sortie. De plus, si vous ne transmettez pas le paramètre `effort`, son niveau par défaut est `max`. Il est impossible de désactiver la réflexion ; pour réduire le nombre de jetons en sortie, vous pouvez régler `effort` sur `low` ou `medium`.
Q3 : Combien MiniMax M3.1 Flash coûte-t-il de moins que M3 ?
Côté tarifs unitaires, les prix d’entrée et de sortie sont deux fois moins élevés que ceux de M3, et la lecture du cache coûte quatre fois moins cher. Au-delà de 512 K jetons en entrée, le prix unitaire de M3 double, tandis que celui de Flash reste inchangé. Le chiffre officiel d’un « coût divisé par trois » est une estimation communiquée par le fabricant pour certaines tâches ; la méthode de calcul n’a pas été publiée.
Q4 : Puis-je utiliser directement une clé API à la consommation dans Claude Code avec un abonnement M Plan ?
Non. Les clés API à la consommation et les clés d’abonnement M Plan sont différentes. Elles se récupèrent à des endroits distincts dans le tableau de bord et ne sont pas interchangeables. Pour connecter un outil avec votre abonnement, vous devez copier la clé d’abonnement.
Q5 : Peut-on déjà appeler MiniMax M3.1 Flash sur APIYI ?
À la date de publication, MiniMax-M3.1-Flash ne figure pas encore sur la page tarifaire d’APIYI. Pour savoir s’il est disponible, consultez cette page ; nous ferons le nécessaire pour l’ajouter rapidement. En attendant, vous pouvez utiliser directement MiniMax M3, claude-opus-5-5 et d’autres modèles sur APIYI, à l’adresse apiyi.com. Une seule clé suffit pour passer de l’un à l’autre.
Q6 : Existe-t-il une option d’essai gratuit ?
La plateforme tierce OpenRouter propose un point d’accès gratuit avec limitation de débit : `minimax/minimax-m3.1-flash:free`. Il convient pour découvrir le modèle. Pour un usage régulier, nous vous conseillons d’estimer les coûts avec un petit volume de données, comme expliqué dans cet article.
Q7 : Quels sont les points faibles de MiniMax M3.1 Flash ?
Des évaluations indépendantes indiquent qu’il est moins performant sur les tâches d’agent à plusieurs étapes et les tâches de terminal : il se classe 22e sur 51 modèles dans Vals Terminal-Bench 4.0. Les résultats communiqués par le fabricant sur les tâches de refactorisation sont également inférieurs à ceux de Claude Opus 5. Par ailleurs, MiniMax n’a pas encore publié de rapport technique détaillant les changements apportés à Flash.
Q8 : Par quoi commencer pour réduire les coûts au maximum ?
Commencez par réduire le paramètre `effort`, réglé par défaut sur `max`. Ensuite, placez au début de la requête les instructions système fixes et les longs documents afin de tirer parti du cache. En général, ces deux mesures ont un effet plus immédiat que le changement de modèle. Pour comparer les coûts de plusieurs modèles en parallèle, vous pouvez effectuer vos tests sur APIYI, à l’adresse apiyi.com.
Points clés sur le prix de MiniMax M3.1 Flash
- Trois tarifs unitaires : 0,15 $ pour les tokens d’entrée, 0,60 $ pour les tokens de sortie et 0,015 $ pour les tokens lus depuis le cache, par million de tokens. Aucun supplément pour les longs contextes.
- La sortie représente l’essentiel de la facture : les tokens de réflexion sont facturés comme des tokens de sortie. Le niveau
maxpar défaut est le plus coûteux ; pour réduire les frais, commencez par diminuer le niveau d’effort. - Impossible de désactiver la réflexion : les paramètres
disabledounonerenvoient une erreur 400. Le niveau le plus bas disponible estlow. - Le cache permet d’économiser 90 % : placez le contenu fixe au début de l’invite et le contenu variable à la fin.
- Le tarif unitaire est deux fois moins élevé que celui de M3 : l’affirmation « coût divisé par trois » correspond à une estimation officielle par tâche ; les deux chiffres ne se contredisent pas.
- À l’usage pour les programmes, par abonnement pour les utilisateurs : les deux types de clés ne sont pas interchangeables. Consultez le site officiel pour connaître le prix mensuel du M Plan.
- Une utilisation combinée est plus avantageuse : sur APIYI, utilisez une seule clé pour confier les tâches en lot à MiniMax et la planification à Opus 5.5.
En résumé
Les points essentiels sur le prix de MiniMax M3.1 Flash :
- Savoir calculer : coût = volume utilisé ÷ 1 000 000 × tarif unitaire. Calculez séparément les tokens d’entrée, ceux lus depuis le cache et ceux de sortie, puis additionnez les montants.
- Savoir économiser : réduisez le niveau d’effort pour limiter les tokens de réflexion et placez le contenu fixe au début pour profiter davantage du cache.
- Savoir choisir : pour les programmes, optez pour l’API à l’usage ; pour un usage individuel, choisissez le M Plan. Pour les agents qui enchaînent de nombreuses étapes et les refontes de grande ampleur, mieux vaut tout de même faire appel à un modèle plus puissant.
Commencez par tester un petit lot de données réelles afin de calculer le coût par requête qui vous correspond, puis choisissez votre mode de paiement et la répartition des tâches. Pour comparer les performances et les coûts de plusieurs modèles, nous vous recommandons de réaliser tous vos tests avec une seule clé via APIYI apiyi.com. Vérifiez la page des tarifs pour savoir si MiniMax-M3.1-Flash est disponible.
📚 Références
- Article officiel de MiniMax : vitesse, coûts et résultats de benchmark déclarés par MiniMax pour M3.1 Flash
- Lien :
minimax.io/blog/minimax-m31f -
À retenir : source des tarifs officiels et de l’affirmation selon laquelle le coût des tâches d’agent a baissé de 70 %
-
Page officielle des tarifs de MiniMax : prix unitaires détaillés de Flash et de M3
- Lien :
platform.minimax.io/docs/guides/pricing -
À retenir : formule de facturation, tarification par paliers pour les longues fenêtres de contexte et prix de
web_search -
Documentation officielle de MiniMax : invocation du modèle : niveaux d’effort et règles de réflexion
- Lien :
platform.minimax.io/docs/guides/text-generation -
À retenir : la réflexion ne peut pas être désactivée et noms des champs
effortselon les protocoles -
Présentation des abonnements MiniMax M Plan : les trois offres Go, Explore et Build
- Lien :
platform.minimax.io/docs/m-plan/intro -
À retenir : multiplicateurs d’utilisation, outils pris en charge et présentation des modèles
-
FAQ officielle de MiniMax : différences entre la clé API et la clé d’abonnement
- Lien :
platform.minimax.io/docs/faq/about-apis -
À retenir : confirmation officielle que les deux types de clés ne sont pas interchangeables
-
Page d’évaluation de Vals AI : résultats d’une évaluation indépendante
- Lien :
vals.ai/models/minimax_MiniMax-M3.1-flash - À retenir : classement Vals Index, points forts et points faibles
Auteur : équipe technique d’APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI, apiyi.com. Pour plus de documentation sur l’intégration, consultez le centre de documentation docs.apiyi.com.