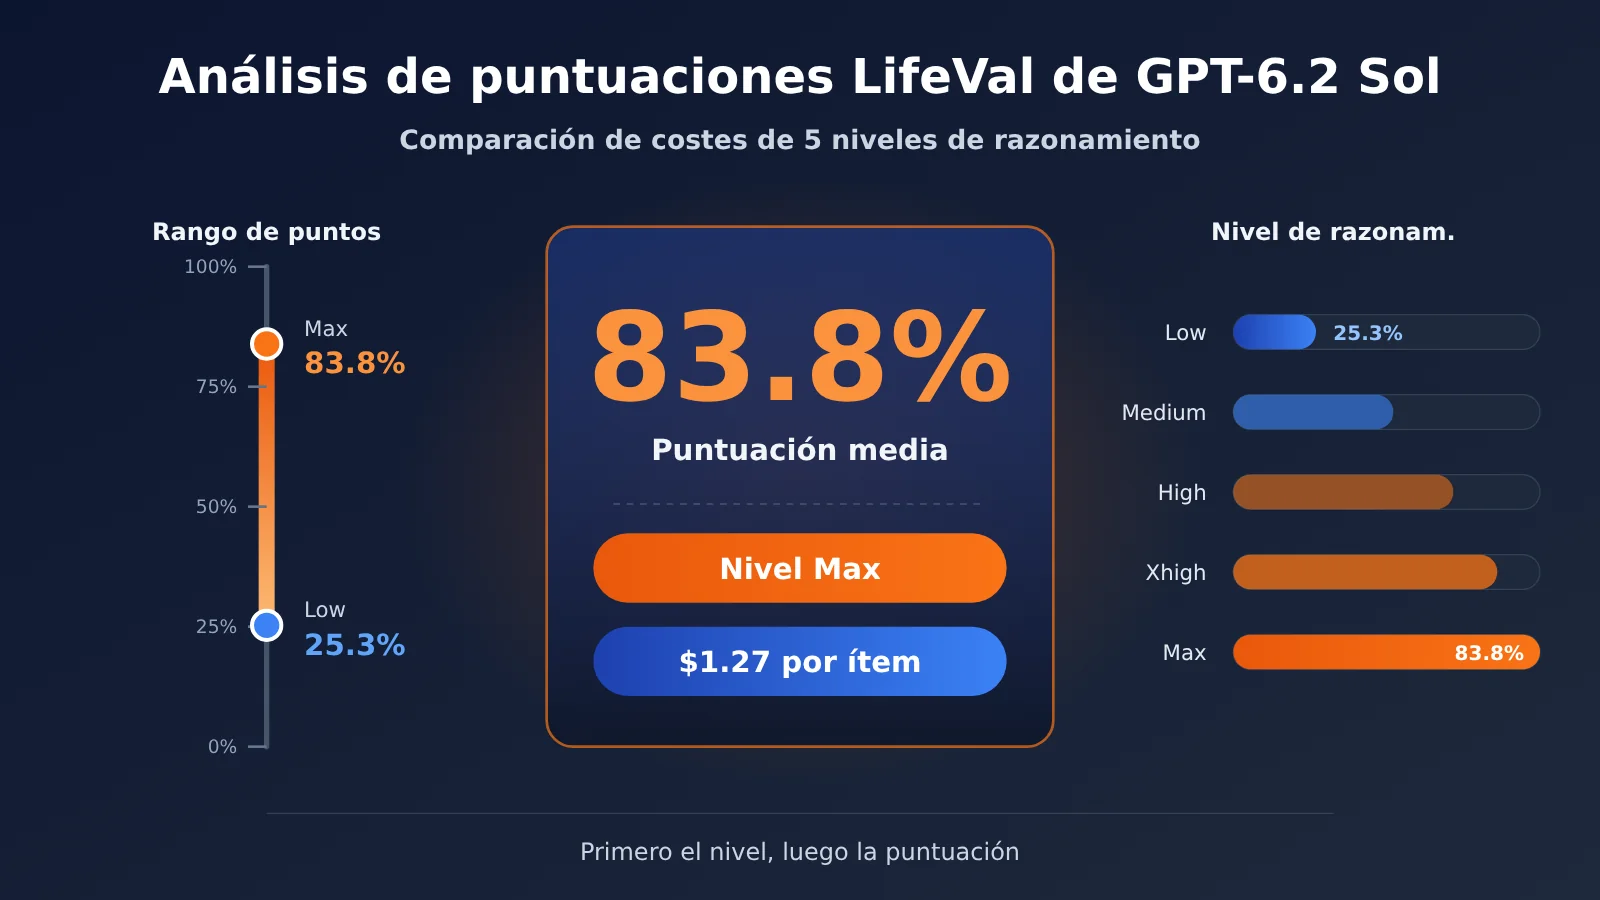
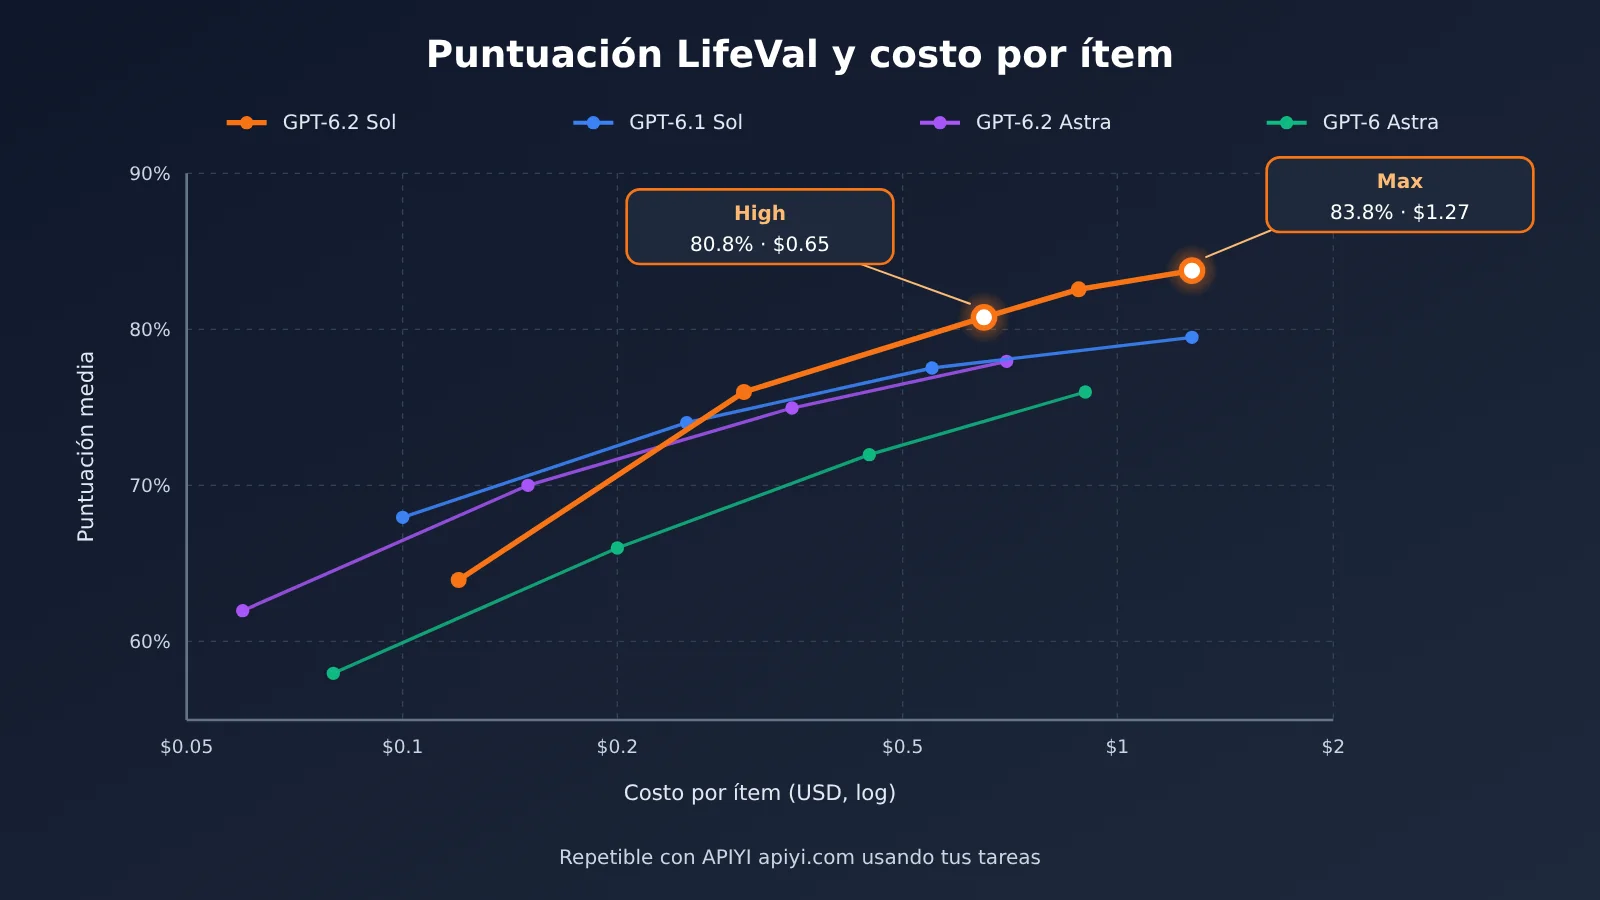
El 83.8% no significa que “se completó el 83.8% de las tareas”, sino la puntuación media de GPT-6.2 Sol en LifeVal con el nivel de razonamiento Max. Esta puntuación se obtiene sumando los puntos que cada tarea recibe ítem por ítem según sus criterios de evaluación; el costo promedio por tarea correspondiente es $1.27. Si el mismo modelo pasa al nivel Low, la puntuación media cae a solo 25.3%; en el nivel High, la puntuación media es 80.8% y el costo promedio por tarea es $0.65. Por eso, cuando hablemos del desempeño de GPT-6.2 Sol en LifeVal, primero hay que dejar claro de qué nivel estamos hablando.
La conclusión es esta: el ranking oficial ofrece “combinaciones de puntuación y costo en tareas y entornos específicos”, no un ranking general que puedas trasladar directamente a tu producto. En este conjunto de datos de LifeVal, el nivel High es un punto de partida que vale la pena probar primero. Al final, qué nivel uses seguirá dependiendo de tus propias tareas: valida con tus entregables y el estado real.
¿Qué puedes aprender con este artículo?
- Qué tipo de tareas mide LifeVal y cómo debería expresarse correctamente el 83.8%.
- Las puntuaciones y costos de los cinco niveles de razonamiento de GPT-6.2 Sol, junto con la comparación en el mismo nivel frente a GPT-6.1 Sol, GPT-6 Astra y GPT-6.2 Astra.
- Por qué pueden ser ciertas al mismo tiempo las afirmaciones oficiales de “costo de aproximadamente un séptimo” y “fuerte caída en el nivel Low”.
- Cómo tomar prestado el método de validación de LifeVal para diseñar tareas de evaluación repetibles para tu asistente diario.
Índice: La tabla To Know explica primero los términos de evaluación que se usarán más adelante; el resumen de impacto indica, por separado, qué deberían mirar los usuarios generales y qué los desarrolladores. La parte de hechos objetivos presenta, en orden, el origen de las tareas de LifeVal y su forma de puntuación, junto con los datos por nivel que aparecen en la imagen publicada el 17 de noviembre. La parte de análisis y juicio descompone primero los denominadores de varias comparaciones, luego ofrece un ejemplo de validación para un asistente de rutas y agenda que puedes reescribir directamente, y explica los límites de transferencia.
Para saber: conceptos clave para entender la puntuación LifeVal de GPT-6.2 Sol
| Concepto | Explicación breve |
|---|---|
| LifeVal | Benchmark de OpenAI para medir el rendimiento de un asistente de IA al completar tareas digitales cotidianas personalizadas |
| Contexto personalizado | Información como preferencias del usuario, historial, condiciones específicas de la tarea, etc., que cambia qué se considera una «respuesta aceptable» |
| Rúbrica de evaluación | Desglose del grado de finalización de una tarea en varios requisitos verificables uno por uno |
| Entorno controlado | Entorno de evaluación con aplicaciones, datos y estado inicial preconfigurados, para facilitar la verificación de los resultados de las acciones |
| Diferencias en el estado del backend | Cambios en el estado de la aplicación registrados antes y después de la prueba, usados para confirmar si las operaciones de las herramientas realmente surtieron efecto |
| Recompensa media | Métrica agregada que resulta de puntuar cada tarea según la rúbrica; los porcentajes de las gráficas publicadas son este tipo de «puntuación promedio» |
| Intensidad de razonamiento | Nivel que controla la inversión en razonamiento del modelo; este artículo compara Low, Medium, High, Xhigh y Max |
| Costo por tarea | Costo promedio por cada tarea en las gráficas de evaluación; varía según el uso del modelo y las tarifas |
Resumen rápido del impacto de GPT-6.2 Sol LifeVal
- Usuarios generales: cuando vean «83.8%», deben entenderlo como «una puntuación promedio en un conjunto de tareas cotidianas de usuarios estadounidenses de habla inglesa», no como tasa de éxito. Además, hay que tener en cuenta que el mismo modelo varía mucho según el nivel de razonamiento; la experiencia del producto depende de qué nivel elija quien lo integra.
- Responsables de producto: el nivel Low tiene el precio más bajo, pero esta vez en LifeVal quedó muy por detrás del nivel Low de la generación anterior, Sol. Si al actualizar se mantiene la configuración de niveles de la versión anterior, podría pasar que «al cambiar al nuevo modelo el rendimiento empeore».
- Desarrolladores de API: vale la pena tomar como referencia el diseño de aceptación de LifeVal, es decir, puntuar por separado entregables, estado del entorno y respuesta. Comparar los niveles Low, Medium y High con el mismo conjunto de tareas propias es más fiable que citar directamente las cifras de la tabla de clasificación.
Datos objetivos: con qué tareas LifeVal evalúa al modelo GPT-6.2 Sol
Origen y cronología de LifeVal
LifeVal es una evaluación de OpenAI para medir tareas personalizadas de agentes para el día a día. La página de investigación de OpenAI está fechada el 2 de noviembre de 2026, y el artículo correspondiente, el 3 de noviembre. El 17 de noviembre, OpenAI publicó GPT-6.2 Astra y GPT-6.2 Sol, y en la página de lanzamiento incluyó una gráfica de LifeVal con las puntuaciones por niveles de los nuevos modelos (identificador de la gráfica: lifeval-v2).
La distribución de tareas del artículo proviene de estudios de uso del tiempo de Estados Unidos y de varios países, y también toma como referencia una encuesta de disposición a pagar dirigida a la población estadounidense; al final, las actividades cotidianas quedaron organizadas en 148 categorías. Los experimentos del artículo usan 169 tareas. Cabe señalar que los modelos evaluados en el propio artículo llegan hasta GPT-6 Astra; las cifras por niveles de la serie GPT-6.2 solo aparecen en la gráfica oficial publicada más tarde.
Según el posicionamiento oficial, Sol está orientado a trabajo diario de alta frecuencia, programación convencional y agentes de múltiples pasos que se pueden escalar; Astra está orientado a razonamiento más difícil y entregables profesionales. Este posicionamiento encaja con las «tareas de asistente cotidiano» que mide LifeVal.
El diseño de tareas de LifeVal: una misma necesidad, respuestas válidas que cambian según la persona
La característica distintiva de LifeVal es la personalización. Pongamos el caso de comparar escuelas después de mudarse: para usuarios con hijos de edades distintas, rutas de desplazamiento distintas o preferencias distintas por distritos escolares, la respuesta válida no es la misma. Otro ejemplo: al buscar vivienda sopesando presupuesto y tiempo de desplazamiento, el presupuesto máximo y el tiempo de desplazamiento aceptable determinan directamente qué viviendas cuentan como resultados válidos.
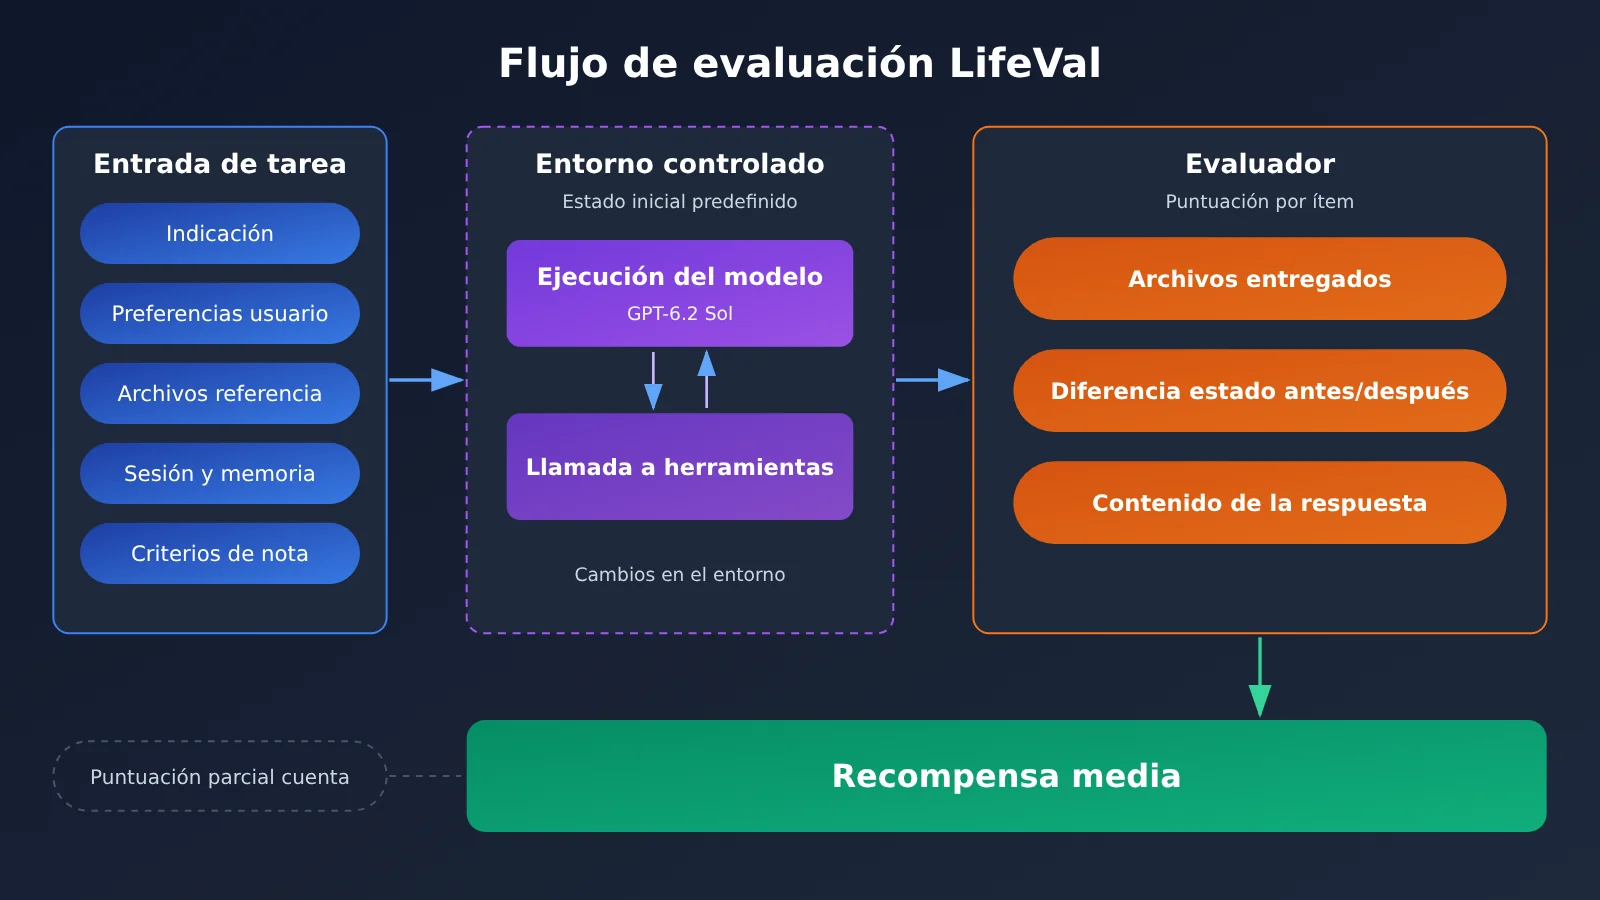
Según los criterios del artículo, cada tarea incluye una indicación, preferencias del usuario, archivos de referencia, conversaciones y memoria relevantes, una rúbrica de evaluación y un entorno controlado con un estado preestablecido. Una vez finalizada la ejecución, el evaluador puede verificar tres tipos de cosas: los archivos entregados por el modelo, el estado anterior y posterior del entorno sobre el que operaron las herramientas, y la respuesta del modelo; después otorga puntuaciones por separado según cada requisito de la tarea.
Por qué 83.8% solo puede expresarse como «puntuación promedio»
El eje vertical de las gráficas de resultados del artículo es el valor de recompensa promedio. Por lo tanto, 83.8% debe expresarse como «puntuación promedio», y no como «el 83.8% de las tareas se ejecutó con éxito por completo». Aunque una tarea solo cumpla parte de los ítems de evaluación, también aporta una parte de la puntuación.
El artículo también señala varias limitaciones: tanto en el entorno offline como en las páginas web en caché sigue habiendo parte de la información que cambia con el tiempo, y la muestra está formada sobre todo por usuarios de Estados Unidos que usan inglés. Esto significa que las puntuaciones no se pueden extrapolar directamente a otras regiones, otros idiomas u otros ecosistemas de aplicaciones.
Gráfico de publicación de LifeVal para GPT-6.2 Sol: puntuaciones de los cinco niveles y coste por tarea
Los datos de la siguiente tabla proceden de la información pública del gráfico interactivo LifeVal que aparece en la página de lanzamiento de OpenAI del 17 de noviembre de 2026. Cada celda indica «puntuación media / coste medio por tarea (USD)»: son datos de evaluación públicos declarados por la propia OpenAI, no mediciones realizadas por un organismo independiente.
| Modelo | Low | Medium | High | Xhigh | Max |
|---|---|---|---|---|---|
| GPT-6.2 Sol | 25.3% / $0.089 | 70.3% / $0.38 | 80.8% / $0.65 | 82.6% / $0.88 | 83.8% / $1.27 |
| GPT-6.1 Sol | 66.8% / $0.52 | 75.5% / $0.73 | 77.1% / $0.88 | 77.8% / $0.96 | 79.5% / $1.27 |
| GPT-6.2 Astra | 46.3% / $0.59 | 78.9% / $1.56 | 83.1% / $2.41 | 83.7% / $2.94 | 86.1% / $4.23 |
| GPT-6 Astra | 67.5% / $3.51 | 74.3% / $5.30 | 76.0% / $6.52 | 77.5% / $6.94 | 79.8% / $9.04 |
El texto del anuncio de lanzamiento afirma que, en LifeVal, Sol obtiene una puntuación superior a GPT-6 Astra con un coste equivalente, aproximadamente, a una séptima parte de este. El término de comparación aquí es GPT-6 Astra, el buque insignia de la generación anterior, y no el GPT-6.2 Astra de la misma tanda. La otra comparativa del anuncio, la de FrontierCode 2.0, sí utiliza GPT-6.2 Astra; al leer, conviene no mezclar las conclusiones de ambos grupos.
📌 Nota sobre el criterio de los datos: el «coste por tarea» de la tabla es el valor medio del gráfico oficial de evaluación, y depende de la longitud de entrada, la longitud de salida y el uso de herramientas de esa evaluación concreta. Para saber cuánto te cuesta a ti una tarea, tendrás que volver a medirlo con solicitudes reales: puedes usar APIYI apiyi.com con la misma clave API para ejecutar las distintas configuraciones de Sol una tras otra y comparar directamente con la factura.
Información de acceso API de GPT-6.2 Sol
El ID del modelo de API es gpt-6.2-sol y se puede invocar mediante Responses y Chat Completions. Las llamadas a funciones y las herramientas integradas utilizan la ruta de Responses, y ninguno de los dos endpoints acepta el nivel de razonamiento none. El precio oficial Standard de contexto corto es de $2.00 por entrada y $10.00 por salida (USD por millón de tokens; la salida ya incluye los tokens de razonamiento), igual que GPT-6.1 Sol.
A 20 de noviembre de 2026, tanto la tabla maestra pública de modelos como la interfaz de precios de APIYI ya listan gpt-6.2-sol, con las entradas responses y chat indicadas. La tarificación del tramo corto coincide con la oficial; los grupos realmente disponibles, el rango de parámetros y la facturación se rigen por la configuración actual y la facturación de APIYI apiyi.com.
Análisis: cómo pueden coexistir el «coste de un séptimo» y la caída en Low en GPT-6.2 Sol LifeVal
Primero, alinea el objeto de comparación y el denominador
De la misma gráfica se pueden sacar dos impresiones —«gran avance» y «clara regresión»—, y la causa de fondo es que el objeto de comparación y el nivel son distintos. Las diferencias y proporciones de la tabla siguiente se calculan a partir de los valores publicados oficialmente.
| Grupo de comparación | Valores de ambas partes | Diferencia de puntuación | Relación de coste |
|---|---|---|---|
| 6.2 Sol Max vs. GPT-6 Astra Max, el flagship de la generación anterior | 83.8%/$1.27 vs 79.8%/$9.04 | +4.0 puntos porcentuales | ≈14.0%, es decir, «aproximadamente una séptima parte» |
| 6.2 Sol Max vs. 6.1 Sol Max | 83.8%/$1.27 vs 79.5%/$1.27 | +4.3 puntos porcentuales | Mismo coste |
| 6.2 Sol Low vs. 6.1 Sol Low | 25.3%/$0.089 vs 66.8%/$0.52 | −41.5 puntos porcentuales | Coste menor, pero la puntuación cae considerablemente |
| 6.2 Sol Medium vs. 6.1 Sol Medium | 70.3%/$0.38 vs 75.5%/$0.73 | −5.2 puntos porcentuales | Aproximadamente la mitad del coste |
| 6.2 Sol High vs. 6.1 Sol Max | 80.8%/$0.65 vs 79.5%/$1.27 | +1.3 puntos porcentuales | Aproximadamente la mitad |
| 6.2 Sol Max vs. 6.2 Astra Max | 83.8%/$1.27 vs 86.1%/$4.23 | −2.3 puntos porcentuales | ≈30% |
En estas cifras, «puntos porcentuales» describe la diferencia entre puntuaciones medias, mientras que «proporción de coste» describe la relación entre el coste medio por ítem; una no se puede convertir en la otra. Lo de «una séptima parte» solo se cumple en el grupo «6.2 Sol Max frente a GPT-6 Astra Max». Si se toma como referencia GPT-6.2 Astra del mismo periodo, Sol en el nivel Max queda, de hecho, 2.3 puntos porcentuales por debajo.
💡 Consejo para elegir modelo: la diferencia entre niveles de un mismo modelo puede ser mayor que la diferencia entre modelos distintos. Conviene ejecutar primero una comparación por niveles en APIYI apiyi.com con un conjunto fijo de tareas y, a partir de ahí, decidir el nivel predeterminado; no reutilices directamente la configuración de niveles del modelo anterior.
La señal del nivel Low: la actualización no puede ser un “reemplazo a ciegas”
El nivel Low de 6.2 Sol solo alcanza 25.3% en LifeVal, 41.5 puntos porcentuales por debajo de 6.1 Sol Low. El material de lanzamiento oficial menciona que Sol consume menos tokens de salida en varias tareas, y el costo medio por tarea del nivel Low es de solo $0.089. Una hipótesis razonable es que, en tareas personalizadas de varios pasos, una inversión baja en razonamiento no basta para cubrir las restricciones de preferencia y las operaciones con herramientas. Esto es solo una suposición: la compañía no ha explicado la caída del nivel Low.
Para los equipos de producto, el impacto es directo. Si tu aplicación usaba el nivel Low en 6.1 Sol para ahorrar costos y cambias directamente el ID del modelo sin ajustar el nivel, la calidad de las tareas cotidianas complejas podría bajar de forma notable. En cambio, el nivel Max, con el mismo costo medio por tarea, está 4.3 puntos porcentuales por encima del Sol de la generación anterior, lo que indica que el techo del nuevo modelo realmente ha subido.
Por qué el nivel High es el primero que vale la pena probar en esta evaluación
En 6.2 Sol, de High a Xhigh y de ahí a Max, las mejoras entre niveles contiguos son de solo 1.8 y 1.2 puntos porcentuales, respectivamente, mientras que el costo medio por tarea sube $0.23 y $0.39 en ese mismo orden. El nivel High, con $0.65, alcanza 80.8%, ya por encima del nivel Max de 6.1 Sol y del nivel Max de GPT-6 Astra. Si nos ceñimos a LifeVal, High es el punto de partida con un “equilibrio razonable entre calidad y costo”.
Sin embargo, esta conclusión tiene tres premisas: que la distribución de tareas se parezca a la de LifeVal, que el idioma y el entorno de uso se acerquen al escenario de usuarios de inglés estadounidense y que la estructura de costos se parezca a la proporción de entrada/salida de esta evaluación. Si falla cualquiera de ellas, la conclusión puede cambiar. En la práctica, lo más prudente es empezar con High y, después, según la tasa de cumplimiento en tus propias tareas, decidir si bajar a Medium o subir a Xhigh o Max.
Análisis y evaluación: validar tu propio asistente GPT-6.2 Sol con el enfoque de LifeVal
Construir una tarea de itinerario familiar de bajo riesgo
Lo más valioso que LifeVal tiene para ofrecer no es la puntuación en sí, sino el método de «validar por artefactos y estado». Aquí tienes un ejemplo de itinerario familiar: se le dan de antemano al asistente tres restricciones duras —el punto de origen y destino, las condiciones de accesibilidad para el desplazamiento y el límite máximo de presupuesto— y se le pide que entregue propuestas candidatas con rutas verificables, además de un borrador de agenda editable.
| Criterio de evaluación | Cómo se verifica | ¿Automatizable? |
|---|---|---|
| ¿Se cumplen las restricciones de ubicación? | El origen y el destino de la propuesta coinciden con la entrada | Verificable automáticamente |
| ¿Se cumplen las condiciones de accesibilidad? | La descripción de la ruta cubre explícitamente los requisitos de accesibilidad | Parcialmente automático, requiere revisión manual por muestreo |
| ¿El presupuesto no se excede? | Analizar los importes de la propuesta y compararlos con el límite | Verificable automáticamente |
| ¿Los enlaces respaldan la información? | El enlace es accesible y su contenido coincide con la propuesta | Requiere revisión manual |
| ¿Existe el archivo de borrador de agenda? | Revisar el estado antes y después del archivo de salida o de la entrada de calendario | Verificable automáticamente |
| ¿Pregunta cuando falta información clave? | Omitir deliberadamente datos como la fecha y ver si indaga por iniciativa propia | Requiere criterio humano |
Este conjunto de criterios corresponde a las tres vías de validación de LifeVal: el entregable (el borrador de agenda), el cambio de estado (si el archivo o la entrada se escriben realmente) y la calidad de la respuesta (cumplimiento de restricciones y preguntas proactivas). Ejecuta el mismo lote de tareas con Low, Medium y High, y luego decide el nivel inicial combinando la tasa de cumplimiento y el coste.
Ejemplo mínimo: invocar GPT-6.2 Sol y registrar el consumo de razonamiento
El siguiente ejemplo llama a gpt-6.2-sol mediante la interfaz Responses y, al mismo tiempo, lee los tokens de salida y los tokens de razonamiento incluidos en ellos, para poder calcular después el costo de cada partida.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "high"},
    input="请为我规划周六的家庭出行:从家到市立博物馆,需全程无障碍,交通预算不超过 200 元,并给出日程草稿。"
)
print(resp.output_text)
print(resp.usage.output_tokens, resp.usage.output_tokens_details.reasoning_tokens)
Ver el script de comparación por niveles (Low / Medium / High)
import re
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Con una sola clave puedes comparar varios niveles
)

# Precio Standard de contexto corto, USD / millón de tokens (la salida ya incluye los tokens de razonamiento)
PRICE_IN, PRICE_OUT = 2.00, 10.00

TASKS = [
    {
        "prompt": "从家到市立博物馆,周六上午出发,全程无障碍,交通预算不超过 200 元。"
                  "请给出带路线说明的候选方案,并输出一份日程草稿。",
        "budget": 200,
        "must_include": ["无障碍", "博物馆"],
    },
    {
        # Falta la fecha a propósito, para comprobar si pregunta de forma proactiva
        "prompt": "帮我安排一次带老人去公园的出行,预算 100 元以内,需要无障碍路线。",
        "budget": 100,
        "must_include": ["无障碍"],
        "expect_question": True,
    },
]

def check(task, text):
    """Puntúa ítem por ítem según los criterios de evaluación y devuelve una puntuación de 0 a 1"""
    items = []
    items += [kw in text for kw in task["must_include"]]
    amounts = [float(x) for x in re.findall(r"(\d+(?:\.\d+)?)\s*元", text)]
    items.append(bool(amounts) and max(amounts) <= task["budget"])
    if task.get("expect_question"):
        items.append("?" in text or "?" in text)
    return sum(items) / len(items)

for effort in ["low", "medium", "high"]:
    scores, cost = [], 0.0
    for task in TASKS:
        resp = client.responses.create(
            model="gpt-6.2-sol",
            reasoning={"effort": effort},
            input=task["prompt"],
        )
        u = resp.usage
        cost += u.input_tokens / 1e6 * PRICE_IN + u.output_tokens / 1e6 * PRICE_OUT
        scores.append(check(task, resp.output_text))
    print(f"{effort:>6}: 平均得分 {sum(scores)/len(scores):.1%}, "
          f"平均单项费用 ${cost/len(TASKS):.4f}")
Las comprobaciones automáticas del script solo cubren los ítems de evaluación que se pueden verificar por máquina; la veracidad de los enlaces y la calidad de las preguntas de aclaración siguen requiriendo una revisión manual. Para los valores de los parámetros del nivel de razonamiento (especialmente las cadenas correspondientes a Xhigh y Max), toma como referencia la documentación oficial vigente y las indicaciones de parámetros del canal que estés usando.
🚀 Inicio rápido: regístrate en APIYI apiyi.com y obtén crédito de prueba gratuito. La plataforma ofrece una interfaz compatible con OpenAI, así que basta cambiar la clave en el script anterior para que funcione; viene bien para hacer una primera ronda de validación con una muestra pequeña antes de elegir el nivel definitivo.
Límites de transferencia de las conclusiones de LifeVal sobre GPT-6.2 Sol
Al trasladar las conclusiones de LifeVal a tu propio producto, hay que considerar al menos tres diferencias. La primera es idioma y región: la muestra del artículo se centra en usuarios de inglés estadounidense; en escenarios en chino, el ecosistema de aplicaciones de mapas, pagos y calendario es completamente distinto. La segunda es el entorno: LifeVal se ejecuta en entornos controlados y páginas web almacenadas en caché, mientras que un producto real se enfrenta a fluctuaciones de red, fallos de autorización de herramientas y diferencias en el estado de las cuentas. La tercera es la estructura de costes: la tarifa oficial por ítem corresponde a la proporción de entrada/salida de esa evaluación; las solicitudes de contexto largo que superan 272K de entrada cambian por completo a una tarifa más alta, por lo que el coste por ítem puede diferir bastante de las gráficas.
Por eso, una forma de uso bastante razonable es: toma las gráficas oficiales como base para «reducir el rango de candidatos» y tu propio conjunto de tareas como base para la «decisión final». Para un asistente cotidiano complejo, puedes empezar por establecer una línea base con el nivel High y luego probar por separado si Medium mantiene las restricciones duras clave, y si Xhigh o Max reducen de forma clara el retrabajo manual; deja que hablen la tasa real de cumplimiento y la factura.
Cuando tu conjunto de tareas, la rúbrica de evaluación y las comprobaciones de entorno estén listos, actualizar el modelo deja de ser «cambiar de modelo mirando el ranking» y se convierte en un proceso de ingeniería que puede repetirse en cada iteración. Cuando necesites comparar repetidamente varios modelos y niveles, puedes usar la interfaz unificada de APIYI apiyi.com para ejecutar GPT-6.2 Sol, GPT-6.2 Astra, etc., dentro del mismo conjunto de scripts de aceptación.
Referencias
-
Anuncio de lanzamiento de OpenAI GPT-6.2 Astra y Sol (incluye gráfico de niveles de LifeVal)
- Enlace:
openai.com/zh-Hans-CN/index/introducing-gpt-6-2-astra-sol - Descripción: Publicado el 17/11/2026, fuente de los datos por niveles que aparecen en este artículo
- Enlace:
-
Página de investigación y artículo académico de LifeVal
- Enlace:
openai.com/index/lifeval,cdn.openai.com/pdf/lifeval.pdf - Descripción: Origen de las tareas, método de puntuación y notas sobre limitaciones (artículo §3–§5)
- Enlace:
-
Ficha del modelo GPT-6.2 Sol y precios oficiales
- Enlace:
developers.openai.com/api/docs/models/gpt-6.2-sol - Descripción: Especificaciones de la ventana de contexto, reglas de facturación para contexto largo y corto, y límites
- Enlace:
-
Tabla general de modelos de APIYI
- Enlace:
docs.apiyi.com/models.md - Descripción: Modelos listados públicamente, punto de entrada e información de precios
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: Te invitamos a escribirnos en el sitio web oficial de APIYI, apiyi.com; más materiales de integración están disponibles en el centro de documentación docs.apiyi.com