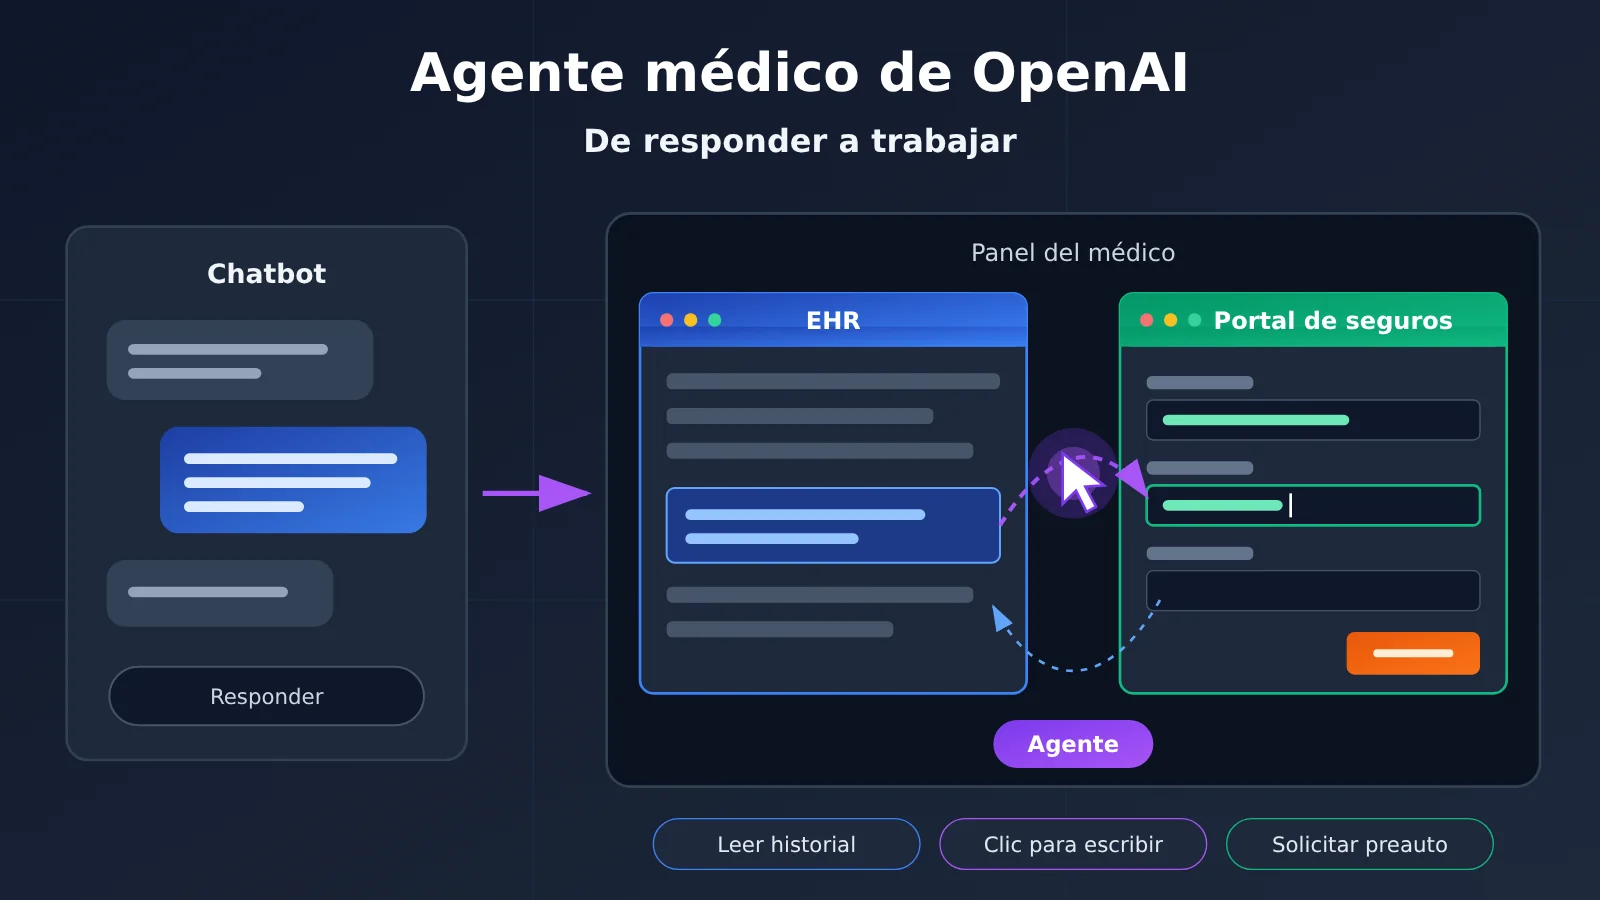
El avance clave del Agent Computer-use de OpenAI para el sector sanitario es que puede entrar en los sistemas de software que las instituciones médicas ya están usando, leer la información longitudinal del historial del paciente y, a partir de ahí, preparar notas clínicas, borradores de órdenes médicas, respuestas a pacientes y materiales de preautorización con la aseguradora. El valor de la IA está pasando de responder preguntas profesionales a ejecutar procesos de negocio reales. El foco de competencia de la IA médica también cambia: ya no se limita a preguntas y respuestas sobre conocimiento médico, sino que se mete de lleno en los flujos de trabajo clínicos y administrativos. Conviene subrayar que, tanto en las demos como en los casos públicos, estos materiales siempre pasan por la revisión de un médico o de personal autorizado; la IA no tiene por sí sola potestad para recetar ni para tomar decisiones médicas.
¿Qué podrá saber después de leer este artículo?
- En la demo de MRI, la cadena completa de operaciones del Agent, desde leer el historial clínico hasta preparar la solicitud de preautorización.
- Qué mide realmente cada uno de los tres datos —99% de seguridad, 93% de valoración alta por parte de los médicos y 94.3% de rubric points— y en qué se diferencian de los resultados del paper HealthAdminBench de Stanford.
- En qué fase está cada uno: CVS Health, Cigna, Abridge y Ambience, entre demo sintética, despliegue en producción y desarrollo.
- Cómo separar la autoridad de aprobación clínica de la capacidad de ejecución del Agent, y cómo deberían calcular los desarrolladores el costo completo del Agent.
Índice
La parte de hechos objetivos se desarrolla en este orden: primero reconstruir qué le hizo hacer a la IA OpenAI esta vez; luego comparar las diferencias entre un Chatbot y un Computer-use Agent; después desglosar el significado de los resultados de evaluación; a continuación repasar cómo están implementando estas capacidades CVS, Cigna, Abridge y Ambience; y por último presentar los mecanismos de control de riesgo del Agent sanitario. La parte de análisis y juicio tratará por qué el sector sanitario necesita especialmente esta capacidad, cómo deben decidir desarrolladores e instituciones médicas, y qué significa Computer Use para toda la industria de aplicaciones de IA.
Para saber: referencia rápida de conceptos relacionados con agentes médicos
| Concepto | Explicación breve |
|---|---|
| Computer Use | Capacidad de completar tareas observando y operando interfaces de software (capturas de pantalla, clics, escritura). |
| EHR | Sistema de historia clínica electrónica; el software central del hospital donde se guardan visitas, medicamentos, imágenes y demás información del paciente. |
| Payer Portal | Portal del pagador de seguros, donde las instituciones médicas envían autorizaciones previas y verifican la cobertura del seguro. |
| Prior Authorization | Autorización previa: antes de realizar algunos estudios o tratamientos, se necesita la aprobación de la aseguradora. |
| MCP | Protocolo estándar para descubrir e invocar herramientas externas. |
| RPA | Automatización mediante reglas o scripts preconfigurados para ejecutar procesos repetitivos. |
| Rubric points | Puntos de rúbrica, divididos según las reglas de evaluación, que miden el cumplimiento de requisitos parciales. |
| Tasa de éxito de extremo a extremo | Proporción de tareas completas que cumplen todas las condiciones de éxito. |
| Traza | Evidencia del recorrido que registra el proceso de ejecución, las acciones realizadas y el estado de la interfaz. |
| BAA | Acuerdo de socios comerciales que define la responsabilidad del proveedor de servicios al tratar información de salud protegida (PHI). |
| RBAC | Control de acceso basado en roles, que asigna los datos y operaciones accesibles según el puesto de trabajo. |
Vista rápida del impacto del Agent médico
- Desarrolladores y responsables técnicos: el foco ya no está en si el modelo puede responder correctamente preguntas médicas, sino en validar, según cada tarea concreta, el mecanismo de ejecución, la tasa de finalización de extremo a extremo y el costo total. Las capturas de pantalla cuentan como entrada de imagen; las llamadas multiturno, las herramientas y el entorno de ejecución también se facturan, así que no basta mirar solo el precio unitario de los tokens de texto.
- Instituciones médicas y responsables de flujos de trabajo: hace falta distinguir qué es una demostración con datos sintéticos, qué es una evaluación del fabricante, qué es un piloto empresarial y qué es un caso en producción. Al ponerlo en marcha también hay que implementar la aprobación humana, la configuración de permisos y los registros de auditoría; no se debe tomar el efecto de la demo como base directa para la compra.
- Personal clínico: a corto plazo, lo que más probablemente notará es una reducción de la carga administrativa, por ejemplo en la preparación de materiales de autorización previa y en la búsqueda de información entre sistemas. El juicio clínico y la responsabilidad de la firma siguen en manos del médico.
Hechos objetivos: qué lanzó esta vez el Agent médico de OpenAI
¿Qué ha hecho esta vez la IA en el agente médico de OpenAI?
El 16 de noviembre de 2026, OpenAI presentó nuevos avances en un agente que opera computadoras para equipos médicos. También dio a conocer los resultados de evaluación de flujos de trabajo clínicos y administrativos, así como experiencias de colaboración con empresas como CVS Health, Abridge, Ambience y Cigna Healthcare. Durante HLTH 2026, Karan Singhal, responsable de Health AI en OpenAI, también presentó los avances relacionados.
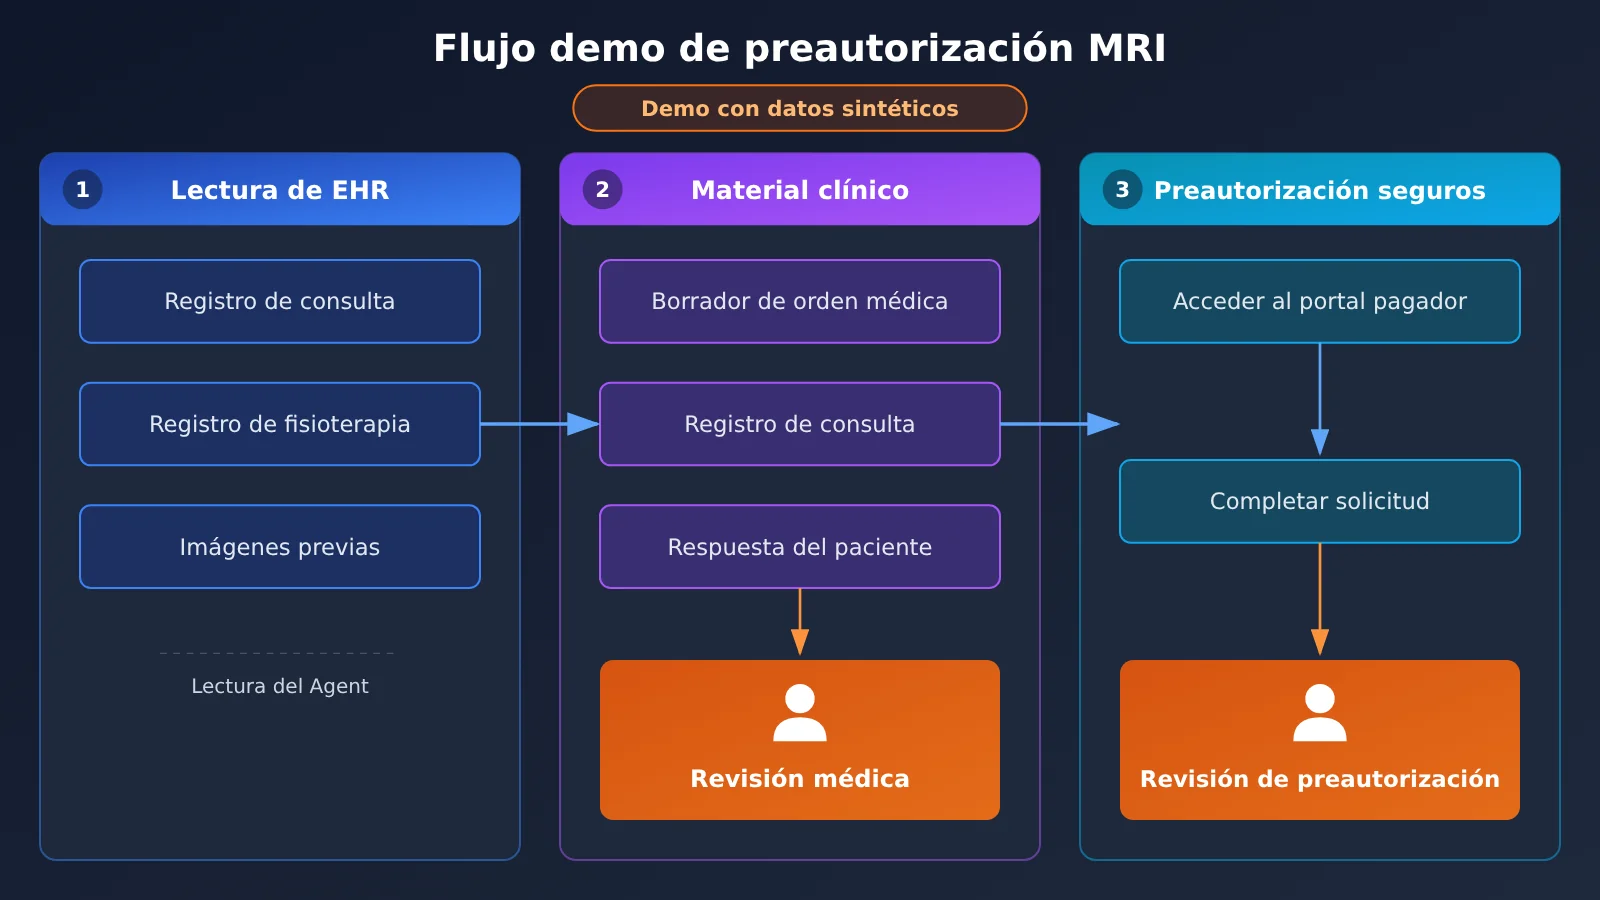
Lo que mejor ilustra este cambio es el flujo de trabajo de MRI que presentó OpenAI. Un paciente escribe a su médico por dolor lumbar y el médico considera solicitar una MRI. Después, el agente completó tres etapas de trabajo entre el EHR y el portal del seguro:
- Lectura de información del EHR: revisa los registros de consultas del paciente, los registros de fisioterapia y los estudios de imagen anteriores.
- Preparación de materiales clínicos: redacta la orden de MRI, la nota de esta consulta y la respuesta al paciente; todo queda pendiente de revisión médica.
- Preautorización del seguro: con el mismo registro del paciente, entra al portal del pagador del seguro para preparar la solicitud de preautorización de la MRI, que queda para revisión del personal de preautorización.
Cabe aclarar que esta demostración utiliza datos sintéticos de pacientes (Synthetic Patient Data) y no una operación en producción con pacientes reales. Lo que muestra es una cadena de capacidades; no significa que algún hospital ya esté gestionando casos reales con este flujo.
OpenAI también mostró un caso de consulta sobre medicamentos después de una fractura en un niño. Un familiar pregunta por la dosis de ibuprofeno para el niño; el agente revisa los registros de consulta y los estudios de imagen, lee el peso y la dosis administrada en la clínica que constan en la historia clínica y, a partir de ello, redacta instrucciones de uso del medicamento, indicaciones para el cuidado del yeso y signos de alarma que requieren atención médica urgente. El agente guarda el registro médico en estado sin firmar y la respuesta a la familia como borrador sin enviar; la aprobación final queda en manos del médico. Elevated PSA y Digoxin refill (renovación de digoxina) también se incluyeron como tipos de tarea en EHR Inbox, pero la compañía no hizo públicos el registro completo de operaciones ni las puntuaciones independientes de estas dos categorías de tareas.
Del Chatbot al agente médico Computer-use: ¿dónde está el cambio?
Los sistemas tradicionales de preguntas y respuestas médicas responden con conocimiento general; la generación de documentos médicos puede producir borradores, pero el contenido todavía tiene que copiarse manualmente en el sistema. La diferencia de un Computer-use Agent es que entra directamente en software existente mediante un ciclo de «observar captura de pantalla → planificar → hacer clic o escribir → verificar con nueva captura», completa tareas de varios pasos entre aplicaciones y puede cambiar el estado de negocio dentro del software.
| Forma de capacidad | Salida principal | ¿Toca sistemas de negocio? | Escenario médico típico | Punto de riesgo principal |
|---|---|---|---|---|
| Chatbot de preguntas y respuestas médicas | Respuesta textual | No | Consulta de conocimiento médico, búsqueda de evidencia | Exactitud del contenido |
| Generación de documentos médicos | Notas, borradores de cartas | Indirecto, requiere entrada manual | Instrucciones de alta, cartas de autorización previa | Contenido inconsistente con la historia clínica |
| Computer-use Agent | Operaciones de interfaz y cambios de estado del sistema | Sí, opera directamente EHR y portales | Relleno de autorización previa, actualización de estado de derivación, extracción de datos entre sistemas | Clics erróneos, confusión de pacientes, propagación de errores |
En la API de OpenAI, Computer Use se implementa principalmente mediante Responses API y admite acciones como click, type, scroll, keypress, drag y screenshot. La documentación oficial presenta dos rutas: una es Computer Tool, donde el modelo devuelve acciones estructuradas de ratón y teclado que ejecuta la aplicación; la otra es Code Execution, donde el modelo genera código que invoca herramientas como Playwright, PyAutoGUI, etc. Para GPT-6 Astra, actualmente la recomendación oficial es el enfoque Code Execution. La documentación también insiste en algo importante: que el modelo haya generado instrucciones de operación no significa que la operación ya se haya realizado correctamente; la aplicación debe ejecutar la acción y luego confirmar el resultado, por ejemplo con una nueva captura de pantalla.
¿Qué dicen realmente las métricas de evaluación del Agent médico de OpenAI?
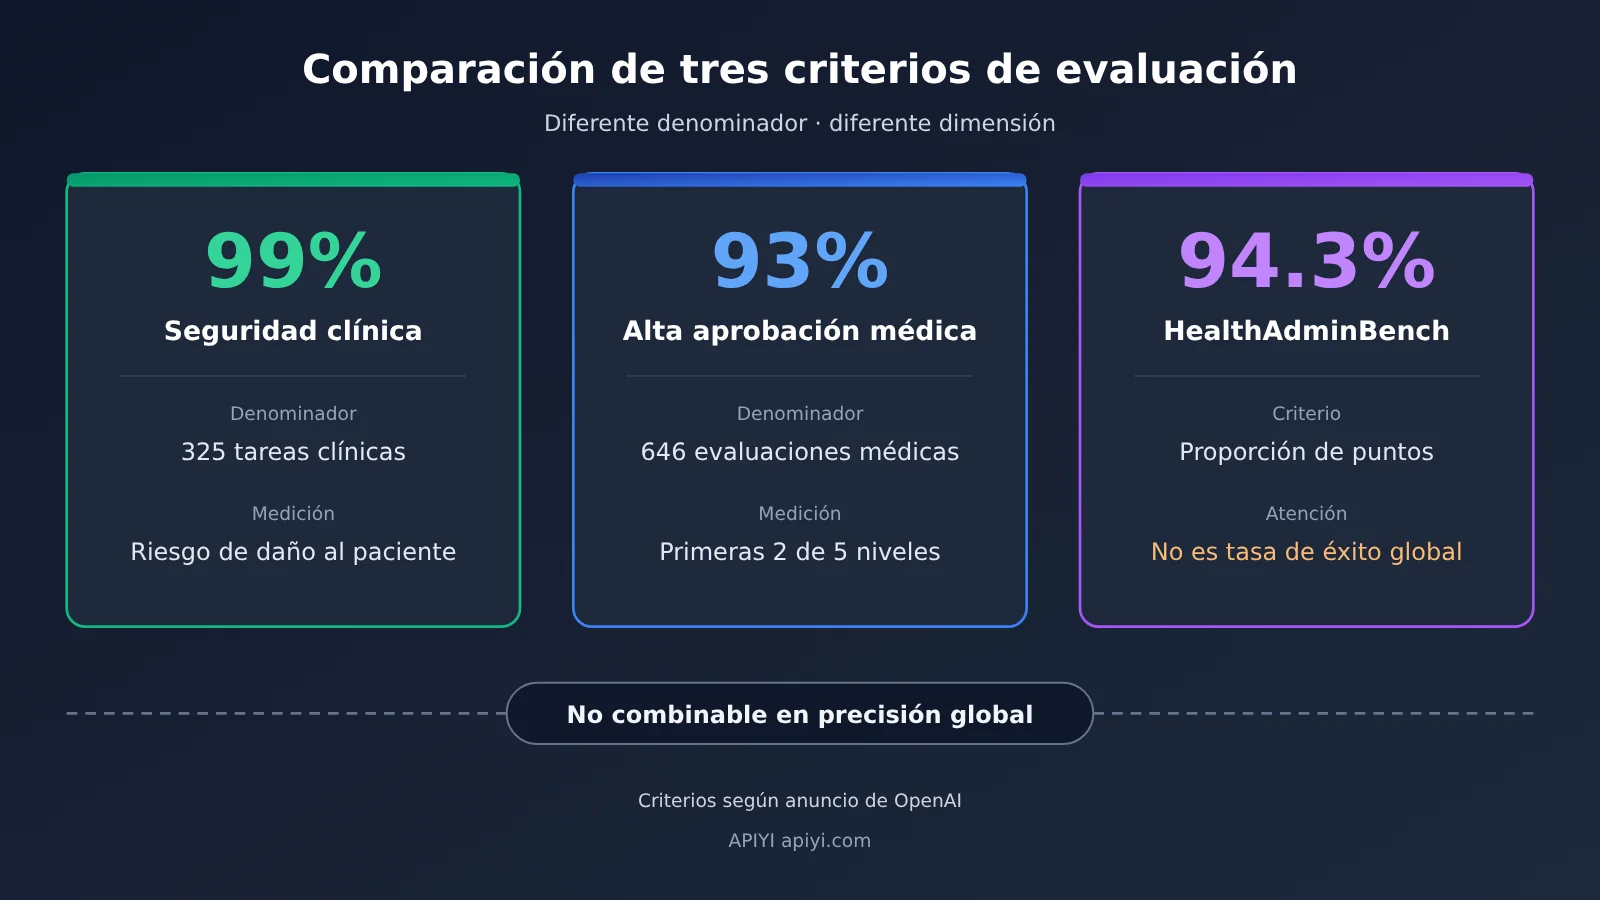
OpenAI publicó tres conjuntos de datos centrales cuyos denominadores y dimensiones de evaluación son distintos: no se pueden fusionar en una «precisión global», y ninguno de ellos corresponde a la precisión del diagnóstico médico.
| Métrica | Valor | Objeto evaluado | Denominador / criterio | No debe interpretarse como |
|---|---|---|---|---|
| Seguridad de tareas clínicas | 99% | GPT-6 Astra | 325 tareas revisadas, evalúa si errores, omisiones o acciones podrían causar daño al paciente | Precisión diagnóstica, cero errores |
| Alta valoración médica | 93% | GPT-6 Astra | 646 evaluaciones, proporción conjunta de Very / Extremely Helpful en una escala de cinco niveles | Tasa de éxito de tareas, 646 médicos |
| HealthAdminBench | 94.3% | GPT-6 Astra | Proporción de rubric points, maximum reasoning effort | Tasa de éxito de tareas completas |
| HealthAdminBench | 91.8% | GPT-6 Luna | Proporción de rubric points, maximum reasoning effort | Tasa de éxito de tareas completas |
| Coste por tarea | $0.085 | GPT-6 Luna | Condiciones de evaluación específicas, 98% menos que Astra | Precio de despliegue en producción |
La revisión clínica no se limita al texto final generado: también examina las acciones que el Agent realmente ejecuta, los registros médicos que produce, las órdenes médicas y los mensajes al paciente. Es decir, la evaluación cubre tanto la calidad del contenido como el proceso de operación del software. Sin embargo, la fuente oficial no publica cuántos médicos independientes corresponden a las 646 evaluaciones, y el cuerpo del anuncio tampoco ofrece intervalos de confianza, resultados por tarea ni casos de fallo completos.
HealthAdminBench es un benchmark de Agents administrativos sanitarios propuesto por el Shah Lab de Stanford. Según el artículo 2604.09937v1, el benchmark incluye 135 tareas y 1698 subtareas, de las cuales 1177 subtareas usan juicio determinista y 521 usan un modelo como juez; en el artículo, la tasa de éxito de tareas completas más alta la obtiene Claude Opus 4.6 CUA con 36.3%, mientras que la tasa de éxito de subtareas más alta la obtiene GPT-5.4 CUA con 82.8%. La versión web temprana del Shah Lab tenía 70 tareas y 947 puntos de puntuación, y entonces reportaba una tasa máxima de éxito de tareas completas del 22.9%, lo que sirve como referencia histórica.
Estas cifras pertenecen a versiones, modelos, fechas, condiciones de ejecución e indicadores distintos: no se pueden alinear en una misma tabla de clasificación. El 94.3% de OpenAI usa el criterio de rubric points, mientras que el 36.3% del artículo es la tasa de éxito de extremo a extremo de tareas completas. Esa diferencia ya sugiere algo: en los Agents médicos, «acertar pasos parciales» y «terminar la tarea completa» pueden estar muy lejos el uno del otro.
¿Cómo implementan CVS, Cigna, Abridge y Ambience agentes médicos?
La madurez de los casos de empresas varía mucho; a continuación se clasifican según el estado divulgado públicamente. Estas cifras provienen principalmente de lo divulgado por las empresas y OpenAI; los medios actúan como corroboración cruzada, pero no equivalen a una auditoría de terceros.
| Empresa | Escenario | Estado divulgado | Hechos clave |
|---|---|---|---|
| CVS Health | Envío de documentos, derivaciones y consultas de especialidad entre sistemas clínicos | Flujo de trabajo en producción | En un fin de semana liquidó un backlog de documentos de varios meses; otro agente procesa cada día decenas de miles de pasos de operación de sistemas relacionados con consultas |
| Cigna Healthcare | Integración de información entre sistemas antes de la gestión de cuidados | Desplegado | El personal de enfermería tenía que revisar más de 10 sistemas; del concepto al despliegue en menos de 8 semanas |
| Abridge | Coordinación de barreras al alta | En desarrollo | Los médicos solicitan al agente, mediante Abridge Assistant, que coordine en paralelo la obtención de medicamentos y la atención domiciliaria |
| Ambience Healthcare | Solicitudes de autorización previa con seguros | Demostración de solución de gobernanza | Se detiene y pregunta al médico cuando el historial clínico es ambiguo, y solo presenta la solicitud tras obtener aprobación |
| Assort | Cierre del ciclo de derivaciones | Caso oficial | La API escribe la información de la derivación y Computer Use completa la actualización de estado en la interfaz de Athena |
Las «decenas de miles» de CVS se refieren al volumen de trabajo que implican los pasos de operación del sistema, no a que la IA haya tomado decenas de miles de decisiones clínicas de forma independiente. CVS también liberó como código abierto CUA Agent Kit (licencia Apache-2.0), que adopta una arquitectura de dos fases: primero, un Computer-use Agent explora el flujo de trabajo a partir de lenguaje natural y registra capturas de pantalla, acciones, posiciones objetivo y otras evidencias de trace; después, Codex Skill convierte las trayectorias exitosas en código determinista, que se ejecuta repetidamente tras la revisión de ingenieros. Según el README, la fase de ejecución determinista no requiere una clave API del modelo.
El caso de Assort ilustra el papel de Computer Use: Assort ya puede escribir la información de derivación en el historial clínico mediante la API de Athena, pero al ciclo completo le falta un paso de operación en la interfaz. El agente selecciona directamente al médico de derivación en la interfaz de Athena, completa los detalles y actualiza el estado a Visit Scheduled; esa derivación se elimina de inmediato de la lista de seguimiento del personal. La API se encarga de las operaciones estructuradas y Computer Use de cubrir lo que la API no abarca.
¿Cómo controla riesgos un agente médico?
Las capacidades de gobernanza que OpenAI ha publicado incluyen RBAC, registros de auditoría, configuración del alcance de acceso de las aplicaciones, aprobación humana antes de operaciones críticas y mecanismos de control que limitan al agente a flujos de trabajo designados. Las instituciones médicas pueden pausar al agente en cualquier momento y consultar el registro paso a paso de sus operaciones.
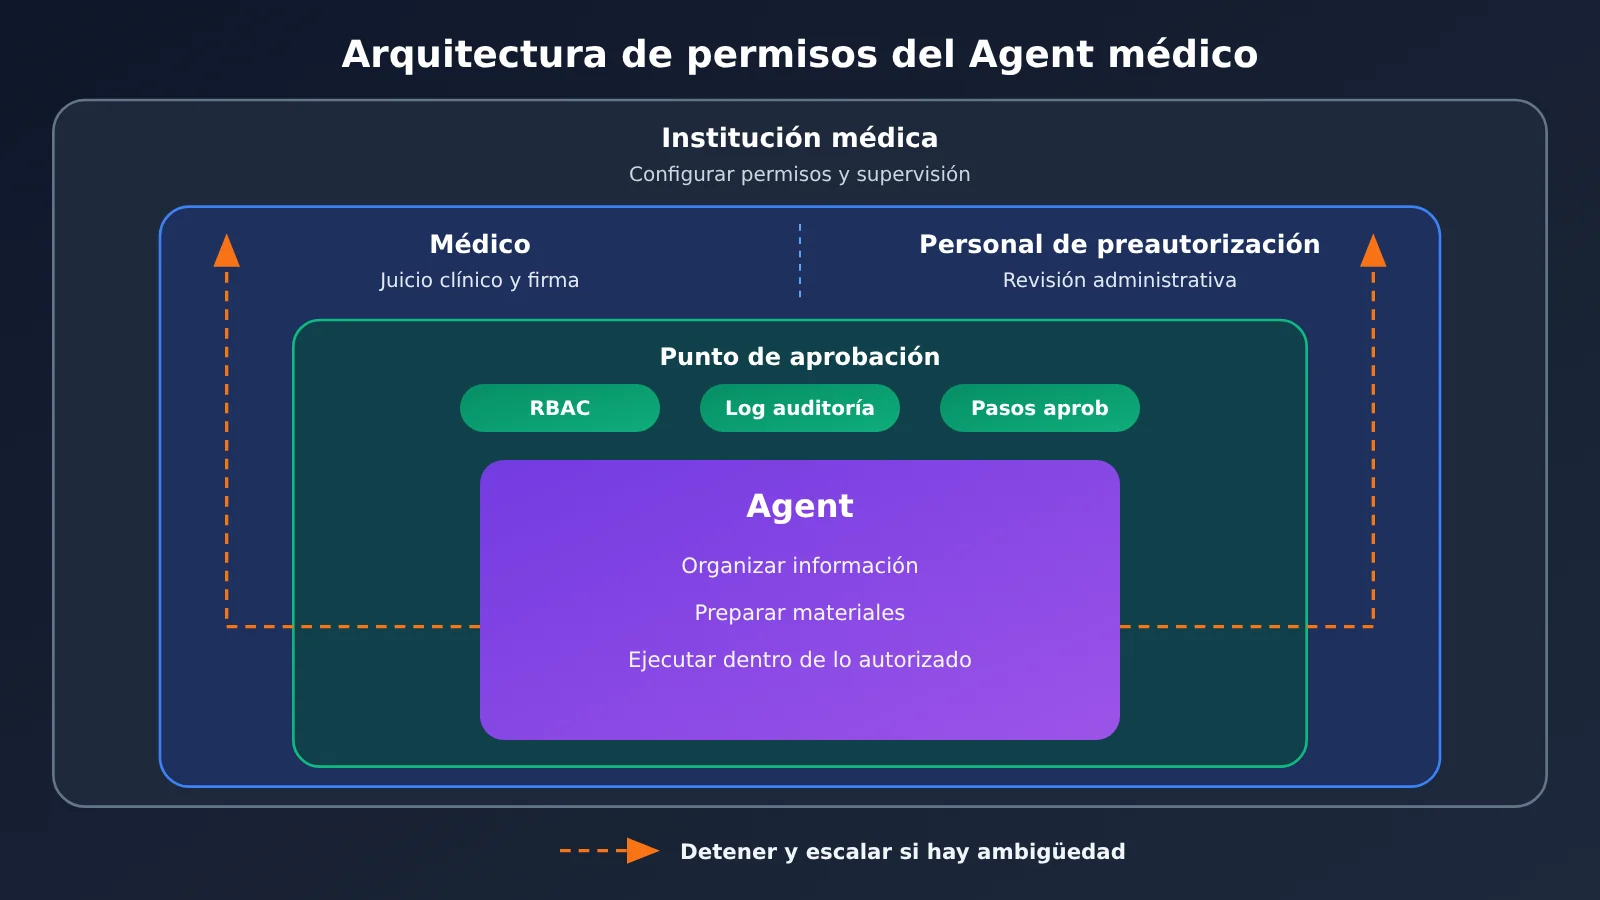
En realidad, se trata de un diseño de separación de responsabilidades: la IA se encarga de organizar información, preparar materiales y ejecutar operaciones dentro del alcance autorizado; los médicos, del juicio clínico; el personal de preautorización, de la revisión administrativa; y las instituciones médicas, de configurar permisos y supervisar procesos. Los permisos del agente deben estar alineados con los límites de la responsabilidad clínica.
En materia de cumplimiento de datos, OpenAI señala que los datos de las organizaciones en ChatGPT for Healthcare no se usarán para entrenar modelos fundacionales, y CVS también indica que los datos de producción relevantes permanecen en su propia infraestructura. Sin embargo, para respaldar flujos de trabajo conformes con HIPAA que impliquen PHI, las organizaciones médicas necesitan usar servicios aptos, asegurarse de que estén cubiertos por un BAA firmado con OpenAI, configurar ajustes de seguridad y políticas de retención de datos, y limitar, mediante permisos organizacionales, los registros y operaciones a los que puede acceder el agente. Por tanto, “ser compatible con flujos de trabajo HIPAA” no significa que “todas las llamadas a la API de OpenAI cumplan automáticamente”.
En cuanto a los canales disponibles, estas capacidades se pueden usar a través de OpenAI API, ChatGPT for Healthcare, ChatGPT for Clinicians, ChatGPT Work y Codex. El personal clínico estadounidense que cumpla los requisitos puede solicitar ChatGPT for Clinicians de forma gratuita; esta política de gratuidad tiene restricciones geográficas y de elegibilidad. ChatGPT for Healthcare no tiene un precio de suscripción fijo y uniforme publicado.
Análisis y criterio: los trade-offs de los agentes médicos y su significado para la industria
¿Por qué el sector sanitario necesita especialmente agentes del tipo Computer Use?
La fragmentación de la información en la atención médica es muy característica. Una sola consulta puede implicar al mismo tiempo el EHR, el sistema de imagenología, el sistema de prescripción, el portal del seguro, el sistema de derivaciones y la plataforma de gestión de altas; estos sistemas suelen venir de fabricantes distintos y sus interfaces no están completas. La autorización previa de una MRI es un ejemplo claro: el médico solo emite un juicio clínico, pero el personal tiene que ir y venir una y otra vez entre el historial médico, los registros de fisioterapia, el material de imagenología y el portal del seguro, copiando y subiendo información.
Desde esta perspectiva, lo que resuelve Computer Use no es «si la IA entiende o no la medicina», sino «si la información puede fluir entre sistemas». Mi valoración es que la automatización administrativa sanitaria podría alcanzar escala comercial antes que la automatización del diagnóstico clínico. La razón es que las tareas administrativas son abundantes, muy repetitivas y con límites claros; los resultados se pueden verificar mediante formularios y estados del sistema, y el riesgo de responsabilidad es relativamente controlable. El caso de Cigna, que comprimió la búsqueda de información en más de 10 sistemas a unos pocos segundos, refleja justamente ese camino de «primero aliviar la carga, sin sustituir».
Sin embargo, el benchmark de Stanford también revela la verdadera dificultad. Investigaciones preliminares encontraron que la transferencia de datos entre aplicaciones y el procesamiento de documentos son fuentes importantes de fallos de los agentes: incluso cuando comprenden la información del paciente, pueden equivocarse al subir archivos, rellenar campos o actualizar estados. En el contexto sanitario, un error en un sistema puede además replicarse a múltiples sistemas posteriores, y es precisamente por eso que la aprobación manual y la verificación del estado tras la operación resultan indispensables.
¿Cómo pueden los desarrolladores evaluar los costos y la viabilidad de un agente médico?
Para los desarrolladores, el primer paso no tiene por qué ser usar Computer Use directamente. Lo más recomendable es dividir primero el flujo de trabajo: los componentes puramente textuales, como la extracción de información y la redacción de materiales, pueden validarse al principio con interfaces de modelos convencionales; la parte de operación de la interfaz se evalúa por separado según su tasa de éxito. El siguiente ejemplo valida el componente textual de «extracción de campos necesarios para la preautorización» usando materiales sintéticos; es solo una demostración técnica y no constituye ninguna recomendación de diagnóstico o tratamiento:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Según la lista de modelos realmente disponibles en la plataforma
    messages=[{"role": "user", "content": "从以下合成病历中列出影像检查预授权需要核对的字段清单:……"}]
)
print(resp.choices[0].message.content)
Ver el código completo con estadísticas de costos de tokens
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Precio unitario: USD / millón de tokens; complétalo según el modelo que uses realmente
PRICE = {"input": 0.10, "output": 0.50, "cached_input": 0.01}

def run_step(prompt: str, model: str = "gpt-4o-mini") -> dict:
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "你只做字段抽取,不给出任何诊疗建议,信息不明确时输出 NEED_HUMAN。"},
            {"role": "user", "content": prompt},
        ],
    )
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    cost = ((u.prompt_tokens - cached) * PRICE["input"]
            + cached * PRICE["cached_input"]
            + u.completion_tokens * PRICE["output"]) / 1_000_000
    return {"text": resp.choices[0].message.content, "cost_usd": round(cost, 6)}

steps = ["合成病历片段 A ……", "合成病历片段 B ……"]
total = 0.0
for s in steps:
    r = run_step(s)
    total += r["cost_usd"]
    print(r["text"])
print("模型 Token 成本合计(不含工具、环境与维护):", round(total, 6))
🚀 Sugerencia para validar rápido: antes de integrarte formalmente en un sistema médico, puedes usar APIYI apiyi.com para comparar varios modelos, con una sola clave API, en componentes textuales como extracción de campos y redacción de materiales. Los nuevos usuarios tienen una cuota de prueba gratuita, ideal para ejecutar de principio a fin el script de evaluación y acumular datos a nivel de tarea.
En cuanto a los costos, los precios Standard de contexto corto consultados el 17 de noviembre de 2026 (USD por millón de tokens) son los siguientes: GPT-6 Astra, entrada 10, salida 50, entrada en caché 1; GPT-6 Luna, entrada 0.10, salida 0.50, entrada en caché 0.01. La velocidad de procesamiento, la longitud del contexto y la región influyen en el cobro real. Si partimos de 0.085 USD por tarea de Luna y de la proporción «98% más baja», Astra costaría aproximadamente 4.25 USD por tarea; sin embargo, se trata de una estimación y de un costo en condiciones de referencia, por lo que no debe considerarse una cotización de producción.
El cálculo completo debería contabilizar por separado, en cada turno, las entradas visuales y de texto y las salidas facturables; además de las llamadas a herramientas, el entorno de ejecución y el mantenimiento de ingeniería. Si los tokens generados por los reintentos ya están acumulados en el total, no los sumes otra vez. La diferencia de precio de casi 50 veces entre los dos niveles de modelos también sugiere un enfoque por capas: la推理 compleja va a modelos de mayor capacidad, los pasos estructurados y de alta frecuencia a modelos de bajo costo, y los flujos que ya se han explorado hasta estabilizarse se convierten en código determinista, como CVS.
💰 Consejo para optimizar costos: al estratificar modelos, primero puedes usar el mismo conjunto de código compatible con OpenAI en APIYI apiyi.com para cambiar entre modelos de distintos precios, medir la calidad y el consumo de tokens de cada tipo de subtarea, y luego decidir qué etapas merecen un modelo de mayor capacidad.
| Etapa de validación | Pregunta a responder | Evidencia sugerida | Herramientas de referencia |
|---|---|---|---|
| Etapa de texto | ¿La calidad de extracción y redacción es estable? | Comparación con anotación manual, tasa de activación de NEED_HUMAN | Comparación de múltiples modelos en APIYI apiyi.com |
| Operación de interfaz | ¿Cuál es la tasa de finalización de extremo a extremo? | Capturas de pantalla y Trace, verificación del estado posterior a la operación | Documentación de OpenAI Computer Use y entorno sandbox |
| Consolidación de procesos | ¿Qué pasos pueden convertirse en código determinista? | Tasa de reproducción de trayectorias exitosas | Arquitectura de dos fases tipo CUA Agent Kit |
| Gobernanza del despliegue | ¿Los permisos y aprobaciones cubren las acciones clave? | Configuración de RBAC, muestreo de logs de auditoría | Sistema propio de permisos y cumplimiento de la institución |
¿Agente médico y RPA: sustitución o fusión?
El RPA tradicional depende de reglas fijas y de la localización de elementos en la interfaz: en cuanto la interfaz cambia, el script puede dejar de funcionar. El Agent con computer use, en cambio, entiende lenguaje natural, observa la interfaz en ese momento y se adapta a los cambios, pero volver a razonar cada vez implica costos y variabilidad en los resultados. En un estudio que compara ambas tecnologías (DOI: 10.1080/23311975.2026.2724760), los procesos P2 y P3 se ejecutaron 10 veces con cada tecnología; en el proceso P1 el Agent registró solo 1 fallo, que no se incluyó en las estadísticas posteriores, así que no se puede afirmar en términos generales que todas las tareas se ejecutaron 10 veces. El estudio utilizó configuraciones de herramientas de 2025, por lo que no representa directamente los resultados de los modelos de 2026.
A juicio del autor, el enfoque de CVS —«exploración con IA, consolidación en código, ejecución repetida»— tiene más probabilidades de convertirse en la forma de ingeniería dominante: el Agent se encarga de descubrir y comprender procesos desconocidos, el código determinista se encarga de repetir de forma estable los procesos ya conocidos, la API sigue asumiendo las interacciones de alta frecuencia y estructura definida, y la aprobación humana protege los nodos críticos. Combinar API, Computer Use, código determinista y aprobación humana resulta más realista que apostar por una sola de estas tecnologías.
¿Qué significa un Agent médico para toda la industria de la IA?
La medicina es solo un campo de pruebas de alto umbral. Su fragmentación de sistemas, requisitos de cumplimiento y límites de responsabilidad son más estrictos que los de una empresa común. Si un Agent de tipo ejecutivo puede establecer aquí una forma de operar auditable, pausable y con permisos alineados, este método puede migrarse a sectores como seguros, finanzas y administración pública, que también dependen de sistemas heredados.
Esto también implica que las dimensiones de la competencia industrial están cambiando. Antes se comparaba si el modelo podía escribir buen contenido; a partir de ahora habrá que comparar más bien si puede completar tareas en sistemas reales, si puede detenerse a tiempo cuando comete errores y si cada paso deja rastro auditable. Para los proveedores de software, Computer Use permite que las empresas de IA participen en flujos de trabajo sin controlar completamente el software subyacente, lo que reduce el umbral de integración y presiona el viejo modelo de «esperar a que el proveedor abra la interfaz». Pero las interacciones de alta fiabilidad y alta frecuencia siguen encajando mejor con API; Computer Use es más un complemento que un sustituto.
Vale la pena seguir de cerca varios puntos: si OpenAI publicará datos de evaluación por tarea y la configuración experimental completa; si la versión en paper de HealthAdminBench podrá convertirse en un criterio unificado de comparación para todos; si el plan de coordinación de altas de Abridge podrá pasar del desarrollo al despliegue; y si los datos de producción de más hospitales podrán demostrar que la tasa de finalización de extremo a extremo es realmente viable. Antes de que aparezcan esas evidencias, las demostraciones y las puntuaciones son solo un punto de partida, no una conclusión.
El Agent médico ya ha demostrado que puede «actuar», pero si realmente puede aliviar la carga clínica y administrativa dependerá de su tasa de finalización de extremo a extremo en flujos de trabajo reales, de su capacidad de detenerse cuando comete errores y de su costo a largo plazo. Como dice el proverbio inglés: The proof of the pudding is in the eating. (El resultado real se comprueba con la práctica.)
Referencias
- Anuncio oficial de OpenAI: Advancing computer-use agents for healthcare teams
- Enlace:
openai.com/index/advancing-computer-use-for-healthcare-teams
- Enlace:
- Documentación de ayuda de ChatGPT for Healthcare: capacidades del producto, BAA y descripción de los plugins
- Enlace:
help.openai.com/en/articles/20001046-chatgpt-for-healthcare
- Enlace:
- Documentación para desarrolladores de OpenAI Computer Use: rutas de Computer Tool y Code Execution
- Enlace:
developers.openai.com/api/docs/guides/tools-computer-use
- Enlace:
- Artículo de HealthAdminBench: tareas y métricas de la versión 2604.09937v1
- Enlace:
arxiv.org/html/2604.09937v1
- Enlace:
- CVS Health CUA Agent Kit: arquitectura de exploración y consolidación en dos fases
- Enlace:
github.com/cvs-health/cua-agent-kit
- Enlace:
- Reportaje de Fierce Healthcare: socios y casos de uso de HLTH26
- Enlace:
fiercehealthcare.com/ai-and-machine-learning/hlth26-cvs-health-cigna-and-ambience-collaborating-openai-test-computer-use
- Enlace:
- Cambridge Dictionary: verificación del texto original del refrán
- Enlace:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Enlace:
Autor: equipo técnico de APIYI
Intercambio técnico: si quieres comparar el desempeño de varios Modelos de Lenguaje Grande en la parte textual de un Agent, puedes visitar APIYI apiyi.com para obtener créditos de prueba; para más detalles sobre la integración, consulta el centro de documentación en docs.apiyi.com