Nota del autor: una guía paso a paso para incorporar los 177 Agent Skills científicos de K-Dense-AI: desde la comprobación del entorno y la selección de habilidades hasta su instalación, la resolución de dependencias y la verificación de que se activan. También veremos cómo solucionar errores y evaluar los riesgos.
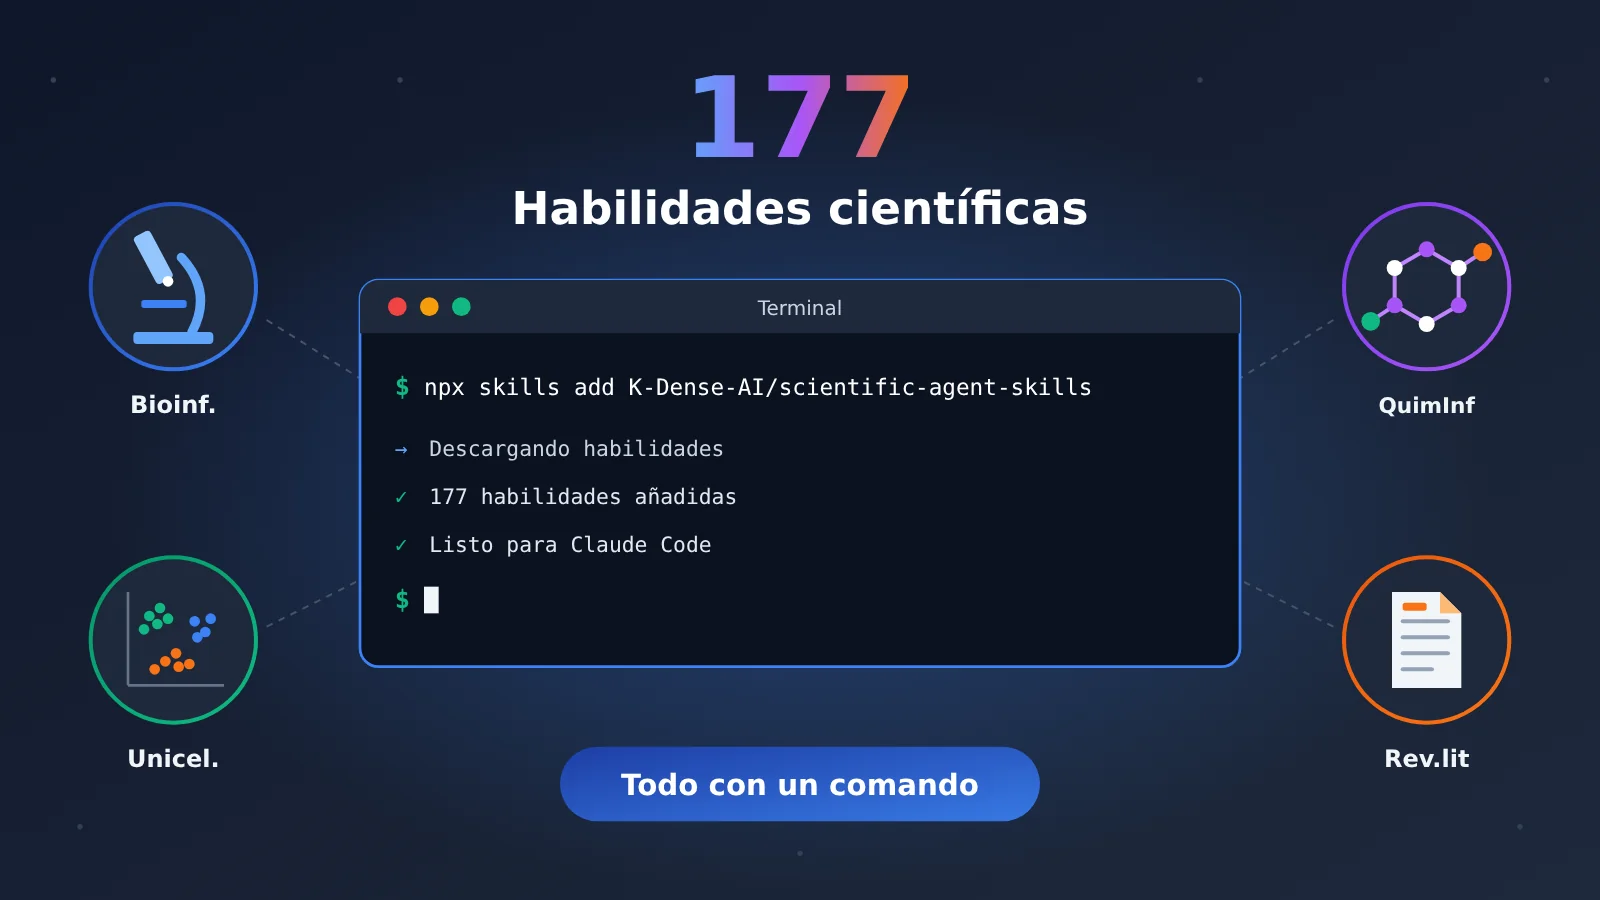
Los Scientific Agent Skills de código abierto de K-Dense-AI son un paquete de 177 habilidades científicas para agentes de programación como Claude Code y Cursor. Convierten flujos de trabajo como el análisis de células individuales, la quimioinformática, la revisión de literatura y la búsqueda en bases de datos en manuales que un agente puede entender. Así no tienes que escribir desde cero el flujo de control de calidad, revisar la documentación de las API ni comprobar los DOI cada vez. Eso sí, no conviene instalarlos todos de golpe: estas habilidades permiten al agente ejecutar código, instalar paquetes y conectarse a Internet, y la instalación de los archivos de habilidades no incluye automáticamente las dependencias de Python.
No es una recomendación del tipo «instálalo y serás invencible», sino una guía de integración en cinco pasos, con resultados que puedes comprobar en cada uno.
Qué conseguirás: al terminar, podrás elegir entre 5 y 10 habilidades científicas que necesites para tu área, instalarlas en el directorio correcto, añadir sus dependencias y conseguir que el agente las utilice de verdad, con resultados y cifras que podrás verificar uno por uno.
¿Qué incluyen los 177 Skills de investigación?
El repositorio es K-Dense-AI/scientific-agent-skills y tiene licencia MIT. Al 28 de octubre de 2026, contaba con 54.959 estrellas, 4.846 forks y 177 subdirectorios en skills/. Su versión más reciente era la 2.72.0. El README afirma que lo usan «más de 250.000 científicos» y que es la «biblioteca n.º 1 de Agent Skills para ciencia», pero son cifras declaradas por sus responsables, no estadísticas de terceros. El artículo que acompaña al proyecto es arXiv:2609.00065.
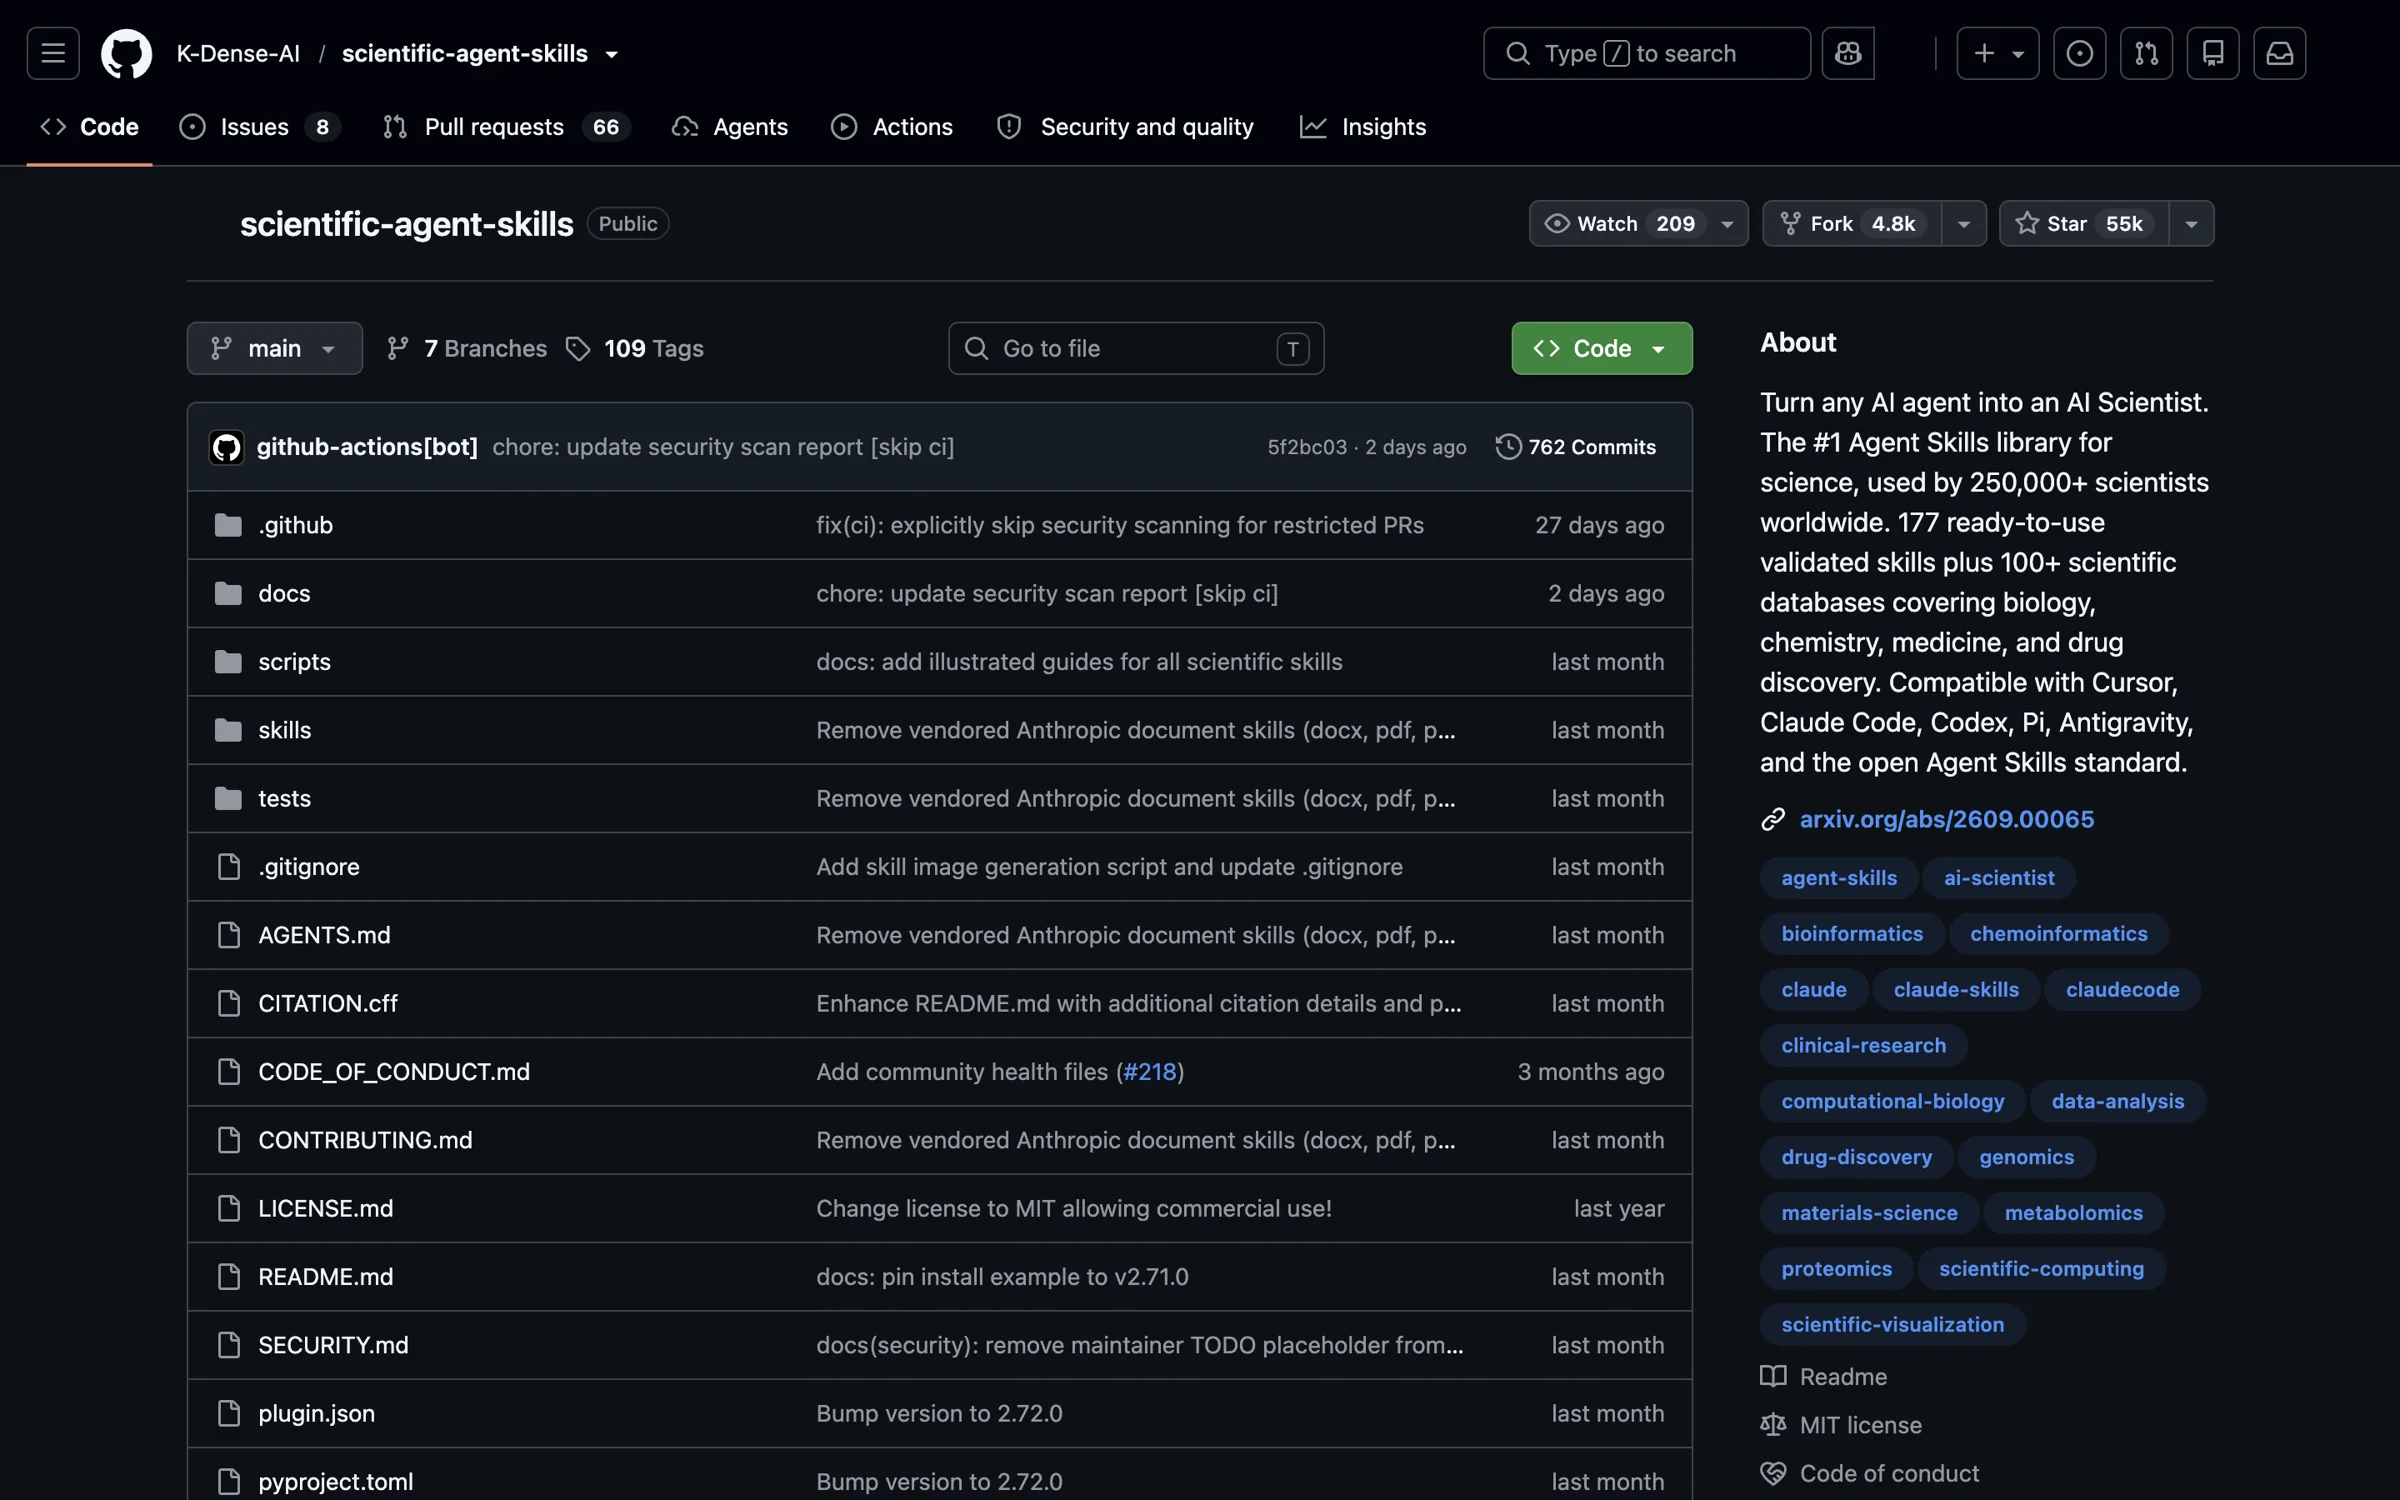
Figura 1: Página principal del repositorio, capturada el 28 de octubre de 2026, con 55.000 estrellas y 4.800 forks. La sección About indica que incluye 177 habilidades y más de 100 bases de datos.
¿Por qué 177? La versión 2.71.0 incluía 181 habilidades. A partir de la 2.72.0, las cuatro habilidades para documentos —docx, pdf, pptx y xlsx— dejaron de distribuirse con el repositorio. Si las necesitas, debes instalarlas por separado desde el repositorio de Anthropic.
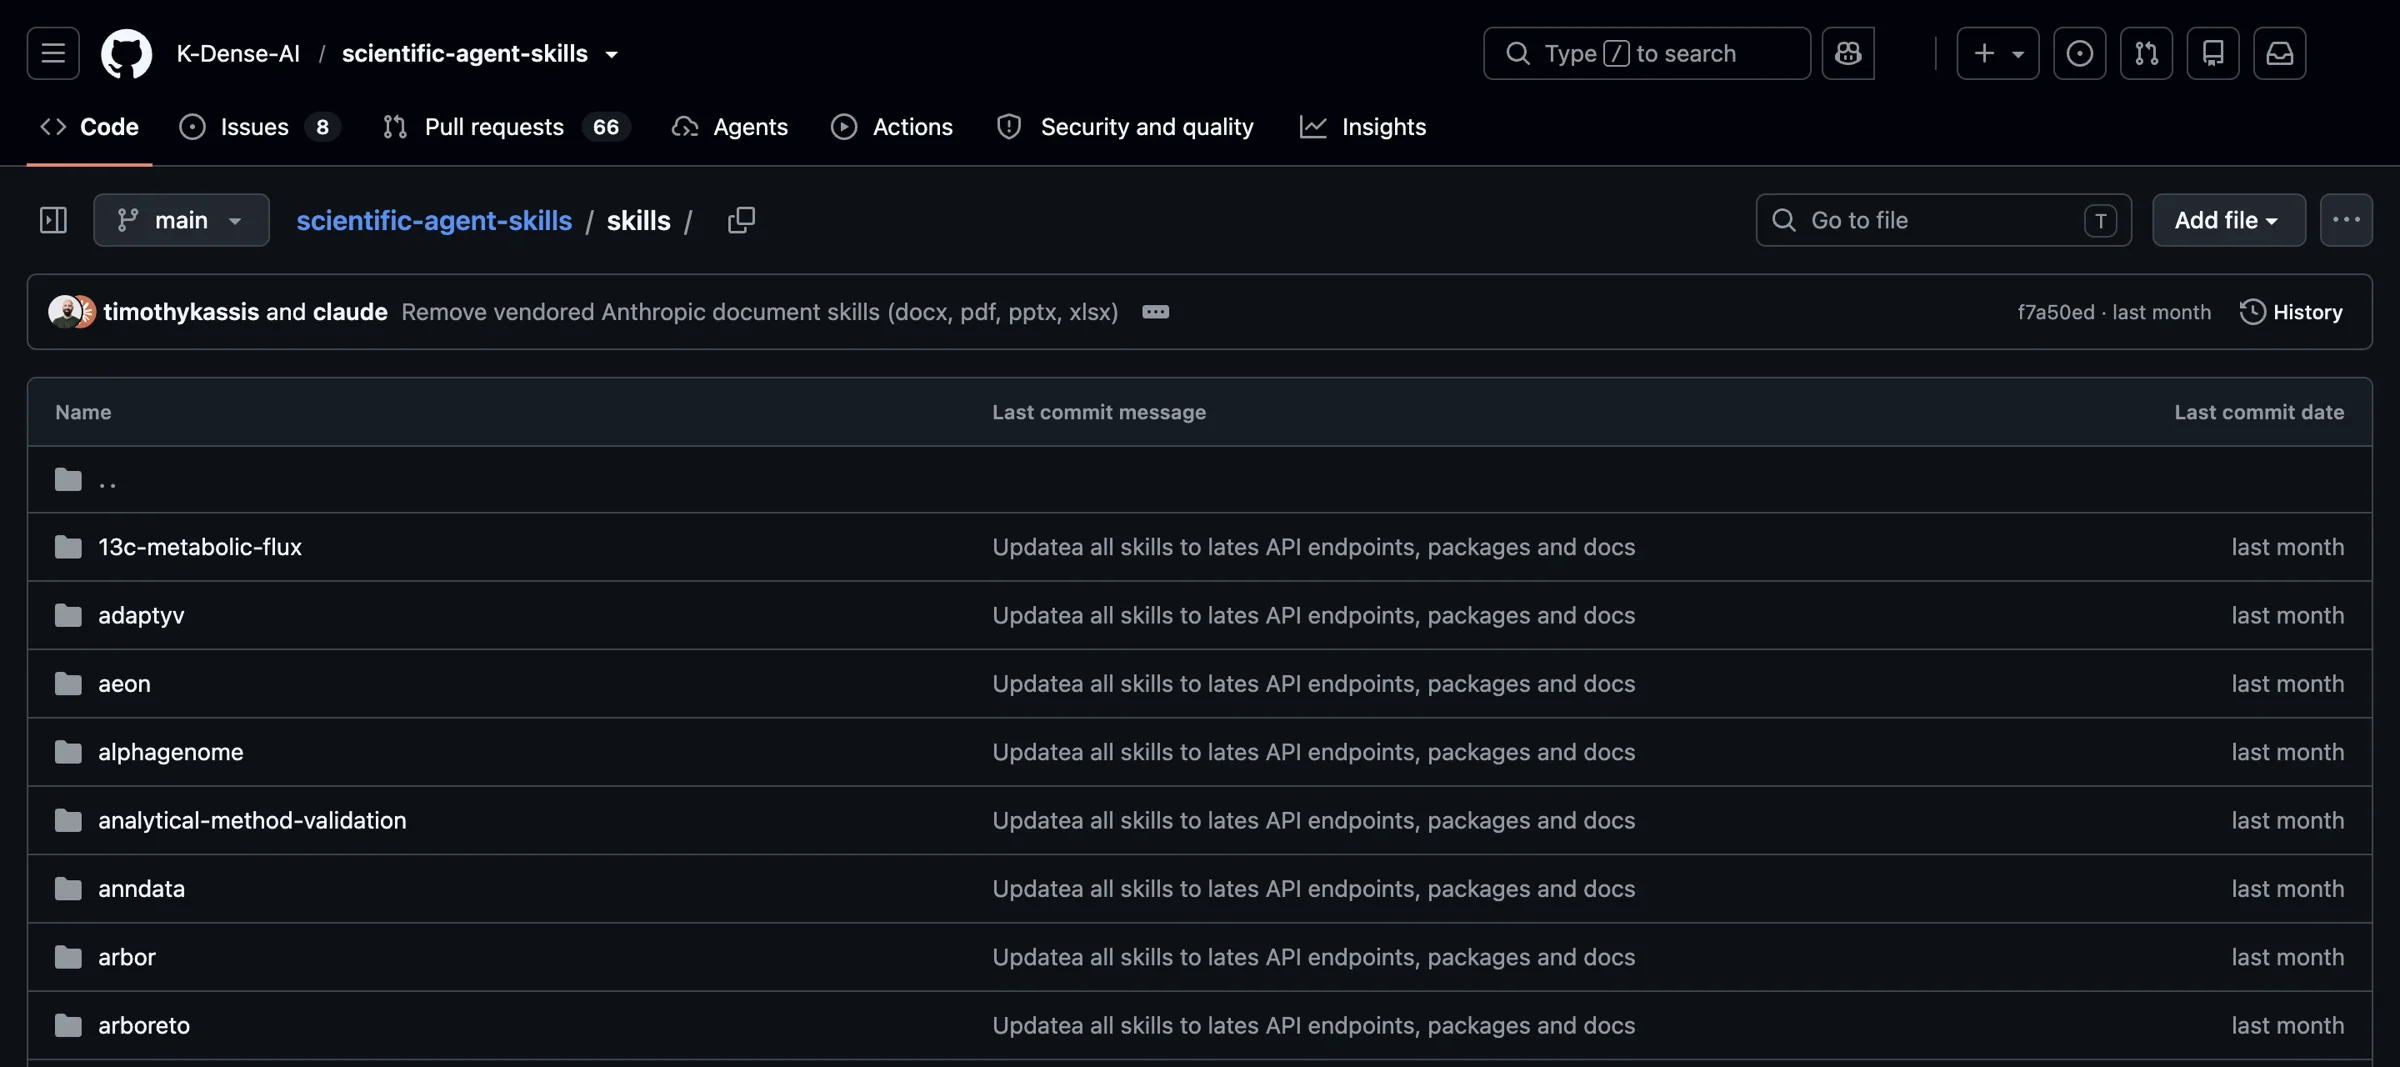
Figura 2: El directorio skills/ muestra decenas de carpetas de habilidades en una sola pantalla. El mensaje del commit más reciente dice «Remove vendored Anthropic document skills»: ese fue el cambio que redujo la cifra de 181 a 177.
El README divide todas las habilidades en 22 categorías principales. La siguiente tabla las reúne por áreas y muestra solo algunas habilidades y paquetes representativos, sin enumerarlos todos:
| Área (categorías principales del README) | Habilidades / paquetes representativos | Usos habituales |
|---|---|---|
| Bioinformática, multiómica, proteómica y espectrometría de masas | scanpy, pydeseq2, pyopenms, nextflow; habilidades para paquetes como scVelo |
Control de calidad y agrupamiento de células individuales, expresión diferencial, procesamiento de espectrometría de masas y orquestación de flujos de trabajo |
| Quimioinformática y descubrimiento de fármacos, ciencia de materiales | rdkit, pymatgen |
Filtrado y descriptores moleculares, estructuras cristalinas y cálculos de materiales |
| Física y astronomía, ingeniería y simulación | qiskit; habilidades para paquetes como QuTiP |
Circuitos cuánticos y simulación de sistemas cuánticos |
| Investigación clínica, IA médica, normativas y estándares | clinical-reports; habilidades para paquetes como pydicom |
Borradores de informes clínicos y lectura de imágenes médicas |
| Análisis y visualización de datos, aprendizaje automático, datos geoespaciales | scientific-visualization, timesfm-forecasting; habilidades para paquetes como scikit-learn, PyTorch Lightning y GeoPandas |
Gráficos con calidad de publicación, predicción de series temporales, modelado y análisis de datos espaciales |
| Comunicación científica, metodología de investigación | literature-review, scientific-writing, paper-lookup, paperzilla, scientific-slides, research-grants, peer-review, generate-image |
Revisiones sistemáticas, redacción de artículos, diapositivas para reuniones de equipo, solicitudes de financiación y comentarios de revisión |
| Consulta de bases de datos | database-lookup; habilidades específicas como DepMap, Imaging Data Commons, PrimeKG, NCATS ARAX y AlphaGenome |
Consultas unificadas a fuentes de datos públicas, que requieren registro o autorización |
Solo el skill database-lookup reúne 80 fuentes de datos. Si se suman los skills especializados y los paquetes que cubren varias bases de datos, el README anuncia más de 100 bases de datos. También hay más de 70 skills para paquetes de Python, entre ellos RDKit, Scanpy, scikit-learn, PyTorch Lightning, pydicom, QuTiP, GeoPandas, pymatgen, Qiskit, scVelo y TimesFM. Cada skill especifica las versiones del paquete compatibles y cómo usarlo.
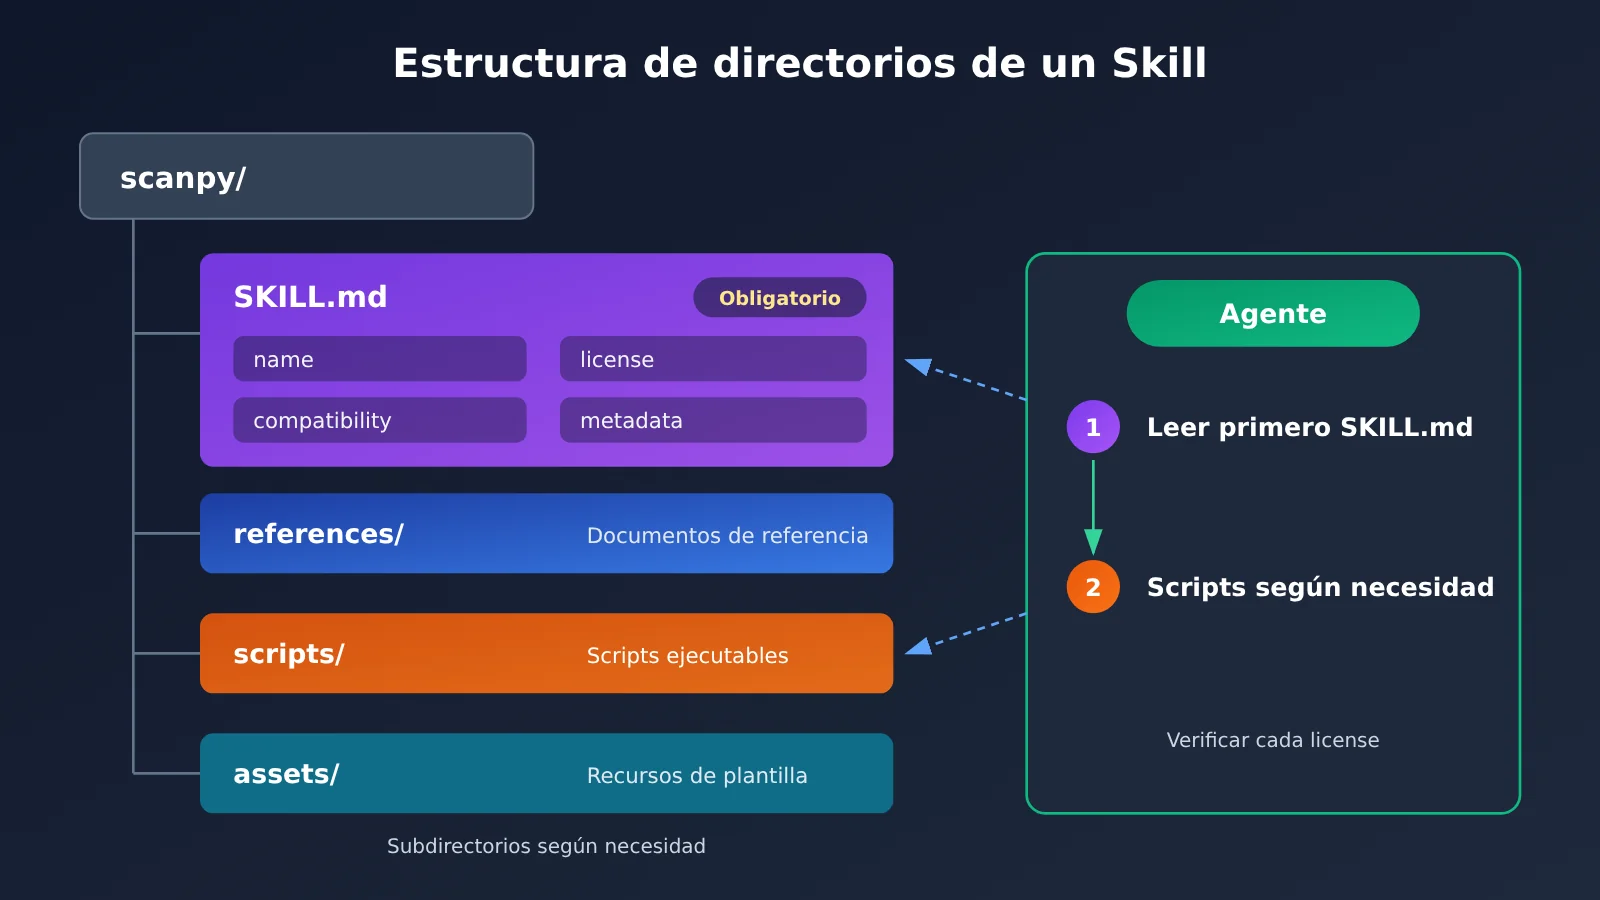
Estructura de directorios de un skill para investigación científica
Cada skill es una carpeta que debe incluir SKILL.md. Los directorios references/, scripts/ y assets/ se incluyen según sea necesario. Por ejemplo, el frontmatter de scanpy indica que la licencia es BSD-3-Clause, requiere Python 3.12+, tiene metadata.version 1.8 y last-reviewed 2026-10-01.
Hay un detalle fácil de pasar por alto: el repositorio en su conjunto tiene licencia MIT, pero cada skill declara su propia licencia en el campo license de SKILL.md, y puede ser distinta de la del repositorio. Si vas a usarlo comercialmente o redistribuirlo, revisa cada licencia por separado.
Proceso de integración de Skills para investigación en 5 pasos
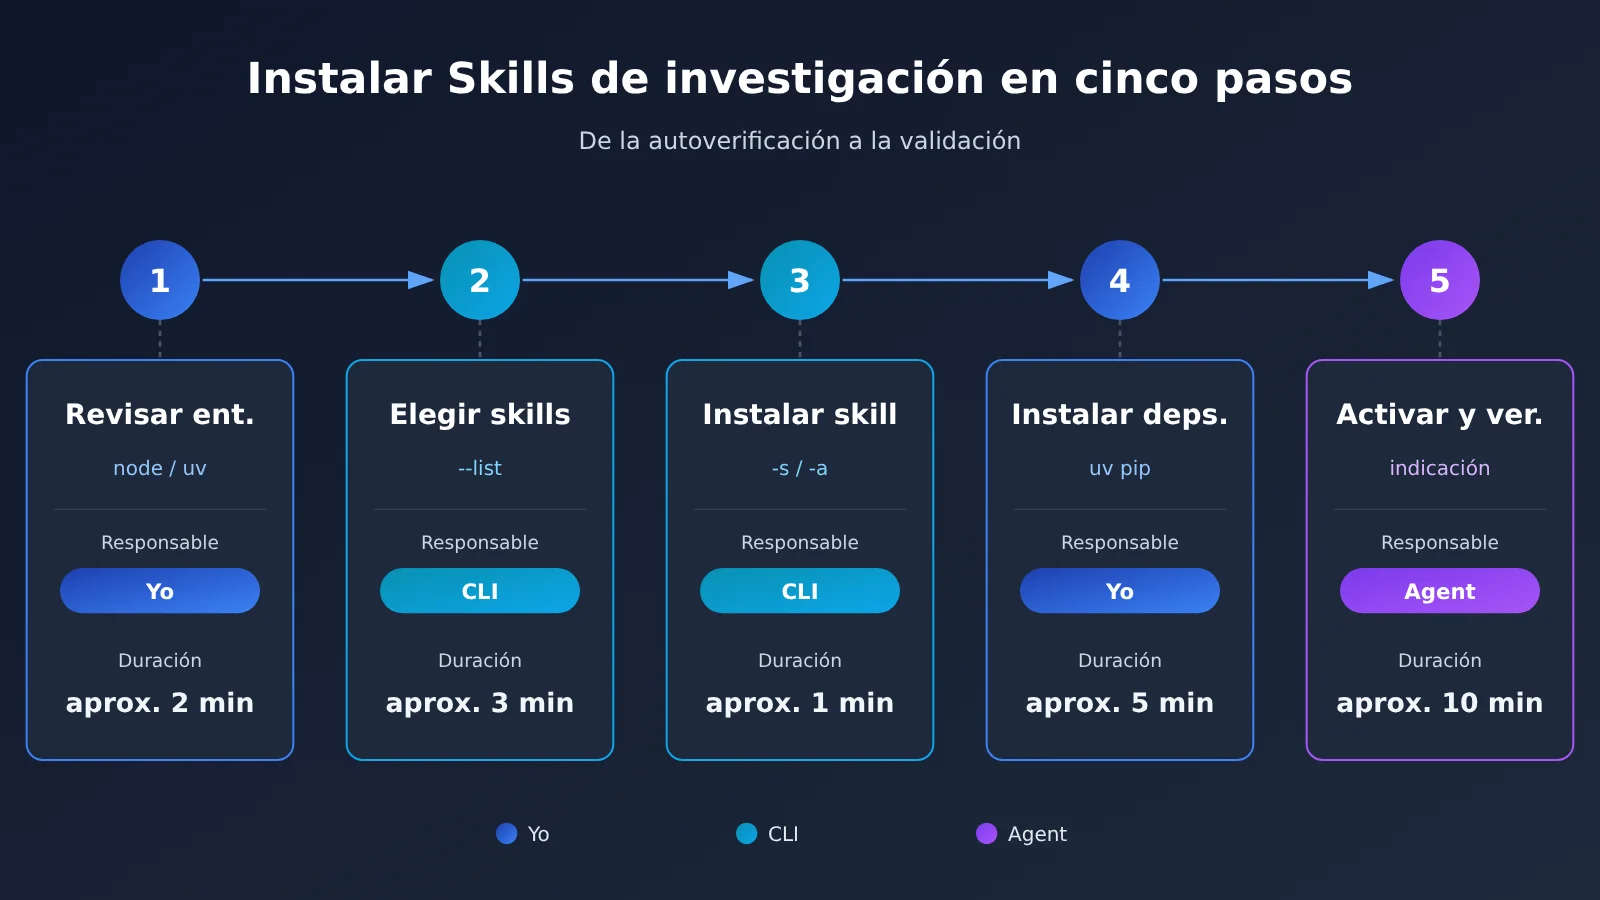
El proceso completo tiene cinco pasos: revisar el entorno → consultar la lista y elegir habilidades → instalar solo las necesarias → añadir dependencias y credenciales → activarlas y comprobar que funcionan. En cada paso indicamos si los comandos los ejecutas tú, la herramienta de línea de comandos o el Agent.
Paso 1: Entender cómo se instalan las Skills para investigación y qué requisitos tienen
Tiempo estimado: unos 5 minutos Requisito previo: poder abrir una terminal Dificultad: baja (puedes omitirlo si ya tienes todo preparado)
Qué hacer: ejecuta tú mismo los siguientes comandos de comprobación, uno por uno, para saber si puedes instalar directamente, si primero necesitas alguna herramienta o si tu entorno no es compatible.
node -v: el instaladornpx skillsrequiere Node.js 22.20 o superiorpython3 --version: la cadena de herramientas incluida en el repositorio requiere Python 3.13 o superior (el rango de dependencias de cada habilidad se especifica en su apartado de compatibilidad)uv --version: uv se usa para instalar las dependencias de las habilidadesgh --version: solo es necesario si planeas instalar mediante GitHub CLI; la versión debe ser superior a 2.90.0- Sistema: macOS, Linux o Windows + WSL2
Qué verás: cada comando muestra un número de versión. Si aparece command not found, significa que esa herramienta aún no está instalada.
Cómo comprobar que todo está listo: la versión de Node debe ser al menos la v22.20, la de Python al menos la 3.13, uv debe mostrar su número de versión y el entorno que utilizas debe ser compatible con el estándar Agent Skills. El instalador skills (paquete npm, vercel-labs/skills, licencia MIT, última versión 1.7.4) admite oficialmente más de 70 entornos, entre ellos Claude Code, Cursor, Codex, Gemini CLI, Antigravity y OpenClaw. Las habilidades no están vinculadas a ningún modelo: tú decides qué modelo usa el entorno. En el paso 5 veremos cómo conectar el modelo a APIYI.
Paso 2: revisa la lista de Skills para investigación antes de decidir cuáles instalar
Tiempo: unos 10 minutos Requisito previo: haber completado el paso 1 Dificultad: baja (no se recomienda omitirlo)
Qué hacer: ejecuta el comando que solo muestra la lista, sin instalar nada. La herramienta de línea de comandos descargará el repositorio y leerá los nombres y las descripciones de todas las Skills, pero no instalará ninguna en tu equipo.
npx skills add K-Dense-AI/scientific-agent-skills --list
Qué verás: la terminal mostrará 177 Skills, cada una con su nombre y una breve descripción.
Aviso tras probarlo: este paso primero clona el repositorio completo en tu equipo, y ocupa más de 400 MB. Si la conexión es lenta, la terminal puede quedarse durante bastante tiempo en Cloning repository…; pasados 300 segundos, mostrará el error Clone timed out. Para ampliar el tiempo de espera, vuelve a ejecutar el comando con SKILLS_CLONE_TIMEOUT_MS=600000 (10 minutos). También puedes ejecutar primero git clone y después usar skills add con el directorio local.
Criterio de comprobación: tienes una lista de 5 a 10 Skills candidatas. El README dice literalmente “Do not install everything at once” («No instales todo de una vez»), y la recomendación oficial también es no instalarlas todas juntas. Cuantas más Skills instales, más difícil será para el agente elegir la adecuada y más código tendrás que revisar.
Puedes elegirlas según tu área:
- Bioinformática:
scanpy,pydeseq2ydatabase-lookup; añadepyopenmssi trabajas con espectrometría de masas - Quimioinformática:
rdkitydatabase-lookup; añadepymatgensi trabajas con materiales - Bibliografía y redacción:
literature-review,paper-lookup,scientific-writingypeer-review - Visualización de datos:
scientific-visualization; añadetimesfm-forecastingsi trabajas con series temporales - Automatización de laboratorio: consulta la salida de
--listpara ver los nombres concretos de las Skills de esta categoría; para la orquestación de flujos de trabajo, puedes empezar pornextflow
Paso 3: Instala solo las skills de investigación que necesitas
Tiempo: unos 5 minutos Requisito previo: tener una lista de candidatas Dificultad: media
Qué hacer: ejecuta tú mismo el comando de instalación. La herramienta de línea de comandos se encargará de escribir las skills en el directorio del agente. El «un solo comando» del título se refiere a npx skills add K-Dense-AI/scientific-agent-skills. Si lo ejecutas directamente, entrarás en modo interactivo y podrás seleccionar las skills y los agentes. Si seleccionas todas las skills, las instalarás todas, algo que no recomendamos.
Significado de los parámetros:
-s/--skill: especifica el nombre de la skill;'*'significa todas-a/--agent: especifica el agente, por ejemplo,claude-codeocodex-g: instala en el directorio de usuario (global); sin este parámetro, instala en el proyecto actual--copy: copia los archivos; por defecto se usan enlaces simbólicos (symlinks), que mantienen una sola copia local y facilitan las actualizaciones-y: omite la confirmación, útil para scripts o CI
Comandos no interactivos que puedes copiar directamente (con Claude Code y una instalación a nivel de proyecto como ejemplo; cada línea instala una skill):
npx skills add K-Dense-AI/scientific-agent-skills -s scanpy -a claude-code -ynpx skills add K-Dense-AI/scientific-agent-skills -s database-lookup -a claude-code -ynpx skills add K-Dense-AI/scientific-agent-skills -s pydeseq2 -a claude-code -y
Para instalar a nivel global, añade -g al final del comando; si prefieres copiar los archivos en lugar de usar enlaces simbólicos, añade --copy. Para instalar varias skills a la vez, consulta las instrucciones de npx skills add --help.
| Agente | Directorio del proyecto | Directorio global |
|---|---|---|
| Claude Code | .claude/skills/ |
~/.claude/skills/ |
| Cursor | .agents/skills/ |
~/.cursor/skills/ |
| Codex | .agents/skills/ |
~/.agents/skills/ |
| Gemini CLI | .agents/skills/ |
~/.gemini/skills/ |
| Antigravity | .agents/skills/ |
~/.gemini/antigravity/skills/ |
| OpenClaw | skills/ |
~/.openclaw/skills/ |
Cómo elegir entre instalación a nivel de proyecto y global: instala en el proyecto las skills que solo estén relacionadas con un trabajo concreto, como pydeseq2 para un proyecto de análisis específico. Así podrás compartirlas con el equipo junto con el proyecto. Instala globalmente las que uses a diario, como las de búsqueda bibliográfica y redacción.
Qué verás: el instalador confirmará que cada skill se ha instalado correctamente y mostrará la ruta de destino.
Criterio de comprobación: ejecuta tú mismo npx skills list o directamente ls .claude/skills/ para confirmar que están todos los directorios de las skills recién instaladas y que cada uno contiene un archivo SKILL.md.
También hay otras dos formas de instalarlas:
gh skill install K-Dense-AI/scientific-agent-skills --agent claude-code --pin v2.71.0: usa--pinpara fijar una versión o un SHA de commit, ideal para proyectos cuyos resultados deban ser reproduciblesgit cloneen~/.agents/skills/scientific-agent-skills(a nivel de usuario) o en.agents/skills/scientific-agent-skills(a nivel de proyecto)
Paso 4: Completa las dependencias de Python y las credenciales de los Skills científicos
Tiempo: 10-30 minutos (según el tamaño de los paquetes) Requisito previo: los Skills ya están instalados Dificultad: media (no se puede omitir)
Qué hacer: este es el paso donde más suelen aparecer problemas, así que vale la pena repetirlo: instalar los archivos de un Skill ≠ instalar sus dependencias. Abre personalmente el archivo SKILL.md de cada Skill, revisa el campo compatibility e instala las dependencias con uv. Ten en cuenta que uv sync solo instala las herramientas de desarrollo y validación del repositorio, no todos los paquetes de computación científica.
cat .claude/skills/scanpy/SKILL.md: revisa compatibility; el Skill de scanpy indica que se ha probado con Python 3.13 + Scanpy 1.12.4 + AnnData 0.13.4uv venv .venv-scrna --python 3.13: crea un entorno independiente para cada flujo de trabajo y evita conflictos entre los paquetes de análisis de células individuales y los de quimioinformáticasource .venv-scrna/bin/activateuv pip install "scanpy[leiden]"
Algunos Skills necesitan una clave propia. Por ejemplo, generate-image usa la API de imágenes de OpenRouter, por lo que debes configurar export OPENROUTER_API_KEY=你的Key; además, se cobra por uso. Listar los modelos o añadir --dry-run no tiene costo, así que conviene empezar por ahí. literature-review necesita conexión a internet para validar los DOI, y para exportar a PDF también debes instalar Pandoc y XeLaTeX.
Si ya usas APIYI, no necesitas abrir otra cuenta de OpenRouter para generar imágenes: la documentación de APIYI incluye dos Skills aportados por la comunidad: apiyi-gpt-image-2-gen (acceso oficial a gpt-image-2, facturación por tokens y compatibilidad con 4K y tamaños personalizados) y apiyi-gpt-image-2-all-gen (acceso mediante ingeniería inversa, $0.025 por uso y edición de imágenes mediante conversación). Después de instalarlos en Cursor, Codex CLI, Gemini CLI, OpenCode, GitHub Copilot o Amp, basta con decir: «Usa apiyi-gpt-image-2-gen para generar una imagen de 3840×2160». La clave se configura mediante la variable de entorno APIYI_API_KEY.
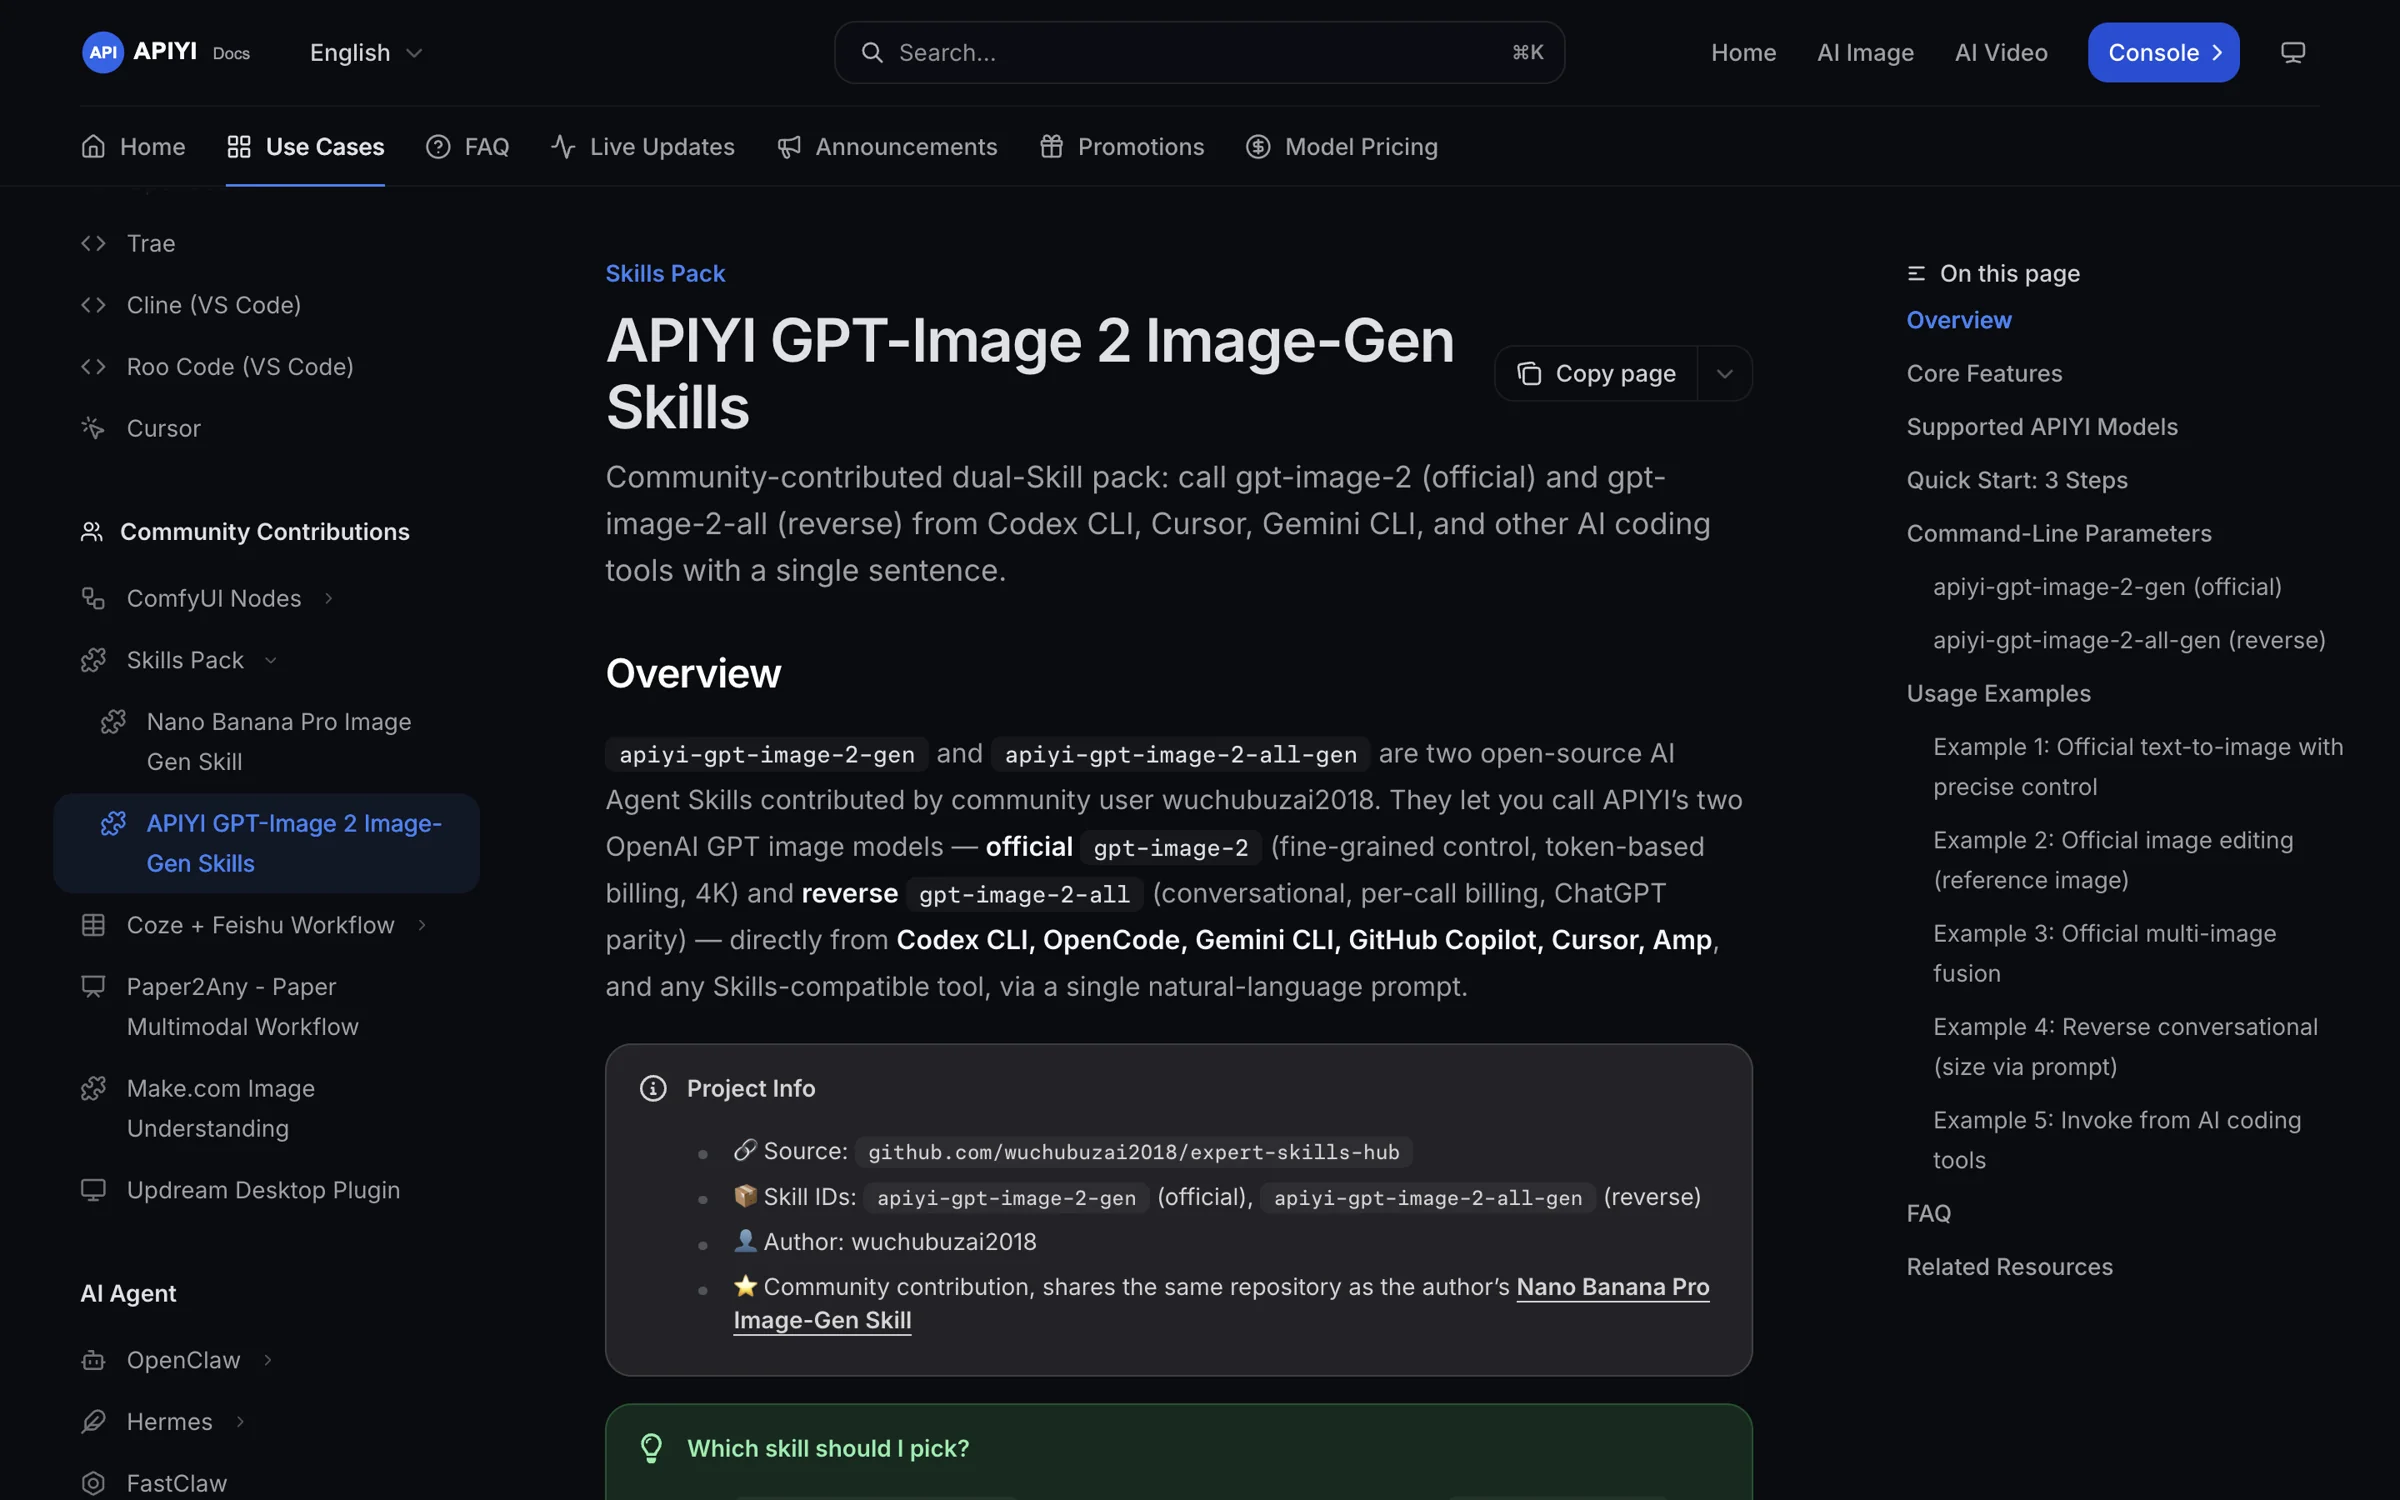
Figura 3: página de la colección de Skills en la documentación de APIYI. Ambos Skills de generación de imágenes indican el identificador del modelo, el método de facturación y cómo investigar errores de instalación.
Qué verás: uv mostrará la lista de paquetes que ha resuelto e instalado.
Criterio de verificación: ejecuta personalmente python -c "import scanpy, anndata; print(scanpy.__version__, anndata.__version__)" y comprueba que las versiones coincidan con el campo compatibility. Para los Skills que necesitan una clave, usa echo $OPENROUTER_API_KEY | head -c 6 y confirma que la variable de entorno esté activa.
Paso 5: Activar las skills de investigación y verificar los resultados
Tiempo: unos 10 minutos Requisito previo: dependencias instaladas Dificultad: baja
Qué hacer: reinicia el host para que vuelva a buscar en el directorio de skills. Después, escribe una indicación en el chat y deja que el agente haga el resto: leer SKILL.md, ejecutar scripts y generar los archivos. Se recomienda combinar una frase inicial general con el nombre de la skill:
- Empieza con
Use available skills you have access to whenever possible. - Luego nombra la skill, por ejemplo: «Usa la skill literature-review para hacer una revisión sistemática»
Qué verás: la respuesta del agente indicará qué skill leyó y qué comandos va a ejecutar.
Criterios de verificación (comprueba los tres):
- ¿El agente indicó claramente qué skill usó? Si no lo hizo, pregúntale: «¿Qué skill usaste?»
- ¿En qué directorio quedaron los archivos generados? Comprueba con
lsque realmente existan. - ¿Coinciden los datos del resultado con sus fuentes? Comprueba si los DOI se pueden abrir y si se pueden encontrar los ID de las entradas en las bases de datos.
Comandos de mantenimiento habituales (ejecútalos tú): npx skills check busca actualizaciones, npx skills update actualiza y npx skills remove desinstala. El instalador recopila datos de uso anónimos de forma predeterminada; puedes desactivarlo con DISABLE_TELEMETRY=1 o DO_NOT_TRACK=1.
🎯 Primero haz que funcione y luego calcula los costos: las skills son gratuitas y de código abierto; lo que cuesta dinero son las invocaciones del modelo al ejecutarlas. Un flujo completo de análisis de célula única suele requerir varias rondas de lectura de documentación, escritura de código y corrección de errores, por lo que puede consumir bastantes tokens. Si tu host admite endpoints compatibles con OpenAI personalizados, puedes configurar
base_urlcomohttps://api.apiyi.com/v1y usar una sola clave con APIYI apiyi.com para cambiar entre modelos como Claude, GPT y Gemini. Así podrás comparar el rendimiento y el costo de ejecutar la misma skill con distintos modelos. En Claude Code, por ejemplo, basta con configurar dos variables de entorno:ANTHROPIC_BASE_URLcon el valorhttps://api.apiyi.comyANTHROPIC_AUTH_TOKENcon tu clave. Una vez configuradas, las skills seguirán funcionando en Claude Code.
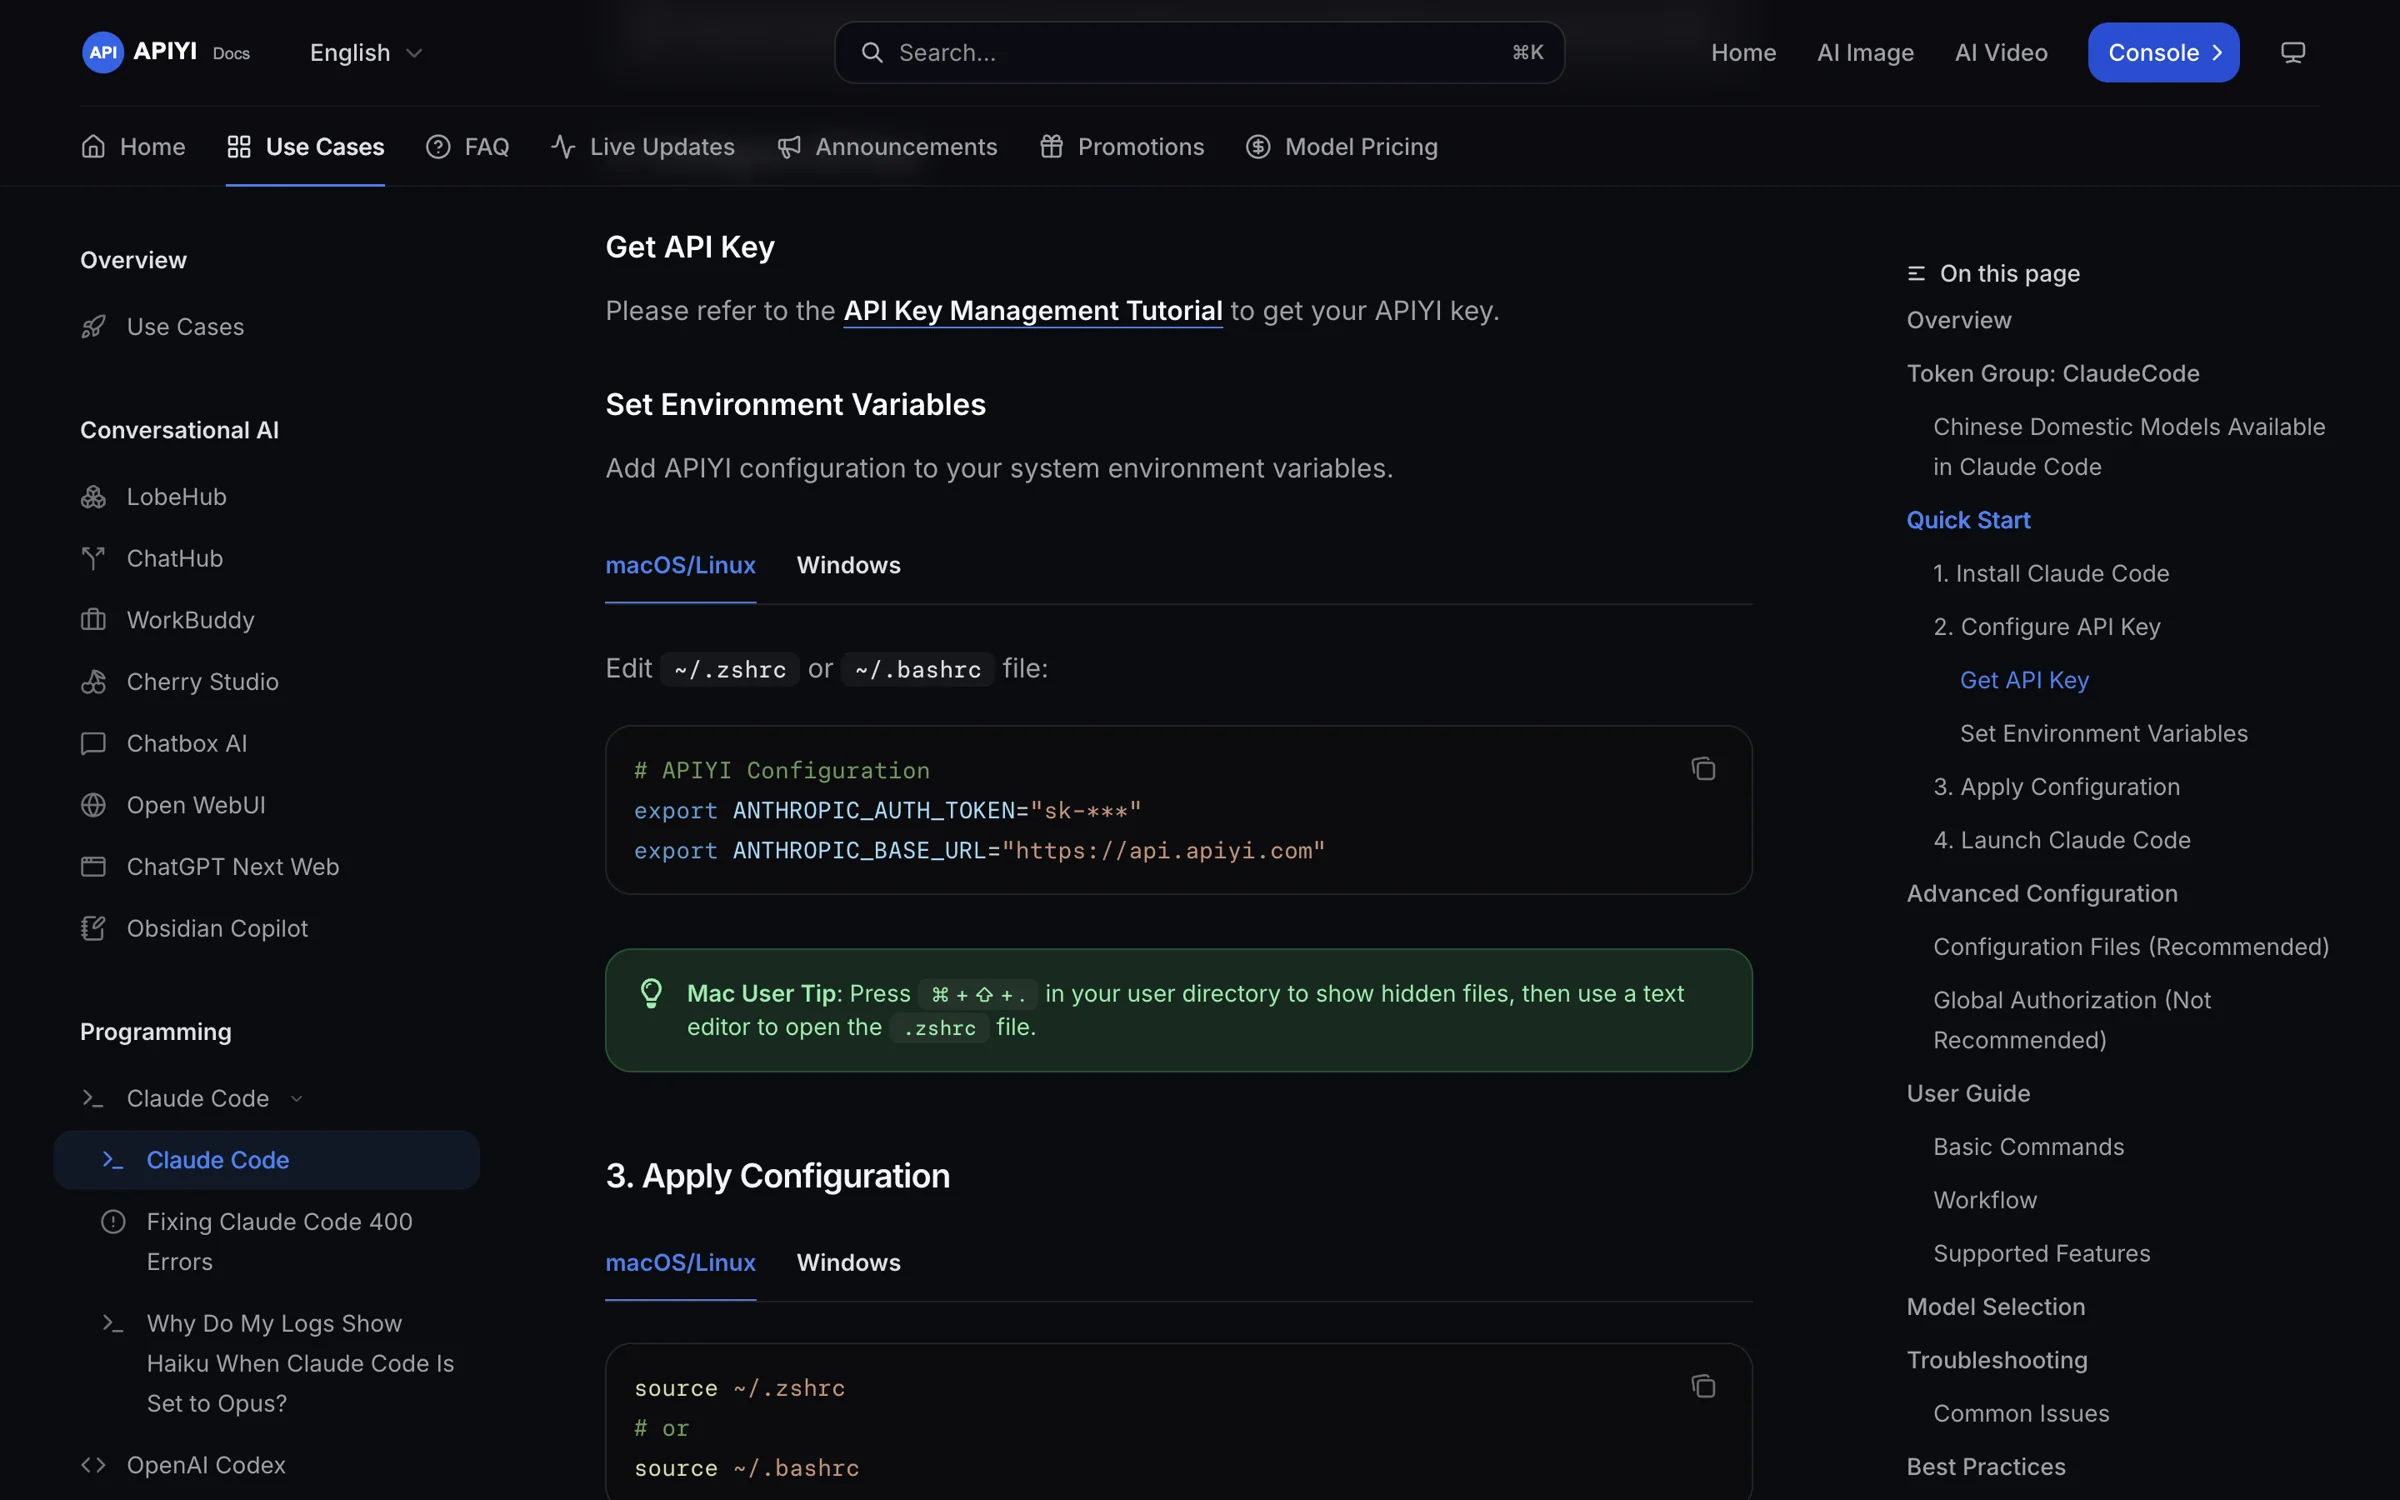
Figura 4: Configuración de Claude Code en la documentación de APIYI: solo se necesitan dos variables de entorno (la clave está oculta en la captura).
| Modelo | Entrada | Salida | Lectura de caché | Plataforma disponible |
|---|---|---|---|---|
| claude-opus-5-5 | $4 / millón de tokens | $20 / millón de tokens | $0.2 / millón de tokens | APIYI apiyi.com |
Consulta la lista de modelos de la plataforma para conocer los modelos y precios vigentes. Las indicaciones para las skills de investigación incluyen repetidamente el mismo archivo SKILL.md. Como la lectura de caché cuesta solo una vigésima parte de la entrada, puede suponer un ahorro considerable en sesiones largas.
Tres escenarios reales para poner en marcha por primera vez los Skills de investigación
Escenario uno: análisis de células individuales
Indicación: Use available skills you have access to whenever possible. Después, añade: «Usa scanpy para el control de calidad, la normalización, la reducción de dimensionalidad y el agrupamiento; cellxgene-census como referencia para los tipos celulares; database-lookup para consultar genes marcadores; y pydeseq2 para analizar la expresión diferencial». El agente leerá estos Skills en orden, generará los scripts de análisis y los ejecutará.
Al revisar el resultado, fíjate en tres cosas: que los umbrales de control de calidad estén indicados, que exista el archivo con los resultados del agrupamiento y que los genes expresados diferencialmente se puedan encontrar en las fuentes de datos que devuelve database-lookup.
Escenario dos: revisión de la literatura
Indicación: «Usa el Skill literature-review para hacer una revisión sistemática sobre un tema concreto, completa la bibliografía con paper-lookup y, por último, organiza todo en un primer borrador con scientific-writing». Este Skill comprueba los DOI en línea, así que abre cada DOI para confirmar que la publicación existe y que los autores y el año son correctos.
Escenario tres: cribado de compuestos
Indicación: «Usa database-lookup para obtener un conjunto de moléculas candidatas de PubChem y ChEMBL, fíltralas con rdkit por peso molecular de 300 a 500 y logP de 2 a 4, y exporta los resultados a un CSV». Para revisar el resultado, comprueba personalmente algunas entradas: recalcula el peso molecular con RDKit y verifica que coincida con el del CSV; después, busca los ID de los compuestos en PubChem para confirmar que corresponden.
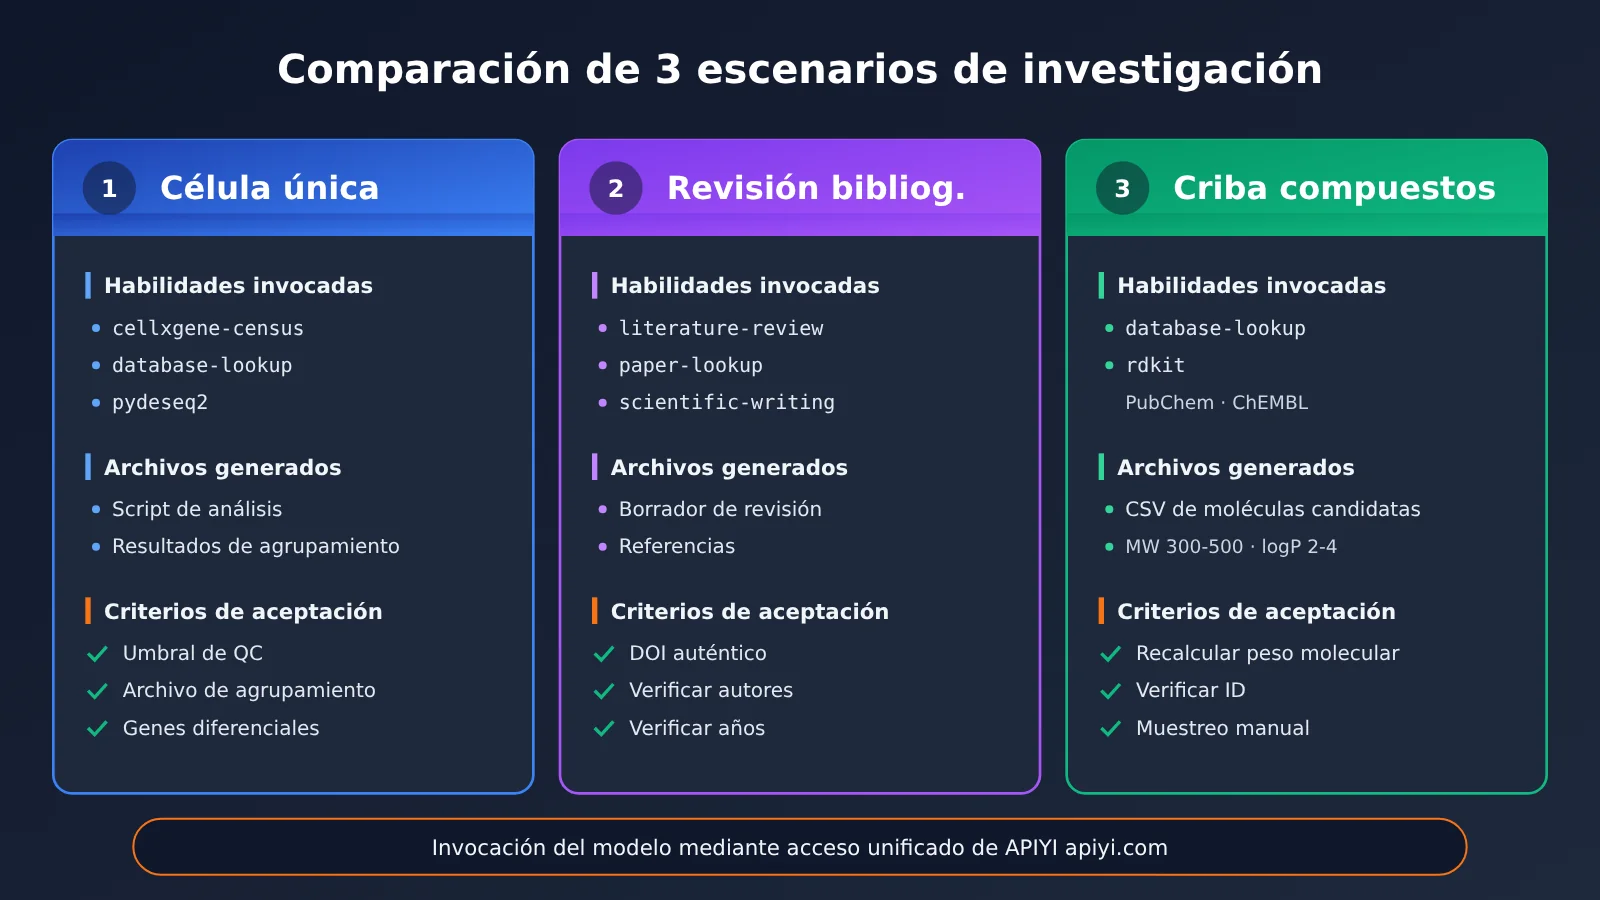
Tabla de solución de problemas de habilidades para investigación científica
| Problema | Causas habituales | Solución |
|---|---|---|
| La habilidad no se carga | El directorio está en la ubicación incorrecta o falta SKILL.md en él |
Comprueba la tabla de directorios del paso 3; reinicia el IDE después de corregirlo; en Cursor, revisa Settings → Rules para ver si se ha reconocido |
| Faltan dependencias de Python | Solo se instalaron los archivos de la habilidad, no sus dependencias | Instálalas con uv pip install según la sección compatibility de SKILL.md y comprueba que esté activado el entorno correspondiente |
| Límite de solicitudes de la base de datos | Las solicitudes en lote son demasiado rápidas o se superó la cuota gratuita | Consulta la documentación de la base de datos, añade caché, divide las solicitudes en lotes y reduce la concurrencia |
| Error de autenticación | La clave no está configurada, ha caducado o no tiene permisos suficientes | Comprueba la variable de entorno con echo y revisa los permisos en el panel del servicio correspondiente |
La ruta antigua scientific-skills/ devuelve un 404 |
A partir de la versión v2.43.0, la ruta de las habilidades cambió a skills/ |
Actualiza la ruta en los scripts locales y los marcadores, o vuelve a instalar |
| Se quiere desinstalar y reinstalar | Hay confusión entre versiones o el enlace simbólico ya no funciona | Ejecuta npx skills remove y después npx skills add; si necesitas fijar una versión, usa gh skill install --pin |
Se queda en Cloning repository… y luego aparece Clone timed out |
El repositorio ocupa más de 400 MB y 300 segundos no son suficientes | Vuelve a ejecutar el comando con SKILLS_CLONE_TIMEOUT_MS=600000, o usa primero git clone para copiar el repositorio en local y luego instálalo desde esa ruta |
Riesgos y descargo de responsabilidad de los Skills para investigación
Lee esta sección con atención. Scientific Agent Skills es un proyecto comunitario de código abierto, no una API oficial de ninguna plataforma. Solo lo recomendamos; no lo avalamos.
Los skills pueden ejecutar acciones. Un skill puede indicarle al agente que ejecute código arbitrario, instale paquetes, haga solicitudes de red o modifique archivos locales. Un skill malicioso o mal diseñado puede hacer que el agente actúe de forma incorrecta. Recomendamos lo siguiente:
- Antes de instalar un skill, lee su archivo
SKILL.mdy comprueba qué paquetes utiliza y a qué servicios externos se conecta. - Revisa el historial de contribuciones: los skills firmados por K-Dense-AI han pasado por una revisión interna; los aportados por la comunidad solo reciben una revisión «en la medida de lo posible».
- Haz tu propio análisis: primero ejecuta
uv pip install cisco-ai-skill-scannery luegoskill-scanner scan <path> --use-behavioral, sustituyendo<path>por el directorio del skill. El proyecto realiza análisis incrementales cada semana y vuelve a analizar todo al menos cada 30 días. Los resultados se publican endocs/security-report.md.
Restricciones de servicios de terceros. Algunos skills requieren registrarse en bases de datos de terceros o usar tu propia clave API. En esos casos, debes respetar los términos y los límites de uso de cada servicio. La recopilación masiva de datos puede activar límites de velocidad o incluso provocar el bloqueo de la cuenta. Conviene probar primero con una cuenta secundaria o en un entorno aislado.
Límites clínicos y regulatorios. Los skills relacionados con ámbitos clínicos, médicos o regulatorios solo deben usarse para investigación y elaboración de borradores. No sustituyen las decisiones de diagnóstico, liberación o certificación.
Responsabilidad. Cada usuario debe evaluar y asumir las consecuencias del uso de estos skills. Ni esta plataforma ni el autor del artículo se hacen responsables de ellas.
Preguntas frecuentes FAQ
Q1: ¿Qué es exactamente Scientific Agent Skills?
Es una biblioteca de habilidades para investigación mantenida por K-Dense-AI. Contiene 177 carpetas de habilidades que siguen el estándar Agent Skills e indican al agente cómo realizar un proceso de investigación, qué paquetes usar y a qué bases de datos conectarse. No es un modelo ni un servicio de API.
Q2: ¿Por qué no se recomienda instalar las 177 habilidades de investigación con un solo comando?
Primero, el README oficial indica claramente que no se deben instalar todas a la vez. Segundo, cuantas más habilidades haya instaladas, más difícil le resultará al agente elegir la adecuada. Y tercero, cada habilidad puede ejecutar código, así que cuantas más instales, más tendrás que revisar. Basta con elegir entre 5 y 10 según tu área de trabajo.
Q3: ¿Por qué ahora hay 177 y no 181?
A partir de la versión 2.72.0, las cuatro habilidades para documentos docx, pdf, pptx y xlsx ya no se distribuyen con el repositorio. Si las necesitas, instálalas por separado desde el repositorio skills de Anthropic.
Q4: Si las habilidades son gratuitas, ¿dónde está el gasto principal?
El gasto principal está en la invocación del modelo al ejecutar las habilidades. Algunas también pueden generar cargos por servicios de terceros: por ejemplo, `generate-image` usa OpenRouter, que cobra por cada uso. Para las invocaciones del modelo, puedes usar APIYI apiyi.com con pago por uso y sin cuota mensual fija. Así puedes probar primero un proceso pequeño, medir el consumo de tokens y decidir después qué modelo usar a largo plazo.
Q5: Ya las instalé en Cursor, pero ¿qué hago si el agente no usa las habilidades?
Primero, comprueba en Settings → Rules que las habilidades se hayan reconocido. Después, añade `Use available skills you have access to whenever possible.` al principio de la indicación y menciona la habilidad por su nombre. Si sigue sin usarla, prueba con otro modelo para comparar. Con APIYI apiyi.com puedes cambiar entre varios modelos con una sola clave API, lo que facilita la búsqueda del problema.
Q6: ¿Cómo puedo garantizar que los resultados de investigación sean reproducibles?
Usa `gh skill install –pin` para fijar la habilidad a una versión o commit concreto; fija las versiones de las dependencias de Python en un entorno uv independiente; y registra también los campos metadata.version y last-reviewed de `SKILL.md`.
Q7: ¿Todas estas habilidades tienen licencia MIT?
No necesariamente. El repositorio en su conjunto tiene licencia MIT, pero cada habilidad tiene su propio campo de licencia. Por ejemplo, `scanpy` usa BSD-3-Clause. Revisa cada licencia antes de usar las habilidades con fines comerciales.
Puntos clave sobre las Skills de investigación
- Qué son: 177 habilidades de investigación de código abierto que abarcan las 22 categorías principales enumeradas en el README
- Cómo instalarlas: consulta primero la lista con
--listy usa-sy-apara instalar solo las que necesites - Requisitos previos: Node.js 22.20+, Python 3.13+, uv y un entorno compatible con el estándar Agent Skills
- El error más común: instalar los archivos de las habilidades no instala sus dependencias; crea un entorno uv independiente para cada flujo de trabajo
- Cómo verificar los resultados: comprueba qué habilidad se usó, en qué directorio están los archivos generados y si las cifras coinciden con sus fuentes
- Seguridad: lee
SKILL.mdantes de instalar y pasa el escáner de Cisco - Costo: las habilidades son gratuitas; puedes usar APIYI apiyi.com para acceder a distintos modelos y comparar sus costos de invocación
Resumen
Estas 177 Skills de investigación son muy útiles, pero conviene avanzar paso a paso, sin intentar instalarlo todo:
- Comprueba el entorno antes de instalar: verifica las versiones y la compatibilidad del entorno, y después usa
--listpara elegir entre 5 y 10 habilidades - Instala las habilidades y las dependencias por separado: usa
npx skills addpara los archivos de las habilidades y uv para las dependencias de Python; necesitas completar ambos pasos - Asegúrate de poder verificar los resultados: en cada ejecución, revisa qué habilidad se usó, dónde están los archivos generados y de dónde vienen las cifras
Lo mejor es empezar con un flujo pequeño que ya conozcas bien, como agrupar un conjunto de datos pequeño con scanpy, y completarlo de principio a fin antes de añadir más habilidades. Para el modelo, puedes empezar con el pago por uso de APIYI apiyi.com y, según el consumo de tokens, decidir qué modelo usar a largo plazo.
📚 Referencias
- Repositorio Scientific Agent Skills: código fuente de las habilidades, README e informe de seguridad
- Enlace:
github.com/K-Dense-AI/scientific-agent-skills -
Descripción: incluye 177 habilidades, instrucciones de instalación, solución de problemas y
docs/security-report.md -
Instalador skills: comandos y parámetros de npx skills
- Enlace:
github.com/vercel-labs/skills -
Descripción: consulta los comandos add / list / check / update / remove y la correspondencia de directorios para más de 70 entornos
-
Repositorio Anthropic Skills: habilidades para documentos docx, pdf, pptx y xlsx
- Enlace:
github.com/anthropics/skills -
Descripción: a partir de la versión 2.72.0, estas cuatro habilidades para documentos deben instalarse por separado desde este repositorio
-
Artículo relacionado: Scientific Agent Skills: A Library of Procedural Knowledge for Research Agents
- Enlace:
arxiv.org/abs/2609.00065 -
Descripción: explica los principios de diseño de la biblioteca de habilidades
-
Documentación de APIYI · Integración con Claude Code: variables de entorno, grupos y solución de problemas
- Enlace:
docs.apiyi.com/scenarios/programming/claude-code -
Descripción: conecta Claude Code a APIYI con dos variables de entorno. Una vez instaladas las habilidades, aquí encontrarás cómo poner en marcha el modelo
-
Documentación de APIYI · Skills de generación de imágenes con GPT-Image 2: dos habilidades de generación de imágenes aportadas por la comunidad
- Enlace:
docs.apiyi.com/scenarios/ecosystem/apiyi-gpt-image-skills -
Descripción: parámetros, facturación y errores frecuentes de
apiyi-gpt-image-2-genyapiyi-gpt-image-2-all-gen -
Tabla general de precios de modelos de APIYI: modelos, tipos, métodos de facturación y precios unitarios
- Enlace:
docs.apiyi.com/models - Descripción: el precio unitario de claude-opus-5-5 citado en este artículo se basa en esta tabla. Los precios pueden cambiar, así que revísalos antes de usar el modelo
Autor: Equipo técnico de APIYI
Contacto técnico: puedes contactarnos desde la página principal de APIYI. Encontrarás más información sobre la integración de modelos en el centro de documentación de docs.apiyi.com