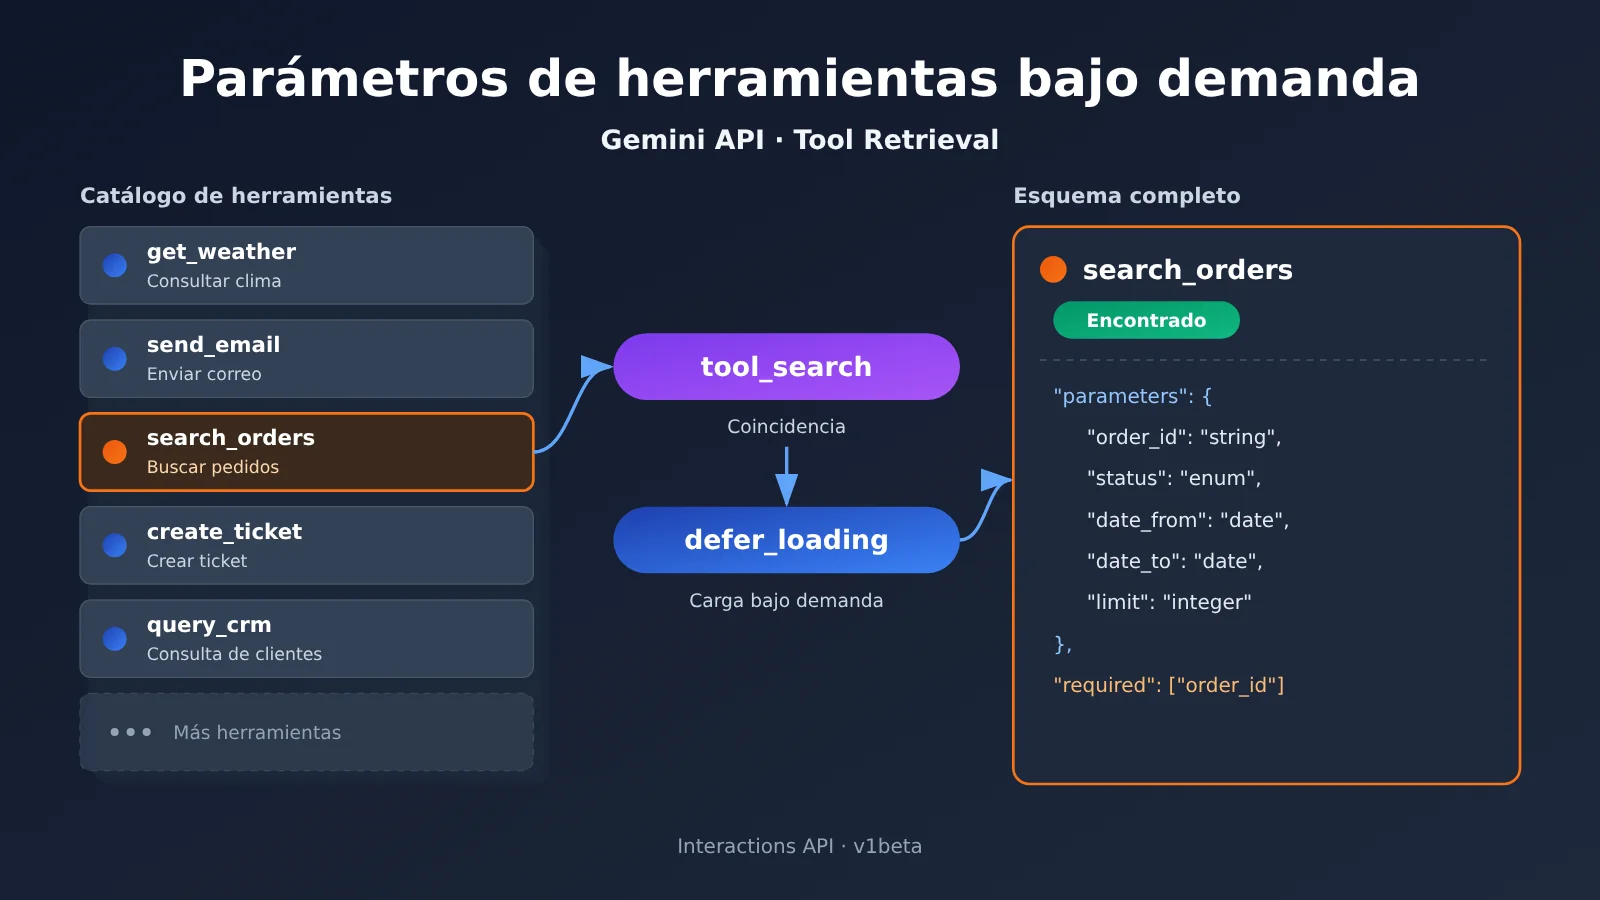
El 19 de noviembre de 2026, Google presentó Tool Retrieval (recuperación de herramientas) en versión Preview dentro de la Gemini Interactions API. El agente puede ver primero solo el nombre y una breve descripción de las herramientas, y cargar el esquema completo de parámetros en el contexto cuando realmente necesita invocarlas. Principalmente resuelve el problema de que «cuantas más herramientas se conectan, más contexto queda ocupado por definiciones de herramientas que están inactivas». Es especialmente adecuado para agentes con muchas herramientas, donde las invocaciones se concentran en unas pocas de alta frecuencia y, al mismo tiempo, existe una gran cantidad de herramientas de uso poco frecuente; no significa que todas las aplicaciones ahorren costos simplemente por activarlo de forma predeterminada.
¿Qué podrás aprender al leer este artículo?
- Qué cambia exactamente Tool Retrieval y por qué pueden cumplirse simultáneamente estas dos ideas: «el desarrollador sigue enviando la declaración completa de herramientas» y «el modelo no necesita leer de antemano el esquema completo»
- Toda la cadena de ejecución desde el registro de herramientas hasta
function_call, y la división de responsabilidades entre la recuperación del lado del servidor y la recuperación del lado del cliente - Los 4 ID de modelo que tienen compatibilidad explícita confirmada, el precio estándar y el significado de «no hay una tarifa adicional por esta función, pero los tokens se facturan como siempre»
- Los dos ejemplos orientativos oficiales con direcciones opuestas: cuándo se ahorra y cuándo, en cambio, sale más caro
- Las limitaciones a tener en cuenta antes de integrarlo y cómo determinar si merece la pena para tu agente
Índice: más adelante, una tabla conceptual y un resumen de impacto te ayudarán a ponerte rápidamente en contexto. La sección «Hechos objetivos» explica, en orden, la información del lanzamiento, el mecanismo de funcionamiento, la carga híbrida y el MCP remoto, los modelos compatibles y el costo, y las limitaciones de uso; todo se basa en el anuncio oficial de Google y la documentación para desarrolladores. La sección «Análisis y opinión» ofrece criterios de aplicabilidad, un método de medición de línea base antes de migrar y algunas preguntas frecuentes; los contenidos con carácter de juicio o predicción se marcarán por separado.
Conceptos que debes conocer primero sobre Tool Retrieval en la API de Gemini (To Know)
| Concepto | Explicación breve |
|---|---|
| Tool Retrieval | Primero se buscan las herramientas necesarias y luego se añade al contexto del modelo la definición completa de parámetros de las herramientas encontradas |
| Interactions API | Interfaz de Gemini orientada a agentes; gestiona el historial de interacciones, los pasos de ejecución de herramientas y la salida del modelo. Disponible oficialmente desde junio de 2026 |
| Esquema de parámetros | Estructura que describe qué parámetros acepta una función, de qué tipo son y cuáles son obligatorios; normalmente se expresa con JSON Schema |
| Function Calling | El modelo genera el nombre de la función y sus parámetros, la aplicación ejecuta la función y luego devuelve el resultado al modelo |
tool_search |
Tipo de herramienta que declara el mecanismo de búsqueda de herramientas; a través de él, el modelo busca y carga definiciones de herramientas |
defer_loading |
Configuración del modo del lado del servidor que retrasa la carga de la definición completa de parámetros de una herramienta hasta que la búsqueda la encuentre |
short_description |
Descripción breve de una herramienta diferida, para que el modelo identifique la herramienta en el catálogo inicial |
| MCP remoto | Herramientas proporcionadas por servicios de terceros externos a la aplicación, conectadas mediante Model Context Protocol |
| Caché implícita | La plataforma reutiliza automáticamente prefijos de contexto idénticos; la parte que coincide se factura según la tarifa de entrada en caché |
Resumen rápido del impacto de Tool Retrieval en la API de Gemini
- Desarrolladores que están conectando muchas herramientas de negocio a un agente: ya no necesitan crear su propio buscador de herramientas; pueden dejar que el modelo lea bajo demanda los esquemas de decenas o incluso cientos de herramientas. Aun así, sigue siendo necesario enviar el array completo de herramientas en cada solicitud y reevaluar caché y facturación. Antes de migrar, conviene medir con el flujo actual de Function Calling cuánto ocupan realmente las definiciones de herramientas; interfaces unificadas multi-modelo como APIYI apiyi.com pueden ayudar a obtener rápidamente una línea base de comparación.
- Responsables de producto y costos: no hay una tarifa independiente por la funcionalidad, pero cada búsqueda del lado del servidor activa una inferencia adicional del modelo. Si ahorra dinero o no depende del tamaño del conjunto de herramientas, la longitud del contexto y la frecuencia de búsqueda; hay que verificarlo con los campos de facturación, no basta con mirar el mensaje promocional.
- Aplicaciones con pocas herramientas y llamadas estables: los ejemplos de cálculo oficiales muestran que, cuando un conjunto pequeño de herramientas se combina con un contexto largo, el total de tokens puede aumentar en lugar de bajar; seguir cargándolas directamente es la opción más estable.
- Equipos que usan frameworks de agentes: esta es una capacidad nueva en la capa de API del modelo, y puede que el framework no se adapte de inmediato. No conviene dar por hecho que la carga progresiva a nivel del framework ya está resuelta.
Datos objetivos: qué ha lanzado Gemini API Tool Retrieval
Información y contexto del lanzamiento de Gemini API Tool Retrieval
El blog oficial de Google publicó el 19 de noviembre de 2026 «Introducing Tool Retrieval in the Gemini API», escrito por Lucia Loher, gerente de producto de Gemini API, y Nora Kassner, investigadora de Google DeepMind. La funcionalidad está actualmente en fase Preview y solo puede usarse en la Interactions API; requiere la versión v1beta. El método antiguo generateContent no es compatible.
La preparación del lado de ingeniería precedió al anuncio. El 18 de noviembre, el SDK oficial de Python de Google lanzó la v3.6.0, y las notas de actualización indican que se añadieron esquemas públicos relacionados con Tool Retrieval y los resultados de funciones. Ese mismo día, el SDK de Go v1.79.0 también incluía las actualizaciones correspondientes. Según la cronología, en esta ocasión se completaron las capacidades de descubrimiento de herramientas y carga bajo demanda sobre la Interactions API, que ya estaba en GA (disponibilidad general); no se trata del lanzamiento de un nuevo producto API.
La demanda de los desarrolladores también está documentada. El 18 de marzo de 2026, un desarrollador presentó el Issue #2185 en el repositorio del SDK de Python, solicitando compatibilidad con defer_loading y tool_search, porque después de que un agente se conecta a más de 30 herramientas, el esquema completo provoca una inflación del contexto. Los responsables de Google respondieron el 20 de marzo y lo registraron como solicitud de funcionalidad. Estos son comentarios de demanda, no pruebas de rendimiento.
En una frase, Tool Retrieval se puede resumir así: las herramientas primero pueden descubrirse y los parámetros concretos se leen cuando hace falta invocarlas.
Cómo Tool Retrieval cambia la forma de cargar el Schema de las herramientas
En la carga estática tradicional, aunque el usuario solo quiera tramitar un reembolso, las declaraciones de parámetros de decenas de herramientas —pedidos, logística, inventario, CRM, etc.— también entran en el contexto con cada inferencia. La documentación de Google señala que unas pocas docenas de declaraciones de funciones pueden ocupar decenas de miles de tokens. Esto resta espacio al historial de conversación y, cuando hay muchas herramientas similares, también puede interferir con que el modelo elija la herramienta correcta.
La clave de Tool Retrieval está en distinguir tres niveles:
- Capa de solicitud API: los desarrolladores siguen enviando la definición completa de las herramientas, incluido el Schema de parámetros.
- Contexto inicial del modelo: las herramientas marcadas con
defer_loading: trueaparecen solo como nombre másshort_description. Si no se ha configurado una descripción breve, se toma la primera frase de ladescriptioncompleta. - Fase de invocación de herramientas: después de que una herramienta coincida con la búsqueda, el Schema completo entra en el contexto y el modelo genera, a partir de él, una invocación con parámetros.
Por eso, cuando el título dice “ya no se cargan todos los parámetros de las herramientas cada vez”, el significado preciso es que el modelo ya no lee por adelantado todos los parámetros completos en cada ronda, no que el desarrollador deje de enviar las declaraciones completas. En el modo del lado del servidor, la documentación oficial exige reenviar el array tools completo en cada solicitud, incluso cuando se usa previous_interaction_id.
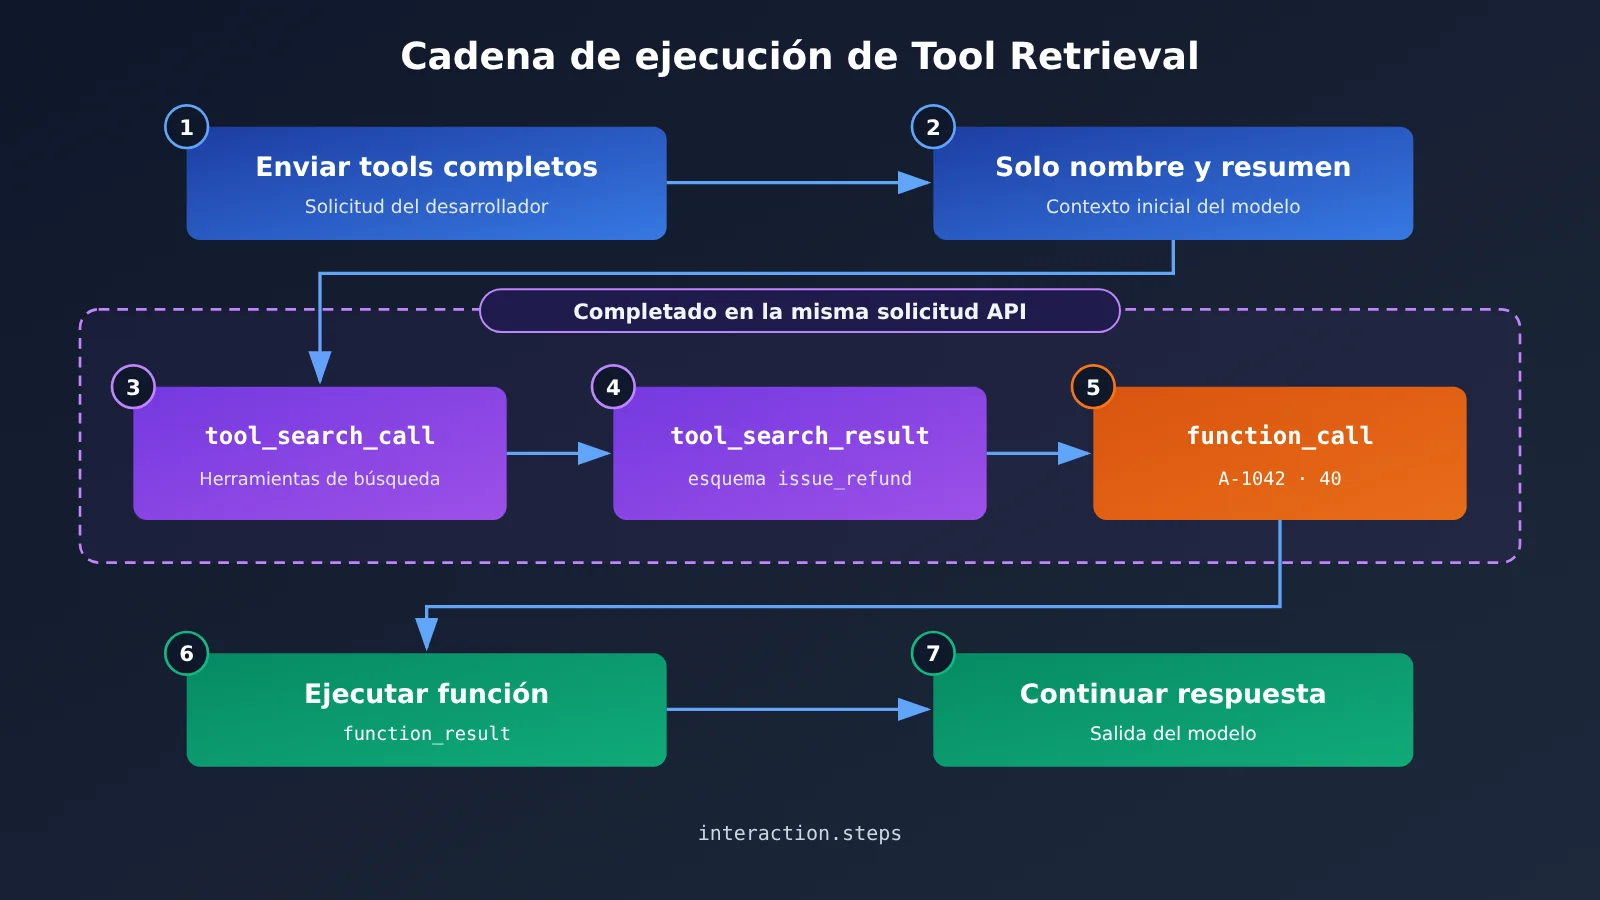
Cadena de ejecución de Tool Retrieval: ejemplo oficial de reembolso
El anuncio de Google utiliza un escenario de reembolso de pedido: el producto del pedido A-1042 llegó dañado y el usuario solicita un reembolso de 40 USD; la herramienta necesaria es issue_refund. El proceso completo de recuperación en el servidor es el siguiente:
- En la solicitud se declara
{"type": "tool_search"}y se establecedefer_loading: truepara herramientas de baja frecuencia comoissue_refund. - El modelo determina, según la tarea, que necesita la capacidad de reembolso y lanza
tool_search_call. - La API devuelve
tool_search_result, que incluye el esquema completo de parámetros deissue_refund. - El modelo lee la definición de parámetros y genera
function_callcon los parámetrosorder_id: "A-1042"yamount: 40. - La aplicación ejecuta la función y devuelve
function_result; el modelo continúa la tarea a partir de ese resultado.
La búsqueda, la carga y la generación de la llamada a función pueden completarse dentro de la misma solicitud externa a la API, y todos los pasos se pueden consultar en interaction.steps. Cabe tener en cuenta que una misma solicitud no equivale a una sola inferencia interna: cada búsqueda en el servidor provoca una invocación adicional del modelo que se factura. Además, este es un caso demostrativo y no representa ninguna estadística sobre la tasa de éxito de los reembolsos.
A continuación, un código de ejemplo basado en la documentación oficial, que se conecta directamente al endpoint de Google y solo muestra la estructura de la solicitud:
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "issue_refund",
        "description": "Refund an order.",
        "short_description": "Refund a customer order.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "amount": {"type": "number"}
            },
            "required": ["order_id", "amount"]
        }
    }
]

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Refund 40 USD for order A-1042.",
    tools=tools
)
for step in interaction.steps:
    print(step.type)  # tool_search_call / tool_search_result / function_call
El reparto de responsabilidades de Function Calling sigue igual. Para funciones personalizadas, la API solo devuelve function_call; ejecutar el reembolso, acceder a la base de datos y gestionar permisos siguen siendo tareas de la aplicación. Solo al conectarse a un servidor MCP remoto la API realiza la llamada remota en su lugar y devuelve mcp_server_tool_call y mcp_server_tool_result.
Carga híbrida en Tool Retrieval, MCP remoto y dos modos de recuperación
Google recomienda combinar ambos enfoques: las herramientas de uso frecuente se cargan directamente, mientras que las herramientas de nicho o especializadas de baja frecuencia se cargan de forma diferida. Así, las tareas simples no tienen que pasar primero por una búsqueda, y las capacidades de cola larga tampoco ocupan el contexto de forma permanente. Un servidor MCP remoto también puede configurarse completo para carga diferida: por ejemplo, agregando defer_loading: true a una configuración de type: "mcp_server", las herramientas que expone ese servidor se cargarán bajo demanda, sin necesidad de declararlas una por una.
Además del modo del lado del servidor, en el que Gemini realiza la recuperación, la documentación oficial también ofrece un modo del lado del cliente: el desarrollador declara un tool_search con execution: "client", su propia aplicación consulta el registro de herramientas y luego coloca las declaraciones completas de las herramientas coincidentes en function_result.result para devolverlas al modelo. Las diferencias entre ambos modos son las siguientes:
| Dimensión de comparación | Recuperación en el servidor | Recuperación en el cliente |
|---|---|---|
| Ubicación de ejecución | Servidor de Gemini API (server por defecto) |
Aplicación del desarrollador (client) |
| ¿Requiere un recuperador propio? | No | Sí |
| ¿Requiere declarar la biblioteca de herramientas de antemano? | Sí | No; se pueden incorporar nuevas herramientas durante la sesión |
defer_loading |
Aplica | No aplica |
| Viajes de red adicionales | Sin viajes adicionales del cliente | Un viaje adicional por cada búsqueda |
| Control de permisos | Determinado por el conjunto de herramientas declarado en la solicitud | Se puede combinar con filtrado de permisos por usuario propio |
| Escenarios típicos | Conjuntos de herramientas grandes y relativamente fijos | Bibliotecas de herramientas dinámicas, multiinquilino, registros privados de empresa |
En el modo del lado del cliente, las declaraciones de funciones devueltas deben ser objetos estructurados y no pueden convertirse en cadenas JSON. Dentro de una misma solicitud no se pueden mezclar ambos modos, y como máximo se puede declarar un único tool_search.
¿Qué modelos admite Gemini API Tool Retrieval y cuánto cuesta?
El anuncio de Google es bastante amplio: afirma que todos los modelos Gemini 3.6 y posteriores son compatibles, incluidos todos los modelos Gemini 4. Sin embargo, a fecha del 20 de noviembre, la documentación para desarrolladores solo enumera explícitamente 4 ID de modelo. Al implementarlo, hay que guiarse por la documentación para desarrolladores; establecer defer_loading en un modelo no compatible devuelve HTTP 400.
| ID del modelo | Precio de entrada estándar (USD/millón de tokens) | Precio de salida estándar (incluye Thinking) | Notas |
|---|---|---|---|
gemini-4-hydrogen |
$1.50 | $7.50 | Marcado como Free Tier |
gemini-4-argon |
$2.00 ($4.00 a partir del 1 de diciembre) | $10.00 ($20.00 a partir del 1 de diciembre) | Sin Free Tier |
gemini-3.8-flash |
$0.75 ($1.50 a partir del 1 de enero de 2027) | $3.75 ($7.50 a partir del 1 de enero de 2027) | Marcado como Free Tier |
gemini-3.6-flash |
$0.75 ($1.50 a partir del 1 de enero de 2027) | $3.75 ($7.50 a partir del 1 de enero de 2027) | Marcado como Free Tier |
Los precios provienen del nivel Standard de la página de precios de Google Gemini Developer API. La cuota real y los límites de velocidad de Free Tier deben confirmarse por proyecto.
En cuanto a la facturación, Google indica claramente que Tool Retrieval no tiene una tarifa de función independiente, pero eso no significa que la búsqueda sea gratuita. La lista de descripciones resumidas de las herramientas diferidas, las instrucciones de búsqueda fijas adicionales que se añaden al activar tool_search, el razonamiento extra de cada recuperación del lado del servidor, el Schema completo que se carga y su retención en turnos posteriores se facturan como tokens según las tarifas del modelo elegido. Al analizar los costos, hay que prestar especial atención al campo total_tool_use_tokens, que registra la entrada adicional de invocación del modelo provocada por la búsqueda del lado del servidor. Fijarse solo en la caída de tokens de entrada iniciales hace que sea muy fácil sobreestimar el ahorro.
Ejemplo ilustrativo oficial de tokens para Tool Retrieval
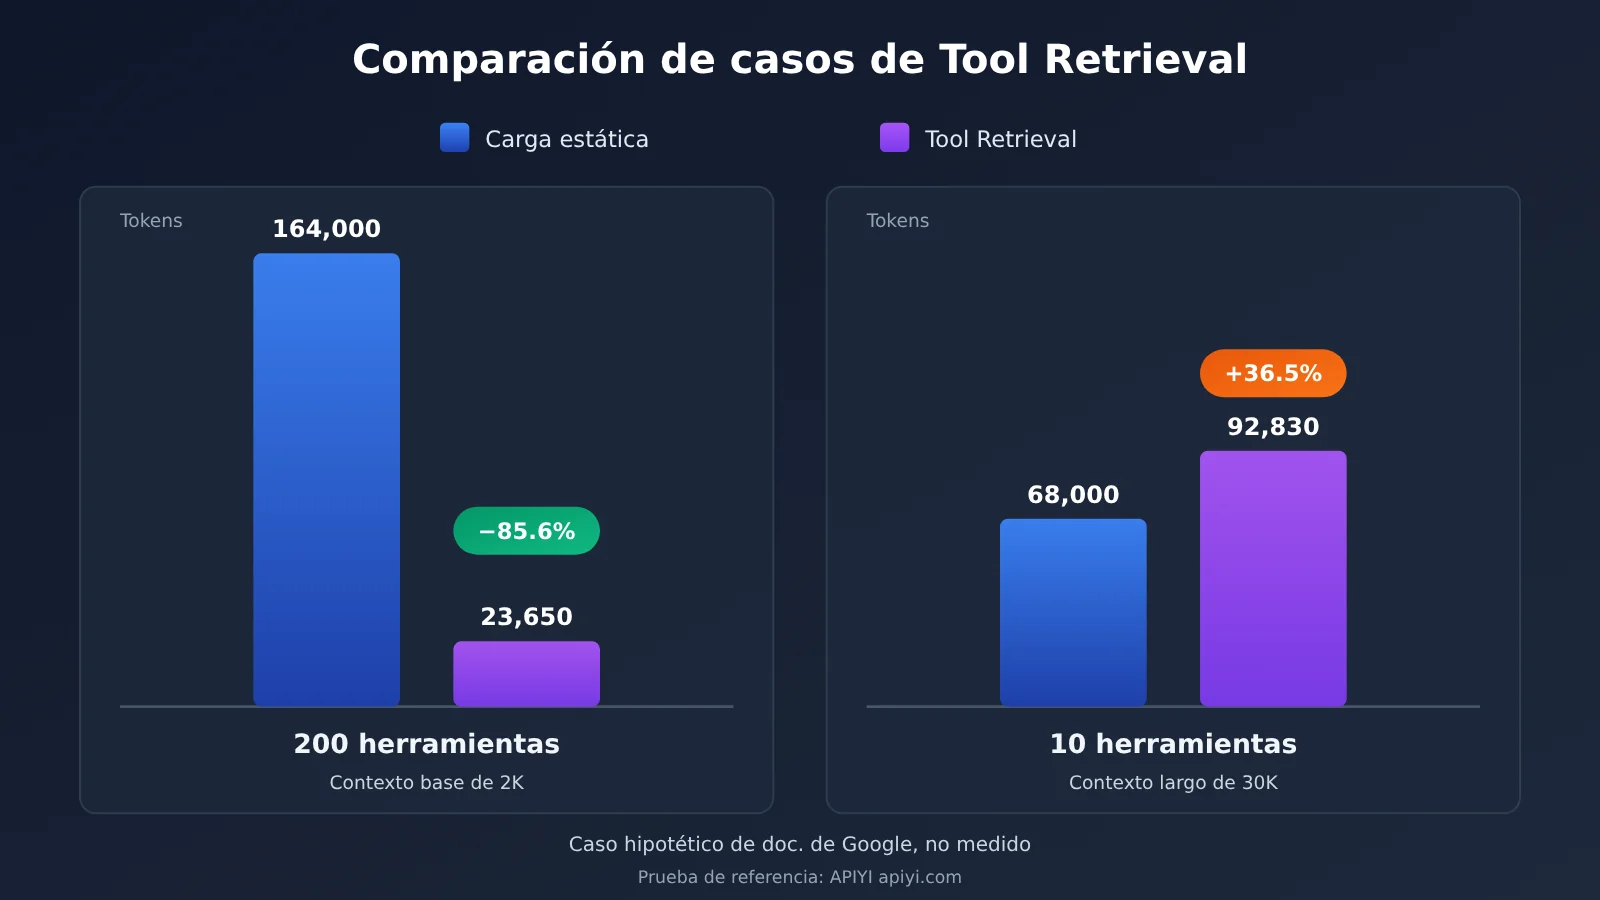
Las primeras pruebas oficiales mostraron que cada herramienta de carga diferida ocupa, en promedio, alrededor de 26 tokens dentro del catálogo inicial. Es un valor aproximado, no un costo fijo. El documento también ofrece dos ejemplos hipotéticos cuyas conclusiones van en direcciones opuestas:
| Escenario (hipótesis oficial) | Carga estática de todas las herramientas | Tool Retrieval | Cambio |
|---|---|---|---|
| 200 herramientas, 400 tokens cada una, contexto base de 2,000, se usan 2 herramientas, 2 solicitudes en total | 164,000 | aprox. 23,650 | reducción de aprox. 85.6% (según el cálculo del ejemplo) |
| 10 herramientas, 400 tokens cada una, contexto base de 30,000, se usan 2 herramientas, 2 solicitudes en total | 68,000 | 92,830 | aumento de aprox. 36.5% (según el cálculo del ejemplo) |
La segunda comparación resulta más cara porque la búsqueda del lado del servidor requiere una inferencia adicional y vuelve a procesar un contexto que ya de por sí es largo; además, 10 herramientas no ocupan tanto por sí solas, así que el ahorro en el esquema no compensa el costo de la búsqueda. Ambas cifras son ejemplos hipotéticos señalados por Google, no incluyen tokens de salida ni beneficios de caché y no son benchmarks de producción. A la fecha de revisión de la información, Google no ha publicado la proporción de ahorro de tokens medida en pruebas reales de esta función, ni mejoras de latencia, ni aumentos en la precisión de selección de herramientas.
En cuanto al almacenamiento en caché, Google indica que Tool Retrieval admite caché implícita: el esquema completo no aparece en el prefijo inicial, y los prefijos como las instrucciones del sistema y el catálogo de herramientas tienden a mantenerse más estables. Sin embargo, el documento también advierte que la carga diferida acorta la indicación inicial, por lo que las solicitudes que antes necesitaban una gran cantidad de esquema para alcanzar el umbral mínimo de caché podrían quedar por debajo de ese umbral.
Limitaciones actuales del uso de Tool Retrieval
Los siguientes puntos vienen de la documentación oficial y son los que más fácilmente te hacen tropezar durante el desarrollo:
- Las herramientas ya cargadas no se pueden descargar: una vez que un Schema se ha recuperado, permanece en la sesión actual. En sesiones muy largas, seguir recuperando nuevas herramientas hace que el contexto siga creciendo.
- Cada solicitud reenvía el array completo de herramientas: incluyendo
tool_search, todas las herramientas diferidas y no diferidas, y la configuración MCP correspondiente. No puedes enviar solonameyshort_descriptionomitiendoparameters. - No diferir las herramientas que las instrucciones del sistema mencionan directamente: el modelo puede saltarse la búsqueda e invocarlas directamente, lo que provoca errores por falta de contexto cargado.
- En sesiones sin estado hay que conservar íntegro el paso de recuperación: si gestionas el historial por tu cuenta con
store=false,tool_search_call,tool_search_resulty susignatureno se pueden eliminar ni modificar, de lo contrario puede devolver HTTP 400. - Para depurar hay que mirar los steps: aunque
interaction.statusno searequires_action, el resultado puede contener unfunction_callpendiente de ejecución. - Cuando no hay coincidencia puede devolver texto: si la búsqueda del servidor no encuentra una herramienta compatible, no necesariamente devuelve un error estructurado.
Análisis y valoración: qué implica Tool Retrieval de la API de Gemini para el desarrollo de agentes
Cuándo aplicar Tool Retrieval
El valor real de esta actualización es separar dos cosas: «mantener una lista completa de herramientas» y «leer esa lista completa en cada ronda de razonamiento». La biblioteca de herramientas puede seguir creciendo, mientras que en el contexto del modelo solo reside un catálogo muy ligero. Para equipos que integran continuamente nuevos sistemas de negocio, esto alivia la carga de tener que recortar el conjunto de herramientas de antemano y también reduce los casos en los que, para controlar los tokens, la aplicación filtra dinámicamente herramientas en cada ronda y termina rompiendo el prefijo de caché.
Sin embargo, los ejemplos oficiales ya dejan claro que el beneficio tiene condiciones. Combinando las recomendaciones de ingeniería oficiales, se puede hacer una primera valoración con la siguiente tabla (son sugerencias de decisión de ingeniería, no umbrales numéricos estrictos):
| Tipo de agente | Características de las herramientas | Recomendación |
|---|---|---|
| Atención al cliente, asistentes de procesos de negocio | Decenas de herramientas; unas pocas de consulta son de alta frecuencia, mientras que reembolsos, aprobaciones y contratos son de baja frecuencia | Cargar directamente las de alta frecuencia; usar recuperación del lado del servidor para la cola larga |
| Agentes de desarrollo/operaciones con múltiples servidores MCP | Cada servidor tiene muchas herramientas, pero una sola tarea usa apenas una pequeña parte | Configurar defer_loading para el servidor MCP en conjunto |
| Plataformas multinquilino que exponen herramientas según permisos | El conjunto de herramientas varía según el usuario y el espacio de trabajo | Recuperación del lado del cliente, combinada con un registro propio y filtrado por permisos |
| Asistentes pequeños | Menos de unas 20 herramientas estables, la mayoría se usan en cada ronda | Seguir con carga estática |
| Contexto largo + búsquedas frecuentes | Conversaciones muy largas; a menudo se necesitan varias recuperaciones por ronda | Medir primero y luego decidir; existe el riesgo de que aumente el coste neto |
Nuestra conclusión: cuanto más «cola larga» sea la distribución de invocaciones de herramientas, más vale la pena usar Tool Retrieval. Al contrario, si la mayoría de las herramientas se usan en cada ronda, la carga diferida solo añadirá una inferencia de búsqueda adicional.
Antes de migrar a Tool Retrieval, mide el consumo real del Schema de herramientas
La base más fiable para decidir si migrar o no son los datos de tu propio negocio. Antes de migrar, puedes usar el flujo actual de Function Calling compatible con OpenAI para medir la diferencia de Tokens de entrada entre dos tipos de solicitud: «todas las herramientas» y «solo las herramientas realmente utilizadas», obteniendo así el consumo real del Schema de herramientas. El script siguiente hace precisamente este tipo de medición de línea base, y no es Tool Retrieval en sí mismo:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI, para medir la línea base de carga estática
)

def make_tool(name, desc):
    return {"type": "function", "function": {
        "name": name, "description": desc,
        "parameters": {"type": "object",
                       "properties": {"order_id": {"type": "string"}},
                       "required": ["order_id"]}}}

all_tools = [make_tool(f"crm_tool_{i}", f"CRM operation {i}") for i in range(50)]
messages = [{"role": "user", "content": "查询订单 A-1042 的状态"}]

for label, tools in [("全量 50 个工具", all_tools), ("仅 1 个工具", all_tools[:1])]:
    resp = client.chat.completions.create(
        model="your-model-id", messages=messages, tools=tools)
    print(label, "prompt_tokens =", resp.usage.prompt_tokens)
Ver el script completo de medición de línea base (comparación por lotes según la cantidad de herramientas)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Medir el consumo del Schema de herramientas de distintos modelos a través de la interfaz unificada de APIYI
)

def load_tools(path: str) -> list:
    """Leer las definiciones de herramientas en formato OpenAI desde el registro de herramientas del negocio (archivo JSON)"""
    with open(path, "r", encoding="utf-8") as f:
        return json.load(f)

def measure(model: str, tools: list, prompt: str) -> int:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools if tools else None,
        max_tokens=16,
    )
    return resp.usage.prompt_tokens

def baseline_report(model: str, tools: list, prompt: str, steps=(0, 10, 20, 50, 100)):
    base = measure(model, [], prompt)
    print(f"无工具基础输入: {base} tokens")
    for n in steps:
        if n == 0 or n > len(tools):
            continue
        used = measure(model, tools[:n], prompt)
        print(f"{n:>4} 个工具: {used} tokens, Schema 约占 {used - base} tokens")

if __name__ == "__main__":
    tools = load_tools("tool_registry.json")
    baseline_report("your-model-id", tools, "查询订单 A-1042 的状态")
🎯 Recomendación técnica: Antes de evaluar Tool Retrieval, puedes ejecutar la línea base de carga estática en varios modelos principales con una sola clave API a través de APIYI apiyi.com, para ver con claridad cuántos Tokens ocupa realmente el Schema de herramientas en tu solicitud. Una vez tengas esa línea base, activa
tool_searchen Gemini Interactions API como comparación y contrasta la suma detotal_input_tokensytotal_tool_use_tokens.
Cabe aclarar que Tool Retrieval depende de la interfaz v1beta de Interactions API y de campos dedicados; las llamadas compatibles con OpenAI de arriba solo sirven para medir el consumo de la carga estática. Al hacer la prueba comparativa, se recomienda mantener consistentes el modelo, la biblioteca de herramientas, el conjunto de tareas, la longitud del contexto y las condiciones de caché, y luego comparar el costo total facturado, el tiempo de extremo a extremo, la tasa de selección correcta de herramientas y el número promedio de búsquedas, para poder atribuir las diferencias a la estrategia de recuperación. Si quieres ver las diferencias de línea base entre distintos modelos dentro del mismo conjunto de scripts, la interfaz unificada de APIYI apiyi.com te ahorra el trabajo de integrar cada proveedor por separado.
Desarrollos futuros que conviene seguir (valoración predictiva)
Lo siguiente son valoraciones, no hechos confirmados.
Primero, hay diferencias entre el anuncio y la documentación para desarrolladores en cuanto a los modelos compatibles. Habrá que seguir las actualizaciones de la documentación para ver si modelos como Gemini 4 Carbon y Gemini 4 Neon entran en la lista de compatibilidad. Segundo, «no se puede descargar un Schema ya cargado» es una limitación evidente para agentes de sesiones largas. Si la versión estable ofrece o no un mecanismo de descarga o eliminación influirá directamente en su rendimiento en tareas prolongadas. Tercero, los usuarios de Google ADK ya habían reportado en el Issue #7241 problemas de carga progresiva e invalidación de caché. Que la API del modelo admita una nueva capacidad no significa que el framework la adopte automáticamente; vale la pena seguir el ritmo de adaptación en la capa del framework.
La idea de cargar definiciones de herramientas bajo demanda ya tenía precedentes en la industria; esta vez Google la incorpora a la interfaz Agent de Gemini. Como la interfaz puede cambiar durante la fase Preview, al integrar sistemas en producción se recomienda mantener un interruptor para volver a la carga estática.
Algunas preguntas frecuentes sobre Gemini API Tool Retrieval
P1: ¿Con Tool Retrieval activado, el cuerpo de la solicitud se hace más pequeño?
No. En el modo servidor, cada solicitud sigue enviando el array completo de herramientas; lo que disminuye es el espacio que ocupan las herramientas en el contexto inicial del modelo. Si quieres calcular primero el volumen de definiciones de herramientas en las solicitudes actuales, puedes usar el script anterior para obtener una línea base a través de APIYI apiyi.com.
P2: ¿Google dice oficialmente que se puede ahorrar un 85 %?
No existe tal conclusión basada en pruebas reales. El 85,6 % se calculó a partir de un caso hipotético con 200 herramientas; el mismo documento también muestra el contraejemplo de que, con un conjunto pequeño de herramientas, los tokens aumentan alrededor de un 36,5 %.
P3: ¿Tool Retrieval tiene coste?
No hay una tarifa específica por la función, pero las indicaciones de búsqueda, la inferencia adicional y los Schema cargados se facturan como tokens según la tarifa del modelo. Los equipos sensibles al presupuesto pueden probar primero a pequeña escala, con facturación por uso mediante APIYI apiyi.com, el gasto de Function Calling de distintos modelos, y luego decidir qué modelo usar para el Agent.
P4: Con Tool Retrieval, ¿ya no hace falta ejecutar las funciones por cuenta propia?
No. Las funciones personalizadas siguen ejecutándose en la aplicación, que devuelve el resultado; Tool Retrieval solo se encarga de encontrar y cargar las definiciones de herramientas. Solo las herramientas MCP remotas las invoca la API en tu nombre.
El conjunto de herramientas será cada vez más grande, pero en cada ronda normalmente solo necesitamos unas pocas. Tool Retrieval separa «tener todas las herramientas preparadas» de «tomarlas cuando hagan falta». Bien utilizado, puede aligerar a los agentes grandes; mal utilizado, también puede hacer que pagues de más por una ronda de inferencia. Como se dice en las Analectas (Wei Ling Gong): «Para hacer bien su trabajo, primero hay que afilar las herramientas». Primero mide el peso de cada «herramienta» que tienes en la mano y luego decide cómo colocarla.
📚 Referencias
-
Anuncio oficial de Google: Presentación de Tool Retrieval en la API de Gemini (2026-11-19)
- Enlace:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval - Descripción: Información del lanzamiento, objetivos de diseño, los dos modos de recuperación y principios de precios
- Enlace:
-
Documentación para desarrolladores de Google Tool Retrieval: configuración, límites, facturación y ejemplos ilustrativos
- Enlace:
aistudio.google.com/docs/tool-retrieval - Descripción: Lista de modelos compatibles, campo Usage, mejores prácticas y errores comunes
- Enlace:
-
Precios de Gemini Developer API: precios estándar de los modelos y tarifas de caché
- Enlace:
aistudio.google.com/docs/pricing - Descripción: Precio unitario de entrada y salida de cada modelo y fecha de entrada en vigor
- Enlace:
-
Documentación de la API Interactions: propósito de la interfaz y pasos de ejecución
- Enlace:
aistudio.google.com/docs/interactions-overview - Descripción: Conversaciones con estado, estructura de steps y diferencias con generateContent
- Enlace:
-
Google Python SDK v3.6.0 e Issue #2185: evidencia de ingeniería y registro de necesidades de desarrolladores
- Enlace:
github.com/googleapis/python-genai/releases/tag/v3.6.0 - Enlace:
github.com/googleapis/python-genai/issues/2185 - Descripción: Actualización del esquema público del SDK y necesidades tempranas de la comunidad
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes contactarnos desde la página principal de APIYI apiyi.com; para más recursos de integración, visita el centro de documentación en docs.apiyi.com