Nota del autor: a partir de las pruebas públicas con tres agentes personales, desglosamos los problemas de la capa de interfaz que hay detrás de sus carencias de ejecución y ofrecemos una lista de correcciones para la llamada a herramientas, la tolerancia a fallos y los reintentos, la compatibilidad de formatos y el control de costos.
36Kr publicó el 4 de noviembre de 2026 «Los agentes personales se sientan a la mesa: ¿quién mostró primero sus debilidades?», donde puso a tres agentes personales en la misma mesa y los sometió a pruebas reales. Las conclusiones de este tipo de comparativas suelen coincidir bastante: a los agentes no les falta “saber hablar”, les falta “terminar lo que empiezan”. El problema central que aborda este artículo es que las carencias de ejecución de los agentes, en la mayoría de los casos, están en la capa de interfaz, y no solo en el modelo en sí.
Este no es otro artículo de ranking sobre “qué agente es más listo”. No vamos a repetir las puntuaciones concretas del artículo original. En lugar de eso, agrupamos los fallos de ejecución más habituales en este tipo de pruebas en 5 categorías y después los relacionamos uno a uno con los puntos que se pueden corregir en el diseño de la interfaz de los agentes.
Valor clave: al terminar este artículo, sabrás qué parámetros de interfaz conviene revisar primero cuando montes tu propio agente, cómo gestionar los fallos y cómo cambiar sin problemas entre los dos formatos de interfaz de OpenAI y Anthropic.
Puntos clave de las deficiencias de ejecución de la API del Agent
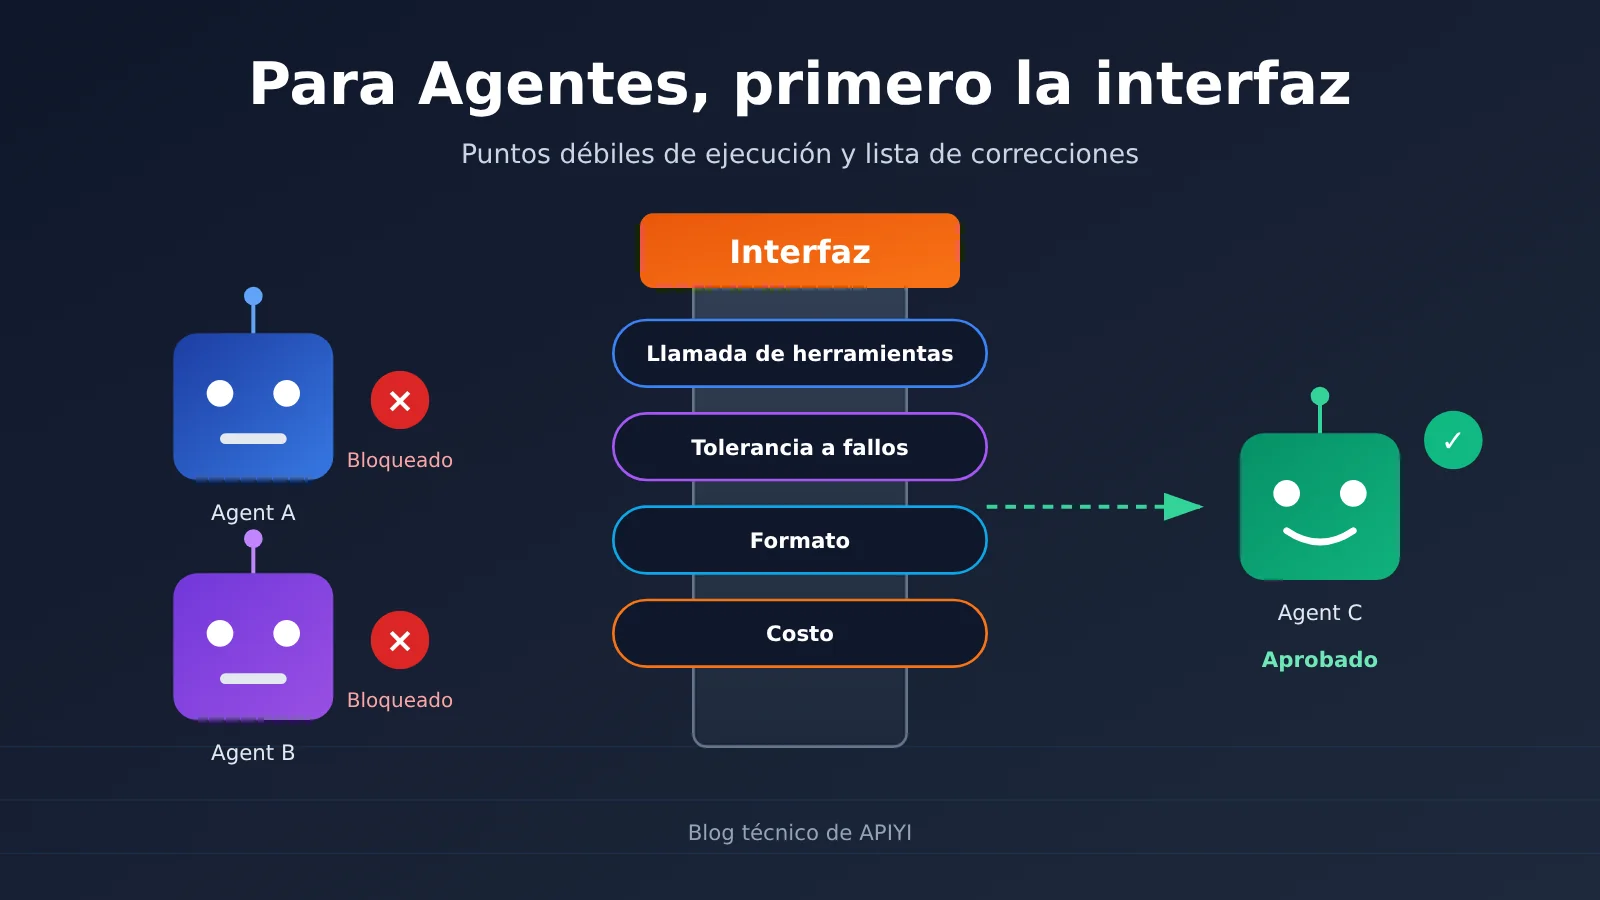
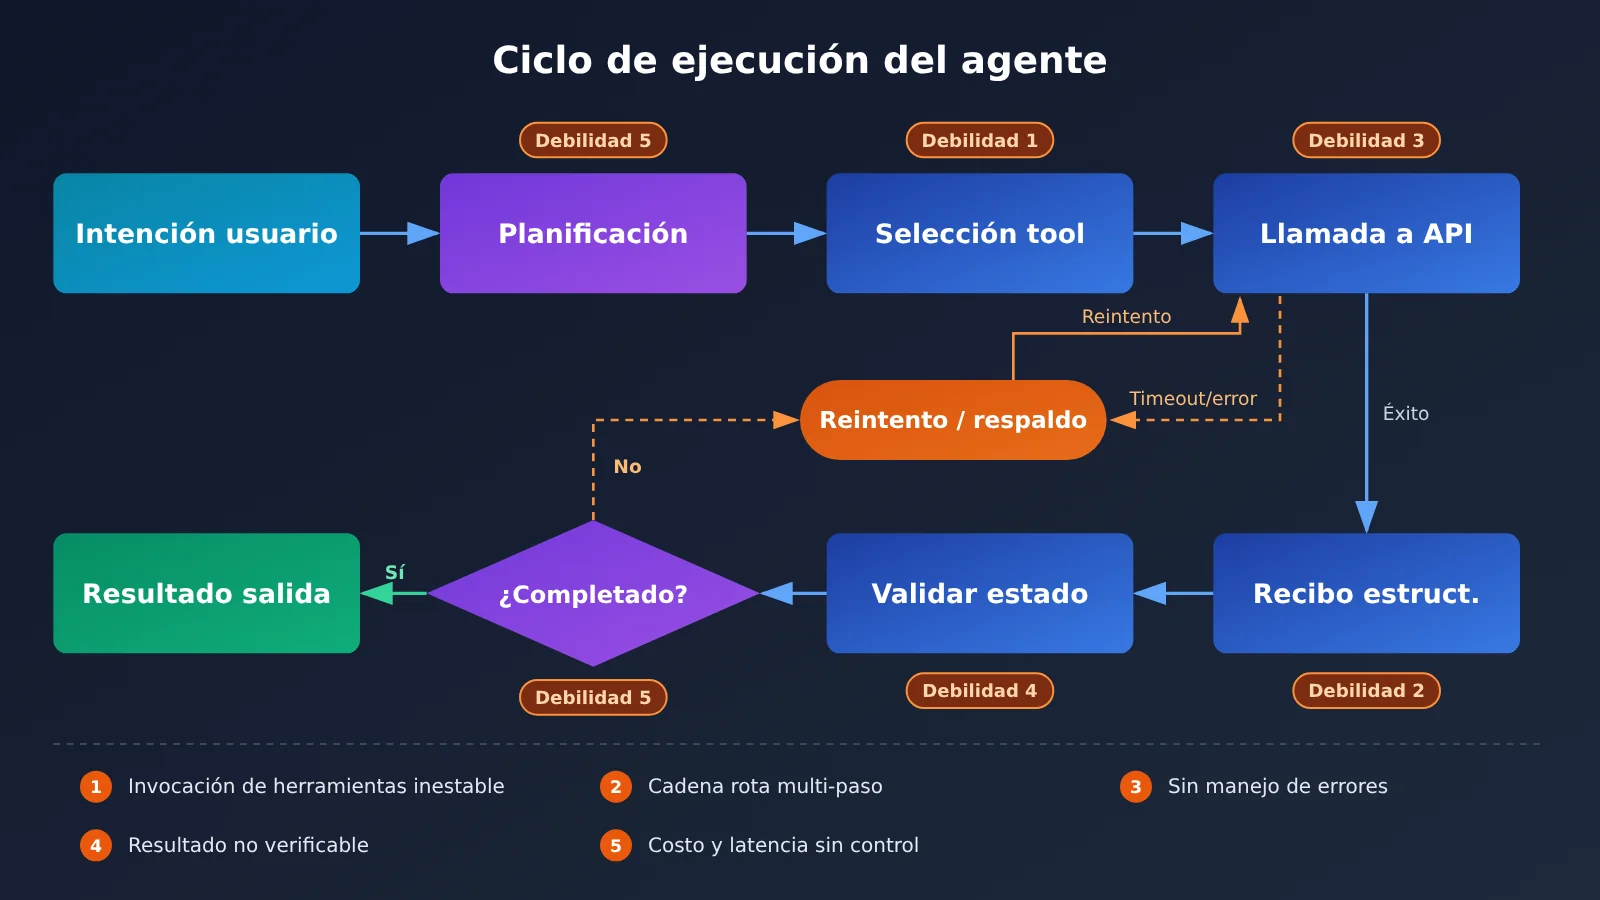
El objetivo de un Agent personal es encargarse de todo por el usuario: reservar billetes, organizar correos, recopilar información, operar páginas web. Basta con que falle un solo paso para que el usuario sienta que “no terminó”. Si seguimos la pista a los fallos más habituales en las pruebas reales, casi todos acaban en los 5 tipos de problemas de API que aparecen abajo.
| Deficiencia de ejecución | Síntoma típico | Causa raíz en la capa de API | Enfoque de solución |
|---|---|---|---|
| Invocación de herramientas inestable | Elige la herramienta equivocada, faltan campos en los parámetros, formato inválido | Descripción de la herramienta ambigua, el esquema no impone restricciones | Simplificar el conjunto de herramientas y definir un esquema de parámetros estricto |
| Ruptura de la cadena en tareas de varios pasos | Llega al tercer o cuarto paso y ya ha olvidado el objetivo | Contexto gestionado de forma demasiado laxa, los resultados de las herramientas no se devuelven correctamente | Normalizar el historial de mensajes y comprimir los resultados intermedios |
| Fallos externos sin mecanismo de respaldo | Ante un límite de tasa o un timeout, abandona directamente o miente diciendo que ha terminado | No distingue los tipos de error ni aplica una estrategia de reintento | Reintentar por niveles según el código de estado, añadir timeout y degradación |
| Resultados no verificables | Responde “ya está hecho” cuando en realidad no ha hecho nada | Faltan acuses de recibo de ejecución y validación de estado | Exigir un acuse de recibo estructurado en cada paso |
| Costes y latencia fuera de control | Llamadas en bucle, una sola tarea consume una gran cantidad de tokens | No hay límite de pasos ni se aprovecha la caché | Fijar un número máximo de turnos, usar modelos por capas y aprovechar la caché |
Detalle de las principales deficiencias de la API del Agent
Las dos primeras deficiencias parecen un problema de capacidad del modelo, pero en realidad gran parte se puede resolver con ingeniería. La causa más habitual de una invocación de herramientas inestable es darle al modelo decenas de herramientas a la vez, con descripciones que se solapan; es normal que el modelo elija mal. Si reducimos las herramientas al ámbito que la tarea actual realmente necesita y especificamos para cada parámetro el tipo, los valores de enumeración y si es obligatorio, la tasa de error suele bajar de forma notable. La ruptura en tareas de varios pasos suele estar en la devolución de resultados de las herramientas: si no se vincula el resultado con el ID de llamada correspondiente según el protocolo, el modelo no puede confirmar si el paso anterior tuvo éxito o no.
Las tres últimas son problemas puramente de ingeniería. Un Agent competente debe tener claro qué hacer si algo falla y cómo demostrar que ha terminado. En las pruebas reales, lo que más decepciona al usuario no es el fallo en sí, sino que después del fallo se finja éxito. Por eso, un mecanismo de acuse de recibo y una clasificación de errores en la capa de API resultan más útiles que cambiar a un modelo más grande.
Puesta en marcha rápida de la interfaz de Agent: lista de verificación en 5 pasos
Los pasos siguientes no dependen de ningún framework concreto: sirven tanto si escribes tu propio bucle de Agent a mano como si usas un framework de Agent ya existente. Tal como se indica en este artículo, aquí no incluimos código; toda la configuración clave va explicada en tablas.
Paso 1: unificar el punto de entrada de la interfaz de Agent
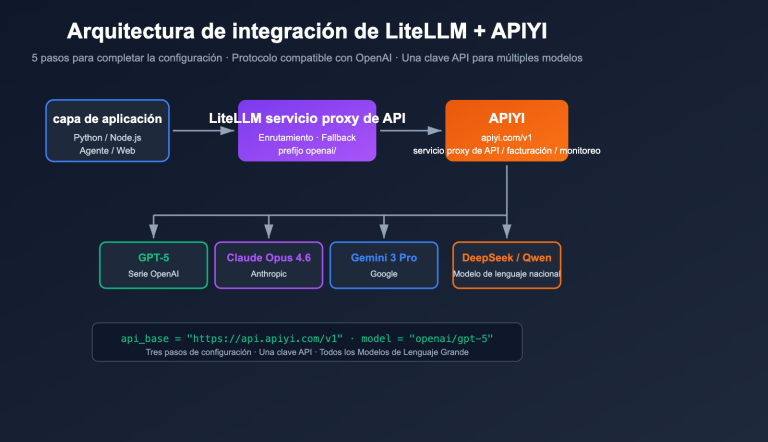
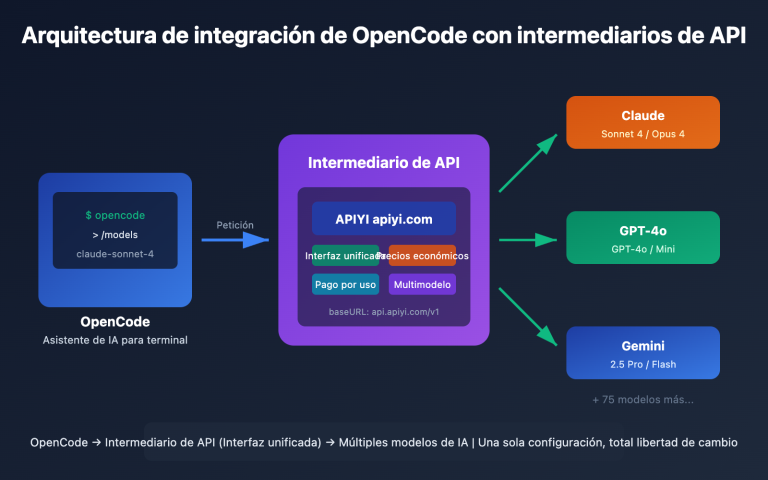
Un Agent suele necesitar una combinación de «modelo potente para planificar y modelo rápido para ejecutar». Si cada modelo se integra por separado con un proveedor distinto, la autenticación, el formato de los errores y los criterios de facturación serán diferentes en cada caso, y el coste de diagnóstico se dispara. Lo más cómodo es usar un punto de entrada unificado compatible a la vez con los formatos de interfaz de OpenAI y Anthropic: basta con cambiar base_url, api_key y model para cambiar de modelo.
| Elemento de configuración | Función | Valor recomendado |
|---|---|---|
base_url |
Dirección de la interfaz | Según la documentación del proveedor; por ejemplo, la dirección indicada en la documentación de APIYI, docs.apiyi.com |
api_key |
Credencial de autenticación | Guárdala en una variable de entorno; no la escribas en la indicación ni en los logs |
model |
Nombre del modelo | Configura por separado planificación y ejecución, para poder sustituirlos de forma independiente |
timeout |
Tiempo de espera por petición | Ajústalo según el tipo de tarea; en tareas de salida larga, relájalo un poco |
max_retries |
Número de reintentos automáticos del SDK | Mantenlo bajo; que la capa de negocio gestione sus propios reintentos por niveles |
🚀 Inicio rápido: APIYI ofrece acceso por API a los principales Modelos de Lenguaje Grande que aparecen en este artículo y es compatible al mismo tiempo con los formatos de interfaz de OpenAI y Anthropic; con los SDK actuales basta con cambiar
base_urlpara conectarse. Encontrarás las instrucciones de integración en el centro de documentación de APIYI: docs.apiyi.com.
Paso 2: Definir con rigor los parámetros de invocación de herramientas del agente
La invocación de herramientas es la primera barrera para que un agente pueda ejecutar acciones. Cuanto más estrictos sean los parámetros, menor será el margen para que el modelo “improvise” y más baja será la tasa de errores.
| Parámetro | Significado | Recomendación práctica |
|---|---|---|
tools |
Lista de herramientas que se pueden invocar | En cada turno, expón solo las herramientas necesarias para la etapa actual; en la descripción, indica claramente “cuándo usarla y cuándo no” |
tool_choice |
Estrategia de selección de herramientas | Especifica una herramienta cuando haya que forzar una acción; déjalo en automático para preguntas abiertas |
| Esquema de parámetros | Estructura de entrada de la herramienta | Incluye los campos obligatorios en required; siempre que puedas usar enumeraciones, evita el texto libre |
response_format |
Salida estructurada | Exige una estructura JSON en la respuesta final para que el programa pueda validarla con facilidad |
max_tokens |
Límite de salida | En el formato de Anthropic es obligatorio; hay que estimarlo según la tarea |
temperature |
Aleatoriedad | Bájala en los pasos de ejecución para reducir que una misma entrada genere acciones distintas |
Paso 3: Gestionar las diferencias de formato entre OpenAI y Anthropic
Muchos agentes parecen “volverse de repente más torpes” al cambiar de modelo, y la causa no está en el modelo, sino en que los protocolos de herramientas de ambos formatos son distintos y los resultados se devuelven de forma desalineada. La siguiente tabla recoge las diferencias que más errores suelen causar.
| Aspecto | Formato OpenAI Chat Completions | Formato Anthropic Messages |
|---|---|---|
| Ubicación del mensaje de sistema | Se incluye en messages, con rol system |
Se usa el parámetro de nivel superior system |
| Definición de herramientas | type: function más un objeto function |
name, description, input_schema |
| Cuando el modelo inicia una llamada | tool_calls dentro del mensaje del asistente |
Bloque de contenido de tipo tool_use |
| Devolución del resultado de la herramienta | Mensaje con rol tool e incluye tool_call_id |
Bloque de contenido tool_result dentro de un mensaje de usuario, asociado a tool_use_id |
| Límite de salida | max_tokens es opcional |
max_tokens es obligatorio |
Ninguno de los dos formatos es intrínsecamente mejor; lo importante es mantener una sola representación intermedia dentro del agente y convertirla al formato correspondiente en el momento de la solicitud. Si utilizas un punto de entrada compatible con ambos formatos, como APIYI, puedes hacer que la serie Claude utilice el formato nativo de Anthropic y que los demás modelos usen el formato de OpenAI, de modo que cada uno conserve la capacidad de invocación de herramientas más completa posible.
Paso 4: Diseñar un plan de contingencia para los fallos de la interfaz del Agent
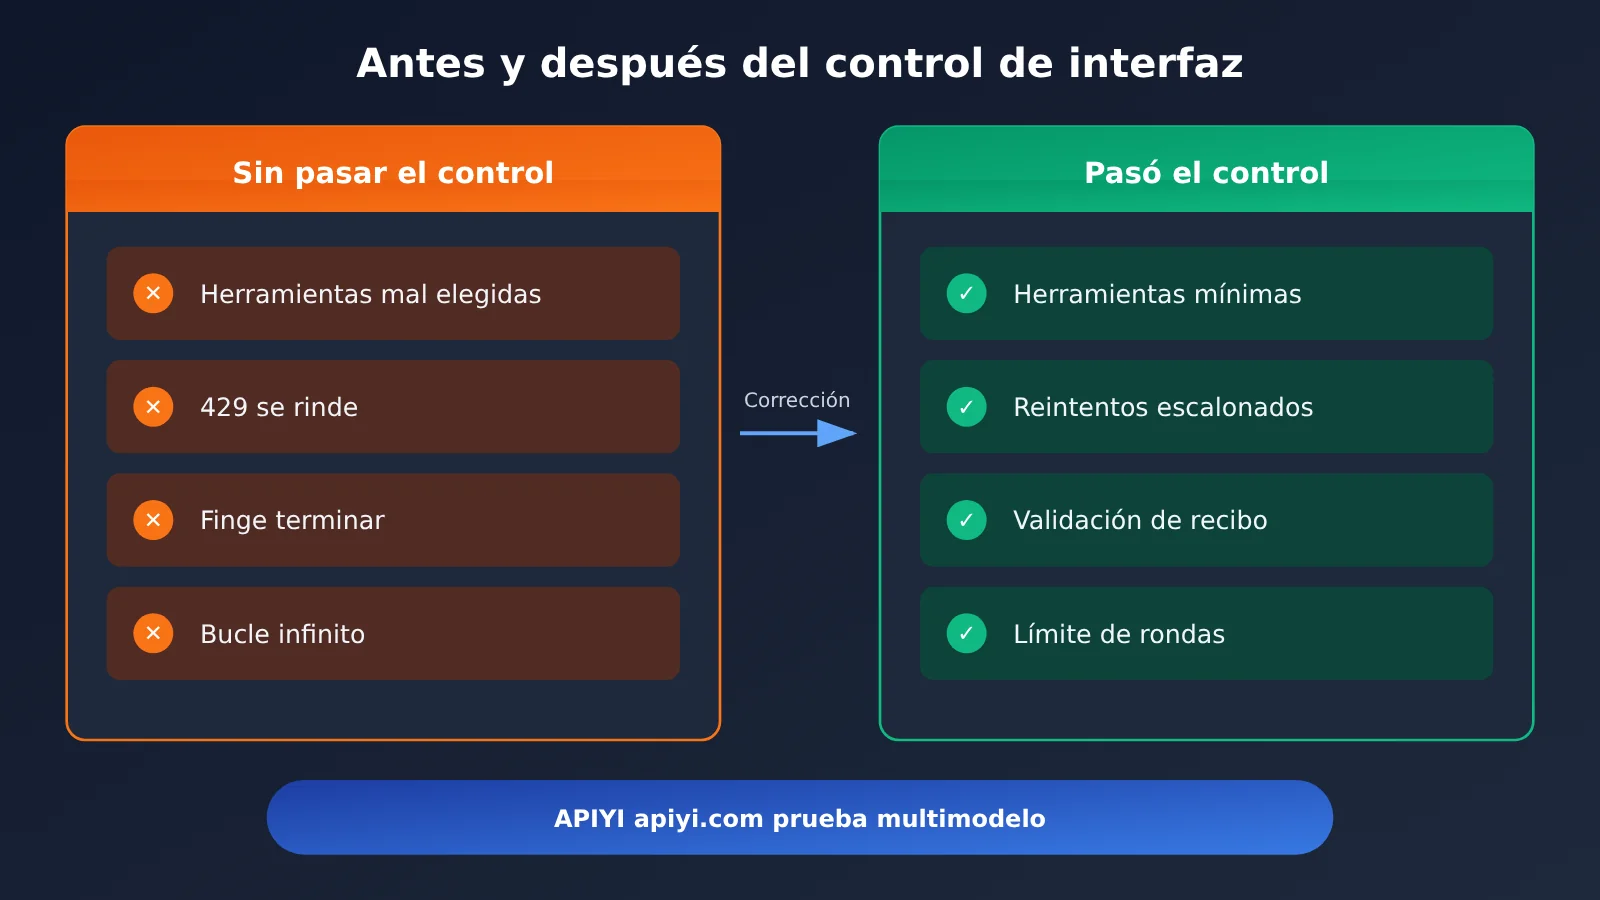
«Si falla, lo dejamos» y «si falla, fingimos que funcionó» son las dos conductas que más dañan la experiencia en las pruebas reales. Lo correcto es clasificar primero por tipo de error y luego decidir si reintentar, degradar o informar honestamente al usuario.
| Tipo de error | Causa habitual | Estrategia del Agent |
|---|---|---|
| 400, error de parámetros | Parámetros de herramienta inválidos, formato de mensaje desalineado | No reintentar a ciegas: devolver el mensaje de error al modelo para que lo corrija una vez |
| 401 / 403, autenticación | Clave inválida o permisos insuficientes | Terminar de inmediato y pedir al usuario que revise la configuración |
| 429, límite de tasa | Concurrencia demasiado alta o cuota insuficiente | Reintentar con retroceso exponencial y, si hace falta, cambiar a un modelo de respaldo |
| 5xx, error del servidor | Fluctuaciones del servicio upstream | Reintentos limitados; al superar el máximo, degradar |
| Timeout | Salidas largas o inestabilidad de red | Pasar a salida en streaming, o dividir la tarea en partes más pequeñas y reintentar |
Hay un detalle que se suele pasar por alto: las herramientas con efectos secundarios deben ser idempotentes. En operaciones como enviar correos, hacer un pedido o escribir en la base de datos, antes de reintentar hay que confirmar si la vez anterior ya surtió efecto; de lo contrario, el Agent hará dos veces lo mismo.
Paso 5: Añadir recibos de ejecución y compuertas de coste al Agent
Cada herramienta, al terminar, debería devolver un recibo estructurado que incluya al menos tres campos: «si tuvo éxito, qué se hizo y el identificador del resultado clave». Antes de que el Agent anuncie que la tarea está completada, debe ser el programa —y no el modelo— quien verifique el recibo; así se elimina por diseño el «fingir que terminó».
En cuanto al coste, se recomienda añadir tres compuertas: número máximo de rondas de bucle, presupuesto de tokens por tarea y detección de llamadas repetidas. Trabajos como planificar, ejecutar y clasificar pueden repartirse entre modelos de distintos niveles; conviene mantener estables los prompts de sistema largos y las definiciones de herramientas para aprovechar la caché de indicaciones. Para los precios concretos de entrada, salida y caché, así como los criterios de facturación, toma como referencia los datos reales de la página de precios de APIYI https://docs.apiyi.com/models; este artículo no ofrece ninguna cifra de precio sin verificar.
💡 Recomendación: en la fase de construcción, recorre todo el ciclo cerrado con poco tráfico y luego ve añadiendo herramientas poco a poco. Con APIYI apiyi.com puedes comparar rápidamente, bajo una misma clave API, la estabilidad de distintos modelos en la invocación de herramientas; cambiar de modelo solo requiere modificar el campo
model.
Referencia de selección de interfaces de Agent por capas
Un Agent con buena capacidad de ejecución rara vez usa un solo modelo. Organizarlo por capas según su responsabilidad no solo mejora la estabilidad, sino que también facilita controlar los costos.
| Capa de responsabilidad | Requisitos de capacidad | Criterio de selección | Plataformas disponibles | Referencia de precio |
|---|---|---|---|---|
| Capa de planificación | Contexto largo, razonamiento complejo, descomposición de tareas | Elegir un modelo insignia con gran capacidad de razonamiento | APIYI apiyi.com, API oficial | Según la página de precios de APIYI |
| Capa de ejecución | Invocación de herramientas estable, respuesta rápida | Elegir un modelo de gama media con desempeño estable en la invocación de herramientas | APIYI apiyi.com, API oficial | Según la página de precios de APIYI |
| Capa ligera | Clasificación de intenciones, validación de formato, compresión de resúmenes | Elegir un modelo pequeño de baja latencia y bajo costo | APIYI apiyi.com, API oficial | Según la página de precios de APIYI |
Para saber qué modelos están disponibles concretamente y cuáles son los nombres de modelo más recientes, consulta la documentación de APIYI en docs.apiyi.com. Te recomiendo tomar tus propias tareas reales y ejecutar una tanda de muestras con cada modelo, midiendo la tasa de éxito en la invocación de herramientas, el número promedio de turnos y el consumo por tarea; luego decide qué modelo usar en cada capa, sin quedarte solo con los rankings públicos.
Preguntas frecuentes (FAQ)
P1: ¿Qué es la «barrera de la interfaz» en un Agent?
Se refiere a la capa de ingeniería que hay entre que el Agent «lo tiene claro» y «lo termina de hacer», e incluye la definición de herramientas, el protocolo de invocación, el manejo de errores, el acuse de recibo de resultados y el control de costos. El modelo se encarga de decidir y la capa de interfaz de llevar esas decisiones a la práctica de forma fiable. Si esta barrera no se supera, incluso el modelo más potente acabará mostrando una mala capacidad de ejecución.
P2: ¿La mala ejecución es culpa del modelo o de la interfaz?
De ambas cosas, pero los problemas de interfaz suelen subestimarse. Elegir mal la herramienta, usar formatos de parámetros incorrectos, romper la cadena de llamadas o afirmar que se ha terminado cuando en realidad ha fallado son situaciones que en buena medida se pueden mitigar endureciendo el schema, normalizando el retorno de resultados y añadiendo validaciones en el acuse de recibo. Mi recomendación es dejar bien sólida la capa de interfaz antes de decidir si de verdad hace falta cambiar de modelo.
P3: ¿Qué tendencia muestran las pruebas con tres Agent personales?
Este reportaje de pruebas de 36Kr de noviembre de 2026 muestra que los Agent personales ya han entrado en la fase de «a ver quién es capaz de terminar de verdad las tareas», y el foco de la comparación ha pasado de la calidad de la conversación al ciclo cerrado de ejecución. Para conocer el comportamiento concreto de cada producto, consulta el artículo original; aquí solo extraigo las lecciones de ingeniería de carácter general.
Q4: ¿Debo elegir el formato de OpenAI o el de Anthropic?
Depende del modelo. La serie Claude usa de forma nativa el formato de Anthropic, lo que permite aprovechar al completo funciones como la invocación de herramientas y el caché; para la mayoría de los demás modelos, el formato de OpenAI es más universal. APIYI es compatible con ambos formatos, así que puedes mantener una representación intermedia unificada dentro del Agent y convertirla según el modelo en el momento de la petición.
Q5: ¿Cómo conecto varios modelos a mi Agent de forma rápida?
1. Regístrate en APIYI apiyi.com y obtén tu API Key;
2. Configura `base_url` siguiendo la documentación de docs.apiyi.com;
3. Rellena `model` por separado en la capa de planificación y en la de ejecución, y haz pruebas comparativas con el mismo lote de tareas.
Todo el proceso no requiere tocar el SDK, solo ajustar elementos de configuración.
Q6: ¿Cómo estimo el costo de un Agent y dónde consulto los precios?
Primero calcula el número medio de turnos por tarea y los tokens de entrada y de salida, y luego multiplícalo por el precio unitario del modelo correspondiente. Los precios de entrada, salida y caché, así como los criterios de facturación, deben tomarse siempre de los datos reales de la página de precios de APIYI https://docs.apiyi.com/models; las diferencias entre modelos son considerables, así que conviene hacer los cálculos con la página real.
Q7: Cuando hay muchas herramientas, el Agent se vuelve cada vez más inestable. ¿Qué hago?
Expón las herramientas de forma dinámica según la fase de la tarea, y en cada turno dale al modelo solo unas pocas herramientas relevantes. También puedes usar primero un modelo ligero para clasificar el enrutamiento y luego pasar al modelo de ejecución el subconjunto de herramientas correspondiente. Dejar claros los límites de aplicación en la descripción de cada herramienta resulta más eficaz que acumular más ejemplos.
Q8: Después de trabajar bien la capa de interfaz, ¿qué limitaciones quedan?
La capa de interfaz mejora mucho la estabilidad, pero no resuelve el techo de razonamiento del propio modelo ni los cambios de sitios web o servicios de terceros. En tareas de cadena larga sigue siendo recomendable mantener puntos de confirmación humana, sobre todo en operaciones irreversibles como pagos, borrados o envíos al exterior.
Puntos clave sobre la capacidad de ejecución en la interfaz de Agent
- Las carencias de ejecución suelen estar en la capa de interfaz: elegir mal la herramienta, romper la cadena de pasos, afirmar que se ha completado cuando no es así… la mayoría de estos problemas tienen solución de ingeniería
- Mejor pocas herramientas que demasiadas: exponer las herramientas por fases; cuanto más estricto sea el schema de parámetros, más estable será el resultado
- Hay que aislar las diferencias de formato: una representación interna unificada y, al hacer la petición, convertir al formato de OpenAI o de Anthropic
- Los errores deben clasificarse: 400 corregir, 429 hacer backoff, 5xx degradar; las operaciones con efectos secundarios deben ser idempotentes
- La finalización la determina el programa: recibo estructurado más validación de estado, para evitar el «falso completado»
- Poner puertas al coste: límite de turnos, presupuesto de tokens y usar modelos por niveles; los precios se consultan en la página de precios de APIYI
- Ruta de inicio: acceder a varios modelos a través del punto de entrada unificado de APIYI; basta con cambiar
base_urlymodelpara comparar
Resumen
Las pruebas reales de tres Agent personales son un toque de atención para los desarrolladores: el foco de la competencia entre Agents está pasando de «saber conversar» a «saber terminar». Para completar la capacidad de ejecución, la inversión más rentable es superar primero la barrera de la interfaz:
- Invocación de herramientas: simplificar las herramientas, apretar el schema y normalizar el retorno de resultados;
- Tolerancia a fallos y red de seguridad: clasificación de errores, reintentos limitados y protección de idempotencia;
- Verificable y controlable: recibos estructurados, validación por programa y puertas de coste.
Se recomienda empezar con una tarea real y recorrer todo el ciclo completo antes de ampliar capacidades poco a poco. Recomendamos acceder a través de APIYI apiyi.com, compatible con los formatos de interfaz de OpenAI y Anthropic, lo que facilita comparar la estabilidad de ejecución de distintos modelos. La documentación está en docs.apiyi.com y los precios se consultan en https://docs.apiyi.com/models.
📚 Materiales de referencia
- 36Kr: los agentes personales llegan a la mesa, ¿quién mostró debilidad primero?: reportaje de pruebas reales con tres agentes personales
- Enlace:
36kr.com/p/4055385191224452 -
Nota: es la fuente del tema de este artículo; para conocer los productos concretos y su desempeño en las pruebas, consulte el texto original
-
Centro de documentación de APIYI: configuración de integración y descripción de los modelos disponibles
- Enlace:
docs.apiyi.com -
Nota: configuración de
base_url, formas de integración en formato OpenAI y Anthropic -
Página de precios de modelos de APIYI: precio unitario y criterios de facturación
- Enlace:
docs.apiyi.com/models - Nota: todo el contenido relacionado con precios en este artículo se basa en los datos reales de esta página
Autor: equipo técnico de APIYI
Contacto técnico: puede escribirnos a través del sitio web oficial de APIYI, apiyi.com; para más materiales de integración, visite el centro de documentación en docs.apiyi.com