Resumen: Este artículo analiza el descuento nocturno del 8 % en Credits de Qwen4-Max-Preview y compara, desde tres perspectivas —alcance de uso, unidad de facturación y costo total por tarea—, el plan de suscripción Token Plan, la API de pago por uso de la versión oficial y las plataformas de agregación de API multimodelo.
Qwen4-Max-Preview: la conclusión sobre el 8 % de Credits, de entrada
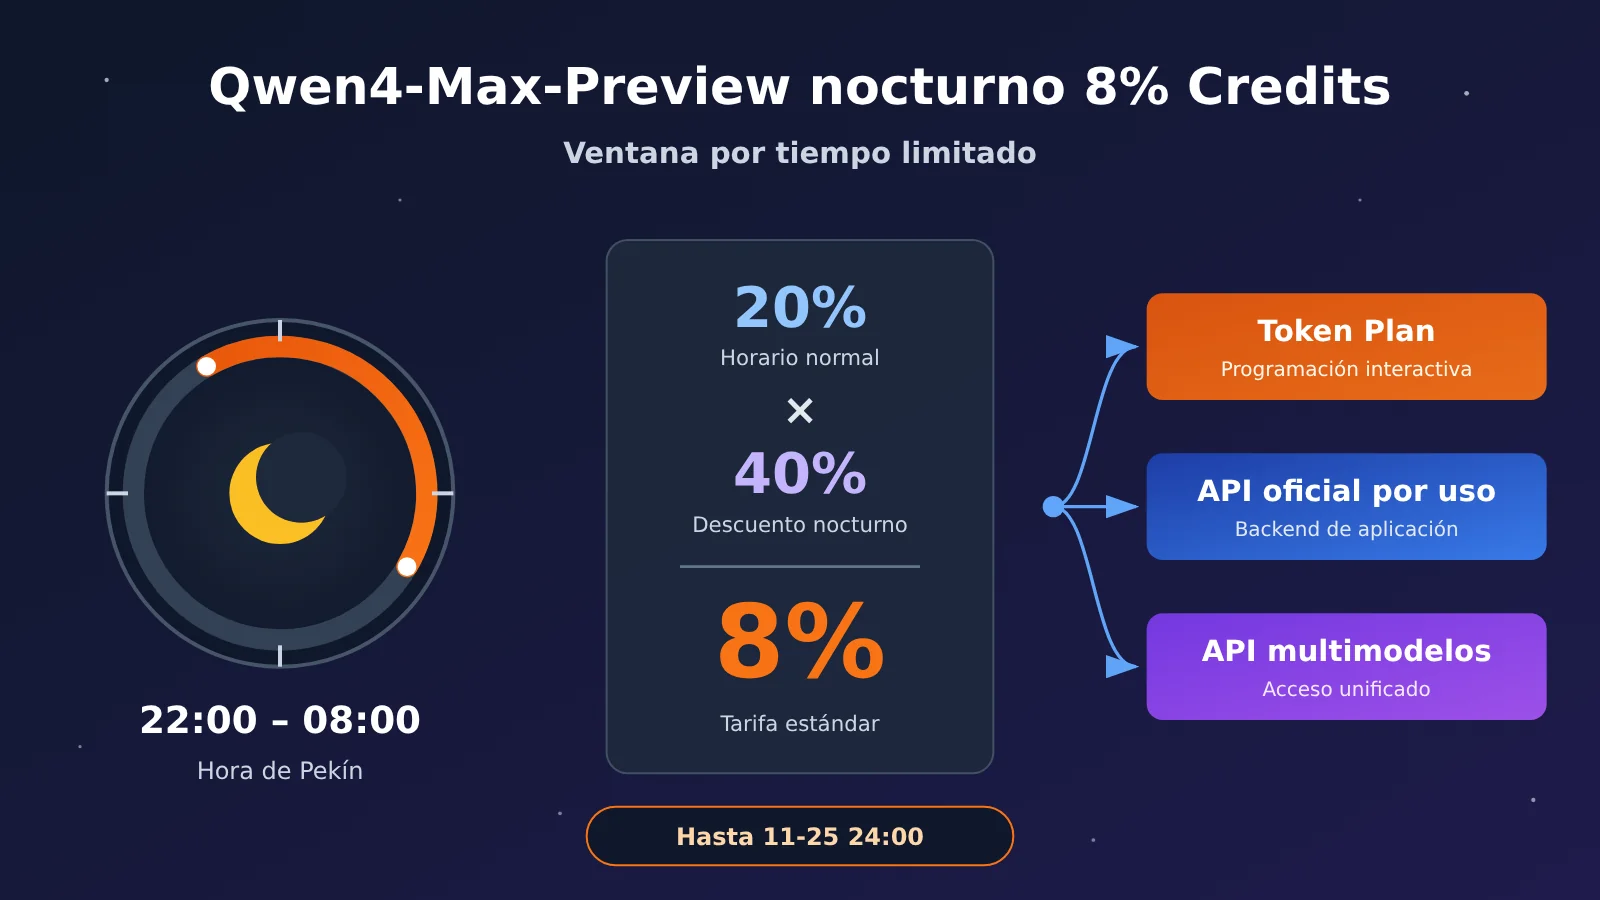
Al invocar Qwen4-Max-Preview en Token Plan, el consumo de Credits entre las 22:00 y las 08:00 (hora de Beijing) equivale al 8 % de la tarifa estándar. Esta cifra se obtiene al combinar el precio al 20 % del horario normal con un descuento nocturno adicional que deja el precio en el 40 % de ese valor (20 % × 40 % = 8 %). La promoción estará vigente hasta el final de Preview, es decir, hasta las 24:00 del 25 de noviembre de 2026 (hora de Beijing); después, el modelo dejará de estar disponible.
Este descuento solo aplica a los escenarios permitidos por Token Plan, es decir, al uso interactivo dentro de herramientas de programación y herramientas de agentes. Si necesitas conectar el modelo al backend de una aplicación propia o a procesos automatizados, tendrás que elegir un producto de API de pago por uso que permita esos casos de uso. La versión oficial Qwen4-Max, lanzada el 16 de noviembre, ya ofrece precios independientes de pago por uso y puede cubrir esa necesidad.
A continuación, desglosamos el cálculo del 8 % y los precios de los planes Token Plan; luego explicamos la base de facturación por uso y el mecanismo de caché de la versión oficial. Después comparamos las tres opciones de invocación con cuatro criterios: tareas aptas, modalidad de uso, unidad de facturación e interfaz. También presentamos un marco de cálculo para agrupar costos por tarea. Para terminar, damos recomendaciones según el tipo de tarea real del desarrollador.
Para saber: terminología de facturación de Qwen4-Max-Preview
| Término | Explicación |
|---|---|
| Credits | Unidad de consumo de los planes de suscripción Token Plan; la cantidad consumida depende del modelo utilizado y de la composición concreta de cada llamada |
| Token | Unidad de medida de la entrada, la salida y el contenido de razonamiento del modelo |
| Token Plan | Producto de Alibaba Cloud que entrega derechos de Credits por ciclo de suscripción, con versión personal y versión de equipo |
| API de pago por uso | Modalidad de servicio de modelos facturada según el volumen real de llamadas, pensada para la integración de aplicaciones |
| Acierto de caché | La entrada reenviada se reutiliza en el servidor y se calcula según la regla de facturación correspondiente a la caché |
| Token de razonamiento | Tokens generados durante el proceso de inferencia del modelo; ocupan el presupuesto de salida y se incluyen en la facturación de salida |
| Plataforma de agregación de API | Servicio que ofrece invocación de múltiples modelos y gestión de consumo a través de una interfaz unificada |
| Costo unitario por tarea | Suma de todas las solicitudes, reintentos, llamadas a herramientas y consumo de modelos necesarios para completar un mismo objetivo |
1 ¿Cómo se llega a pagar solo el 8% de la tarifa estándar con Qwen4-Max-Preview?
1.1 Dos capas de descuento acumuladas: 20% × 40% = 8%
Durante el periodo de la promoción Preview, Token Plan establece dos capas de descuento en Credits para Qwen4-Max-Preview:
- Horario normal: el consumo de Credits es el 20% de la tarifa estándar. Con el mismo presupuesto de Credits, en teoría se puede completar un volumen de invocaciones aproximadamente 5 veces mayor que con la tarifa estándar.
- Horario nocturno: todos los días, de 22:00 a 08:00 del día siguiente, hora de Pekín, sobre ese 20% se aplica otro 40%.
- Resultado acumulado: 20% × 40% = 8%, es decir, el 8% de la tarifa estándar.
La documentación oficial ofrece un ejemplo de proporción: si una llamada debe consumir 100 Credits según la tarifa estándar, en horario normal consume 20 Credits y en horario nocturno 8 Credits. Es solo un ejemplo matemático para mostrar la proporción; el consumo real de cada invocación debe verificarse en el detalle de uso de la consola. La empresa también se reserva el derecho de ajustar la promoción según las condiciones operativas.
1.2 Límites temporales de la ventana por tiempo limitado de Qwen4-Max-Preview
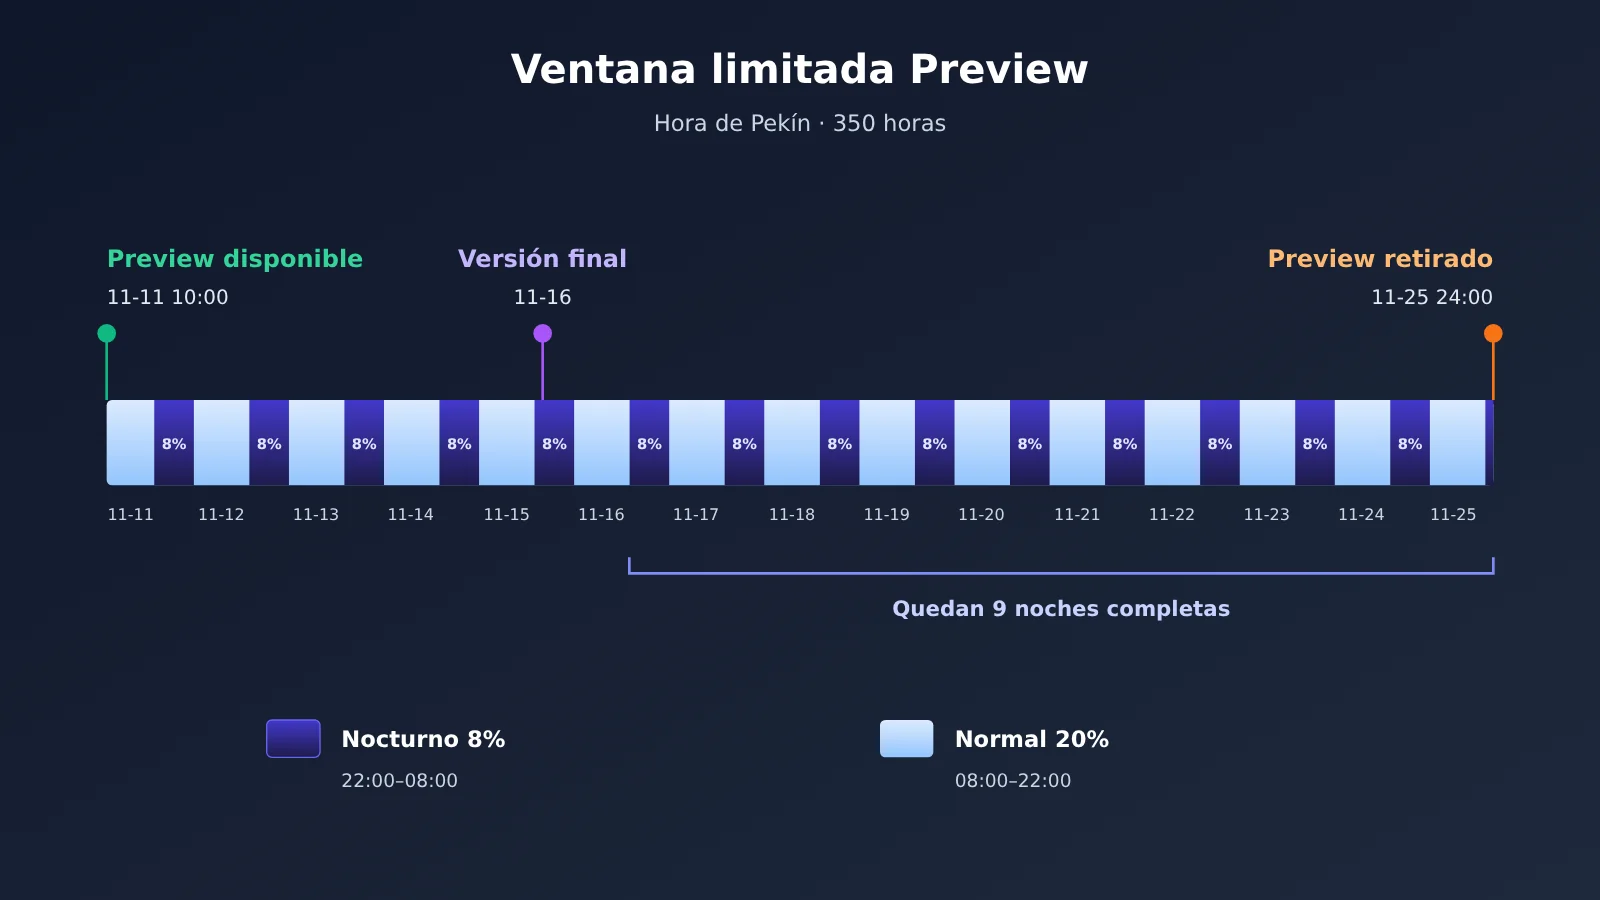
Preview abrió el 11 de noviembre de 2026 a las 10:00 y finaliza el 25 de noviembre a las 24:00 (ambas en hora de Pekín), en total 350 horas. Tomando como referencia hoy, 16 de noviembre, las franjas nocturnas completas que quedan son las 9 noches que van de la noche del 16 de noviembre a la mañana del 25 de noviembre. La noche del 25 de noviembre, la franja nocturna solo dura de 22:00 a 24:00, dos horas; después Preview deja de estar disponible.
Tras el lanzamiento de la versión oficial Qwen4-Max el 16 de noviembre, la fecha de retirada de Preview no cambia. La documentación oficial del modelo ya recomienda usar la versión oficial, así que los flujos de trabajo creados dentro de la ventana de Preview deben prepararse con tiempo para migrar a qwen4-max.
2 Cómo comprar y consumir los Credits del Token Plan
2.1 Precios y cuotas de los paquetes del Token Plan personal
Hasta el 16 de noviembre de 2026, los paquetes publicados en la página oficial del Token Plan personal de Alibaba Cloud son los siguientes. La cuota mensual y los precios se ajustaron el 9 de noviembre, así que las capturas de pantalla y los precios que aparecen en artículos anteriores ya no son válidos.
| Paquete | Precio mensual | Credits mensuales | Agentes concurrentes | Precio para nuevos usuarios |
|---|---|---|---|---|
| Lite | 39 yuanes | 20,000 | 1–2 | 19.5 yuanes/mes |
| Essential | 79 yuanes | 45,000 | 2–3 | 39.5 yuanes/mes |
| Standard | 139 yuanes | 80,000 | 3–4 | La página no indica descuento para nuevos usuarios |
| Pro | 312 yuanes | 200,000 | 6–8 | La página no indica descuento para nuevos usuarios |
El precio para nuevos usuarios es válido hasta el 30 de noviembre de 2026 a las 23:59:59 (UTC+8) y está limitado a las cuentas que nunca hayan comprado antes el Token Plan personal. El descuento para nuevos usuarios reduce el precio de la suscripción del paquete; en cambio, el 2折 y el 0.8折 de Preview reducen el consumo de Credits al invocar el modelo. Son dos cosas que actúan en etapas distintas.
2.2 Reglas de los paquetes de uso adicional del Token Plan
Cuando se agota la cuota del paquete, se pueden comprar paquetes de uso adicional. Las reglas son las siguientes:
- Precio de 100 yuanes por paquete/mes; cada paquete incluye 20,000 Credits.
- Hay que tener ya un paquete válido y se pueden acumular como máximo 5 al mismo tiempo.
- La validez es de un mes y la cuota que no se use caduca al llegar la fecha de vencimiento.
- La cuota del paquete de uso es independiente de la cuota mensual original del paquete.
2.3 La relación de medición entre Credits y Tokens
Los Credits son la unidad de descuento del Token Plan y los Tokens son la unidad de cómputo del modelo; no se pueden convertir uno a uno. Según la explicación oficial, cuántos Credits se descuentan en una invocación depende de los siguientes factores:
- El tipo de modelo y su coeficiente de facturación;
- El número de Tokens de entrada y, dentro de ellos, cuántos aciertan en la caché;
- El número de Tokens de salida, incluidos los Tokens de pensamiento;
- El número de invocaciones de herramientas y las invocaciones adicionales que generan las herramientas integradas y las subtareas.
Por eso, con 39 yuanes y 20,000 Credits no se puede calcular el precio unitario de Qwen4-Max-Preview por millón de Tokens. La página oficial no publica un precio independiente por millón de Tokens para Preview ni admite el pago por uso de Preview. Como referencia, hay un registro real: un desarrollador completó un proyecto interactivo de máquina de garra en Qoder, tardó unos 75 minutos y calculó un consumo de aproximadamente 65 Credits. Se trata del registro de una sola tarea con una herramienta concreta, y sirve únicamente para hacerse una idea del orden de magnitud del consumo.
3 Comparación de los métodos de facturación entre Qwen4-Max-Preview y la versión oficial
3.1 Preview: solo se puede acceder a través del Token Plan exclusivo
El acceso a Preview es fijo: se suscribe el Token Plan en versión personal o de equipo, se obtiene la clave API específica del paquete, se usa la Base URL exclusiva https://token-plan.cn-beijing.maas.aliyuncs.com y se establece el ID del modelo como qwen4-max-preview (alias qwen4.0-max-preview, que es el que aparece de forma uniforme en la facturación). Es compatible con las especificaciones de las interfaces OpenAI Chat Completions, Responses y Anthropic Messages.
El presupuesto de salida de Preview es de 393,216 Tokens, compartido entre el contenido de razonamiento y la respuesta final, y la intensidad de razonamiento predeterminada es xhigh. Al migrar desde otros modelos, si se configura max_tokens basándose solo en la longitud de la respuesta final, la respuesta podría quedar truncada porque el contenido de razonamiento consume todo el presupuesto.
3.2 Versión oficial Qwen4-Max: precios de la API con pago por uso
La versión oficial qwen4-max se lanzó el 16 de noviembre. Se puede usar tanto dentro del Token Plan como mediante invocación con pago por uso. A continuación se muestran los precios de facturación por uso de la versión oficial que figuran en la página oficial del modelo (en yuanes, por millón de Tokens):
| Región de despliegue | Entrada | Salida (incluye razonamiento y respuesta) |
|---|---|---|
| China continental, Norte 2 (Pekín) | 10 yuanes | 30 yuanes |
| Estados Unidos, Virginia | 10 yuanes | 30 yuanes |
| Alemania, Fráncfort | 10 yuanes | 30 yuanes |
| Japón, Tokio | 10 yuanes | 30 yuanes |
| China, Hong Kong | 10 yuanes | 30 yuanes |
| Singapur | 10.938 yuanes | 32.813 yuanes |
La región de Pekín cuenta además con una cuota gratuita de 1 millón de Tokens, válida durante 90 días a partir del momento de activación de Bailian, del lanzamiento del modelo o de la aprobación de la solicitud, según lo que ocurra primero; para los detalles concretos prevalecen las reglas de la página oficial. Estos precios se aplican únicamente a la versión oficial y no sirven para deducir el consumo estándar de Credits de Preview.
Los parámetros de la versión oficial también difieren de los de Preview: la ventana de contexto es igualmente de 1,000,000 Tokens, la salida máxima es de 262,144 Tokens en modo de razonamiento y de 131,072 Tokens en modo sin razonamiento; la intensidad de razonamiento predeterminada es high y el presupuesto de razonamiento predeterminado es 131,072. Al migrar, es necesario revisar de nuevo la configuración del límite de salida.
3.3 Mecanismo de caché explícita de la versión oficial Qwen4-Max
La versión oficial admite caché explícita, lo que permite reutilizar prefijos de entrada fijos como la indicación del sistema, las descripciones de herramientas y los documentos de referencia. La caché explícita es compatible con las tres interfaces OpenAI Chat Completions, Responses y Anthropic Messages, y el TTL puede ser de 5 minutos o de 1 hora.
Las tareas de Agent de múltiples turnos normalmente repiten en cada turno las mismas instrucciones del sistema y las mismas descripciones de herramientas, y ahí es justamente donde la caché puede ahorrar más costes. La caché tiene reglas de facturación independientes; para conocer los precios unitarios concretos, consulta la página de facturación de invocación del modelo de la región correspondiente.
4 Los tres modos de invocación de Qwen4-Max-Preview: ¿para quién es cada uno?
4.1 Comparativa de las tres soluciones
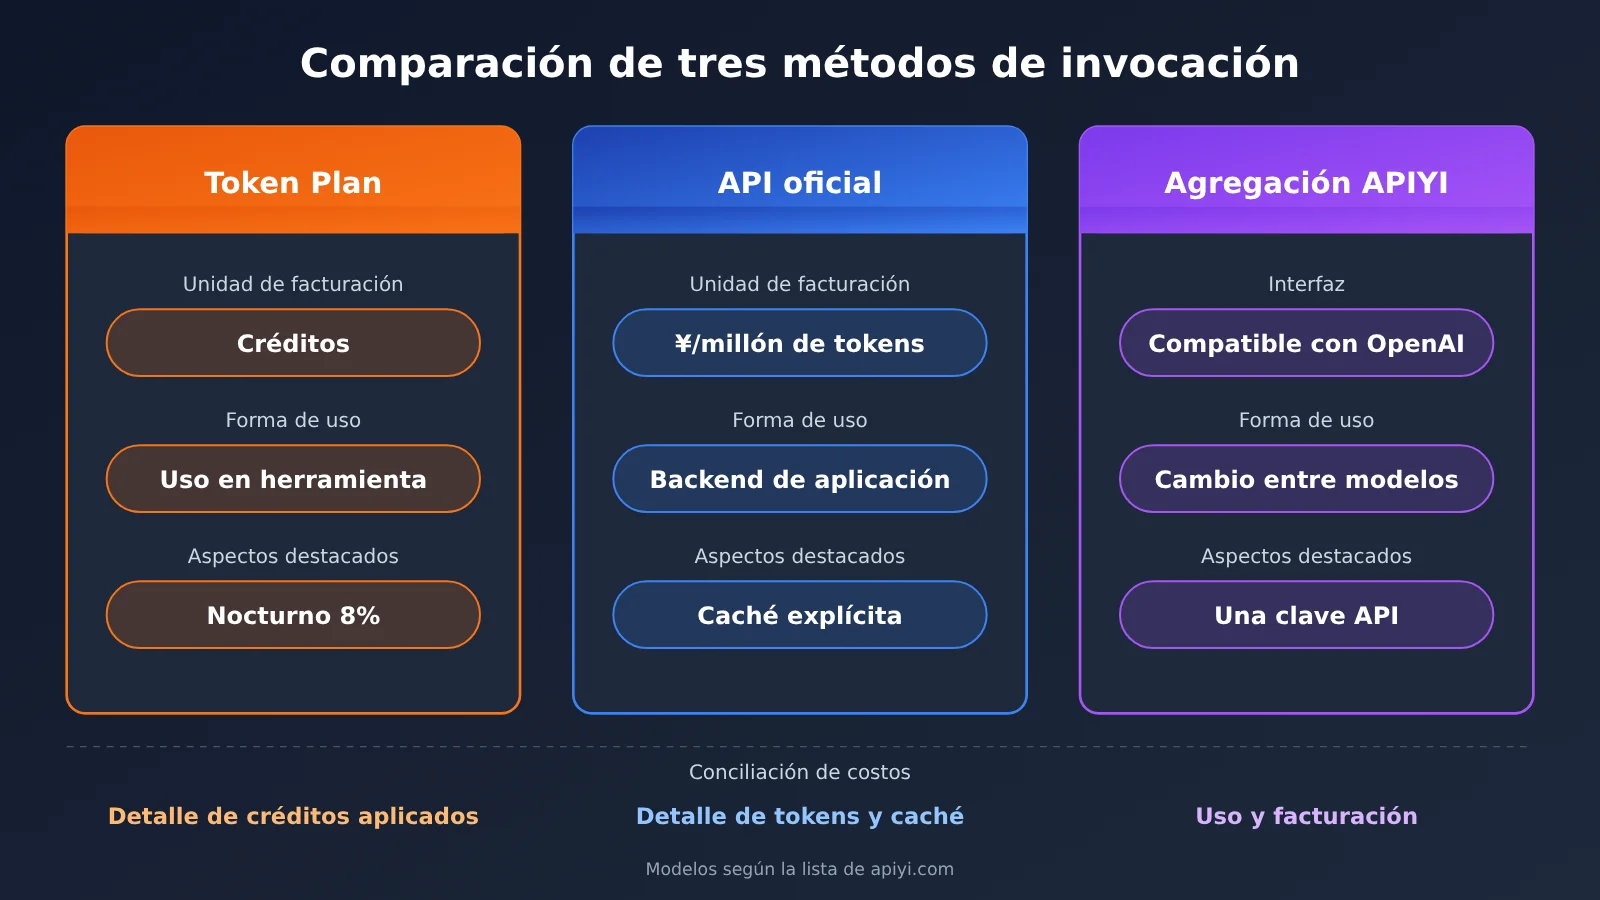
| Dimensión | Suscripción Token Plan | API de pago por uso de la versión oficial | Plataforma de agregación de API multimodelo |
|---|---|---|---|
| Tareas adecuadas | Programación interactiva, conversación con Agent | Backend de aplicaciones propias, negocio automatizado | Aplicaciones multimodelo, comparación y cambio de modelos |
| Formas de uso permitidas | Solo uso interactivo en herramientas de programación y herramientas de agentes inteligentes | Integración en aplicaciones | Integración en aplicaciones, gestión unificada de múltiples modelos |
| Unidad de facturación | Credits | Yuanes/millón de Tokens (según región) | Según el precio unitario por Token publicado en la interfaz de precios de la plataforma |
| Vigencia de la cuota | Los paquetes y bolsas de uso son mensuales; caducan al vencer | Facturación por uso; la cuota gratuita de Pekín dura 90 días | Facturación por uso |
| Interfaz | Base URL dedicada y clave dedicada del paquete | Interfaz oficial de Bailian | Interfaz compatible con OpenAI, como APIYI apiyi.com |
| Método de verificación de costes | Detalle real de deducción de Credits en la consola | Consolidación según el detalle de Tokens y la facturación de caché | Consolidación según el campo usage de la solicitud y la facturación de la plataforma |
4.2 Suscripción a Token Plan: ideal para programación interactiva dentro de herramientas
Token Plan es compatible con herramientas como Claude Code, Cursor, Qwen Code, Qoder, Qoder CN y OpenClaw; consulta la documentación oficial de integración de cada herramienta para más detalles. Cuando los desarrolladores lanzan tareas activamente desde estas herramientas, el descuento nocturno del 8% de Preview se aplica directamente y el costo queda fijado por adelantado en forma de Credits.
Los límites de uso están recogidos en las normas oficiales de permisos: no se pueden usar scripts de automatización para hacer invocaciones por lotes, no se puede colocar la clave del plan en el backend de una aplicación propia, no se pueden hacer invocaciones por lotes no interactivas, ni usar los beneficios del plan a través de plataformas de flujo de trabajo como Dify, n8n o Coze, o de herramientas de prueba de API como Postman o Insomnia. Salirse de estos límites puede provocar la suspensión de la suscripción o el bloqueo de la clave. Además, las condiciones de suscripción de la versión personal establecen que el contenido de entrada y el generado durante el uso se utilizarán para mejorar el servicio y optimizar el modelo; antes de procesar información confidencial, conviene revisar el acuerdo.
4.3 API oficial de pago por uso: ideal para integrar aplicaciones en producción
Para backends de aplicaciones propias, tareas por lotes y flujos automatizados, conviene usar la API de pago por uso del qwen4-max oficial. El criterio de facturación es el precio unitario público en yuanes por millón de tokens y, junto con la caché explícita, el costo se puede verificar solicitud por solicitud. Esta vía no ofrece los descuentos importantes de Credits, pero las formas de uso y el método de facturación son claros y conformes.
4.4 Plataformas de agregación de API multimodelo: ideales para equipos que necesitan una interfaz unificada
Si la aplicación necesita usar a la vez varios modelos como OpenAI, Claude, Gemini, etc., este tipo de plataforma permite hacer la invocación del modelo con una sola clave API y un conjunto de interfaces compatibles con OpenAI, además de gestionar el uso de forma centralizada. APIYI es una de estas plataformas. Cabe aclarar que un artículo del Centro de Ayuda de APIYI del 13 de noviembre registraba que Qwen4 aún no aparecía en la tabla general de modelos ni en la interfaz de precios, y un artículo público del 16 de noviembre también marcaba qwen4-max como todavía no disponible. Ambas son instantáneas de esos días; para confirmar si ya está disponible, consulte la tabla general de modelos y la interfaz de precios actuales.
🎯 Recomendación técnica: al construir una aplicación multimodelo, primero puede comparar en APIYI apiyi.com, con el mismo código, el rendimiento de varios modelos ya disponibles en su tarea. Cuando el modelo objetivo esté disponible, basta modificar el parámetro
modelpara hacer el cambio.
5 Cómo calculan los desarrolladores los costos reales de Qwen4-Max-Preview y la API
5.1 Marco de cálculo del coste por tarea de Qwen4-Max
Que el precio unitario del modelo sea bajo no significa que el coste total de completar una tarea también lo sea. Una tarea de agente puede incluir decenas de solicitudes, mucho contexto repetido, salidas de razonamiento largas y reintentos tras fallos. Al comparar alternativas, conviene tomar como unidad “completar un mismo objetivo” y agrupar los costes según el detalle de facturación de cada producto:
| Concepto de coste | Cálculo en la API de pago por uso | Registro en el plan de Credits |
|---|---|---|
| Entrada no cacheada | Cantidad de entrada no cacheada × precio unitario de entrada correspondiente | Registrar directamente los Credits efectivamente descontados en la consola |
| Caché | Costes de lectura, escritura y almacenamiento en caché, calculados según las reglas de la región correspondiente | Ya incluidos en los Credits efectivamente descontados |
| Salida | Cantidad de salida (incluidos los tokens de razonamiento facturados) × precio unitario de salida | Ya incluidos en los Credits efectivamente descontados |
| Herramientas y reintentos | Coste de invocación de herramientas + consumo total de las solicitudes reintentadas | Ya incluidos en los Credits efectivamente descontados |
Expresado como fórmula: coste por tarea = cantidad de entrada no cacheada × precio de entrada + costes de lectura/escritura y almacenamiento en caché + cantidad de salida (incluido el razonamiento facturado) × precio de salida + costes de herramientas/reintentos y similares. El plan de Credits no convierte tokens: registra directamente la diferencia de saldo de Credits entre el inicio y el final de la tarea. Como los dos tipos de resultados usan unidades distintas, al compararlos hay que evaluar por separado “cuántos yuanes cuesta cada tarea” y “cuántos Credits se descuentan por cada tarea”; después, junto con la tarifa mensual del paquete, se puede juzgar la relación coste-beneficio.
5.2 Registrar con código el consumo de tokens de cada solicitud
La verificación del plan de pago por uso depende del campo usage que devuelve cada solicitud. El siguiente ejemplo mínimo muestra cómo leer el consumo en la interfaz compatible con OpenAI. Sustituye el ID del modelo por uno que ya esté publicado en la lista de modelos de la plataforma:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # Toma como referencia un modelo ya publicado en la lista de modelos de la plataforma
    messages=[{"role": "user", "content": "总结这段日志中的错误类型"}],
)
print(resp.usage)  # Registra prompt_tokens / completion_tokens, etc., para la atribución de costos
Ver el código completo para atribuir costos por tarea
import openai
from dataclasses import dataclass, field

@dataclass
class TaskLedger:
    """Atribuye el consumo de tokens por tarea; los precios unitarios los pasa quien llama, según el producto y la región elegidos"""
    input_price_per_m: float          # yuanes por millón de tokens, entrada sin caché
    output_price_per_m: float         # yuanes por millón de tokens, salida (incluye el razonamiento)
    cache_cost: float = 0.0           # costos de lectura, escritura y almacenamiento de caché, se rellenan a mano según el detalle
    tool_cost: float = 0.0            # costos de invocación de herramientas
    records: list = field(default_factory=list)

    def add(self, usage):
        cached = 0
        details = getattr(usage, "prompt_tokens_details", None)
        if details is not None:
            cached = getattr(details, "cached_tokens", 0) or 0
        self.records.append({
            "uncached_input": usage.prompt_tokens - cached,
            "output": usage.completion_tokens,
        })

    def total(self) -> float:
        inp = sum(r["uncached_input"] for r in self.records)
        out = sum(r["output"] for r in self.records)
        return (inp / 1e6 * self.input_price_per_m
                + out / 1e6 * self.output_price_per_m
                + self.cache_cost + self.tool_cost)

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Rellena los precios unitarios según el producto y la región que realmente uses
ledger = TaskLedger(input_price_per_m=0.0, output_price_per_m=0.0)

for attempt in range(3):  # El consumo generado por los reintentos también cuenta en el costo de la tarea
    resp = client.chat.completions.create(
        model="YOUR_MODEL_ID",
        messages=[{"role": "user", "content": "修复 query.py 中的分页错误"}],
    )
    ledger.add(resp.usage)
    if resp.choices[0].finish_reason == "stop":
        break

print(f"本任务请求数: {len(ledger.records)},合计成本: {ledger.total():.4f} 元")
5.3 Cálculo hipotético: una tarea de Agent en la región de Pekín de la versión oficial
El siguiente cálculo es hipotético; las cifras solo sirven para demostrar la fórmula. Supongamos que una tarea invoca Qwen4-Max de la versión oficial en la región de Pekín con pago por uso, con 2.000.000 de Tokens de entrada sin caché acumulados y 50.000 Tokens de salida (incluido el razonamiento), sin usar caché ni herramientas de facturación:
- Entrada: 2 × 10 yuan = 20 yuan
- Salida: 0,05 × 30 yuan = 1,5 yuan
- Total: 21,5 yuan
Este resultado muestra que el coste de las tareas de Agent con contexto largo proviene principalmente de la entrada que se envía una y otra vez. Si las indicaciones de sistema y las descripciones de herramientas fijas se convierten en caché explícita, la estructura de la parte de entrada cambia; cuánto se ahorra depende de la tasa de acierto de la caché y del precio unitario de la caché en la región correspondiente. Para la misma tarea con el plan de Credits, registra directamente el consumo real descontado; no uses estos 21,5 yuan para convertir a Credits.
💰 Verificación de costes: si tu negocio necesita comparar el coste por tarea de varios modelos ya publicados en la misma tarea, puedes leer el usage de cada modelo a través de la interfaz unificada de APIYI apiyi.com y agregarlo con el TaskLedger anterior bajo el mismo criterio.
6 Cómo elegir el plan de invocación durante la etapa Qwen4-Max-Preview
6.1 Programación interactiva: usar Token Plan en la ventana nocturna para tareas largas
Si escribes código principalmente en herramientas como Claude Code, Cursor o Qoder, el Token Plan y la oferta de Preview son la combinación que mejor encaja. Así se hace:
- Programa las tareas interactivas que requieren mucho contexto y razonamiento prolongado entre las 22:00 y las 08:00, y sé tú quien las lanza y les hace seguimiento en la herramienta; por ejemplo, comprensión de bases de código, depuración entre módulos o análisis de documentos largos.
- Reserva presupuesto de salida para el contenido de razonamiento: en Preview, los 393.216 Tokens se comparten entre el razonamiento y la respuesta.
- Anota el saldo de Credits al inicio y al final de cada tarea para ir acumulando tus propios datos de consumo por tarea.
- En la primera compra, compara los precios para nuevos usuarios de los dos niveles: Lite 19,5 yuan y Essential 39,5 yuan; la oferta está vigente hasta el 30 de noviembre.
- Antes del 25 de noviembre, ejecuta tus tareas habituales con
qwen4-maxde la versión oficial para confirmar el límite de salida y la configuración de intensidad de razonamiento.
6.2 Aplicaciones propias y negocios de automatización: elegir la API de pago por uso o una plataforma agregadora
Los servicios backend, las tareas programadas, el procesamiento por lotes y la integración en plataformas de flujo de trabajo entran en el ámbito de las restricciones del Token Plan personal, así que conviene elegir una API de pago por uso que permita invocaciones desde backends comerciales. Si solo usas modelos de la familia Tongyi, puedes conectarte directamente a la API oficial de pago por uso de Qwen4-Max de la versión oficial y aprovechar la caché explícita para controlar el coste de entrada. Cuando la aplicación necesita combinar modelos de varios proveedores, puedes usar una plataforma agregadora de API para unificar la interfaz y la facturación.
💡 Consejo de elección: el canal de acceso debe decidirse según la disponibilidad real del modelo. Cuando el modelo objetivo ya está publicado en APIYI apiyi.com, puedes llamarlo directamente a través de la interfaz unificada; si aún no lo está, primero puedes desarrollar en la plataforma el flujo de interfaz y cálculo de costes con un modelo ya publicado y cambiar el parámetro model una vez que se publique.
6.3 Guía rápida de decisión para Qwen4-Max-Preview
- Desarrollador individual que trabaja principalmente dentro de herramientas de programación: Token Plan más la ventana nocturna de Preview; después del 25 de noviembre, cambia a
qwen4-maxde la versión oficial. - Equipo que desarrolla su propia aplicación: API de pago por uso de la versión oficial, elige el precio unitario según la región y activa la caché explícita.
- Aplicación multimodelo o fase de selección de modelo: plataforma agregadora de API multimodelo, interfaz unificada y costes agregados por tarea.
- Datos confidenciales: revisa primero los términos de uso de datos del producto correspondiente y luego decide cómo conectarte.
7 Resumen: uso correcto de la ventana de Credits al 8 % de Qwen4-Max-Preview
El beneficio nocturno de Credits al 8 % de Qwen4-Max-Preview es una oferta por tiempo limitado dentro de Token Plan, válida hasta las 24:00 del 25 de noviembre y aplicable al uso interactivo en herramientas de programación y herramientas de agentes. La versión oficial de Qwen4-Max se lanzó el 16 de noviembre; en la región de Pekín, el precio de pago por uso es de 10 yuanes por millón de tokens de entrada y 30 yuanes por millón de tokens de salida, adecuado para backends de aplicaciones y operaciones de automatización. Credits y Token pertenecen a dos sistemas de medición distintos; al comparar costos, hay que tomar como referencia la tarea unitaria y registrar por separado las deducciones de Credits y los importes agregados por Token.
Al tomar una decisión, puedes seguir este orden: primero determina si la tarea es una interacción dentro de una herramienta o una llamada desde el backend; luego identifica el producto autorizado correspondiente; y, por último, mide el costo real con la misma tarea. Cuando necesites comparar resultados y costos entre varios modelos ya disponibles, puedes validarlo rápidamente mediante la interfaz unificada de APIYI (apiyi.com).
📚 Referencias
-
Documentación oficial de Qwen4-Max-Preview: especificaciones del modelo, fecha de disponibilidad y métodos de acceso
- Enlace:
help.aliyun.com/zh/model-studio/qwen4-max-preview - Descripción: presupuesto de salida, parámetros de razonamiento y Base URL dedicada
- Enlace:
-
Documentación oficial de la versión estable de Qwen4-Max: precios de pago por uso y caché explícita
- Enlace:
help.aliyun.com/zh/model-studio/qwen4-max - Descripción: precio unitario por región, límite de salida y TTL de caché
- Enlace:
-
Suscripción y beneficios del plan personal de Token Plan: precios de los paquetes, Credits y ofertas por tiempo limitado
- Enlace:
help.aliyun.com/zh/model-studio/token-plan-personal-overview - Descripción: reglas de precio al 20 % y al 40 % en horario nocturno, precios para nuevos usuarios y paquetes de uso
- Enlace:
-
Permisos y normas de uso de Token Plan: escenarios de uso permitidos y prohibidos
- Enlace:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Descripción: alcance del uso interactivo y consecuencias de infracciones
- Enlace:
-
Uso y cuota de Token Plan: mecanismo de consumo de Credits
- Enlace:
help.aliyun.com/zh/model-studio/token-plan-usage-quota - Descripción: factores que afectan el consumo de Credits
- Enlace:
-
Actualizaciones de funciones de Token Plan: registro de lanzamiento de Preview y de la versión oficial
- Enlace:
help.aliyun.com/zh/model-studio/token-plan-product-updates - Descripción: eventos de versión del 11 y el 16 de noviembre
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: Visítanos en la página principal de APIYI (apiyi.com) para contactarnos; encontrarás más materiales de integración en el centro de documentación docs.apiyi.com.