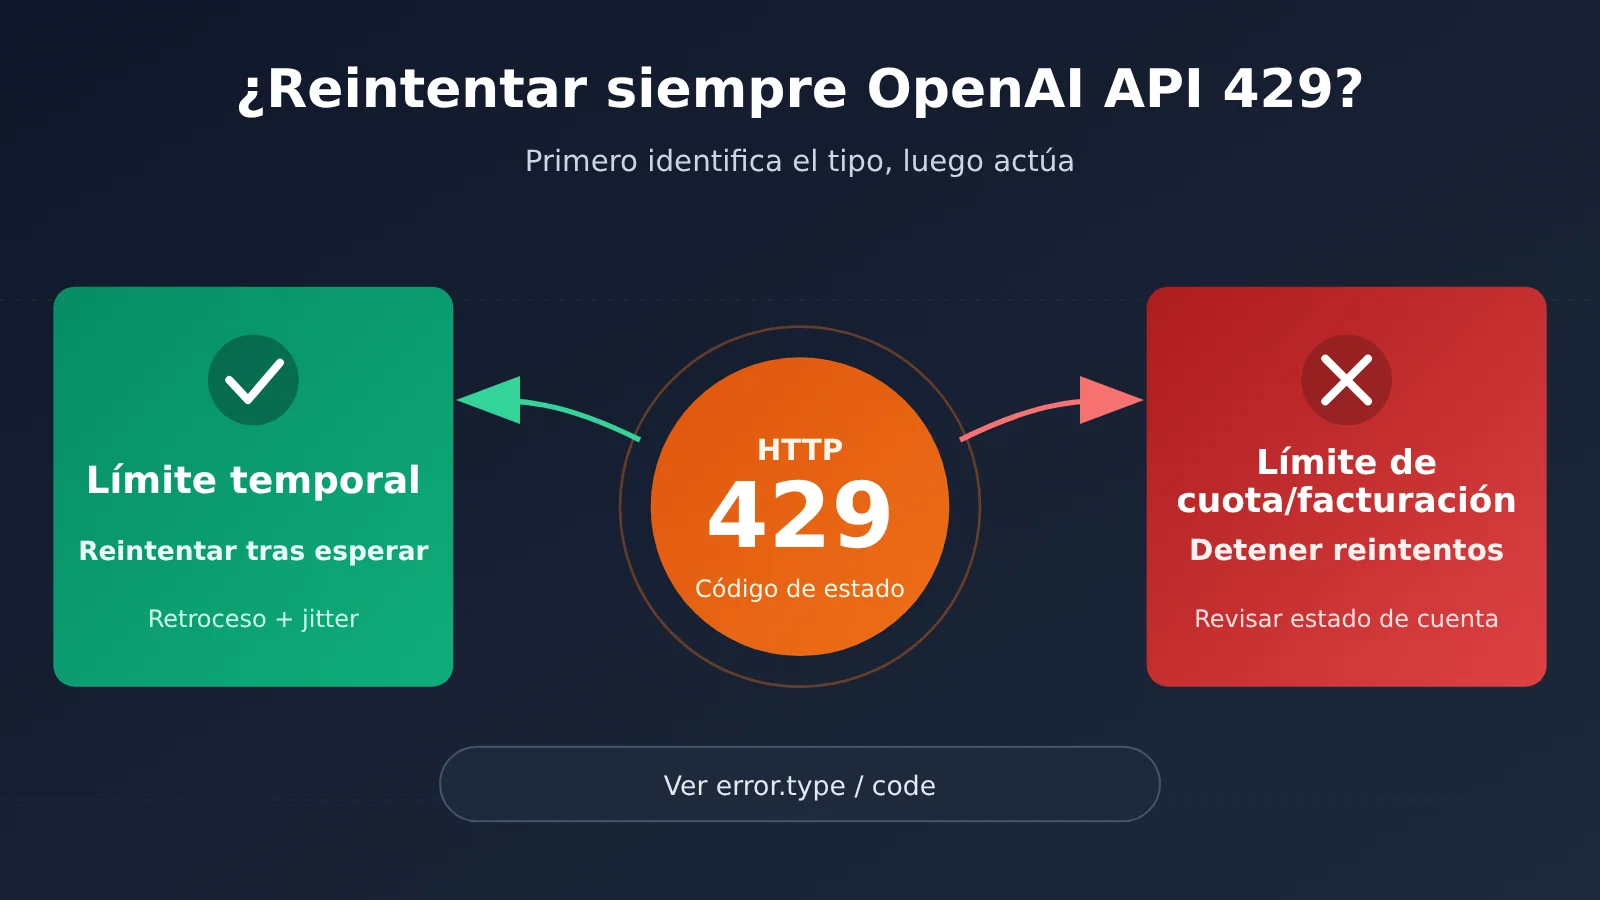
No conviene reintentar indefinidamente. Que la API de OpenAI devuelva un 429 no significa que baste esperar un poco y volver a intentarlo. Solo tiene sentido esperar y reintentar cuando se trata de un límite de velocidad temporal. Una cuota agotada, una anomalía de facturación o un límite de uso a nivel de organización no se recuperan por muchos reintentos que hagas; además, lo único que consigues es atascar la cola.
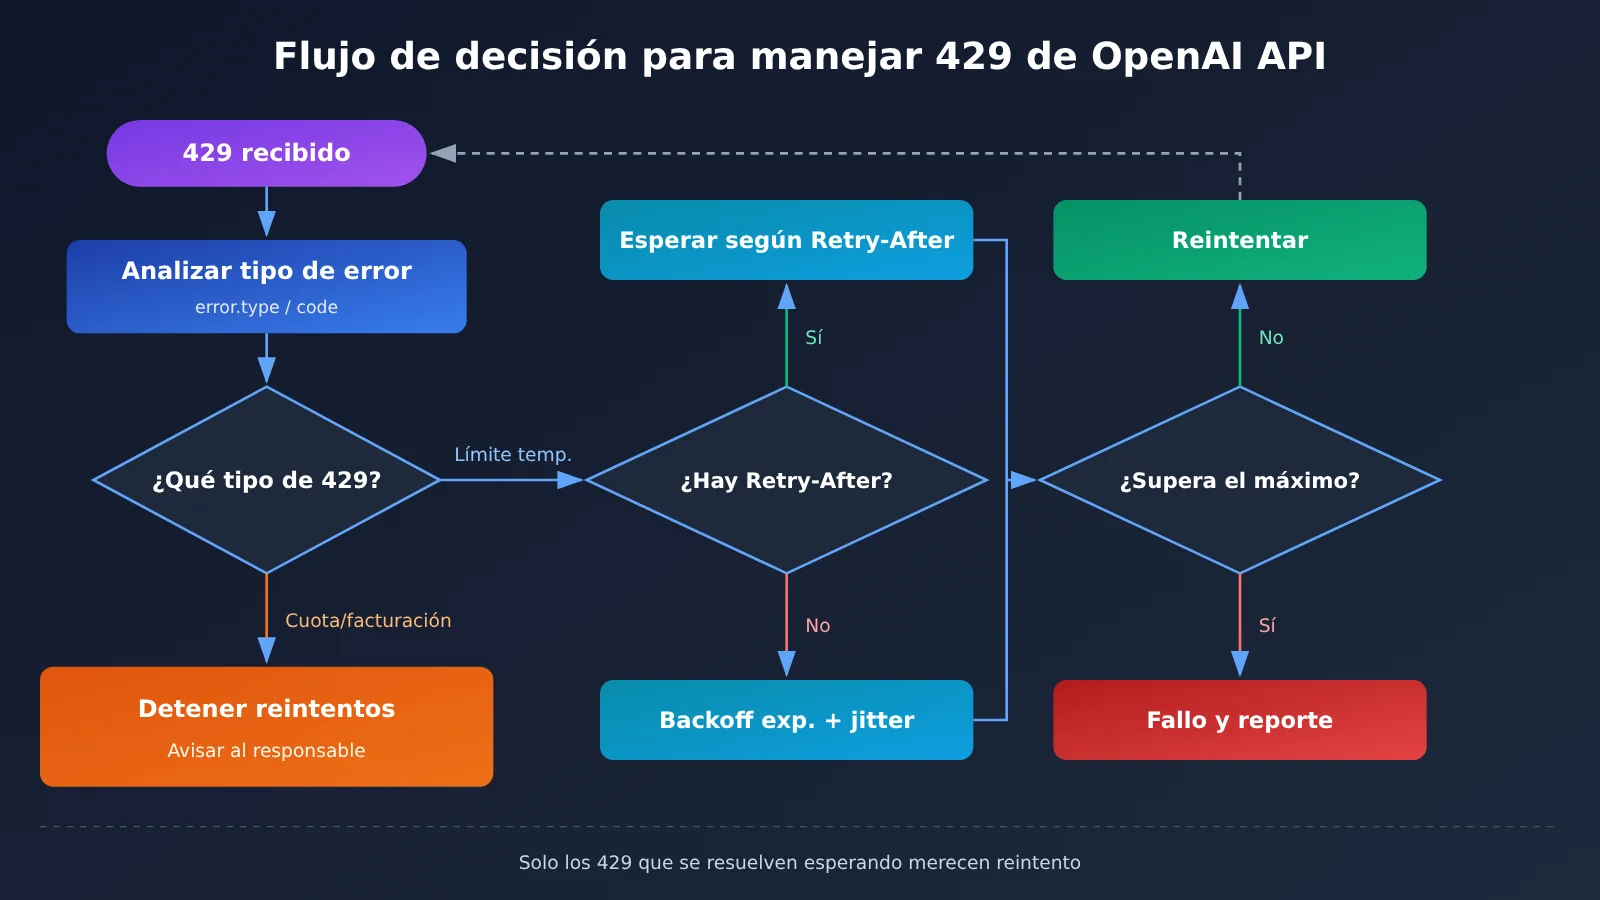
Lo correcto es revisar primero el mensaje de error, error.type y, si existe, error.code, para determinar a qué clase de 429 pertenece. Si es un límite de velocidad temporal y hay un Retry-After válido, espera lo que indique; si no, usa retroceso exponencial con jitter aleatorio y establece un máximo de intentos.
¿Qué puedes aprender al leer este artículo?
- En qué clases, como mínimo, se dividen los 429 de la API de OpenAI y cómo conviene tratar cada una.
- Cómo se relacionan
Retry-After, el retroceso exponencial y el jitter aleatorio, y cuándo usar cada uno. - Por qué los reintentos automáticos del SDK oficial, la cola de tareas y un botón manual de «reintentar» terminan amplificando los 429 cuando se combinan.
- Distintas soluciones para cuellos de botella por número de solicitudes y por tokens, y qué tener en cuenta cuando una solicitud en streaming falla a mitad de camino.
Índice: antes del texto principal, una tabla de conceptos y un resumen rápido de impacto te ayudarán a unificar terminología y a encontrar la sección que te interesa. La sección «Hechos objetivos» reúne lo que la documentación oficial de OpenAI dice sobre los 429: clasificación de errores, reglas de reintento y comportamiento del SDK. La sección «Análisis y criterios» aborda la implementación práctica: ajustar la estrategia según el tipo de cuello de botella, diseñar el estado de la cola, diagnosticar la superposición de reintentos y las diferencias semánticas que hay que tener en cuenta al migrar a otro gateway.
Para saber: conceptos necesarios para entender un 429 de OpenAI API
| Concepto | Explicación breve |
|---|---|
| HTTP 429 | El código de estado «Too Many Requests». La API de OpenAI lo usa tanto para señalar límites de velocidad como para límites de cuota o de uso |
| Límite de velocidad (Rate Limit) | El máximo de solicitudes que puedes lanzar en un periodo de tiempo. OpenAI cuenta por separado el número de solicitudes y el volumen de tokens |
| RPM / TPM | Solicitudes por minuto y tokens por minuto. Si cualquiera de los dos toca su techo, puede dispararse un 429 |
error.type / error.code |
Campos estructurados dentro del cuerpo de la respuesta de error. Sirven para distinguir la causa concreta del 429 y son más fiables que mirar solo el código de estado |
| Retry-After | Campo de cabecera de la respuesta que indica cuánto tiempo recomienda el servidor esperar antes de volver a intentarlo. Cuando su valor es válido, conviene respetarlo |
| Retroceso exponencial (Exponential Backoff) | Tras cada fallo, el tiempo de espera se multiplica, por ejemplo 1 segundo, 2 segundos, 4 segundos, con un tope máximo |
| Jitter (aleatoriedad) | Añadir una cantidad aleatoria al tiempo de espera para evitar que muchos clientes reintenten todos en el mismo instante |
| Salida en streaming | El modelo devuelve el contenido a medida que lo genera. Una vez que la salida ha empezado, si algo falla a mitad de camino ya no se puede simplemente reproducir todo de nuevo |
| Reintentos acumulados | El SDK, la cola de tu aplicación y las acciones manuales del usuario reintentan cada uno por su lado, y el volumen real de solicitudes acaba multiplicándose |
Impacto de un vistazo: qué significa un 429 de OpenAI API para cada rol
| Rol | Impacto principal | Puntos a vigilar |
|---|---|---|
| Desarrolladores backend | Una lógica de reintento mal escrita puede convertir una limitación temporal de velocidad en un fallo persistente | Distinguir los tipos de 429 y centralizar los reintentos en una sola capa |
| Responsables de tareas batch y de datos | Las tareas masivas pueden chocar a la vez con los dos límites: número de solicitudes y tokens | Ritmo de envío, volumen de contexto y diseño del estado de la cola |
| Producto y frontend | Si el usuario pulsa “Reintentar” una y otra vez, se seguirán generando nuevos 429 | Indicar al usuario cuándo volver a intentarlo o aclarar que el motivo está en la cuenta |
| Operaciones y administradores de cuentas | Los 429 por cuota o facturación no se resuelven solos con código | Detectar y resolver a tiempo el estado de la cuenta, en lugar de dejar que los reintentos automáticos actúen sin control |
Hechos objetivos: cómo describe OpenAI el 429 en su documentación oficial
Esta sección se basa en la guía de códigos de error, la guía de límites de velocidad y el artículo del Centro de Ayuda sobre cómo diagnosticar un 429, todos mantenidos públicamente por OpenAI. Fecha de verificación: 2026-11-17. Se trata de documentación viva que se actualiza continuamente; este artículo no puede verificar cuándo se publicó originalmente el contenido, así que no lo presentamos como una noticia del día, sino como una descripción de las reglas vigentes.
Los diferentes orígenes del error 429 de la API de OpenAI
La postura central de la documentación oficial es: aunque ambos sean 429, el significado puede ser distinto; hay que determinarlo combinando el mensaje de error, error.type y el error.code disponible. Los límites temporales de velocidad y las restricciones de cuota, facturación o uso a nivel de organización se gestionan de forma diferente.
El primero es «en la ventana actual las solicitudes fueron demasiado rápidas o demasiadas»; tras un tiempo, cuando la ventana se renueva, se recupera. El segundo tiene que ver con el estado de la propia cuenta, por ejemplo cuota agotada, problemas de pago, límites de uso a nivel de organización. Este tipo de problemas no desaparece por sí solo con el paso del tiempo.
| Tipo de 429 | Señales típicas | ¿Se resuelve esperando? | Acción recomendada |
|---|---|---|---|
| Límite de velocidad por número de solicitudes | El mensaje de error apunta al límite de número de solicitudes; code habitual rate_limit_exceeded |
Normalmente sí | Respetar Retry-After, o usar retroceso exponencial con jitter |
| Límite de velocidad por cantidad de tokens | El mensaje de error apunta al límite de tokens | Normalmente sí, pero es fácil que se dispare repetidamente | Aplicar retroceso y a la vez reducir la cantidad de tokens por solicitud |
| Restricciones de cuota/facturación/organización | El mensaje de error apunta a la cuota o a la facturación; code habitual insufficient_quota |
No | Detener los reintentos automáticos y notificar al responsable para que gestione la cuenta |
Cabe destacar que el valor concreto de error.code debe basarse en el contenido realmente devuelto y en la documentación oficial. Los code de la tabla anterior son solo ejemplos comunes; en el código, no conviene basar las decisiones únicamente en cadenas codificadas de forma fija, y también hay que conservar el mensaje de error original para la depuración mediante registros.
El recuento de solicitudes y el volumen de tokens pueden estar limitados de forma independiente
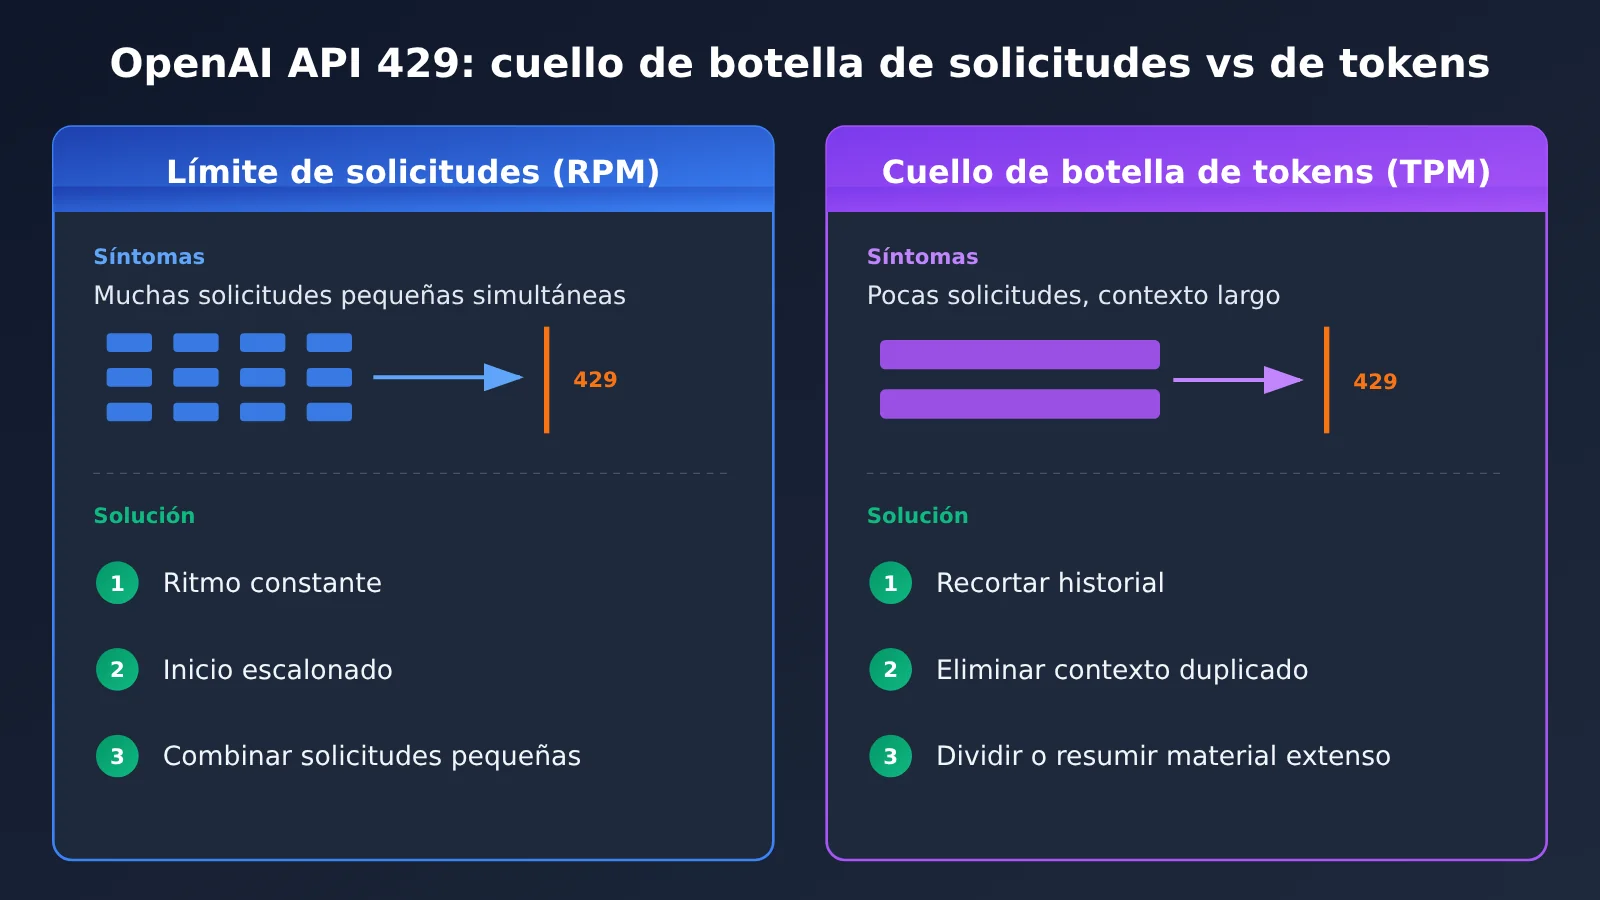
La guía de límites de velocidad explica que los límites se miden desde varias dimensiones, y las más habituales son el número de solicitudes y el volumen de tokens, que se aplican de forma independiente. Es decir, aunque el número de solicitudes esté todavía muy lejos del máximo, también puedes chocar primero con el límite de tokens porque cada solicitud arrastra un contexto muy largo. Y al revés: muchas solicitudes muy pequeñas también pueden agotar antes el recuento de solicitudes.
OpenAI ofrece en las cabeceras de respuesta información relacionada con los límites de velocidad, como el número de solicitudes restantes, el número de tokens restantes y el tiempo de restablecimiento de cada uno. Estos campos de cabecera te ayudan a saber, antes de que salte realmente el 429, a qué límite estás más cerca.
La forma de reintentar el 429 de la API de OpenAI recomendada oficialmente
Para las limitaciones temporales de velocidad que merece la pena reintentar, la recomendación oficial se puede resumir en dos puntos:
- Si existe un Retry-After válido, respétalo. Es la señal más directa que ofrece el servidor, más precisa que cualquier conjetura del cliente.
- Si no hay Retry-After, usa retroceso exponencial con jitter aleatorio. El tiempo de espera crece con cada fallo y luego se le suma una cantidad aleatoria, para evitar que todos los clientes reintenten a la vez.
La premisa de estas dos reglas es que «este 429 sea del tipo que se resuelve esperando». Si es un problema de cuota o facturación, hasta el algoritmo de retroceso más preciso no hace más que girar en el vacío.
Comportamiento de reintento automático del SDK oficial
El SDK oficial de OpenAI reintenta automáticamente los errores de límite de frecuencia que cumplan los criterios; el comportamiento concreto depende de la configuración del cliente. En el SDK de Python, por ejemplo, puedes ajustarlo con el parámetro max_retries, o ponerlo en 0 para desactivar los reintentos automáticos.
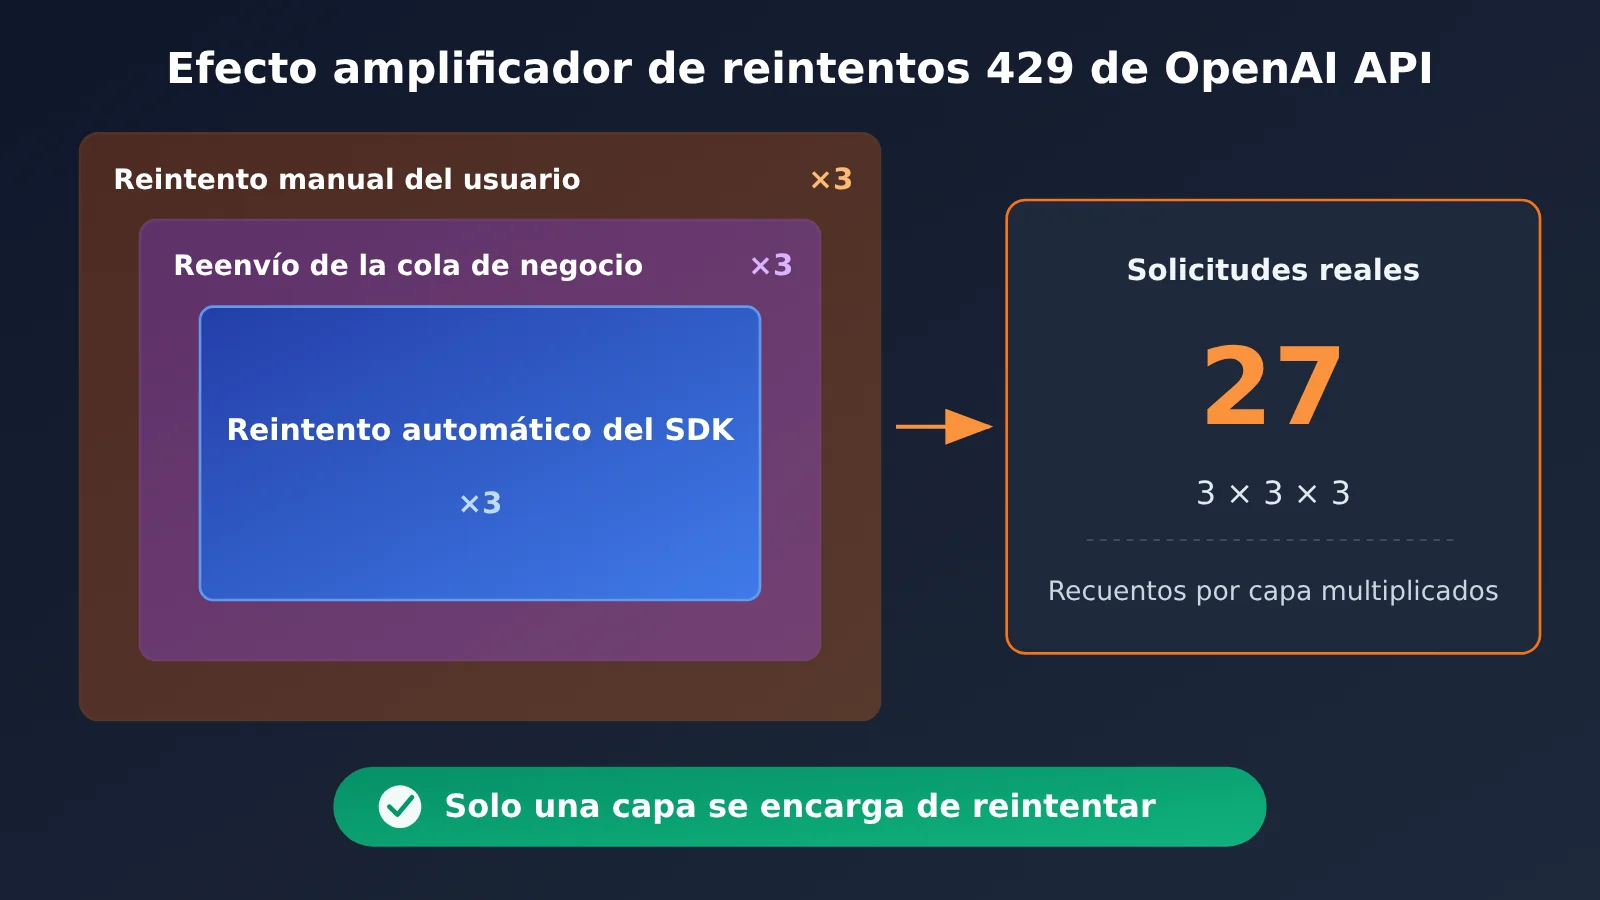
Esto significa que, aunque tu código de negocio no incluya ni una sola línea de lógica de reintento, puede que la solicitud ya se haya reintentado varias veces. Si la capa de negocio añade además su propia capa de reintentos, el número real de solicitudes será el producto de ambas.
Los errores a mitad de una solicitud en streaming no siempre se pueden resolver repitiendo la solicitud completa
La documentación oficial también menciona un caso límite que se pasa por alto con facilidad: una vez que la salida en streaming ha empezado, los errores que ocurran después no siempre se pueden resolver repitiendo toda la solicitud. Puede que el usuario ya haya visto parte del contenido, y que los sistemas posteriores ya hayan consumido parte de los datos. Repetir la solicitud tal cual provocaría contenido duplicado, incoherencias entre lo mostrado antes y después, y además volvería a consumir tokens.
Análisis y decisión: cómo llevar un 429 de OpenAI API a la práctica de ingeniería
Lo que sigue es una opinión de ingeniería basada en los hechos anteriores, no son palabras oficiales de OpenAI.
Un ejemplo de backoff para el 429 de OpenAI API que puedes adaptar directamente
El ejemplo siguiente refleja varios principios: desactivar el reintento automático del SDK y delegar esa responsabilidad a la capa de negocio; lanzar directamente los errores relacionados con la cuota; respetar primero el Retry-After; cuando no exista, usar backoff exponencial con jitter completo; y limitar el número máximo de intentos.
import random
import time
from openai import OpenAI, RateLimitError

# Desactiva el reintento automático del SDK para que no se superponga con el reintento personalizado de abajo
client = OpenAI(max_retries=0)

# Tipos de 429 que el reintento no puede resolver (según la respuesta real y la documentación oficial)
NON_RETRYABLE_CODES = {"insufficient_quota"}


def parse_retry_after(response):
    """Analiza los segundos de Retry-After; si no son válidos, devuelve None. El formato de fecha HTTP se puede analizar adicionalmente si hace falta."""
    if response is None:
        return None
    value = response.headers.get("retry-after")
    try:
        seconds = float(value)
        return seconds if seconds >= 0 else None
    except (TypeError, ValueError):
        return None


def call_with_backoff(messages, model, max_attempts=5, base=1.0, cap=60.0):
    for attempt in range(max_attempts):
        try:
            return client.chat.completions.create(model=model, messages=messages)
        except RateLimitError as e:
            if e.code in NON_RETRYABLE_CODES:
                raise  # Problemas de cuota/facturación: los gestiona el proceso de la cuenta
            if attempt == max_attempts - 1:
                raise  # Se superó el límite: lo gestiona la cola o la alerta
            wait = parse_retry_after(e.response)
            if wait is None:
                # Jitter completo: valor aleatorio dentro de [0, límite exponencial]
                wait = random.uniform(0, min(cap, base * 2 ** attempt))
            time.sleep(wait)
Los valores max_attempts, base y cap del ejemplo son solo puntos de partida, no valores recomendados. El nivel de límite de cada cuenta es diferente y la forma de la tarea también varía, así que no existe un número de concurrencia ni de reintentos uniforme que sirva para todas las cuentas; hay que ajustarlo según los propios datos de monitoreo.
Ajuste según el tipo de cuello de botella: las soluciones para el cuello de botella de número de solicitudes y el de tokens son distintas
El retroceso (backoff) solo resuelve «cómo esperar esta vez», pero no «por qué siempre chocamos contra el límite». Para reducir los 429, primero hay que saber contra qué línea estamos chocando.
La clave del cuello de botella de número de solicitudes es espaciar el ritmo de envío. En la entrada de la cola conviene liberar a velocidad constante, por ejemplo con un token bucket o con intervalos fijos de liberación, para que una gran cantidad de tareas no salga de golpe en el mismo segundo. Al iniciar tareas por lotes también hay que escalonar el arranque, sin dispararlas todas en punto.
La clave del cuello de botella de tokens es reducir el volume de cada solicitud. Los desperdicios más comunes incluyen: arrastrar en cada turno de conversación un system prompt muy largo y todo el historial; reenviar el mismo documento grande en varias solicitudes; y meter todo el material en el modelo cuando en realidad solo se necesita un fragmento. Recortar, resumir o hacer recuperación antes de enviar suele ser mucho más eficaz que aumentar el número de reintentos.
Distinguir en el estado de la cola entre «espera de reintento» y «bloqueo de cuenta»
Muchos sistemas solo manejan dos estados: «en cola» y «fallido». Cuando aparece un 429, esto provoca dos tipos de diagnósticos erróneos: una limitación temporal de velocidad se trata como fallo y la tarea se descarta, mientras que un problema de cuota se trata como «en cola» y se espera indefinidamente.
Un enfoque más razonable consiste en separar los dos tipos de 429 en dos estados distintos, cada uno con su propia visualización:
| Estado de la cola | Condición de activación | Información que debe mostrarse | Procesamiento posterior |
|---|---|---|---|
| Espera de reintento | Limitación temporal de velocidad | Hora estimada del próximo intento, número de intentos realizados | Reintentar automáticamente al llegar la hora; al alcanzar el límite, pasar a fallido |
| Bloqueo de cuenta | Cuota, facturación, límites de uso de la organización | Motivo del bloqueo (por ejemplo, cuota insuficiente) | Pausar las tareas posteriores de la misma cuenta y notificar al responsable |
| Fallido | Superación del límite de reintentos u otro error irrecuperable | Tipo de error e información original | Intervención manual o degradación del servicio |
«Bloqueo de cuenta» tiene además un efecto colateral. Es muy probable que otras tareas de la misma cuenta también se topen con el mismo 429, así que lo sensato es pausarlas todas en conjunto, en lugar de dejar que cada tarea choque por su cuenta.
Detectar reintentos superpuestos: SDK, cola y botón manual
Si notas que cuantos más reintentos haces con un 429, más 429 aparecen, lo primero que debes revisar es si hay varias capas de reintento activas a la vez. La cadena típica es: el SDK reintenta unas cuantas veces por su cuenta, la cola de negocio vuelve a encolar la tarea tras el fallo otras tantas veces, y el usuario final, al ver el error en la interfaz, pulsa «reintentar» manualmente. Al multiplicar las tres capas, una petición original puede convertirse en más de una docena de peticiones reales, y además estas suelen concentrarse justo dentro de la ventana de limitación de velocidad, agravando aún más el problema.
A la hora de investigar, conviene confirmar capa por capa:
- Capa del SDK: verifica el valor real de
max_retries; no te fíes de lo que crees recordar como valor por defecto. - Capa de la cola: confirma si las tareas se vuelven a encolar automáticamente tras un fallo y si ese reencolado aplica algún retroceso (backoff).
- Capa de interacción: comprueba si el botón «reintentar» está deshabilitado durante la espera y si muestra la hora del próximo intento.
- Capa de registros: asigna un ID único a cada tarea original y cuenta cuántas peticiones se han enviado realmente para ella.
El principio es bien sencillo: en una misma cadena, deja que solo una capa se encargue de reintentar; las demás capas solo se ocupen de transmitir el estado.
En escenarios de streaming, conviene diseñar por separado la estrategia de recuperación de 429 de la API de OpenAI
Cuando una solicitud de streaming se topa con un 429 al establecer la conexión y antes de haber devuelto ningún contenido, puede tratarse igual que una solicitud normal. Pero una vez que ya ha empezado a emitir, la decisión de «volver a reproducir o no» debería quedar en manos del negocio. Por ejemplo, avisar claramente al usuario de que la generación se interrumpió y dejar que sea él quien decida regenerar; o descartar lo ya emitido y reemplazarlo por completo. No conviene relanzar en silencio en segundo plano, porque acabarías con dos片段 de contenido duplicado en la interfaz.
Al migrar a otras plataformas, no copies tal cual la semántica de 429 de OpenAI
La clasificación de errores, los valores de error.code, el comportamiento de Retry-After y las cabeceras de respuesta descritos en este artículo corresponden a la semántica de la API oficial de OpenAI. Si llamas al modelo a través de una pasarela de terceros, un servicio proxy o una plataforma agregadora (por ejemplo, APIYI), los códigos de error, las dimensiones de limitación de tasa y las recomendaciones de reintento del proveedor deben regirse por la documentación de esa plataforma: hay que verificarlos por separado y no vale trasladar directamente el comportamiento de OpenAI. Lo más sensato es aplicar una capa de normalización de errores en la capa de integración, de modo que los 429 de distintos orígenes se mapeen a los tres estados que menciona este artículo —»esperar y reintentar / bloqueo de cuenta / fallo»— y luego se entreguen al módulo de reintentos unificado.
Cambios que vale la pena seguir de cerca
La documentación de códigos de error y la de límites de velocidad de OpenAI se mantienen en revisión constante. Los niveles de cuota, las dimensiones de medición y los campos de las cabeceras de respuesta pueden cambiar en cualquier momento. Conviene conservar en el código los registros con el texto literal del error y revisar de forma periódica la lógica de decisión contra la documentación oficial. Además, no escribas «todos los 429 se resuelven esperando» en ninguna configuración predeterminada. Si esa suposición se aplica cuando la cuota ya está agotada, el precio a pagar es una cola de tareas girando en vacío durante toda la noche.
En esencia, un 429 es el servidor diciendo «ve más despacio»; a veces también está diciendo «este camino, por ahora, no lleva a ninguna parte». Distinguir cuál de las dos cosas ocurre y luego decidir si conviene esperar, cambiar de enfoque o detenerse importa más que cualquier algoritmo de reintentos, por ingenioso que sea. Como dice el Lunyu (Analectas), en el pasaje «Zi Lu»:
«No busques la rapidez, no te fijes en las pequeñas ganancias. Quien busca la rapidez no llega; quien se fija en las pequeñas ganancias no culmina grandes empresas.»