Anmerkung des Autors: Dieser Artikel zerlegt einen zeitgesteuerten Agent für Monitoring und Zusammenfassungen in vier Bausteine. Er erklärt, wie sich die Modellaufruf-Schicht über eine OpenAI-kompatible Schnittstelle von einem bestimmten SDK entkoppeln lässt, und liefert ein ausführbares Python-Beispiel.
OpenRouter hat kürzlich ein Tutorial veröffentlicht, das mit @openrouter/agent 0.11.0 einen dauerhaft laufenden, zeitgesteuerten KI-Agent in TypeScript aufbaut. Er überwacht automatisch Hacker News und erstellt Zusammenfassungen. Dieses Szenario ist typisch: Viele Teams wünschen sich etwas Ähnliches, um jeden Morgen Branchennachrichten, Aktivitäten der Konkurrenz oder populäre Beiträge aus Tech-Communitys zusammenzufassen. Wir nehmen das Tutorial zum Anlass, eine allgemeine Architektur für einen Monitoring- und Zusammenfassungs-Agent zu entwerfen, die nicht an ein bestimmtes SDK gebunden ist.
Dies ist keine Nacherzählung des Tutorials. Vom Originaltutorial sind nur zusammenfassende Informationen öffentlich verfügbar; über die konkrete Implementierung spekulieren wir nicht. Stattdessen geht es um allgemeinere Fragen: Aus welchen Teilen besteht ein solcher Agent, und wie lässt sich die Modellaufruf-Schicht so gestalten, dass Modelle und Anbieter jederzeit gewechselt werden können?
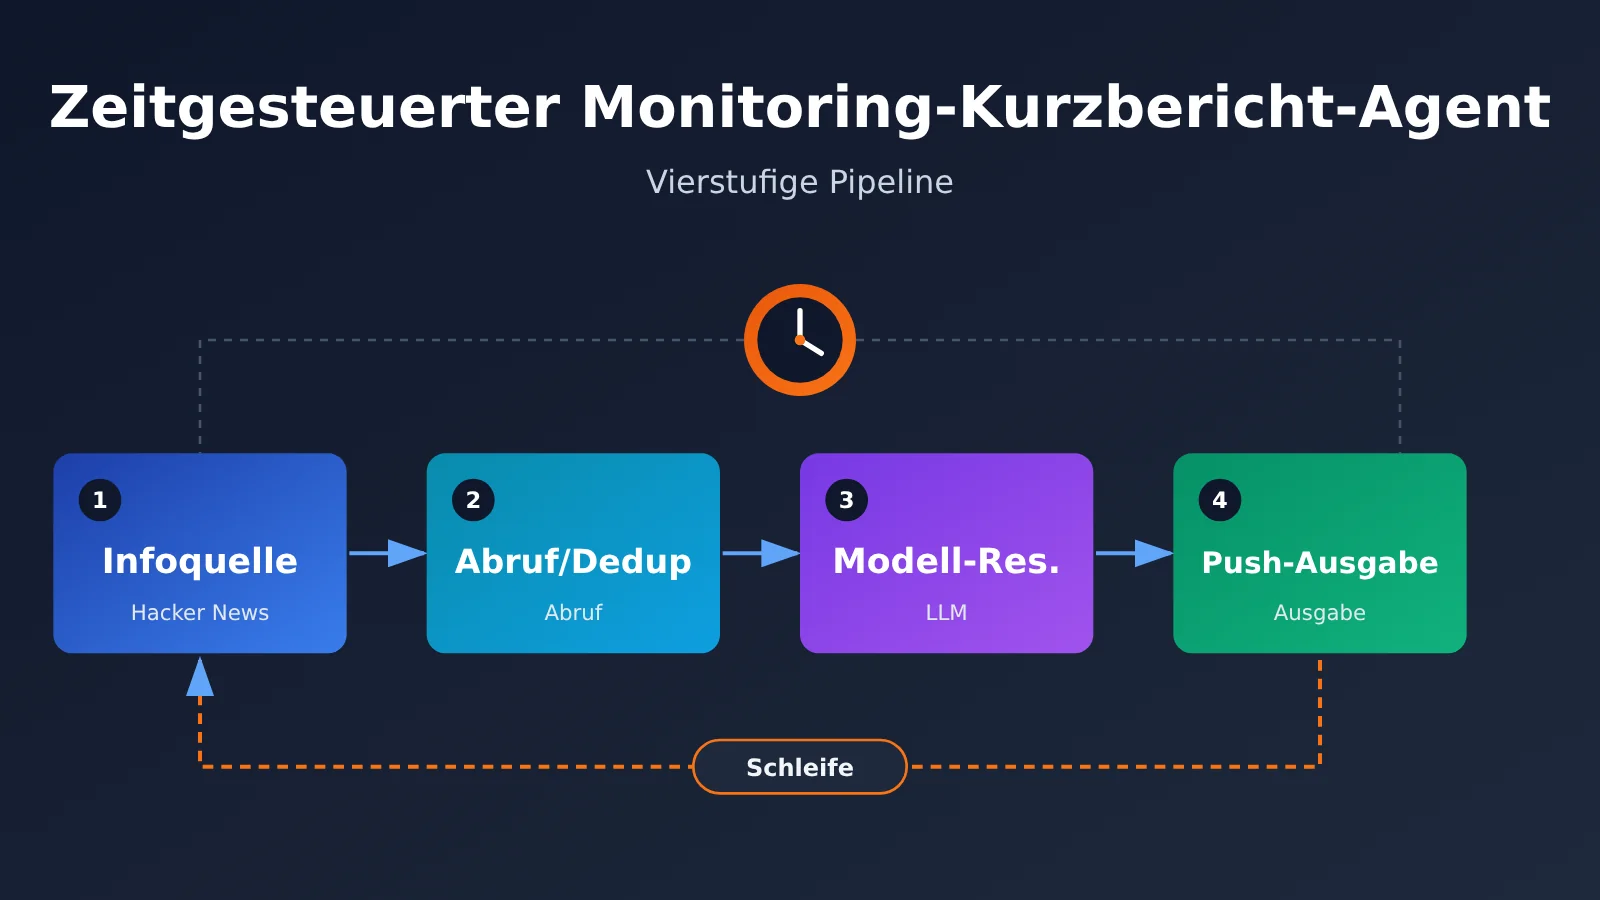
Das nehmen Sie mit: Sie lernen eine Struktur aus vier Schritten kennen – zeitgesteuerter Start, Datenbeschaffung, Zusammenfassung durch das Modell und Ergebnisausgabe – und erhalten eine Python-Implementierung auf Basis einer OpenAI-kompatiblen Schnittstelle, die Sie direkt anpassen können.
Die wichtigsten Punkte zum Monitoring-Zusammenfassungs-Agenten
Die Tabelle fasst die wichtigsten Erkenntnisse zusammen. Die folgenden Abschnitte gehen auf die einzelnen Punkte ein.
| Punkt | Beschreibung | Nutzen |
|---|---|---|
| Vierstufiger Aufbau | Zeitgesteuerter Start → Datenabruf → Zusammenfassung durch das Modell → Ausgabe | Jede Stufe lässt sich unabhängig austauschen und testen |
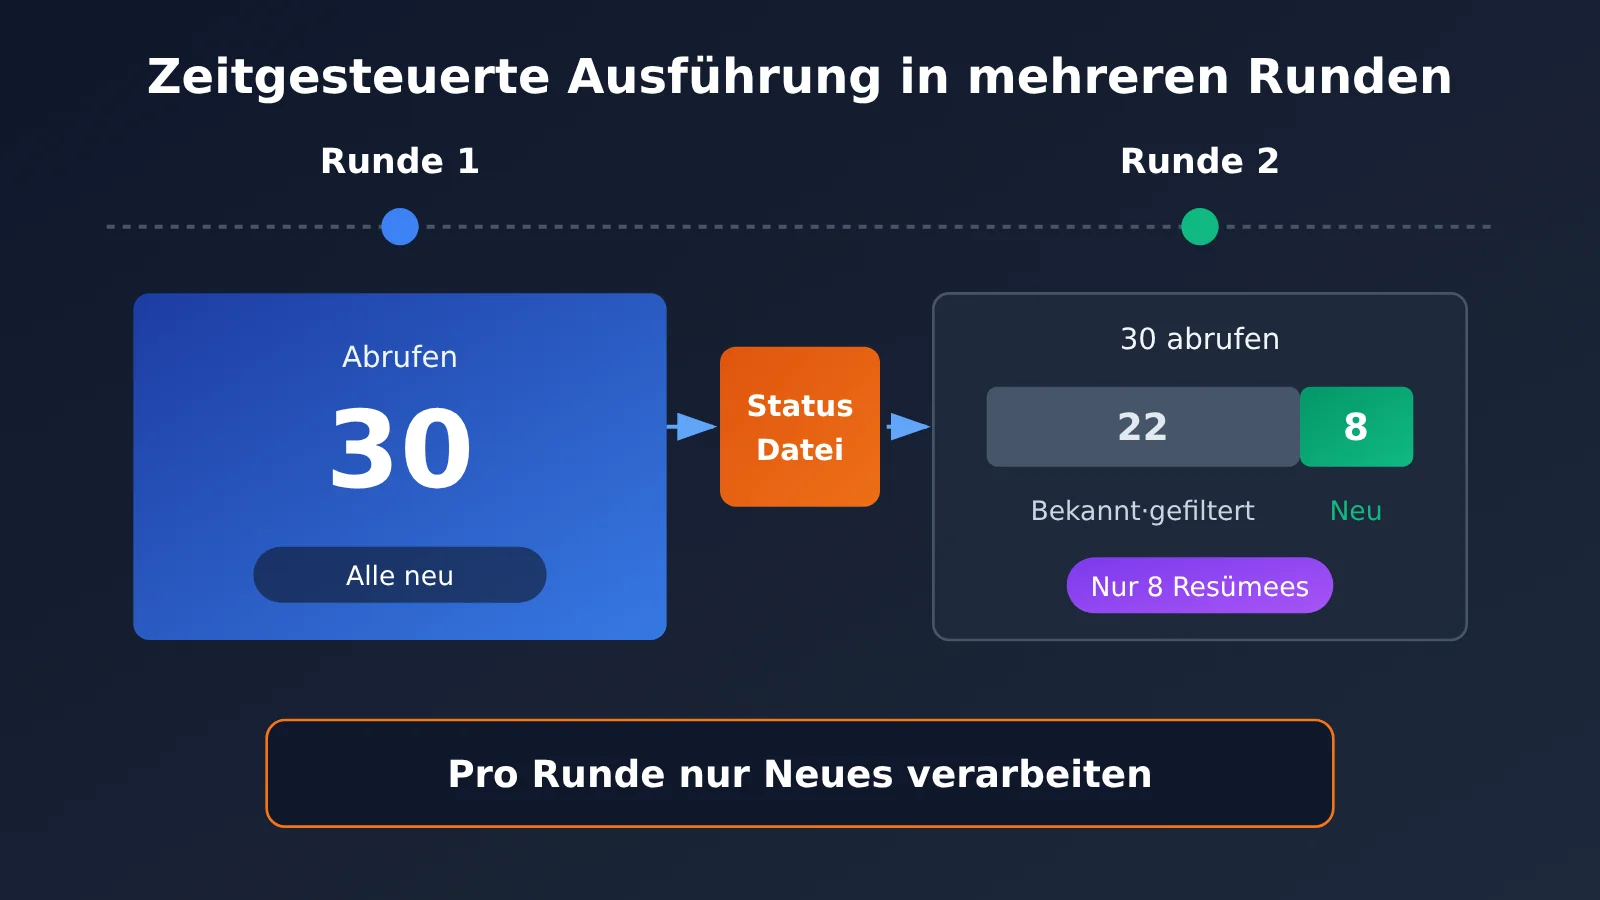
| Zustandsverwaltung | Bereits verarbeitete Einträge erfassen, um doppelte Zusammenfassungen zu vermeiden | Spart Modellaufrufe und sorgt für übersichtlichere Ergebnisse |
| Entkoppelte Modellaufrufschicht | Der Anwendungscode nutzt nur eine Schnittstelle für Zusammenfassungen und ist nicht direkt von einem bestimmten SDK abhängig | Modell oder Anbieter lassen sich durch eine Konfigurationsänderung wechseln |
| OpenAI-kompatibles Protokoll | Das einheitliche Chat-Completions-Format bildet die Grundlage für Modellaufrufe | Ausgereiftes Ökosystem, das Modelle verschiedener Anbieter unterstützt |
| Modell passend zur Aufgabe wählen | Für Zusammenfassungen zählen Kontextlänge, Befolgung von Anweisungen, Stabilität und Kosten | Verhindert, dass einfache Aufgaben unnötig teuer werden |
Die vier Bestandteile eines Monitoring-Zusammenfassungs-Agenten
Ein „dauerhaft laufender Agent“ ist im Kern eine Pipeline, die regelmäßig von einem Timer gestartet wird. Er braucht keine komplexen mehrstufigen Schlussfolgerungen, muss aber besonders zuverlässig sein – schließlich überwacht niemand ständig seine Ausführung. Eine Aufteilung in vier Komponenten mit klaren Aufgaben ist die Grundlage für einen langfristig stabilen Betrieb.
| Komponente | Aufgabe | Übliche Umsetzung | Wichtige Designpunkte |
|---|---|---|---|
| Zeitgesteuerter Auslöser | Startet die Aufgabe in festen Abständen | cron, systemd timer, Timer für Cloud-Funktionen, zeitgesteuerte CI-Workflows, Scheduling-Bibliotheken im Prozess | Auslösung und Geschäftslogik trennen; fehlgeschlagene Läufe wiederholbar machen |
| Datenabruf | Ruft neue Inhalte aus Informationsquellen ab | Öffentliche APIs, RSS, Web-Scraping | Timeouts setzen, die Anzahl der Einträge begrenzen und bereits gesehene IDs erfassen |
| Zusammenfassungsmodul | Ruft ein großes Sprachmodell auf, um Zusammenfassungen zu erstellen | Chat-Completions-Schnittstelle | Eingaben kürzen, eine feste Eingabeaufforderung verwenden und das Ausgabeformat vorgeben |
| Ausgabemodul | Stellt die Ergebnisse dort bereit, wo Menschen sie sehen können | E-Mail, Webhooks für Messenger-Bots, Markdown-Dateien, Datenbanken | Bei fehlgeschlagener Zustellung eine Alternative vorsehen, etwa das Speichern auf der Festplatte |
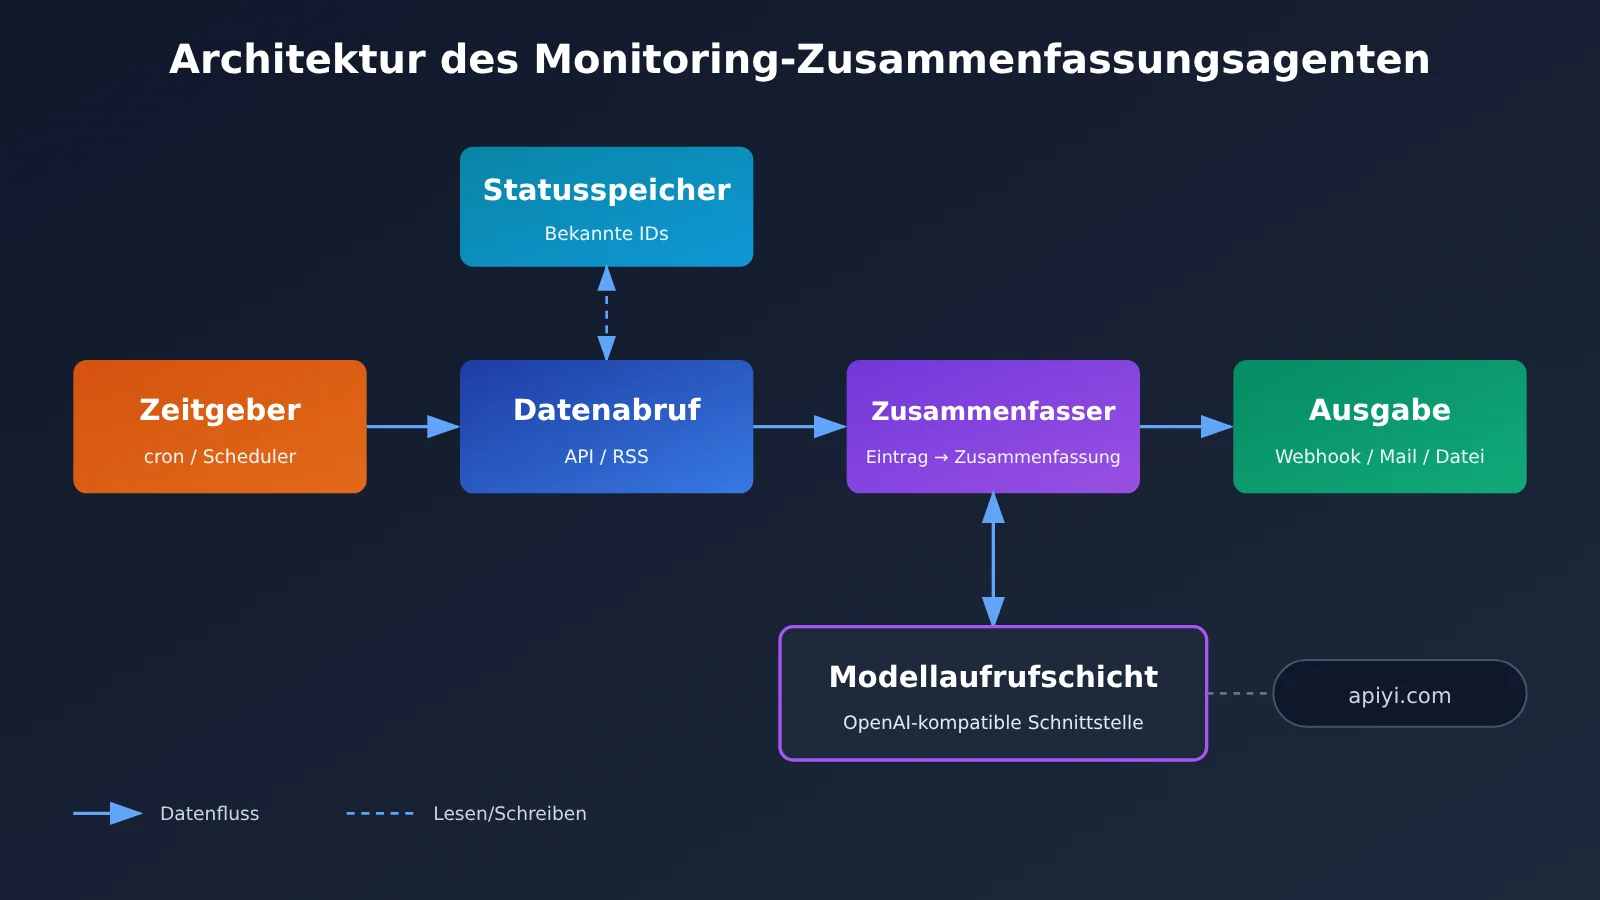
Die vier Teile tauschen nur einfache Datenstrukturen aus: Der Datenabruf liefert eine „Liste von Einträgen“, das Zusammenfassungsmodul einen „Zusammenfassungstext“, den das Ausgabemodul verarbeitet. So lassen sich Probleme in jeder Stufe einzeln eingrenzen. Ist etwa die Qualität der Zusammenfassung schlecht, muss nur das Zusammenfassungsmodul angepasst werden. Schlägt die Zustellung fehl, prüft man das Ausgabemodul.
In einer ersten Version steckt oft die gesamte Logik in einem einzigen Skript. Das funktioniert, ist aber schwer zu warten. Wer später Hacker News durch GitHub Trending ersetzen oder zu einem Modell eines anderen Anbieters wechseln möchte, muss größere Teile des Codes ändern. Bei einer Aufteilung in Komponenten genügt für eine weitere Informationsquelle ein neuer Datenabruf; für den Modellwechsel reicht eine Konfigurationsänderung.
Zeitgesteuerte Ausführung des Monitoring-Zusammenfassungs-Agenten
Die zeitgesteuerte Ausführung macht den Agenten zum Dauerläufer. Im OpenRouter-Tutorial wird dafür ein dauerhaft laufender Prozess verwendet. Für die tatsächliche Bereitstellung gibt es jedoch mehrere Möglichkeiten – entscheidend ist, welche Infrastruktur bereits vorhanden ist.
| Auslöser | Ausführungsmodell | Vorteile | Zu beachten |
|---|---|---|---|
| System-Cron | Startet jedes Mal einen neuen Prozess, der sich nach der Ausführung beendet | Einfach und zuverlässig, kein dauerhaft laufender Prozess und keine Speicherlecks | Zustand muss gespeichert, Umgebungsvariablen müssen separat konfiguriert werden |
| Prozessinterne Scheduling-Bibliothek | Dauerhaft laufender Prozess mit interner Zeitsteuerung | Verbindungen und Caches lassen sich gemeinsam nutzen | Bei Abstürzen muss der Prozess überwacht und neu gestartet werden, etwa mit systemd oder einer Container-Neustartrichtlinie |
| Cloud-Function-Timer | Serverlose, zeitgesteuerte Ausführung | Kein Serverbetrieb, Abrechnung pro Aufruf | Begrenzte Ausführungsdauer, Zustand muss extern gespeichert werden |
| Zeitgesteuerter CI-Workflow | Planmässige Ausführung auf einer CI-Plattform | Keine Serverkosten, nachvollziehbare Logs | Ausführung kann sich verzögern, nicht für häufige Aufrufe geeignet |
Für Zusammenfassungen, die stündlich oder täglich erstellt werden, ist System-Cron mit einem Skript, das sich nach der Ausführung beendet, meist die wirtschaftlichste Lösung. So wächst der Speicherbedarf eines dauerhaft laufenden Prozesses gar nicht erst an. Schlägt ein Lauf fehl, folgt beim nächsten Termin automatisch ein neuer Versuch. Ein dauerhaft laufender Prozess lohnt sich vor allem dann, wenn Sie im Minutentakt überwachen oder aufwendige Ressourcen zwischen mehreren Läufen teilen möchten.
Wie sich die Modellaufruf-Schicht eines Monitoring-Zusammenfassungs-Agenten entkoppeln lässt
Darum geht es im Kern dieses Artikels. Das Tutorial von OpenRouter nutzt das eigene SDK @openrouter/agent, mit dem sich schnell loslegen lässt. Ob das SDK benutzerdefinierte OpenAI-kompatible Endpunkte unterstützt, geht aus den öffentlich verfügbaren Zusammenfassungen derzeit nicht hervor. Wir haben das auch nicht überprüft und behandeln deshalb nicht, wie sich dieses SDK an andere Plattformen anbinden lässt.
Wir wählen einen anderen Ansatz: Statt den Anwendungscode direkt von einem bestimmten Agent-SDK abhängig zu machen, schalten wir eine schlanke „Zusammenfassungsschnittstelle“ dazwischen. Der Anwendungscode ruft nur summarize(items) auf. Welches Modell und welcher Endpunkt dahinterstehen, entscheidet diese Schicht anhand der Konfiguration.
Schnittstellendesign für die Aufrufschicht des Monitoring-Zusammenfassungs-Agenten
Für die Aufrufschicht gelten drei einfache Prinzipien, die später viel Nacharbeit ersparen:
- Nur fachliche Funktionen bereitstellen: Nach außen steht
summarize(items) -> strzur Verfügung. Technische Parameter wiemessagesundtemperaturebleiben vor dem Anwendungscode verborgen. - Ein einheitliches Protokoll nutzen: Intern kommt das OpenAI-kompatible Chat-Completions-Format zum Einsatz.
base_url,api_keyundmodelwerden vollständig aus Umgebungsvariablen gelesen. - Bei Fehlern ein Fallback bieten: Schlägt ein Aufruf fehl, wird er begrenzt oft wiederholt. Bleibt er erfolglos, gibt der Agent die ursprüngliche Titelliste aus. So liegt für den Tag zumindest ein lesbares Ergebnis vor.
Das OpenAI-kompatible Protokoll dient als Grundlage, weil es sich als allgemeines Format etabliert hat. Das offizielle SDK und zahlreiche Tools von Drittanbietern erlauben es, die base_url zu ändern. Solange der Server dieses Format unterstützt, lässt sich das Modell mit einer Konfigurationsänderung wechseln.
| Schnittstelle | Aufwand für den Modellwechsel | Ökosystem und Tools | Geeignete Einsatzbereiche |
|---|---|---|---|
| Bindung an ein anbieterspezifisches Agent-SDK | Ein Anbieterwechsel erfordert meist Codeänderungen | Die integrierten Funktionen des SDK sind sofort nutzbar | Wenn die Plattform langfristig feststeht und integrierte Funktionen wichtig sind |
| Offizielles OpenAI-SDK mit kompatiblem Endpunkt | Es genügt, base_url und model zu ändern |
Das ausgereifteste Ökosystem mit den meisten Beispielen | Die meisten Aufgaben zur Zusammenfassung von Monitoring-Ergebnissen |
| Selbst gekapselte HTTP-Aufrufe | Eine Konfigurationsänderung genügt, die Wartung liegt aber bei dir | Die wenigsten Abhängigkeiten | Umgebungen, in denen die Größe der Abhängigkeiten besonders wichtig ist |
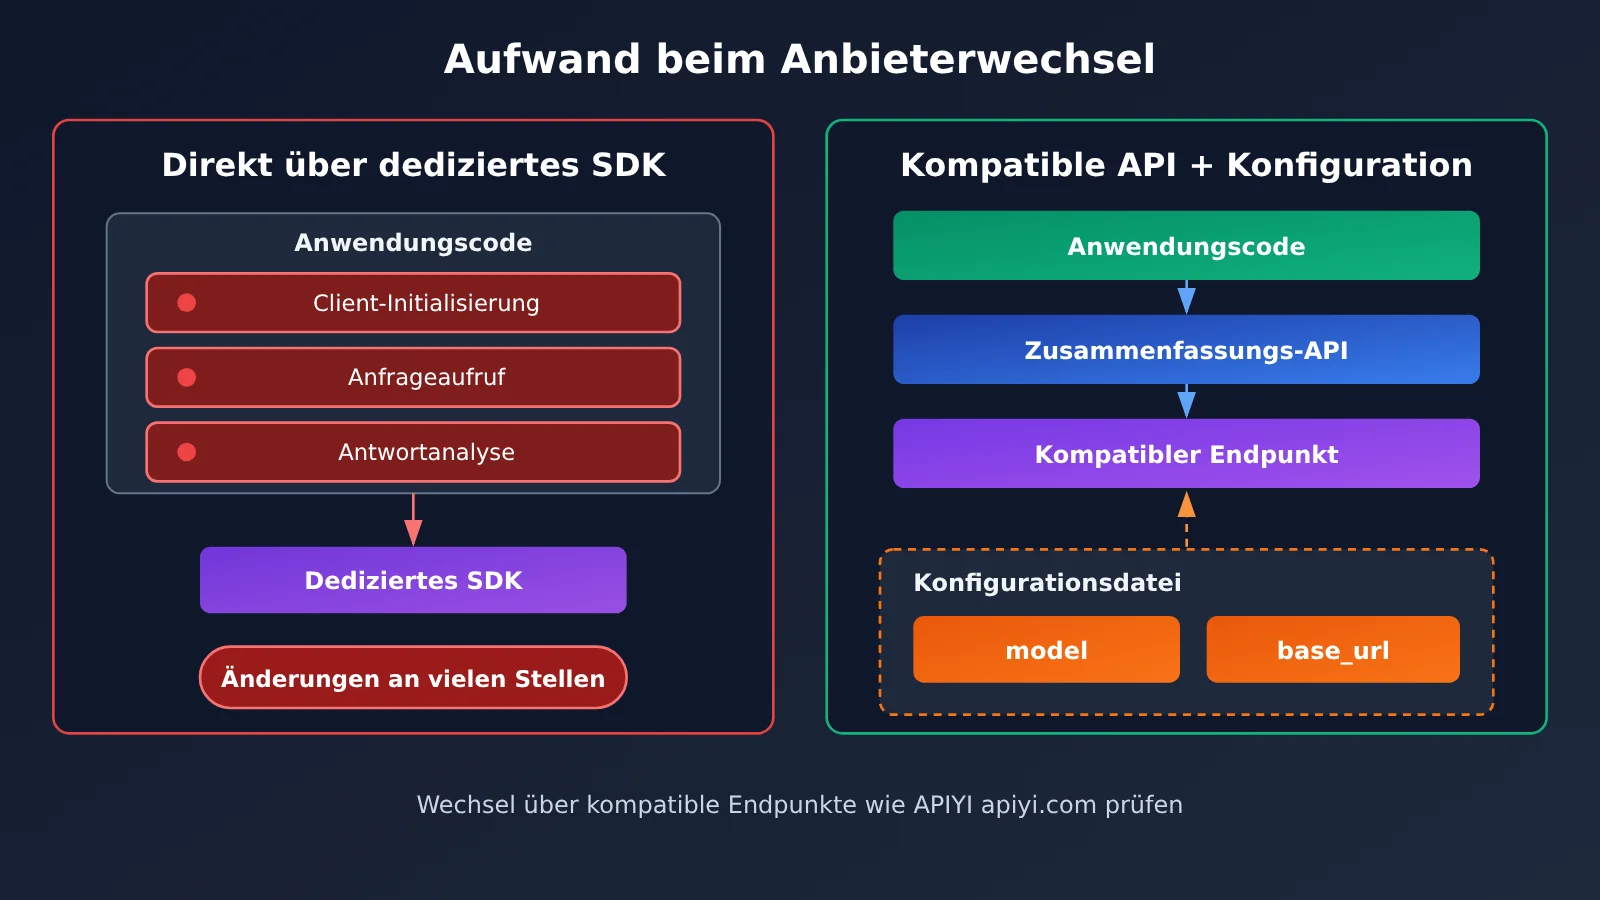
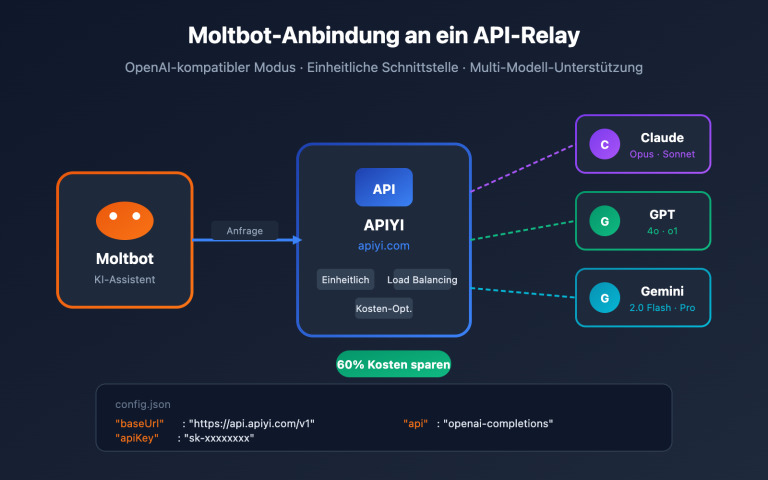
Bei diesem Design sind Aggregationsplattformen wie APIYI eine mögliche Option für die Modellaufruf-Schicht. APIYI ist mit dem OpenAI-API-Format kompatibel und unterstützt die Anbindung über das offizielle OpenAI-SDK. Für einen Modellwechsel muss nur der Modellname geändert werden. Für den Monitoring-Zusammenfassungs-Agenten bedeutet das: Du kannst mit demselben API-Schlüssel die Zusammenfassungen verschiedener Modelle vergleichen, ohne für jedes Modell eine eigene Anbindung zu schreiben.
Was bei der Modellauswahl für Monitoring-Zusammenfassungen zählt
Zusammenfassungen wirken wie eine einfache Aufgabe. Doch je nach Informationsquelle unterscheiden sich die Anforderungen an das Modell erheblich. Systematische Testdaten für solche Aufgaben liegen uns derzeit nicht vor. Deshalb geben wir keine Empfehlung für „das beste Modell“, sondern zeigen, welche Faktoren Sie bei der Entscheidung abwägen sollten.
| Faktor | Warum er wichtig ist | Praxistipp |
|---|---|---|
| Kontextlänge | Pro Durchlauf müssen Dutzende Überschriften oder sogar vollständige Texte verarbeitet werden | Eingaben zuerst kürzen und das Modell anhand der verbleibenden Länge auswählen |
| Befolgung von Anweisungen | Zusammenfassungen benötigen ein festes Format für die Zustellung und Weiterverarbeitung | Mehrere Durchläufe mit einer festen Eingabeaufforderung testen und prüfen, ob das Format stabil bleibt |
| Sprachkenntnisse | Aus englischen Quellen sollen chinesische Zusammenfassungen entstehen | Besonders auf die korrekte Übersetzung von Fachbegriffen achten |
| Kosten pro Aufruf | Bei zeitgesteuerten Aufgaben summieren sich die Kosten über längere Zeit | Nur einen Aufruf pro Durchlauf durchführen sowie die Anzahl der Eingaben und die Ausgabelänge begrenzen |
| Dienststabilität | Bei unbeaufsichtigtem Betrieb fallen Fehler oft erst am nächsten Tag auf | Wiederholungsversuche und Fallbacks einrichten sowie ein Ersatzmodell bereithalten |
💡 Empfehlung: Für Zusammenfassungen gibt es keine pauschal beste Modellwahl. Am zuverlässigsten ist es, mehrere Modelle einige Tage lang mit Ihren tatsächlichen Informationsquellen zu vergleichen. Über APIYI auf apiyi.com können Sie mit demselben Code zwischen mehreren Kandidaten wechseln. Vergleichen Sie dabei die Formatstabilität und die Qualität der chinesischen Formulierungen, bevor Sie sich für ein Modell entscheiden.
Schnellstart: Agent für Monitoring-Zusammenfassungen
Im Folgenden erstellen wir mit Python eine erste lauffähige Version. Als Informationsquelle dient die öffentliche API von Hacker News (hacker-news.firebaseio.com/v0). Das entspricht dem Szenario aus dem OpenRouter-Tutorial und erleichtert den Vergleich.
Minimalbeispiel: Abrufen und zusammenfassen
Der folgende Code ruft die Titel der zehn beliebtesten Hacker-News-Beiträge ab und lässt das Modell eine chinesische Zusammenfassung erstellen. Damit können wir prüfen, ob der gesamte Ablauf funktioniert:
import requests
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI 兼容端点
)

HN = "https://hacker-news.firebaseio.com/v0"
ids = requests.get(f"{HN}/topstories.json", timeout=10).json()[:10]
titles = [requests.get(f"{HN}/item/{i}.json", timeout=10).json().get("title", "") for i in ids]

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 示例模型名,以平台模型列表为准
    messages=[{"role": "user", "content": "用中文分 3 点总结这些热帖的主题:\n" + "\n".join(titles)}]
)
print(resp.choices[0].message.content)
Der Code funktioniert, ist aber noch nicht für den Dauerbetrieb geeignet: Es gibt weder eine Deduplizierung noch eine Fehlerbehandlung, und Modell und Endpunkt sind fest vorgegeben. Die vollständige Version unten trennt die vier Komponenten und ergänzt eine Zustandsverwaltung.
Vollständigen Code anzeigen (vier Komponenten + Deduplizierung + Fallback)
import json
import os
import time
from pathlib import Path

import openai
import requests

HN = "https://hacker-news.firebaseio.com/v0"
STATE_FILE = Path(os.getenv("STATE_FILE", "seen_ids.json"))
TOP_N = int(os.getenv("TOP_N", "30"))


# ---------- 数据获取器 ----------
def fetch_new_stories(seen: set) -> list:
    ids = requests.get(f"{HN}/topstories.json", timeout=10).json()[:TOP_N]
    items = []
    for i in ids:
        if i in seen:
            continue
        item = requests.get(f"{HN}/item/{i}.json", timeout=10).json() or {}
        if item.get("title"):
            items.append({"id": i, "title": item["title"],
                          "url": item.get("url", ""), "score": item.get("score", 0)})
    return items


# ---------- 状态管理 ----------
def load_seen() -> set:
    return set(json.loads(STATE_FILE.read_text())) if STATE_FILE.exists() else set()

def save_seen(seen: set) -> None:
    STATE_FILE.write_text(json.dumps(sorted(seen)[-2000:]))  # 只保留最近的 ID


# ---------- 摘要器(模型调用层) ----------
class Summarizer:
    def __init__(self):
        self.client = openai.OpenAI(
            api_key=os.environ["LLM_API_KEY"],
            base_url=os.getenv("LLM_BASE_URL", "https://api.apiyi.com/v1"),
        )
        self.model = os.getenv("SUMMARY_MODEL", "gpt-4o-mini")

    def summarize(self, items: list, retries: int = 2) -> str:
        lines = "\n".join(f"- [{x['score']}] {x['title']}" for x in items)
        prompt = ("你是技术资讯编辑。请用中文把下面的 Hacker News 新热帖归纳为 3-5 个主题,"
                  "每个主题一句话,并列出最值得关注的 3 条标题。\n" + lines)
        for attempt in range(retries + 1):
            try:
                resp = self.client.chat.completions.create(
                    model=self.model,
                    messages=[{"role": "user", "content": prompt}],
                    max_tokens=800,
                )
                return resp.choices[0].message.content
            except Exception as e:
                print(f"摘要失败(第 {attempt + 1} 次):{e}")
                time.sleep(2 ** attempt)
        return "【模型暂不可用,以下为原始标题】\n" + lines  # 降级输出


# ---------- 输出器 ----------
def deliver(text: str) -> None:
    webhook = os.getenv("WEBHOOK_URL")
    if webhook:
        try:
            requests.post(webhook, json={"text": text}, timeout=10).raise_for_status()
            return
        except Exception as e:
            print(f"推送失败,改为落盘:{e}")
    Path(f"digest-{time.strftime('%Y%m%d-%H%M')}.md").write_text(text, encoding="utf-8")


# ---------- 一次运行(由定时器触发) ----------
def run_once() -> None:
    seen = load_seen()
    items = fetch_new_stories(seen)
    if not items:
        print("没有新条目,本轮跳过")
        return
    deliver(Summarizer().summarize(items))
    save_seen(seen | {x["id"] for x in items})


if __name__ == "__main__":
    run_once()
Ein paar wichtige Designentscheidungen der vollständigen Version sind erklärenswert. Erstens stellt Summarizer nach außen nur summarize bereit; Modellname, Endpunkt und API-Schlüssel stammen alle aus Umgebungsvariablen. Das entspricht der zuvor beschriebenen Entkopplung der Aufrufschicht. Zweitens behält die Zustandsdatei nur die jüngsten IDs, damit sie bei dauerhaftem Betrieb nicht unbegrenzt wächst. Und schließlich werden bei einem Modellfehler die ursprünglichen Titel ausgegeben und bei einem Zustellungsfehler lokal gespeichert. So liefert jeder Durchlauf ein nachvollziehbares Ergebnis.
Zeitgesteuerte Ausführung des Monitoring-Zusammenfassungs-Agenten
Das Skript ist so aufgebaut, dass es einmal ausgeführt wird und sich anschließend beendet. Deshalb lässt es sich direkt über cron starten. Die folgende Konfiguration führt es täglich um 8 und um 20 Uhr aus:
# crontab -e
0 8,20 * * * cd /opt/hn-digest && LLM_API_KEY=xxx SUMMARY_MODEL=gpt-4o-mini /usr/bin/python3 agent.py >> run.log 2>&1
Wenn Sie ein anderes Modell vergleichen möchten, ändern Sie einfach SUMMARY_MODEL auf den gewünschten Modellnamen. Der Code bleibt unverändert. In Produktionsumgebungen sollten Sie den Schlüssel in einer .env-Datei oder einem Dienst zur Schlüsselverwaltung speichern, statt ihn direkt in die crontab zu schreiben.
🚀 Tipp für den schnellen Einstieg: Prüfen Sie zunächst mit einem Minimalbeispiel, ob die gesamte Verbindung funktioniert. Wechseln Sie dann zur vollständigen Version und richten Sie cron ein. APIYI apiyi.com bietet neuen Nutzern ein kostenloses Testkontingent. Mit einem einzigen Schlüssel können Sie zwischen Modellen von OpenAI, Claude, Gemini und anderen wechseln – ideal, um in der Prototypenphase schnell die Qualität der Zusammenfassungen zu vergleichen.
Häufig gestellte Fragen (FAQ)
Q1: Was ist ein zeitgesteuerter Monitoring- und Zusammenfassungs-Agent?
Das ist ein automatisiertes Programm, das regelmäßig durch einen Timer gestartet wird: Es ruft nach Zeitplan neue Inhalte aus Informationsquellen ab, lässt sie von einem großen Sprachmodell zusammenfassen und verschickt das Ergebnis per E-Mail oder Messenger oder speichert es in einer Datei. Anders als ein dialogbasierter Agent läuft es dauerhaft und unbeaufsichtigt. Deshalb sind Stabilität und das Erkennen von Duplikaten wichtiger als komplexe Schlussfolgerungen.
Q2: Was ist der Unterschied zwischen einem speziellen Agent-SDK und einer OpenAI-kompatiblen Schnittstelle?
Ein spezielles SDK bringt Funktionen wie Tool-Aufrufe und Zeitsteuerung oft schon mit. Das erleichtert den Einstieg, bindet den Anwendungscode aber an die jeweilige Plattform. Eine OpenAI-kompatible Schnittstelle setzt auf einer niedrigeren Ebene an: Zeitsteuerung und Duplikaterkennung müssen Sie selbst ergänzen. Dafür lassen sich Modelle und Anbieter durch eine Änderung der Konfiguration wechseln. Bei einfachen Zusammenfassungsaufgaben ist diese Flexibilität meist wertvoller.
Q3: Lässt sich das OpenRouter-Tutorial zu @openrouter/agent direkt für andere Plattformen anpassen?
Die derzeit öffentlich verfügbaren Zusammenfassungen besagen lediglich, dass das Tutorial `@openrouter/agent` 0.11.0 in TypeScript verwendet. Ob das SDK benutzerdefinierte Endpunkte unterstützt, geht daraus nicht hervor und wurde von uns nicht überprüft. Wenn Sie sich einen späteren Wechsel offenhalten möchten, ist es sicherer, sich am Anwendungsfall zu orientieren und ihn mit einer OpenAI-kompatiblen Schnittstelle wie in diesem Artikel selbst umzusetzen.
Q4: Für welche konkreten Anwendungsfälle eignet sich ein Monitoring- und Zusammenfassungs-Agent?
– **Täglicher Überblick über beliebte Beiträge in Technik-Communitys**: zum Beispiel eine Zusammenfassung der täglichen Themen auf Hacker News und in Technikforen
– **Updates von Wettbewerbern verfolgen**: Blogs oder Änderungsprotokolle beobachten und Änderungen zusammenfassen
– **Neuigkeiten aus Open-Source-Projekten**: neue Versionen und wichtige Issues aus beobachteten Repositorys zusammentragen
– **Morgendlicher Branchenüberblick**: mehrere RSS-Feeds bündeln und jeden Morgen eine Zusammenfassung auf Chinesisch verschicken
Q5: Wie lässt sich ein Modell schnell per API für Zusammenfassungen aufrufen?
Empfehlenswert ist eine Aggregator-Plattform, die das OpenAI-kompatible Format unterstützt:
1. Registrieren Sie sich bei APIYI auf apiyi.com und erhalten Sie einen API-Schlüssel sowie kostenloses Testguthaben
2. Setzen Sie `base_url` im Code dieses Artikels auf `https://api.apiyi.com/v1`
3. Wechseln Sie über die Umgebungsvariable `SUMMARY_MODEL` zwischen verschiedenen Modellen und vergleichen Sie die Qualität der Zusammenfassungen
Q6: Wie lassen sich die Kosten bei dauerhaftem Betrieb kontrollieren?
Die Grundidee: nur neue Einträge verarbeiten und das Modell pro Durchlauf nur einmal aufrufen. Filtern Sie bereits bekannte Einträge mithilfe einer Statusdatei heraus, begrenzen Sie die Anzahl der Eingaben pro Durchlauf sowie `max_tokens` und legen Sie das Ausführungsintervall passend zum tatsächlichen Bedarf fest. Die Preise verschiedener Modelle unterscheiden sich teilweise deutlich. Auf der Modellpreisseite von APIYI unter apiyi.com können Sie sie vergleichen und für einfache Aufgaben wie Zusammenfassungen ein günstigeres Modell auswählen.
Q7: Welche bekannten Einschränkungen hat ein Monitoring- und Zusammenfassungs-Agent?
– **Titel allein liefern nur begrenzte Informationen**: Zusammenfassungen anhand von Titeln können Inhalte falsch einordnen. Bei Bedarf lässt sich auch der vollständige Text abrufen; achten Sie dabei auf die Eingabelänge und die geltenden Regeln für den Abruf
– **Das Modell kann Details erfinden**: Die Eingabeaufforderung sollte verlangen, dass die Zusammenfassung ausschließlich auf den bereitgestellten Inhalten basiert. Behalten Sie für wichtige Aussagen die Links zu den Originalquellen bei
– **Informationsquellen können sich ändern**: Änderungen am Schnittstellenformat oder an Limits für Anfragen können dazu führen, dass der Abruf fehlschlägt. Überwachen Sie deshalb die Betriebsprotokolle
Die wichtigsten Erkenntnisse zum Monitoring- und Zusammenfassungs-Agenten
- Vierstufiger Aufbau: Zeitgesteuerte Ausführung, Datenabruf, Zusammenfassung durch das Modell und Ergebnisausgabe sind voneinander getrennt. Das erleichtert Austausch und Fehlersuche.
- Nach dem Durchlauf beenden: Für selten ausgeführte Zusammenfassungen ist cron mit einem einmalig ausgeführten Skript einfacher zu betreiben als ein dauerhaft laufender Prozess.
- Der Status bestimmt die Qualität: Bereits erfasste IDs speichern und bei jedem Durchlauf nur neue Einträge zusammenfassen. Das vermeidet Wiederholungen und unnötigen Aufwand.
- Aufrufschicht entkoppeln: Die Anwendungslogik hängt nur von der Schnittstelle
summarizeab. Modell, Endpunkt und API-Schlüssel stammen vollständig aus der Konfiguration. - Kompatibles Protokoll als Grundlage: Mit dem OpenAI-kompatiblen Format lässt sich das Modell durch Ändern einer einzigen Umgebungsvariable wechseln.
- Modelle praktisch testen: Vergleiche Kontextfenster, Befolgung von Anweisungen, Sprache, Kosten und Stabilität. Über APIYI apiyi.com kannst du verschiedene Modelle mit demselben Code ausprobieren.
- Fallbacks für Fehler vorsehen: Schlägt das Modell fehl, werden die Originaltitel ausgegeben. Scheitert die Zustellung, wird das Ergebnis lokal gespeichert.
Fazit
Beim Aufbau eines zeitgesteuerten Monitoring- und Zusammenfassungs-Agenten kommt es weniger auf ein komplexes Framework an als auf eine klare Struktur:
- Komponenten trennen: Die vier Komponenten für Ausführung, Abruf, Zusammenfassung und Ausgabe sind über einfache Datenstrukturen verbunden. Jeder Schritt lässt sich einzeln testen.
- Schnittstellen entkoppeln: Eine schlanke Zusammenfassungsschnittstelle schirmt die Anwendung vom konkreten SDK ab. Darunter kommt das OpenAI-kompatible Protokoll zum Einsatz.
- Stabilität priorisieren: Deduplizierung, Wiederholungsversuche und Fallbacks sind für unbeaufsichtigte Aufgaben unverzichtbar.
Das Hacker-News-Tutorial von OpenRouter liefert ein gutes Praxisbeispiel. Die allgemeine Architektur in diesem Artikel ermöglicht es dir, denselben Ansatz auf beliebige Informationsquellen und Modelle zu übertragen. Am besten testest du zunächst die gesamte Verarbeitungskette mit einem einfachen Beispiel. Anschliessend lässt du sie einige Tage über cron laufen und beurteilst die Qualität der Zusammenfassungen, bevor du dich für ein Modell zur langfristigen Nutzung entscheidest.
Für eine schnelle Prüfung bietet sich APIYI apiyi.com an: Mit einem einzigen API-Schlüssel kannst du zwischen mehreren gängigen Modellen wechseln. Neue Nutzer erhalten ausserdem kostenloses Testguthaben, um Modelle bereits in der Prototypenphase zu vergleichen.
📚 Referenzen
- Zusammenfassung des OpenRouter-Tutorials: Mit dem Agent SDK einen dauerhaft laufenden KI-Agenten zur Überwachung von Hacker News erstellen
- Link:
aihot.news/items/upl3hjjdokqe13w3ieo9opr0v -
Beschreibung: Die Einführung zu diesem Artikel zeigt, wie sich mit
@openrouter/agent0.11.0 in TypeScript ein zeitgesteuerter Agent erstellen lässt. -
Offizielle Hacker-News-API: Öffentliche Datenschnittstelle mit reinem Lesezugriff
- Link:
github.com/HackerNews/API -
Beschreibung: Dokumentiert unter anderem die Felder der Schnittstellen topstories und item. Sie dient als Datenquelle für die Beispiele in diesem Artikel.
-
OpenAI Python SDK: Offizielle Client-Bibliothek
- Link:
github.com/openai/openai-python - Beschreibung: Erklärt, wie sich kompatible Endpunkte über den Parameter
base_urlanbinden lassen.
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Weitere Informationen zur Anbindung finden Sie im Dokumentationsportal unter docs.apiyi.com.