작성자 주: 정해진 시간에 실행되는 모니터링 요약 Agent의 네 가지 구성 요소를 살펴봐요. 모델 호출 계층이 OpenAI 호환 인터페이스를 통해 특정 SDK와의 결합을 어떻게 줄이는지 설명하고, 실행 가능한 Python 예제도 제공해요.
OpenRouter가 최근 @openrouter/agent 0.11.0을 사용해 TypeScript로 정기 실행되는 상시 AI Agent를 만드는 튜토리얼을 공개했어요. 이 Agent는 Hacker News를 자동으로 모니터링하고 요약을 생성해요. 매일 아침 업계 소식, 경쟁사 동향, 기술 커뮤니티 인기 글을 자동으로 모아보고 싶은 팀이라면 관심을 가질 만한 사례예요. 이 글에서는 이를 계기로 특정 SDK에 종속되지 않는 모니터링 요약 Agent의 범용 아키텍처를 살펴봐요.
원문 튜토리얼을 다시 설명하는 글은 아니에요. 원문에는 요약 정보만 공개되어 있으므로 구체적인 구현 방식은 추측하지 않아요. 대신 모니터링 요약 Agent를 구성하는 요소와 모델이나 서비스 제공업체를 언제든 바꿀 수 있는 모델 호출 계층 설계에 집중해요.
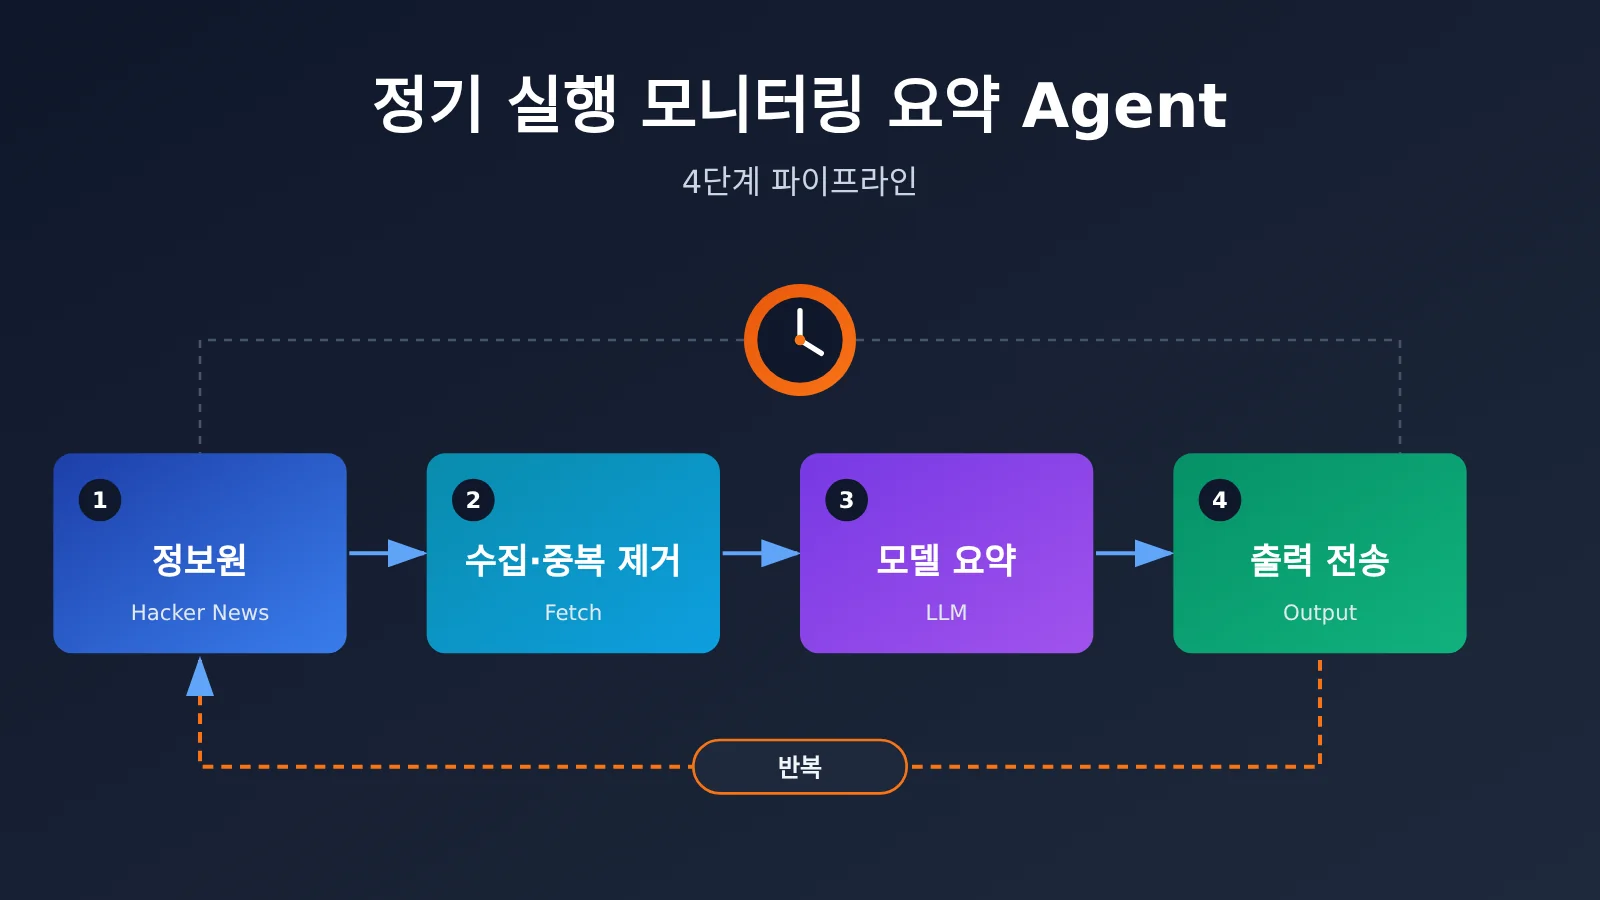
이 글의 핵심: 「정기 실행, 데이터 수집, 모델 요약, 결과 출력」의 4단계 구조를 이해하고, OpenAI 호환 인터페이스를 기반으로 바로 수정해 쓸 수 있는 Python 구현 예제를 얻을 수 있어요.
모니터링 요약 Agent 핵심 요점
먼저 표로 전체 내용을 요약하고, 다음 섹션에서 하나씩 살펴볼게요.
| 요점 | 설명 | 장점 |
|---|---|---|
| 4단계 구조 | 정기 실행 → 데이터 수집 → 모델 요약 → 결과 출력 | 각 단계를 독립적으로 교체하고 테스트할 수 있어요 |
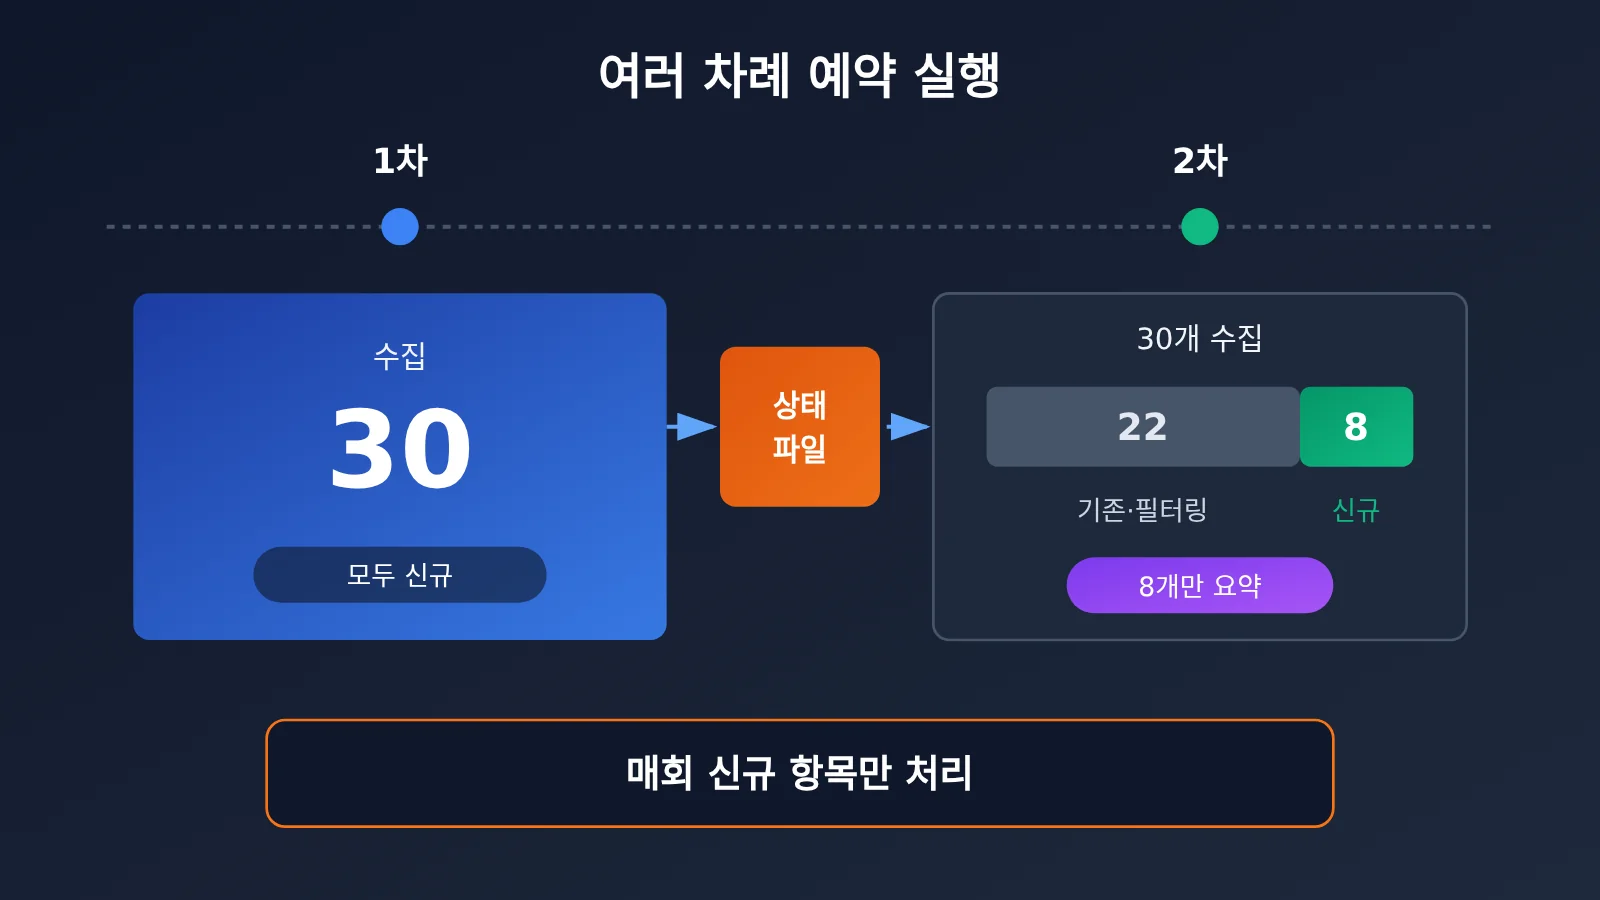
| 상태 관리 | 처리한 항목을 기록해 중복 요약을 방지해요 | 호출량을 줄이고 출력을 깔끔하게 유지해요 |
| 모델 호출 계층 분리 | 비즈니스 코드는 특정 SDK 대신 요약 인터페이스에만 의존해요 | 설정만 바꿔 모델이나 서비스 제공업체를 교체할 수 있어요 |
| OpenAI 호환 프로토콜 | 통일된 Chat Completions 형식을 호출 계층의 기반으로 사용해요 | 생태계가 성숙해 여러 모델을 연결할 수 있어요 |
| 작업에 맞는 모델 선택 | 요약 작업에는 컨텍스트 길이, 지시 이행 능력, 안정성, 비용을 살펴봐요 | 단순한 작업에 비싼 비용을 지불하지 않아도 돼요 |
모니터링 요약 Agent의 네 가지 구성 요소
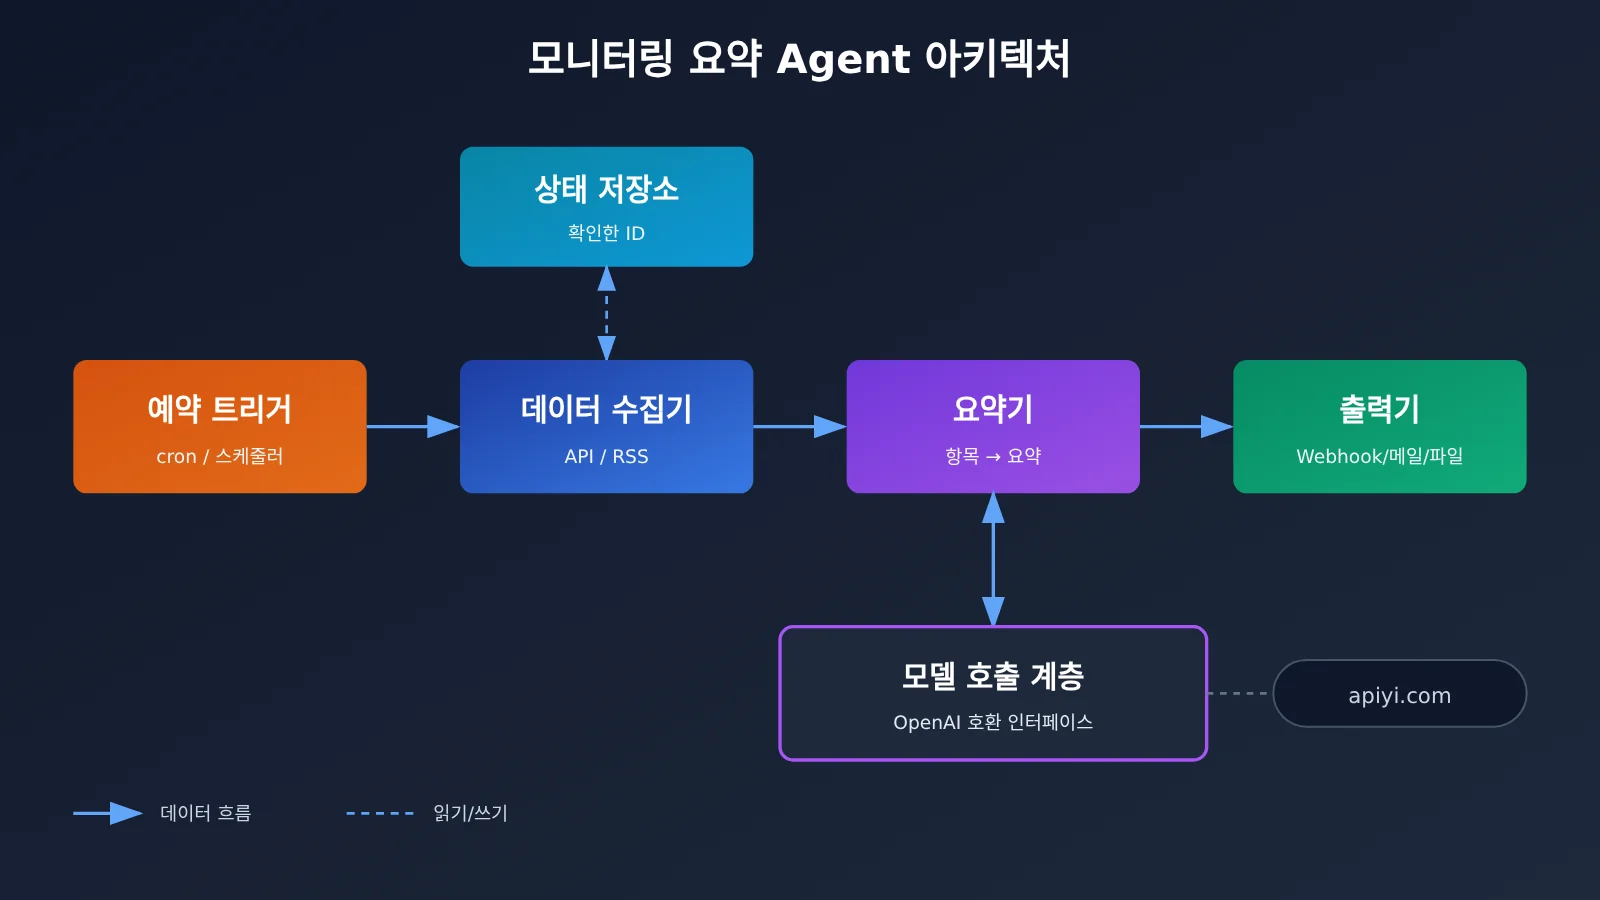
‘상주형 Agent’는 기본적으로 타이머가 반복해서 실행하는 파이프라인이에요. 복잡한 다단계 추론은 필요하지 않지만, 아무도 실행 과정을 지켜보지 않기 때문에 높은 안정성이 요구돼요. 장기간 안정적으로 운영하려면 역할이 명확한 네 가지 구성 요소로 나누는 게 좋아요.
| 구성 요소 | 역할 | 일반적인 구현 방식 | 설계 포인트 |
|---|---|---|---|
| 정기 실행 트리거 | 일정한 주기로 작업을 실행해요 | cron, systemd timer, 클라우드 함수 타이머, CI 예약 워크플로, 프로세스 내 스케줄링 라이브러리 | 실행 트리거와 비즈니스 로직을 분리하고, 실패 시 다시 실행할 수 있게 해요 |
| 데이터 수집기 | 정보 소스에서 새 콘텐츠를 가져와요 | 공개 API, RSS, 웹 스크래핑 | 타임아웃과 항목 수 제한을 설정하고, 확인한 ID를 기록해요 |
| 요약기 | 대규모 언어 모델을 호출해 요약을 생성해요 | Chat Completions 인터페이스 | 입력을 필요한 만큼 잘라내고, 프롬프트를 고정하며, 출력 형식을 제한해요 |
| 출력기 | 결과를 사람이 확인할 수 있는 곳으로 보내요 | 이메일, IM 봇 Webhook, Markdown 파일, 데이터베이스 | 전송 실패에 대비해 파일로 저장하는 등 대체 수단을 마련해요 |
네 구성 요소는 간단한 데이터 구조로만 서로 정보를 주고받아요. 수집기는 ‘항목 목록’을 출력하고, 요약기는 ‘요약 텍스트’를 출력하며, 출력기는 이 텍스트를 전달해요. 이렇게 설계하면 어느 단계에서든 문제를 따로 파악할 수 있어요. 예를 들어 요약 품질이 나쁘면 요약기만 조정하고, 전송에 실패하면 출력기만 확인하면 돼요.
처음에는 모든 로직을 하나의 스크립트에 넣는 경우가 많아요. 실행은 되지만 유지보수가 어려워요. Hacker News를 GitHub Trending으로 바꾸거나 다른 업체의 모델로 교체하려면 코드 전체를 수정해야 하죠. 구성 요소별로 나누면 정보 소스를 확장할 때 수집기만 추가하면 되고, 모델 계층은 설정만 바꾸면 돼요.
모니터링 요약 에이전트의 정기 실행 방식 선택
정기 실행은 에이전트가 「상시 동작」하는 핵심이에요. OpenRouter 튜토리얼에서는 상주 프로세스로 구현했지만, 실제 배포 방식은 기존 인프라에 따라 선택할 수 있어요.
| 실행 방식 | 동작 형태 | 장점 | 주의할 점 |
|---|---|---|---|
| 시스템 cron | 실행할 때마다 새 프로세스를 시작하고 작업이 끝나면 종료 | 간단하고 안정적이며, 프로세스가 상주하지 않아 메모리 누수 걱정이 없음 | 상태를 디스크에 저장해야 하며, 환경 변수를 별도로 설정해야 함 |
| 프로세스 내부 스케줄링 라이브러리 | 상주 프로세스 내부에서 정기적으로 실행 | 연결과 캐시를 공유하기 편리함 | 프로세스가 중단될 경우를 대비해 관리가 필요함(예: systemd, 컨테이너 재시작 정책) |
| 클라우드 함수 타이머 | 서버리스 환경에서 정해진 시간에 실행 | 운영 부담이 없고 호출 횟수에 따라 과금됨 | 실행 시간에 제한이 있으며, 상태를 외부에 저장해야 함 |
| CI 정기 워크플로 | CI 플랫폼에서 일정에 따라 실행 | 서버 비용이 들지 않고 로그를 추적할 수 있음 | 실행 시간이 지연될 수 있어 빈번한 실행에는 적합하지 않음 |
한 시간이나 하루에 한 번 실행하는 요약 작업이라면, 시스템 cron과 「작업 후 바로 종료되는」 스크립트를 함께 쓰는 방식이 대체로 가장 경제적이에요. 상주 프로세스의 메모리 증가 문제를 피할 수 있고, 실패해도 다음 실행 주기에 자동으로 다시 시도해요. 분 단위의 빈번한 모니터링이 필요하거나 실행 간에 무거운 리소스를 공유해야 할 때만 상주 프로세스를 고려하면 돼요.
모니터링 요약 Agent의 모델 호출 계층을 분리하는 방법
이 글의 핵심이에요. OpenRouter 튜토리얼은 자체 @openrouter/agent SDK를 사용하는데, 빠르게 시작하기에는 편리해요. 다만 이 SDK가 사용자 지정 OpenAI 호환 엔드포인트를 지원하는지는 공개된 요약 정보에 나와 있지 않고, 저희도 확인하지 못했어요. 따라서 이 글에서는 해당 SDK를 다른 플랫폼에 연결하는 방법은 다루지 않아요.
대신 다른 방법을 살펴볼게요. 비즈니스 코드가 특정 업체의 Agent SDK에 직접 의존하지 않도록, 중간에 얇은 「요약 인터페이스」 계층을 추가하는 거예요. 비즈니스 코드는 summarize(items)만 호출하고, 어떤 모델과 엔드포인트를 사용할지는 이 계층이 설정에 따라 결정해요.
모니터링 요약 Agent의 호출 계층 인터페이스 설계
호출 계층의 설계 원칙은 세 가지로 정리할 수 있어요. 모두 간단하지만, 나중에 다시 작업해야 할 일을 크게 줄여줘요.
- 비즈니스 의미만 노출: 외부에는
summarize(items) -> str을 제공하고,messages,temperature같은 저수준 파라미터는 비즈니스 코드에 노출하지 않아요. - 내부 프로토콜 통일: 내부에서는 OpenAI 호환 Chat Completions 형식을 사용하고,
base_url,api_key,model은 모두 환경 변수에서 읽어요. - 실패 시 대체 결과 제공: 호출이 실패하면 정해진 횟수만큼 재시도하고, 그래도 실패하면 원본 제목 목록을 출력해요. 이렇게 하면 그날 최소한 읽을 수 있는 결과물은 확보할 수 있어요.
OpenAI 호환 프로토콜을 기반으로 선택한 이유는 사실상 범용 형식으로 자리 잡았고, 공식 SDK와 다수의 서드파티 도구가 base_url 변경을 지원하기 때문이에요. 서버가 이 형식과 호환되기만 하면 모델 전환은 설정 한 줄을 바꾸는 일로 간단해져요.
| 인터페이스 선택 | 모델 전환 비용 | 생태계와 도구 | 적합한 상황 |
|---|---|---|---|
| 특정 업체의 전용 Agent SDK에 종속 | 서비스 제공업체를 바꾸려면 보통 코드를 수정해야 함 | 해당 SDK의 내장 기능을 바로 사용 가능 | 해당 플랫폼을 장기간 사용할 계획이고 내장 기능이 중요한 경우 |
| OpenAI 공식 SDK + 호환 엔드포인트 직접 사용 | base_url과 model만 변경하면 됨 |
생태계가 가장 성숙하고 예제가 가장 많음 | 대부분의 모니터링 요약 작업 |
| HTTP 호출 직접 구현 | 설정만 바꾸면 되지만 유지보수는 직접 담당 | 의존성이 가장 적음 | 의존성 크기에 매우 민감한 환경 |
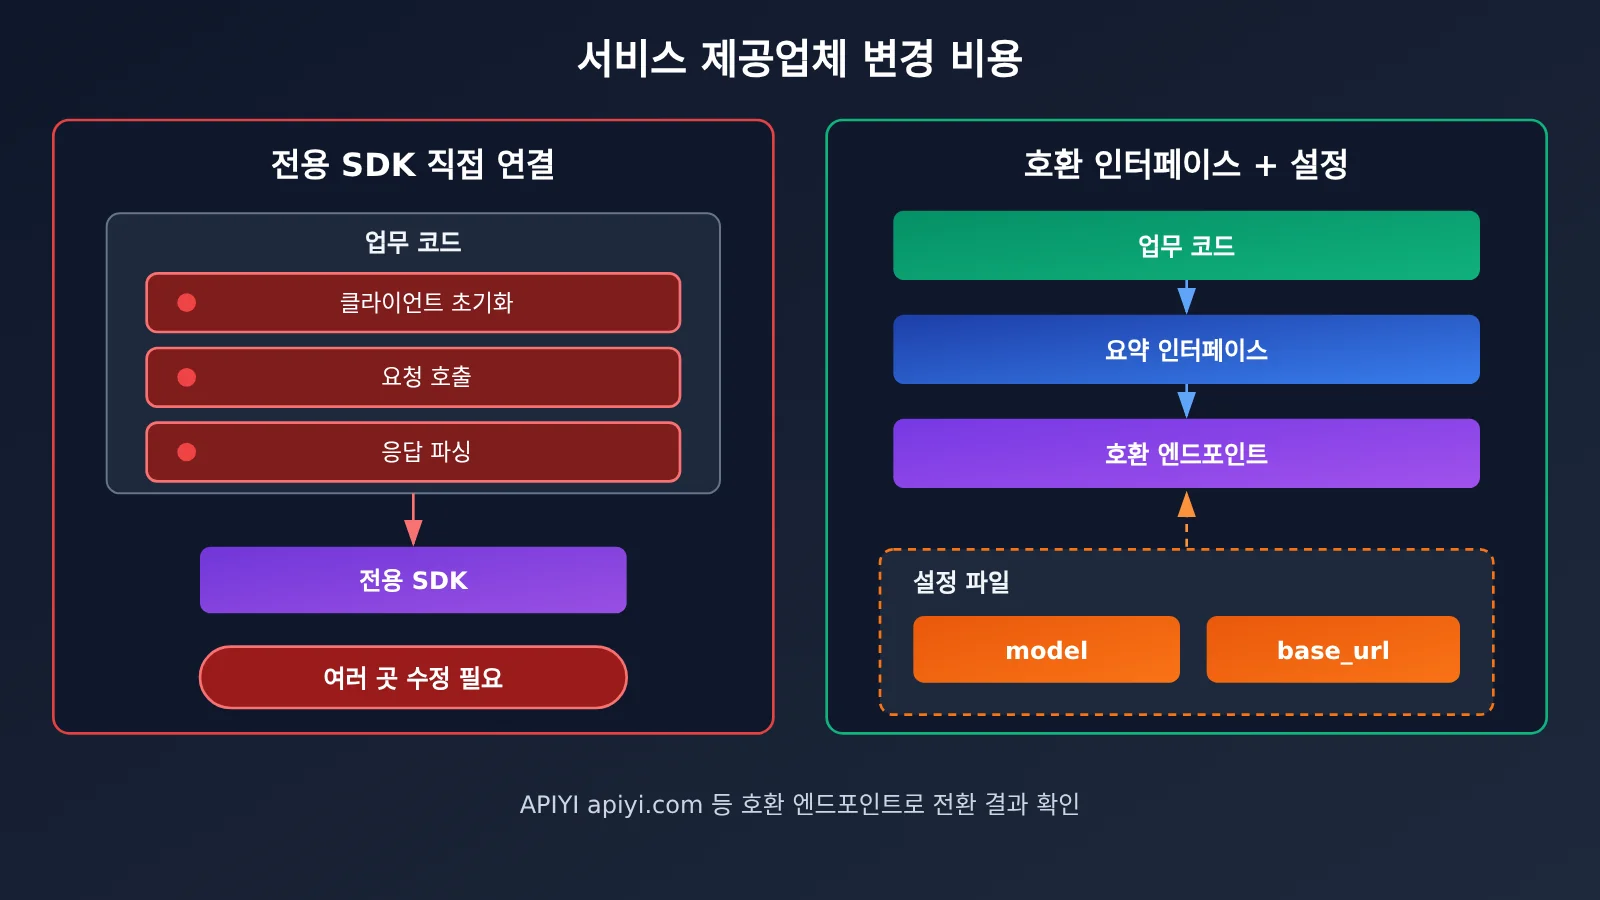
이렇게 설계하면 APIYI 같은 통합 플랫폼을 모델 호출 계층의 한 가지 선택지로 사용할 수 있어요. APIYI는 OpenAI API 형식과 호환되고 OpenAI 공식 SDK 연결을 지원하며, 모델 이름만 바꿔 모델을 전환할 수 있어요. 모니터링 요약 Agent에서는 모델마다 별도의 연동 코드를 작성하지 않고도 같은 API 키로 여러 모델의 요약 결과를 비교할 수 있다는 뜻이에요.
모니터링 요약 작업에 적합한 모델을 고를 때 고려할 점
요약 작업은 단순해 보이지만, 정보 출처에 따라 모델에 필요한 능력은 크게 달라져요. 현재 이 작업에 대한 체계적인 테스트 데이터가 없으므로 ‘어떤 모델이 가장 좋은지’ 결론을 내리기보다 선택할 때 고려할 기준을 정리했어요.
| 고려 요소 | 중요한 이유 | 실무 조언 |
|---|---|---|
| 컨텍스트 길이 | 한 번에 수십 개의 제목이나 본문까지 입력해야 해요 | 먼저 입력을 줄인 뒤, 줄인 길이에 맞춰 모델을 선택해요 |
| 지시 준수 능력 | 푸시 알림과 파싱을 위해 요약 형식을 일정하게 유지해야 해요 | 같은 프롬프트로 여러 차례 실행해 형식이 안정적인지 확인해요 |
| 언어 능력 | 영어 정보 출처를 중국어로 요약해야 해요 | 전문 용어가 정확하게 번역되는지 중점적으로 확인해요 |
| 호출 비용 | 정기 작업을 오래 실행하면 비용이 누적돼요 | 실행마다 한 번씩 호출하고, 입력 항목 수와 출력 길이를 관리해요 |
| 서비스 안정성 | 무인으로 실행하므로 실패해도 다음 날에야 발견할 수 있어요 | 재시도와 대체 처리를 설정하고 예비 모델을 준비해요 |
💡 선택 팁: 요약 모델 선택에는 정답이 없어요. 실제로 사용하는 정보 출처로 며칠간 비교 테스트하는 것이 가장 확실해요. APIYI apiyi.com에서 같은 코드로 후보 모델을 바꿔가며 형식의 안정성과 중국어 표현을 비교한 뒤, 장기적으로 사용할 모델을 결정해 보세요.
모니터링 요약 Agent 빠르게 시작하기
Python으로 최소한의 기능을 갖춘 버전을 만들어 볼게요. 정보 소스로는 Hacker News 공개 API(hacker-news.firebaseio.com/v0)를 사용해요. OpenRouter 튜토리얼과 같은 상황을 다루므로 비교하며 이해하기 편해요.
가장 간단한 예제: 가져오기와 요약
다음 코드는 Hacker News의 인기 게시물 상위 10개 제목을 가져와 모델에 중국어 요약을 요청해요. 전체 과정이 정상적으로 동작하는지 확인할 수 있어요.
import requests
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI 兼容端点
)

HN = "https://hacker-news.firebaseio.com/v0"
ids = requests.get(f"{HN}/topstories.json", timeout=10).json()[:10]
titles = [requests.get(f"{HN}/item/{i}.json", timeout=10).json().get("title", "") for i in ids]

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 示例模型名,以平台模型列表为准
    messages=[{"role": "user", "content": "用中文分 3 点总结这些热帖的主题:\n" + "\n".join(titles)}]
)
print(resp.choices[0].message.content)
이 코드는 실행할 수 있지만, 아직 상시 운영에는 적합하지 않아요. 중복 제거와 실패 처리가 없고, 모델과 엔드포인트도 코드에 고정되어 있어요. 아래 완성 버전은 네 가지 구성 요소를 분리하고 상태 관리를 추가했어요.
전체 구현 코드 보기 (4개 구성 요소 + 중복 제거 + 대체 처리)
import json
import os
import time
from pathlib import Path

import openai
import requests

HN = "https://hacker-news.firebaseio.com/v0"
STATE_FILE = Path(os.getenv("STATE_FILE", "seen_ids.json"))
TOP_N = int(os.getenv("TOP_N", "30"))


# ---------- 数据获取器 ----------
def fetch_new_stories(seen: set) -> list:
    ids = requests.get(f"{HN}/topstories.json", timeout=10).json()[:TOP_N]
    items = []
    for i in ids:
        if i in seen:
            continue
        item = requests.get(f"{HN}/item/{i}.json", timeout=10).json() or {}
        if item.get("title"):
            items.append({"id": i, "title": item["title"],
                          "url": item.get("url", ""), "score": item.get("score", 0)})
    return items


# ---------- 状态管理 ----------
def load_seen() -> set:
    return set(json.loads(STATE_FILE.read_text())) if STATE_FILE.exists() else set()

def save_seen(seen: set) -> None:
    STATE_FILE.write_text(json.dumps(sorted(seen)[-2000:]))  # 只保留最近的 ID


# ---------- 摘要器(模型调用层) ----------
class Summarizer:
    def __init__(self):
        self.client = openai.OpenAI(
            api_key=os.environ["LLM_API_KEY"],
            base_url=os.getenv("LLM_BASE_URL", "https://api.apiyi.com/v1"),
        )
        self.model = os.getenv("SUMMARY_MODEL", "gpt-4o-mini")

    def summarize(self, items: list, retries: int = 2) -> str:
        lines = "\n".join(f"- [{x['score']}] {x['title']}" for x in items)
        prompt = ("你是技术资讯编辑。请用中文把下面的 Hacker News 新热帖归纳为 3-5 个主题,"
                  "每个主题一句话,并列出最值得关注的 3 条标题。\n" + lines)
        for attempt in range(retries + 1):
            try:
                resp = self.client.chat.completions.create(
                    model=self.model,
                    messages=[{"role": "user", "content": prompt}],
                    max_tokens=800,
                )
                return resp.choices[0].message.content
            except Exception as e:
                print(f"摘要失败(第 {attempt + 1} 次):{e}")
                time.sleep(2 ** attempt)
        return "【模型暂不可用,以下为原始标题】\n" + lines  # 降级输出


# ---------- 输出器 ----------
def deliver(text: str) -> None:
    webhook = os.getenv("WEBHOOK_URL")
    if webhook:
        try:
            requests.post(webhook, json={"text": text}, timeout=10).raise_for_status()
            return
        except Exception as e:
            print(f"推送失败,改为落盘:{e}")
    Path(f"digest-{time.strftime('%Y%m%d-%H%M')}.md").write_text(text, encoding="utf-8")


# ---------- 一次运行(由定时器触发) ----------
def run_once() -> None:
    seen = load_seen()
    items = fetch_new_stories(seen)
    if not items:
        print("没有新条目,本轮跳过")
        return
    deliver(Summarizer().summarize(items))
    save_seen(seen | {x["id"] for x in items})


if __name__ == "__main__":
    run_once()
완성 버전에는 짚고 넘어갈 설계 포인트가 몇 가지 있어요. 먼저 Summarizer는 summarize만 외부에 공개하고, 모델 이름과 엔드포인트, Key는 모두 환경 변수에서 가져와요. 앞서 설명한 호출 계층 분리가 바로 이런 방식이에요. 상태 파일에는 최근 ID만 보관해 장기간 실행해도 파일이 계속 커지지 않도록 했어요. 마지막으로 모델 호출에 실패하면 원본 제목을 출력하고, 알림 전송에 실패하면 결과를 파일에 저장해 매번 추적 가능한 결과를 남겨요.
모니터링 요약 Agent의 정기 배포
스크립트는 한 번 실행하고 종료되도록 설계했으므로 시스템 cron에 맡기면 돼요. 아래 설정은 매일 8시와 20시에 한 번씩 실행해요.
# crontab -e
0 8,20 * * * cd /opt/hn-digest && LLM_API_KEY=xxx SUMMARY_MODEL=gpt-4o-mini /usr/bin/python3 agent.py >> run.log 2>&1
다른 모델과 비교하고 싶다면 SUMMARY_MODEL을 다른 모델 이름으로 바꾸기만 하면 돼요. 코드는 한 줄도 수정할 필요가 없어요. 운영 환경에서는 키를 crontab에 직접 쓰지 말고 .env 파일이나 키 관리 서비스에 보관하는 것이 좋아요.
🚀 빠른 시작 팁: 먼저 최소 예제로 전체 흐름이 정상 작동하는지 확인한 뒤, 완성 버전으로 전환해 cron에 연결해 보세요. APIYI apiyi.com은 신규 사용자에게 무료 테스트 크레딧을 제공해요. 하나의 Key로 OpenAI, Claude, Gemini 등의 모델을 전환할 수 있어 프로토타입 단계에서 요약 성능을 빠르게 비교하기 좋아요.
자주 묻는 질문 FAQ
Q1: 정해진 시간에 실행되는 모니터링 요약 Agent란 무엇인가요?
타이머에 따라 주기적으로 실행되는 자동화 프로그램이에요. 정해진 일정에 맞춰 정보 소스의 새 콘텐츠를 수집하고, 대규모 언어 모델로 요약한 뒤 이메일, 메신저 또는 파일로 전달해요. 대화형 Agent와 달리 무인으로 장기간 실행되므로 복잡한 추론보다 안정성과 중복 제거가 더 중요해요.
Q2: 전용 Agent SDK와 OpenAI 호환 인터페이스는 어떻게 다른가요?
전용 SDK는 도구 호출이나 스케줄링 기능을 제공해 빠르게 시작할 수 있지만, 비즈니스 코드가 해당 플랫폼에 종속돼요. OpenAI 호환 인터페이스는 더 저수준이라 스케줄링과 중복 제거를 직접 구현해야 하지만, 설정만 바꾸면 모델과 서비스 제공업체를 전환할 수 있어요. 로직이 단순한 요약 작업에는 보통 이런 유연성이 더 유용해요.
Q3: OpenRouter의 @openrouter/agent 튜토리얼을 다른 플랫폼에 바로 적용할 수 있나요?
현재 공개된 요약 정보에는 해당 튜토리얼이 TypeScript에서 `@openrouter/agent` 0.11.0을 사용한다는 내용만 나와 있어요. SDK가 사용자 지정 엔드포인트를 지원하는지는 명시되어 있지 않고, 저희도 확인하지 못했어요. 나중에 플랫폼을 전환할 가능성이 있다면, 튜토리얼의 활용 아이디어를 참고하되 이 글처럼 OpenAI 호환 호출 계층을 직접 구현하는 편이 더 안전해요.
Q4: 모니터링 요약 Agent는 어떤 상황에 활용할 수 있나요?
– **기술 커뮤니티 인기 글 일간 요약**: Hacker News나 기술 포럼의 주요 주제를 매일 정리
– **경쟁사 업데이트 추적**: 경쟁사 블로그나 변경 로그를 모니터링하고 변경 사항 요약
– **오픈소스 프로젝트 동향**: 관심 있는 저장소의 새 버전과 주요 Issue 취합
– **업계 뉴스 모닝 브리핑**: 여러 RSS 소스를 모아 매일 아침 중국어 브리핑 전달
Q5: API로 모델을 빠르게 호출해 요약하려면 어떻게 하나요?
OpenAI 호환 형식을 지원하는 통합 플랫폼을 추천해요.
1. APIYI apiyi.com에서 계정을 등록하고 API 키와 무료 테스트 크레딧을 받아요.
2. 이 글의 코드에서 `base_url`을 `https://api.apiyi.com/v1`로 설정해요.
3. `SUMMARY_MODEL` 환경 변수로 모델을 바꿔가며 요약 결과를 비교해요.
Q6: 장기간 실행할 때 호출 비용을 어떻게 관리하나요?
핵심은 새로 추가된 항목만 처리하고 실행할 때마다 모델을 한 번만 호출하는 거예요. 상태 파일로 이미 확인한 항목을 걸러내고, 실행당 입력 항목 수와 `max_tokens`를 제한하세요. 실행 주기도 실제 필요에 맞게 설정하면 돼요. 모델별 가격 차이가 크므로 APIYI apiyi.com의 모델 가격 페이지를 비교해 요약처럼 가벼운 작업에 더 경제적인 모델을 선택할 수 있어요.
Q7: 모니터링 요약 Agent에는 어떤 제한이 있나요?
– **제목만으로는 정보가 부족해요**: 제목만 보고 요약하면 내용을 잘못 판단할 수 있어요. 필요하면 본문을 수집하되 입력 길이와 수집 관련 규정에 주의하세요.
– **모델이 세부 내용을 지어낼 수 있어요**: 프롬프트에 제공된 내용만 바탕으로 요약하도록 명시하고, 주요 결론에는 원본 링크를 남겨두세요.
– **정보 소스가 바뀔 수 있어요**: 인터페이스 형식이나 요청 제한 정책이 변경되면 수집이 실패할 수 있으므로 실행 로그를 확인해야 해요.
모니터링 요약 Agent 핵심 포인트 Key Takeaways
- 4단계 구조: 정기 실행, 데이터 수집, 모델 요약, 결과 출력을 분리하면 교체와 문제 해결이 쉬워요
- 작업 후 종료하는 방식이 더 안정적: 실행 빈도가 낮은 요약 작업은 상시 실행 프로세스보다 cron과 일회성 스크립트로 운영하기 편해요
- 상태 관리가 품질을 좌우해요: 확인한 ID를 기록하고 새 항목만 요약하면 중복과 낭비를 피할 수 있어요
- 호출 계층은 분리하세요: 비즈니스 로직은
summarize인터페이스에만 의존하고, 모델과 엔드포인트, API 키는 모두 설정에서 가져와요 - 호환 프로토콜을 기반으로 사용하세요: OpenAI 호환 형식을 쓰면 환경 변수 한 줄만 바꿔 모델을 교체할 수 있어요
- 모델은 직접 테스트해서 선택하세요: 컨텍스트, 지시 준수, 언어, 비용, 안정성을 비교하세요. APIYI apiyi.com에서는 같은 코드로 모델을 바꿔가며 검증할 수 있어요
- 실패에 대비한 대체 수단을 마련하세요: 모델 호출이 실패하면 원본 제목을 출력하고, 알림 전송이 실패하면 결과를 파일로 저장해요
정리
정기적으로 실행되는 모니터링 요약 Agent를 만들 때 중요한 건 복잡한 프레임워크가 아니라 구조를 명확하게 나누는 것이에요.
- 컴포넌트 분리: 실행, 수집, 요약, 출력 네 컴포넌트를 간단한 데이터 구조로 연결하면 각 단계를 따로 테스트할 수 있어요
- 인터페이스 분리: 얇은 요약 인터페이스로 특정 SDK에 대한 의존성을 분리하고, 하위 계층에는 OpenAI 호환 프로토콜을 사용해요
- 안정성 우선: 중복 제거, 재시도, 대체 처리는 무인 작업에 꼭 필요한 설계예요
OpenRouter의 Hacker News 튜토리얼은 좋은 활용 사례를 보여줘요. 이 글의 범용 아키텍처를 사용하면 같은 방식을 어떤 정보원과 모델에도 적용할 수 있어요. 먼저 간단한 예제로 전체 흐름을 확인한 뒤 cron으로 며칠간 실행해 보고, 요약 품질을 살펴 장기적으로 사용할 모델을 선택해 보세요.
APIYI apiyi.com을 통해 효과를 빠르게 검증하는 것도 추천해요. API 키 하나로 여러 주요 모델을 바꿔 사용할 수 있고, 신규 사용자에게는 프로토타입 단계의 비교 테스트에 활용할 수 있는 무료 테스트 크레딧도 제공돼요.
📚 참고 자료
- OpenRouter 튜토리얼 요약: Agent SDK로 상시 실행 AI Agent를 구축해 Hacker News 모니터링하기
- 링크:
aihot.news/items/upl3hjjdokqe13w3ieo9opr0v -
설명: 이 글의 출발점이 된 자료로, TypeScript에서
@openrouter/agent0.11.0을 사용해 정기적으로 실행되는 Agent를 구축하는 방법을 소개해요. -
Hacker News 공식 API: 공개 읽기 전용 데이터 인터페이스
- 링크:
github.com/HackerNews/API -
설명: topstories, item 등의 인터페이스 필드 설명을 담고 있으며, 이 글의 예제 데이터 소스 문서예요.
-
OpenAI Python SDK: 공식 클라이언트 라이브러리
- 링크:
github.com/openai/openai-python - 설명:
base_url매개변수로 호환 엔드포인트에 연결하는 방법을 소개해요.
작성자: APIYI 기술팀
기술 문의: APIYI 웹사이트 홈페이지에서 문의해 주세요. 연동 관련 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.