作者注:拆解定時運行的監控摘要 Agent 的 4 個組成部分,講清模型調用層如何藉助 OpenAI 兼容接口與具體 SDK 解耦,並給出可運行的 Python 示例。
OpenRouter 最近發佈了一篇教程,用 @openrouter/agent 0.11.0 在 TypeScript 裏搭了一個定時運行的常駐 AI Agent,自動監控 Hacker News 並生成摘要。這個場景很有代表性,很多團隊都想要類似的東西:每天早上自動彙總行業資訊、競品動態或技術社區熱帖。本文以它爲引子,拆出一套 不綁定特定 SDK 的監控摘要 Agent 通用架構。
這不是那篇教程的複述。原教程只公開了摘要信息,我們不推測它的具體實現。本文關注更通用的問題:一個監控摘要 Agent 由哪幾部分組成,模型調用層怎樣設計才能隨時切換模型和服務商。
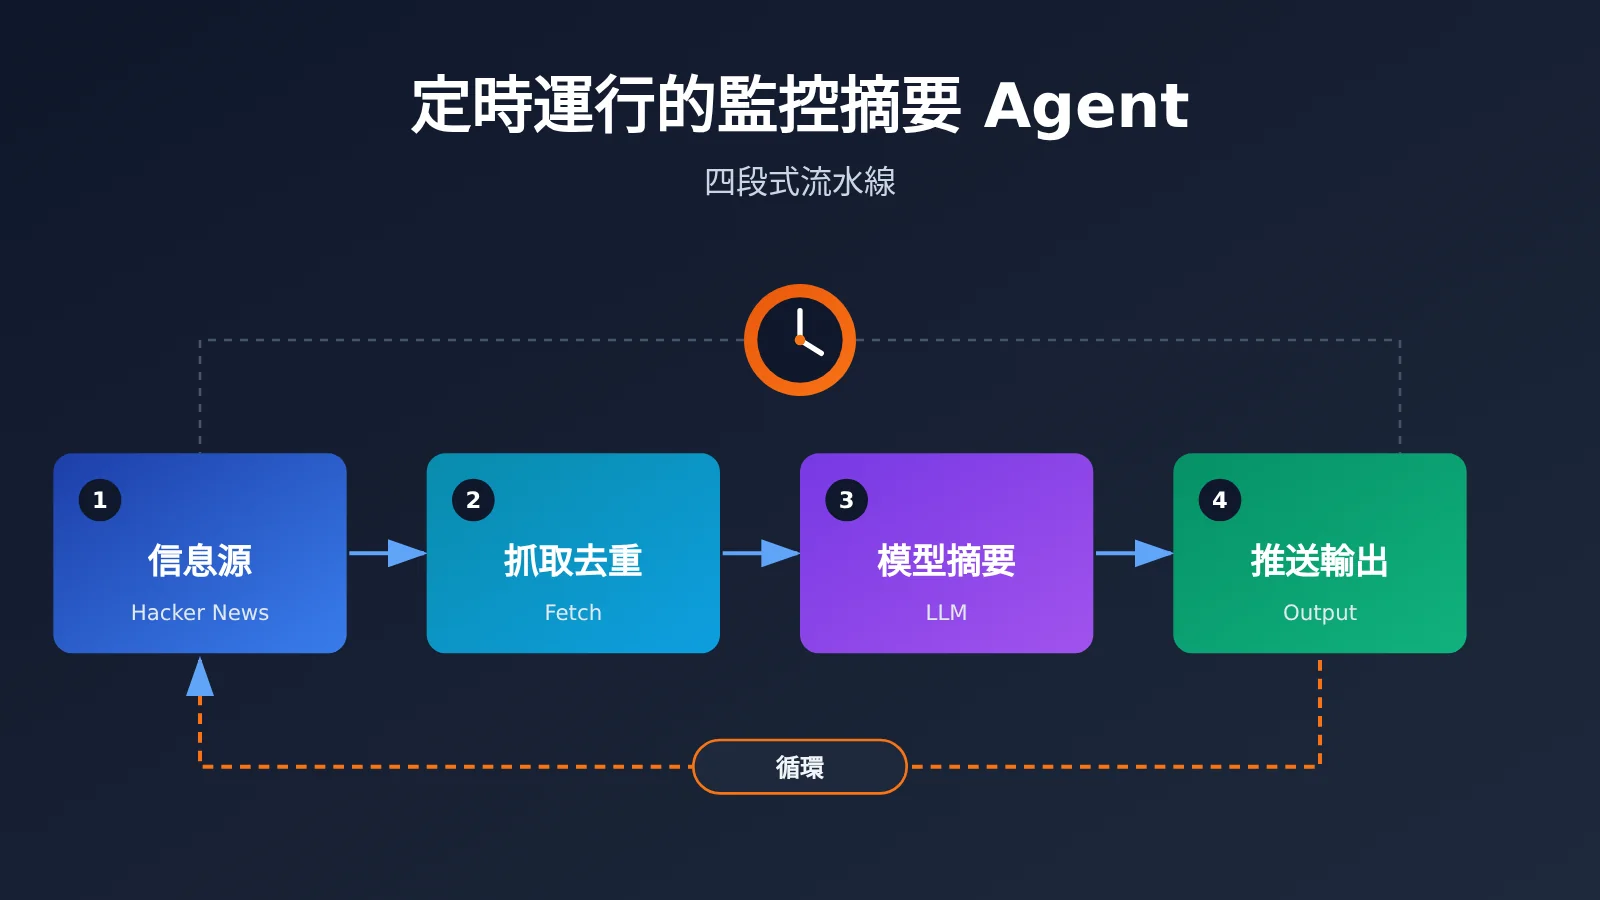
核心價值:讀完本文,你會掌握「定時觸發、數據獲取、模型摘要、結果輸出」四段式結構,並拿到一份基於 OpenAI 兼容接口、可直接改造的 Python 實現。
監控摘要 Agent 核心要點
先用一張表概括整篇文章的結論,後續章節逐項展開。
| 要點 | 說明 | 價值 |
|---|---|---|
| 四段式結構 | 定時觸發 → 數據獲取 → 模型摘要 → 結果輸出 | 每一段都可以獨立替換和測試 |
| 狀態管理 | 記錄已處理條目,避免重複摘要 | 節省調用量,輸出更乾淨 |
| 模型調用層解耦 | 業務代碼只依賴一個摘要接口,不直接依賴某家 SDK | 換模型、換服務商只改配置 |
| OpenAI 兼容協議 | 用統一的 Chat Completions 格式作爲調用層底座 | 生態成熟,可接入多家模型 |
| 模型按任務選 | 摘要任務看上下文長度、指令遵循、穩定性和成本 | 避免爲簡單任務付出高價 |
監控摘要 Agent 的四個組成部分
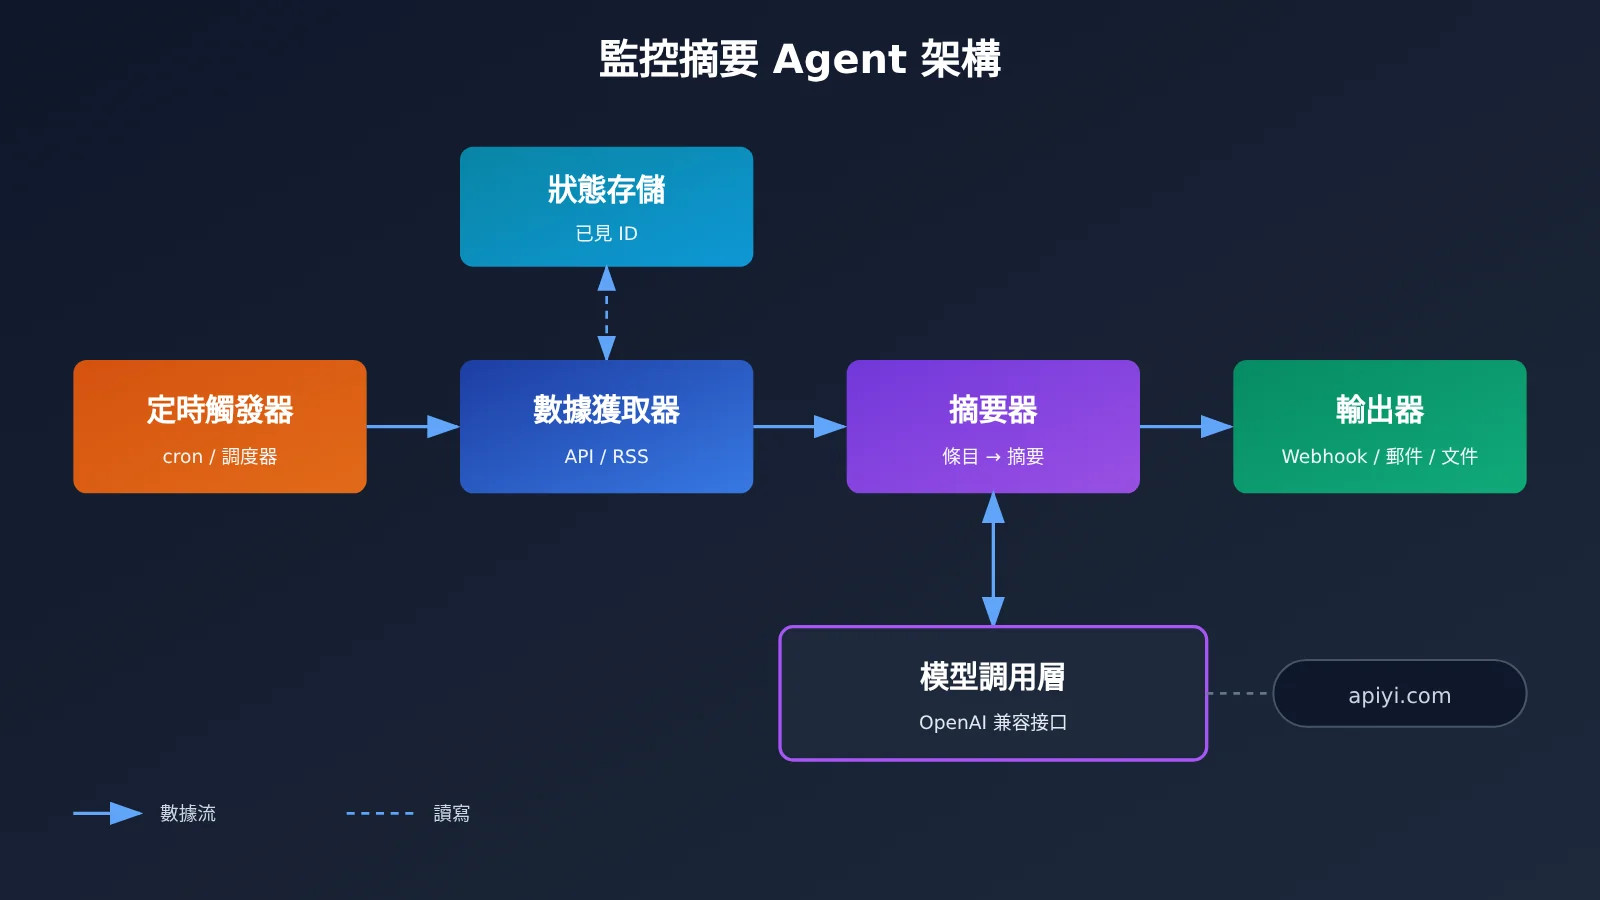
所謂「常駐 Agent」,本質上是一個被定時器反覆喚醒的流水線。它不需要複雜的多步推理,但對穩定性要求很高,因爲沒人會盯着它跑。把它拆成四個職責清晰的組件,是讓它長期穩定運行的前提。
| 組成 | 職責 | 常見實現 | 設計要點 |
|---|---|---|---|
| 定時觸發器 | 按固定節奏喚醒任務 | cron、systemd timer、雲函數定時器、CI 定時工作流、進程內調度庫 | 觸發與業務邏輯分離,失敗可重跑 |
| 數據獲取器 | 從信息源拉取新內容 | 公開 API、RSS、網頁抓取 | 設置超時、限制條數、記錄已見 ID |
| 摘要器 | 調用大模型生成摘要 | Chat Completions 接口 | 輸入裁剪、提示詞固定、輸出格式約束 |
| 輸出器 | 把結果送到人能看到的地方 | 郵件、IM 機器人 Webhook、Markdown 文件、數據庫 | 推送失敗要有降級,例如落盤保存 |
這四個部分之間只通過簡單的數據結構交互:獲取器輸出「條目列表」,摘要器輸出「摘要文本」,輸出器負責消費文本。這樣設計的好處是任何一環出問題都能單獨定位,比如摘要質量差就只調摘要器,推送失敗就只查輸出器。
很多人第一版會把所有邏輯塞進一個腳本,能跑但難維護。一旦想把 Hacker News 換成 GitHub Trending,或者把模型換成另一家,就得改動整段代碼。按組件拆開之後,擴展信息源只是新增一個獲取器,模型層更是隻改配置。
監控摘要 Agent 的定時觸發方式選擇
定時觸發是「常駐」二字的來源。OpenRouter 的教程把它做成了常駐進程,但在實際部署中你有多種選擇,關鍵看你已有的基礎設施。
| 觸發方式 | 運行形態 | 優點 | 需要注意 |
|---|---|---|---|
| 系統 cron | 每次啓動新進程,跑完退出 | 簡單可靠,進程不常駐,內存不泄漏 | 狀態必須落盤,環境變量需單獨配置 |
| 進程內調度庫 | 常駐進程,內部定時執行 | 便於共享連接和緩存 | 進程崩潰需要守護(如 systemd、容器重啓策略) |
| 雲函數定時器 | 無服務器按時觸發 | 免運維,按調用計費 | 有執行時長上限,狀態要存外部 |
| CI 定時工作流 | 在 CI 平臺上按計劃運行 | 零服務器成本,日誌可追溯 | 調度時間可能有延遲,不適合高頻 |
對於每小時或每天跑一次的摘要任務,系統 cron 加一個「跑完即退出」的腳本通常是性價比最高的方案。它天然避免了常駐進程的內存增長問題,失敗後下一輪會自動重試。只有當你需要分鐘級的高頻監控,或者要在多輪之間共享較重的資源時,才值得上常駐進程。
監控摘要 Agent 的模型調用層如何解耦
這是本文的重點。OpenRouter 的教程使用自家的 @openrouter/agent SDK,這對快速起步很方便。但 SDK 是否支持自定義 OpenAI 兼容端點,目前公開的摘要信息裏沒有說明,我們也沒有核實,因此本文不討論把該 SDK 接到其他平臺的做法。
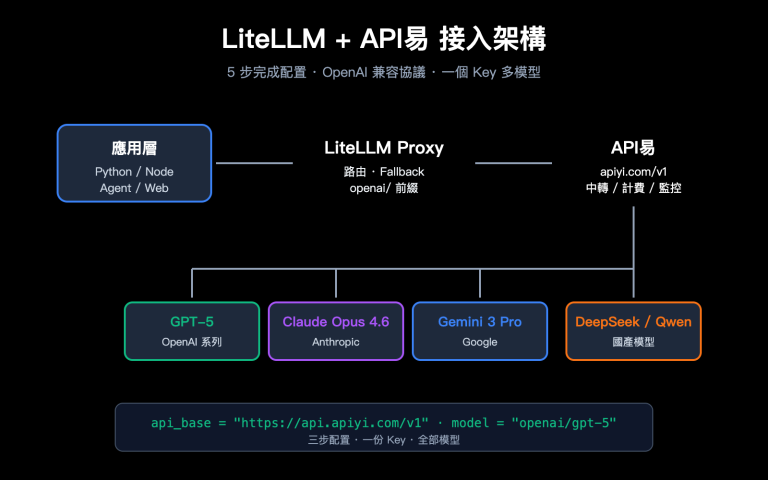
我們換一個思路:不讓業務代碼直接依賴任何一家的 Agent SDK,而是在中間加一層很薄的「摘要接口」。業務代碼只調用 summarize(items),至於背後用哪家模型、哪個端點,全部由這一層根據配置決定。
監控摘要 Agent 的調用層接口設計
調用層的設計原則可以歸納爲三條,都不復雜,但能省下以後大量返工:
- 只暴露業務語義:對外提供
summarize(items) -> str,不把messages、temperature等底層參數泄漏給業務代碼。 - 底層統一協議:內部使用 OpenAI 兼容的 Chat Completions 格式,
base_url、api_key、model全部從環境變量讀取。 - 失敗可降級:調用失敗時重試有限次數,仍失敗則輸出原始標題列表,保證當天至少有一份可讀結果。
選擇 OpenAI 兼容協議作爲底座,是因爲它已經成爲事實上的通用格式,官方 SDK 和大量第三方工具都支持修改 base_url。只要服務端兼容這套格式,切換模型就退化成改一行配置。
| 接口選擇 | 切換模型的成本 | 生態與工具 | 適合場景 |
|---|---|---|---|
| 綁定某家專用 Agent SDK | 換服務商通常要改代碼 | 該 SDK 內置的能力開箱即用 | 已確定長期使用該平臺、看重內置功能 |
| 直接用 OpenAI 官方 SDK + 兼容端點 | 改 base_url 和 model 即可 |
生態最成熟,示例最多 | 大多數監控摘要類任務 |
| 自封裝 HTTP 調用 | 改配置即可,但維護成本自擔 | 依賴最少 | 對依賴體積極其敏感的環境 |
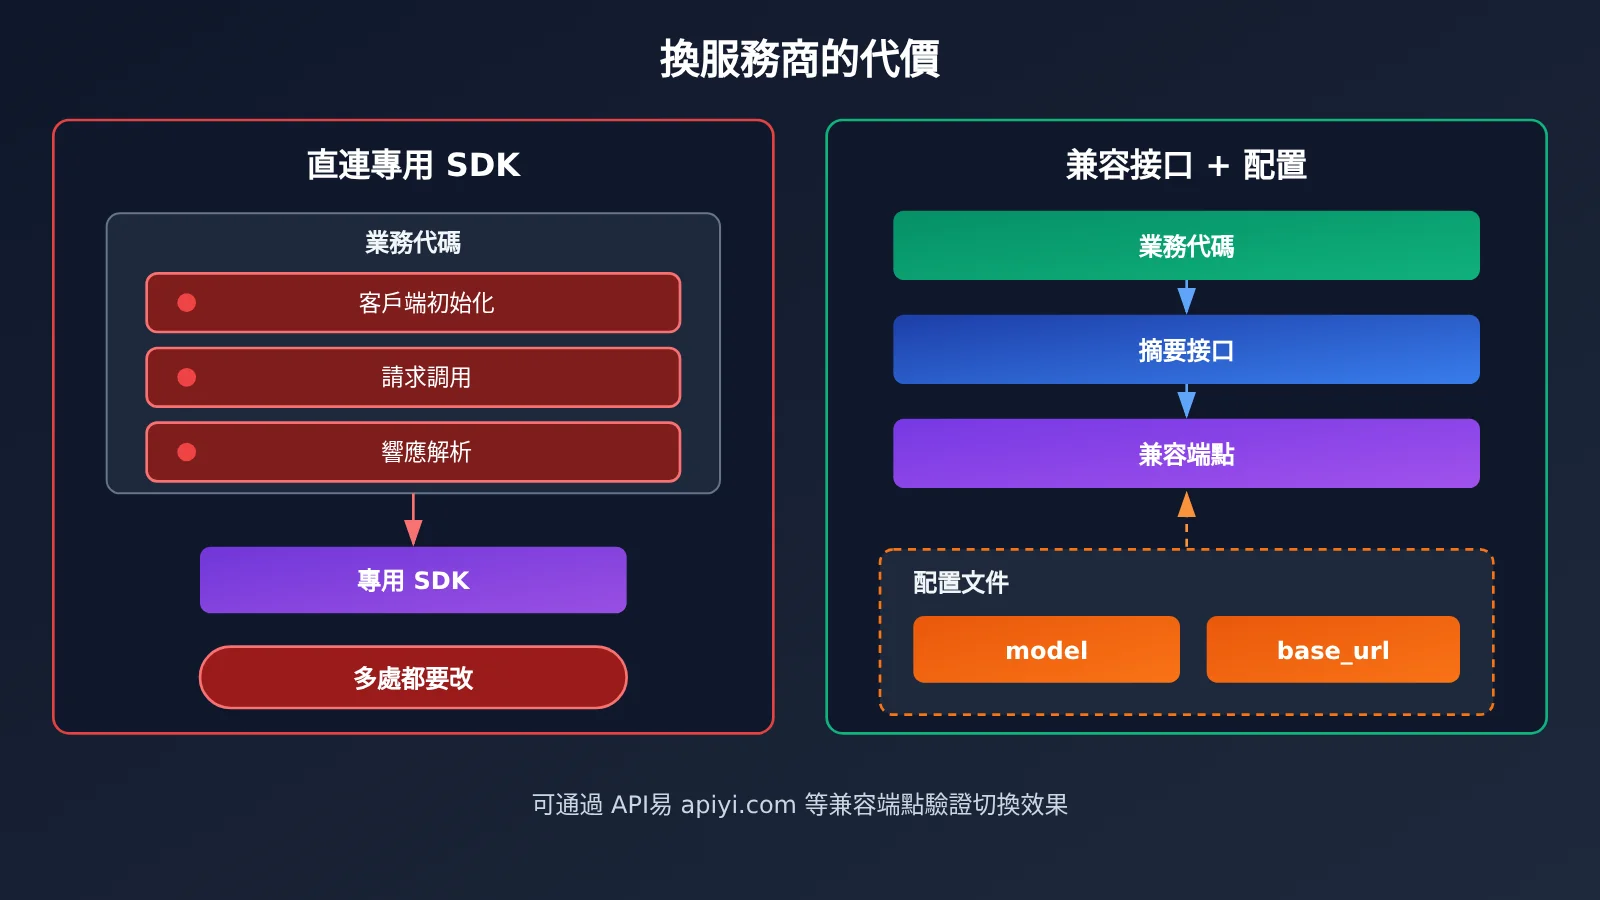
按這種設計,API易 這類聚合平臺就可以作爲模型調用層的一個選項。API易 兼容 OpenAI API 格式,支持 OpenAI 官方 SDK 接入,切換模型只需修改模型名稱。對監控摘要 Agent 來說,這意味着你可以在同一個 Key 下對比不同模型的摘要效果,而不用爲每家模型各寫一套接入代碼。
爲監控摘要任務選擇模型要考慮什麼
摘要任務看起來簡單,但不同信息源對模型的要求差別很大。我們目前沒有針對這類任務的系統測試數據,因此不給出「哪個模型最好」的結論,只列出決策時應該權衡的維度。
| 考量因素 | 爲什麼重要 | 實踐建議 |
|---|---|---|
| 上下文長度 | 一次要喂入幾十條標題甚至正文 | 先裁剪輸入,再按裁剪後的長度選模型 |
| 指令遵循 | 摘要需要固定格式,便於推送和解析 | 用固定提示詞跑幾輪,看格式是否穩定 |
| 語言能力 | 英文信息源要輸出中文摘要 | 重點檢查專業術語翻譯是否準確 |
| 調用成本 | 定時任務長期運行,費用會累積 | 每輪調用一次,控制輸入條數和輸出長度 |
| 服務穩定性 | 無人值守,失敗往往要到第二天才發現 | 配好重試與降級,並保留備用模型 |
💡 選擇建議:摘要模型沒有標準答案,最可靠的辦法是用你真實的信息源跑幾天對比。建議通過 API易 apiyi.com 用同一套代碼切換幾個候選模型,比較格式穩定性和中文表達,再決定長期使用哪一個。
監控摘要 Agent 快速上手
下面用 Python 實現一個最小可用版本。信息源選用 Hacker News 公開 API(hacker-news.firebaseio.com/v0),與 OpenRouter 教程的場景保持一致,方便對照理解。
極簡示例:抓取並摘要
以下代碼拉取 Hacker News 熱門前 10 條標題,交給模型生成中文摘要,用來驗證整條鏈路是否跑通:
import requests
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI 兼容端點
)

HN = "https://hacker-news.firebaseio.com/v0"
ids = requests.get(f"{HN}/topstories.json", timeout=10).json()[:10]
titles = [requests.get(f"{HN}/item/{i}.json", timeout=10).json().get("title", "") for i in ids]

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 示例模型名,以平臺模型列表爲準
    messages=[{"role": "user", "content": "用中文分 3 點總結這些熱帖的主題:\n" + "\n".join(titles)}]
)
print(resp.choices[0].message.content)
這段代碼能跑通,但還不能「常駐」:它沒有去重、沒有失敗處理、模型和端點也是寫死的。下面的完整版把四個組件拆開,並加上狀態管理。
查看完整實現代碼(四組件 + 去重 + 降級)
import json
import os
import time
from pathlib import Path

import openai
import requests

HN = "https://hacker-news.firebaseio.com/v0"
STATE_FILE = Path(os.getenv("STATE_FILE", "seen_ids.json"))
TOP_N = int(os.getenv("TOP_N", "30"))


# ---------- 數據獲取器 ----------
def fetch_new_stories(seen: set) -> list:
    ids = requests.get(f"{HN}/topstories.json", timeout=10).json()[:TOP_N]
    items = []
    for i in ids:
        if i in seen:
            continue
        item = requests.get(f"{HN}/item/{i}.json", timeout=10).json() or {}
        if item.get("title"):
            items.append({"id": i, "title": item["title"],
                          "url": item.get("url", ""), "score": item.get("score", 0)})
    return items


# ---------- 狀態管理 ----------
def load_seen() -> set:
    return set(json.loads(STATE_FILE.read_text())) if STATE_FILE.exists() else set()

def save_seen(seen: set) -> None:
    STATE_FILE.write_text(json.dumps(sorted(seen)[-2000:]))  # 只保留最近的 ID


# ---------- 摘要器(模型調用層) ----------
class Summarizer:
    def __init__(self):
        self.client = openai.OpenAI(
            api_key=os.environ["LLM_API_KEY"],
            base_url=os.getenv("LLM_BASE_URL", "https://api.apiyi.com/v1"),
        )
        self.model = os.getenv("SUMMARY_MODEL", "gpt-4o-mini")

    def summarize(self, items: list, retries: int = 2) -> str:
        lines = "\n".join(f"- [{x['score']}] {x['title']}" for x in items)
        prompt = ("你是技術資訊編輯。請用中文把下面的 Hacker News 新熱帖歸納爲 3-5 個主題,"
                  "每個主題一句話,並列出最值得關注的 3 條標題。\n" + lines)
        for attempt in range(retries + 1):
            try:
                resp = self.client.chat.completions.create(
                    model=self.model,
                    messages=[{"role": "user", "content": prompt}],
                    max_tokens=800,
                )
                return resp.choices[0].message.content
            except Exception as e:
                print(f"摘要失敗(第 {attempt + 1} 次):{e}")
                time.sleep(2 ** attempt)
        return "【模型暫不可用,以下爲原始標題】\n" + lines  # 降級輸出


# ---------- 輸出器 ----------
def deliver(text: str) -> None:
    webhook = os.getenv("WEBHOOK_URL")
    if webhook:
        try:
            requests.post(webhook, json={"text": text}, timeout=10).raise_for_status()
            return
        except Exception as e:
            print(f"推送失敗,改爲落盤:{e}")
    Path(f"digest-{time.strftime('%Y%m%d-%H%M')}.md").write_text(text, encoding="utf-8")


# ---------- 一次運行(由定時器觸發) ----------
def run_once() -> None:
    seen = load_seen()
    items = fetch_new_stories(seen)
    if not items:
        print("沒有新條目,本輪跳過")
        return
    deliver(Summarizer().summarize(items))
    save_seen(seen | {x["id"] for x in items})


if __name__ == "__main__":
    run_once()
完整版有幾個關鍵設計值得說明。首先,Summarizer 只對外暴露 summarize,模型名、端點、Key 全部來自環境變量,這正是前文說的調用層解耦。其次,狀態文件只保留最近的一批 ID,避免長期運行後文件無限增長。最後,模型失敗時輸出原始標題,推送失敗時落盤保存,保證每一輪都有可追溯的產出。
監控摘要 Agent 的定時部署
腳本設計成「跑一次就退出」,因此直接交給系統 cron 即可。下面的配置表示每天 8 點和 20 點各運行一次:
# crontab -e
0 8,20 * * * cd /opt/hn-digest && LLM_API_KEY=xxx SUMMARY_MODEL=gpt-4o-mini /usr/bin/python3 agent.py >> run.log 2>&1
如果想對比另一個模型,只需把 SUMMARY_MODEL 改成其他模型名,代碼一行不動。生產環境建議把密鑰放進 .env 文件或密鑰管理服務,不要直接寫在 crontab 裏。
🚀 快速上手建議:先用極簡示例確認鏈路通暢,再切換到完整版接入 cron。API易 apiyi.com 爲新用戶提供免費測試額度,一個 Key 即可在 OpenAI、Claude、Gemini 等模型之間切換,適合在原型階段快速比較摘要效果。
常見問題 FAQ
Q1:什麼是定時運行的監控摘要 Agent?
它是一個被定時器週期性喚醒的自動化程序:按計劃抓取信息源的新內容,交給大模型歸納成摘要,再推送到郵件、IM 或文件中。和對話式 Agent 不同,它無人值守、長期運行,所以穩定性和去重比複雜推理更重要。
Q2:用專用 Agent SDK 和用 OpenAI 兼容接口有什麼區別?
專用 SDK 往往封裝了工具調用、調度等能力,起步更快,但業務代碼會和該平臺綁定。OpenAI 兼容接口更底層,需要自己補齊調度和去重,換來的是切換模型和服務商只改配置。對於邏輯簡單的摘要任務,後者的靈活性通常更有價值。
Q3:OpenRouter 的 @openrouter/agent 教程能直接改用其他平臺嗎?
目前公開的摘要信息只說明該教程用 `@openrouter/agent` 0.11.0 在 TypeScript 中實現,沒有說明 SDK 是否支持自定義端點,我們也未覈實。如果你希望保留切換空間,更穩妥的做法是參考其場景思路,用本文這種 OpenAI 兼容的調用層自行實現。
Q4:監控摘要 Agent 適合哪些具體場景?
– **技術社區熱帖日報**:如 Hacker News、技術論壇每日主題歸納
– **競品更新追蹤**:監控競品博客或更新日誌,生成變更摘要
– **開源項目動態**:彙總關注倉庫的新版本和重要 Issue
– **行業資訊晨報**:聚合多個 RSS 源,每天早上推送一份中文簡報
Q5:如何通過 API 快速調用模型來實現摘要?
推薦使用支持 OpenAI 兼容格式的聚合平臺:
1. 訪問 API易 apiyi.com 註冊賬號,獲取 API Key 和免費測試額度
2. 把本文代碼的 `base_url` 設爲 `https://api.apiyi.com/v1`
3. 通過 `SUMMARY_MODEL` 環境變量切換不同模型,對比摘要效果
Q6:怎樣控制長期運行的調用成本?
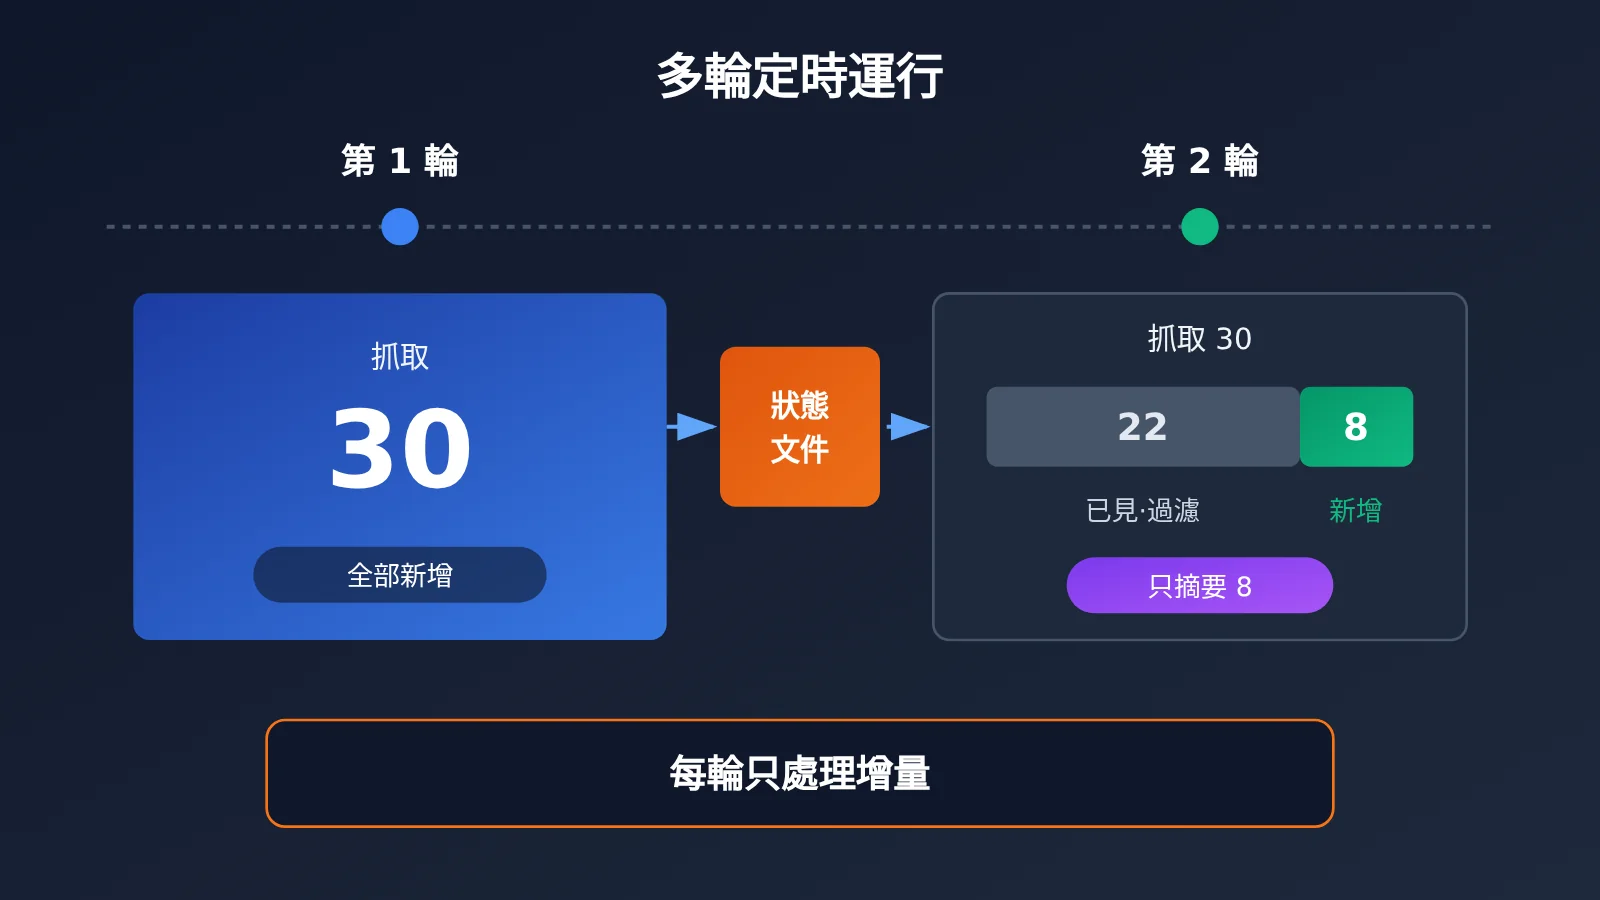
核心思路是隻處理增量、一輪只調一次模型。用狀態文件過濾已見條目,限制每輪輸入條數和 `max_tokens`,並根據實際需求設定運行頻率。不同模型價格差異較大,可以在 API易 apiyi.com 的模型價格頁面對比後,爲摘要這類輕量任務選擇更經濟的模型。
Q7:監控摘要 Agent 有哪些已知限制?
– **只看標題信息有限**:僅憑標題摘要可能誤判內容,需要時可抓取正文,但要注意輸入長度和抓取合規
– **模型可能編造細節**:提示詞應要求只基於給定內容歸納,關鍵結論保留原始鏈接
– **信息源會變化**:接口格式或限流策略調整會導致抓取失敗,需要監控運行日誌
監控摘要 Agent 核心要點 Key Takeaways
- 四段式結構:定時觸發、數據獲取、模型摘要、結果輸出各自獨立,便於替換和排錯
- 跑完即退出更穩:低頻摘要任務用 cron 加一次性腳本,比常駐進程更省心
- 狀態決定質量:記錄已見 ID,每輪只摘要增量,避免重複和浪費
- 調用層要解耦:業務只依賴
summarize接口,模型、端點、Key 全部來自配置 - 兼容協議做底座:OpenAI 兼容格式讓換模型變成改一行環境變量
- 模型靠實測選:按上下文、指令遵循、語言、成本、穩定性對比,可在 API易 apiyi.com 用同一套代碼切換驗證
- 失敗要有降級:模型失敗輸出原始標題,推送失敗落盤保存
總結
搭建一個定時運行的監控摘要 Agent,關鍵不在於用多麼複雜的框架,而在於把結構拆清楚:
- 組件拆分:觸發、獲取、摘要、輸出四個組件通過簡單數據結構銜接,每一環都能單獨測試
- 接口解耦:用一層薄薄的摘要接口隔離具體 SDK,底層採用 OpenAI 兼容協議
- 穩定優先:去重、重試、降級是無人值守任務的必備設計
OpenRouter 的 Hacker News 教程提供了一個很好的場景樣板,而本文的通用架構讓你可以把同樣的思路遷移到任何信息源和任何模型上。下一步,建議先用極簡示例跑通鏈路,再接入 cron 連續運行幾天,觀察摘要質量後再決定長期使用的模型。
推薦通過 API易 apiyi.com 快速驗證效果,一個 API Key 即可在多個主流模型之間切換,新用戶還有免費測試額度可用於原型階段的對比測試。
📚 參考資料
- OpenRouter 教程摘要:用 Agent SDK 搭建常駐 AI Agent 監控 Hacker News
- 鏈接:
aihot.news/items/upl3hjjdokqe13w3ieo9opr0v -
說明:本文的引子,介紹了用
@openrouter/agent0.11.0 在 TypeScript 中搭建定時 Agent 的場景 -
Hacker News 官方 API:公開的只讀數據接口
- 鏈接:
github.com/HackerNews/API -
說明:包含 topstories、item 等接口的字段說明,是本文示例數據源的文檔
-
OpenAI Python SDK:官方客戶端庫
- 鏈接:
github.com/openai/openai-python - 說明:介紹如何通過
base_url參數接入兼容端點
作者:APIYI 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心