Am 20. Oktober 2026 fiel ein Verfügbarkeitsbereich von Google Cloud in London für fast acht Stunden aus. Fünf Tage zuvor war auch DeepSeek den größten Teil des Vormittags nicht erreichbar. Viele Entwickler fragen sich nun, ob beim nächsten Mal auch ihre eigene KI-Anwendung ausfällt.
Der vorgelagerte Dienst kann jederzeit ausfallen. Wer nur Modell-APIs nutzt, muss zwar kein eigenes Rechenzentrum verlegen, sollte sein Geschäft aber auch nicht an nur ein Modell binden.
Das nehmen Sie mit: Nach der Lektüre wissen Sie, in welchen Fällen Sie aktiv werden müssen – und in welchen nicht. Außerdem erfahren Sie, wie Sie für Ausfälle eine Alternative zu Ihrem Modell bereithalten.
Zwei Ausfälle in einer Woche – was jeweils betroffen war
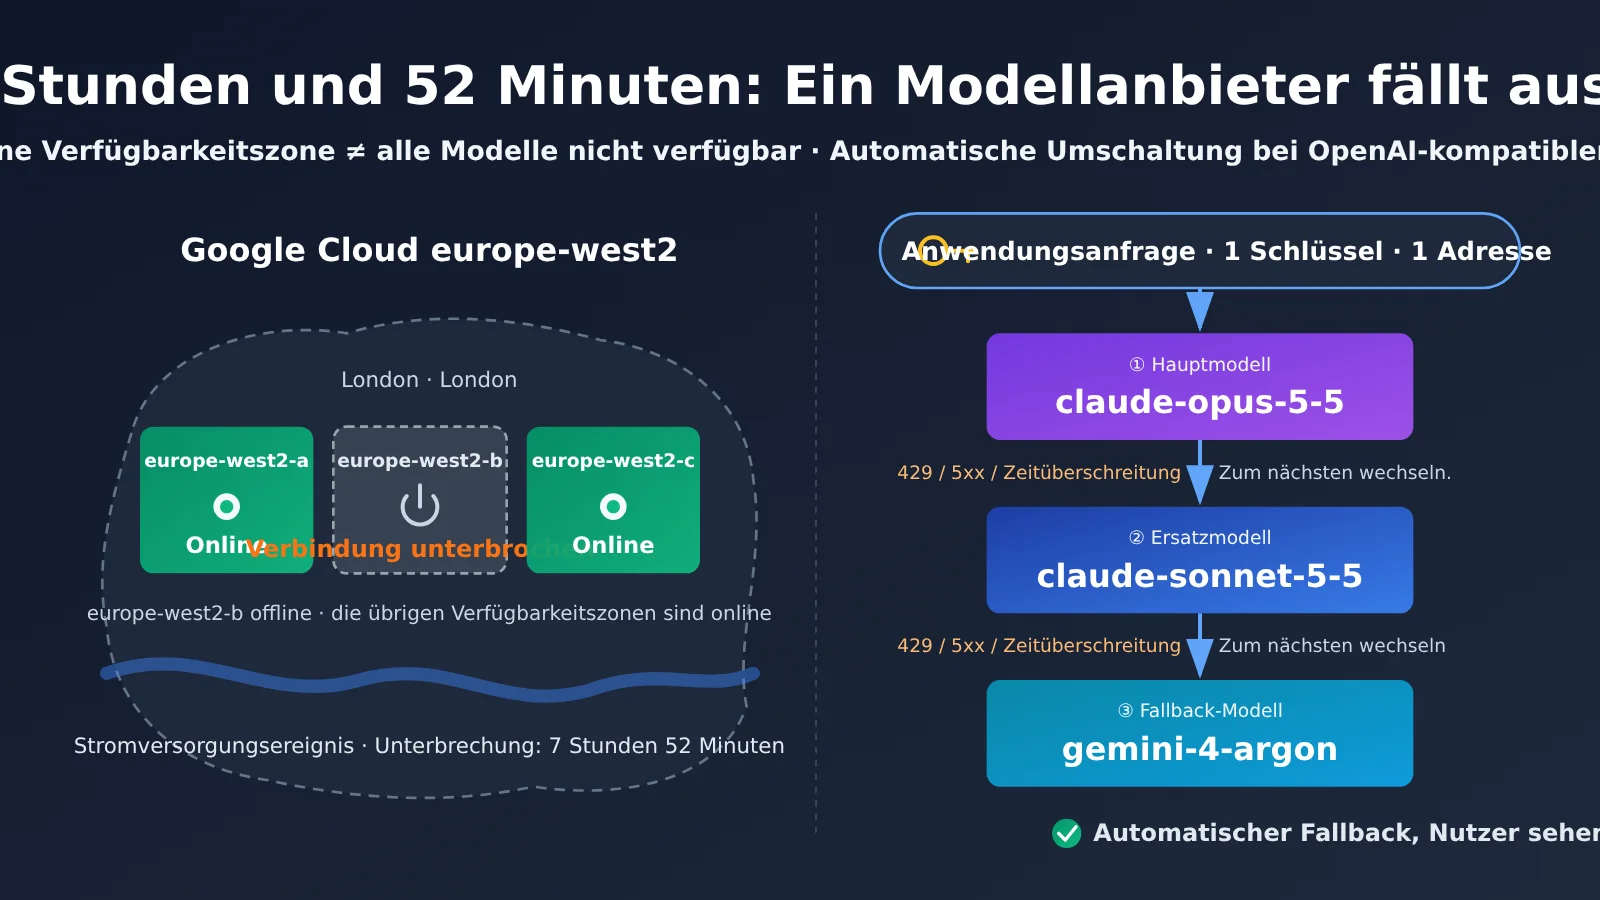
Zuerst Google Cloud. Am 20.10.2026 kam es von 14:08 bis 22:00 Uhr Pekinger Zeit in der Londoner Availability Zone europe-west2-b wegen eines Stromversorgungsproblems zu einem Ausfall. Insgesamt dauerte er 7 Stunden und 52 Minuten. Betroffen waren Compute-, Speicher-, Datenbank- und Netzwerkdienste in dieser Availability Zone. Wer lediglich Modell-APIs remote aufruft, war nicht direkt betroffen. Wenn der eigene Dienst aber genau in dieser Zone lief, standen an diesem Nachmittag Hintergrundaufgaben, Datenbankverbindungen und externe Schnittstellen still. Niemand konnte die Arbeit für sie vorab erledigen.
Dann DeepSeek. Ab dem 15.10.2026 um 08:11 Uhr Pekinger Zeit kam es zu teilweisen Ausfällen bei Website, Chat und den APIs von V4 Pro und V4.1 Flash. Laut offizieller Statusseite dauerte die Störung 4 Stunden und 52 Minuten; um 13:04 Uhr desselben Tages war sie behoben. Caixin und die South China Morning Post sprachen von „fast fünf Stunden“. Das ist die Formulierung der Medien – maßgeblich ist die Dauer laut offiziellem Protokoll. DeepSeek erstattete später den Verbrauch vom 8. bis 14. Oktober als Guthaben. Die Ursache hat das Unternehmen nicht bekannt gegeben, deshalb spekulieren wir hier nicht. Für Nutzerinnen und Nutzer war an diesem Vormittag entscheidend, ob es eine zweite Möglichkeit gab – nicht, was die Ursache war.
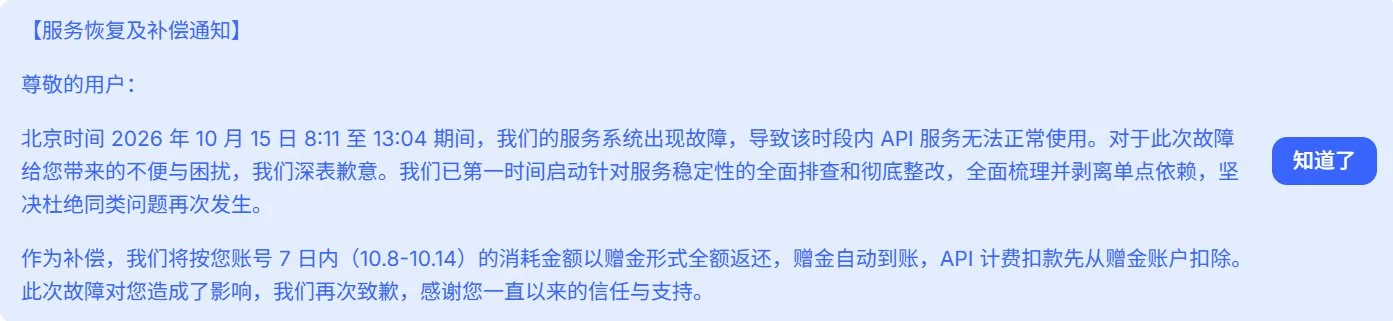
Bild: DeepSeek informiert Nutzer über die Wiederherstellung des Dienstes und eine Entschädigung. Der API-Dienst war am 15. Oktober von 8:11 bis 13:04 Uhr Pekinger Zeit nicht ordnungsgemäß verfügbar. Der Verbrauchsbetrag des jeweiligen Kontos vom 8. bis 14. Oktober wird vollständig als Guthaben gutgeschrieben. Die Gutschrift erfolgt automatisch. API-Gebühren werden zuerst vom Guthabenkonto abgezogen.
Beide Ausfälle taten an derselben Stelle weh: Das Modell ist Teil des täglichen Arbeitsablaufs. Fällt die Schnittstelle aus, stehen auch Programmieren, Recherchieren und die Batchverarbeitung still. Bis der Anbieter das Problem behoben hat, ist schnell ein halber Tag vorbei. Eine Erstattung gleicht die Rechnung aus, aber nicht die ausgefallene Arbeit. Wenn ein Team an diesem Tag Übersetzungen abliefern, eine Evaluierungsrunde durchführen oder einen Release fertigstellen wollte, erledigt sich das nicht von selbst, nur weil es später eine Entschädigung gibt. Die Arbeit verschiebt sich nach hinten und belastet zusätzlich die Planung des nächsten Tages.
| Punkt | Verifizierte Fakten zum Google-Cloud-Vorfall |
|---|---|
| Vorfallnummer | Xs2XTHzAVC9YnafnPyzj |
| Betroffener Bereich | Availability Zone europe-west2-b in der Region europe-west2 |
| Ursache | Stromversorgungsproblem; offiziell wurden keine weiteren Details genannt |
| Beginn | 20.10.2026, 14:08 Uhr Pekinger Zeit |
| Ende | 20.10.2026, 22:00 Uhr Pekinger Zeit; Dauer: 7 Stunden und 52 Minuten |
| Nicht betroffen | Looker Studio |
Availability Zone und Region – wo liegt der Unterschied?
Wer „Stromausfall in London“ liest, denkt vielleicht zuerst, dass ganz Google Cloud in London ausgefallen ist. Das stimmt aber nicht. Eine Region (europe-west2) kann man sich als ein ganzes Areal mit Rechenzentren von Google in London vorstellen. Availability Zones (europe-west2-a, b und c) sind voneinander getrennte Gebäude innerhalb dieses Areals. Sie haben getrennte Stromversorgungen und Netzwerke, damit die anderen Gebäude einspringen können, wenn eines ausfällt. Diesmal war eines der drei Gebäude dunkel, die beiden anderen waren weiterhin online.
Betroffen waren also vor allem Teams, die ihre Dienste ausschließlich in Zone b betrieben. Waren die Dienste bereits auf die Zonen a und c verteilt, konnte der Traffic auf die noch verfügbaren Gebäude umgeleitet werden und die Auswirkungen fielen deutlich geringer aus. Wer lediglich Modell-APIs remote aufruft, dürfte von diesem Stromausfall kaum etwas bemerkt haben.
Die beiden Ausfälle im Vergleich
| Vergleichspunkt | Google Cloud London | DeepSeek |
|---|---|---|
| Zeitpunkt (Pekinger Zeit) | 20.10.2026, 14:08 bis 22:00 Uhr | 15.10.2026, 08:11 bis 13:04 Uhr |
| Dauer | 7 Stunden und 52 Minuten | 4 Stunden und 52 Minuten |
| Was war ausgefallen? | Compute-, Speicher-, Datenbank- und Netzwerkdienste in europe-west2-b | Website, Chat sowie die APIs von V4 Pro und V4.1 Flash |
| Ursache | Stromversorgungsproblem; keine weiteren Details | Vom Anbieter nicht bekannt gegeben |
| Maßnahmen danach | Der Anbieter empfahl, wenn möglich in eine andere Availability Zone oder Region umzuziehen | Verbrauch vom 8. bis 14. Oktober wurde als Guthaben erstattet |
| Wer nur Modell-APIs aufruft | Nicht direkt betroffen | Direkt betroffen; ohne Ausweichmöglichkeit bleibt nur Warten |
Der Vergleich macht den Unterschied deutlich: Beim Google-Cloud-Ausfall waren diejenigen betroffen, die ihre Maschinen in Zone b betrieben. Die Lösung ist eine Bereitstellung über mehrere Availability Zones hinweg. Beim DeepSeek-Ausfall traf es diejenigen, die nur einen einzigen Modellanbieter eingebunden hatten. Hier hilft es, ein Ersatzmodell vorzusehen. Im ersten Fall geht es um das Rechenzentrum, im zweiten um den Modellaufruf. Im Folgenden geht es um den zweiten Fall.
Was wir aus diesem Ausfall lernen sollten
Ein Anbieter kann ausfallen. Deshalb sollten eine zweite und dritte Möglichkeit bereitstehen – und am besten nicht alle vom selben Anbieter kommen. Innerhalb desselben Anbieters auf eine günstigere Modellvariante zu wechseln, ist keine echte Ausweichmöglichkeit. Wenn der ganze Anbieter Probleme hat, fallen beide Varianten gleichzeitig aus.
Auch der Zeitpunkt des Wechsels ist wichtig: Nur bei 429, 500, 502, 503, 504 und Timeouts sollte auf ein anderes Modell gewechselt werden. In diesen Fällen kann der Anbieter vorübergehend überlastet sein, und ein anderer Modellaufruf hat vielleicht Erfolg. Bei 401, 403 und Ablehnungen durch Inhaltsfilter sollte kein Modellwechsel erfolgen. Dann liegt das Problem am API-Schlüssel oder am Inhalt selbst – zehn andere Modelle würden genauso ablehnen. Außerdem gilt: Wenn die eigene Datenbank und der eigene Speicher in einer ausgefallenen Availability Zone liegen, hilft ein Modellwechsel nicht. Dann muss eine Bereitstellung über mehrere Availability Zones hinweg geprüft werden. Modell-Fallback und Notfallwiederherstellung des Rechenzentrums sind zwei verschiedene Dinge – nicht miteinander verwechseln.
Wenn die Ausweichlösung einmal eingerichtet ist, sollte sie nach dem Ende eines Ausfalls nicht wieder entfernt werden. Sie erzeugt im Normalbetrieb keine zusätzlichen Anfragen: Wenn das primäre Modell beim ersten Versuch erfolgreich antwortet, kommt sie gar nicht zum Einsatz. Beim nächsten Ausfall greift sie aber automatisch – ohne dass jemand mitten in der Nacht den Code ändern muss. Bevor Sie mit der Umsetzung beginnen, senden Sie jedem Modell eine einfache Testanfrage. So können Sie prüfen, ob der Modellname stimmt und eine Antwort zurückkommt, bevor Sie die Modelle miteinander verketten. Die Antworten verschiedener Modelle können sich im Stil unterscheiden. Wenn das Ausgabeformat für den Anwendungsfall wichtig ist, können Sie es in der System-Eingabeaufforderung fest vorgeben und so die Unterschiede beim Modellwechsel verringern.
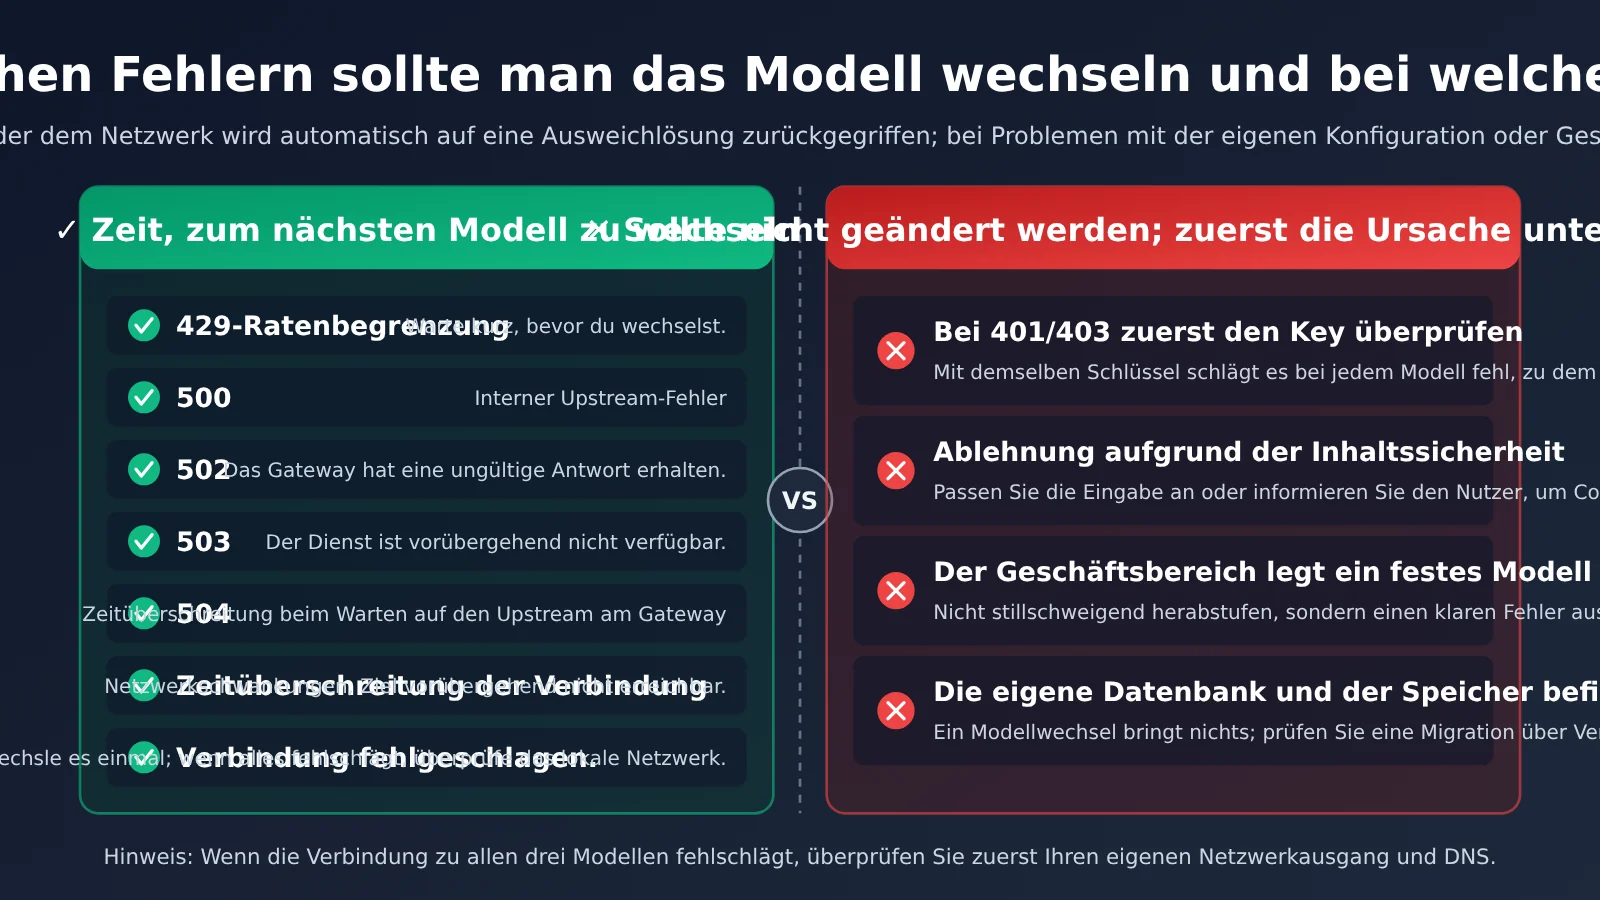
Wie sollten die Einstellungen für die Ausweichkette aussehen?
Zu wissen, dass bei einem Fehler gewechselt wird, reicht nicht. Ein zu schneller oder zu langsamer Wechsel kann ebenfalls Probleme verursachen. Die folgenden Punkte werden besonders häufig gefragt. Pauschale Antworten gibt es nicht – passen Sie die Einstellungen an Ihren Anwendungsfall an.
| Einstellung | Empfehlung | Warum? |
|---|---|---|
| Wie oft dasselbe Modell erneut versuchen? | Höchstens einmal; schlägt es erneut fehl, zum nächsten wechseln | Wenn beim Anbieter eine Störung vorliegt, sorgt ein weiterer Versuch mit demselben Modell oft nur für eine zusätzliche Warteschleife |
| Wie lange auf eine einzelne Anfrage warten? | Bei Chats kürzer, bei langen Texten länger | Dauert es zu lange, schließen Nutzerinnen und Nutzer vielleicht die Seite, bevor der Wechsel greift |
| Was tun bei 429? | Ein oder zwei Sekunden warten und dann wechseln | Eine Drosselung kann durch eine kurze Lastspitze entstehen und sich schnell wieder legen |
| Wie lange darf die gesamte Kette höchstens dauern? | Die Wartezeiten aller drei Stufen zusammen sollten die akzeptable Wartezeit der Nutzer nicht überschreiten | So bleibt eine Anfrage nicht dauerhaft hängen, wenn alle drei Stufen langsam sind |
| Welche Protokolleinträge sind wichtig? | Bei jeder Anfrage festhalten, welche Stufe erfolgreich war oder fehlgeschlagen ist und welcher Fehlercode zurückkam | So lässt sich im Nachhinein erkennen, welcher Anbieter Probleme hatte und ob die Reihenfolge angepasst werden sollte |
| Wann sollte jemand benachrichtigt werden? | Wenn der Anteil der Aufrufe über die Ersatzstufe plötzlich steigt | Wenn die Ausweichlösung greift, merken es weder die Nutzer noch möglicherweise das Team. Jemand muss wissen, wenn das primäre Modell Probleme hat |
Der letzte Punkt wird besonders leicht übersehen. Je besser die Ausweichlösung funktioniert, desto unauffälliger bleibt ein Problem mit dem primären Modell. Wenn niemand die Protokolle prüft, kann das primäre Modell schon einen ganzen Tag ausgefallen sein, während alle denken, es sei alles in Ordnung – und auf der Rechnung tauchen trotzdem zahlreiche Aufrufe des Ersatzmodells auf.
Für einen Modellwechsel brauchen Sie keinen neuen API-Schlüssel
Bei einer Ausweichlösung schrecken viele vor zu großem Aufwand zurück. Für jedes Modell ein eigenes Konto beantragen, die Adresse ändern und das Anfrageformat anpassen – damit warten die meisten Teams, bis der nächste Ausfall sie dazu zwingt.
Bei APIYI verwenden Sie dieselbe Adresse https://api.apiyi.com/v1/chat/completions und denselben API-Schlüssel. Im Anfragekörper ändern Sie nur den Wert von model. Als Hauptmodell dient claude-opus-5-5. Fällt es aus, wechseln Sie zu claude-sonnet-5-5 und, falls auch dieses Modell ausfällt, zu gemini-4-argon. Die ersten beiden Modelle stammen vom selben Anbieter, das dritte von einem anderen. Gibt es bei einem Anbieter einen größeren Ausfall, bleibt so eine Alternative. Der Anpassungsaufwand ist gering: Im Anwendungscode ergänzen Sie lediglich eine geordnete Liste mit Modellnamen. Anfrageformat, Authentifizierung und Antwortstruktur bleiben unverändert – auch das Testen ist dadurch unkompliziert.
| Reihenfolge | Modellname | Eingabepreis | Ausgabepreis | Rolle |
|---|---|---|---|---|
| 1 | claude-opus-5-5 | 4 | 20 | Hauptmodell |
| 2 | claude-sonnet-5-5 | 2 | 10 | Erste Ausweichoption, günstigeres Modell desselben Anbieters |
| 3 | gemini-4-argon | 2 | 10 | Zweite Ausweichoption, anderer Anbieter |
| Optional | gpt-6-astra | 10 | 50 | Teurere Ausweichoption, nur über die OpenAI-Schnittstelle |
| Optional | deepseek-v4.1-flash | 0.30 | 1.20 | Günstige Ausweichoption |
Die Preise in der Tabelle sind in US-Dollar pro einer Million Tokens angegeben. Sie basieren auf der Preisseite vom 21.10.2026 und einem Multiplikator von 1. Preise können sich ändern. Maßgeblich sind die Angaben auf der Preisseite von api.apiyi.com.
In drei Schritten eine Ausweichlösung einrichten
Schritt 1: API-Schlüssel erstellen. Registrieren Sie sich auf api.apiyi.com und erstellen Sie einen API-Schlüssel. Die Abrechnung erfolgt nutzungsbasiert, der Dienst ist innerhalb Chinas direkt erreichbar und Sie benötigen keine ausländische Kreditkarte. Mit diesem einen API-Schlüssel können Sie alle Modelle aus der Tabelle aufrufen.
Schritt 2: Jedes Modell einzeln testen. Tragen Sie als Schnittstellenadresse https://api.apiyi.com/v1 ein. Die Schnittstelle ist mit dem OpenAI-Format kompatibel. Wenn Sie bisher die offizielle OpenAI-Bibliothek verwendet haben, können Sie Ihren Code mit einer geänderten Adresse und einem neuen API-Schlüssel weiterverwenden. Testen Sie mit derselben Eingabeaufforderung nacheinander claude-opus-5-5, claude-sonnet-5-5 und gemini-4-argon. Prüfen Sie, ob alle Modelle ordnungsgemäß antworten und das erwartete Format liefern.
Schritt 3: Reihenfolge festlegen und den Ausfall durchspielen. Tragen Sie die drei Modellnamen in der gewünschten Reihenfolge in die Konfiguration ein. Legen Sie anhand der Regeln aus dem vorherigen Abschnitt fest, wann gewechselt werden soll. Gehen Sie nach der Einrichtung nicht sofort live: Setzen Sie zunächst die Wartezeit für das Hauptmodell vorübergehend sehr niedrig und lösen Sie absichtlich einen Timeout aus. Prüfen Sie, ob die Anfrage beim zweiten Modell landet und ob der Wechsel im Protokoll erfasst wird. Erst wenn dieser Test bestanden ist, ist die Ausweichlösung wirklich einsatzbereit. Details zu den Parametern finden Sie in der Integrationsdokumentation unter docs.apiyi.com.
Die Reihenfolge passend zum Anwendungsfall festlegen
Die hier vorgeschlagene Reihenfolge priorisiert die Qualität, ist aber nicht die einzig sinnvolle. Je nach Anwendungsfall kann auch ein anderes Modell an erster Stelle stehen.
| Anwendungsfall | Empfohlene Reihenfolge | Begründung |
|---|---|---|
| Programmieren und komplexe Schlussfolgerungen | claude-opus-5-5 → claude-sonnet-5-5 → gemini-4-argon | Qualität hat Vorrang – das ist die Standardreihenfolge in diesem Artikel |
| Kundenservice und alltägliche Gespräche | claude-sonnet-5-5 → gemini-4-argon → deepseek-v4.1-flash | Bei vielen Aufrufen und hoher Preissensibilität muss das Hauptmodell nicht das teuerste sein |
| Übersetzungen und Zusammenfassungen in großen Mengen | deepseek-v4.1-flash → gemini-4-argon → claude-sonnet-5-5 | Bei vielen Aufrufen steht das günstige Modell an erster Stelle. Bei einem Ausfall wird der Reihe nach zu einem leistungsfähigeren Modell gewechselt |
| Ausgaben mit strengen Formatvorgaben | Zuerst zwei Modelle desselben Anbieters, danach ein Modell eines anderen Anbieters | Der Stil der Modelle eines Anbieters ist oft ähnlicher. Dadurch fällt der Wechsel weniger stark aus |
Für die Reihenfolge gelten zwei einfache Grundsätze: Das letzte Modell sollte möglichst von einem anderen Anbieter stammen, und der Preis sollte zum Wert des jeweiligen Vorgangs passen. Das Beispiel mit den Übersetzungen in großen Mengen zeigt auch den praktischen Nutzen der Ausweichlösung: Wäre das an erster Stelle stehende DeepSeek-Modell am 15. Oktober ausgefallen, wären die Anfragen automatisch zu den beiden anderen Anbietern gewechselt. Der Auftrag wäre trotzdem abgeschlossen worden.
Wichtig ist: Ein Modellwechsel sorgt dafür, dass der Schritt „Modell aufrufen“ weiterläuft. Einen Stromausfall im Rechenzentrum kann er nicht beheben.
Anbieter können ausfallen – richten Sie vorher eine Alternative ein
Ein öffentlich dokumentiertes Beispiel ist die offizielle DeepSeek-Unterbrechung vom 15.10.2026: Damals wechselte APIYI auf den voll leistungsfähigen Kanal von Volcano Engine. Der Modellname musste nicht geändert werden, und der Produktionsbetrieb lief wieder normal. Die Quelle finden Sie unter docs.apiyi.com im Bereich „Live-Updates“.
Anbieter können ausfallen – das ist niemandes Schuld. Eine Alternative im Voraus einzurichten ist hilfreicher, als stundenlang abzuwarten. Im Alltag kostet das fast nichts und bindet kaum Arbeitszeit, solange es vor dem Ausfall erledigt wird. Danach bleibt nur, unter Zeitdruck Änderungen vorzunehmen.
Wo Sie am Tag eines Ausfalls zuerst nachsehen sollten
Wenn plötzlich viele Anfragen fehlschlagen, ändern Sie nicht sofort den Code. Nehmen Sie sich zwei Minuten Zeit und prüfen Sie drei Stellen: Erstens Google Cloud Service Health, um festzustellen, ob ein Problem auf Rechenzentrumsebene vorliegt. Zweitens die offizielle Statusseite des jeweiligen Modellanbieters – in diesem Fall die Statusseite von DeepSeek. Drittens die aktuellen Meldungen unter docs.apiyi.com. Änderungen an den Upstream-Routen von APIYI werden dort bekannt gegeben.
Zeigen alle drei Stellen keine Störung an, suchen Sie anschließend bei sich selbst: Ist der API-Schlüssel abgelaufen? Ist genug Guthaben vorhanden? Gibt es Probleme mit dem Netzwerkausgang oder DNS? Wenn Sie in umgekehrter Reihenfolge vorgehen, suchen Sie womöglich lange im eigenen Code, obwohl die Ursache beim Anbieter liegt.
Vier Dinge, die Sie heute erledigen können
- Listen Sie alle Stellen auf, an denen Ihre Anwendung Modelle aufruft, und prüfen Sie, welche davon nur einen Anbieter nutzen.
- Ergänzen Sie für jede Stelle, die nur einen Anbieter nutzt, mindestens ein Ausweichmodell eines anderen Anbieters.
- Wechseln Sie wie oben beschrieben nur bei Statuscodes 429 und 5xx sowie bei Timeouts, und protokollieren Sie jeden Wechsel.
- Lösen Sie absichtlich einmal einen Timeout beim Hauptmodell aus und prüfen Sie, ob die Anfrage tatsächlich beim Ausweichmodell landet.
Wenn Sie diese vier Punkte erledigt haben, wird Ihre Anwendung beim nächsten Stromausfall im Rechenzentrum oder Ausfall eines Modellanbieters höchstens ein paar Sekunden langsamer sein – statt einen halben Tag stillzustehen.
Häufige Fragen
F1: Sollte ich London nach dem Stromausfall bei Google Cloud sofort verlassen?
Nicht unbedingt. Die offizielle Empfehlung lautet „falls möglich“ – sie fordert also nicht alle dazu auf, sofort umzuziehen. Teams mit Workloads in europe-west2-b können einen Wechsel in eine andere Zone oder Region prüfen. Teams, die lediglich Modell-APIs aufrufen, müssen nicht umziehen. Für sie ist es sinnvoller, zuerst eine Ausweichlösung für die Modelle einzurichten.
F2: Wird der Modellwechsel teurer?
Mit der oben genannten Reihenfolge wird es sogar günstiger. Das Hauptmodell claude-opus-5-5 kostet 4 für Eingaben und 20 für Ausgaben; beide Ausweichmodelle kosten 2 für Eingaben und 10 für Ausgaben. Die Kosten steigen nur, wenn Sie ein Modell wie gpt-6-astra mit Preisen von 10 für Eingaben und 50 für Ausgaben in die Liste der Ausweichmodelle aufnehmen.
F3: Kann ich diese Modelle mit einem einzigen API-Schlüssel aufrufen?
Ja. Alle genannten Modelle verwenden dieselbe OpenAI-kompatible Adresse und denselben API-Schlüssel. Sie ändern lediglich `model`. Beachten Sie, dass gpt-6-astra nur über die OpenAI-Schnittstelle verfügbar ist.
F4: Wird die Antwortqualität beim Wechsel zu einem Ausweichmodell schlechter?
Es kann Unterschiede geben – vor allem beim Wechsel vom leistungsfähigsten Modell zu einer günstigeren Variante. Für die meisten Anwendungen ist eine etwas langsamere und leicht schlechtere Antwort aber besser als eine Fehlermeldung. Wenn das Ausgabeformat besonders wichtig ist, legen Sie es in der System-Eingabeaufforderung verbindlich fest. Vergleichen Sie die Ausgaben mehrerer Modelle außerdem vorab wie in Schritt 2 beschrieben. Dann wissen Sie, was Sie erwartet, bevor Sie live gehen.
F5: Entstehen zusätzliche Kosten, wenn ich ein Ausweichmodell bereithalte, obwohl es keine Ausfälle gibt?
Nein. Bei der nutzungsbasierten Abrechnung zahlen Sie nur für tatsächlich gesendete Anfragen. Wenn das Hauptmodell erfolgreich antwortet, wird das Ausweichmodell nicht aufgerufen und verursacht keine Kosten. Tatsächlich anfallen können lediglich der Zeitaufwand für die Einrichtung und die Kosten für einige Testanfragen während des Probelaufs.
Die wichtigsten Punkte im Überblick
- Zwei Ausfälle: Stromausfall in Google Cloud europe-west2-b über 7 Stunden und 52 Minuten; offiziell dokumentierter Ausfall bei DeepSeek über 4 Stunden und 52 Minuten.
- Was die Fakten aussagen: Nicht ganz Europa war betroffen, und die Modelle selbst wurden dadurch nicht abgeschaltet. DeepSeek hat die Ursache nicht offiziell bekannt gegeben.
- Wann gewechselt werden sollte: Nur bei 429, 500, 502, 503, 504 und Timeouts wechseln – nicht bei 401, 403 oder einer Ablehnung durch den Inhaltsfilter.
- Vorgehen: Die Ausweichlösung sollte möglichst nicht vom selben Anbieter stammen. Dieselbe Adresse und derselbe API-Schlüssel genügen – ändern Sie nur
model. - Test: Lösen Sie nach der Einrichtung absichtlich einmal einen Timeout beim Hauptmodell aus. Prüfen Sie, ob die Anfrage beim Ausweichmodell landet und der Wechsel protokolliert wird.
Eine Rückerstattung gleicht die Rechnung aus, aber sie holt keine ausgefallene Arbeit zurück. Legen Sie die Modellreihenfolge im Voraus fest. Beim nächsten Problem auf Anbieterseite merken Ihre Nutzer dann höchstens, dass die Anwendung ein paar Sekunden langsamer ist.
Quellen
- Google Cloud Service Health: Vorfall mit mehreren Diensten in europe-west2 (Xs2XTHzAVC9YnafnPyzj), 20.10.2026
- Google Cloud Service Health: Vorfall mit Google SecOps und Sicherheitsprodukten in europe-west2 (separat erfasst), 20.10.2026
- BBC: Bericht über die Auswirkungen der Google-Cloud-Störung auf britische Banken und öffentliche Dienste, 20.10.2026
- Offizielle DeepSeek-Statusseite: dokumentierter Dienstausfall vom 15.10.2026
- Offizielle Dokumentation: aktuelle Meldungen unter docs.apiyi.com
Autor: Technisches Team von APIYI
Technischer Austausch: Wenn Sie bei der Einrichtung einer Modellausweichlösung auf Probleme stoßen, freuen wir uns über Ihre Fragen und Anmerkungen im Kommentarbereich.