Nota del autor: analizamos los cuatro componentes de un agente de monitoreo y resumen programado, explicamos cómo desacoplar la capa de invocación del modelo de un SDK concreto mediante una interfaz compatible con OpenAI y ofrecemos un ejemplo funcional en Python.
OpenRouter publicó recientemente un tutorial en el que usa @openrouter/agent 0.11.0 para crear en TypeScript un agente de IA que se ejecuta de forma programada, monitorea Hacker News y genera resúmenes automáticamente. Es un caso de uso muy representativo: muchos equipos quieren algo parecido para recopilar cada mañana noticias del sector, novedades de la competencia o publicaciones populares de comunidades tecnológicas. Tomando ese ejemplo como punto de partida, presentamos una arquitectura general para un agente de monitoreo y resumen que no depende de un SDK específico.
Esto no es una repetición de aquel tutorial. El tutorial original solo publicó información resumida, así que no especularemos sobre su implementación concreta. Aquí nos centramos en una pregunta más general: qué componentes necesita un agente de monitoreo y resumen, y cómo diseñar la capa de invocación del modelo para poder cambiar de modelo y proveedor en cualquier momento.
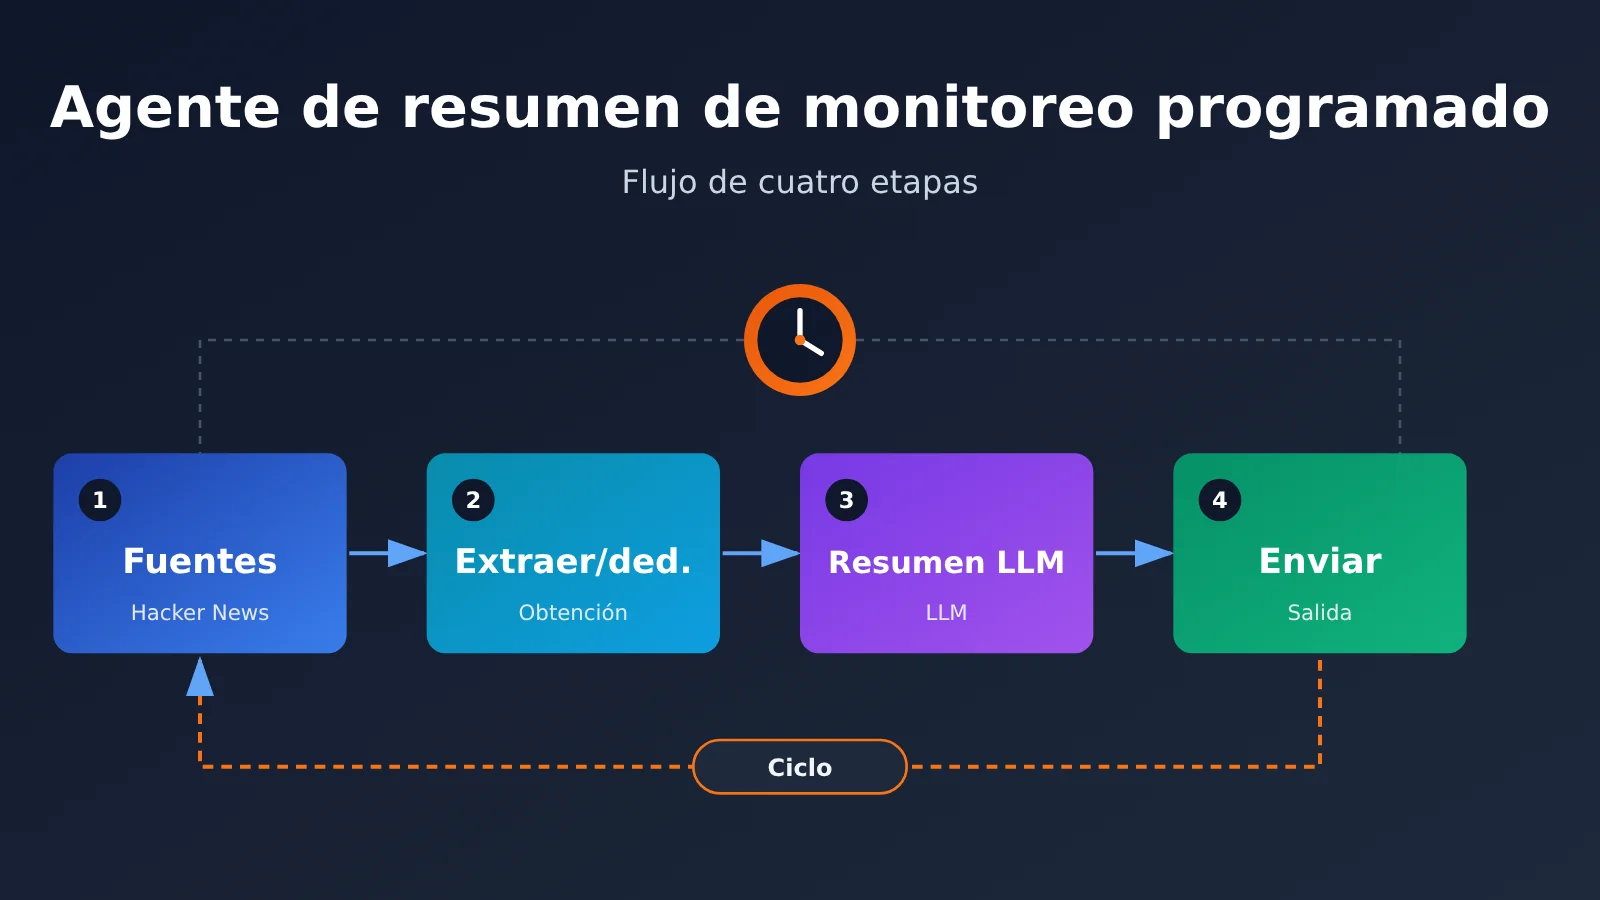
En resumen: al terminar, conocerás una estructura de cuatro etapas —activación programada, obtención de datos, resumen con el modelo y entrega de resultados— y tendrás una implementación en Python basada en una interfaz compatible con OpenAI que podrás adaptar directamente.
Puntos clave de un agente de monitorización y resumen
Esta tabla resume las conclusiones del artículo. En las siguientes secciones veremos cada punto en detalle.
| Punto clave | Descripción | Ventaja |
|---|---|---|
| Estructura en cuatro etapas | Activación programada → Obtención de datos → Resumen con el modelo → Entrega del resultado | Cada etapa se puede sustituir y probar por separado |
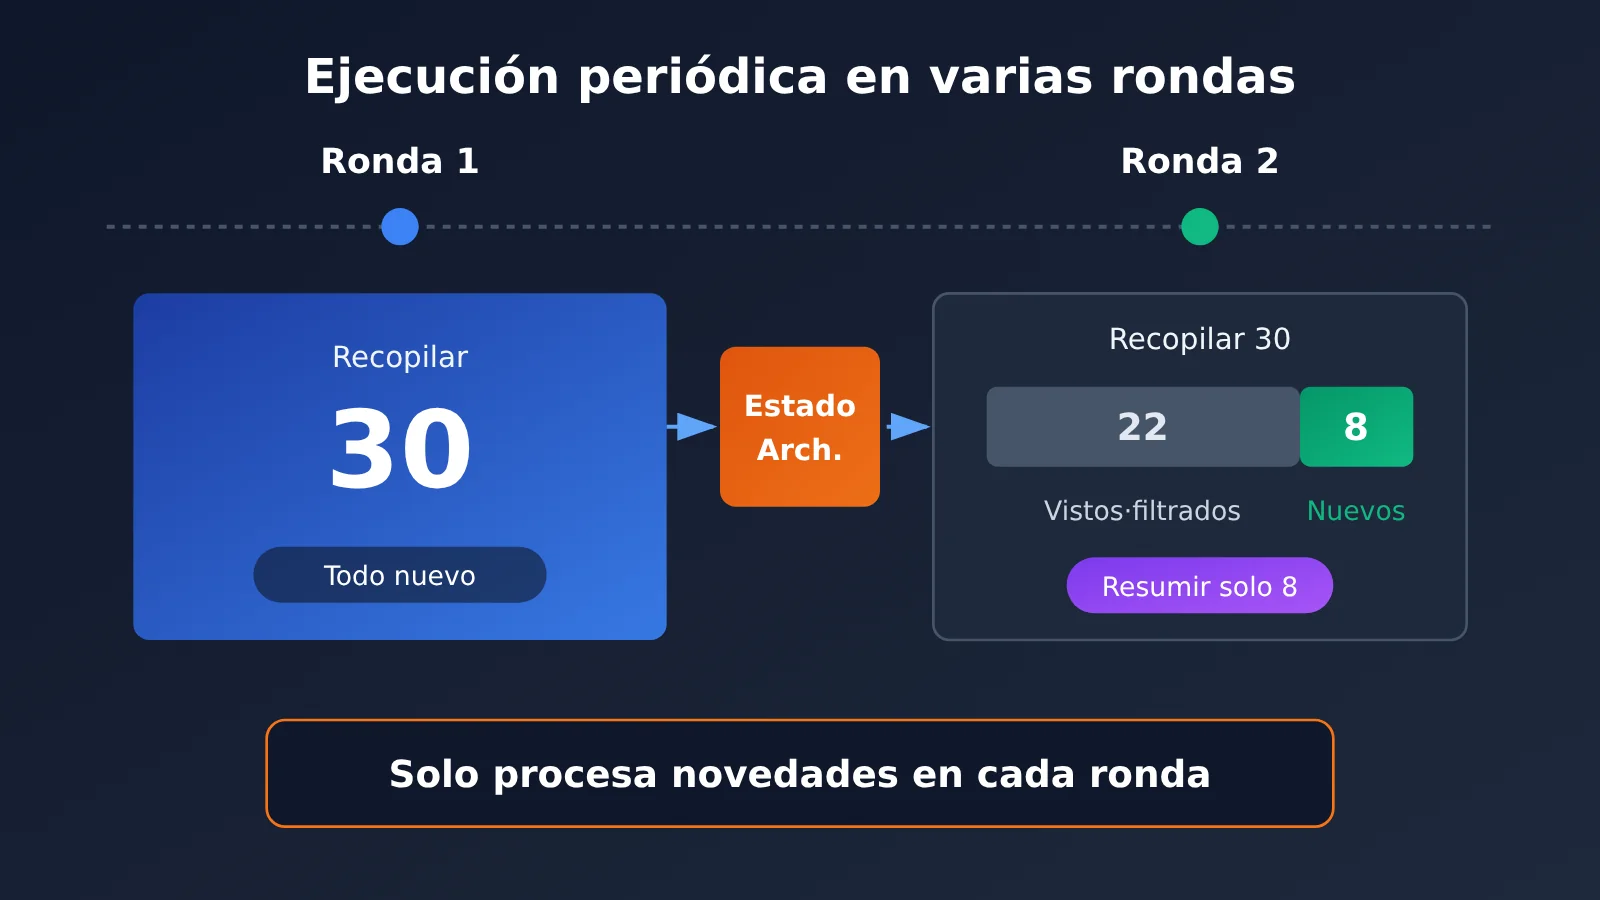
| Gestión del estado | Registra los elementos ya procesados para evitar resúmenes duplicados | Reduce las invocaciones y genera resultados más limpios |
| Capa de invocación del modelo desacoplada | La lógica de negocio depende solo de una interfaz de resumen, no directamente del SDK de un proveedor | Para cambiar de modelo o proveedor basta con modificar la configuración |
| Protocolo compatible con OpenAI | Usa el formato unificado de Chat Completions como base de la capa de invocación | Cuenta con un ecosistema consolidado y permite conectar modelos de distintos proveedores |
| Elegir el modelo según la tarea | Para resumir, importan la longitud del contexto, el seguimiento de instrucciones, la estabilidad y el costo | Evita pagar de más por tareas sencillas |
Los cuatro componentes de un agente de monitorización y resumen
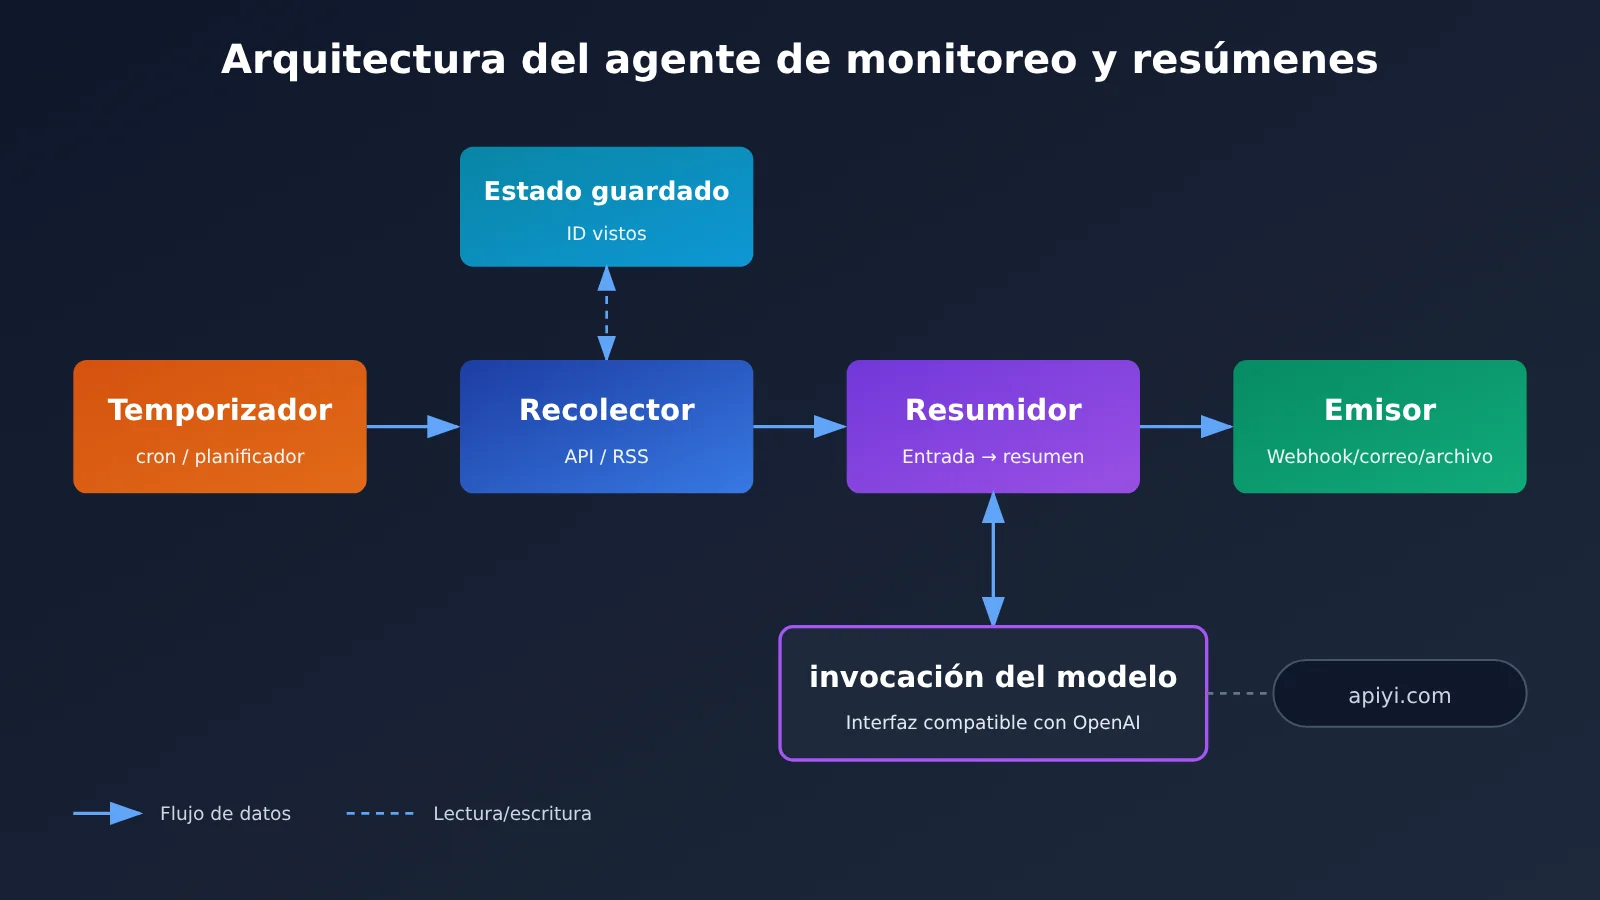
Un «agente permanente» es, en esencia, un flujo de trabajo que un temporizador activa periódicamente. No necesita razonamientos complejos de varios pasos, pero sí una gran estabilidad, porque nadie estará pendiente de su ejecución. Dividirlo en cuatro componentes con responsabilidades claras es el primer paso para que funcione de forma estable a largo plazo.
| Componente | Responsabilidad | Implementaciones habituales | Claves de diseño |
|---|---|---|---|
| Activador programado | Activa la tarea a intervalos fijos | cron, temporizador de systemd, temporizador de funciones en la nube, flujo de trabajo programado de CI, biblioteca de planificación dentro del proceso | Separar la activación de la lógica de negocio y permitir reintentos si falla |
| Recolector de datos | Obtiene contenido nuevo de las fuentes | API públicas, RSS, extracción de páginas web | Establecer tiempos de espera, limitar el número de elementos y registrar los ID ya vistos |
| Resumidor | Invoca un Modelo de Lenguaje Grande para generar el resumen | Interfaz de Chat Completions | Recortar la entrada, fijar la indicación y restringir el formato de salida |
| Módulo de salida | Envía el resultado a un lugar donde las personas puedan verlo | Correo electrónico, webhook de un bot de mensajería, archivo Markdown, base de datos | Si falla el envío, contar con una alternativa, como guardar el resultado en disco |
Estos cuatro componentes solo intercambian estructuras de datos sencillas: el recolector entrega una «lista de elementos», el resumidor produce un «texto resumido» y el módulo de salida se encarga de procesar ese texto. Así es más fácil localizar los problemas: si la calidad del resumen es baja, solo hay que ajustar el resumidor; si falla el envío, basta con revisar el módulo de salida.
En la primera versión, muchas personas meten toda la lógica en un solo script. Funciona, pero es difícil de mantener. En cuanto quieren sustituir Hacker News por GitHub Trending o cambiar de proveedor de modelos, tienen que modificar buena parte del código. Al separar los componentes, ampliar las fuentes de información solo requiere añadir un recolector, mientras que en la capa del modelo basta con cambiar la configuración.
Cómo elegir la activación programada del agente de resúmenes de monitoreo
La activación programada es lo que permite que el agente funcione de forma continua. En el tutorial de OpenRouter se implementa como un proceso permanente, pero en la práctica tienes varias opciones. La elección depende de la infraestructura que ya tengas.
| Método de activación | Forma de ejecución | Ventajas | Aspectos a tener en cuenta |
|---|---|---|---|
| Cron del sistema | Inicia un proceso nuevo cada vez y lo cierra al terminar | Simple y fiable; el proceso no permanece activo y no acumula fugas de memoria | Hay que guardar el estado en disco y configurar las variables de entorno por separado |
| Biblioteca de programación dentro del proceso | Proceso permanente que ejecuta tareas periódicamente | Facilita compartir conexiones y caché | Hay que supervisar el proceso por si falla, por ejemplo, con systemd o una política de reinicio del contenedor |
| Temporizador de funciones en la nube | Activación programada sin servidor | No requiere administrar servidores y se factura por invocación | Tiene un límite de duración y el estado debe guardarse externamente |
| Flujo de trabajo programado de CI | Se ejecuta según un calendario en la plataforma de CI | Sin costos de servidor y con registros consultables | La ejecución puede retrasarse; no es adecuado para tareas de alta frecuencia |
Para una tarea de resumen que se ejecuta cada hora o cada día, cron del sistema junto con un script que termina al completar el trabajo suele ser la opción más rentable. Evita de forma natural el crecimiento de memoria de un proceso permanente y, si falla, volverá a intentarlo en la siguiente ejecución. Un proceso permanente solo suele valer la pena si necesitas monitoreo frecuente, a intervalos de minutos, o compartir recursos pesados entre ejecuciones.
Cómo desacoplar la capa de invocación del modelo de un agente de resúmenes de monitoreo
Este es el tema central del artículo. El tutorial de OpenRouter usa su propio SDK, @openrouter/agent, que resulta cómodo para empezar rápidamente. Sin embargo, la información pública disponible no aclara si el SDK admite endpoints personalizados compatibles con OpenAI, y tampoco lo hemos verificado. Por eso, aquí no veremos cómo conectarlo a otras plataformas.
En su lugar, usaremos otro enfoque: evitar que el código de negocio dependa directamente del SDK de agente de un proveedor e insertar una «interfaz de resumen» ligera. El código de negocio solo llama a summarize(items); esta capa decide qué modelo y endpoint usar según la configuración.
Diseño de la interfaz de la capa de invocación
El diseño se basa en tres principios sencillos que pueden ahorrar mucho trabajo en el futuro:
- Exponer solo la lógica de negocio: ofrecer
summarize(items) -> strsin filtrar al código de negocio parámetros de bajo nivel comomessagesotemperature. - Unificar el protocolo interno: usar el formato Chat Completions compatible con OpenAI y leer
base_url,api_keyymodeldesde variables de entorno. - Contar con una alternativa ante fallos: si la invocación falla, reintentar un número limitado de veces y, si sigue fallando, mostrar la lista original de títulos para garantizar que ese día haya al menos un resultado legible.
Elegimos el protocolo compatible con OpenAI como base porque ya se ha convertido en un formato de uso general de facto, y tanto el SDK oficial como numerosas herramientas de terceros permiten modificar base_url. Si el servidor es compatible con este formato, cambiar de modelo se reduce a modificar una línea de configuración.
| Opción de interfaz | Coste de cambiar de modelo | Ecosistema y herramientas | Casos adecuados |
|---|---|---|---|
| Depender del SDK de agente de un proveedor | Cambiar de proveedor suele requerir cambios en el código | Funciones integradas del SDK listas para usar | Cuando ya se ha decidido usar la plataforma a largo plazo y se valoran sus funciones integradas |
| Usar directamente el SDK oficial de OpenAI + un endpoint compatible | Basta con cambiar base_url y model |
El ecosistema más consolidado, con más ejemplos | La mayoría de las tareas de resúmenes de monitoreo |
| Implementar llamadas HTTP propias | Basta con cambiar la configuración, pero hay que asumir el mantenimiento | Menos dependencias | Entornos donde importa especialmente reducir el tamaño de las dependencias |
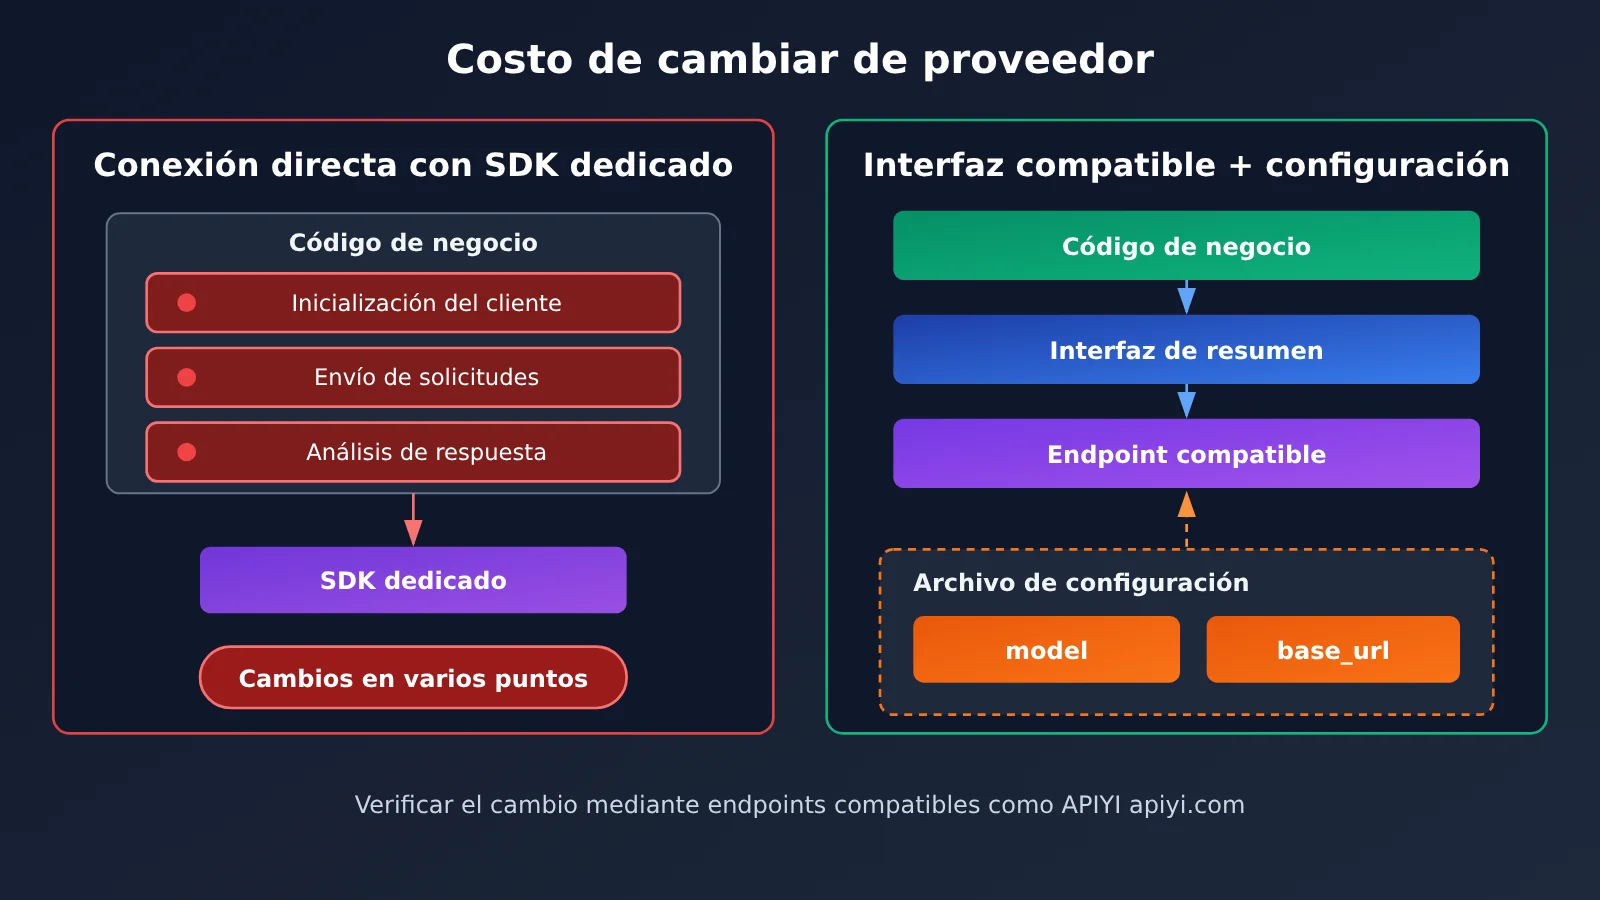
Con este diseño, una plataforma agregadora como APIYI puede ser una opción para la capa de invocación del modelo. APIYI es compatible con el formato de la API de OpenAI, admite la integración mediante el SDK oficial de OpenAI y permite cambiar de modelo modificando únicamente su nombre. Para un agente de resúmenes de monitoreo, esto significa que puedes comparar los resultados de distintos modelos con una misma clave, sin escribir una integración distinta para cada proveedor.
Qué tener en cuenta al elegir un modelo para resumir fuentes de información
Resumir parece una tarea sencilla, pero los requisitos del modelo varían mucho según la fuente. Por ahora no contamos con datos de pruebas sistemáticas para este tipo de tarea, así que no vamos a concluir qué modelo es «el mejor». En su lugar, repasamos los factores que conviene valorar.
| Factor | Por qué importa | Recomendación práctica |
|---|---|---|
| Longitud del contexto | Puede ser necesario enviar decenas de titulares o incluso textos completos en una sola llamada | Recorta primero la entrada y elige el modelo según la longitud resultante |
| Seguimiento de instrucciones | El resumen necesita un formato fijo para facilitar su envío y procesamiento | Ejecuta varias pruebas con la misma indicación y comprueba si el formato se mantiene estable |
| Capacidad lingüística | Las fuentes en inglés deben generar resúmenes en chino | Comprueba especialmente que la traducción de los términos técnicos sea precisa |
| Costo de las llamadas | Las tareas programadas se ejecutan durante mucho tiempo y los gastos se acumulan | Haz una sola llamada por ejecución y controla la cantidad de entradas y la longitud de la salida |
| Estabilidad del servicio | El proceso funciona sin supervisión y los fallos pueden pasar desapercibidos hasta el día siguiente | Configura reintentos y alternativas de respaldo, y ten disponible un modelo de reserva |
💡 Recomendación: No hay una respuesta universal para elegir un modelo de resumen. Lo más fiable es comparar varios durante unos días con tus fuentes reales. Puedes usar APIYI apiyi.com para cambiar entre varios modelos candidatos con el mismo código, comparar la estabilidad del formato y la calidad de la expresión en chino, y decidir cuál usar a largo plazo.
Primeros pasos con un agente de monitoreo y resumen
Vamos a implementar una versión mínima funcional en Python. Usaremos la API pública de Hacker News (hacker-news.firebaseio.com/v0) como fuente de información, igual que en el tutorial de OpenRouter, para facilitar la comparación.
Ejemplo mínimo: obtener y resumir noticias
El siguiente código obtiene los títulos de las 10 noticias más populares de Hacker News y le pide al modelo que genere un resumen en chino. Así podemos comprobar que todo el flujo funciona:
import requests
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI 兼容端点
)

HN = "https://hacker-news.firebaseio.com/v0"
ids = requests.get(f"{HN}/topstories.json", timeout=10).json()[:10]
titles = [requests.get(f"{HN}/item/{i}.json", timeout=10).json().get("title", "") for i in ids]

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 示例模型名,以平台模型列表为准
    messages=[{"role": "user", "content": "用中文分 3 点总结这些热帖的主题:\n" + "\n".join(titles)}]
)
print(resp.choices[0].message.content)
Este código funciona, pero todavía no puede ejecutarse de forma continua: no elimina duplicados, no gestiona errores y tanto el modelo como el endpoint están definidos directamente en el código. La versión completa de abajo separa los cuatro componentes y añade gestión del estado.
Ver el código de la implementación completa (cuatro componentes + eliminación de duplicados + alternativa de respaldo)
import json
import os
import time
from pathlib import Path

import openai
import requests

HN = "https://hacker-news.firebaseio.com/v0"
STATE_FILE = Path(os.getenv("STATE_FILE", "seen_ids.json"))
TOP_N = int(os.getenv("TOP_N", "30"))


# ---------- 数据获取器 ----------
def fetch_new_stories(seen: set) -> list:
    ids = requests.get(f"{HN}/topstories.json", timeout=10).json()[:TOP_N]
    items = []
    for i in ids:
        if i in seen:
            continue
        item = requests.get(f"{HN}/item/{i}.json", timeout=10).json() or {}
        if item.get("title"):
            items.append({"id": i, "title": item["title"],
                          "url": item.get("url", ""), "score": item.get("score", 0)})
    return items


# ---------- 状态管理 ----------
def load_seen() -> set:
    return set(json.loads(STATE_FILE.read_text())) if STATE_FILE.exists() else set()

def save_seen(seen: set) -> None:
    STATE_FILE.write_text(json.dumps(sorted(seen)[-2000:]))  # 只保留最近的 ID


# ---------- 摘要器(模型调用层) ----------
class Summarizer:
    def __init__(self):
        self.client = openai.OpenAI(
            api_key=os.environ["LLM_API_KEY"],
            base_url=os.getenv("LLM_BASE_URL", "https://api.apiyi.com/v1"),
        )
        self.model = os.getenv("SUMMARY_MODEL", "gpt-4o-mini")

    def summarize(self, items: list, retries: int = 2) -> str:
        lines = "\n".join(f"- [{x['score']}] {x['title']}" for x in items)
        prompt = ("你是技术资讯编辑。请用中文把下面的 Hacker News 新热帖归纳为 3-5 个主题,"
                  "每个主题一句话,并列出最值得关注的 3 条标题。\n" + lines)
        for attempt in range(retries + 1):
            try:
                resp = self.client.chat.completions.create(
                    model=self.model,
                    messages=[{"role": "user", "content": prompt}],
                    max_tokens=800,
                )
                return resp.choices[0].message.content
            except Exception as e:
                print(f"摘要失败(第 {attempt + 1} 次):{e}")
                time.sleep(2 ** attempt)
        return "【模型暂不可用,以下为原始标题】\n" + lines  # 降级输出


# ---------- 输出器 ----------
def deliver(text: str) -> None:
    webhook = os.getenv("WEBHOOK_URL")
    if webhook:
        try:
            requests.post(webhook, json={"text": text}, timeout=10).raise_for_status()
            return
        except Exception as e:
            print(f"推送失败,改为落盘:{e}")
    Path(f"digest-{time.strftime('%Y%m%d-%H%M')}.md").write_text(text, encoding="utf-8")


# ---------- 一次运行(由定时器触发) ----------
def run_once() -> None:
    seen = load_seen()
    items = fetch_new_stories(seen)
    if not items:
        print("没有新条目,本轮跳过")
        return
    deliver(Summarizer().summarize(items))
    save_seen(seen | {x["id"] for x in items})


if __name__ == "__main__":
    run_once()
La versión completa tiene algunas decisiones de diseño que vale la pena destacar. Primero, Summarizer solo expone summarize; el nombre del modelo, el endpoint y la clave API proceden de variables de entorno. Así se desacopla la capa de invocación, como vimos antes. Además, el archivo de estado solo conserva un lote de ID recientes para evitar que crezca indefinidamente. Por último, si falla el modelo, se entregan los títulos originales; si falla el envío, se guardan en disco. Así, cada ejecución deja un resultado que se puede consultar.
Programación del agente de resúmenes de monitorización
El script está diseñado para «ejecutarse una vez y terminar», así que se puede programar directamente con cron. La siguiente configuración lo ejecuta todos los días a las 8:00 y a las 20:00:
# crontab -e
0 8,20 * * * cd /opt/hn-digest && LLM_API_KEY=xxx SUMMARY_MODEL=gpt-4o-mini /usr/bin/python3 agent.py >> run.log 2>&1
Si quieres comparar otro modelo, solo tienes que cambiar SUMMARY_MODEL por su nombre, sin tocar una sola línea de código. En producción, conviene guardar la clave en un archivo .env o en un servicio de gestión de secretos, en lugar de escribirla directamente en crontab.
🚀 Consejo para empezar: comprueba primero que todo funciona con el ejemplo más sencillo y después pasa a la versión completa para integrarla con cron. APIYI apiyi.com ofrece crédito gratuito de prueba a los nuevos usuarios. Con una sola clave puedes cambiar entre modelos como OpenAI, Claude y Gemini, lo que facilita comparar rápidamente los resultados de los resúmenes durante la fase de prototipo.
Preguntas frecuentes
P1: ¿Qué es un agente de monitoreo y resumen programado?
Es un programa automatizado que se activa periódicamente: recopila el contenido nuevo de distintas fuentes según un horario, se lo entrega a un Modelo de Lenguaje Grande para generar un resumen y lo envía por correo, mensajería instantánea o a un archivo. A diferencia de un agente conversacional, funciona sin supervisión durante largos períodos, por lo que la estabilidad y la eliminación de duplicados son más importantes que el razonamiento complejo.
P2: ¿Qué diferencia hay entre usar un SDK de agente dedicado y una interfaz compatible con OpenAI?
Un SDK dedicado suele incluir funciones como la llamada a herramientas y la programación de tareas, lo que permite empezar más rápido, pero también vincula el código de la aplicación a esa plataforma. Una interfaz compatible con OpenAI es de más bajo nivel y requiere implementar la programación y la eliminación de duplicados, pero permite cambiar de modelo o proveedor modificando solo la configuración. Para tareas de resumen con una lógica sencilla, esta flexibilidad suele ser más valiosa.
P3: ¿Se puede adaptar directamente el tutorial de @openrouter/agent de OpenRouter para usar otra plataforma?
La información pública disponible solo indica que el tutorial utiliza `@openrouter/agent` 0.11.0 en TypeScript. No especifica si el SDK admite endpoints personalizados y tampoco lo hemos verificado. Si quieres conservar la flexibilidad de cambiar de plataforma, lo más seguro es tomar el tutorial como referencia para el caso de uso e implementar tu propia capa de invocación compatible con OpenAI, como la de este artículo.
P4: ¿Para qué casos concretos sirve un agente de monitoreo y resumen?
– **Resumen diario de publicaciones populares en comunidades tecnológicas**: por ejemplo, una recopilación diaria de temas de Hacker News y foros de tecnología.
– **Seguimiento de la competencia**: monitorear blogs o registros de cambios de competidores y generar resúmenes de sus novedades.
– **Novedades de proyectos de código abierto**: recopilar nuevas versiones e issues importantes de los repositorios que sigues.
– **Boletín matutino del sector**: reunir información de varias fuentes RSS y enviar cada mañana un resumen en chino.
P5: ¿Cómo puedo invocar rápidamente un modelo mediante una API para generar resúmenes?
Te recomendamos usar una plataforma agregadora compatible con el formato de OpenAI:
1. Visita APIYI apiyi.com, crea una cuenta y obtén una clave API y crédito gratuito de prueba.
2. Configura el `base_url` del código de este artículo como `https://api.apiyi.com/v1`.
3. Usa la variable de entorno `SUMMARY_MODEL` para cambiar de modelo y comparar la calidad de los resúmenes.
P6: ¿Cómo puedo controlar el costo de las llamadas durante un funcionamiento prolongado?
La idea principal es procesar solo el contenido nuevo y hacer una sola llamada al modelo en cada ejecución. Usa un archivo de estado para filtrar las entradas ya procesadas, limita el número de entradas y `max_tokens` en cada ejecución, y ajusta la frecuencia según tus necesidades. Los precios varían mucho entre modelos: puedes compararlos en la página de precios de modelos de APIYI apiyi.com y elegir uno más económico para tareas ligeras como los resúmenes.
P7: ¿Qué limitaciones conocidas tiene un agente de monitoreo y resumen?
– **Los títulos aportan información limitada**: resumir solo a partir de títulos puede llevar a interpretaciones erróneas. Si hace falta, puedes extraer el texto completo, teniendo en cuenta la longitud de la entrada y las normas aplicables a la extracción.
– **El modelo puede inventar detalles**: la indicación debe pedirle que resuma únicamente el contenido proporcionado. Conserva los enlaces originales para las conclusiones importantes.
– **Las fuentes pueden cambiar**: los cambios en el formato de una interfaz o en sus límites de uso pueden provocar fallos en la recopilación, por lo que conviene supervisar los registros de ejecución.
Puntos clave del agente de monitoreo y resumen
- Estructura en cuatro etapas: activación programada, obtención de datos, resumen con el modelo y entrega de resultados funcionan de forma independiente, lo que facilita sustituir componentes y detectar errores.
- Terminar y salir es más fiable: para tareas de resumen poco frecuentes, cron y un script de ejecución única dan menos problemas que un proceso permanente.
- El estado determina la calidad: registra los ID ya procesados y resume solo las novedades en cada ejecución para evitar repeticiones y gastos innecesarios.
- Desacopla la capa de invocación: la lógica de negocio solo depende de la interfaz
summarize; el modelo, el endpoint y la clave proceden de la configuración. - Usa un protocolo compatible como base: el formato compatible con OpenAI permite cambiar de modelo modificando una sola variable de entorno.
- Elige el modelo con pruebas reales: compara contexto, seguimiento de instrucciones, idioma, costo y estabilidad. En APIYI apiyi.com puedes cambiar de modelo y hacer pruebas con el mismo código.
- Prepara alternativas ante fallos: si falla el modelo, muestra los títulos originales; si falla el envío, guarda los resultados en disco.
Conclusión
Para crear un agente de monitoreo y resumen que se ejecute de forma programada, lo importante no es usar un framework complejo, sino definir bien la estructura:
- Separación de componentes: activación, obtención, resumen y salida se conectan mediante estructuras de datos sencillas, y cada etapa se puede probar por separado.
- Desacoplamiento de interfaces: una capa ligera de resumen aísla el SDK concreto, con el protocolo compatible con OpenAI como base.
- Estabilidad primero: la deduplicación, los reintentos y las alternativas ante fallos son esenciales para las tareas que se ejecutan sin supervisión.
El tutorial de Hacker News de OpenRouter ofrece un buen ejemplo de aplicación, mientras que la arquitectura general de este artículo permite trasladar la misma idea a cualquier fuente de información y modelo. Como siguiente paso, prueba primero el flujo completo con un ejemplo mínimo; después, intégralo con cron y déjalo funcionar durante varios días. Observa la calidad de los resúmenes antes de decidir qué modelo usar a largo plazo.
Puedes usar APIYI apiyi.com para validar los resultados rápidamente: con una sola clave API puedes cambiar entre varios modelos populares. Los nuevos usuarios también cuentan con crédito gratuito para comparar modelos durante la fase de prototipo.
📚 Referencias
- Resumen del tutorial de OpenRouter: cómo crear un agente de IA permanente que supervise Hacker News con Agent SDK
- Enlace:
aihot.news/items/upl3hjjdokqe13w3ieo9opr0v -
Descripción: el punto de partida de este artículo; presenta cómo crear en TypeScript un agente que se ejecuta periódicamente con
@openrouter/agent0.11.0 -
API oficial de Hacker News: interfaz pública de datos de solo lectura
- Enlace:
github.com/HackerNews/API -
Descripción: documentación de la fuente de datos del ejemplo, con información sobre los campos de endpoints como topstories e item
-
SDK de Python de OpenAI: biblioteca oficial de cliente
- Enlace:
github.com/openai/openai-python - Descripción: explica cómo conectarse a endpoints compatibles mediante el parámetro
base_url
Autor: equipo técnico de APIYI
Consultas técnicas: puedes contactarnos desde la página principal de APIYI. Encontrarás más información de integración en el centro de documentación docs.apiyi.com