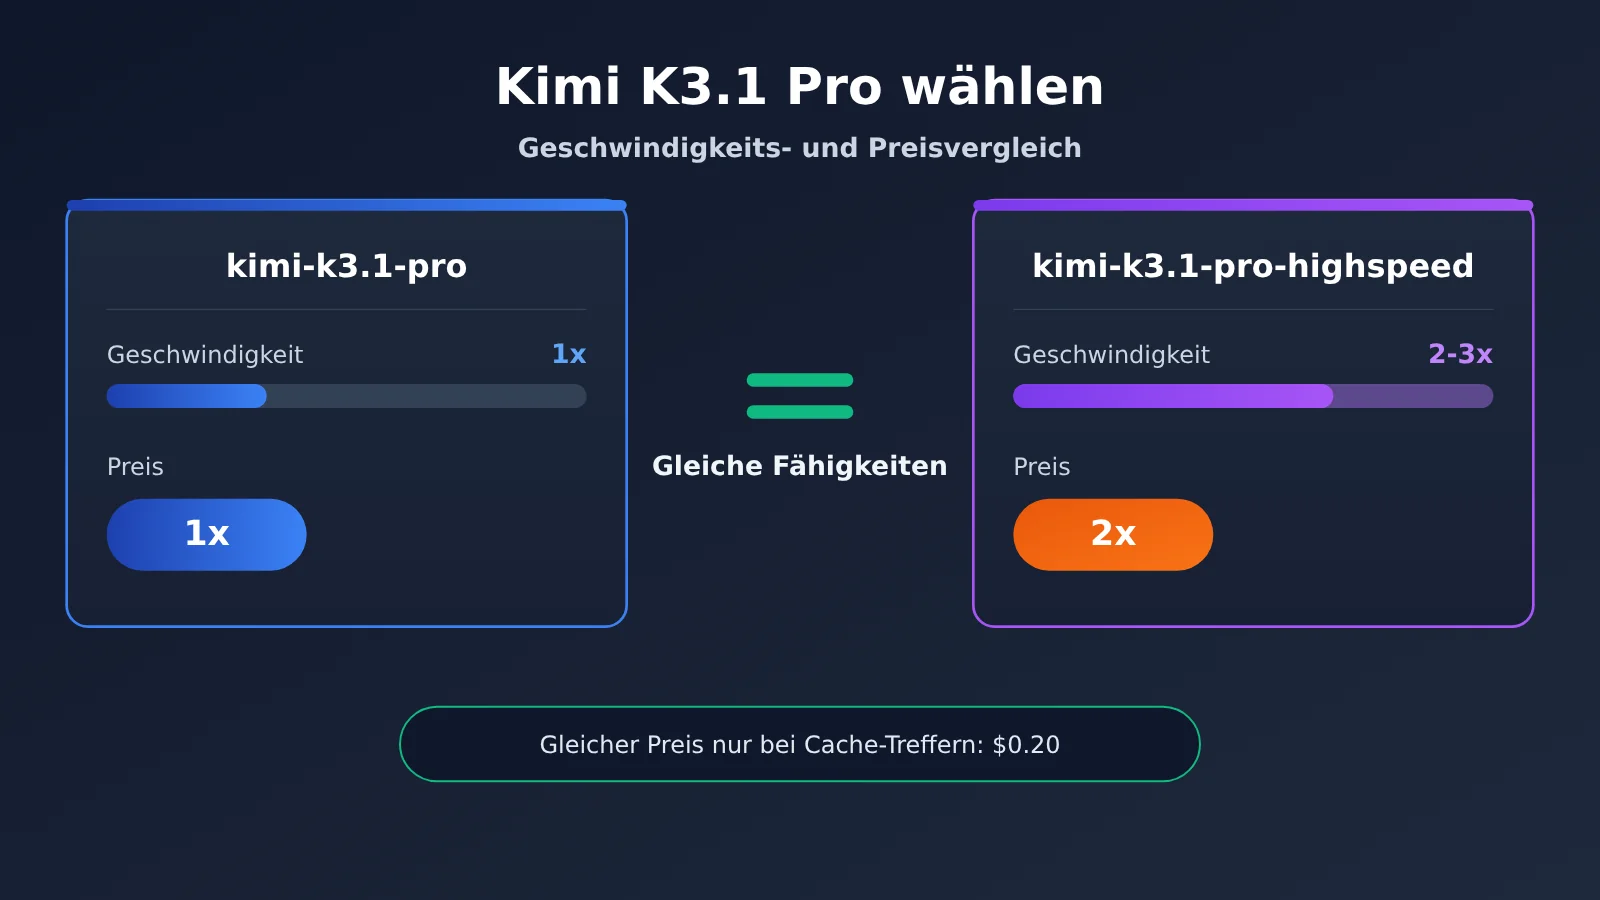
Kimi K3.1 Pro und die Highspeed-Version bieten dieselben Modellfähigkeiten. Der einzige zusätzliche Vorteil von Highspeed ist das Tempo: Laut offiziellen Angaben ist die Version zwei- bis dreimal schneller. Dafür sind die Preise fast durchgehend doppelt so hoch. Nur der Preis bei einem Cache-Treffer bleibt unverändert: Beide Versionen kosten 0,20 $. Wer vor dem Bildschirm auf ein Ergebnis wartet, ist mit Highspeed gut beraten. Für Aufgaben, die im Hintergrund in großer Zahl laufen, reicht die Standardversion.
Diese Schlussfolgerung stützt sich auf drei Quellen: Im offiziellen Blog von Moonshot steht, dass beide Modelle über „same capabilities“ verfügen. Die offizielle Preisseite führt fünf Einheitspreise auf, und in der offiziellen Kimi-Code-Dokumentation heißt es, Highspeed verbrauche etwa doppelt so viel Kontingent. Im Folgenden kennzeichne ich die Herkunft jeder Angabe als „offizielle Angaben“, „Drittquelle“ oder „nicht verifiziert“. Wo keine Daten vorliegen, sage ich das ausdrücklich, statt Schätzungen als Messergebnisse auszugeben.
In diesem Artikel geht es nicht darum, welches Modell intelligenter ist. Da beide Versionen dieselben Fähigkeiten haben, bleibt nur eine Frage für die Kostenrechnung: Lohnt es sich, doppelt so viel zu zahlen, um gleich gute Ergebnisse schneller zu erhalten?
Das erfahren Sie in diesem Artikel: eine Preistabelle mit fünf Tarifstufen, eine Methode, um Wartezeit in Geld umzurechnen, zwei Rechnungen, die Sie selbst überprüfen können, und eine Übersicht mit Empfehlungen für sechs verschiedene Anwendungsfälle.
1. Die wichtigsten Unterschiede zwischen Kimi K3.1 Pro und Highspeed: gleiche Fähigkeiten, nur Tempo und Preis unterscheiden sich
Zunächst der Überblick: Die folgende Tabelle zeigt alle vergleichbaren Merkmale der beiden Modelle. In der letzten Spalte ist jeweils angegeben, aus welcher Quelle die Information stammt. Mit Kontext ist die gesamte Textmenge gemeint, die ein Modell auf einmal „sehen“ kann. Sie wird in Tokens gemessen. Ein Token ist die grundlegende Einheit für Abrechnung und Berechnung – grob gesagt ein Wort- oder Wortbestandteil.
| Vergleichsmerkmal | kimi-k3.1-pro (Standardversion) | kimi-k3.1-pro-highspeed | Quellenbewertung |
|---|---|---|---|
| Modellfähigkeiten | Referenz | Wie die Standardversion | Offizielle Eigenangabe |
| Kontextlänge | 1.048.576 Tokens | 1.048.576 Tokens | Offizielle Eigenangabe |
| Generierungsgeschwindigkeit | Referenz | Laut Anbieter 2- bis 3-mal schneller | Offizielle Eigenangabe, keine detaillierten Messdaten |
| Preis | Referenz | Außer bei Cache-Treffern doppelt so hoch | Offizielle Preisangabe |
| Voraussetzungen für die Nutzung mit Kimi Code | Mitgliedschaft ab Plus (für 1M Kontext Pro oder höher erforderlich) | Mitgliedschaft ab Pro | Offizielle Dokumentation |
| Verbrauch des Kimi-Code-Kontingents | Referenz | Etwa doppelt so hoch | Offizielle Dokumentation |
| Offizielle Zugangskanäle | kimi.ai, Kimi Work, Kimi Code, Kimi API | Wie links | Offizieller Blog |
Die Tabelle zeigt im Grunde ganz einfach: Abgesehen von Geschwindigkeit, Preis und Mitgliedschaftsstufe gibt es keine Unterschiede zwischen den beiden Modellen. Mit der falschen Wahl verlierst du also nicht an „Qualität“, sondern nur Geld oder Zeit.
1.1 Preisvergleich zwischen Kimi K3.1 Pro und Highspeed (alle fünf Preiskategorien)
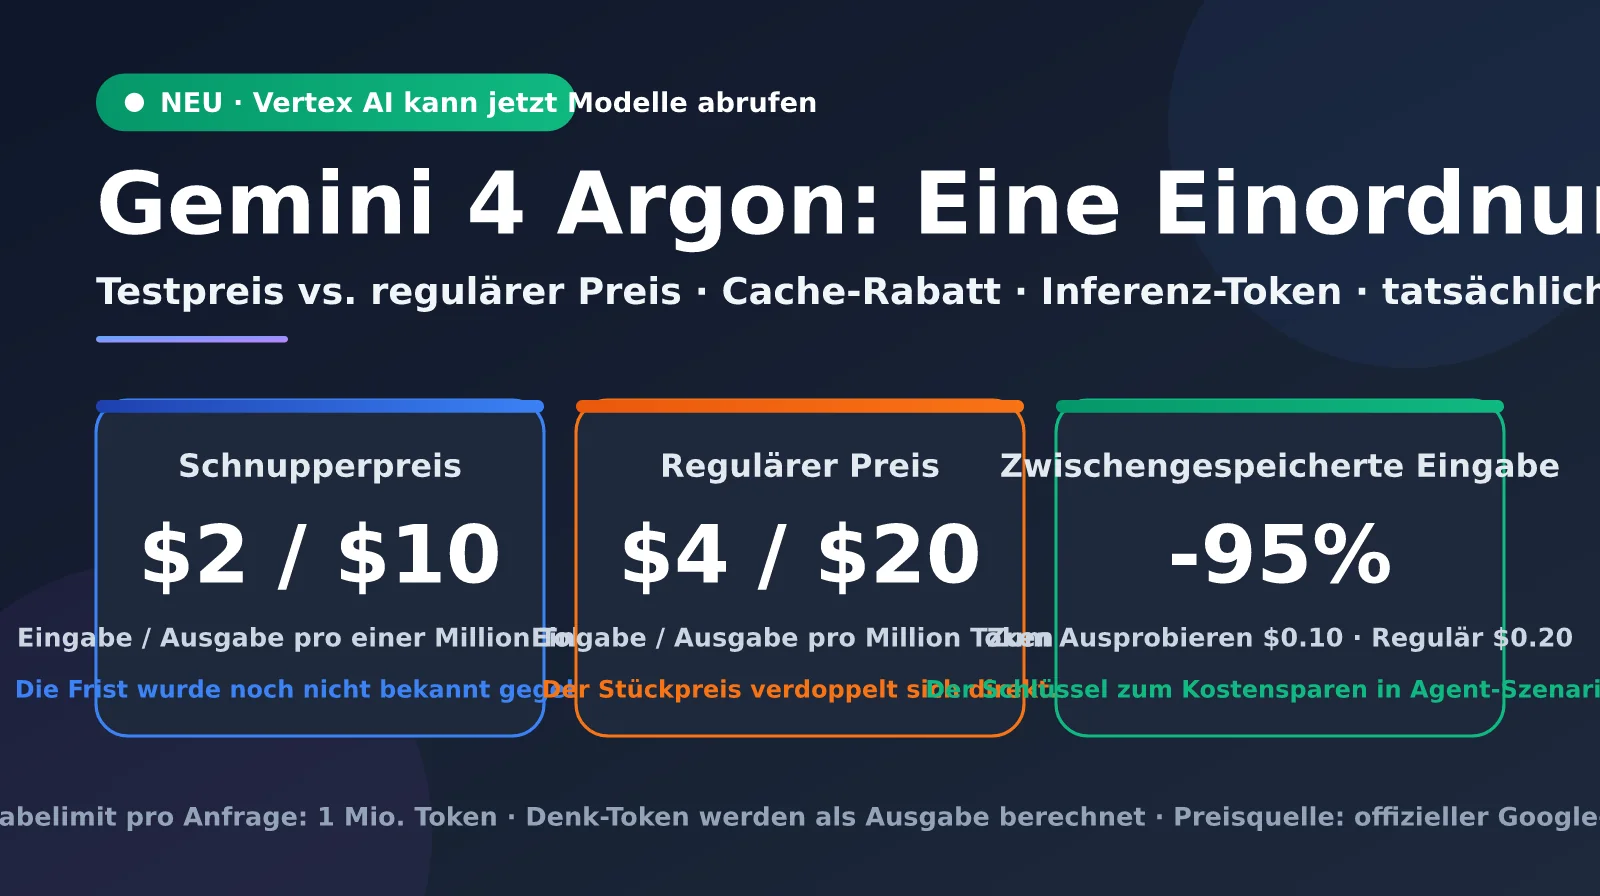
Die folgenden Preise wurden am 24.10.2026 abgerufen. Sie sind in US-Dollar pro Million Tokens angegeben und verstehen sich ohne Steuern. Die Quelle ist die offizielle Preisliste. Zunächst eine kurze Erklärung zu den Abrechnungsposten: „Eingabe“ bezeichnet den Inhalt, den du an das Modell sendest, „Ausgabe“ den Inhalt, den das Modell zurückgibt. „Cache“ bedeutet, dass die Plattform einen bestimmten Präfix – etwa wiederholt mitgesendeten Projektcode – zwischenspeichert. Taucht derselbe Präfix in einer späteren Anfrage erneut auf, kann er direkt wiederverwendet werden. Das ist ein „Cache-Treffer“ und wird günstiger abgerechnet. Für das erstmalige Speichern im Cache fällt eine Gebühr für das „Schreiben“ an. Dabei gibt es zwei Speicherfristen: 5 Minuten und 1 Stunde.
| Abrechnungsposten | kimi-k3.1-pro | kimi-k3.1-pro-highspeed | Faktor |
|---|---|---|---|
| Eingabe (Cache-Treffer) | $2.00 | $4.00 | 2-fach |
| Ausgabe | $10.00 | $20.00 | 2-fach |
| Eingabe bei Cache-Treffer | $0.20 | $0.20 | gleich, der einzige Preis ohne Aufschlag |
| Cache-Schreibvorgang (5 Minuten) | $2.00 | $4.00 | 2-fach |
| Cache-Schreibvorgang (1 Stunde) | $4.00 | $8.00 | 2-fach |
Auch die öffentlichen Aufzeichnungen des unabhängigen Entwicklers Simon Willison bestätigen das: Highspeed kostet doppelt so viel, aber die Eingabe bei einem Cache-Treffer wird genauso berechnet wie in der Standardversion. Dieses Detail spielt für die spätere Kostenrechnung eine Rolle. Wenn der Großteil deiner Eingaben Cache-Treffer sind, fällt der tatsächliche Gesamtpreis für Highspeed weniger als doppelt so hoch aus, denn der größte Eingabeposten wird nicht teurer.
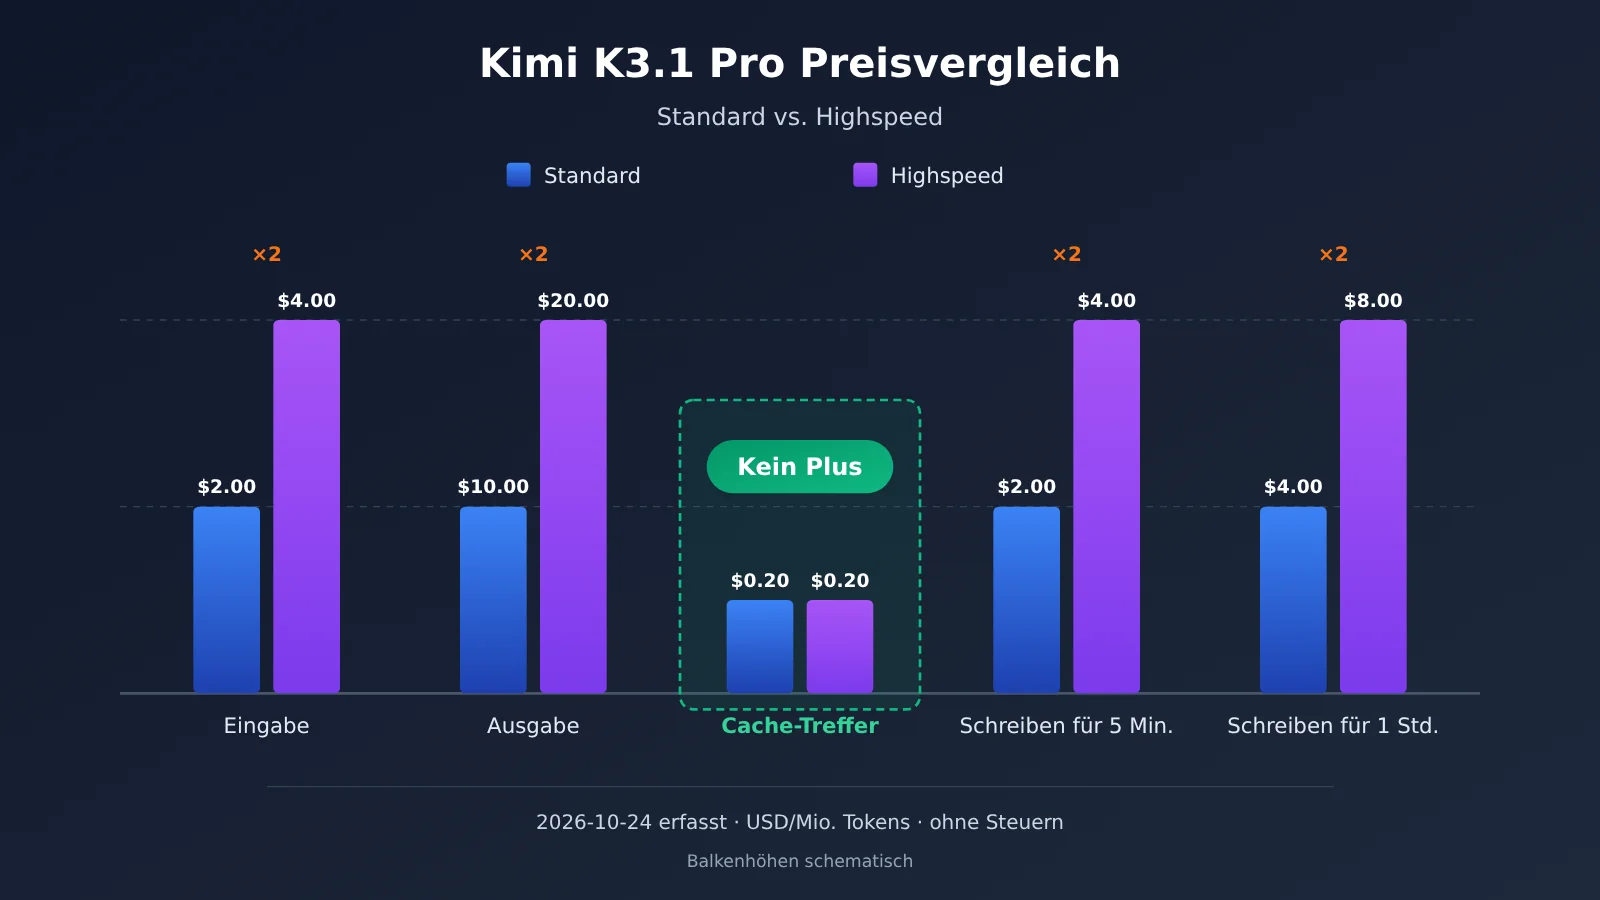
Preisangaben: Die Grafik und die Tabelle oben beruhen auf der offiziellen Preisliste. Wenn du die API über APIYI apiyi.com aufrufst, gelten die dort in der Modellliste angegebenen Modellnamen und Preise. Diese beiden Modelle werden derzeit noch integriert. Wir werden das Modell so bald wie möglich anbieten.
2. Wie groß ist der Geschwindigkeitsunterschied bei Kimi K3.1 Pro Highspeed?
Hier müssen wir ehrlich sein: Derzeit gibt es nur sehr wenige verlässliche Geschwindigkeitsdaten. Der Anbieter nennt lediglich einen Multiplikatorbereich. Drittanbieter haben nur die Standardversion getestet; öffentlich zugängliche Benchmarks zur konkreten Token-Ausgabe pro Sekunde von Highspeed gibt es nicht. Tokens pro Sekunde gibt an, wie viele Tokens ein Modell pro Sekunde ausgibt. Je höher der Wert, desto kürzer musst du warten, bis die Antwort fertig ist.
| Messwert | Wert | Einstufung der Quelle | Erläuterung |
|---|---|---|---|
| Relative Geschwindigkeit von Highspeed | 2- bis 3-mal so schnell wie die Standardversion | Eigene Angabe des Anbieters | Testbedingungen und detaillierte Daten wurden nicht veröffentlicht |
| Ausgabegeschwindigkeit der Standardversion | 80,7 Tokens/Sekunde | Drittanbieter (Artificial Analysis) | Entspricht Stufe 2 von 4 |
| Ausgabegeschwindigkeit von Highspeed | Keine Angabe | Nicht verifiziert | Drittanbieter haben Highspeed noch nicht separat getestet |
| Durchschnittliche Ausgabe pro Aufgabe bei der Standardversion | Ca. 55K Tokens | Drittanbieter (Artificial Analysis) | Bezieht sich auf die Testaufgaben des Intelligence Index |
| Kosten pro Aufgabe bei der Standardversion | Ca. $1.98 (auf der Modellseite werden $2.11 angezeigt) | Drittanbieter (Artificial Analysis) | Wie oben |
Auf die Frage „Wie viele Tokens pro Sekunde schafft Highspeed?“ gibt es derzeit also keine verlässliche Antwort. Artikel mit konkreten Zahlen beruhen entweder auf eigenen Tests – dabei solltest du die Testbedingungen prüfen – oder leiten den Wert ab, indem sie 80,7 mit 2 oder 3 multiplizieren. Wir nennen keine solche Zahl, sondern zeigen dir, wie du die Entscheidung ohne Benchmarkdaten treffen kannst.
2.1 So wählst du zwischen Kimi K3.1 Pro: Wartezeit in Geld umrechnen
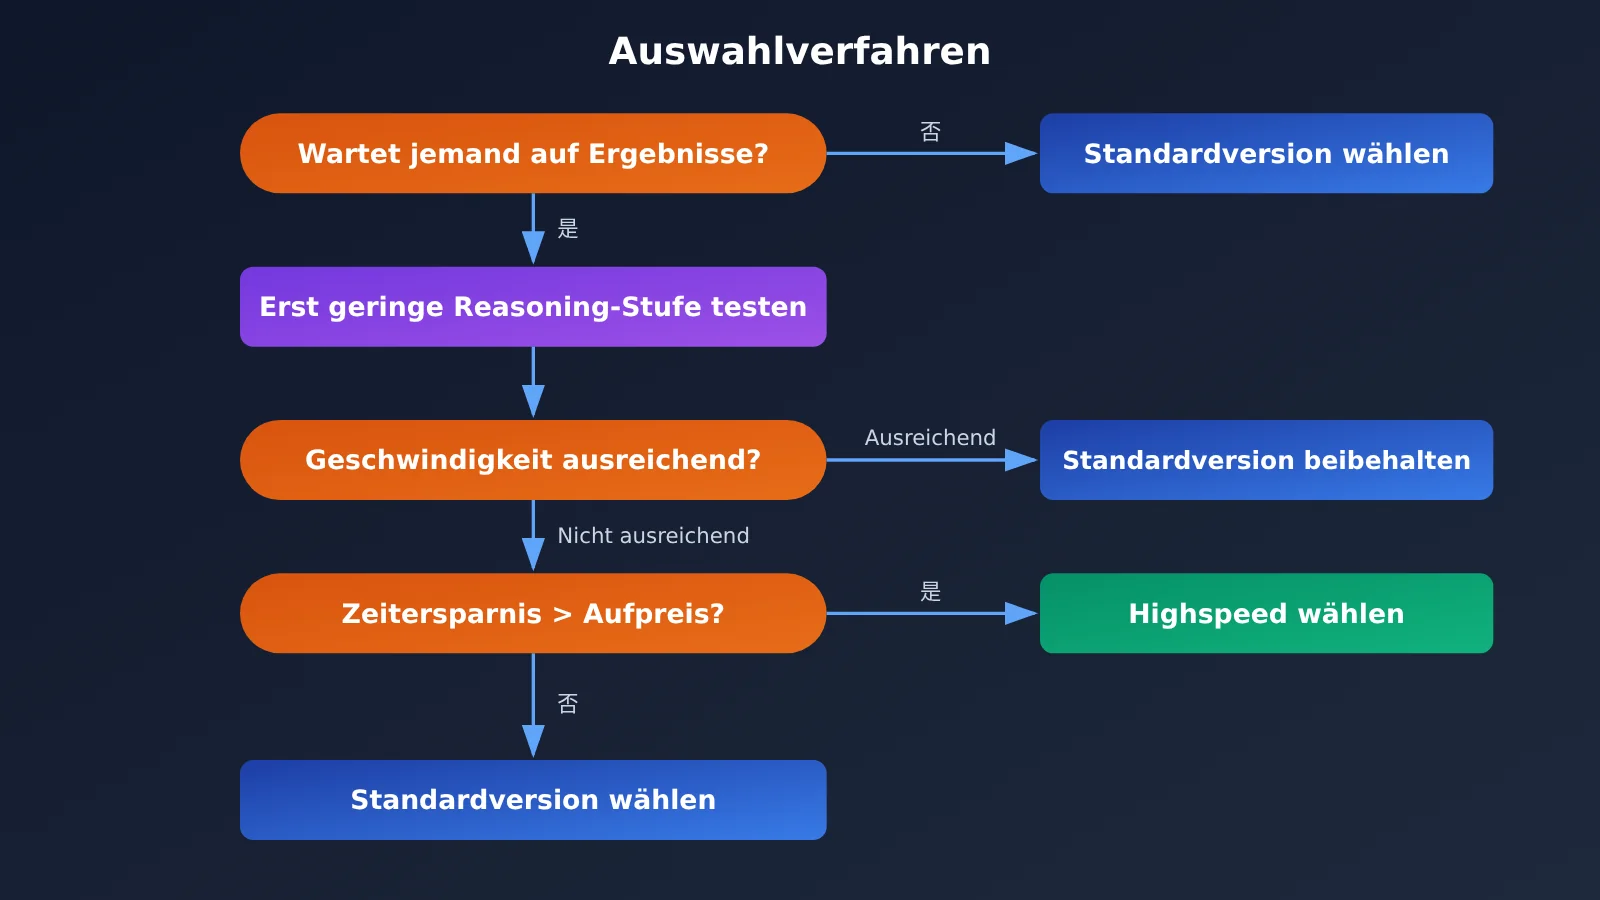
Geschwindigkeit an sich ist nichts wert. Entscheidend ist, wie viel Wartezeit dadurch eingespart wird. Wenn niemand auf das Ergebnis wartet, spielt es keine Rolle, wie schnell es kommt. Die Entscheidung lässt sich in vier Schritten treffen:
- Wartezeit pro Anfrage abschätzen: Ausgegebene Tokens ÷ Geschwindigkeit. Bei der Standardversion mit 80,7 Tokens/Sekunde dauert die Ausgabe von 1.500 Tokens beispielsweise etwa 19 Sekunden. Beachte, dass bei beiden Modellen das Denkverfahren stets aktiviert ist und ebenfalls Zeit benötigt. Die tatsächliche Wartezeit fällt daher länger aus und hängt von der jeweiligen Aufgabe ab.
- Einsparung durch Highspeed abschätzen: Ausgehend von den offiziellen Angaben – 2- bis 3-mal so schnell – dauert die Ausgabe derselben Menge etwa 6 bis 10 Sekunden. Das spart pro Anfrage ungefähr 10 Sekunden. Dies ist eine Schätzung, kein Messergebnis. Überprüfe sie mit deinen eigenen Anfragen.
- Mit der Anzahl der Anfragen und dem Stundensatz verrechnen: Bei 100 Interaktionen pro Tag und 10 Sekunden Ersparnis pro Anfrage kommen rund 17 Minuten zusammen. Multipliziere diese 17 Minuten mit den Zeitkosten für dich oder dein Team.
- Mit den Mehrkosten vergleichen: Berechne anhand der Methode aus Abschnitt 3, wie viel mehr Highspeed pro Tag kostet. Wenn der Wert der eingesparten Zeit höher ist als die Mehrkosten, lohnt sich Highspeed.
Ein häufiger Denkfehler, den du vermeiden solltest: Dreimal so schnell bedeutet nicht, dass du dreimal so produktiv bist. Die Modellausgabe ist nur ein Teil des Arbeitsablaufs. Die Zeit, die du zum Lesen des Codes, Nachdenken, Überarbeiten und Ausführen von Tests brauchst, wird dadurch nicht kürzer. Gespart wird nur die Wartezeit auf das Modell. Verwende daher in Schritt 3 unbedingt die tatsächliche Wartezeit und rechne den Produktivitätsgewinn nicht einfach anhand des Geschwindigkeitsmultiplikators hoch.
3. Kimi K3.1 Pro und Highspeed: zwei Kostenrechnungen
Die folgenden beiden Rechnungen basieren auf den offiziellen Preisen. Alle Rechenschritte sind angegeben, damit du die Zahlen mit deinem eigenen Tokenverbrauch nachrechnen kannst.
3.1 Szenario A: 20 interaktive Codeänderungen
Annahmen: Jede Anfrage umfasst 30.000 Tokens Eingabe, davon 25.000 Tokens wiederholt verwendeten Repository-Kontext und 5.000 Tokens neue Inhalte. Die Ausgabe umfasst jeweils 1.500 Tokens. Es gibt 20 aufeinanderfolgende Anfragen mit jeweils weniger als 5 Minuten Abstand, sodass der Cache durchgehend gültig bleibt.
Standardversion:
- Erste Anfrage: Eingabe
30000 × $2 / 100万 = $0.06. Dabei werden 25.000 Tokens in den Cache geschrieben; dieser Teil wird mit25000 × $2 / 100万 = $0.05berechnet. - Bei jedem weiteren Cache-Treffer:
25000 × $0.2 / 100万 = $0.005 - Neue Inhalte pro Anfrage:
5000 × $2 / 100万 = $0.01 - Ausgabe pro Anfrage:
1500 × $10 / 100万 = $0.015 - Gesamtkosten pro Anfrage:
$0.005 + $0.01 + $0.015 = $0.03
Highspeed:
- Der Preis für Cache-Treffer bleibt unverändert bei
$0.005. - Neue Inhalte kosten doppelt so viel:
5000 × $4 / 100万 = $0.02 - Die Ausgabe kostet ebenfalls doppelt so viel:
1500 × $20 / 100万 = $0.03 - Gesamtkosten pro Anfrage:
$0.005 + $0.02 + $0.03 = $0.055, also etwa $0.06
Mit den einmaligen Kosten für das erstmalige Befüllen des Caches belaufen sich die Gesamtkosten für 20 Anfragen auf etwa $0.66 bei der Standardversion und etwa $1.26 bei Highspeed. Vergleicht man die Kosten pro Anfrage genau, ist Highspeed etwa 1,8-mal so teuer wie die Standardversion – also weniger als doppelt so teuer. Der Grund: Der Preis für Cache-Treffer steigt nicht.
Fazit: Highspeed kostet etwa doppelt so viel, kann die Wartezeit laut offiziellen Angaben aber um mehr als die Hälfte verkürzen. Für die zusätzlichen rund $0.60 sparst du über 20 Anfragen hinweg einige Minuten Wartezeit. Für die meisten Entwickler dürfte sich das lohnen.
3.2 Szenario B: 1.000 Anfragen in der Offline-Massenverarbeitung
Annahmen: Jede Anfrage umfasst 8.000 Tokens Eingabe und 600 Tokens Ausgabe. Insgesamt werden 1.000 Anfragen verarbeitet. Zwischen den Anfragen gibt es keine wiederverwendbaren Präfixe, der Cache kommt also nicht zum Einsatz.
- Kosten pro Anfrage mit der Standardversion:
(8000 × $2 + 600 × $10) / 100万 = $0.016 + $0.006 = $0.022; für 1.000 Anfragen sind das$22. - Kosten pro Anfrage mit Highspeed:
(8000 × $4 + 600 × $20) / 100万 = $0.032 + $0.012 = $0.044; für 1.000 Anfragen sind das$44.
Fazit: Das lohnt sich nicht. Niemand wartet auf jedes einzelne Ergebnis. Die Gesamtzeit für die Verarbeitung hängt meist von der Anzahl gleichzeitiger Anfragen und der Warteschlange ab. Die zusätzlichen $22 bringen keinen spürbaren Vorteil.
| Kostenpunkt | Szenario A: Interaktive Codeänderungen | Szenario B: Offline-Massenverarbeitung |
|---|---|---|
| Anzahl der Anfragen | 20 | 1.000 |
| Cache-Treffer möglich | Ja, 25.000 Tokens werden wiederverwendet | Nein |
| Gesamtkosten der Standardversion | ca. $0.66 | $22 |
| Gesamtkosten mit Highspeed | ca. $1.26 | $44 |
| Tatsächlicher Preisfaktor | ca. 1,8–1,9-mal | 2-mal |
| Wartet jemand auf die Ergebnisse? | Ja | Nein |
| Fazit | Etwa doppelt so teuer, spart mehr als die Hälfte der Wartezeit – lohnt sich | Lohnt sich nicht, Standardversion wählen |
4. Kimi K3.1 Pro oder Highspeed – je nach Einsatzszenario
Wendet man die oben beschriebene Methode auf typische Szenarien an, ergibt sich direkt die folgende Tabelle. Entscheidend sind nur zwei Fragen: Wartet jemand auf das Ergebnis? Und lässt sich der Cache nutzen?
| Szenario | Empfehlung | Begründung |
|---|---|---|
| Interaktive Programmierung | Highspeed | Jemand wartet vor dem Bildschirm auf Änderungen. Der Kontext des Repositorys kann aus dem Cache abgerufen werden, sodass der tatsächliche Aufpreis weniger als das Doppelte beträgt. |
| Dialogbasierter Agent | Highspeed | Mehrere kurze Anfragen und Tool-Aufrufe folgen aufeinander. Die Wartezeit jeder Runde summiert sich zu einem deutlich spürbaren Unterschied. |
| Präsentationen und Livestreams | Highspeed | Das Publikum sieht zu. Langsame Antworten beeinträchtigen direkt den Ablauf. Der Kostenunterschied bei einigen Dutzend Aufrufen ist vernachlässigbar. |
| Stapelverarbeitung zur Datenbereinigung | Standardversion | Niemand wartet auf einzelne Ergebnisse. Die Geschwindigkeit bietet keinen zusätzlichen Nutzen, der doppelte Preis verursacht lediglich Mehrkosten. |
| Offline-Evaluierung | Standardversion | Bei der Evaluierung zählt nur die Ergebnisqualität. Beide Versionen bieten dieselben Fähigkeiten, und die Bewertung ändert sich nicht durch die Geschwindigkeit. |
| Geplante Aufgaben | Standardversion | Die Aufgaben laufen nachts oder im Hintergrund. Ob sie ein paar Minuten früher fertig sind, spielt keine Rolle. Die Kosten sind entscheidend. |
Wenn ein Produkt beide Arten von Szenarien abdeckt, können Sie die Modelle auch kombinieren: Anfragen für direkte Interaktionen mit Nutzern im Frontend laufen über kimi-k3.1-pro-highspeed, Zusammenfassungen, Archivierung und Stapelverarbeitung im Hintergrund über kimi-k3.1-pro. Beide Modelle bieten dieselben Fähigkeiten. Beim Wechsel des Modellnamens müssen Sie die Eingabeaufforderung nicht ändern.
5. Der dritte Hebel für mehr Tempo bei Kimi K3.1 Pro: reasoning_effort und das Kimi-Code-Kontingent
Bevor Sie mehr Geld ausgeben, sollten Sie eine kostenlose Möglichkeit zur Beschleunigung ausprobieren. Beide Modelle sind „Always-Thinking“-Modelle: Vor der Antwort führen sie zunächst interne Schlussfolgerungen durch. Wie lange dieser Prozess dauert, steuert der Parameter reasoning_effort. Er lässt sich als Maß dafür verstehen, wie tief das Modell nachdenken soll. Je niedriger die Stufe, desto kürzer die Denkzeit und desto schneller liegt das Ergebnis vor. Die folgenden Angaben stammen aus der offiziellen Dokumentation:
reasoning_effortunterstützt die drei Stufenlow,highundmax; standardmäßig istmaxeingestellt.- Wenn Sie eine höhere Geschwindigkeit möchten, können Sie zunächst bei der Standardversion
lowausprobieren. Reicht das Tempo aus und ist die Qualität akzeptabel, müssen Sie nicht den doppelten Preis für Highspeed zahlen. - Eine niedrigere Stufe kann die Denktiefe bei komplexen Aufgaben beeinträchtigen. Hier tauschen Sie also Qualität gegen Geschwindigkeit. Bei Highspeed dagegen zahlen Sie für mehr Tempo, ohne die Qualität zu verändern – die Nachteile sind unterschiedlich.
- Beide Optionen lassen sich auch kombinieren: Highspeed mit
loweignet sich für besonders latenzempfindliche Szenarien mit eher einfachen Aufgaben.
Ein weiterer leicht zu übersehender Punkt betrifft Kimi Code. Kimi Code ist das Programmierwerkzeug von Moonshot. Die Nutzung wird auf das Mitgliedschaftskontingent angerechnet. Laut der offiziellen Kimi-Code-Dokumentation gilt:
- Für
k3.1-proist mindestens eine Plus-Mitgliedschaft erforderlich. Für ein Kontextfenster von 1M ist mindestens Pro nötig. - Für
k3.1-pro-highspeedist mindestens eine Pro-Mitgliedschaft erforderlich. - Die Highspeed-Version verbraucht etwa das Doppelte des Kontingents. Bei gleichem Mitgliedschaftskontingent können Sie mit Highspeed ungefähr halb so viel erledigen.
Bei API-Aufrufen sollten Sie außerdem einige feste Parameter beachten. Laut offizieller Vorgabe müssen Sie diese in der Anfrage einfach weglassen und dürfen sie nicht manuell übergeben:
temperatureist fest auf1.0eingestellt.top_pist fest auf0.95eingestellt.nist fest auf1eingestellt.presence_penaltyundfrequency_penaltysind fest auf0eingestellt.max_completion_tokensbeträgt standardmäßig131072und maximal1048576.
6. Kimi K3.1 Pro einfacher nutzen – über APIYI anbinden
Die offizielle API unterstützt sowohl das OpenAI- als auch das Anthropic-Format, darunter die Schnittstellen Chat Completions, Responses und Messages. „OpenAI-kompatibel“ bedeutet: Der vorhandene Code mit dem OpenAI-SDK muss in der Regel nicht angepasst werden. Es genügt, die Adresse und den API-Schlüssel zu ändern und den Modellnamen anzupassen.
Entwickler in China können über APIYI (apiyi.com) mit einem einzigen API-Schlüssel auf mehrere Modelle zugreifen und nutzungsbasiert abrechnen. Für neue Nutzer gibt es ein kostenloses Testguthaben. Die Anbindung funktioniert so:
- OpenAI-Format:
base_urlaufhttps://api.apiyi.com/v1setzen - Anthropic-Format: Die Basisadresse auf
https://api.apiyi.comsetzen - Bei
modelden entsprechenden Modellnamen aus der Modellliste der Plattform eintragen
Wichtig: Bei der Überprüfung am 24.10.2026 waren in der Kimi-Modellliste von APIYI bereits Modelle wie kimi-k2.5, kimi-k2.6, kimi-k2.7-code und kimi-k3 verfügbar. kimi-k3.1-pro und kimi-k3.1-pro-highspeed waren dagegen noch nicht gelistet. Die Modellnamen und Preise auf der Plattform richten sich nach der dortigen Modellliste. Wir werden dieses Modell so bald wie möglich anbieten. Bis dahin können Sie mit einem der verfügbaren Kimi-Modelle bereits den Aufrufpfad und die Caching-Strategie testen. Sobald das Modell verfügbar ist, müssen Sie nur noch den Modellnamen ändern.
7. Entscheidungshilfe: Kimi K3.1 Pro oder Highspeed?
Empfehlung: Fragen Sie zuerst: „Wartet gerade jemand?“ Wenn nicht, nehmen Sie die Standardversion. Wenn doch, senken Sie zunächst
reasoning_effortauflowund testen Sie es erneut. Ist die Antwort immer noch zu langsam, wechseln Sie zu Highspeed. Ob sich das lohnt, können Sie mit der Methode aus Abschnitt 2 berechnen: Rechnen Sie die eingesparte Wartezeit in Geld um und vergleichen Sie den Betrag mit dem Preisunterschied aus Abschnitt 3. Testen Sie die Modelle am besten mit einigen Ihrer eigenen echten Anfragen über APIYI unter apiyi.com. Welche Modelle der K3.1-Pro-Serie verfügbar sind und was sie kosten, entnehmen Sie bitte der Modellliste auf der Plattform. Wir werden dieses Modell so bald wie möglich anbieten.
Einige Grundsätze, die Sie direkt umsetzen können:
- Nutzen Sie standardmäßig die Standardversion und schalten Sie Highspeed nur bei Bedarf ein, statt es als Voreinstellung zu verwenden.
- Je mehr Präfixe wiederverwendet werden, desto eher lohnt sich Highspeed, denn der Preis bei Cache-Treffern verdoppelt sich nicht.
- Verteilen Sie die Anfragen bei gemischter Nutzung im Team je nach Einstiegspunkt: Interaktive Anfragen laufen über Highspeed, Hintergrundaufgaben über die Standardversion.
- Berücksichtigen Sie bei der Nutzung von Highspeed in Kimi Code das Kontingent: Highspeed verbraucht ungefähr das Doppelte.
Häufig gestellte Fragen (FAQ)
F1: Was ist Kimi K3.1 Pro Highspeed?
Es ist die gemeinsam mit Kimi K3.1 Pro veröffentlichte Hochgeschwindigkeitsversion von Moonshot. Der Modellname lautet `kimi-k3.1-pro-highspeed`. Laut Hersteller ist sie zwei- bis dreimal so schnell wie K3.1 Pro. Die Modellfähigkeiten sind identisch, ebenso das Kontextfenster mit 1.048.576 Tokens.
F2: Ist die Highspeed-Version schlechter oder besser als die Standardversion?
Laut Hersteller sind die Fähigkeiten beider Versionen identisch. Es gilt also weder „schneller bedeutet weniger intelligent“ noch „teurer bedeutet intelligenter“. Die Antwortqualität wird vor allem durch die Einstellung von `reasoning_effort` beeinflusst, nicht durch die Wahl der Version.
F3: Wie viel schneller ist die Highspeed-Version genau? Gibt es konkrete Angaben in Tokens pro Sekunde?
Der Hersteller nennt lediglich einen Bereich von „zwei- bis dreimal so schnell“ und hat keine detaillierten Messwerte veröffentlicht. Der Drittanbieter Artificial Analysis hat für die Standardversion eine Ausgabegeschwindigkeit von 80,7 Tokens pro Sekunde gemessen, die Highspeed-Version jedoch nicht separat getestet. Konkrete Werte für Highspeed sind derzeit nicht verifiziert. Am besten messen Sie die Geschwindigkeit mit eigenen Anfragen.
F4: Warum ist die Highspeed-Version in der Praxis nicht unbedingt genau doppelt so teuer?
Weil bei Treffern im Eingabecache für beide Versionen derselbe Preis gilt: 0,20 $ pro Million Tokens. Besteht eine Anfrage zu einem großen Teil aus wiederholten Präfixen, die vom Cache abgedeckt werden, fallen für diesen Anteil keine zusätzlichen Kosten an. Dadurch liegt das Preisverhältnis insgesamt unter dem Faktor zwei. Im Szenario A dieses Artikels kostet eine einzelne Anfrage etwa das 1,8-Fache der Standardversion.
F5: Wie kann ich Kimi K3.1 Pro und Highspeed in China aufrufen?
Sie können die offizielle Kimi-API nutzen oder die OpenAI-kompatible Schnittstelle von APIYI unter apiyi.com verwenden. Ändern Sie dazu `base_url` in `https://api.apiyi.com/v1`. Die Modellnamen und Preise der beiden Versionen bei APIYI entnehmen Sie bitte der Modellliste der Plattform. Die Integration ist noch in Arbeit; wir werden das Modell so bald wie möglich bereitstellen.
F6: Welche bekannten Einschränkungen gibt es bei der Kimi-K3.1-Pro-Reihe?
– Bei beiden Modellen ist die Denkfunktion immer aktiviert. Die Schlussfolgerungsfunktion lässt sich nicht vollständig abschalten; lediglich `reasoning_effort` kann angepasst werden.
– Parameter wie `temperature` und `top_p` sind fest eingestellt und müssen in der Anfrage weggelassen werden. Der Stil lässt sich daher nicht über Sampling-Parameter steuern.
– In Kimi Code ist für Highspeed eine Mitgliedschaft der Stufe Pro oder höher erforderlich. Außerdem wird etwa das Doppelte des Kontingents verbraucht.
– Laut Hersteller werden die vollständigen Gewichte bis zum 04.11.2026 veröffentlicht. Bislang sind sie noch nicht verfügbar.
Kimi K3.1 Pro oder Highspeed? Die wichtigsten Erkenntnisse
- Gleiche Fähigkeiten: Highspeed bietet mehr Tempo, aber keine besseren Antworten.
- Doppelter Preis: Eingabe, Ausgabe und beide Stufen beim Schreiben in den Cache kosten jeweils doppelt so viel. Nur der Preis für Cache-Treffer bleibt mit 0,20 $ gleich.
- Wenig Geschwindigkeitsdaten: Der Hersteller gibt lediglich an, dass Highspeed zwei- bis dreimal schneller ist. Eine Drittanbieter-Messung ermittelte für die Standardversion 80,7 Tokens pro Sekunde.
- Entscheidend ist die Wartezeit: Rechnen Sie die Wartezeit der Nutzer in Geld um und vergleichen Sie sie mit dem Aufpreis. Setzen Sie den Geschwindigkeitsfaktor nicht mit dem Effizienzgewinn gleich.
- Für interaktive Anwendungen: Highspeed: Die Highspeed-Version eignet sich für interaktives Programmieren, dialogbasierte Agents und Live-Demos.
- Für Stapelverarbeitung: Standard: Bei der Datenbereinigung in großen Mengen, Offline-Evaluierungen und zeitgesteuerten Aufgaben zahlen Sie für Highspeed einfach drauf.
- Erst Einstellungen anpassen, dann mehr bezahlen:
reasoning_effortauflowzu setzen, ist eine kostenlose Möglichkeit, die Verarbeitung zu beschleunigen.
Zusammenfassung
Bei der Wahl zwischen Kimi K3.1 Pro und Highspeed sind drei Punkte entscheidend:
- Beide Versionen bieten die gleichen Fähigkeiten: Die Wahl beeinflusst die Qualität der Antworten nicht. Unterschiede gibt es nur bei Geschwindigkeit, Preis und Zugangsvoraussetzungen.
- Der Aufpreis hat eine Ausnahme: Bei vier der fünf Preisstufen verdoppeln sich die Kosten. Der Preis für Cache-Treffer bleibt gleich. Je mehr Präfixe wiederverwendet werden, desto geringer fällt der tatsächliche Aufpreis für Highspeed aus.
- Highspeed lohnt sich nur, wenn jemand wartet: In interaktiven Szenarien zahlen Sie mit Highspeed ungefähr doppelt so viel und verkürzen dafür die Wartezeit um mehr als die Hälfte. Bei Stapelverarbeitung zahlen Sie lediglich mehr.
Für die praktische Anwendung empfehlen wir, zunächst mit der Standardversion und reasoning_effort=low einen Testlauf durchzuführen. Reicht die Geschwindigkeit dann noch nicht aus, wechseln Sie zu Highspeed und überprüfen Sie die Kosten anhand Ihrer eigenen Tokenzahl mit der Formel aus Abschnitt 3. Wenn Sie das Modell über APIYI (apiyi.com) anbinden, beachten Sie bitte die Modellliste der Plattform für die verfügbaren Modellnamen und Preise. Wir werden dieses Modell so bald wie möglich anbieten.
Referenzen
- Offizielle Kimi-Seite und Blog: Ankündigung zur Veröffentlichung von K3.1 Pro und Highspeed sowie Angaben zu Fähigkeiten und Verfügbarkeit
- Link:
kimi.ai -
Hinweis: Quelle der offiziellen Aussage „2- bis 3-mal schneller bei gleicher Leistung“
-
Artificial Analysis: Unabhängige Messungen von Modellgeschwindigkeit und Kosten
- Link:
artificialanalysis.ai -
Hinweis: Quelle der Daten zur Standardversion: 80,7 Tokens pro Sekunde, Ausgabemenge pro Aufgabe und Kosten
-
Blog von Simon Willison: Öffentliche Dokumentation eines Entwicklers
- Link:
simonwillison.net -
Hinweis: Bestätigung, dass Highspeed doppelt so viel kostet und der Preis bei Cache-Treffern dem der Standardversion entspricht
-
APIYI-Modellliste: Auf der Plattform verfügbare Modelle und Preise
- Link:
docs.apiyi.com/models - Hinweis: Abgleich der Verfügbarkeit der Kimi-Modelle auf der Plattform am 24.10.2026
Autor: Technisches Team von APIYI
Technischer Austausch: Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com. Die verfügbaren Modelle und Preise der Kimi-K3.1-Pro-Serie entnehmen Sie bitte der Modellliste der Plattform. Wir werden dieses Modell so bald wie möglich anbieten.