Anmerkung des Autors: Dieser Artikel analysiert die fünf Preisstufen, die Abrechnung für Cache-Treffer und die Rate-Limit-Stufen von Kimi K3.1 Pro anhand der offiziellen Preisliste, die am 24.10.2026 abgerufen wurde. Drei Beispiele zum Nachrechnen zeigen, was eine Anfrage tatsächlich kostet.
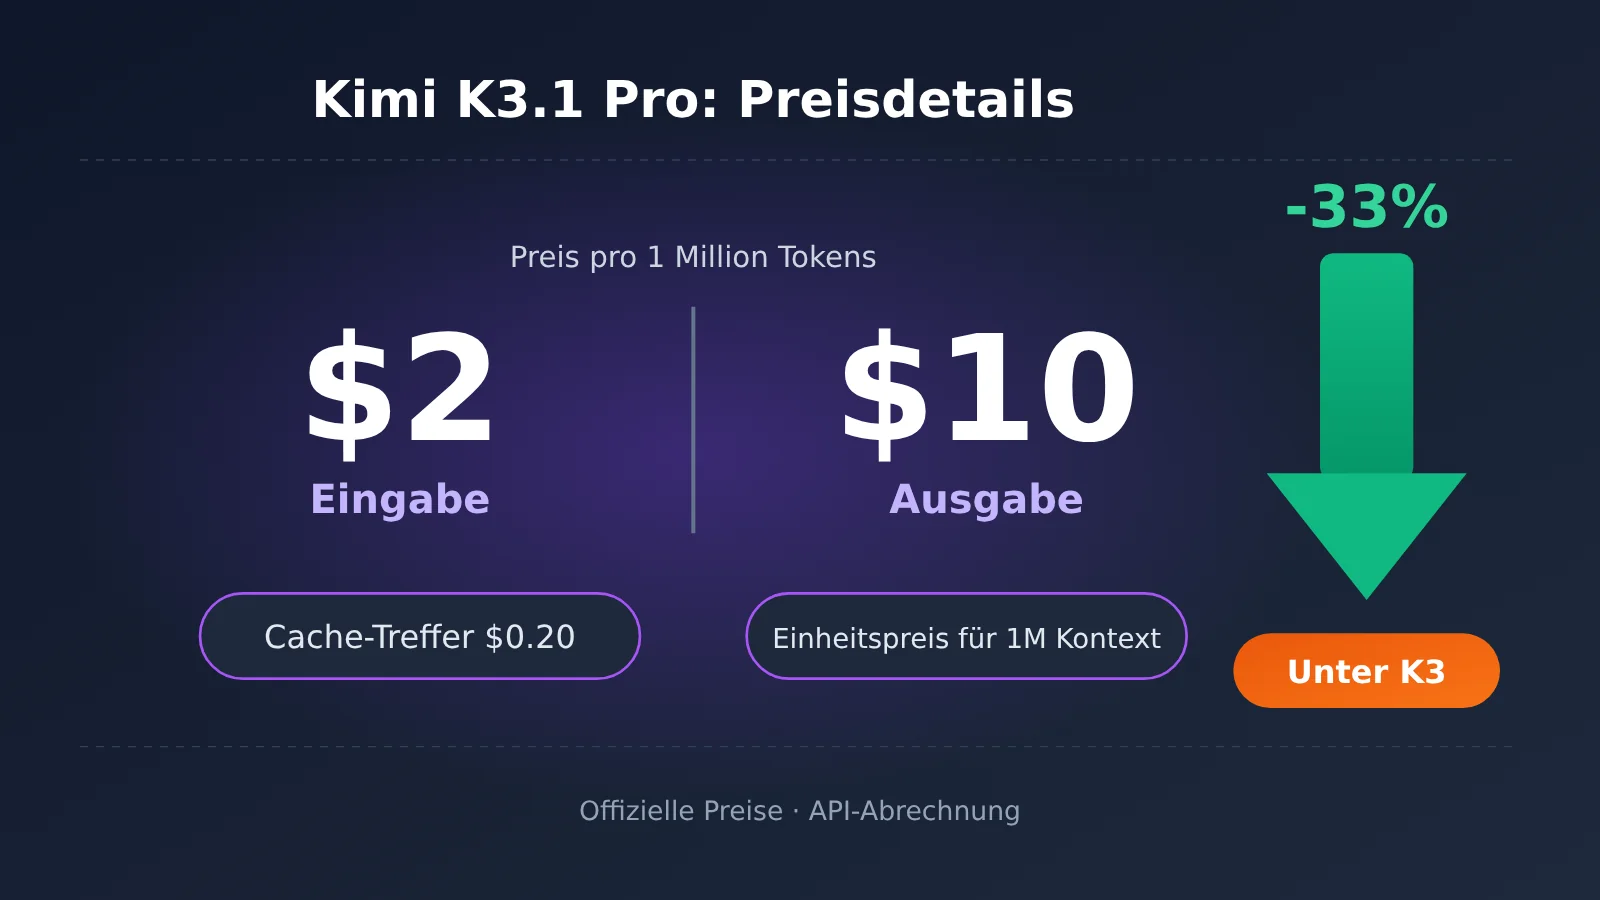
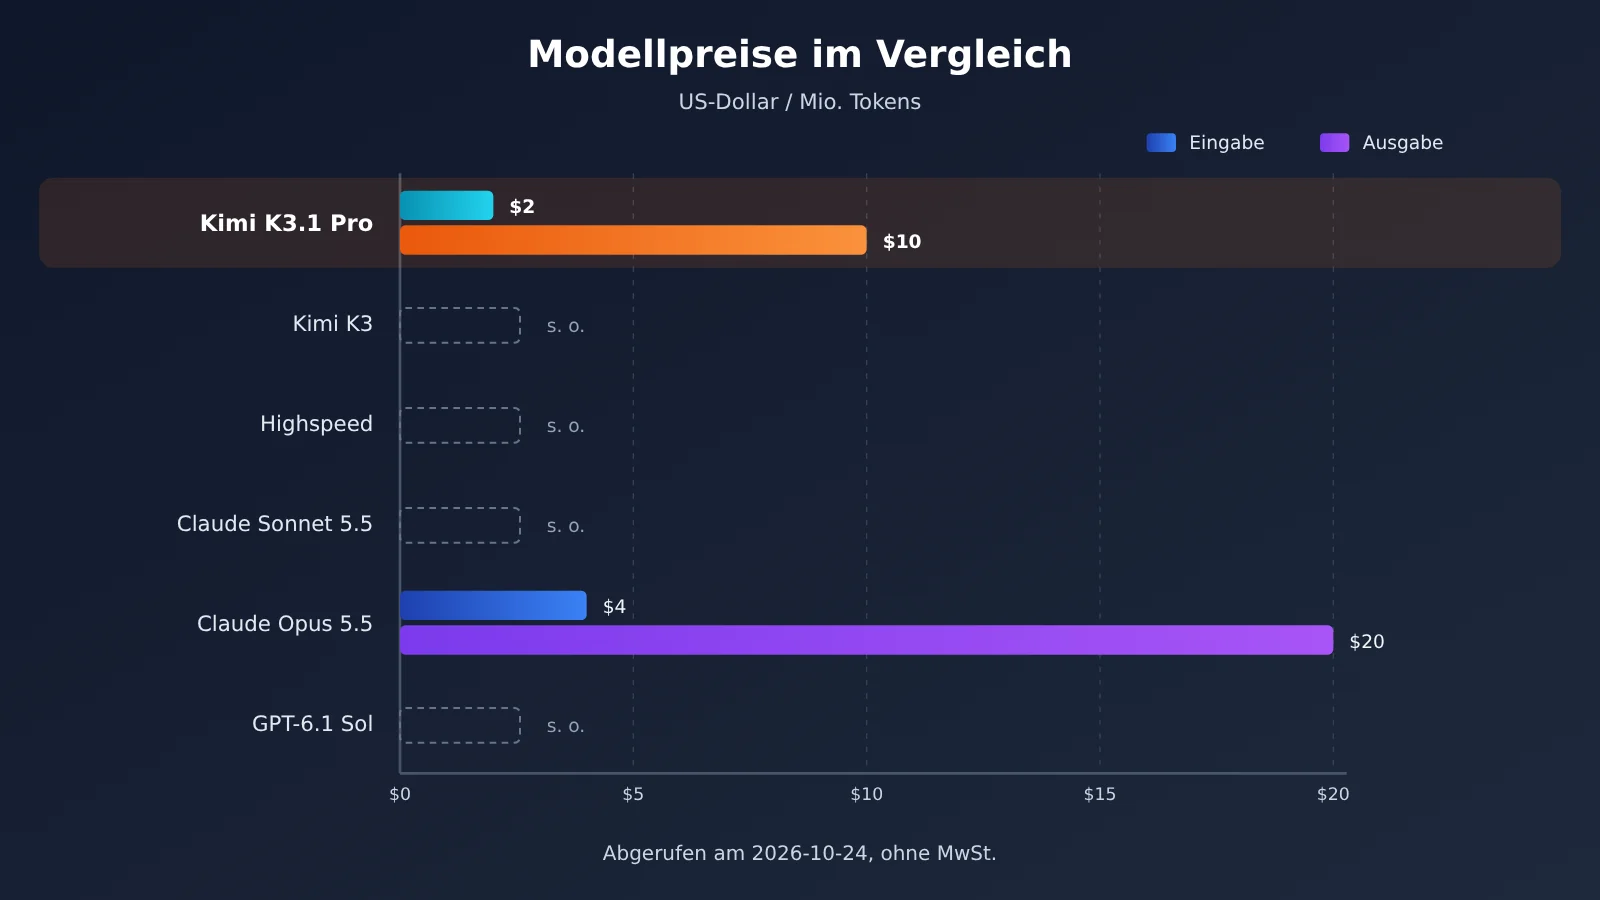
Der offizielle Preis für Kimi K3.1 Pro beträgt 2 $ für Eingaben und 10 $ für Ausgaben; bei Cache-Treffern sind es nur 0,20 $ (jeweils pro Million Tokens). Damit ist das Modell 33 % günstiger als die Vorgängergeneration Kimi K3. Zum gleichen Preis gibt es Claude Sonnet 5.5 und GPT-6.1 Sol; Claude Opus 5.5 kostet doppelt so viel.
Grundlage dieser Angaben sind die offizielle Preisseite von Moonshot (die Pricing-Dokumentation auf platform.kimi.ai) sowie Berechnungen der unabhängigen Organisation Artificial Analysis. Alle Zahlen im Artikel sind mit ihrer Quellenkategorie gekennzeichnet: „offiziell“ steht für Angaben aus Moonshot-Blogs oder offiziellen Dokumenten, „Drittanbieter“ für externe Berechnungen, etwa von Artificial Analysis. Für Angaben, zu denen sich keine verlässliche Quelle finden lässt, steht „nicht verifiziert“.
Dieser Artikel schreibt nicht einfach nur eine Preisliste ab. Eine Senkung des Stückpreises um 33 % bedeutet nicht, dass deine Rechnung automatisch um 33 % sinkt. Im Folgenden erfährst du, wo du sparen kannst – und wo nicht.
Das Wichtigste: Nach der Lektüre kannst du die Kosten für eine Anfrage an Kimi K3.1 Pro selbst berechnen. Du weißt, in welchen Fällen sich der Cache lohnt, wann du deine Rate-Limit-Stufe rechtzeitig anheben solltest und wie Entwickler in China bezahlen und das Modell einbinden können.
1. Die wichtigsten Fakten zu den Preisen von Kimi K3.1 Pro
Die folgende Tabelle beantwortet zunächst die häufigsten Fragen. In den weiteren Abschnitten gehen wir auf die einzelnen Punkte genauer ein.
| Punkt | Details | Quelle | Was das für Sie bedeutet |
|---|---|---|---|
| Grundpreise | Eingabe: 2 $ / Ausgabe: 10 $ / Cache-Treffer: 0,20 $ | Offiziell | Preislich auf dem Niveau von Sonnet 5.5 und GPT-6.1 Sol |
| Vergleich mit der Vorgängerversion | Alle drei Preise liegen 33 % unter denen von K3 | Offiziell / Drittanbieter | Die Preise pro Einheit sind deutlich gesunken |
| Kontext | 1.048.576 Tokens, einheitlicher Preis ohne Preisstufen | Offiziell | Bei langen Dokumenten steigen die Kosten nicht allein aufgrund ihrer Länge |
| Kosten pro Aufgabe | Ca. 1,98 $ (veröffentlichter Artikel) / 2,11 $ (Modellseite) | Drittanbieter | Im Wesentlichen auf dem Niveau von K3 – die Kosten pro Aufgabe sind nicht im selben Umfang gesunken |
| Einstiegshürde | Mindestens 1 $ aufladen; Tier 0 erlaubt nur 3 RPM | Offiziell | Vor dem produktiven Einsatz mit höherem Volumen müssen Sie zunächst ein Upgrade durchführen |
Zunächst zwei Begriffe, die später immer wieder auftauchen: Token ist die kleinste Einheit, nach der das Modell abrechnet. Man kann sich darunter „Wort- und Zeichenfragmente“ vorstellen. Laut offizieller Angabe entsprechen im Englischen etwa 3–4 Zeichen einem Token. Millionen Tokens (MTok) bedeutet 1.000.000 Tokens. Die 2 $ in der Preisliste gelten also für eine Million verarbeitete Eingabe-Tokens.
1.1 Welche Kostenpunkte gibt es bei Kimi K3.1 Pro?
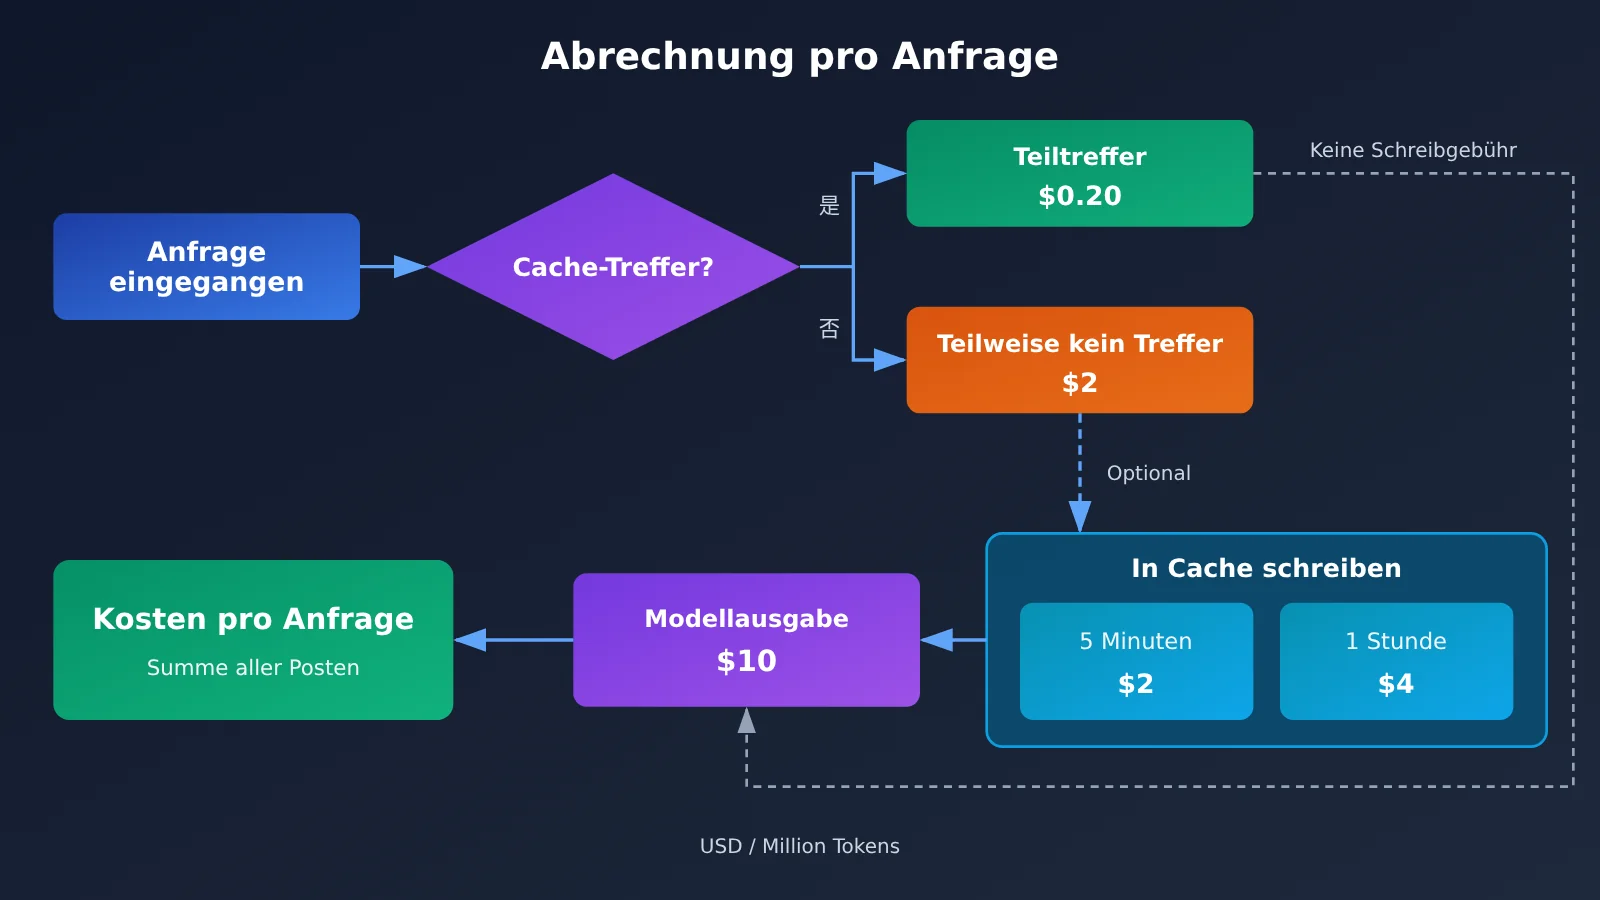
In der offiziellen Dokumentation sind drei Arten abrechenbarer Vorgänge aufgeführt: Cache-Schreibvorgänge (mit zwei Laufzeiten: 5 Minuten und 1 Stunde), Eingabe (Cache-Treffer und Cache-Fehltreffer) und Ausgabe. Daraus ergeben sich die fünf Preise in der Preisliste. Die Rechnung für jede Anfrage ergibt sich aus der Summe dieser Kosten, berechnet anhand der jeweiligen Token-Anzahl.
Der Kontext-Cache ist der besonders interessante Teil dieser Preisgestaltung. Wenn der Anfang mehrerer aufeinanderfolgender Anfragen exakt gleich ist – etwa ein langer Systemprompt –, kann die Plattform diesen Teil speichern und bei der nächsten Anfrage wiederverwenden. Für den wiederverwendeten Teil gilt dann der deutlich günstigere Preis für Cache-Treffer. Laut offizieller Dokumentation aktiviert die Kimi API die Cache-Abrechnung für wiederholte Anfrage-Präfixe automatisch. Die Standard-TTL beträgt 5 Minuten. TTL steht für „Time to Live“, also dafür, wie lange der Cache gespeichert bleibt.
In der offiziellen Dokumentation stehen außerdem einige Regeln, die leicht zu übersehen sind: Bei der K3-Serie wird für Cache-Treffer nur der Preis für Cache-Treffer berechnet; es fallen keine zusätzlichen Schreibkosten an. Datei-APIs – etwa zum Extrahieren von Dokumentinhalten oder zum Speichern von Dateien – sind derzeit kostenlos. Werden die extrahierten Inhalte jedoch an das Modell übergeben, werden sie wie üblich nach Tokens abgerechnet. Die Preise verstehen sich vor Steuern; die endgültige Abrechnung richtet sich nach den Bestimmungen des jeweiligen Zahlungsgebiets.
2. Vollständige Preisliste für Kimi K3.1 Pro: alle fünf Preisstufen im Überblick
Die folgende Tabelle enthält die Preise aller fünf aktuellen Hauptmodelle von Kimi und erleichtert den direkten Vergleich. „Nicht aufgeführt“ bedeutet, dass auf der offiziellen Preisseite kein Preis für diesen Posten angegeben ist – nicht, dass er kostenlos ist.
| Modell | Eingabe (Cache-Miss) | Ausgabe | Eingabe bei Cache-Treffern | Cache-Schreibvorgang, 5 Minuten | Cache-Schreibvorgang, 1 Stunde |
|---|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| kimi-k3(Vorgängergeneration) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
| kimi-k2.7-code | $0.95 | $4.00 | $0.19 | Nicht aufgeführt | Nicht aufgeführt |
| kimi-k2.6 | $0.95 | $4.00 | $0.16 | Nicht aufgeführt | Nicht aufgeführt |
Hinweis: Abgerufen am 24.10.2026. Preise in US-Dollar pro eine Million Tokens, ohne Steuern. Quelle: offizielle Preisseite.
Aus der Tabelle lassen sich einige Muster ablesen. Erstens kostet das Schreiben in den 5-Minuten-Cache bei K3.1 Pro genauso viel wie die normale Eingabe, nämlich $2. Für die Nutzung des 5-Minuten-Caches fallen also praktisch keine zusätzlichen Kosten an. Das Schreiben in den 1-Stunden-Cache kostet $4 und damit das Doppelte des Eingabepreises. Zweitens sind beim Highspeed-Modell alle Preise doppelt so hoch wie bei der Standardversion – mit Ausnahme des Preises für Cache-Treffer, der ebenfalls bei $0.20 liegt. Bei der Wiederverwendung langer Präfixe fällt der Preisunterschied zwischen den beiden Varianten daher geringer aus. Drittens liegen die Preise pro Einheit bei K2.7 Code und K2.6 bei weniger als der Hälfte von K3.1 Pro. Für Aufgaben, die nicht die stärkste Schlussfolgerungsfähigkeit erfordern, sind diese Modelle weiterhin die günstigere Wahl.
2.1 Kimi K3.1 Pro im Vergleich mit Modellen derselben Preisklasse
Vergleicht man mehrere gängige Modelle auf derselben Grundlage (US-Dollar pro einer Million Tokens), wird die Position von K3.1 Pro deutlich.
| Modell | Eingabe / Ausgabe | Eingabe bei Cache-Treffer | Cache-Schreibvorgang · kurze Laufzeit | Cache-Schreibvorgang · lange Laufzeit | Quelle |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2 / $10 | $0.20 | $2 (5 Minuten) | $4 (1 Stunde) | offiziell |
| Kimi K3.1 Pro Highspeed | $4 / $20 | $0.20 | $4 (5 Minuten) | $8 (1 Stunde) | offiziell |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | $2.50 (5 Minuten) | $4 (1 Stunde) | offiziell |
| Claude Opus 5.5 | $4 / $20 | $0.20 | $5 (5 Minuten) | $8 (1 Stunde) | offiziell |
| GPT-6.1 Sol (Eingabe ≤272K) | $2 / $10 | $0.10 | $2.50 (30 Minuten) | $5 (12 Stunden) | offiziell |
| GPT-6.1 Sol (Eingabe >272K) | $4 / $15 | $0.20 | $5 (30 Minuten) | $10 (12 Stunden) | offiziell |
| GPT-6 Astra (Eingabe ≤272K) | $10 / $50 | $1.00 | $12.50 (30 Minuten) | $25 (12 Stunden) | offiziell |
| GPT-6 Astra (Eingabe >272K) | $20 / $75 | $2.00 | $25 (30 Minuten) | $50 (12 Stunden) | offiziell |
Die Daten stammen aus den offiziellen Preisseiten der Anbieter und wurden am 24.10.2026 abgerufen. Alle Preise sind in US-Dollar pro einer Million Tokens angegeben und verstehen sich ohne Steuern. Die drei Anbieter haben unterschiedliche Cache-Laufzeiten: Bei Kimi und Claude sind es 5 Minuten beziehungsweise 1 Stunde, bei OpenAI 30 Minuten beziehungsweise 12 Stunden. Die Schreibpreise betragen das 1,25-Fache beziehungsweise das 2,5-Fache des Preises für Eingaben ohne Cache. Bei den meisten Modellen kostet das Lesen aus dem Cache 10 % des Eingabepreises; bei GPT-6.1 Sol sind es nur 5 %. Außerdem staffelt OpenAI die Preise nach der Länge der Eingabe: Bei ≤272K Tokens gilt der Preis für kurze Kontexte, bei >272K Tokens der für lange Kontexte. Die Tabelle zeigt nur die Standardtarife. OpenAIs Batch-Tarif zum halben Preis sowie Fast (früher Priority) und UltraFast, die teurer sind, sind nicht aufgeführt.
Im Vergleich liegen die Cache-Trefferpreise von Claude Sonnet 5.5 und GPT-6.1 Sol niedriger (beide bei $0.10). Wenn lange Präfixe häufig wiederverwendet werden, sind diese Modelle daher im Vorteil. Der Schreibpreis von Sonnet 5.5 für 5 Minuten liegt mit $2.50 allerdings etwas über den $2 von K3.1 Pro. K3.1 Pro eignet sich dagegen besonders für Aufgaben, bei denen große Dokumente einmalig eingelesen werden: Der Cache-Schreibvorgang ist günstiger, und der Preis pro Kontext bleibt einheitlich. Bei Claude Opus 5.5 sind die Preise für Ein- und Ausgabe doppelt so hoch wie bei K3.1 Pro. Für dieses Modell sollte also der Leistungsbedarf ausschlaggebend sein, nicht der Preis. Die Schwäche von GPT-6.1 Sol liegt beim Cache-Schreibvorgang: Der Tarif für 30 Minuten kostet $2.50 und ist damit teurer als der 5-Minuten-Tarif von K3.1 Pro für $2. Zudem ist der Preis nach Eingabelänge gestaffelt. Bei mehr als 272K Tokens steigen die Kosten auf $4 für die Eingabe und $15 für die Ausgabe. Bei Aufgaben mit langen Dokumenten muss deshalb die Zeile für lange Kontexte zugrunde gelegt werden.
Empfehlung zur Auswahl: Wie gut Modelle derselben Preisklasse in der Praxis abschneiden, hängt von der jeweiligen Aufgabe ab. Am besten testen Sie dieselben Eingabeaufforderungen mit allen Modellen und entscheiden dann. In der Modellübersicht von APIYI (apiyi.com) finden Sie unter anderem claude-sonnet-5-5, claude-opus-5-5 und kimi-k3. Mit einem einzigen API-Schlüssel können Sie die Modelle direkt vergleichen. Den genauen Modellnamen und Preis von K3.1 Pro entnehmen Sie bitte der Modellliste auf der Plattform. Wir werden dieses Modell so bald wie möglich anbieten.
3. Was kostet eine Anfrage mit Kimi K3.1 Pro? Drei Rechenbeispiele
Die Preisliste ist klar – aber entscheidend ist die Frage: „Was kostet mein konkreter Aufruf?“ Die folgenden drei Beispiele decken typische Szenarien ab: kurze Dialoge, wiederverwendbare lange Eingabeaufforderungen und das Lesen langer Dokumente. Die Rechenwege sind jeweils angegeben. Setzen Sie einfach Ihre eigenen Tokenzahlen ein. Die allgemeine Formel lautet: Kosten = Tokenzahl × Preis ÷ 1,000,000.
3.1 Beispiel 1: Kosten einer kurzen Anfrage mit Kimi K3.1 Pro
Szenario: eine gewöhnliche Frage-Antwort-Runde mit 2.000 Eingabetokens (kein Cache-Treffer) und 500 Ausgabetokens.
- Eingabe:
2000 × 2 ÷ 1000000 = $0.004 - Ausgabe:
500 × 10 ÷ 1000000 = $0.005 - Gesamt:
$0.004 + $0.005 = $0.009
Eine solche kurze Unterhaltung kostet also weniger als einen US-Cent. Dabei gilt es zu beachten, dass der Preis für Ausgabetokens fünfmal so hoch ist wie für Eingabetokens. Bei kurzen Anfragen macht die Ausgabe oft mehr als die Hälfte der Kosten aus. Die Ausgabelänge zu begrenzen, ist daher wirksamer, als die Eingabe zu kürzen.
3.2 Beispiel 2: Lange Eingabeaufforderung wiederverwenden und den Cache nutzen
Szenario: Eine System-Eingabeaufforderung mit 20.000 Tokens und zehn Fragen innerhalb von fünf Minuten. Jede Anfrage enthält zusätzlich 1.000 neue Eingabetokens und erzeugt 800 Ausgabetokens.
Ohne Cache wird die gesamte Eingabeaufforderung bei jeder Anfrage zum vollen Preis berechnet:
- Pro Anfrage:
(20000 + 1000) × 2 ÷ 1000000 + 800 × 10 ÷ 1000000 = $0.042 + $0.008 = $0.05 - Für 10 Anfragen:
$0.05 × 10 = $0.50
Mit Cache muss die System-Eingabeaufforderung beim ersten Mal in den Cache geschrieben werden. Die folgenden neun Anfragen greifen direkt darauf zu:
-
- Anfrage: Schreibvorgang
20000 × 2 ÷ 1000000 = $0.04, dazu neue Eingabe für$0.002und Ausgabe für$0.008, insgesamt$0.05
- Anfrage: Schreibvorgang
- 2.–10. Anfrage, jeweils: Cache-Treffer
20000 × 0.2 ÷ 1000000 = $0.004, dazu$0.002 + $0.008, insgesamt$0.014 - Summe der letzten 9 Anfragen:
$0.014 × 9 = $0.126 - Gesamt:
$0.05 + $0.126 ≈ $0.18
Bei denselben zehn Unterhaltungen sinken die Kosten also von 0,50 auf etwa 0,18 US-Dollar – eine Einsparung von rund 60 Prozent. Das Muster „lange, gleichbleibende Eingabeaufforderung plus mehrere Rückfragen“ kommt bei Chatbots im Kundenservice, Coding-Assistenten und Agent-Frameworks häufig vor. Hier bringt der Cache besonders viel.
3.3 Beispiel 3: Lange Dokumente mit Kimi K3.1 Pro lesen
Szenario: Ein Dokument mit 300.000 Tokens wird einmal gelesen und mit 3.000 Tokens zusammengefasst.
- Eingabe:
300000 × 2 ÷ 1000000 = $0.60 - Ausgabe:
3000 × 10 ÷ 1000000 = $0.03 - Gesamt: etwa
$0.63
Wenn Sie innerhalb von fünf Minuten eine weitere Frage zum selben Dokument stellen, wird der Dokumentteil aus dem Cache abgerufen. Für die Eingabe fallen dann nur 300000 × 0.2 ÷ 1000000 = $0.06 an. Hinzu kommen die Kosten für die Ausgabe. Bei Szenarien, in denen Sie wiederholt Fragen zum selben Vertrag, Finanzbericht oder Codebestand stellen, können Sie die Kosten deutlich senken, indem Sie Ihre Fragen innerhalb der Cache-Gültigkeitsdauer bündeln.
4. Einheitlicher Preis für 1M Kontext bei Kimi K3.1 Pro: Was bedeutet die Abrechnung ohne Preisstufen?
Der Kontext lässt sich als „gesamte Menge an Inhalten verstehen, die ein Modell auf einmal verarbeiten kann“. Dazu gehören deine Eingabeaufforderung, der bisherige Gesprächsverlauf und hochgeladene Dokumente. Laut offizieller Dokumentation unterstützen alle Modelle der K3-Serie ein Kontextfenster von 1.048.576 Tokens. K3.1 Pro wird außerdem zu einem einheitlichen Preis pro verbrauchter Menge abgerechnet – ohne Preisstufen nach Kontextlänge.
Laut der offiziellen FAQ wird K3.1 Pro mit einem Kontextfenster von 1M Tokens zu einem einheitlichen verbrauchsabhängigen Preis abgerechnet. Das gilt für Cache-Schreibvorgänge, Eingaben (Cache-Treffer und Cache-Fehlversuche) und Ausgaben. Anders gesagt: Ob du 2.000 oder 800.000 Tokens sendest, der Preis pro Million Tokens beträgt immer 2 $. Ein längerer Request führt also nicht zu einem höheren Preis pro Token.
Das ist beim Vergleich wichtig, denn nicht alle Anbieter rechnen auf diese Weise ab. Bei OpenAI ist der Preis der GPT-6-Serie nach der Eingabelänge gestaffelt: Bis einschließlich 272K Tokens gilt der Preis für kurze Kontexte. Wird diese Grenze überschritten, gilt sofort der höhere Preis für lange Kontexte. Bei GPT-6 Astra steigt beispielsweise der Eingabepreis von 10 $ auf 20 $, der Ausgabepreis von 50 $ auf 75 $ und der Preis für Cache-Treffer von 1,00 $ auf 2,00 $. Claude verfolgt einen anderen Ansatz: Auf der offiziellen Preisseite steht, dass für Claude 4.6 und spätere Modelle – mit Ausnahme von Claude Haiku 5.5 – im gesamten 1M-Kontextfenster der Standardpreis gilt. Ein Request mit 900.000 Tokens kostet pro Token also genauso viel wie einer mit 9.000 Tokens. Nur bei Claude Haiku 5.5 steigt der Preis, wenn die Eingabe 100.000 Tokens überschreitet. K3.1 Pro ist mit seiner Abrechnung ohne Preisstufen also nicht allein: Auch Claude Sonnet 5.5 und Opus 5.5 verlangen keinen Aufpreis für längere Kontexte. Einen Preissprung gibt es tatsächlich bei der GPT-6-Serie.
Für Entwickler bringt der einheitliche Preis zwei direkte Vorteile:
- Das Budget lässt sich linear kalkulieren: Verdoppelt sich die Tokenzahl, verdoppeln sich auch die Kosten. Es gibt keine plötzlichen Preissprünge ab einer bestimmten Länge. Ein Dokument mit 300.000 Tokens wie in Beispiel 3 kannst du einfach zum Einheitspreis kalkulieren.
- Dokumente müssen nicht künstlich aufgeteilt werden: Bei Modellen mit gestaffelten Preisen teilen manche lange Dokumente in mehrere Abschnitte auf, um die teurere Preisstufe zu umgehen. Bei K3.1 Pro spart das nichts und kann durch den Verlust von Kontext sogar die Ergebnisse verschlechtern.
5. Warum Kimi K3.1 Pro Kosten spart – und wo nicht
In diesem Abschnitt rechnen wir offen nach. Der Preis pro Token ist tatsächlich gesunken, doch die Kosten für eine konkrete Aufgabe hängen auch von der Ausgabelänge ab.
| Dimension | Details | Quelle | Auswirkungen auf die Kosten |
|---|---|---|---|
| Niedrigere Preise pro Token | Eingabe, Ausgabe und Cache-Treffer sind jeweils 33 % günstiger als bei K3 | Offiziell / Drittanbieter | Spart Kosten |
| Preis bei Cache-Treffern | $0,20, also nur ein Zehntel des Eingabepreises | Offiziell | Spart bei der Wiederverwendung langer Präfixe deutlich Kosten |
| Cache-Schreibvorgang mit einer Stunde Laufzeit | $4, also das Doppelte des Eingabepreises | Offiziell | Lohnt sich bei Aufgaben mit längeren Abständen; für kurze Aufgaben nicht nötig |
| Denken immer aktiv | Das Denken lässt sich nicht deaktivieren; die durchschnittliche Ausgabe umfasst 55K Tokens und ist damit 14 % länger als bei K3 | Offiziell / Drittanbieter | Macht einen Teil der Preissenkung zunichte |
| Kosten pro Aufgabe | $1,98 (laut veröffentlichtem Artikel) / $2,11 (gewichteter Wert auf der Modellseite) | Drittanbieter | Im Wesentlichen auf dem Niveau von K3 |
5.1 Drei Punkte, durch die Kimi K3.1 Pro Kosten spart
Erstens sind die Preise pro Token direkt um 33 % gesunken: von $3/$15 bei K3 auf $2/$10. Auch der Preis für Cache-Treffer ist von $0,30 auf $0,20 gefallen. Darin stimmen die offizielle Preisliste und die Daten von Artificial Analysis überein. Zweitens kostet ein Cache-Treffer nur ein Zehntel des Eingabepreises. Wie in Beispiel 2 bereits berechnet, können sich bei mehrstufigen Dialogen mit einer festen, langen Eingabeaufforderung die Kosten um etwa 60 % senken. Drittens kostet ein Cache-Schreibvorgang mit einer Stunde Laufzeit zwar das Doppelte, dafür bleibt der Cache länger erhalten. Das eignet sich für Aufgaben, bei denen zwischen zwei Aufrufen mehr als fünf Minuten liegen – etwa für einen regelmäßig alle paar Minuten ausgeführten Agenten oder für Fragen zu langen Dokumenten, bei denen Nutzer innehalten und dann nachfragen. Bei mehr als zwei Cache-Treffern innerhalb einer Stunde gleichen die Einsparungen in der Regel die höheren Schreibkosten aus.
5.2 Wo Kimi K3.1 Pro keine Kosten spart
Denken bedeutet, dass das Modell vor der Antwort intern eine Schlussfolgerungskette durchläuft. Auch diese Inhalte werden als Ausgabe berechnet. Laut offizieller Dokumentation lässt sich das Denken bei K3.1 Pro nicht deaktivieren. Mit reasoning_effort auf low kann lediglich der Umfang des Denkens reduziert werden.
Laut einer Analyse von Artificial Analysis (einem Drittanbieter) gibt K3.1 Pro bei den Aufgaben im Intelligence Index durchschnittlich etwa 55K Tokens aus, K3 dagegen 48K – also 14 % weniger. Da der Ausgabepreis am höchsten ist, zehren die zusätzlichen Tokens einen Teil der möglichen Einsparungen auf. Die Kosten pro Aufgabe liegen laut Berechnung des Drittanbieters bei etwa $1,98 (laut veröffentlichtem Artikel). Auf der Modellseite wird ein gewichteter Wert von $2,11 pro Aufgabe angegeben (mit einem Cache-Rabatt von 90 %). Damit liegt K3.1 Pro im Wesentlichen auf dem Niveau von K3.
Das Fazit: Wenn deine Anwendung vor allem lange Eingaben und deren Wiederverwendung in mehreren Dialogrunden umfasst, macht sich die Preissenkung von K3.1 Pro deutlich auf der Rechnung bemerkbar. Bei Aufgaben mit komplexen Schlussfolgerungen und langen Ausgaben sind die Kosten pro Aufgabe dagegen nicht unbedingt niedriger als bei K3. Am besten testest du zunächst eine kleine Zahl echter Aufgaben und prüfst anschließend die tatsächlichen Kosten.
6. Aufladegrenzen und Rate-Limit-Stufen von Kimi K3.1 Pro
Die offizielle Abrechnung erfolgt nutzungsbasiert, ein Abonnement gibt es nicht. Außerdem werden die Kimi API und die Kimi-Mitgliedschaft sowie Kimi Code unabhängig voneinander abgerechnet. Eine Mitgliedschaft kann nicht mit API-Kosten verrechnet werden. Um die API nutzen zu können, müssen Sie mindestens 1 $ aufladen. Bei einer kumulierten Aufladung von mindestens 5 $ erhalten Sie einen Gutschein über 5 $. Dieser Gutschein zählt nicht zur kumulierten Aufladung (laut offizieller Angabe).
Die Rate-Limit-Stufe richtet sich nach dem kumulierten Aufladebetrag. Zunächst einige Abkürzungen: Gleichzeitige Anfragen bezeichnet die Anzahl der Anfragen, die gleichzeitig verarbeitet werden können. RPM gibt die maximalen Anfragen pro Minute an, TPM die maximal verarbeitbaren Tokens pro Minute und TPD die maximal verarbeitbaren Tokens pro Tag.
| Stufe | Kumulierte Aufladung | Gleichzeitige Anfragen | RPM | TPM | TPD |
|---|---|---|---|---|---|
| Tier0 | 1 $ | 1 | 3 | 500.000 | 1.500.000 |
| Tier1 | 10 $ | 15 | 100 | 2.000.000 | Unbegrenzt |
| Tier2 | 20 $ | 40 | 100 | 3.000.000 | Unbegrenzt |
| Tier3 | 100 $ | 50 | 200 | 3.000.000 | Unbegrenzt |
| Tier4 | 1.000 $ | 60 | 200 | 4.000.000 | Unbegrenzt |
| Tier5 | 3.000 $ | 100 | 300 | 5.000.000 | Unbegrenzt |
Hinweis: Quelle ist die offizielle Dokumentation zu Rate Limits (Seite „pricing/limits“ auf platform.kimi.ai), abgerufen am 24.10.2026.
Die Beschränkungen von Tier0 sind sehr streng: Pro Minute sind nur drei Anfragen möglich, und das Tageslimit liegt bei insgesamt 1,5 Millionen Tokens. Bei einem Dokument mit 300.000 Tokens, wie in Beispiel 3, ist das Tageslimit bereits nach fünf Durchläufen erreicht. Mit einem TPM-Limit von 500.000 passen außerdem nicht einmal zwei solche Dokumente in eine Minute. Wenn Sie große Mengen verarbeiten oder den Dienst für Nutzer bereitstellen möchten, empfiehlt es sich, die kumulierte Aufladung schon während der Testphase auf mindestens Tier1 zu erhöhen.
Wichtig ist noch ein weiterer Punkt: Laut offizieller Angabe lässt sich ein durch Risikokontrollen ausgelöstes Rate Limit nicht wieder aufheben. Sorgen Sie daher vor dem Start für eine Begrenzung der Anfragerate und eine exponentielle Verzögerung bei Wiederholungsversuchen. Versuchen Sie nicht, die Limits mit einem Parallelisierungsskript auszutesten.
7. Kimi K3.1 Pro in China bezahlen und anbinden
Bei den offiziellen Kanälen wird in US-Dollar abgerechnet. Dabei gelten die Zahlungsregeln der jeweiligen Region. Zwar ist eine direkte Zahlung aus China möglich, doch für Entwickler vor Ort sind oft andere Punkte entscheidend: Zahlungsmethoden für Auslandszahlungen, Rechnungen und der Aufwand, API-Schlüssel mehrerer Anbieter zu verwalten. Eine Alternative ist die Anbindung über eine API-Aggregationsplattform. Damit lassen sich mehrere Modelle über ein Konto und einen API-Schlüssel aufrufen.
APIYI (apiyi.com) ist eine API-Aggregationsplattform für KI-Großmodelle. Mit einem API-Schlüssel können Sie gängige Modelle wie OpenAI, Claude und Gemini aufrufen. Die Schnittstelle ist mit dem OpenAI-Format kompatibel, die Abrechnung erfolgt nutzungsbasiert und neue Nutzer erhalten ein kostenloses Testguthaben. Bei der Überprüfung der Modellliste unter docs.apiyi.com/models am 24.10.2026 waren derzeit folgende Modelle aus der Kimi-Reihe verfügbar:
kimi-k3: Eingabe 3 $ / Ausgabe 15 $ / Cache-Lesezugriff 0,3 $kimi-k2.7-code: Eingabe 0,95 $ / Ausgabe 3,99 $ / Cache-Lesezugriff 0,19 $kimi-k2.6: Eingabe 0,6 $ / Ausgabe 2,4 $ / Cache-Lesezugriff 0,1 $kimi-k2.5: Eingabe 0,6 $ / Ausgabe 3,15 $ / Cache-Lesezugriff 0,1 $
kimi-k3.1-pro war am Tag der Überprüfung noch nicht in der Modellliste von APIYI aufgeführt. Deshalb nennen wir hier keinen Preis für dieses Modell auf der Plattform. Modellbezeichnung, Preis und Verfügbarkeit von K3.1 Pro entnehmen Sie bitte der Modellliste in der Plattformkonsole. Wir werden das Modell so bald wie möglich anbieten. Bis dahin können Sie den Ablauf zunächst mit kimi-k3 testen. Sobald K3.1 Pro verfügbar ist, müssen Sie lediglich die Modellbezeichnung ändern.
7.1 Kimi K3.1 Pro schnell einrichten
Unabhängig davon, ob Sie den offiziellen Zugang oder eine Aggregationsplattform nutzen, ist die Einrichtung im Wesentlichen gleich. Hier ein Beispiel mit einer OpenAI-kompatiblen Schnittstelle:
- Registrieren Sie sich und erstellen Sie einen API-Schlüssel. Beim offiziellen Zugang müssen Sie zuvor mindestens 1 $ aufladen.
- Setzen Sie in Ihrem OpenAI-SDK oder Client den Wert von
base_urlaufhttps://api.apiyi.com/v1, wenn Sie APIYI verwenden. Nutzt Ihr Projekt das Anthropic-Format, tragen Sie als Basisadressehttps://api.apiyi.comein. - Setzen Sie
api_keyauf Ihren API-Schlüssel und tragen Sie beimodelden Namen aus der Modellliste der Plattform ein, zum Beispiel das derzeit verfügbarekimi-k3. Sobald K3.1 Pro verfügbar ist, verwenden Sie die dann aufgeführte Modellbezeichnung. - Um die Ausgabekosten für das Nachdenken des Modells zu senken, fügen Sie den Parameter
reasoning_efforthinzu und setzen ihn auflow. Laut offiziellen Angaben lässt sich K3.1 Pro damit nur reduzieren, nicht aber vollständig deaktivieren. - Platzieren Sie lange, unveränderliche System-Eingabeaufforderungen am Anfang der Nachrichten und halten Sie sie konstant. So kann das wiederholte Präfix automatisch aus dem Cache abgerufen werden.
- Prüfen Sie nach dem Aufruf in der Abrechnung oder im Nutzungsfeld der Antwort die Tokenzahlen für Eingabe, Cache-Treffer und Ausgabe. Berechnen Sie die Kosten anschließend anhand der Formel aus Abschnitt 3 erneut.
Tipp für den schnellen Einstieg: Nutzen Sie zunächst das kostenlose Testguthaben von APIYI auf apiyi.com, um Beispiel 2 aus Abschnitt 3 auszuführen. Vergleichen Sie die Nutzung mit und ohne festes Präfix – so lässt sich am schnellsten überprüfen, ob der Cache funktioniert. Modellbezeichnung und Preis von K3.1 Pro auf der Plattform entnehmen Sie bitte der Modellliste. Wir werden das Modell so bald wie möglich anbieten.
Häufig gestellte Fragen (FAQ)
F1: Was kostet Kimi K3.1 Pro genau?
Der offizielle Preis beträgt 2 $ für Eingaben, 10 $ für Ausgaben, 0,20 $ für Cache-Treffer, 2 $ für Cache-Schreibvorgänge mit einer Gültigkeit von 5 Minuten und 4 $ für Cache-Schreibvorgänge mit einer Gültigkeit von 1 Stunde. Alle Preise gelten in US-Dollar pro Million Tokens, ohne Steuern. Abgerufen am 24.10.2026.
F2: Wie viel günstiger ist Kimi K3.1 Pro als K3? Sinkt die tatsächliche Rechnung um 33 %?
Alle drei Einzelpreise liegen offiziell um 33 % niedriger. K3.1 Pro führt jedoch immer Denkprozesse aus und erzeugt im Durchschnitt 14 % mehr Ausgabetokens. Laut einer Berechnung des Drittanbieters Artificial Analysis liegen die Kosten pro Aufgabe bei etwa 1,98 bis 2,11 $ und damit in etwa auf dem Niveau von K3. Bei langen Eingaben und der Wiederverwendung über mehrere Gesprächsrunden fällt die Ersparnis deutlicher aus.
F3: Was ist günstiger: Kimi K3.1 Pro oder Claude Sonnet 5.5?
Beide Modelle kosten für Ein- und Ausgaben jeweils 2 beziehungsweise 10 $. Cache-Treffer sind bei Sonnet 5.5 günstiger (0,10 $), während K3.1 Pro beim Cache-Schreiben für 5 Minuten günstiger ist (2 $ gegenüber 2,50 $). Außerdem gilt für K3.1 Pro auch bei einem Kontextfenster von 1 Million Tokens ein einheitlicher Preis. Bei häufig wiederverwendeten kurzen Präfixen spricht mehr für Sonnet; wenn große Dokumente auf einmal eingelesen werden, eher für K3.1 Pro. Am besten vergleichen Sie beide mit Ihren tatsächlichen Aufgaben.
F4: Lohnt sich der 1-Stunden-Cache von Kimi K3.1 Pro?
Das Schreiben in den 1-Stunden-Cache kostet 4 $ und damit 2 $ mehr als beim 5-Minuten-Cache. Wenn dasselbe Präfix mehr als 5 Minuten später, aber innerhalb einer Stunde, noch mindestens zweimal wiederverwendet wird, lohnt sich der 1-Stunden-Cache in der Regel. Finden alle Aufrufe innerhalb weniger Minuten statt, reicht die standardmäßige Gültigkeit von 5 Minuten.
F5: Wie können Entwickler in China Kimi K3.1 Pro per API aufrufen?
Sie können den offiziellen Zugang nutzen oder das OpenAI-kompatible APIYI-Interface unter apiyi.com verwenden. Tragen Sie dafür `https://api.apiyi.com/v1` als `base_url` ein. Auf der Plattform sind derzeit unter anderem `kimi-k3` und `kimi-k2.7-code` verfügbar. Die genaue Modellbezeichnung und der Preis für K3.1 Pro richten sich nach der Modellliste der Plattform. Wir werden das Modell so bald wie möglich anbieten.
F6: Können Kimi-Mitgliedschaften auf API-Kosten angerechnet werden?
Nein. Laut offizieller Auskunft wird die Kimi API nutzungsbasiert abgerechnet und ist nicht an ein Abonnement gebunden. Kimi-Mitgliedschaften, die Kimi API und Kimi Code werden getrennt abgerechnet.
F7: Worauf muss ich bei der Abrechnung von Kimi K3.1 Pro achten?
– Denkprozesse lassen sich nicht deaktivieren. Dadurch kann die Zahl der Ausgabetokens höher ausfallen. Mit `reasoning_effort` auf `low` lässt sich das abmildern.
– Tier 0 ist auf 3 RPM und 1,5 Millionen TPD begrenzt. Bei höherem Bedarf sollten Sie rechtzeitig ein Upgrade beantragen.
– Eine nach einer Risikoprüfung ausgelöste Drosselung kann nicht aufgehoben werden.
– Die Dateiextraktion ist kostenlos. Werden die extrahierten Inhalte jedoch an das Modell übergeben, werden sie als Eingabe abgerechnet.
F8: Was kann ich vorbereiten, solange Kimi K3.1 Pro auf meiner Plattform noch nicht verfügbar ist?
Sie können zunächst mit `kimi-k3` auf APIYI unter apiyi.com die Aufrufkette, die Cache-Struktur und die Nutzungsstatistik einrichten. Sobald K3.1 Pro verfügbar ist, müssen Sie nur noch die Modellbezeichnung ersetzen. Die genaue Modellbezeichnung und der Preis richten sich nach der Modellliste der Plattform. Wir werden das Modell so bald wie möglich anbieten.
Die wichtigsten Punkte zu den Preisen von Kimi K3.1 Pro
- Grundpreise: 2 $ pro 1 Mio. Input-Token, 10 $ pro 1 Mio. Output-Token und 0,20 $ pro 1 Mio. Token bei Cache-Treffern. Offizielle Preise, ohne Steuern.
- Fünf Preisstufen: Schreibvorgänge mit einer Cache-Dauer von 5 Minuten kosten 2 $, mit 1 Stunde Cache-Dauer 4 $. Die Schreibkosten sind niedrig.
- Preispositionierung: Gleich teuer wie Sonnet 5.5 und GPT-6.1 Sol, halb so teuer wie Opus 5.5.
- Einheitlicher Preis: Für ein Kontextfenster von 1 Mio. Token gibt es keine Preisstaffelung nach Länge. Das Budget lässt sich daher linear kalkulieren.
- Reale Kosten: Der durchgängige Denkmodus führt zu 14 % mehr Output. Die Kosten pro Aufgabe liegen damit ungefähr auf dem Niveau von K3 (Drittanbieterangabe).
- Einstieg: Aufladen ab 1 $. Tier 0 erlaubt nur 3 RPM. Eine durch Risikokontrollen ausgelöste Drosselung lässt sich nicht aufheben.
- Zugang aus China: Über APIYI lässt sich das Modell mit einer OpenAI-kompatiblen Schnittstelle anbinden. Modellbezeichnung und Preis für K3.1 Pro richten sich nach der Plattformliste. Wir werden dieses Modell so bald wie möglich anbieten.
Zusammenfassung
Die wichtigsten Punkte zu den Preisen von Kimi K3.1 Pro:
- Preise: 2 $ pro 1 Mio. Input-Token, 10 $ pro 1 Mio. Output-Token und 0,20 $ pro 1 Mio. Token bei Cache-Treffern. Das sind 33 % weniger als bei K3. Für ein Kontextfenster von 1 Mio. Token gilt ein einheitlicher Preis.
- So sparen Sie Kosten: Platzieren Sie einen festen, langen Präfix ganz am Anfang und nutzen Sie den Cache. Bei mehrstufigen Gesprächen können Sie so rund 60 % der Input-Kosten einsparen.
- Zu erwartende Kosten: Der durchgängige Denkmodus erzeugt längere Ausgaben. Bei komplexen Aufgaben mit Schlussfolgerungen sind die Kosten pro Aufgabe ähnlich hoch wie bei K3. Planen Sie Ihr Budget daher nicht mit einer Reduzierung um 33 %.
- Vorbereitung für den Einsatz: Erhöhen Sie die Rate-Limit-Stufe frühzeitig und steuern Sie die Anfragerate, damit keine Drosselung durch Risikokontrollen ausgelöst wird, die sich nicht aufheben lässt.
Schätzen Sie die Kosten zunächst anhand der Formel aus Abschnitt 3 und Ihrer eigenen Token-Verteilung. Prüfen Sie die Schätzung anschließend mit einigen realen Aufgaben. Wenn Sie in China Kimi, Claude, GPT und andere Modelle mit einem einzigen Schlüssel vergleichen möchten, können Sie über APIYI unter apiyi.com ein kostenloses Kontingent für Tests nutzen. Modellbezeichnung und Preis für K3.1 Pro auf der Plattform richten sich nach der Modellliste. Wir werden dieses Modell so bald wie möglich anbieten.
Referenzquellen
- Kimi Open Platform – Modellpreise: Preise und Abrechnungsregeln für K3.1 Pro und die weiteren Modelle in fünf Preisstufen
- Link:
platform.kimi.ai/docs/pricing/chat -
Hinweis: Offizielle Quelle für die Preistabelle und die einheitliche Abrechnung bei einem Kontextfenster von 1M
-
Kimi Open Platform – Aufladung und Rate Limits: Informationen zu den Stufen Tier0 bis Tier5 und zum Risikomanagement
- Link:
platform.kimi.ai/docs/pricing/limits -
Hinweis: Offizielle Quelle zu Aufladeschwellen und den Beschränkungen für RPM/TPM/TPD
-
Artificial Analysis – Kimi K3.1 Pro: Berechnungen der Kosten pro Aufgabe und der ausgegebenen Tokens durch einen Drittanbieter
- Link:
artificialanalysis.ai -
Hinweis: Datenquelle für die Kosten pro Aufgabe von $1,98 / $2,11 und die Ausgabe von 55K Tokens
-
APIYI-Modellübersicht: Aktuell auf der Plattform verfügbare Modelle und Preise
- Link:
docs.apiyi.com/models - Hinweis: Informationen zur tatsächlichen Verfügbarkeit von Modellen wie Kimi und Claude auf der Plattform
Autor: Das technische Team von APIYI
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website. Weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.