Autorenhinweis: Dieser Beitrag zeichnet nach, wie Claude die Herkunft der NIST-Elliptikkurven-Seeds aufgedeckt hat. Er erläutert, wo die Schlussfolgerungen ihre Grenzen haben, und stellt drei direkt wiederverwendbare Einsatzmöglichkeiten für AI Agents in der Forschung vor – inklusive Code und Methoden zur Kostenkontrolle.
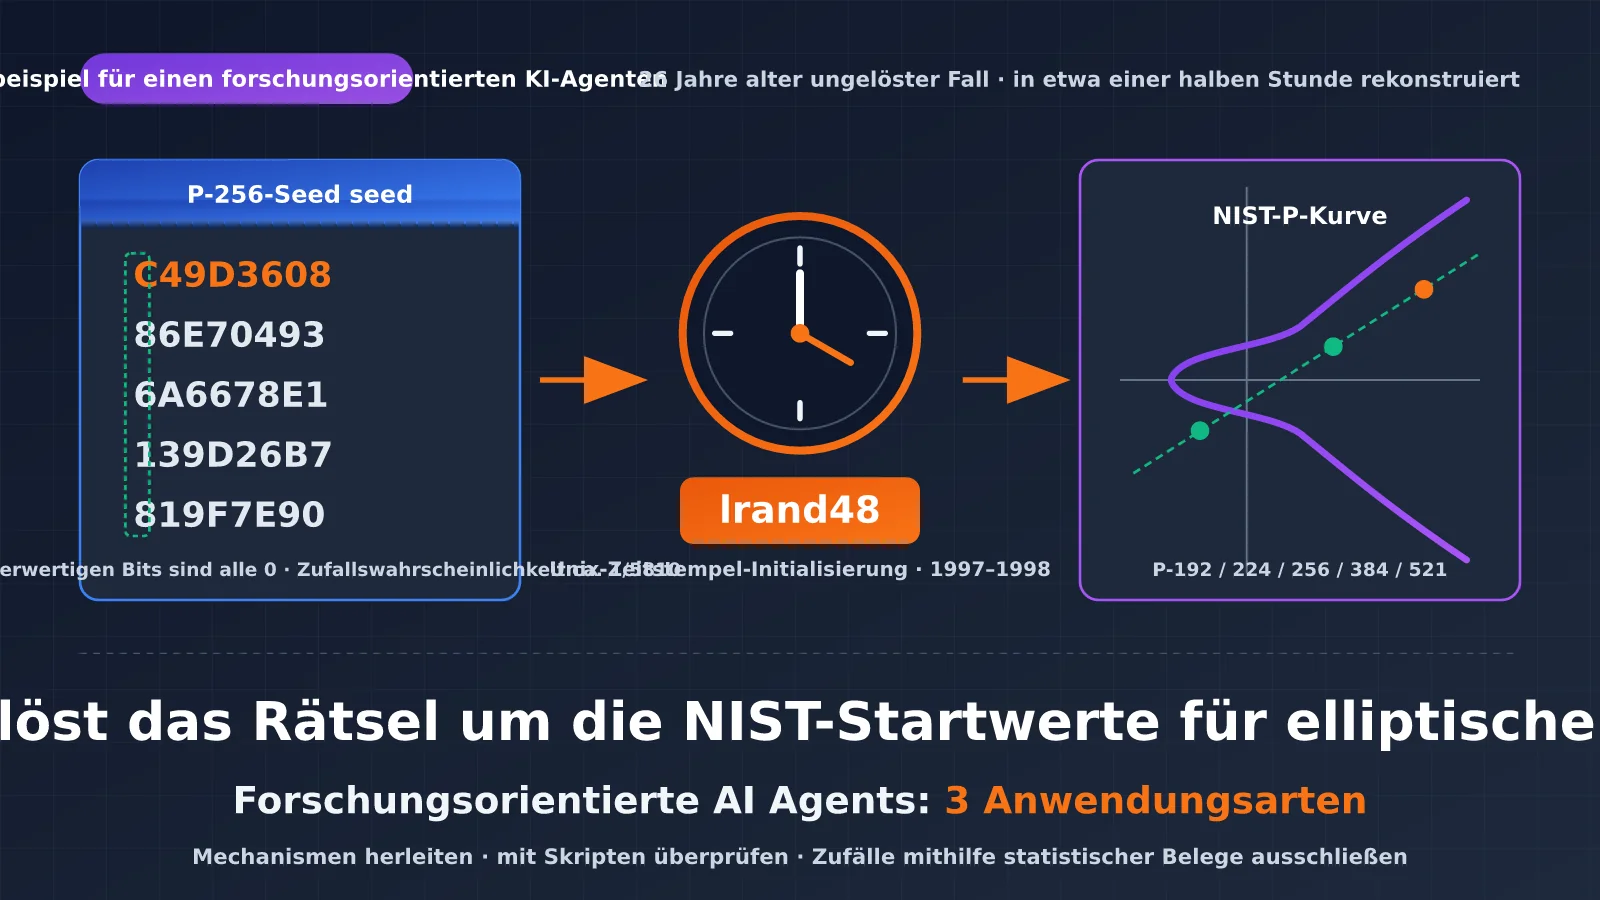
Am 17. Oktober 2026 veröffentlichte das Anthropic Frontier Red Team eine Studie: Ein internes Forschungsmodell leitete innerhalb von etwa einer halben Stunde und ohne jede Eingabeaufforderung her, wie die Seeds der fünf Kurven NIST P-192, P-224, P-256, P-384 und P-521 erzeugt wurden. Die Seeds waren nicht gehasht worden. Sie stammten stattdessen aus dem Pseudozufallszahlengenerator lrand48, der in den C-Bibliotheken der 1990er-Jahre enthalten war. Als Startwert diente ein Unix-Zeitstempel. Der offizielle Beitrag von @AnthropicAI fasste das mit einem Satz zusammen: „It is just timestamps.“ Er wurde rund 855.000-mal aufgerufen.
Das ist weder ein kryptografischer Bruch noch eine neue Sicherheitslücke. Für Forschende ist an diesem Fall vor allem interessant, wie Claude vorgegangen ist: den Mechanismus herleiten, ein Skript zur Überprüfung schreiben und Zufallstreffer mithilfe statistischer Belege ausschließen. Dieser Arbeitsablauf lässt sich direkt auf die eigene Forschung übertragen.
Der zentrale Nutzen: Nach der Lektüre wissen Sie, was dieser Fall belegt – und was nicht. Außerdem erhalten Sie drei sofort einsetzbare Workflows für Forschungs-AI-Agents, jeweils mit konkreten Schritten und ausführbarem Code.
Claude löst das Rätsel um die NIST-Kurven-Seeds: die wichtigsten Punkte
| Punkt | Beschreibung | Bedeutung für Forschende |
|---|---|---|
| Hintergrund des Rätsels | NIST übernahm ECDSA 2000 in FIPS 186-2. Die Seeds für die Kurven stammten von der NSA, ohne dass ihre Herkunft erläutert wurde. | Ein 26 Jahre lang ungelöstes Problem kann als Test für die Schlussfolgerungsfähigkeit von KI dienen. |
| Ergebnis | Die Seeds stammen aus der Ausgabe von lrand48, initialisiert mit Zeitstempeln aus dem Zeitraum von Mai 1997 bis April 1998. |
Das Ergebnis lässt sich von allen reproduzieren und mit geringem Aufwand überprüfen. |
| Methode | Die wahrscheinliche Implementierung wurde hergeleitet, ein eigener Scanner geschrieben, anhand statistischer Merkmale nach Mustern gesucht und schließlich der Zustand rekonstruiert. | Diese drei Schritte lassen sich auf Aufgaben wie die Analyse experimenteller Daten oder Reverse Engineering übertragen. |
| Sicherheitsrelevanz | Es handelt sich nicht um eine Schwachstelle. Nutzer müssen weder ihre Konfiguration ändern noch migrieren. | In Übersichtsarbeiten oder Berichten sollte der Sachverhalt präzise dargestellt und nicht übertrieben werden. |
| Offene Fragen | Der Seed für B-163 ist weiterhin ungeklärt. Auch die Erzeugung der Basispunkte G für P-224 bis P-521 ist nach wie vor unbekannt. | Auch die Ergebnisse von KI haben Grenzen. Noch offene Fragen sollten dokumentiert werden. |
Das Rätsel um die NIST-Kurven-Seeds: Was zeigt dieser Fall?
Der ECDSA-Standard veröffentlicht für jede Kurve einen Seed. Dessen Hash wird verwendet, um den Kurvenkoeffizienten b festzulegen. Der Seed von P-256 lautet C49D3608 86E70493 6A6678E1 139D26B7 819F7E90. Da seine Herkunft nie erklärt wurde, befürchtete die Community lange, die NSA könnte Parameter mit gezielt eingebauten Schwächen ausgewählt haben. Koblitz und Menezes veröffentlichten dazu den Übersichtsartikel „A Riddle Wrapped in an Enigma“. Filippo Valsorda setzte außerdem ein Preisgeld von 36.864 US-Dollar aus. Zeitweise kursierte das Gerücht, Jerry Solinas habe den Seed aus dem Hash eines Scherzes erzeugt. Diese Behauptung stellte sich später als falsch heraus.
Das Ergebnis stärkt in der Praxis das Vertrauen in diese Kurven. Die Seeds stammen aus einem gewöhnlichen, mit einer Uhr initialisierten Pseudozufallszahlengenerator. Es gab also keinen Spielraum für eine gezielte Auswahl, und jeder kann den Vorgang reproduzieren. Im Original wird auch erwähnt, dass einige wenige ebenfalls geeignete Kurvenkandidaten übersprungen wurden. Der Grund dafür ist unbekannt. Es waren jedoch nur wenige, was nicht nach einer gezielten Auswahl schwacher Kurven aussieht. Das Preisgeld wird an die Internet Security Research Group gespendet.
Wer diesen Fall in einer wissenschaftlichen Arbeit oder in einem Seminar zitiert, sollte ihn etwa so beschreiben: „Die KI hat den Erzeugungsprozess historischer Parameter rekonstruiert und reproduzierbar gemacht.“ Formulierungen wie „Die KI hat elliptische Kurven geknackt“ sind dagegen unzutreffend.
Die vier Schritte, mit denen Claude den Seed herleitete
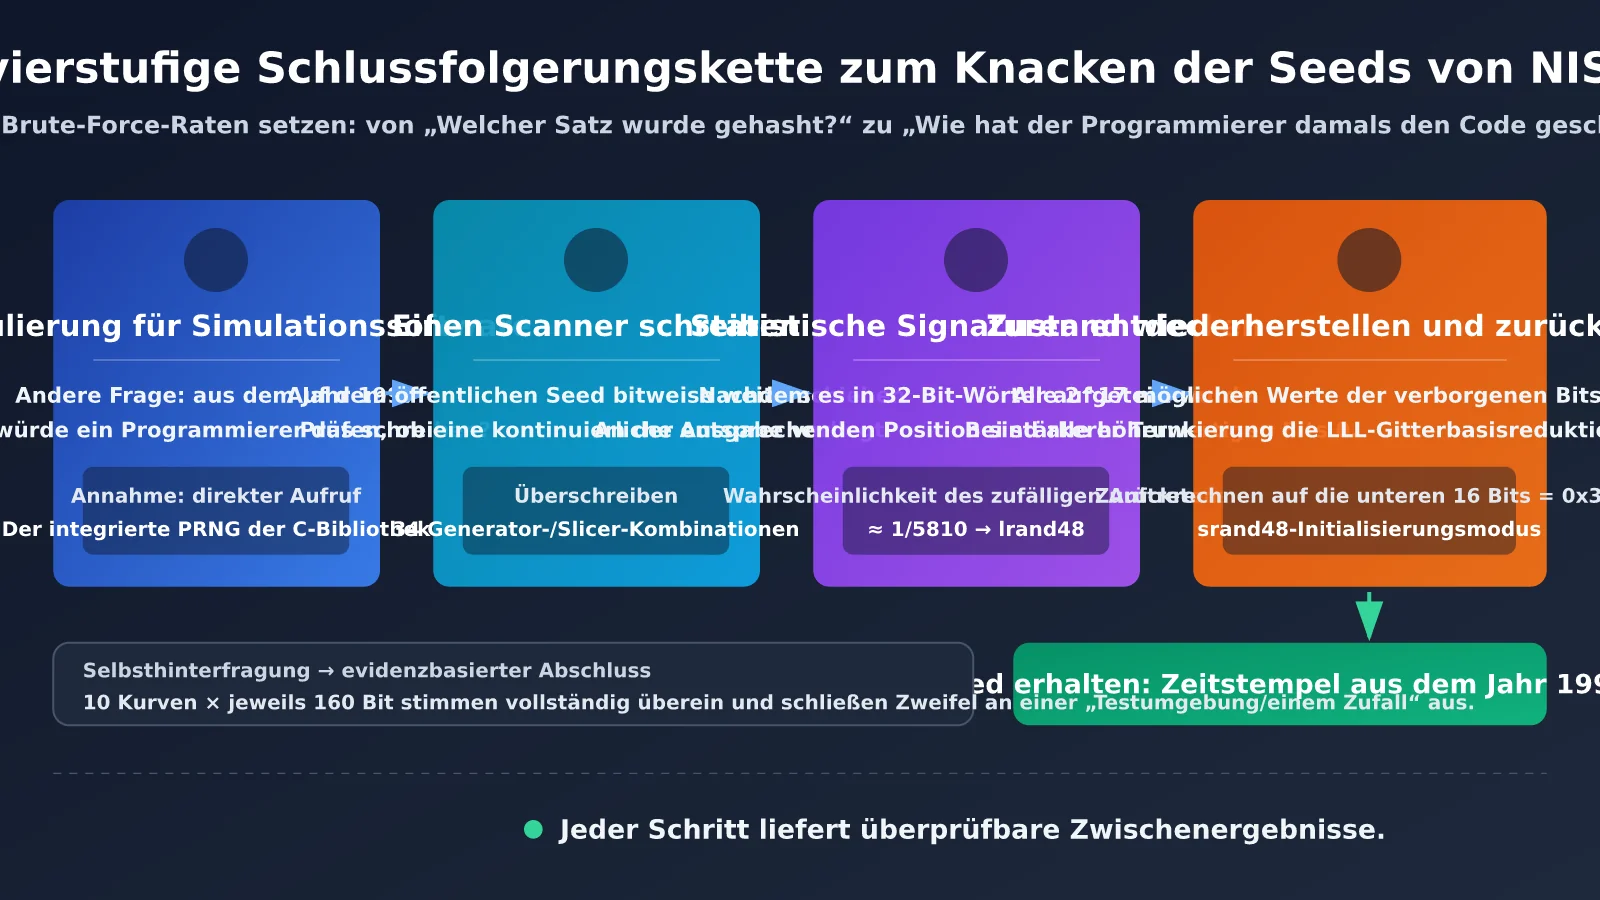
Die Schlussfolgerung beruhte nicht auf blindem Ausprobieren. Der gesamte Prozess bildet eine nachvollziehbare Beweiskette:
- Die Fragestellung ändern: Statt zu raten, „welcher Satz gehasht wurde“, wurde hergeleitet, wie jemand, der 1997 ein Programm zur Kurvenerzeugung schrieb, den Code wahrscheinlich umgesetzt hätte. Die Schlussfolgerung: Vermutlich wurde direkt der im C-Standardbibliothek enthaltene Zufallszahlengenerator verwendet.
- Einen Scanner schreiben: Die veröffentlichten Seeds wurden bitweise durchlaufen, um zu prüfen, ob benachbarte Abschnitte wie aufeinanderfolgende Ausgaben eines Generators aus den 1990er-Jahren aussahen. Insgesamt wurden 34 Kombinationen aus Generatoren und Ausschnitten untersucht.
- Eine statistische Signatur finden: Die Seeds wurden in 32-Bit-Wörter aufgeteilt. An den entsprechenden Stellen waren jeweils alle höheren Bits 0. Die Wahrscheinlichkeit, dass das zufällig auftritt, liegt bei etwa 1 zu 5810. Das passt zu
lrand48, das nur die oberen 31 Bits seines 48-Bit-Zustands zurückgibt. - Den Zustand rekonstruieren und zurückrechnen: Die 2^17 möglichen Belegungen der 17 unbekannten Bits wurden vollständig durchprobiert und anhand der folgenden Wörter überprüft. Für Seeds mit stärkeren Kürzungen kam die LLL-Gitterbasisreduktion zum Einsatz. Anschließend wurde der Zustand so weit zurückgerechnet, bis sich die Initialisierungsstruktur von
srand48zeigte: Die unteren 16 Bits waren gleich0x330E.
Ein weiteres Detail aus dem Schlussfolgerungsprozess: Das Modell fragte sich zunächst, ob es sich vielleicht in einer Testumgebung befand. Anschließend verwarf es diesen Verdacht mit dem Argument, dass es kein Zufall sein könne, wenn bei 10 Kurven jeweils alle 160 Bit übereinstimmten. Dieses Vorgehen – erst die eigene Annahme hinterfragen und dann die Beweislage sorgfältig prüfen – ist genau das, was ein Forschungsagent braucht.
Schnellstart für einen wissenschaftlichen KI-Agenten: Ein Key für den Aufruf von Spitzenmodellen
Bevor Sie loslegen, sollten Sie zunächst die API-Aufrufkette testen. APIYI bietet eine OpenAI-kompatible Schnittstelle. Mit einem Key können Sie claude-opus-5-5 aufrufen oder zu Spitzenmodellen aus den GPT- und Gemini-Familien wechseln, um Ergebnisse gegenzuprüfen.
Die Einrichtungsschritte müssen wir hier nicht wiederholen. Folgen Sie einfach der offiziellen APIYI-Schnellstartanleitung: docs.apiyi.com/getting-started. Erstellen Sie wie dort beschrieben einen Key in der Konsole, übernehmen Sie die base_url (https://api.apiyi.com/v1) und prüfen Sie anhand des Beispiels aus der Dokumentation, ob die Verbindung funktioniert. Abrechnungsmodell und verfügbare Modelle entnehmen Sie bitte der Konsole.
Die drei Anwendungsfälle weiter unten verwenden denselben kleinen Wrapper. Speichern Sie ihn als research_client.py. Er erledigt im Wesentlichen zwei Dinge: Er wählt je nach Phase ein Modell aus und summiert den Tokenverbrauch, damit sich die Kosten kontrollieren lassen.
# research_client.py
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1")
CHEAP = os.environ.get("CHEAP_MODEL", "claude-opus-5-5")  # 填控制台里的轻量模型名
FLAGSHIP = "claude-opus-5-5"
USAGE = {"prompt": 0, "completion": 0, "calls": 0}


def chat(messages, stage="draft", max_tokens=2048, temperature=0.2):
    """stage='draft' 走便宜模型;stage='verify' 走旗舰模型。"""
    r = client.chat.completions.create(model=FLAGSHIP if stage == "verify" else CHEAP,
        messages=messages, max_tokens=max_tokens, temperature=temperature)
    USAGE["prompt"] += r.usage.prompt_tokens
    USAGE["completion"] += r.usage.completion_tokens
    USAGE["calls"] += 1
    return r.choices[0].message.content


def ask(prompt, stage="draft", system=None, max_tokens=2048):
    msgs = ([{"role": "system", "content": system}] if system else []) + [{"role": "user", "content": prompt}]
    return chat(msgs, stage=stage, max_tokens=max_tokens)


def report():
    print(f"累计调用 {USAGE['calls']} 次,prompt={USAGE['prompt']},completion={USAGE['completion']}")
Kostenkontrolle für wissenschaftliche KI-Agenten: Mit einem günstigen Modell den Ablauf testen, mit einem Spitzenmodell entscheidende Ergebnisse prüfen
Forschungsaufgaben erfordern oft mehrere Iterationen. Wer von Anfang an durchgehend ein Spitzenmodell verwendet, verbraucht sein Kontingent schnell für Probleme mit geringem Nutzen, etwa Formatfehler oder fehlgeschlagene JSON-Analysen. Zuverlässiger ist es, die Modelle je nach Phase einzusetzen:
| Phase | Empfohlenes Modell | Kriterium | Typischer Wert für max_tokens |
|---|---|---|---|
| Ablauf debuggen (Eingabeaufforderungsformat, Parsing, Bewertungsfunktion) | Günstiges, leichtgewichtiges Modell | Die Pipeline läuft Ende zu Ende ohne Fehler durch | 512-1024 |
| Hypothesen entwickeln (mögliche Mechanismen auflisten) | Möglichst ein leichtgewichtiges Modell; bei unzureichender Abdeckung auf ein Spitzenmodell wechseln | Die Kandidatenliste umfasst die gängigen Hypothesen, die Ihnen bereits bekannt sind | 1024-2048 |
| Mechanismen herleiten und entscheidende Ergebnisse prüfen | claude-opus-5-5 | Das Ergebnis wird in einer Arbeit verwendet oder bestimmt den weiteren Aufwand für Experimente | 2048-4096 |
| Gegenprüfung | Mit demselben Key zu einem anderen Spitzenmodell wechseln | Beide Modelle kommen unabhängig voneinander zum selben Ergebnis | 2048 |
Als Faustregel für die Praxis gilt: Beim ersten Durchlauf eines Skripts ein günstiges Modell verwenden; sobald ein Ergebnis erstmals festgehalten wird, mit einem Spitzenmodell prüfen.
Wissenschaftliche KI-Agenten: Anwendungsfall 1 – erst Mechanismen herleiten, dann überprüfen
Dieser Schritt entspricht Claudes Ansatz, „die Frage zu verändern“: Statt direkt eine Antwort zu erraten, wird zunächst der Mechanismus hergeleitet, der die Daten erzeugt haben könnte, und anschließend anhand der Daten geprüft. Das eignet sich für Situationen, in denen experimentelle Daten ein ungewöhnliches Muster zeigen, der Entstehungsprozess historischer Daten rückwärts erschlossen werden soll oder bei der Reproduktion einer Studie die Herkunft bestimmter Parameter unklar ist.
Vorgehensweise
- Nur das Phänomen beschreiben, keine Vermutungen nennen: Geben Sie dem Modell die Beobachtungsdaten, bekannten Einschränkungen und den zeitlichen Kontext. Schreiben Sie nicht etwa „Ich glaube, XX ist die Ursache“, damit Sie das Modell nicht in eine bestimmte Richtung lenken.
- Mechanismen und falsifizierbare Vorhersagen anfordern: Zu jedem möglichen Mechanismus gehört eine Aussage dazu, welches Merkmal in den Daten auftreten müsste, wenn der Mechanismus zutrifft.
- Nach Prüfaufwand sortieren: Lassen Sie das Modell die Vorschläge nach dem benötigten Prüfaufwand von gering nach hoch ordnen. Prüfen Sie zuerst die günstigsten.
- Die Reihenfolge mit einem Spitzenmodell überprüfen: Die Kandidatenliste kann zunächst von einem günstigen Modell erstellt werden. Die endgültige Reihenfolge und Herleitung sollte claude-opus-5-5 übernehmen.
Vorlage für die Eingabeaufforderung
from research_client import ask, report

PROMPT = """你是一名严谨的研究助理。下面是一组观测数据和背景,不包含任何关于成因的线索。

【观测】
{observation}

【背景约束】
{context}

请完成:
1. 推演“产生这组数据的过程最可能怎么实现”,至少列出 5 个候选机制;
2. 每个机制给出一条可证伪预测:若成立,数据中必然出现的可检验特征;
3. 估计验证每条预测的成本(低/中/高),按成本升序输出;
4. 指出你最不确定的环节。
输出为 Markdown 表格 + 简短说明。"""

draft = ask(PROMPT.format(
    observation="NIST P-256 种子:C49D3608 86E70493 6A6678E1 139D26B7 819F7E90",
    context="1997-1998 年由政府机构用软件生成;官方未公布生成方法;常见猜测为短语哈希但未被证实",
), stage="draft")

final = ask("请审查并修正以下候选机制列表,删除无法证伪的条目,重新排序:\n" + draft,
            stage="verify", max_tokens=3000)
print(final)
report()
Ob dieser Schritt gelungen ist, lässt sich an zwei Kriterien erkennen: Hat jeder Mechanismus eine falsifizierbare Vorhersage? Lässt sich die erstplatzierte Vorhersage innerhalb einer Stunde überprüfen? Wenn auch nur eines der Kriterien nicht erfüllt ist, lassen Sie das Modell die Antwort überarbeiten.
Einsatzmöglichkeit 2 für Forschungs-AI-Agents: Scan- und Validierungsskripte schreiben lassen
Dieser Schritt entspricht dem Vorgehen, bei dem Claude selbst einen Scanner schrieb und 34 Kombinationen aus Generatoren und Slices abdeckte. Entscheidend ist, aus „sieht ähnlich aus“ die Aussage „statistisch kaum ein Zufall“ zu machen. So lassen sich etwa Parameterscans, Signalerkennung und die Suche nach verborgenen Strukturen in Daten angehen.
Vorgehensweise
- Gib dem Modell eine Vorhersage aus der ersten Einsatzmöglichkeit, die sich möglichst einfach überprüfen lässt. Bitte es, ein Scan-Skript zu schreiben, das nur die Standardbibliothek verwendet.
- Lass das Skript zugleich eine Reihe von Zufallskontrollen ausführen und sowohl die „Trefferquote bei echten Daten“ als auch die „Trefferquote bei Zufallsdaten“ ausgeben.
- Führe das Skript lokal aus. Das Modell soll nur den Code schreiben, nicht die Ergebnisse berichten.
- Sind die Ergebnisse signifikant, kannst du anschließend ein Spitzenmodell bitten, ein anspruchsvolleres Skript zur Zustandsrekonstruktion oder Anpassung zu schreiben.
Beispiel: Eine statistische Signatur wie „alle höchstwertigen Bits sind 0“ reproduzieren
Das folgende Skript veranschaulicht das Prinzip hinter der Signatur in diesem Fall. lrand48 gibt die oberen 31 Bits eines 48-Bit-Zustands zurück. Wird der Wert in einem 32-Bit-Wort gespeichert, ist das höchstwertige Bit daher immer 0. Bei echten Zufallsdaten liegt die Wahrscheinlichkeit, dass das höchstwertige Bit 0 ist, dagegen nur bei 50 Prozent.
import os

def lrand48_stream(seed32, n):
    x = (seed32 << 16) | 0x330E          # srand48 初始化:低 16 位固定为 0x330E
    out = []
    for _ in range(n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        out.append(x >> 17)               # lrand48 只返回高 31 位
    return out

def top_bit_zero_ratio(words):
    return sum(1 for w in words if w >> 31 == 0) / len(words)

lr = lrand48_stream(870000000, 20)        # 1997 年前后的某个 Unix 时间戳
rnd = [int.from_bytes(os.urandom(4), "big") for _ in range(20)]
print("lrand48 最高位为 0 的比例:", top_bit_zero_ratio(lr))   # 恒为 1.0
print("真随机  最高位为 0 的比例:", top_bit_zero_ratio(rnd))  # 约 0.5 上下波动
Das endgültige Ergebnis mit dem offiziellen Code überprüfen
Die Forschungsseite von Anthropic enthält Reproduktionscode, der unter der CC0-Lizenz veröffentlicht wurde. Laut offizieller Anleitung sollte diese Parameterkombination den Seed aus dem P-256-Standard ausgeben:
from datetime import datetime, timezone

def unix(when):
    return int(datetime.fromisoformat(when).replace(tzinfo=timezone.utc).timestamp())

def candidate(t, n, per, shift, width):
    x, out = (t << 16) | 0x330E, ""
    for i in range(per * n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        if i >= per * (n - 1):
            out += "%0*X" % (width, x >> shift)
    return out

seed = candidate(unix("1997-08-16 01:52:34"), 1842, 20, 40, 2)
print(seed)
print("与标准一致:", seed == "C49D360886E704936A6678E1139D26B7819F7E90")
Das Skript initialisiert lrand48 mit einem Zeitstempel und fasst jeweils 20 Ausgaben zu einem 20 Byte langen Seed-Kandidaten zusammen. Der 1842. Kandidat ist der Seed aus dem Standard. Die gesamte Überprüfung lässt sich auf einem gewöhnlichen Laptop in weniger als einer Sekunde ausführen. „Hypothesen aufzustellen ist teuer, ihre Überprüfung billig“ – genau so sieht die ideale Struktur für Forschungsaufgaben dieser Art aus.
Einsatzmöglichkeit 3 für Forschungs-AI-Agents: Mit einem automatischen Bewertungsprogramm iterieren, bis sich die Ergebnisse stabilisieren
Bei den ersten beiden Einsatzmöglichkeiten beurteilt ein Mensch die Ergebnisse. Bei der dritten übernimmt das ein Programm. Du schreibst ein Bewertungsprogramm, das Modell reicht in jeder Runde einen Lösungsvorschlag ein, und das Programm gibt eine Punktzahl sowie fehlerhafte Beispiele zurück. Das Modell überarbeitet daraufhin seinen Vorschlag, bis sich die Punktzahl nicht mehr verbessert. Diese Methode eignet sich für Aufgaben mit klaren Bewertungskriterien, etwa Datenextraktionsregeln, Funktionsanpassungen oder die Suche nach Versuchsparametern.
Vorgehensweise
- Schreibe zuerst das Bewertungsprogramm, erst danach suchst du ein Modell aus: Das Bewertungsprogramm muss deterministisch sein und darf sich nicht vom Modell selbst bewerten lassen.
- Teile die Daten in Entwicklungs- und Holdout-Daten auf: Das Feedback basiert nur auf den Entwicklungsdaten. Zum Schluss prüfst du anhand der Holdout-Daten, ob eine Überanpassung vorliegt.
- Begrenze das Format der Einreichungen: Lass das Modell Daten wie JSON oder reguläre Ausdrücke liefern, statt direkt generierten Code auszuführen. Falls die Ausführung von Code nötig ist, muss sie in einer Sandbox stattfinden.
- Lege Abbruchkriterien fest: Beende den Prozess, sobald eines der folgenden Kriterien erfüllt ist: volle Punktzahl, zwei Runden in Folge ohne Verbesserung oder Erreichen der maximalen Rundenzahl.
- Teste den Ablauf zunächst mit einem günstigen Modell und wechsle für die eigentlichen Experimente anschließend zu einem Spitzenmodell.
Beispiel: Iteration regulärer Ausdrücke zur Extraktion von Parametern aus Versuchsprotokollen
import json, re
from research_client import chat, report

DEV = [
    ("样品A在 350 ℃ 退火 2 小时后测得电导率 4.1 S/m。", {"temp_c": 350, "hours": 2, "cond": 4.1}),
    ("退火温度 420°C,保温 1.5 h,电导率为 12.3 S/m。", {"temp_c": 420, "hours": 1.5, "cond": 12.3}),
    ("B组:300摄氏度下处理 3 小时,σ=0.85 S/m。", {"temp_c": 300, "hours": 3, "cond": 0.85}),
    ("在450 ℃条件下退火4h,测得电导率 20 S/m。", {"temp_c": 450, "hours": 4, "cond": 20}),
]
HOLDOUT = [
    ("样品E 380 ℃ 退火 2.5 小时,电导率 7.6 S/m。", {"temp_c": 380, "hours": 2.5, "cond": 7.6}),
    ("C组于 500°C 保温 0.5 h,σ = 33.1 S/m。", {"temp_c": 500, "hours": 0.5, "cond": 33.1}),
]
FIELDS = ["temp_c", "hours", "cond"]

def score(patterns, data):
    hit, fails = 0, []
    for idx, (text, label) in enumerate(data):
        for f in FIELDS:
            try:
                m = re.search(patterns.get(f, "(?!)"), text)
                ok = m is not None and abs(float(m.group(1)) - label[f]) < 1e-9
            except (re.error, IndexError, ValueError, TypeError):
                ok = False
            hit += ok
            if not ok:
                fails.append(f"样本{idx} 字段{f} 抽取失败:{text}")
    return hit / (len(data) * len(FIELDS)), fails

def parse_json(text):
    return json.loads(text[text.find("{"): text.rfind("}") + 1])

messages = [{"role": "user", "content":
    "为下列实验记录写 Python 正则,抽取 temp_c、hours、cond 三个字段,每个正则恰好一个捕获组,捕获纯数字。"
    "只输出 JSON,例如 {\"temp_c\": \"...\", \"hours\": \"...\", \"cond\": \"...\"},注意转义反斜杠。\n"
    + "\n".join(t for t, _ in DEV)}]

best, stale, patterns = -1.0, 0, {}
for rnd in range(6):
    reply = chat(messages, stage="draft", max_tokens=800)   # 跑通后把 stage 改为 "verify"
    try:
        patterns = parse_json(reply)
        s, fails = score(patterns, DEV)
    except (ValueError, json.JSONDecodeError):
        s, fails = 0.0, ["输出不是合法 JSON"]
    print(f"第 {rnd + 1} 轮 开发集得分 {s:.2f}")
    if s >= 1.0:
        break
    stale = stale + 1 if s <= best else 0
    best = max(best, s)
    if stale >= 2:
        break
    messages += [{"role": "assistant", "content": reply},
                 {"role": "user", "content": "以下抽取失败,请修改正则后重新输出完整 JSON:\n" + "\n".join(fails)}]

print("留出集得分:", score(patterns, HOLDOUT)[0])
report()
Wichtig: Erzielt das Modell auf den Entwicklungsdaten die volle Punktzahl, schneidet auf den Holdout-Daten aber deutlich schlechter ab, deutet das darauf hin, dass es die Antworten „auswendig gelernt“ hat. In diesem Fall solltest du die Entwicklungsdaten erweitern, statt einfach weiter zu iterieren.
Vergleich der drei Einsatzmöglichkeiten für Forschungs-AI-Agents
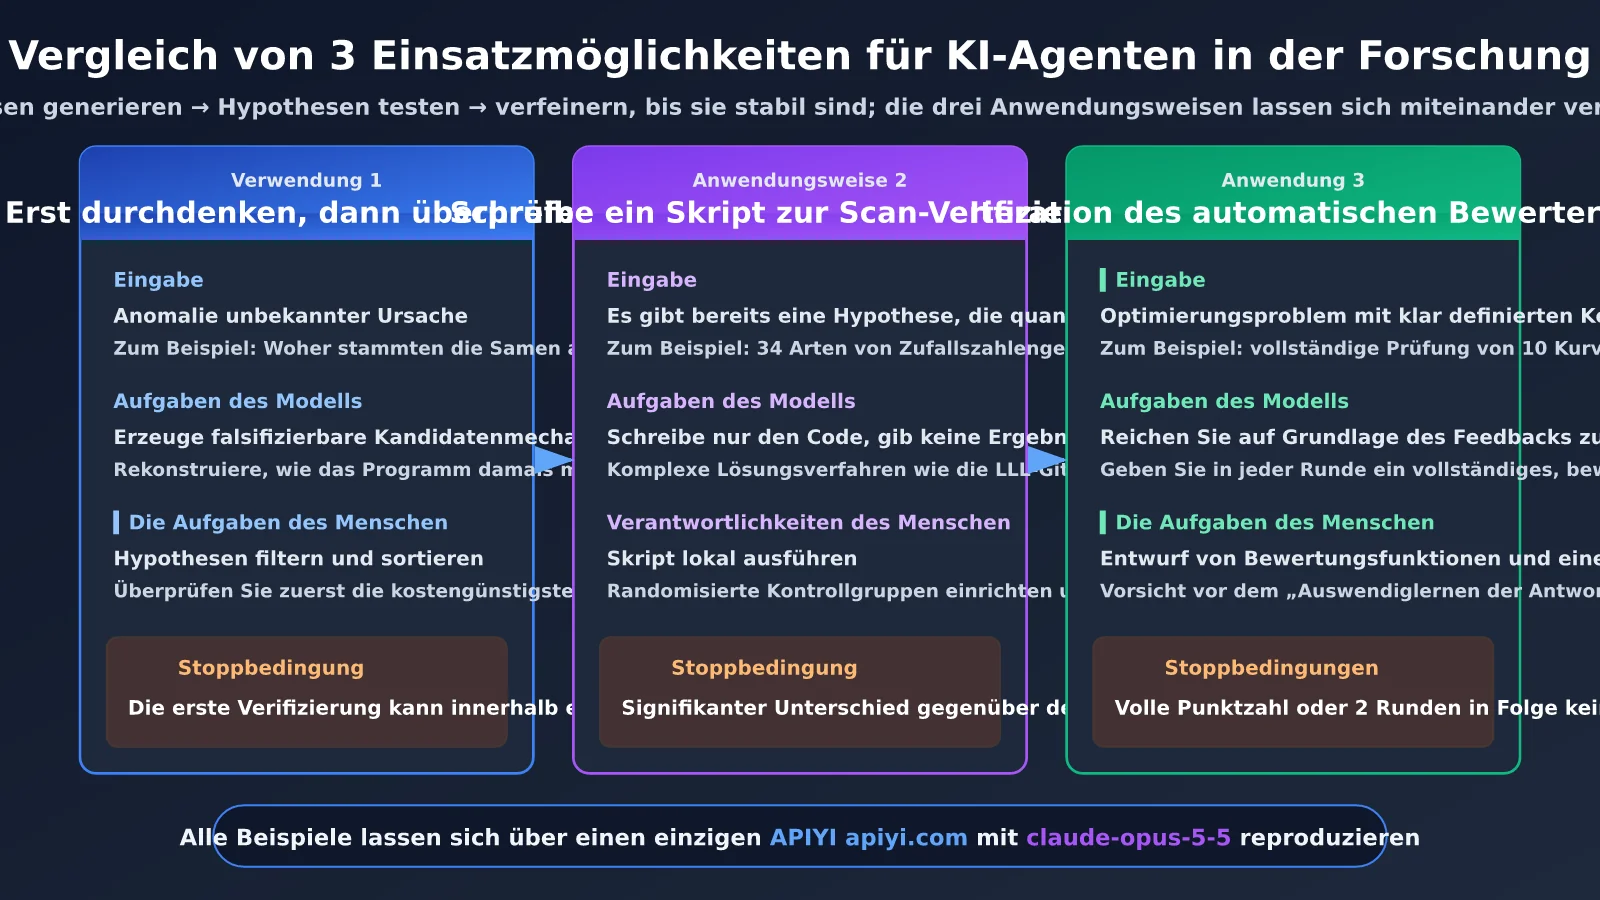
| Dimension | Einsatzmöglichkeit 1: Mechanismus herleiten | Einsatzmöglichkeit 2: Scan- und Validierungsskript | Einsatzmöglichkeit 3: Automatische Bewertungsiteration |
|---|---|---|---|
| Entsprechender Schritt im Fallbeispiel | Herleitung, wie das Programm 1997 geschrieben wurde | 34 Generatoren scannen und statistische Signaturen finden | Nach der Zustandsrekonstruktion alle 10 Kurven vollständig überprüfen |
| Geeignete Aufgaben | Anomalien mit unbekannter Ursache, Rückschlüsse durch Reverse Engineering | Eine Hypothese liegt vor und soll quantitativ überprüft werden | Optimierungsprobleme mit klaren Kennzahlen |
| Aufgabe des Modells | Falsifizierbare Mechanismen vorschlagen | Code schreiben, keine Ergebnisse berichten | Wiederholt Lösungsvorschläge einreichen |
| Aufgabe des Menschen | Hypothesen auswählen und priorisieren | Lokal ausführen und die Kontrollgruppe prüfen | Bewertungsprogramm und Holdout-Daten entwerfen |
| Einsatzpunkt des Spitzenmodells | Abschließende Herleitung und Priorisierung | Anspruchsvolle Berechnungen umsetzen, etwa LLL | Formelle Experimentrunden |
| Abbruchkriterium | Die erste Überprüfung lässt sich innerhalb einer Stunde abschließen | Deutlicher Unterschied zur Zufallskontrolle | Volle Punktzahl oder zwei Runden ohne Verbesserung |
| Aufruf | Einheitliche Schnittstelle von APIYI auf apiyi.com | Ebenso | Ebenso |
Die drei Einsatzmöglichkeiten lassen sich miteinander kombinieren: Die erste liefert Hypothesen, die zweite überprüft sie, und die dritte verfeinert die bestätigten Lösungen, bis sie stabil sind.
Warum für wissenschaftliche Aufgaben wie diese ein Spitzenmodell nötig ist
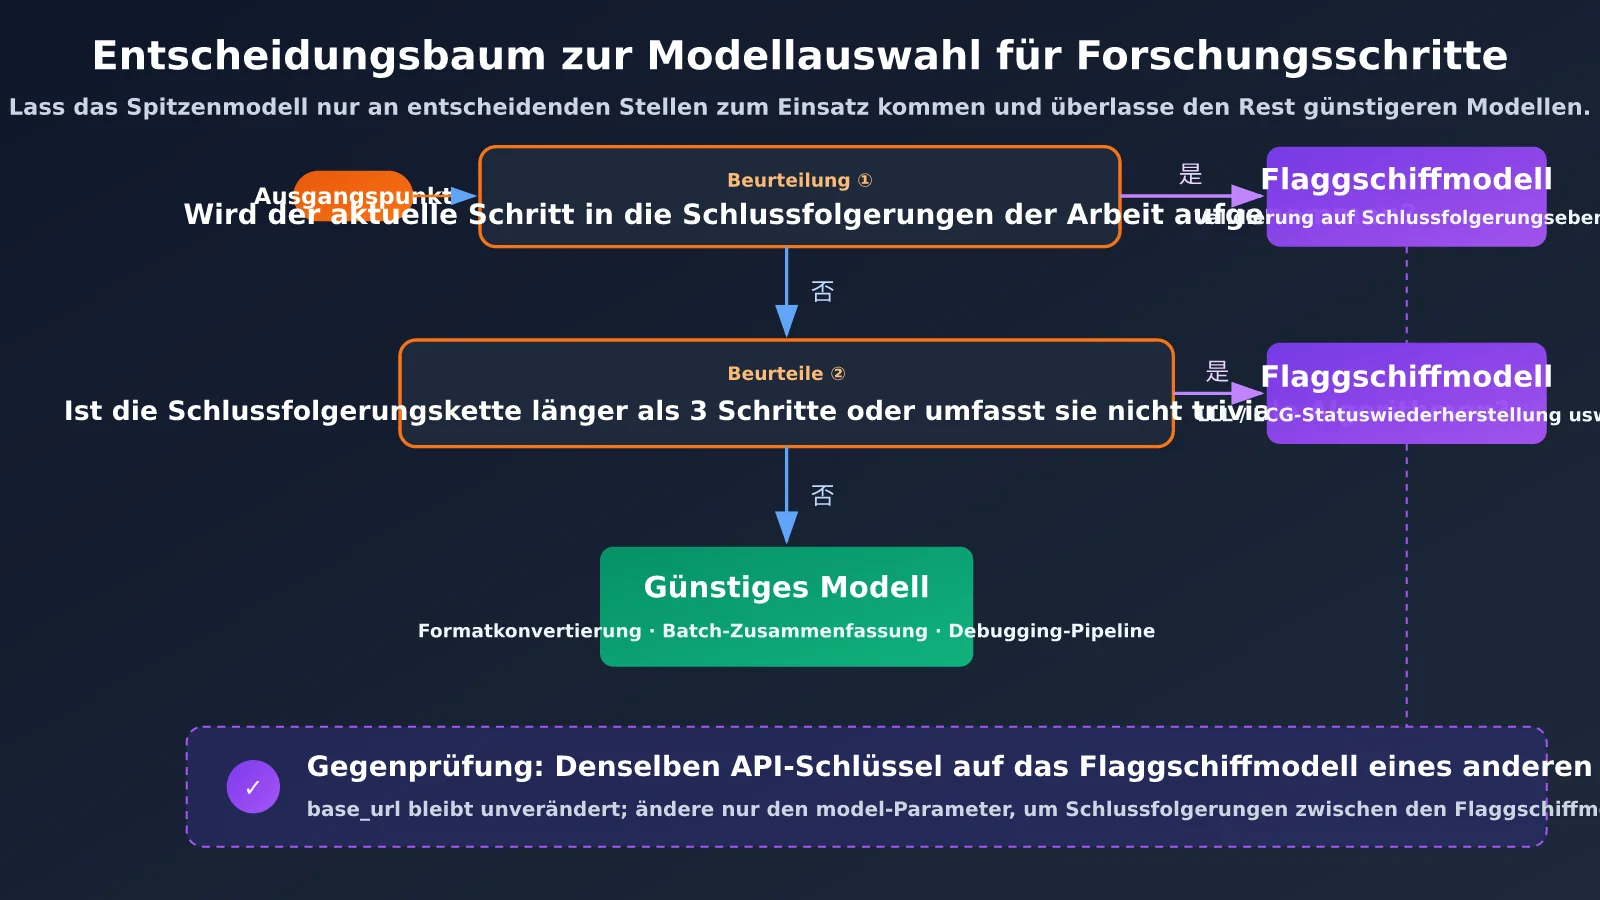
Nicht jeder Schritt in der Forschung erfordert ein Spitzenmodell. Es gibt jedoch Aufgaben, die mit einem kleineren Modell kaum zu bewältigen sind. Mit der folgenden Tabelle können Sie einschätzen, wann sich ein Spitzenmodell empfiehlt:
| Kriterium | Spitzenmodell empfohlen, wenn … | Grund |
|---|---|---|
| Verknüpfungen zwischen Fachgebieten nötig sind | Sie zum Beispiel von einem „Kurven-Seed“ auf Implementierungsdetails einer C-Bibliothek aus den 1990er-Jahren schließen müssen | Kleinere Modelle bleiben eher an der Oberfläche der Frage hängen und raten beispielsweise weiter nach passenden Wortgruppen |
| Die Schlussfolgerungskette mehr als 3 Schritte umfasst und jeder Schritt vom vorherigen abhängt | Sie zum Beispiel eine Hypothese ableiten → scannen → signieren → den Zustand wiederherstellen | Wenn ein Zwischenschritt falsch ist, weichen auch alle folgenden Schritte ab |
| Selbstkritik gefragt ist | Sie zum Beispiel hinterfragen müssen: „Teste ich gerade vielleicht in einer Testumgebung?“ | Spitzenmodelle suchen eher aktiv nach Gegenbeispielen |
| Nichttriviale Algorithmen zum Einsatz kommen | Sie zum Beispiel eine LLL-Gitterreduktion oder die Wiederherstellung eines abgeschnittenen LCG-Zustands durchführen | Die Korrektheit des Codes entscheidet unmittelbar darüber, ob die Verifikation gültig ist |
| Das Ergebnis in eine Veröffentlichung einfließt oder über den Aufwand für Experimente entscheidet | Bei allen Ergebnissen, die veröffentlicht werden | Die Folgen eines Fehlers wiegen deutlich schwerer als die Kosten des Modellaufrufs |
Für Aufgaben wie Formatkonvertierung, Zusammenfassungen in großer Zahl oder das Debuggen einer Evaluator-Pipeline reicht dagegen ein günstigeres Modell aus. Der Schlüssel zur Kostenkontrolle liegt nicht darin, Spitzenmodelle seltener zu verwenden, sondern sie gezielt dort einzusetzen, wo sie in der Tabelle empfohlen werden.
Häufig gestellte Fragen (FAQ)
F1: Hat Claude die NIST-Elliptic-Curve-Kryptografie geknackt?
Nein. Claude hat den Prozess zur Erzeugung des Seeds rekonstruiert. Der Seed stammte von lrand48, das mit einem Zeitstempel initialisiert wurde. Das ist keine neue Angriffsmethode und stellt keine Sicherheitslücke dar. Nutzer müssen weder ihre Konfiguration ändern noch migrieren. Die Schlussfolgerung zeigt vielmehr, dass der Seed nicht gezielt ausgewählt wurde.
F2: Worin unterscheidet sich diese Methode von einer herkömmlichen Brute-Force-Suche?
Bei einer Brute-Force-Suche wird ein festgelegter Hypothesenraum vollständig durchprobiert. Claude wechselte zunächst den Hypothesenraum: Statt zu fragen, „welcher Satz gehasht wurde“, fragte das Modell, „welcher Zufallszahlengenerator verwendet wurde“. Erst danach folgte eine begrenzte vollständige Suche über 2^17 versteckte Bits. Entscheidend für den Erfolg war der erste Schritt.
F3: Wann wurde die Studie veröffentlicht, und welche Fragen sind noch offen?
Die Forschungsseite von Anthropic und der Beitrag von @AnthropicAI wurden beide am 17. Oktober 2026 veröffentlicht. Der Seed von B-163 konnte bisher nicht entschlüsselt werden. Auch die Erzeugungsmethode des Basispunkts G für P-224 bis P-521 ist unklar. Außerdem wurden einige wenige Kurvenkandidaten übersprungen, ohne dass der Grund dafür bekannt ist.
F4: Für welche Forschungsszenarien eignen sich diese drei Anwendungsweisen?
– **Ursachenanalyse bei Experimentabweichungen**: Wenn Instrumentendaten periodische Artefakte aufweisen, können Sie mit Anwendungsweise eins die Implementierung der Erfassungssoftware ableiten.
– **Historische Studien reproduzieren**: Wenn Parameter fehlen, können Sie mit Anwendungsweise zwei mögliche Parameterkombinationen durchsuchen.
– **Daten extrahieren und bereinigen**: Mit Anwendungsweise drei und einem Evaluator lassen sich durch iterative Anpassungen stabile Regeln entwickeln.
F5: Wie kann ich mit einem einzigen Key mehrere Spitzenmodelle zur Gegenprüfung aufrufen?
Registrieren Sie sich bei APIYI unter apiyi.com und erstellen Sie einen Key. Setzen Sie `base_url` auf `https://api.apiyi.com/v1`. Anschließend können Sie zwischen claude-opus-5-5 sowie Spitzenmodellen aus den GPT- und Gemini-Familien wechseln, indem Sie nur den Parameter `model` ändern. Maßgeblich sind die Modellnamen in der Konsolenliste.
F6: Welche bekannten Einschränkungen haben wissenschaftliche KI-Agenten?
– Modelle können plausibel klingende Mechanismen erfinden. Deshalb braucht jede Schlussfolgerung ein lokal ausführbares Validierungsskript.
– Bei iterativen Anpassungen eines Evaluators besteht die Gefahr, dass er sich zu stark an den Entwicklungsdatensatz anpasst. Ein zurückgehaltener Datensatz muss daher erhalten bleiben.
– Die Kosten mehrerer Aufrufe summieren sich. Bringen Sie den Ablauf zunächst mit einem günstigeren Modell zum Laufen und protokollieren Sie dabei den Verbrauch. Die Abrechnung lässt sich in der Konsole von APIYI unter apiyi.com einsehen.
Kernpunkte für forschungsorientierte KI-Agenten: die wichtigsten Erkenntnisse
- Grenzen der Schlussfolgerungen: Claude hat die Herkunft des Seeds rekonstruiert, keine kryptografische Schwachstelle gefunden. Das Vertrauen in die Kurve ist dadurch sogar gestiegen.
- Der entscheidende Schritt: Den Hypothesenraum zu wechseln ist wirksamer, als im alten Raum einfach mehr Rechenleistung einzusetzen.
- Verifikation hat Vorrang: Das Modell schreibt die Skripte, der Mensch führt sie aus. Die Ergebnisse werden immer mit einer Zufallsbaseline verglichen.
- Geschlossener Bewertungsprozess: Ein deterministischer Bewertungsmechanismus und ein zurückgehaltener Datensatz ermöglichen es, so lange zu iterieren, bis die Werte konvergieren. Dann wird gestoppt.
- Modelle gezielt einsetzen: Günstige Modelle helfen dabei, den Ablauf zum Laufen zu bringen. Spitzenmodelle kommen nur bei entscheidenden Schlussfolgerungen und Verifikationen zum Einsatz.
- Einstieg: Über APIYI apiyi.com lässt sich Claude Opus 5.5 mit einem einzigen API-Schlüssel aufrufen. Für Gegenprüfungen können Sie zu anderen Modellen wechseln.
Zusammenfassung
Dass Claude das Rätsel um den NIST-Elliptic-Curve-Seed gelöst hat, liefert Forschenden vor allem drei Erkenntnisse:
- Zuerst den Mechanismus nachvollziehen: Fragen Sie, wie die Daten entstanden sind, statt direkt die Antwort zu erraten.
- Skripte sprechen lassen: Zu jeder Hypothese gehören ausführbarer Prüfcode und ein Zufallsvergleich.
- Einen geschlossenen Bewertungsprozess schaffen: Überlassen Sie die Beurteilung einem deterministischen Programm, iterieren Sie bis zur Konvergenz und prüfen Sie mit einem zurückgehaltenen Datensatz, ob eine Überanpassung vorliegt.
Die Kostenkontrolle bleibt dabei eine Grundvoraussetzung: Bringen Sie den Ablauf zunächst mit einem günstigen Modell zum Laufen. Bei Schritten, die Schlussfolgerungen für wissenschaftliche Arbeiten oder komplexe Algorithmen betreffen, wechseln Sie anschließend zu einem Spitzenmodell. Wir empfehlen, den vollständigen Code aus diesem Artikel über APIYI apiyi.com auszuführen: Bestätigen Sie zunächst mit dem offiziellen Reproduktionscode den P-256-Seed und übertragen Sie dann die drei Anwendungsweisen auf Ihr eigenes Forschungsthema.
Weiterführende Artikel
- 📘 Claude-Modelle mit dem OpenAI SDK aufrufen – Die Unterschiede bei den Parametern kompatibler Schnittstellen kennenlernen
- 📊 Kostenkontrolle bei API-Aufrufen großer Sprachmodelle – usage-Statistiken und Budgetwarnungen nutzen
- 🚀 Workflows zur gegenseitigen Überprüfung durch mehrere Modelle einrichten – Ergebnisse von verschiedenen Spitzenmodellen abgleichen lassen
📚 Referenzen
- Anthropic Frontier Red Team Research-Seite: Studie zur Herkunft des ECDSA-Kurvensamens
- Link:
www.anthropic.com/research/ecdsa-curve-origins -
Hinweis: Primärquelle mit vollständiger Methodik, offenen Fragen und CC0-Reproduktionscode
-
Offizieller X-Beitrag von @AnthropicAI (17.10.2026): „Es sind einfach Zeitstempel.“
- Link:
x.com/AnthropicAI -
Hinweis: Offizielle Stellungnahme; die Diskussion in der Community können Sie dort verfolgen
-
APIYI-Dokumentationszentrum: Anleitung zu Aufrufen über die OpenAI-kompatible Schnittstelle
- Link:
docs.apiyi.com - Hinweis: Informationen zur Konfiguration von
base_url, zu den verfügbaren Modellen und zur Abrechnung
Autor: Das technische Team von APIYI
Technischer Austausch: Teilen Sie in den Kommentaren gern, wie Sie KI-Agenten in Ihrer Forschung einsetzen. Weitere Informationen zur Anbindung finden Sie im APIYI-Dokumentationszentrum unter docs.apiyi.com.