Примечание автора: разбираем, как Claude выяснил происхождение начальных значений эллиптических кривых NIST, обозначаем границы этого вывода и показываем три способа применять AI Agent в исследованиях — с готовым кодом и рекомендациями по контролю затрат.
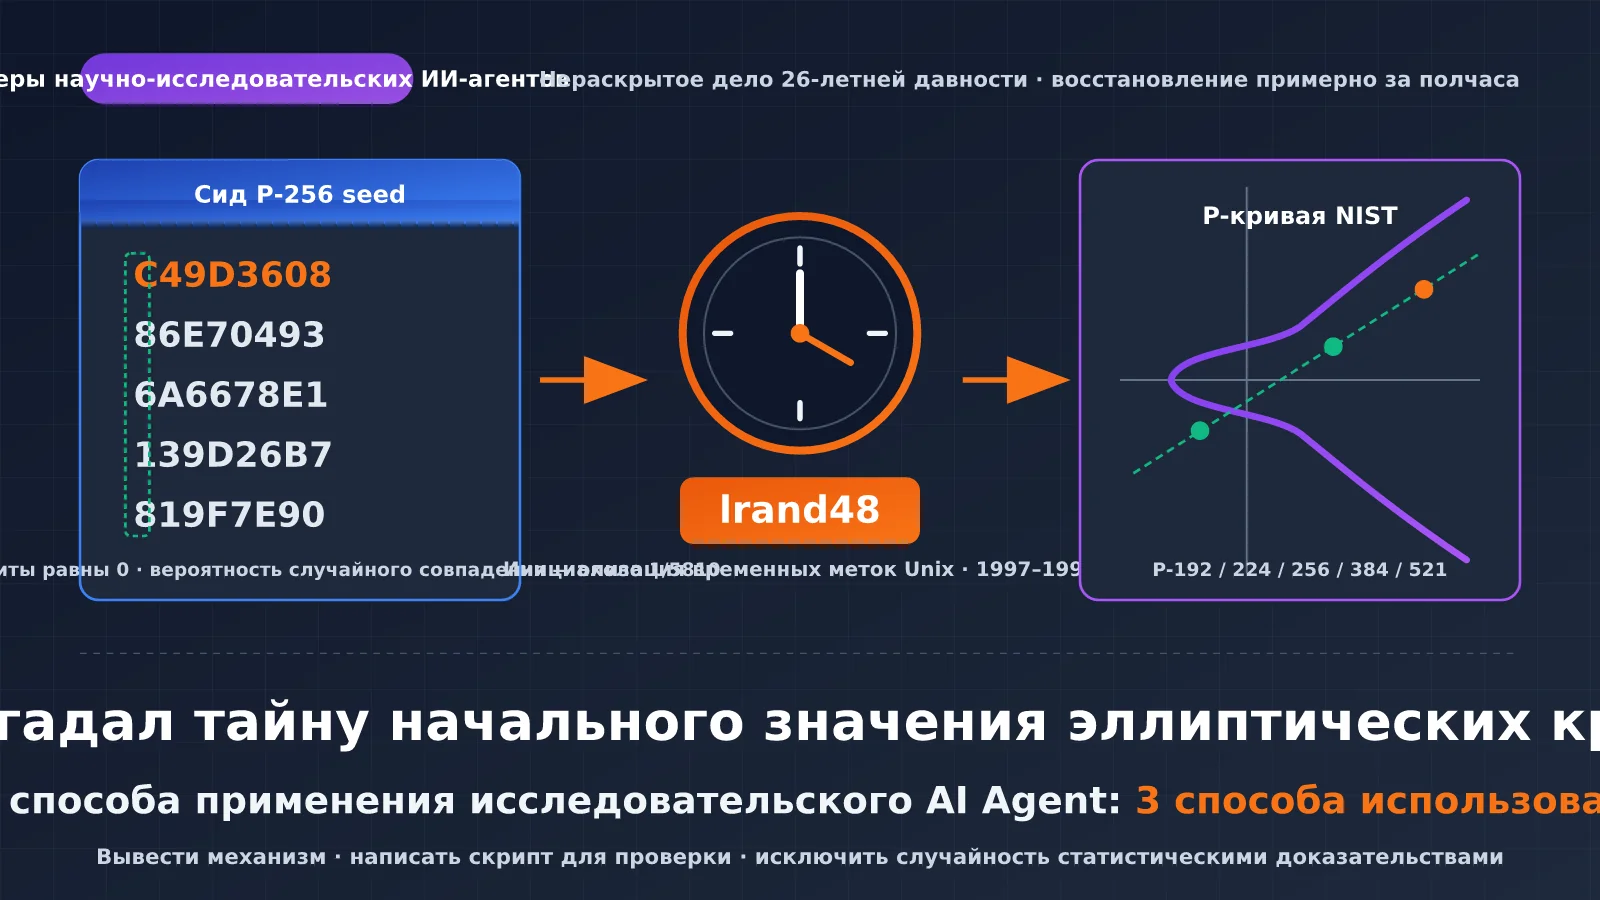
17 октября 2026 года команда Anthropic Frontier Red Team опубликовала исследование: внутренняя исследовательская модель примерно за полчаса и без каких-либо подсказок вывела способ генерации начальных значений для пяти кривых NIST: P-192, P-224, P-256, P-384 и P-521. Эти значения не пропускали через хеш-функции: они оказались результатами работы генератора псевдослучайных чисел lrand48, встроенного в библиотеки C ещё в 1990-х годах. Начальным значением служила временная метка Unix. В официальном посте @AnthropicAI была всего одна фраза: «Это просто временные метки». Пост набрал около 855 тысяч просмотров.
Это не взлом криптографии и не новая уязвимость. Для исследователей ценность этого случая — в подходе Claude: вывести возможный механизм, написать скрипт для проверки и с помощью статистических данных исключить случайное совпадение. Этот процесс можно применить и в собственных исследованиях.
Главное: прочитав статью, вы поймёте, что именно доказывает этот случай, а чего он не доказывает. Кроме того, вы получите три готовых рабочих процесса с исследовательскими AI Agent — с пошаговыми инструкциями и исполняемым кодом.
Как Claude разгадал загадку сидов эллиптических кривых NIST: главное
| Главное | Пояснение | Что это значит для исследователей |
|---|---|---|
| Предыстория загадки | В 2000 году NIST включил ECDSA в стандарт FIPS 186-2. Сиды кривых предоставило АНБ, но откуда они взялись — не объяснили | Загадка, которую не могли решить 26 лет, стала проверкой способности ИИ к рассуждению |
| Вывод | Сиды получены из выходных данных lrand48, инициализированного временными метками за период с мая 1997-го по апрель 1998 года |
Вывод может воспроизвести любой желающий, причём проверка требует совсем немного усилий |
| Ключевой метод | Восстановить вероятный подход к написанию программы, создать сканер, найти статистическую закономерность и восстановить состояние генератора | Эти три шага можно применять для анализа экспериментальных данных, обратного моделирования и других задач |
| Последствия для безопасности | Это не уязвимость: пользователям не нужно менять настройки или переходить на другие кривые | В обзорах и отчётах важно точно описывать результат и не преувеличивать его значение |
| Что осталось неизвестным | Источник сида B-163 не установлен, а способ генерации базовой точки G для кривых P-224 — P-521 всё ещё неясен | У выводов ИИ тоже есть границы: нерешённые вопросы нужно фиксировать |
Загадка сидов эллиптических кривых NIST: что удалось доказать
В стандарте ECDSA для каждой кривой опубликован сид, хеш которого используется для вычисления коэффициента кривой b. Сид P-256 — C49D3608 86E70493 6A6678E1 139D26B7 819F7E90. Поскольку источник сида никогда не объясняли, в сообществе давно опасались, что АНБ могло специально подобрать параметры со слабым местом. Koblitz и Menezes написали обзор «A Riddle Wrapped in an Enigma», а Filippo Valsorda даже объявил награду в 36 864 доллара за решение загадки. Некоторое время ходил слух, что Jerry Solinas получил сид, захешировав шутливую фразу. Позже выяснилось, что это неверно.
Практический результат этой работы — рост доверия к этим кривым. Сиды получены с помощью обычного генератора псевдослучайных чисел, инициализированного системными часами, поэтому возможности для ручного подбора не было. Результат может воспроизвести любой желающий. В исходном материале также отмечается, что пропустили небольшое число других подходящих кривых, но причина неизвестна. Таких кривых было мало — это не похоже на преднамеренный выбор слабых параметров. Призовые деньги пожертвуют Internet Security Research Group.
В статье или на научном семинаре точнее всего сформулировать результат так: «ИИ восстановил процесс генерации исторических параметров и сделал его воспроизводимым». Не стоит писать, что «ИИ взломал эллиптические кривые».
Четыре шага, с помощью которых Claude восстановил происхождение сида
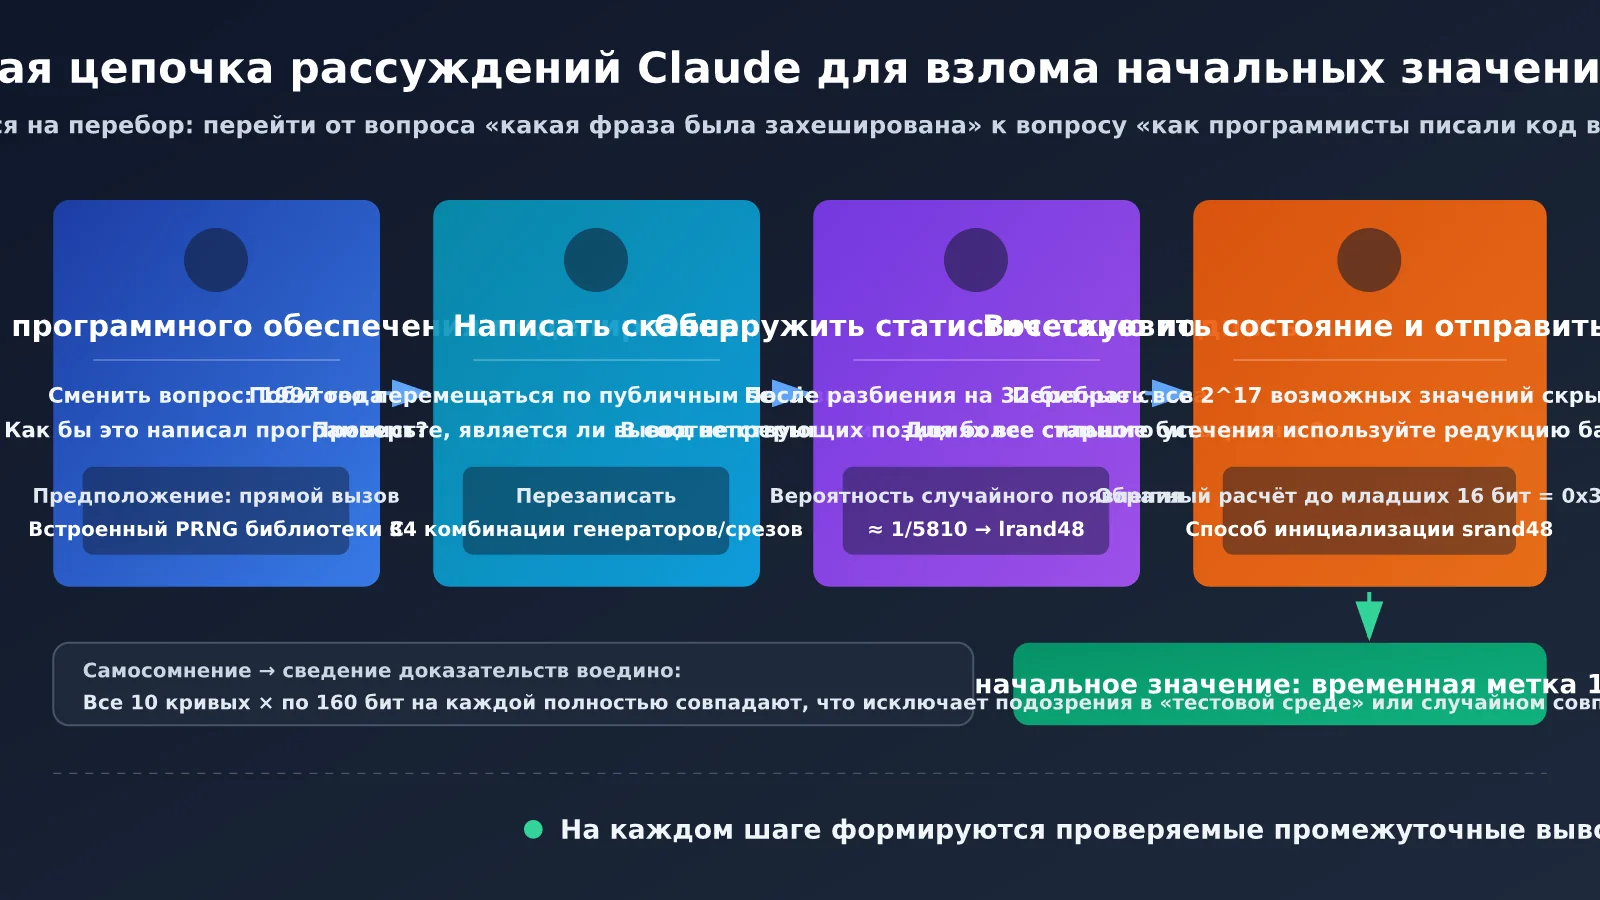
Решение не было результатом перебора наугад. Это последовательная цепочка рассуждений, в которой можно проверить каждый шаг:
- Переосмыслить задачу: вместо догадок о том, «какую фразу захешировали», предположить, как мог написать программу генерации кривых разработчик в 1997 году. Вывод: скорее всего, он воспользовался встроенным генератором случайных чисел из библиотеки C.
- Написать сканер: сдвигаясь по опубликованному сиду побитно, проверять, похожи ли соседние фрагменты на последовательные выходные данные генератора из 1990-х. Всего проверили 34 сочетания генераторов и способов нарезки данных.
- Найти статистическую закономерность: после разбиения сида на 32-битные слова старшие биты в соответствующих позициях оказались нулевыми. Вероятность случайного совпадения — примерно 1 к 5810. Это соответствует особенностям
lrand48, который возвращает 31 старший бит 48-битного состояния. - Восстановить состояние и отмотать его назад: перебрать 2^17 вариантов 17 скрытых битов и проверить результат по следующим словам. Для сидов с большим числом усечённых битов применить редукцию базиса решётки LLL. Затем прокрутить состояние назад до начальной формы
srand48, в которой младшие 16 бит равны0x330E.
В ходе рассуждений модель также на какое-то время заподозрила, что работает в тестовой среде. От этого предположения она отказалась после проверки: совпадение всех 160 бит для 10 кривых невозможно объяснить случайностью. Именно такой подход — сначала усомниться в собственном выводе, а затем устранить сомнения с помощью доказательств — особенно важен для научных ИИ-агентов.
Быстрый старт с научным AI-агентом: одна API-ключ для вызова флагманской модели
Прежде чем приступать к работе, проверьте, что вся цепочка вызова API работает. APIYI предоставляет совместимый с OpenAI интерфейс: с одним API-ключом можно вызывать claude-opus-5-5, а также переключаться на флагманские модели семейства GPT или Gemini для перекрёстной проверки.
Не будем повторять здесь шаги подключения — воспользуйтесь официальной документацией APIYI по быстрому старту: docs.apiyi.com/getting-started. Создайте API-ключ в консоли, получите base_url (https://api.apiyi.com/v1) и выполните пример из документации, чтобы убедиться, что всё работает. Условия оплаты и доступные модели уточняйте в консоли.
В следующих трёх сценариях используется одна небольшая обёртка. Сохраните её в research_client.py. Она делает всего две вещи: выбирает модель для каждого этапа и суммирует расход токенов для контроля затрат.
# research_client.py
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1")
CHEAP = os.environ.get("CHEAP_MODEL", "claude-opus-5-5")  # 填控制台里的轻量模型名
FLAGSHIP = "claude-opus-5-5"
USAGE = {"prompt": 0, "completion": 0, "calls": 0}


def chat(messages, stage="draft", max_tokens=2048, temperature=0.2):
    """stage='draft' 走便宜模型;stage='verify' 走旗舰模型。"""
    r = client.chat.completions.create(model=FLAGSHIP if stage == "verify" else CHEAP,
        messages=messages, max_tokens=max_tokens, temperature=temperature)
    USAGE["prompt"] += r.usage.prompt_tokens
    USAGE["completion"] += r.usage.completion_tokens
    USAGE["calls"] += 1
    return r.choices[0].message.content


def ask(prompt, stage="draft", system=None, max_tokens=2048):
    msgs = ([{"role": "system", "content": system}] if system else []) + [{"role": "user", "content": prompt}]
    return chat(msgs, stage=stage, max_tokens=max_tokens)


def report():
    print(f"累计调用 {USAGE['calls']} 次,prompt={USAGE['prompt']},completion={USAGE['completion']}")
Контроль затрат на научного AI-агента: отлаживайте на недорогой модели, а ключевые выводы проверяйте на флагманской
Научные задачи часто требуют нескольких итераций. Если с самого начала использовать только флагманскую модель, токены будут расходоваться на малозначимые проблемы — например, ошибки форматирования или сбои при разборе JSON. Надёжнее выбирать модель в зависимости от этапа:
| Этап | Рекомендуемая модель | Критерий готовности | Типичное значение max_tokens |
|---|---|---|---|
| Отладка процесса (формат промпта, разбор данных, оценщик) | Недорогая облегчённая модель | Весь процесс проходит от начала до конца без ошибок | 512-1024 |
| Генерация гипотез (перечисление возможных механизмов) | Сначала облегчённая модель; если вариантов недостаточно — перейти на флагманскую | Список охватывает основные гипотезы, которые вам уже известны | 1024-2048 |
| Рассуждения о механизмах и ключевая проверка | claude-opus-5-5 | Вывод попадёт в статью или повлияет на решение о дальнейших экспериментах | 2048-4096 |
| Перекрёстная проверка | Переключиться на флагманскую модель другого семейства с тем же API-ключом | Обе модели независимо приходят к одинаковому выводу | 2048 |
На практике достаточно запомнить одно правило: первый запуск скрипта — на недорогой модели, первый окончательный вывод — на флагманской.
Сценарий 1: сначала рассуждаем о механизмах, затем проверяем
Этот подход соответствует идее Claude «сменить вопрос»: не угадывать ответ напрямую, а сначала рассуждать о механизме, который мог породить данные, и только затем проверять его по этим данным. Подход пригодится, если в экспериментальных данных обнаружилась необычная закономерность, нужно восстановить процесс получения исторических данных или при воспроизведении статьи не удаётся найти исходные параметры.
Порядок действий
- Опишите только наблюдения, не выдвигая догадок: передайте модели данные, известные ограничения и исторический контекст. Не пишите «я думаю, что причиной было XX» — так можно заранее настроить модель на нужную версию.
- Попросите перечислить механизмы и проверяемые предсказания: для каждого возможного механизма добавьте условие вида «если он верен, в данных должен обнаружиться такой-то признак».
- Расположите варианты по стоимости проверки: попросите модель отсортировать их по времени, необходимому для проверки, от меньшего к большему. Начните с самых дешёвых.
- Проверьте порядок с помощью флагманской модели: список можно сначала составить на недорогой модели, а окончательно отсортировать и проанализировать его с помощью claude-opus-5-5.
Шаблон промпта
from research_client import ask, report

PROMPT = """你是一名严谨的研究助理。下面是一组观测数据和背景,不包含任何关于成因的线索。

【观测】
{observation}

【背景约束】
{context}

请完成:
1. 推演“产生这组数据的过程最可能怎么实现”,至少列出 5 个候选机制;
2. 每个机制给出一条可证伪预测:若成立,数据中必然出现的可检验特征;
3. 估计验证每条预测的成本(低/中/高),按成本升序输出;
4. 指出你最不确定的环节。
输出为 Markdown 表格 + 简短说明。"""

draft = ask(PROMPT.format(
    observation="NIST P-256 种子:C49D3608 86E70493 6A6678E1 139D26B7 819F7E90",
    context="1997-1998 年由政府机构用软件生成;官方未公布生成方法;常见猜测为短语哈希但未被证实",
), stage="draft")

final = ask("请审查并修正以下候选机制列表,删除无法证伪的条目,重新排序:\n" + draft,
            stage="verify", max_tokens=3000)
print(final)
report()
Оценить результат можно по двум критериям: есть ли у каждого механизма проверяемое предсказание и можно ли провести проверку, стоящую на первом месте, в течение часа. Если хотя бы один критерий не выполнен, попросите модель переписать ответ.
Применение исследовательского AI-агента № 2: поручите модели написать скрипт для сканирования и проверки
Этот подход повторяет то, как Claude самостоятельно написал сканер, перебравший 34 комбинации генераторов и срезов. Важно перевести вывод «похоже на правду» в утверждение «это вряд ли случайное совпадение с точки зрения статистики». Так можно решать задачи сканирования параметров, обнаружения сигналов и поиска скрытых структур в данных.
Порядок действий
- Передайте модели прогноз из первого сценария, который проще всего проверить, и попросите написать скрипт для сканирования, использующий только стандартную библиотеку.
- Попросите скрипт одновременно проверить набор случайных контрольных данных и вывести «долю совпадений на реальных данных» и «долю совпадений на случайных данных».
- Запустите скрипт локально. Модель должна только написать код, но не сообщать результаты.
- Если результаты статистически значимы, попросите флагманскую модель написать более строгий скрипт для восстановления состояния или подгонки данных.
Пример: воспроизводим статистическую сигнатуру «старший бит всегда равен 0»
Скрипт ниже демонстрирует принцип сигнатуры из этого кейса. lrand48 возвращает старшие 31 бит 48-битного состояния, поэтому после записи в 32-битное слово старший бит всегда равен 0. Для истинно случайных данных вероятность того, что старший бит любого слова равен 0, составляет лишь 50%.
import os

def lrand48_stream(seed32, n):
    x = (seed32 << 16) | 0x330E          # Инициализация srand48: младшие 16 бит фиксированы на уровне 0x330E
    out = []
    for _ in range(n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        out.append(x >> 17)               # lrand48 возвращает только старшие 31 бит
    return out

def top_bit_zero_ratio(words):
    return sum(1 for w in words if w >> 31 == 0) / len(words)

lr = lrand48_stream(870000000, 20)        # Одна из временных меток Unix примерно за 1997 год
rnd = [int.from_bytes(os.urandom(4), "big") for _ in range(20)]
print("Доля слов lrand48 с нулевым старшим битом:", top_bit_zero_ratio(lr))   # Всегда 1.0
print("Доля истинно случайных слов с нулевым старшим битом:", top_bit_zero_ratio(rnd))  # Колеблется примерно около 0.5
Проверяем итоговый вывод официальным кодом
На странице исследования Anthropic опубликован код для воспроизведения результатов под лицензией CC0. Согласно инструкциям, при указанных ниже параметрах скрипт должен вывести seed из стандарта P-256:
from datetime import datetime, timezone

def unix(when):
    return int(datetime.fromisoformat(when).replace(tzinfo=timezone.utc).timestamp())

def candidate(t, n, per, shift, width):
    x, out = (t << 16) | 0x330E, ""
    for i in range(per * n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        if i >= per * (n - 1):
            out += "%0*X" % (width, x >> shift)
    return out

seed = candidate(unix("1997-08-16 01:52:34"), 1842, 20, 40, 2)
print(seed)
print("Совпадает со стандартом:", seed == "C49D360886E704936A6678E1139D26B7819F7E90")
Скрипт инициализирует lrand48 временной меткой, собирает каждые 20 выходных значений в кандидатный 20-байтовый seed, а затем находит seed из стандарта среди 1842 кандидатов. Вся проверка занимает меньше секунды на обычном ноутбуке. Идеальная структура для таких исследовательских задач — «сформулировать гипотезу дорого, проверить вывод дёшево».
Применение исследовательского AI-агента № 3: подключите автоматическую оценку и повторяйте цикл, пока результат не перестанет улучшаться
В первых двух сценариях результат оценивает человек, а в третьем эту задачу берёт на себя программа. Вы пишете оценщик, модель на каждом шаге предлагает решение, а оценщик возвращает баллы и примеры ошибок. Модель учитывает обратную связь и вносит правки, пока оценка не перестанет расти. Такой подход подходит для правил извлечения данных, подбора формы аппроксимирующей функции, поиска экспериментальных параметров и других задач с чёткой метрикой.
Порядок действий
- Сначала напишите оценщик, потом обращайтесь к модели: это должна быть детерминированная программа, а не оценка, которую выставляет сама модель.
- Разделите данные на обучающую и отложенную выборки: для обратной связи используйте только обучающую выборку, а отложенную — в конце, чтобы проверить, не произошло ли переобучение.
- Ограничьте формат ответа: попросите модель выдавать данные в формате JSON или регулярных выражений, а не готовый код для выполнения. Если без выполнения кода не обойтись, запускайте его в изолированной среде.
- Задайте условие остановки: цикл завершается, если достигнут максимальный балл, оценка не выросла два раунда подряд или достигнуто максимальное число раундов.
- Сначала отладьте цикл на недорогой модели, затем запустите полноценный эксперимент на флагманской.
Пример: итеративно подбираем регулярные выражения для извлечения параметров из экспериментальных записей
import json, re
from research_client import chat, report

DEV = [
    ("样品A在 350 ℃ 退火 2 小时后测得电导率 4.1 S/m。", {"temp_c": 350, "hours": 2, "cond": 4.1}),
    ("退火温度 420°C,保温 1.5 h,电导率为 12.3 S/m。", {"temp_c": 420, "hours": 1.5, "cond": 12.3}),
    ("B组:300摄氏度下处理 3 小时,σ=0.85 S/m。", {"temp_c": 300, "hours": 3, "cond": 0.85}),
    ("在450 ℃条件下退火4h,测得电导率 20 S/m。", {"temp_c": 450, "hours": 4, "cond": 20}),
]
HOLDOUT = [
    ("样品E 380 ℃ 退火 2.5 小时,电导率 7.6 S/m。", {"temp_c": 380, "hours": 2.5, "cond": 7.6}),
    ("C组于 500°C 保温 0.5 h,σ = 33.1 S/m。", {"temp_c": 500, "hours": 0.5, "cond": 33.1}),
]
FIELDS = ["temp_c", "hours", "cond"]

def score(patterns, data):
    hit, fails = 0, []
    for idx, (text, label) in enumerate(data):
        for f in FIELDS:
            try:
                m = re.search(patterns.get(f, "(?!)"), text)
                ok = m is not None and abs(float(m.group(1)) - label[f]) < 1e-9
            except (re.error, IndexError, ValueError, TypeError):
                ok = False
            hit += ok
            if not ok:
                fails.append(f"样本{idx} 字段{f} 抽取失败:{text}")
    return hit / (len(data) * len(FIELDS)), fails

def parse_json(text):
    return json.loads(text[text.find("{"): text.rfind("}") + 1])

messages = [{"role": "user", "content":
    "为下列实验记录写 Python 正则,抽取 temp_c、hours、cond 三个字段,每个正则恰好一个捕获组,捕获纯数字。"
    "只输出 JSON,例如 {\"temp_c\": \"...\", \"hours\": \"...\", \"cond\": \"...\"},注意转义反斜杠。\n"
    + "\n".join(t for t, _ in DEV)}]

best, stale, patterns = -1.0, 0, {}
for rnd in range(6):
    reply = chat(messages, stage="draft", max_tokens=800)   # Проверив, что цикл работает, замените stage на "verify"
    try:
        patterns = parse_json(reply)
        s, fails = score(patterns, DEV)
    except (ValueError, json.JSONDecodeError):
        s, fails = 0.0, ["输出不是合法 JSON"]
    print(f"第 {rnd + 1} 轮 开发集得分 {s:.2f}")
    if s >= 1.0:
        break
    stale = stale + 1 if s <= best else 0
    best = max(best, s)
    if stale >= 2:
        break
    messages += [{"role": "assistant", "content": reply},
                 {"role": "user", "content": "以下抽取失败,请修改正则后重新输出完整 JSON:\n" + "\n".join(fails)}]

print("留出集得分:", score(patterns, HOLDOUT)[0])
report()
Обратите особое внимание: если модель набрала максимальный балл на обучающей выборке, но результат на отложенной заметно хуже, значит, она просто «запомнила ответы». В этом случае нужно расширить обучающую выборку, а не продолжать итерации.
Сравнение трёх способов использования исследовательского AI-агента
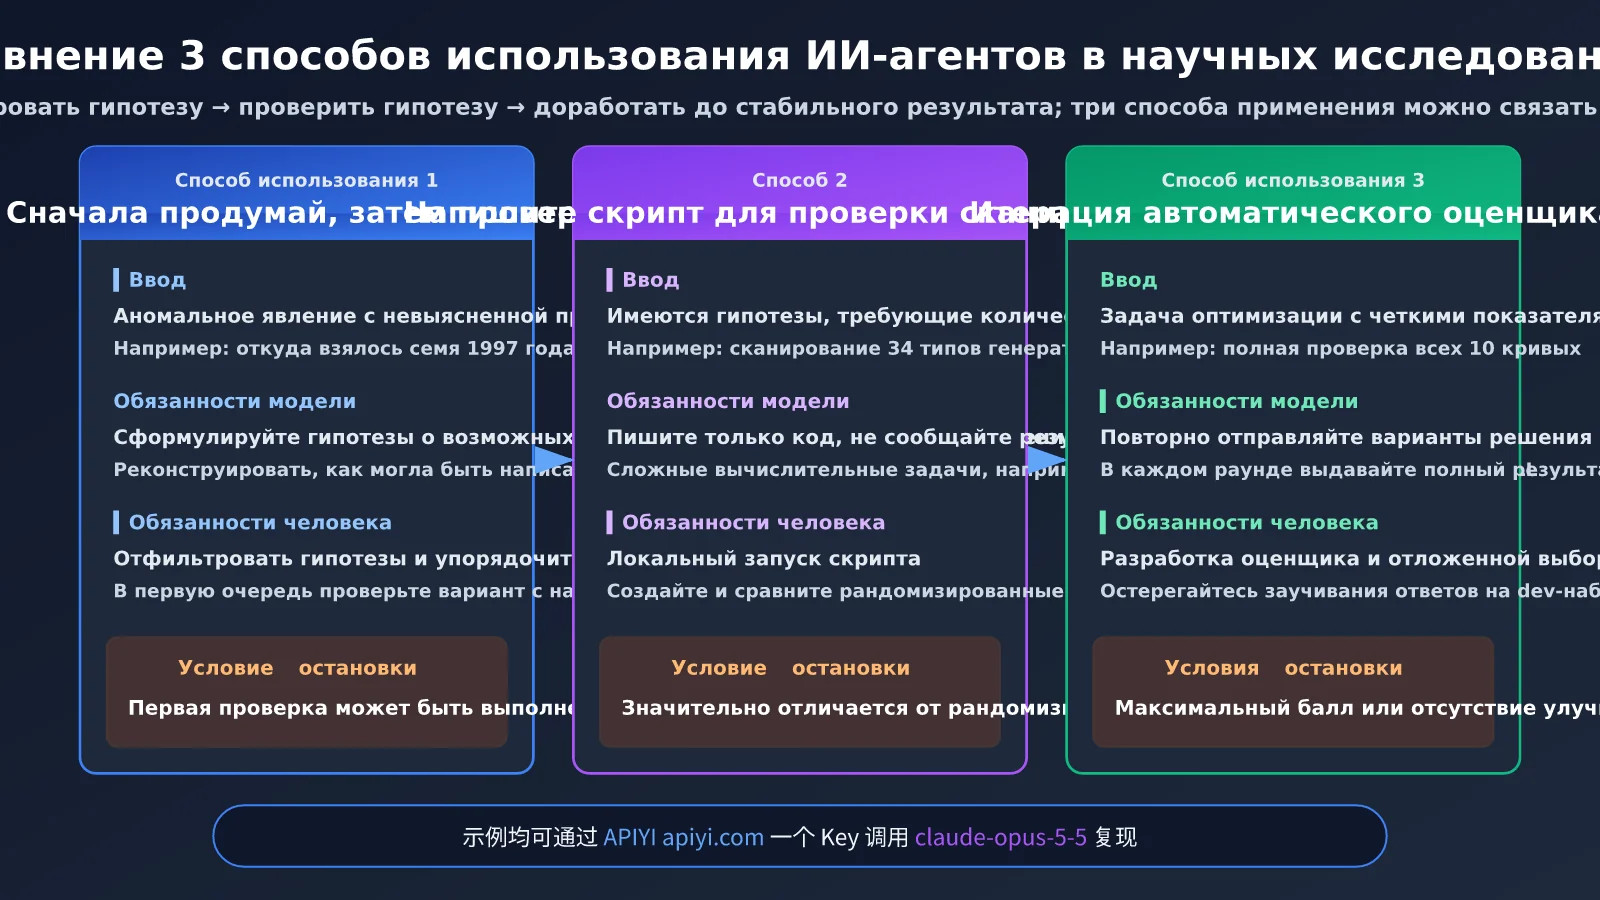
| Критерий | Сценарий 1: выдвижение гипотез | Сценарий 2: скрипт для сканирования и проверки | Сценарий 3: итерации с автоматической оценкой |
|---|---|---|---|
| Этап кейса | Вывод о том, как могли написать программу в 1997 году | Сканирование 34 генераторов, поиск статистической сигнатуры | Полная проверка после восстановления состояния по 10 кривым |
| Подходящие задачи | Необъяснимые аномалии, обратное проектирование | Есть гипотеза, которую нужно количественно проверить | Задачи оптимизации с чёткими метриками |
| Роль модели | Предлагать проверяемые механизмы | Писать код, но не сообщать результаты | Последовательно предлагать решения |
| Роль человека | Отбирать и ранжировать гипотезы | Запускать локально и сравнивать с контрольной группой | Проектировать оценщик и отложенную выборку |
| Когда подключать флагманскую модель | Для итогового анализа и ранжирования | Для решения сложных задач (например, LLL) | Для основных этапов эксперимента |
| Условие остановки | Первую гипотезу можно проверить менее чем за час | Статистически значимое отличие от случайной контрольной группы | Максимальный балл или отсутствие улучшений два раунда подряд |
| Способ вызова | Единый интерфейс APIYI apiyi.com | Аналогично | Аналогично |
Три подхода можно объединить в один процесс: в первом сценарии сформулировать гипотезу, во втором — проверить её, а в третьем — довести подтверждённое решение до стабильного результата.
Почему для научных задач вроде работы с Claude нужна флагманская модель
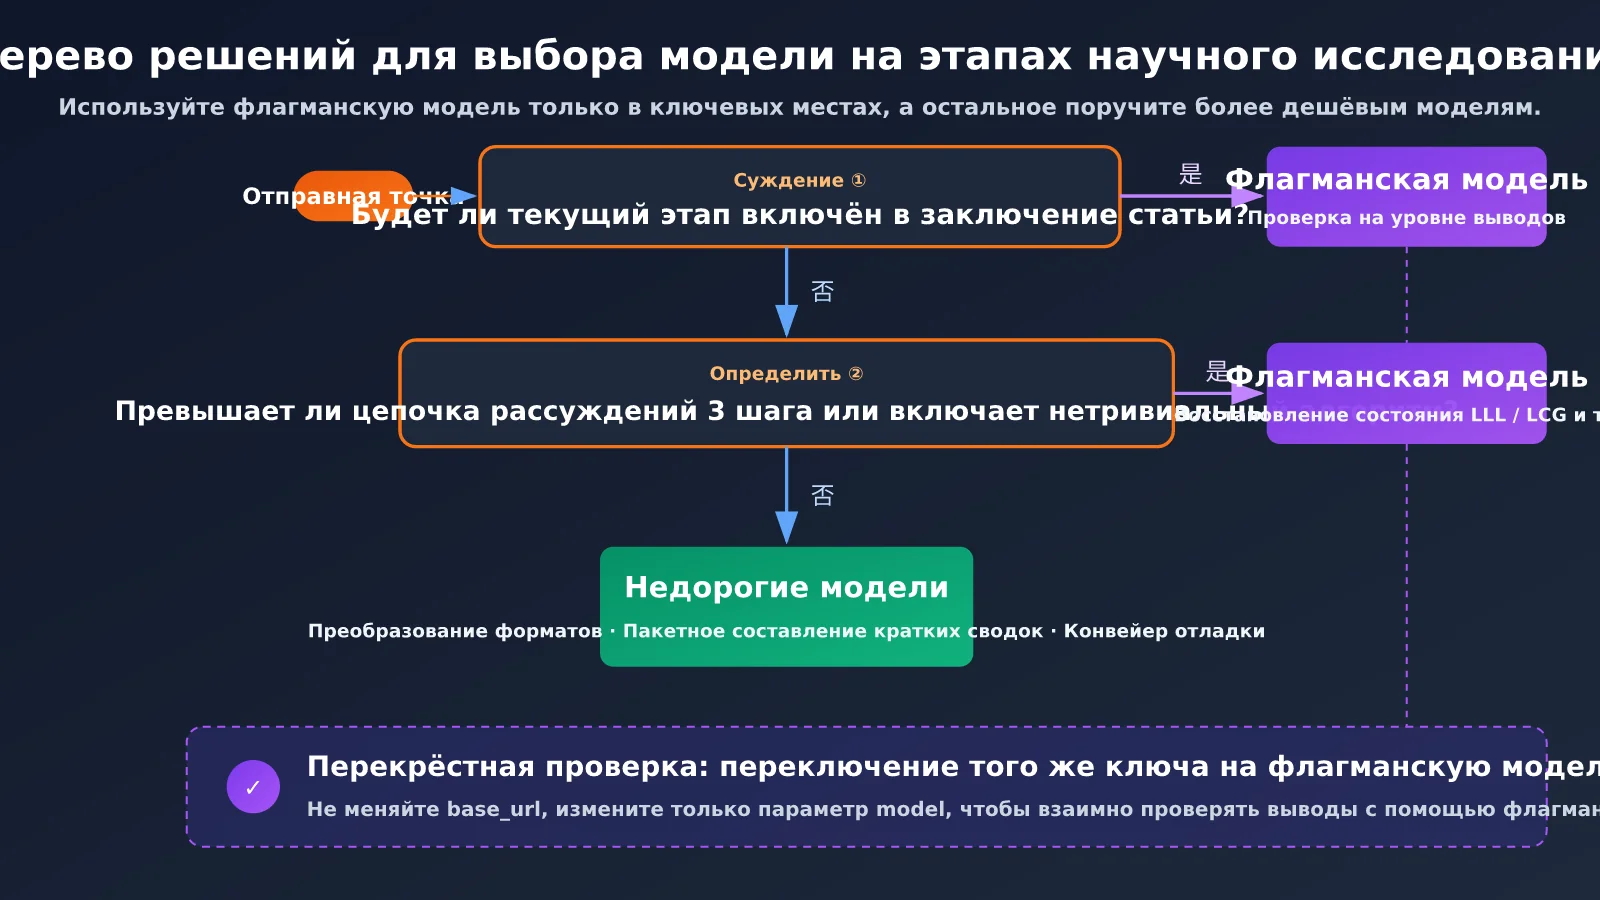
Не каждый этап исследования требует флагманской модели, но есть задачи, которые маленькой модели почти не под силу. Ориентируйтесь на таблицу:
| Критерий | Когда стоит выбрать флагманскую модель | Почему |
|---|---|---|
| Нужно находить связи между разными областями | Например, от «затравки для кривой» перейти к особенностям реализации библиотеки C в 90-х | Маленькая модель чаще цепляется за поверхностный смысл задачи — например, продолжает подбирать похожие фразы |
| Цепочка рассуждений состоит более чем из 3 шагов, и каждый шаг зависит от предыдущего | Например: вывести закономерность → просканировать данные → найти сигнатуру → восстановить состояние | Ошибка на любом промежуточном шаге уводит в сторону все дальнейшие рассуждения |
| Нужно критически оценить собственные предположения | Например, проверить: «А вдруг я работаю в тестовой среде?» | Флагманская модель с большей вероятностью сама будет искать контрпримеры |
| Задача связана с нетривиальным алгоритмом | Например, редукция решётки по алгоритму LLL или восстановление состояния усечённого LCG | От корректности кода напрямую зависит, будет ли проверка убедительной |
| Вывод войдёт в статью или повлияет на решение о вложениях в эксперимент | Любой вывод, который будут публиковать или передавать другим | Цена ошибки намного выше стоимости вызова модели |
Для форматирования данных, массового создания кратких изложений и отладки пайплайна оценки вполне подойдёт недорогая модель. Главное в контроле затрат — не отказываться от флагманских моделей, а использовать их только в ситуациях, перечисленных в таблице.
Часто задаваемые вопросы
Вопрос 1. Claude взломал эллиптические кривые NIST?
Нет. Claude восстановил процесс генерации seed-значения: оно было получено с помощью lrand48, инициализированного временной меткой. Это не новый метод атаки и не уязвимость, поэтому пользователям не нужно менять настройки или переходить на другие решения. Напротив, этот результат показывает, что seed-значения не подбирали вручную.
Вопрос 2. Чем этот метод отличается от обычного перебора?
При переборе проверяют все варианты в рамках заданного пространства гипотез. Claude сначала изменил само пространство гипотез: вместо вопроса «какую фразу хешировали?» он задал вопрос «какой генератор случайных чисел использовали?». И только после этого выполнил ограниченный перебор — проверил 2^17 скрытых битов. Успех определил именно первый шаг.
Вопрос 3. Когда опубликовали это исследование и какие вопросы пока остаются открытыми?
Страница исследования Anthropic и публикация @AnthropicAI вышли 17 октября 2026 года. Пока не удалось восстановить seed-значение для B-163. Также неизвестно, как генерировали базовую точку G для P-224 — P-521. Кроме того, без объяснения остались несколько пропущенных кандидатных кривых.
Вопрос 4. Для каких исследовательских задач подходят эти три подхода?
— **Поиск причин экспериментальных аномалий**: если в данных прибора появляются периодические артефакты, используйте первый подход, чтобы восстановить особенности реализации ПО для сбора данных.
— **Воспроизведение результатов старых статей**: если параметры не указаны, с помощью второго подхода переберите возможные комбинации.
— **Извлечение и очистка данных**: примените третий подход вместе с оценщиком и итеративно подберите стабильные правила.
Вопрос 5. Как с помощью одного ключа вызывать несколько флагманских моделей и сравнивать их результаты?
Зарегистрируйтесь на APIYI apiyi.com и создайте API-ключ. Укажите `https://api.apiyi.com/v1` в параметре `base_url` — затем можно переключаться между claude-opus-5-5 и флагманскими моделями семейств GPT и Gemini, меняя только параметр `model`. Актуальный список доступных моделей смотрите в панели управления.
Вопрос 6. Какие ограничения известны у исследовательских ИИ-агентов?
— Модель может выдумать механизм, который звучит правдоподобно. Поэтому каждый вывод нужно проверять с помощью скрипта, который можно запустить локально.
— При итерациях оценщика легко переобучиться на обучающей выборке — обязательно оставляйте отложенную выборку.
— Затраты на несколько вызовов модели накапливаются. Сначала отладьте процесс на недорогой модели и следите за usage. Условия тарификации можно посмотреть в панели управления APIYI apiyi.com.
Основные выводы о научно-исследовательских ИИ-агентах
- Границы вывода: Claude восстановил источник seed-значений, а не обнаружил уязвимость в криптографии. Доверие к кривым, наоборот, стало выше.
- Ключевой шаг: изменить пространство гипотез эффективнее, чем наращивать вычислительные мощности в старом.
- Сначала проверка: модель пишет скрипт, человек его запускает; результаты всегда нужно сравнивать со случайным базовым уровнем.
- Замкнутый цикл с оценщиком: используйте детерминированную оценку и отложенную выборку. Прекращайте итерации, когда оценка перестанет меняться.
- Разделение моделей по задачам: недорогие модели подходят для отладки процесса, а флагманские — только для важных выводов и проверок.
- Как начать: используйте один API-ключ на APIYI apiyi.com, чтобы вызывать claude-opus-5-5 и переключаться на другие модели для перекрёстной проверки.
Итоги
Из того, как Claude раскрыл загадку с начальными значениями эллиптических кривых NIST, исследователям стоит вынести три урока:
- Сначала разберитесь в механизме: исходите из того, как были получены данные, а не пытайтесь сразу угадать ответ.
- Подтверждайте гипотезы скриптами: для каждой гипотезы нужны исполняемый код проверки и случайный контроль.
- Замкните цикл на оценщике: передайте оценку детерминированной программе, итерируйте до сходимости и проверяйте переобучение на отложенной выборке.
Не забывайте и о контроле расходов: сначала отладьте процесс на недорогой модели, а для работы с выводами научных статей и сложными алгоритмами переходите на флагманскую модель. Рекомендуем запустить весь код из статьи через APIYI apiyi.com: сначала проверить начальное значение для P-256 с помощью официального кода воспроизведения, а затем применить три описанных подхода в собственном исследовании.
Материалы по теме
- 📘 Как вызывать модели Claude через OpenAI SDK — узнайте, чем отличаются параметры совместимых интерфейсов
- 📊 Как контролировать расходы на вызовы API больших языковых моделей — разберитесь в статистике usage и настройке уведомлений о расходах
- 🚀 Как настроить рабочий процесс перекрёстной проверки несколькими моделями — поручите разным флагманским моделям перепроверять выводы
📚 Источники
- Страница исследования Anthropic Frontier Red Team: происхождение начальных значений кривых ECDSA
- Ссылка:
www.anthropic.com/research/ecdsa-curve-origins -
Описание: первоисточник с подробным описанием методики, открытых вопросов и кодом для воспроизведения результатов под лицензией CC0
-
Официальная публикация @AnthropicAI в X (17.10.2026): «Это просто временные метки»
- Ссылка:
x.com/AnthropicAI -
Описание: официальное заявление — здесь можно посмотреть обсуждение сообщества
-
Центр документации APIYI: инструкции по работе с интерфейсами, совместимыми с OpenAI
- Ссылка:
docs.apiyi.com - Описание: настройка
base_url, список моделей и информация о стоимости
Автор: техническая команда APIYI
Обсуждение технологий: расскажите в комментариях, как вы используете ИИ-агентов в исследованиях. Дополнительные материалы по подключению доступны в центре документации APIYI: docs.apiyi.com