著者注:ClaudeがNIST楕円曲線のシードの生成元を突き止めた過程をひも解き、今回の結論が示す範囲を説明します。さらに、研究者がすぐに活用できるAI Agentの使い方を3つ、コードやコスト管理の方法とあわせて紹介します。
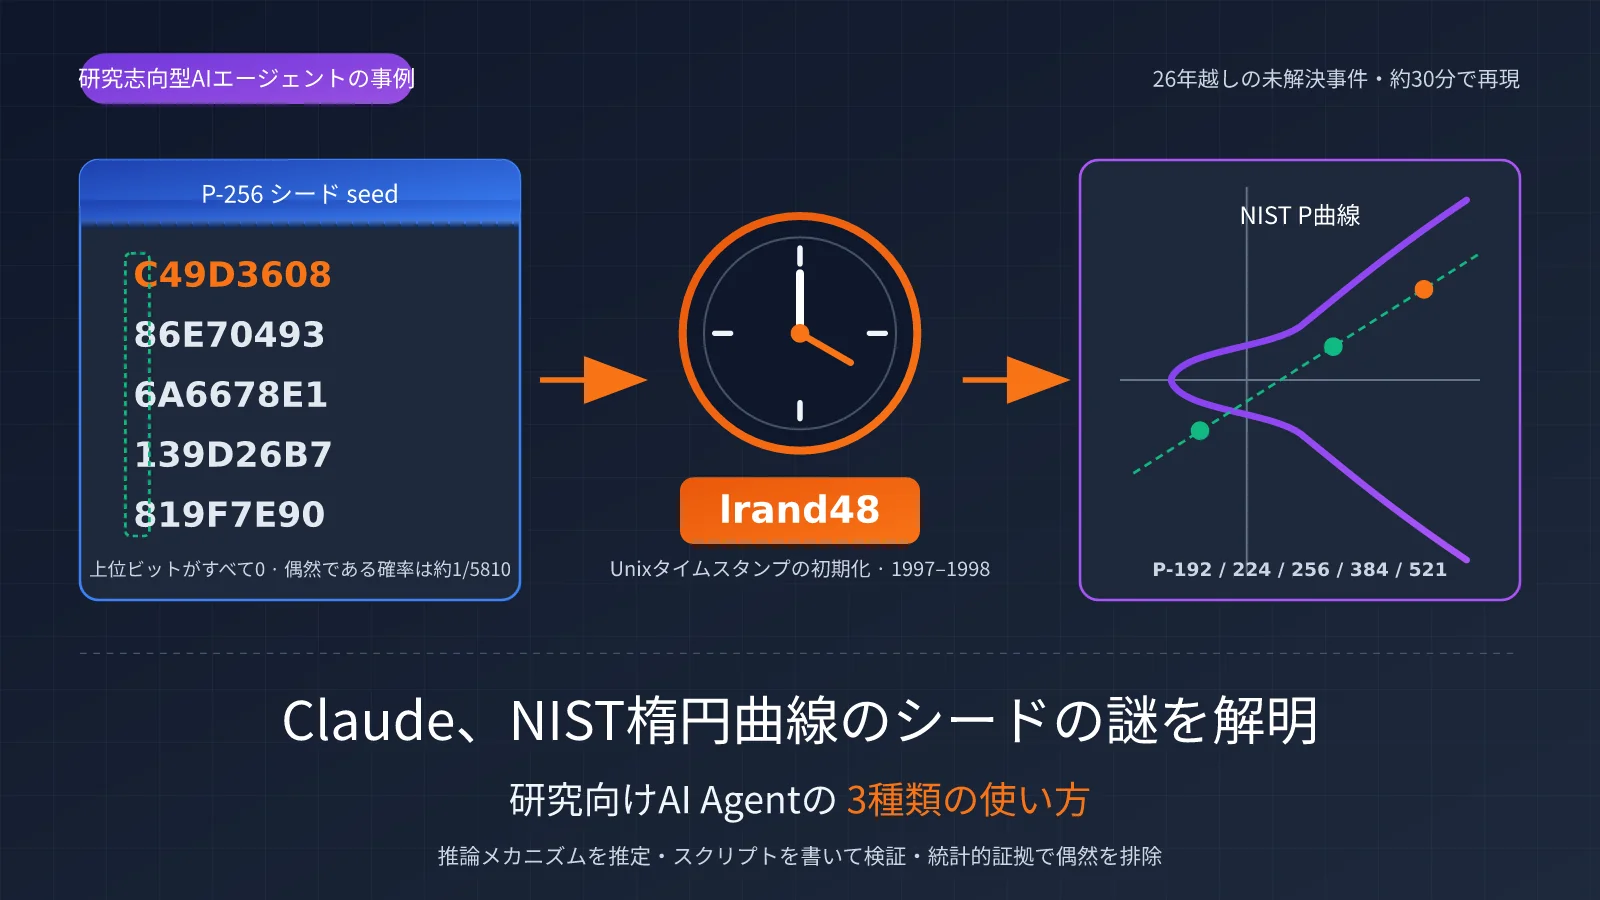
2026年10月17日、Anthropic Frontier Red Teamが研究成果を発表しました。内部の研究用モデルが、ヒントを一切与えられないまま、約30分でNIST P-192、P-224、P-256、P-384、P-521の5つの曲線のシード生成方法を突き止めたというものです。これらのシードはハッシュアルゴリズムを経由したものではなく、1990年代のCライブラリに標準搭載されていた擬似乱数生成器「lrand48」の出力でした。初期値にはUnixタイムスタンプが使われていました。@AnthropicAIの公式投稿は「It is just timestamps.(ただのタイムスタンプです)」の一文のみで、約85万5000回表示されました。
これは暗号解読でも、新たな脆弱性の発見でもありません。 研究者にとってこの事例が参考になるのは、Claudeの作業手順です。仕組みを推論し、検証用スクリプトを書き、統計的な証拠で偶然の一致を排除する。この手順は、あなた自身の研究課題にも応用できます。
この記事でわかること:今回の発見が何を証明し、何を証明しないのかを整理します。また、すぐに使える研究向けAI Agentのワークフローを3つ、操作手順と実行可能なコード付きで紹介します。
Claudeが解き明かしたNIST楕円曲線シードの謎:要点
| 要点 | 説明 | 研究者にとっての意義 |
|---|---|---|
| 謎の背景 | 2000年、NISTはFIPS 186-2でECDSAを採用。曲線のシードはNSAから提供されたものの、出所は説明されていなかった | 26年間未解決だった問題を、AIの推論能力を測る題材として活用できる |
| 結論 | シードはlrand48の出力で、1997年5月から1998年4月までのタイムスタンプを初期値にしていた | 誰でも再現でき、検証コストも低い |
| 主な手法 | ソフトウェアの実装方法を推定し、独自のスキャナーを作成。統計的特徴で候補を絞り込んでから、状態を復元 | この3段階は、実験データの分析や逆モデリングなどにも応用できる |
| セキュリティ上の意味 | 脆弱性ではないため、利用者が設定変更や移行を行う必要はない | 論文や報告書では正確に記述し、誇張を避ける |
| 未解決の点 | B-163のシードは解明されておらず、P-224からP-521までの基点Gの生成方法も不明 | AIの結論にも限界がある。未解決の点を記録しておく必要がある |
NIST楕円曲線シードの謎:この発見が示すこと
ECDSA標準では、各曲線にシードが公開されており、そのシードのハッシュ値を使って曲線係数bを決定します。P-256のシードはC49D3608 86E70493 6A6678E1 139D26B7 819F7E90です。出所が長年説明されていなかったため、NSAが弱点のあるパラメーターを意図的に選んだのではないかと、コミュニティでは懸念されていました。KoblitzとMenezesは『A Riddle Wrapped in an Enigma』というレビューを書き、Filippo Valsordaはこの問題に36,864ドルの懸賞金をかけました。一時はJerry Solinasが冗談のような一文をハッシュしてシードを生成したという説も広まりましたが、後に誤りと判明しています。
今回の結論は、これらの曲線に対する信頼を高めるものです。シードは時刻を初期値とする一般的な擬似乱数生成器から得られており、人為的に選び込む余地はありません。誰でも再現できます。原文によると、同じく利用可能な候補曲線のうち、少数が採用されなかった理由は不明です。ただし、その数は非常に少なく、弱い曲線を意図的に選んだようには見えません。懸賞金はInternet Security Research Groupに寄付される予定です。
論文や研究会でこの件に触れる場合は、「AIが歴史的なパラメーターの生成過程を復元し、再現可能にした」と表現するのが適切です。「AIが楕円曲線を破った」と書くのは避けましょう。
Claudeがシードを推定した4つのステップ
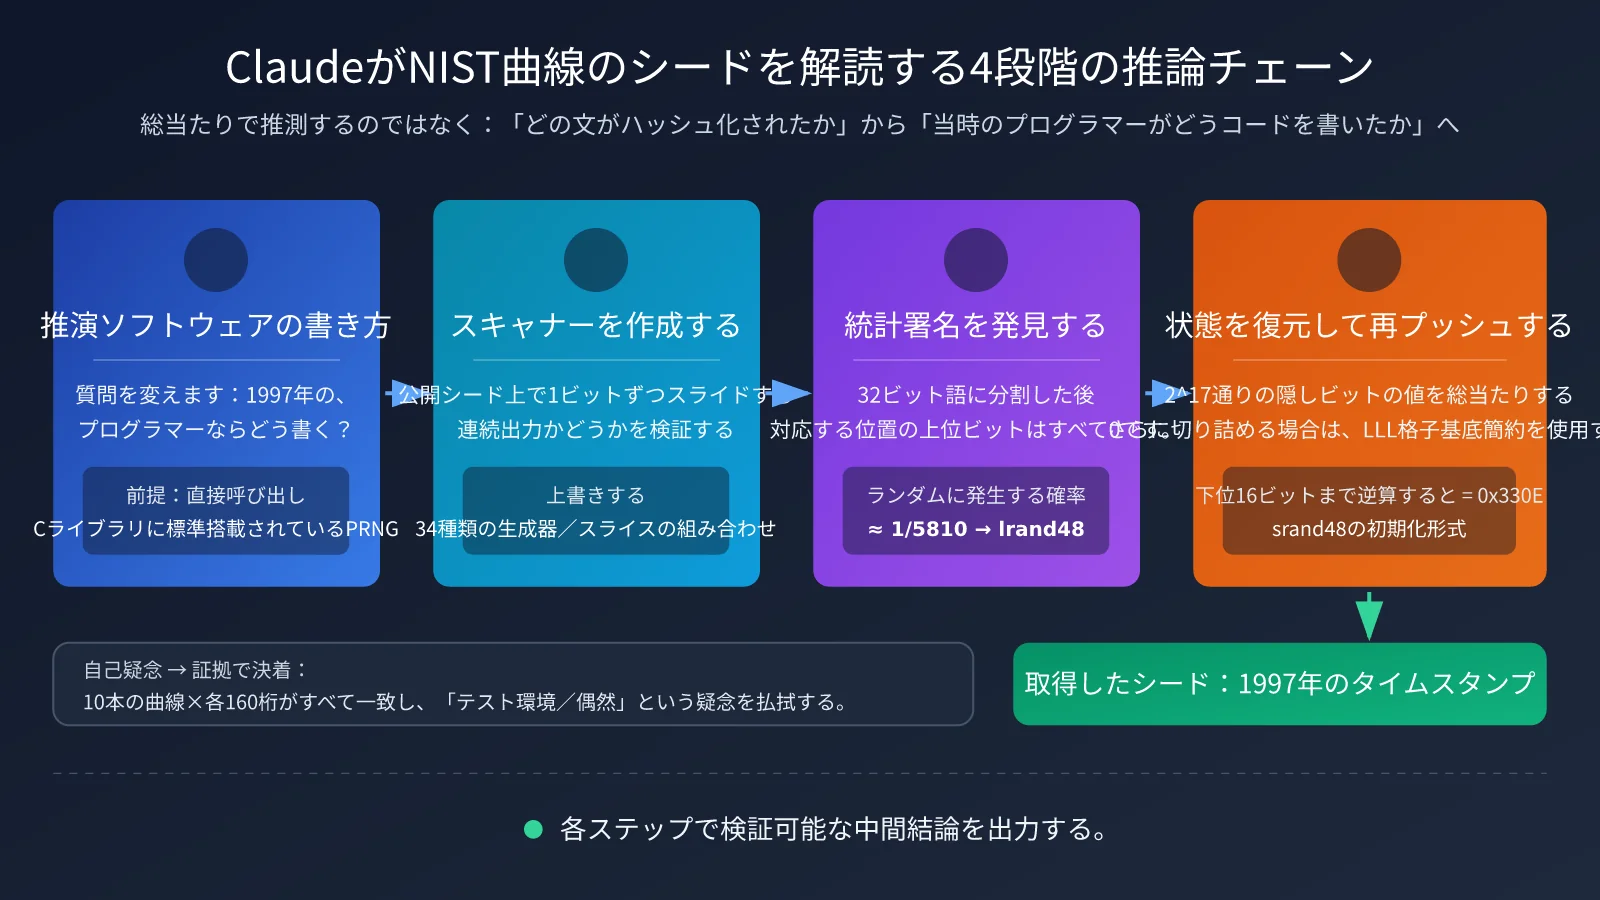
今回の推論は、手当たり次第に候補を試す方法ではありませんでした。検証可能な推論の流れをたどっています。
- 問題の立て方を変える:「どんな一文をハッシュしたのか」を推測するのではなく、1997年当時、曲線生成プログラムを書く開発者がどんなコードを書きそうかを考えました。その結果、Cライブラリに標準搭載された乱数生成器を直接使った可能性が高いと判断しました。
- スキャナーを書く:公開済みのシードを1ビットずつずらしながら、隣接する断片が1990年代の生成器の連続出力に見えるかを検証しました。生成器と切り出し方の組み合わせを、合計34通り調べました。
- 統計的な特徴を探す:シードを32ビットのワードに分割すると、対応する位置の上位ビットがすべて0になっていました。偶然にそうなる確率は約1/5810です。これは、lrand48が48ビットの状態のうち上位31ビットだけを返すという特徴と一致します。
- 状態を復元して逆向きにたどる:隠れた17ビットの2^17通りを総当たりし、後続のワードで検証しました。より多くのビットが切り詰められているシードには、LLL格子基底簡約を使って解を求めました。その後、状態を逆向きにたどり、srand48の初期化パターン、つまり下位16ビットが0x330Eになるところまで戻しました。
推論の過程には、もう一つ興味深い点があります。モデルは一時、自分がテスト環境に置かれているのではないかと疑いました。その後、「10本の曲線で、それぞれ160ビットがすべて一致している。偶然では説明できない」と判断し、その疑いを退けました。「まず自分を疑い、証拠をもとに結論を絞り込む」姿勢は、研究向けAgentにとって特に重要です。
研究向けAI Agentをすぐに使い始める:1つのAPIキーで最上位モデルを呼び出す
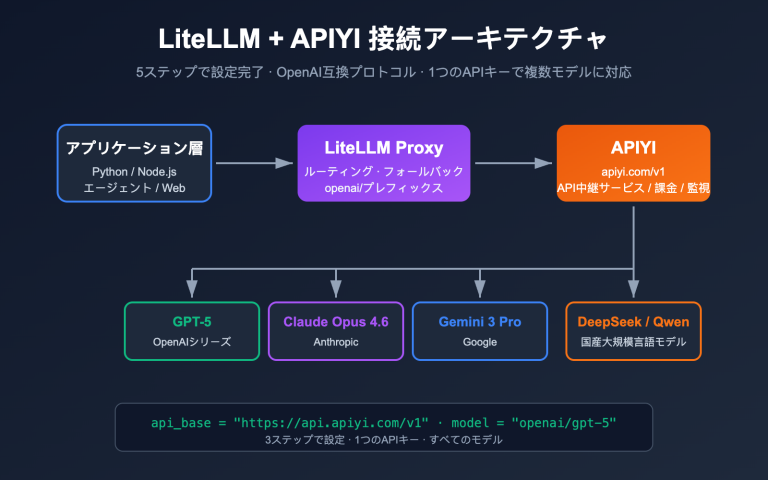
実際に使い始める前に、まずAPI呼び出しの流れを確認しましょう。APIYIはOpenAI互換のインターフェースを提供しており、1つのAPIキーでclaude-opus-5-5を呼び出せます。また、GPT系やGemini系の最上位モデルに切り替えて、結果を相互検証することもできます。
接続手順はここでは繰り返しません。APIYI公式のクイックスタートドキュメント(docs.apiyi.com/getting-started)を参照してください。ドキュメントに従ってコンソールでAPIキーを作成し、base_url(https://api.apiyi.com/v1)を取得したら、掲載されているサンプルで接続を確認できます。料金体系と利用可能なモデルは、コンソールで確認してください。
後述する3つの使い方では、共通の小さなラッパーを使います。research_client.pyとして保存してください。主な役割は、段階に応じてモデルを選ぶことと、コスト管理のためにトークン使用量を記録することです。
# research_client.py
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1")
CHEAP = os.environ.get("CHEAP_MODEL", "claude-opus-5-5")  # 填控制台里的轻量模型名
FLAGSHIP = "claude-opus-5-5"
USAGE = {"prompt": 0, "completion": 0, "calls": 0}


def chat(messages, stage="draft", max_tokens=2048, temperature=0.2):
    """stage='draft' 走便宜模型;stage='verify' 走旗舰模型。"""
    r = client.chat.completions.create(model=FLAGSHIP if stage == "verify" else CHEAP,
        messages=messages, max_tokens=max_tokens, temperature=temperature)
    USAGE["prompt"] += r.usage.prompt_tokens
    USAGE["completion"] += r.usage.completion_tokens
    USAGE["calls"] += 1
    return r.choices[0].message.content


def ask(prompt, stage="draft", system=None, max_tokens=2048):
    msgs = ([{"role": "system", "content": system}] if system else []) + [{"role": "user", "content": prompt}]
    return chat(msgs, stage=stage, max_tokens=max_tokens)


def report():
    print(f"累计调用 {USAGE['calls']} 次,prompt={USAGE['prompt']},completion={USAGE['completion']}")
研究向けAI Agentのコスト管理:軽量モデルで調整し、重要な検証には最上位モデルを使う
研究タスクは何度も反復することが多いため、最初から最後まで最上位モデルを使うと、フォーマットの誤りやJSONの解析失敗といった重要度の低い問題に利用枠を消費してしまいます。段階に応じてモデルを使い分けるのが確実です。
| 段階 | 推奨モデル | 判断基準 | 目安のmax_tokens |
|---|---|---|---|
| ワークフローのデバッグ(プロンプトの形式、解析、評価器) | 軽量で安価なモデル | パイプラインがエラーなくエンドツーエンドで動作する | 512-1024 |
| 仮説の生成(候補となるメカニズムの列挙) | まずは軽量モデルを使用し、網羅性が不足する場合は最上位モデルに切り替える | 候補の一覧に、既知の主要な仮説が含まれている | 1024-2048 |
| メカニズムの推論と重要な検証 | claude-opus-5-5 | 結論を論文に記載する、または今後の実験への投資判断に使う | 2048-4096 |
| 相互検証 | 同じAPIキーで別の提供元の最上位モデルに切り替える | 2つのモデルが独立に同じ結論を出す | 2048 |
実際に使うときは、次のルールを覚えておくと便利です。スクリプトの初回実行には安価なモデル、結論を初めて確定するときには最上位モデルを使いましょう。
研究向けAI Agentの使い方1:まずメカニズムを推論し、その後で検証する
このステップは、Claudeの「問いを変える」アプローチにあたります。答えを直接推測するのではなく、データが生じたメカニズムを推論してから、データを使って検証します。実験データに異常なパターンが見られる場合、過去のデータが生成されたプロセスを逆算したい場合、論文を再現しようとしてもパラメーターの出典が見つからない場合などに適しています。
手順
- 現象だけを説明し、推測は伝えない:観測データ、既知の制約、当時の背景をモデルに渡します。「XXが原因だと思う」といった表現は避け、モデルの推論を誘導しないようにします。
- メカニズムと反証可能な予測を列挙させる:候補となるメカニズムごとに、「このメカニズムが正しければ、データにはどのような特徴が現れるはずか」という予測を1つ添えます。
- 検証コストの低い順に並べる:検証に必要な時間が短い順に並べるようモデルに指示し、まずはコストの低いものから検証します。
- 最上位モデルで並び順を再確認する:候補のリストは安価なモデルで生成しても構いませんが、最終的な順序付けと推論はclaude-opus-5-5に任せます。
プロンプトのテンプレート
from research_client import ask, report

PROMPT = """你是一名严谨的研究助理。下面是一组观测数据和背景,不包含任何关于成因的线索。

【观测】
{observation}

【背景约束】
{context}

请完成:
1. 推演“产生这组数据的过程最可能怎么实现”,至少列出 5 个候选机制;
2. 每个机制给出一条可证伪预测:若成立,数据中必然出现的可检验特征;
3. 估计验证每条预测的成本(低/中/高),按成本升序输出;
4. 指出你最不确定的环节。
输出为 Markdown 表格 + 简短说明。"""

draft = ask(PROMPT.format(
    observation="NIST P-256 种子:C49D3608 86E70493 6A6678E1 139D26B7 819F7E90",
    context="1997-1998 年由政府机构用软件生成;官方未公布生成方法;常见猜测为短语哈希但未被证实",
), stage="draft")

final = ask("请审查并修正以下候选机制列表,删除无法证伪的条目,重新排序:\n" + draft,
            stage="verify", max_tokens=3000)
print(final)
report()
このステップの質は、次の2点で判断できます。各メカニズムに反証可能な予測があるか、そして最初に挙げられた検証を1時間以内に完了できるかです。どちらか一方でも満たしていなければ、モデルに書き直しを指示しましょう。
研究型AI Agentの使い方2:モデルにスキャン・検証スクリプトを書かせる
このステップは、Claude自身にスキャナーを書かせ、34種類の生成器とスライスの組み合わせを網羅した方法にあたります。重要なのは、「似ているように見える」を「統計的に偶然とは考えにくい」へと変えることです。パラメーターのスキャン、信号検出、検索データに隠れた構造の発見などに活用できます。
手順
- 使い方1で挙げた予測のうち、検証コストが最も低いものをモデルに渡し、標準ライブラリだけに依存するスキャンスクリプトを書くよう依頼します。
- スクリプトにランダムな対照データも処理させ、「実データのヒット率」と「ランダムデータのヒット率」を出力させます。
- スクリプトは自分のローカル環境で実行します。モデルにはコードを書かせるだけにし、結果の報告はさせません。
- 結果に有意な差が見られたら、次にフラッグシップモデルへ、より厳密な状態復元やフィッティング用のスクリプトを書かせます。
例:「上位ビットがすべて0」という統計的特徴を再現する
次のスクリプトは、今回の事例で確認された特徴の仕組みを示しています。lrand48 は48ビット状態の上位31ビットを返すため、32ビットの値に格納すると最上位ビットは必ず0になります。一方、真のランダムデータでは、各値の最上位ビットが0になる確率は半分です。
import os

def lrand48_stream(seed32, n):
    x = (seed32 << 16) | 0x330E          # srand48の初期化:下位16ビットは0x330Eに固定
    out = []
    for _ in range(n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        out.append(x >> 17)               # lrand48は上位31ビットだけを返す
    return out

def top_bit_zero_ratio(words):
    return sum(1 for w in words if w >> 31 == 0) / len(words)

lr = lrand48_stream(870000000, 20)        # 1997年前後のUnixタイムスタンプ
rnd = [int.from_bytes(os.urandom(4), "big") for _ in range(20)]
print("lrand48で最上位ビットが0となる割合:", top_bit_zero_ratio(lr))   # 常に1.0
print("真のランダムデータで最上位ビットが0となる割合:", top_bit_zero_ratio(rnd))  # およそ0.5前後で変動
公式コードで最終的な結論を検証する
Anthropicの研究ページには、CC0ライセンスで公開された再現用コードが添付されています。公式の説明によると、以下のパラメーターを指定すると、P-256規格で使われているシードが出力されます。
from datetime import datetime, timezone

def unix(when):
    return int(datetime.fromisoformat(when).replace(tzinfo=timezone.utc).timestamp())

def candidate(t, n, per, shift, width):
    x, out = (t << 16) | 0x330E, ""
    for i in range(per * n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        if i >= per * (n - 1):
            out += "%0*X" % (width, x >> shift)
    return out

seed = candidate(unix("1997-08-16 01:52:34"), 1842, 20, 40, 2)
print(seed)
print("規格と一致:", seed == "C49D360886E704936A6678E1139D26B7819F7E90")
このスクリプトでは、タイムスタンプを使ってlrand48を初期化し、20回分の出力をまとめて20バイトの候補シードを作ります。1842番目の候補が規格に記載されたシードです。検証は一般的なノートPCでも1秒以内に完了します。「仮説を立てるコストは高いが、結論を検証するコストは低い」——これが、こうした研究タスクの理想的な構造です。
研究型AI Agentの使い方3:自動スコアラーを用意し、スコアが収束するまで反復する
最初の2つの使い方では人が結果を判断しますが、3つ目では判断をプログラムに任せます。スコアラーを用意し、モデルが各ラウンドで案を提出すると、スコアラーがスコアと失敗したサンプルを返します。モデルはその結果をもとに修正し、スコアが伸びなくなるまで繰り返します。データ抽出ルール、フィッティング関数の形式、実験パラメーターの探索など、明確な評価指標があるタスクに適しています。
手順
- モデルを使う前にスコアラーを書く:スコアラーは決定論的なプログラムにし、モデル自身による採点には依存させません。
- 開発セットとホールドアウトセットに分ける:フィードバックには開発セットだけを使い、最後にホールドアウトセットで過学習を確認します。
- 提出形式を制限する:モデルにはJSONや正規表現などのデータを提出させ、生成コードを直接実行しないようにします。コードを実行する必要がある場合は、サンドボックス内で実行してください。
- 収束条件を設定する:満点、2ラウンド連続でスコアが向上しない、最大ラウンド数に到達、のいずれかを満たしたら終了します。
- 安価なモデルでループを動作確認してから、フラッグシップモデルに切り替えて本実験を行います。
例:実験記録からパラメーターを抽出する正規表現を反復改善する
import json, re
from research_client import chat, report

DEV = [
    ("样品A在 350 ℃ 退火 2 小时后测得电导率 4.1 S/m。", {"temp_c": 350, "hours": 2, "cond": 4.1}),
    ("退火温度 420°C,保温 1.5 h,电导率为 12.3 S/m。", {"temp_c": 420, "hours": 1.5, "cond": 12.3}),
    ("B组:300摄氏度下处理 3 小时,σ=0.85 S/m。", {"temp_c": 300, "hours": 3, "cond": 0.85}),
    ("在450 ℃条件下退火4h,测得电导率 20 S/m。", {"temp_c": 450, "hours": 4, "cond": 20}),
]
HOLDOUT = [
    ("样品E 380 ℃ 退火 2.5 小时,电导率 7.6 S/m。", {"temp_c": 380, "hours": 2.5, "cond": 7.6}),
    ("C组于 500°C 保温 0.5 h,σ = 33.1 S/m。", {"temp_c": 500, "hours": 0.5, "cond": 33.1}),
]
FIELDS = ["temp_c", "hours", "cond"]

def score(patterns, data):
    hit, fails = 0, []
    for idx, (text, label) in enumerate(data):
        for f in FIELDS:
            try:
                m = re.search(patterns.get(f, "(?!)"), text)
                ok = m is not None and abs(float(m.group(1)) - label[f]) < 1e-9
            except (re.error, IndexError, ValueError, TypeError):
                ok = False
            hit += ok
            if not ok:
                fails.append(f"サンプル{idx}のフィールド{f}の抽出に失敗:{text}")
    return hit / (len(data) * len(FIELDS)), fails

def parse_json(text):
    return json.loads(text[text.find("{"): text.rfind("}") + 1])

messages = [{"role": "user", "content":
    "以下の実験記録からtemp_c、hours、condの3つのフィールドを抽出するPython正規表現を書いてください。各正規表現にはキャプチャグループをちょうど1つ含め、数字のみをキャプチャしてください。"
    "JSONだけを出力してください。例:{\"temp_c\": \"...\", \"hours\": \"...\", \"cond\": \"...\"}。バックスラッシュのエスケープに注意してください。\n"
    + "\n".join(t for t, _ in DEV)}]

best, stale, patterns = -1.0, 0, {}
for rnd in range(6):
    reply = chat(messages, stage="draft", max_tokens=800)   # 動作確認後、stageを"verify"に変更
    try:
        patterns = parse_json(reply)
        s, fails = score(patterns, DEV)
    except (ValueError, json.JSONDecodeError):
        s, fails = 0.0, ["出力が有効なJSONではありません"]
    print(f"第{rnd + 1}ラウンド 開発セットのスコア {s:.2f}")
    if s >= 1.0:
        break
    stale = stale + 1 if s <= best else 0
    best = max(best, s)
    if stale >= 2:
        break
    messages += [{"role": "assistant", "content": reply},
                 {"role": "user", "content": "以下の抽出に失敗しました。正規表現を修正し、完全なJSONを再出力してください:\n" + "\n".join(fails)}]

print("ホールドアウトセットのスコア:", score(patterns, HOLDOUT)[0])
report()
特に注意したいのは、開発セットで満点を取れても、ホールドアウトセットのスコアが大きく下がる場合です。これは、モデルが「答えを暗記している」ことを示しています。その場合は反復を続けるのではなく、開発セットを拡充しましょう。
研究向けAI Agentの3つの使い方を比較
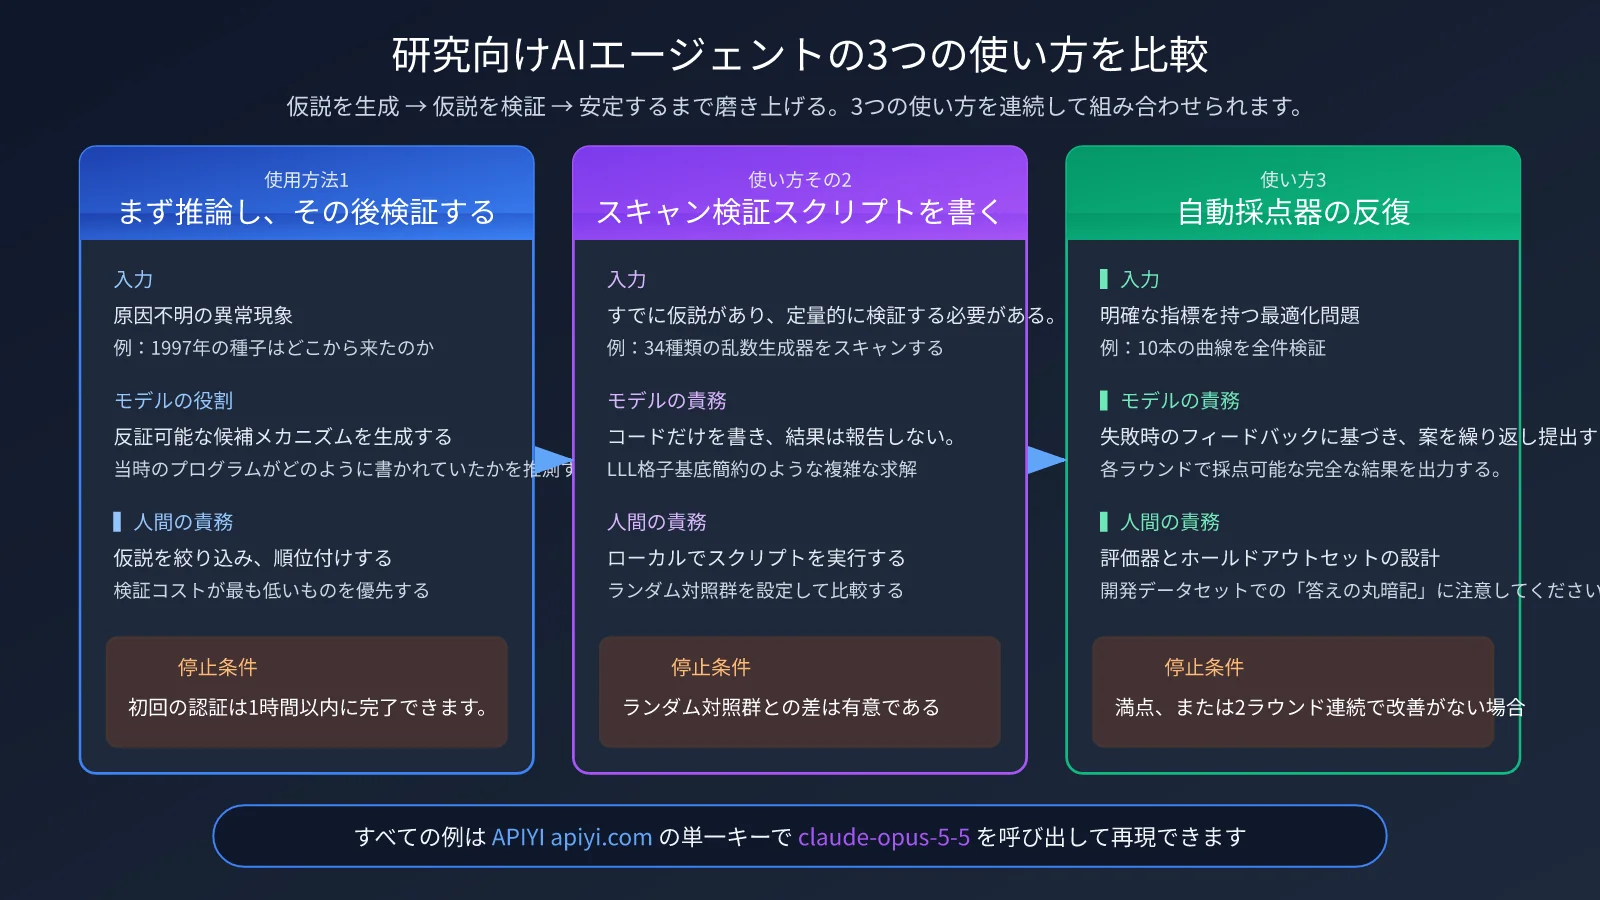
| 観点 | 使い方1:仕組みを推論する | 使い方2:スキャン・検証スクリプトを書く | 使い方3:自動スコアで反復する |
|---|---|---|---|
| 対応する事例の段階 | 1997年当時のプログラムの書き方を推論 | 34種類の生成器をスキャンし、統計的特徴を探す | 状態復元後、10個の曲線ですべて検証 |
| 適したタスク | 原因不明の異常、リバースエンジニアリングによる推測 | 仮説がすでにあり、定量的に検証したい場合 | 明確な指標がある最適化問題 |
| モデルの役割 | 反証可能な仕組みの候補を生成 | 結果を報告せずにコードを書く | 案を繰り返し提出する |
| 人の役割 | 仮説を選別し、優先順位を付ける | ローカルで実行し、対照群と比較する | スコアラーとホールドアウトセットを設計する |
| フラッグシップモデルを使う場面 | 最終的な推論と優先順位付け | LLLなど、複雑な求解処理を実装 | 本実験のラウンド |
| 停止条件 | 1時間以内に最初の検証を完了できる | ランダム対照との間に有意な差がある | 満点、または2ラウンド連続で改善なし |
| 呼び出し方法 | APIYI apiyi.comの統一インターフェース | 同左 | 同左 |
3つの使い方は、連続して活用できます。使い方1で仮説を立て、使い方2で検証し、使い方3で検証済みの方法を安定するまで磨き上げます。
なぜClaudeのような研究タスクにはフラッグシップモデルが必要なのか
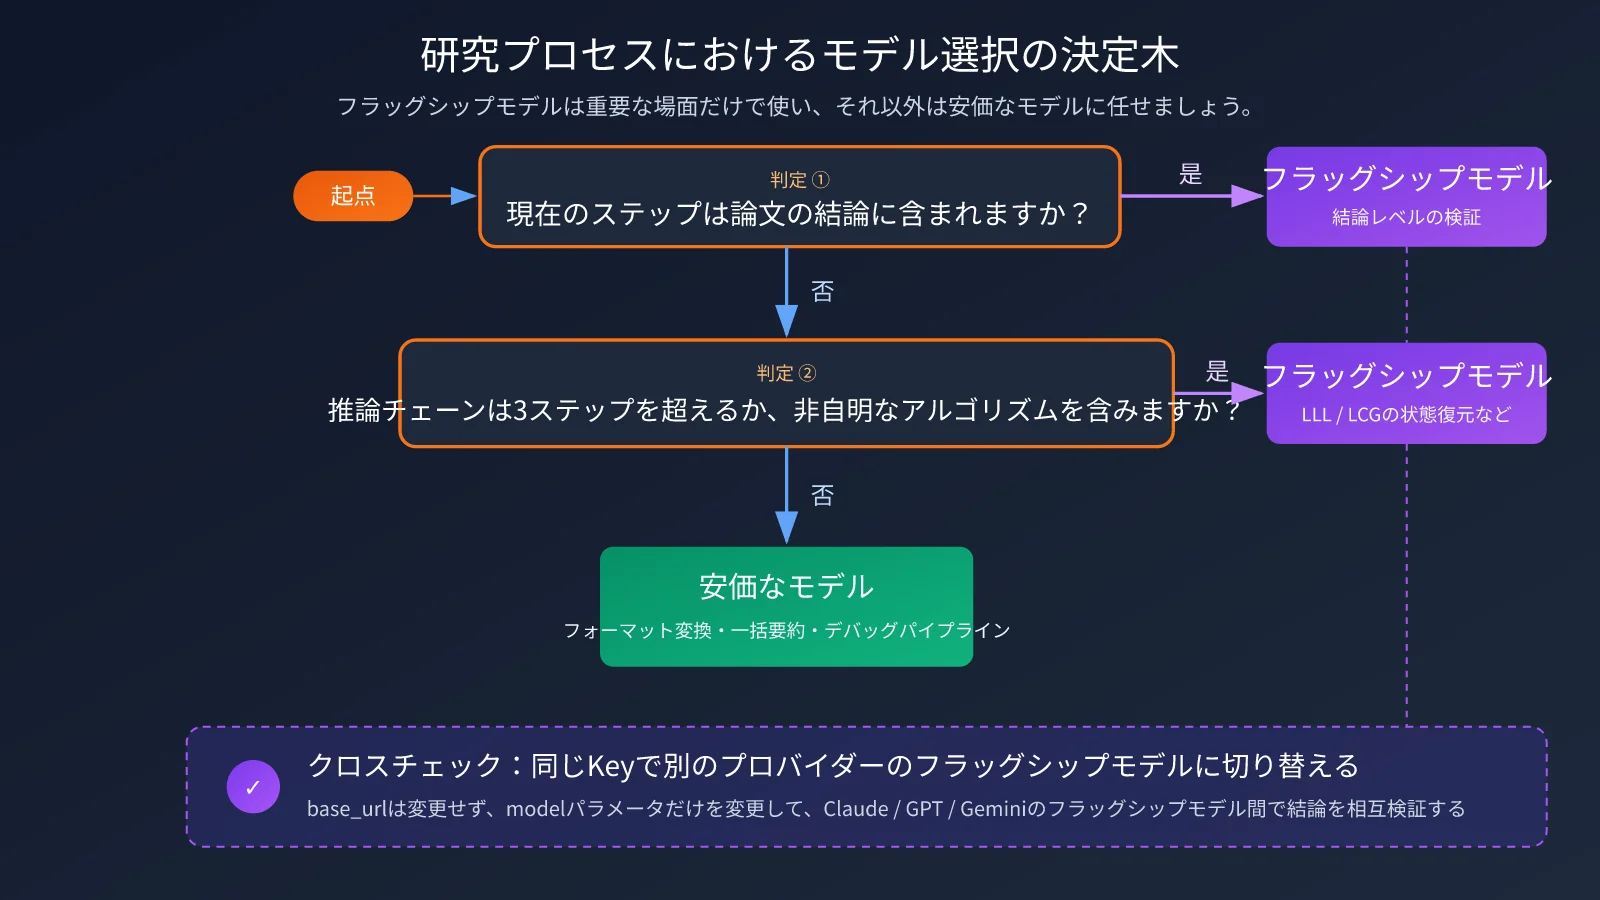
研究のすべての工程にフラッグシップモデルが必要なわけではありません。ただし、小型モデルに切り替えるとほとんど対応できないタスクもあります。次の表を目安に判断してください。
| 判断基準 | 該当する場合はフラッグシップモデルを推奨 | 理由 |
|---|---|---|
| 分野をまたいだ連想が必要 | たとえば「曲線の種」から「90年代のCライブラリの実装詳細」を連想する | 小型モデルは問題の表面にとどまり、短いフレーズを推測し続ける傾向があります |
| 推論が3段階を超え、各段階が前の段階に依存する | たとえば、推論→探索→署名→状態復元 | 途中の段階で誤りがあると、その後の結果もすべてずれてしまいます |
| 自分の仮説を疑う必要がある | たとえば、「テスト環境で実験しているのではないか」と疑う | フラッグシップモデルのほうが、反例を自発的に探す可能性が高くなります |
| 自明でないアルゴリズムを扱う | たとえば、LLL格子基底簡約や切り詰めLCGの状態復元 | コードの正しさが、検証の成否を直接左右します |
| 結論が論文に掲載される、または実験への投資判断に使われる | 外部に公表する結論全般 | 誤りによる損失は、モデルの呼び出しコストをはるかに上回ります |
一方、フォーマット変換、一括要約、評価器パイプラインのデバッグなどは、安価なモデルで十分です。コストを抑えるポイントは、フラッグシップモデルの利用を減らすことではなく、上の表に挙げた場面だけで使うことです。
よくある質問(FAQ)
Q1:ClaudeはNISTの楕円曲線を解読したのですか?
いいえ。Claudeが復元したのは種の生成過程です。この種は、タイムスタンプを初期値としてlrand48で生成されたものです。これは新しい攻撃手法ではなく、脆弱性を示すものでもありません。ユーザーが設定を変更したり、移行したりする必要はありません。この結論はむしろ、種が人為的に選ばれたものではないことを示しています。
Q2:この方法は従来の総当たり探索とどう違うのですか?
総当たり探索は、固定された仮説空間の中ですべての候補を試します。Claudeはまず仮説空間そのものを切り替え、「どのフレーズがハッシュ化されたか」ではなく、「どの乱数生成器が使われたか」を考えました。そのうえで、限られた範囲(隠れた17ビット、2^17通り)を総当たりで探索しています。成否を分けたのは、最初の切り替えです。
Q3:この研究はいつ発表されましたか?未解決の点はありますか?
Anthropicの研究ページと@AnthropicAIの投稿は、どちらも2026年10月17日に公開されました。現時点ではB-163の種は解読されておらず、P-224からP-521までの基点Gの生成方法も不明です。また、候補となる曲線の一部が除外されていますが、その理由も分かっていません。
Q4:どのような研究場面で、3つの使い方を応用できますか?
– **実験の異常原因を特定する**:計測器のデータに周期的なアーティファクトが現れた場合、使い方1でデータ収集ソフトウェアの実装方法を推定します。
– **過去の論文を再現する**:パラメーターが欠けている場合、使い方2で候補となるパラメーターの組み合わせを探索します。
– **データの抽出とクリーニング**:使い方3と評価器を組み合わせ、ルールを反復的に調整して安定させます。
Q5:1つのAPIキーで複数のフラッグシップモデルを呼び出し、クロスチェックするには?
APIYI(apiyi.com)に登録してAPIキーを作成し、base_urlを`https://api.apiyi.com/v1`に設定します。あとは`model`パラメーターを変更するだけで、claude-opus-5-5とGPT系、Gemini系のフラッグシップモデルを切り替えられます。利用可能なモデル名は、コンソールの一覧をご確認ください。
Q6:研究用AIエージェントには、どのような既知の制限がありますか?
– モデルは、もっともらしい仕組みをでっち上げることがあります。そのため、すべての結論にローカルで実行できる検証スクリプトが必要です。
– 評価器を反復的に調整すると、開発データに過学習するおそれがあります。必ずホールドアウトセットを用意してください。
– 複数回の呼び出しはコストが積み重なります。まず安価なモデルで一連の処理を動かし、usageも記録してください。料金体系はAPIYI(apiyi.com)のコンソールで確認できます。
研究型AIエージェントの要点 Key Takeaways
- 結論の範囲:Claudeが解明したのはシードの由来であり、暗号上の脆弱性ではありません。むしろ、曲線の信頼性は高まりました。
- 重要な一手:古い仮説空間で計算量を増やすより、仮説空間そのものを切り替えるほうが効果的です。
- 検証を優先:モデルにスクリプトを書かせ、人が実行し、必ずランダムなベースラインと比較します。
- スコアラーの反復ループ:決定論的なスコアリングとホールドアウトセットを組み合わせ、スコアが収束したら反復を止めます。
- モデルの使い分け:安価なモデルで手順を整え、最先端モデルは重要な推論と検証にのみ使います。
- 始め方:APIYI(apiyi.com)で1つのAPIキーを使ってclaude-opus-5-5を呼び出し、ほかのモデルに切り替えてクロスチェックします。
まとめ
ClaudeがNISTの楕円曲線シードの謎を解明したことから、研究者が得られる示唆は主に3つあります。
- まず生成メカニズムを推論する:「答えは何か」を直接推測するのではなく、「データはどのように生成されたのか」から考えます。
- スクリプトで検証する:各仮説に、実行可能な検証コードとランダムな対照条件を用意します。
- スコアラーの反復ループを構築する:判定を決定論的なプログラムに任せ、収束するまで反復し、ホールドアウトセットで過学習を確認します。
コスト管理は常に前提です。まずは安価なモデルで手順を整え、論文の結論や複雑なアルゴリズムに関わる段階で最先端モデルに切り替えましょう。APIYI(apiyi.com)を使って、この記事のコードを最初から最後まで実行してみるのがおすすめです。まず公式の再現コードでP-256のシードを確認し、その後、3つの使い方を自分の研究テーマに応用してみてください。
関連記事
- 📘 OpenAI SDKでClaudeシリーズのモデルを呼び出す方法 – 互換インターフェースのパラメーターの違いを確認できます
- 📊 大規模言語モデルAPIの呼び出しコストを管理する実践方法 – usageの統計と予算アラートの設定方法を学べます
- 🚀 複数モデルによるクロスチェックのワークフロー構築 – 異なるフラッグシップモデル同士で結論を照合できます
📚 参考資料
- Anthropic Frontier Red Teamの研究ページ:ECDSA曲線のシードの由来に関する研究
- リンク:
www.anthropic.com/research/ecdsa-curve-origins -
説明:一次資料です。詳しい手法、未解決の課題、CC0ライセンスの再現コードが掲載されています。
-
@AnthropicAIの公式X投稿(2026-10-17):「It is just timestamps.」
- リンク:
x.com/AnthropicAI -
説明:公式発表です。コミュニティでの議論もこちらから確認できます。
-
APIYIドキュメントセンター:OpenAI互換インターフェースの利用方法
- リンク:
docs.apiyi.com - 説明:base_urlの設定、モデル一覧、料金について説明しています。
著者: APIYI技術チーム
技術交流: 研究でAIエージェントを活用する方法を、ぜひコメント欄で共有してください。接続に関する資料は、APIYI docs.apiyi.comのドキュメントセンターをご覧ください。