Nota del autor: analizamos cómo Claude dedujo el origen de las semillas de las curvas elípticas del NIST, aclaramos los límites de esta conclusión y presentamos 3 usos de agentes de IA que los investigadores pueden aplicar directamente, con código y métodos para controlar los costos.
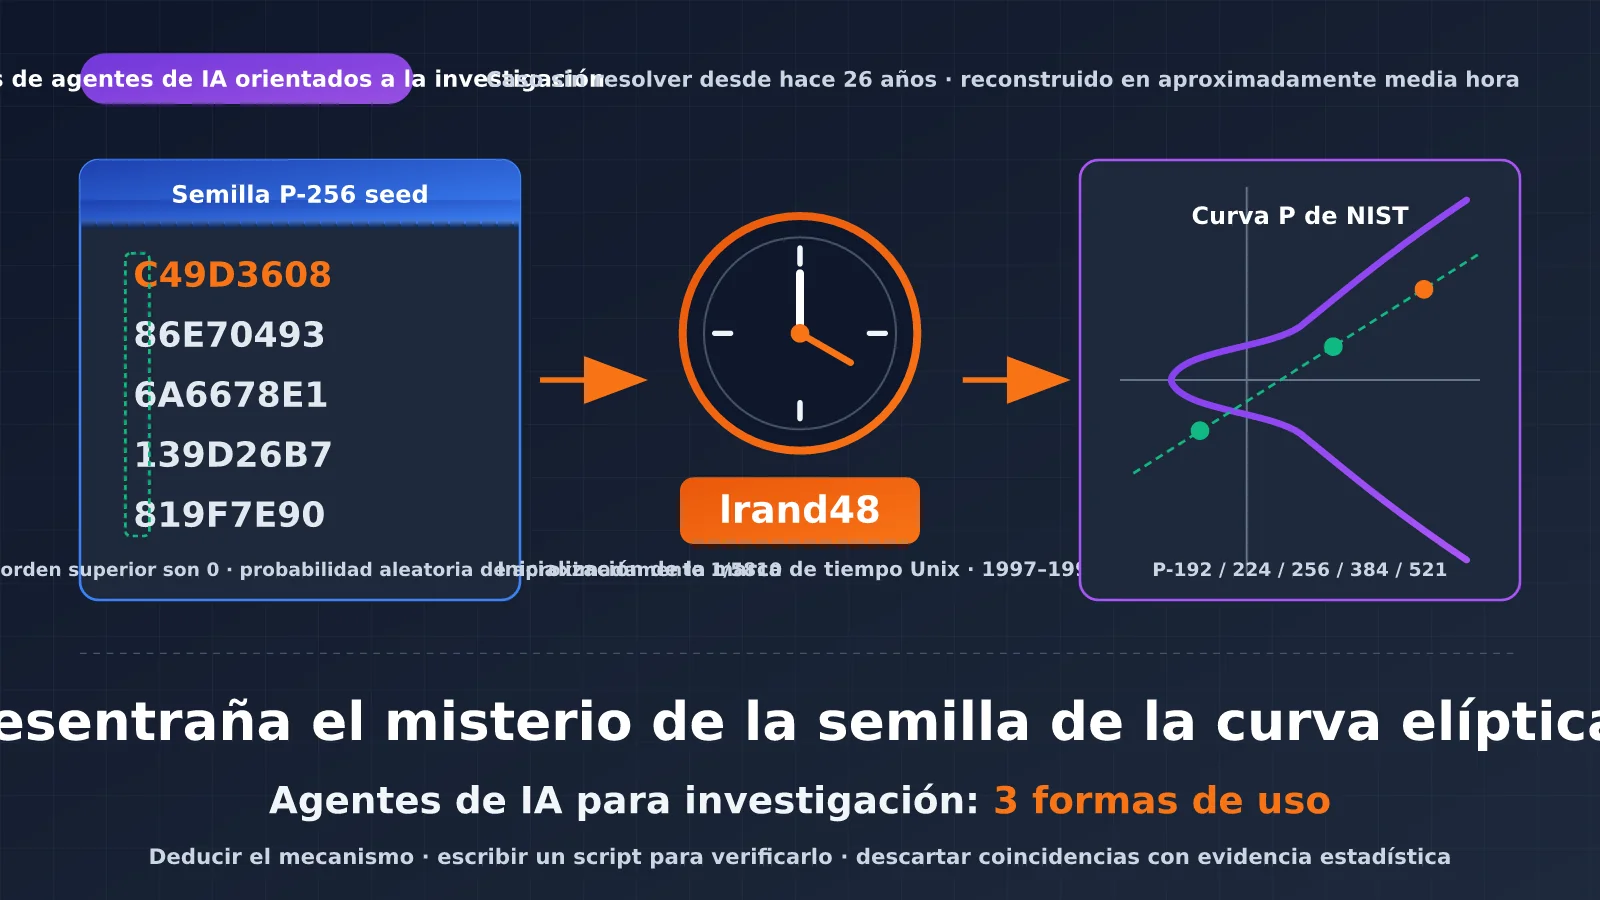
El 17 de octubre de 2026, Anthropic Frontier Red Team publicó un estudio: un modelo de investigación interno dedujo, en aproximadamente media hora y sin recibir ninguna indicación, cómo se generaron las semillas de las cinco curvas NIST P-192, P-224, P-256, P-384 y P-521. Estas semillas no se procesaron con ningún algoritmo hash: eran resultados del generador de números pseudoaleatorios lrand48, incluido en las bibliotecas de C de los años noventa, cuyo valor inicial era una marca de tiempo de Unix. La publicación oficial de @AnthropicAI solo decía: “It is just timestamps.” y alcanzó unas 855.000 visualizaciones.
Esto no es un ataque criptográfico ni una vulnerabilidad nueva. Para los investigadores, el valor de este caso está en la forma de trabajar de Claude: deducir el mecanismo, escribir un script para comprobarlo y descartar coincidencias con pruebas estadísticas. Este flujo de trabajo se puede aplicar directamente a tus propios proyectos.
Valor principal: al terminar de leer, sabrás qué demuestra este caso y qué no. También encontrarás 3 flujos de trabajo con agentes de IA para investigación que puedes empezar a usar de inmediato, cada uno con pasos de uso y código ejecutable.
Claude resuelve el misterio de la semilla de la curva elíptica de NIST: puntos clave
| Punto clave | Descripción | Qué significa para el personal investigador |
|---|---|---|
| Contexto del misterio | En 2000, NIST adoptó ECDSA en FIPS 186-2. La NSA proporcionó las semillas de las curvas, pero no explicó su origen. | Un problema que nadie había resuelto en 26 años puede servir para evaluar la capacidad de razonamiento de la IA. |
| Conclusión | Las semillas procedían de salidas de lrand48, inicializado con marcas de tiempo de entre mayo de 1997 y abril de 1998. |
Cualquiera puede reproducir la conclusión; verificarla cuesta muy poco. |
| Método clave | Deducir cómo se habría escrito el software, crear un escáner propio, localizar el patrón estadístico y recuperar el estado. | Estos tres pasos se pueden aplicar al análisis de datos experimentales, la ingeniería inversa y otras tareas. |
| Implicaciones de seguridad | No se trata de una vulnerabilidad; no es necesario cambiar la configuración ni migrar. | Al escribir una revisión o un informe, conviene describirlo con precisión y no exagerar su alcance. |
| Cuestiones pendientes | La semilla de B-163 sigue sin resolverse, y aún se desconoce cómo se generó el punto base G de P-224 a P-521. | Las conclusiones de la IA también tienen límites; hay que dejar constancia de lo que sigue sin resolverse. |
El misterio de las semillas de las curvas elípticas de NIST: qué demuestra este hallazgo
El estándar ECDSA publica una semilla para cada curva; su hash se utiliza para determinar el coeficiente b de la curva. La semilla de P-256 es C49D3608 86E70493 6A6678E1 139D26B7 819F7E90. Como nunca se explicó su origen, durante mucho tiempo la comunidad temió que la NSA hubiera elegido deliberadamente parámetros con puntos débiles. Koblitz y Menezes escribieron la revisión «A Riddle Wrapped in an Enigma», y Filippo Valsorda llegó a ofrecer una recompensa de 36.864 dólares por resolver el enigma. Durante un tiempo circuló el rumor de que Jerry Solinas había generado la semilla usando el hash de una broma; después se demostró que esa versión era falsa.
El efecto práctico de esta conclusión es que refuerza la confianza en estas curvas. Las semillas se generaron con un generador de números pseudoaleatorios convencional inicializado por el reloj, sin margen para elegirlas a dedo. Cualquiera puede reproducir el resultado. El texto original también señala que se descartaron unas pocas curvas candidatas que igualmente eran válidas, aunque se desconoce el motivo. Eran muy pocas, lo que no parece indicar una selección deliberada de curvas débiles. El dinero de la recompensa se donará a Internet Security Research Group.
Al citar este hallazgo en un artículo o en una reunión de grupo, una formulación precisa sería: «La IA reconstruyó el proceso con el que se generó un parámetro histórico y permitió reproducirlo». No conviene decir que «la IA rompió las curvas elípticas».
Los 4 pasos del razonamiento de Claude para resolver las semillas
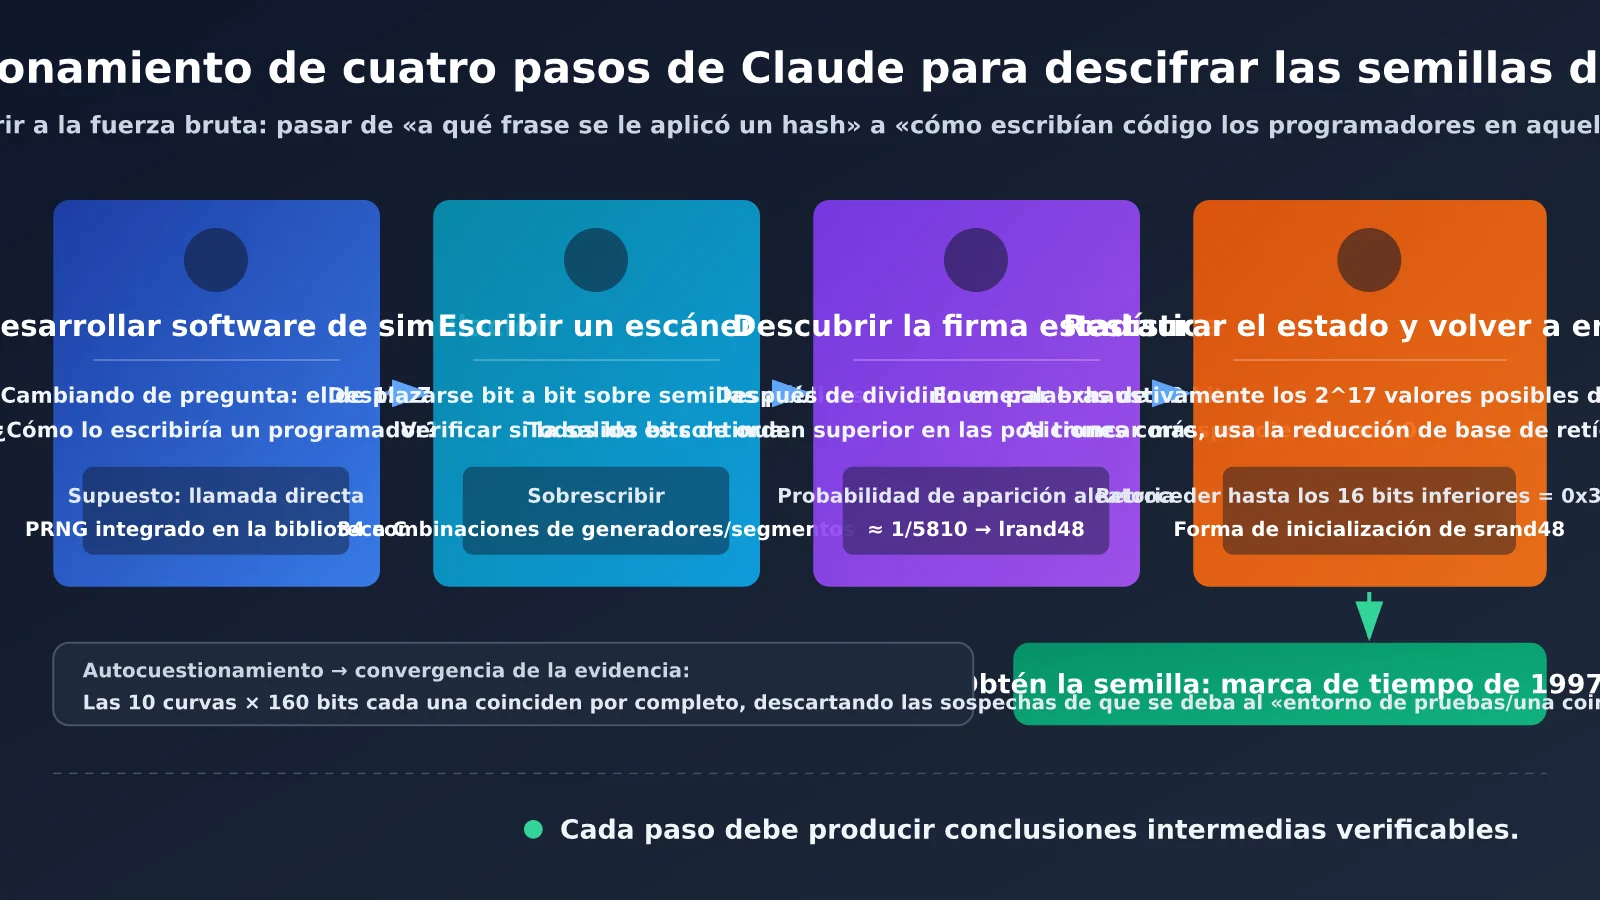
El razonamiento no se basó en hacer conjeturas a ciegas. Todo el proceso siguió una cadena lógica que se puede comprobar:
- Replantear el problema: en lugar de adivinar «qué frase se convirtió en hash», dedujo cómo habría escrito el programa de generación de curvas alguien en 1997. La conclusión fue que probablemente utilizó directamente el generador de números aleatorios incluido en la biblioteca de C.
- Crear un escáner: recorrió las semillas publicadas bit a bit y comprobó si los fragmentos consecutivos se parecían a salidas sucesivas de algún generador de los años noventa. En total, cubrió 34 combinaciones de generadores y segmentos.
- Detectar el patrón estadístico: al dividir las semillas en palabras de 32 bits, todos los bits más significativos de las posiciones correspondientes eran cero. La probabilidad de que esto ocurriera al azar era de aproximadamente 1 entre 5810. El patrón encajaba con
lrand48, que solo devuelve los 31 bits más altos de un estado de 48 bits. - Recuperar el estado y retroceder: probó las 2^17 combinaciones de los 17 bits ocultos y las validó con las palabras siguientes. Para las semillas con más bits truncados, recurrió a la reducción de base de retículos LLL. Después retrocedió el estado hasta encontrar el patrón de inicialización de
srand48: los 16 bits inferiores eran iguales a 0x330E.
Hubo además un detalle interesante durante el razonamiento: por un momento, el modelo sospechó que podía estar en un entorno de prueba. Luego descartó esa posibilidad con un argumento: «10 curvas, 160 bits cada una, y todo coincide; no puede ser casualidad». Esa forma de «cuestionar primero la propia conclusión y luego zanjar la duda con pruebas» es justo lo que más se necesita de un agente de investigación.
Guía rápida para crear un agente de IA para investigación científica: llama a modelos insignia con una sola clave
Antes de empezar, asegúrate de que la cadena de llamadas a la API funciona. APIYI ofrece una interfaz compatible con OpenAI: con una sola clave puedes llamar a claude-opus-5-5 o cambiar a modelos insignia de las familias GPT y Gemini para contrastar resultados.
No hace falta repetir aquí los pasos de integración. Consulta directamente la guía oficial de inicio rápido de APIYI: docs.apiyi.com/getting-started. Sigue las instrucciones para crear una clave en la consola y obtener el base_url (https://api.apiyi.com/v1). Después, usa el ejemplo de la documentación para confirmar que todo funciona. Consulta la consola para ver los precios y los modelos disponibles.
Los tres usos que veremos más adelante comparten una pequeña capa de código. Guárdala como research_client.py. Su función principal es elegir un modelo según la etapa y acumular el uso de tokens para controlar los costos.
# research_client.py
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1")
CHEAP = os.environ.get("CHEAP_MODEL", "claude-opus-5-5")  # 填控制台里的轻量模型名
FLAGSHIP = "claude-opus-5-5"
USAGE = {"prompt": 0, "completion": 0, "calls": 0}


def chat(messages, stage="draft", max_tokens=2048, temperature=0.2):
    """stage='draft' 走便宜模型;stage='verify' 走旗舰模型。"""
    r = client.chat.completions.create(model=FLAGSHIP if stage == "verify" else CHEAP,
        messages=messages, max_tokens=max_tokens, temperature=temperature)
    USAGE["prompt"] += r.usage.prompt_tokens
    USAGE["completion"] += r.usage.completion_tokens
    USAGE["calls"] += 1
    return r.choices[0].message.content


def ask(prompt, stage="draft", system=None, max_tokens=2048):
    msgs = ([{"role": "system", "content": system}] if system else []) + [{"role": "user", "content": prompt}]
    return chat(msgs, stage=stage, max_tokens=max_tokens)


def report():
    print(f"累计调用 {USAGE['calls']} 次,prompt={USAGE['prompt']},completion={USAGE['completion']}")
Cómo controlar los costos de un agente de IA para investigación: depura con modelos económicos y reserva los insignia para las verificaciones importantes
Las tareas de investigación suelen requerir varias rondas de iteración. Si usas un modelo insignia desde el principio, consumirás cuota en problemas de poco valor, como errores de formato o fallos al analizar JSON. Una opción más segura es asignar los modelos según la etapa:
| Etapa | Modelo recomendado | Criterio de evaluación | max_tokens habitual |
|---|---|---|---|
| Depuración del flujo (formato de la indicación, análisis y evaluador) | Modelo ligero y económico | El flujo se ejecuta de principio a fin sin errores | 512-1024 |
| Generación de hipótesis (enumerar mecanismos candidatos) | Prioriza un modelo ligero; cambia a uno insignia si la cobertura es insuficiente | La lista de candidatos incluye las hipótesis principales que ya conoces | 1024-2048 |
| Deducción de mecanismos y verificaciones clave | claude-opus-5-5 | Las conclusiones se incluirán en un artículo o determinarán la inversión en experimentos posteriores | 2048-4096 |
| Validación cruzada | Cambia a otro modelo insignia con la misma clave | Ambos modelos llegan de forma independiente a la misma conclusión | 2048 |
Como regla práctica, recuerda esto: la primera vez que ejecutes el script, usa un modelo económico; la primera vez que presentes una conclusión, usa un modelo insignia.
Uso 1 de un agente de IA para investigación científica: deduce primero los mecanismos y luego verifícalos
Este paso corresponde a la idea de Claude de «cambiar la pregunta»: en lugar de adivinar directamente la respuesta, primero deduce el mecanismo que pudo generar los datos y después contrástalo con ellos. Es útil en situaciones como estas: los datos experimentales muestran patrones anómalos, necesitas inferir cómo se generaron datos históricos o no encuentras el origen de los parámetros al intentar reproducir un artículo.
Pasos
- Describe solo lo que observas, sin sugerir explicaciones: proporciona al modelo los datos observados, las restricciones conocidas y el contexto histórico. Evita frases como «creo que se debe a XX» para no sesgarlo.
- Pide que enumere mecanismos y predicciones falsables: cada mecanismo candidato debe incluir una predicción del tipo «si este mecanismo es correcto, ¿qué característica debería aparecer en los datos?».
- Ordena las opciones según el costo de verificación: pide al modelo que las ordene de menor a mayor según el tiempo necesario para verificarlas. Empieza por las más económicas.
- Pide a un modelo insignia que revise el orden: puedes generar la lista de candidatos primero con un modelo económico y dejar la clasificación definitiva y la deducción en manos de claude-opus-5-5.
Plantilla de indicación
from research_client import ask, report

PROMPT = """你是一名严谨的研究助理。下面是一组观测数据和背景,不包含任何关于成因的线索。

【观测】
{observation}

【背景约束】
{context}

请完成:
1. 推演“产生这组数据的过程最可能怎么实现”,至少列出 5 个候选机制;
2. 每个机制给出一条可证伪预测:若成立,数据中必然出现的可检验特征;
3. 估计验证每条预测的成本(低/中/高),按成本升序输出;
4. 指出你最不确定的环节。
输出为 Markdown 表格 + 简短说明。"""

draft = ask(PROMPT.format(
    observation="NIST P-256 种子:C49D3608 86E70493 6A6678E1 139D26B7 819F7E90",
    context="1997-1998 年由政府机构用软件生成;官方未公布生成方法;常见猜测为短语哈希但未被证实",
), stage="draft")

final = ask("请审查并修正以下候选机制列表,删除无法证伪的条目,重新排序:\n" + draft,
            stage="verify", max_tokens=3000)
print(final)
report()
Para determinar si este paso es satisfactorio, comprueba dos cosas: que cada mecanismo tenga una predicción falsable y que la verificación situada en primer lugar pueda completarse en menos de una hora. Si alguna de las dos condiciones no se cumple, pide al modelo que lo reescriba.
Uso dos de un agente de IA para investigación: pedirle que escriba scripts de exploración y validación
Este paso corresponde a la forma en que Claude escribió su propio escáner para cubrir 34 combinaciones de generadores y segmentos. La clave está en transformar «parece que sí» en «es poco probable que sea una coincidencia desde el punto de vista estadístico». Este enfoque también sirve para tareas como explorar parámetros, detectar señales o buscar estructuras ocultas en los datos.
Pasos
- Entrega al modelo la predicción de menor coste de validación del uso uno y pídele que escriba un script de exploración que solo dependa de la biblioteca estándar.
- Pídele que ejecute también un conjunto de controles aleatorios y muestre las tasas de acierto de los datos reales y de los datos aleatorios.
- Ejecuta el script localmente. El modelo solo debe escribir el código, no informar de los resultados.
- Si el resultado es significativo, pide a un modelo insignia que escriba un script más estricto para recuperar el estado o realizar el ajuste.
Ejemplo: reproducir una firma estadística del tipo «todos los bits altos son 0»
El siguiente script ilustra el principio de la firma observada en este caso. lrand48 devuelve los 31 bits más altos de un estado de 48 bits, así que, al guardar el resultado en una palabra de 32 bits, el bit más alto siempre será 0. En datos verdaderamente aleatorios, la probabilidad de que el bit más alto de cada palabra sea 0 es solo del 50 %.
import os

def lrand48_stream(seed32, n):
    x = (seed32 << 16) | 0x330E          # 初始化 srand48:低 16 位固定为 0x330E
    out = []
    for _ in range(n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        out.append(x >> 17)               # lrand48 只返回高 31 位
    return out

def top_bit_zero_ratio(words):
    return sum(1 for w in words if w >> 31 == 0) / len(words)

lr = lrand48_stream(870000000, 20)        # 1997 年前后的某个 Unix 时间戳
rnd = [int.from_bytes(os.urandom(4), "big") for _ in range(20)]
print("lrand48 最高位为 0 的比例:", top_bit_zero_ratio(lr))   # 恒为 1.0
print("真随机  最高位为 0 的比例:", top_bit_zero_ratio(rnd))  # 约 0.5 上下波动
Verificar la conclusión final con el código oficial
La página de investigación de Anthropic incluye código de reproducción publicado bajo la licencia CC0. Según las instrucciones oficiales, con el siguiente conjunto de parámetros debería obtenerse la semilla del estándar P-256:
from datetime import datetime, timezone

def unix(when):
    return int(datetime.fromisoformat(when).replace(tzinfo=timezone.utc).timestamp())

def candidate(t, n, per, shift, width):
    x, out = (t << 16) | 0x330E, ""
    for i in range(per * n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        if i >= per * (n - 1):
            out += "%0*X" % (width, x >> shift)
    return out

seed = candidate(unix("1997-08-16 01:52:34"), 1842, 20, 40, 2)
print(seed)
print("与标准一致:", seed == "C49D360886E704936A6678E1139D26B7819F7E90")
El script funciona así: inicializa lrand48 con una marca de tiempo y agrupa cada 20 salidas para formar una semilla candidata de 20 bytes. La candidata número 1842 es la semilla del estándar. Toda la verificación se completa en menos de un segundo en un portátil normal. «Proponer una hipótesis cuesta mucho, pero verificar la conclusión cuesta poco»: esa es la estructura ideal para este tipo de investigación.
Uso tres de un agente de IA para investigación: añadir un evaluador automático e iterar hasta que la puntuación converja
Los dos primeros usos dependen de una persona para evaluar los resultados; el tercero delega esa evaluación en un programa. Escribes un evaluador, el modelo presenta una solución en cada ronda y el evaluador devuelve una puntuación y los casos fallidos. A partir de esa información, el modelo modifica la solución hasta que la puntuación deja de mejorar. Este método es adecuado para tareas con métricas de evaluación claras, como definir reglas de extracción de datos, ajustar la forma de una función o buscar parámetros experimentales.
Pasos
- Escribe primero el evaluador; luego busca un modelo: debe ser un programa determinista y no depender de que el propio modelo se puntúe.
- Divide los datos en un conjunto de desarrollo y otro de reserva: usa solo el conjunto de desarrollo para dar retroalimentación y, al final, comprueba si hay sobreajuste con el conjunto de reserva.
- Limita el formato de las entregas: pide al modelo datos como JSON o expresiones regulares para evitar ejecutar código generado directamente. Si es imprescindible ejecutar código, hazlo en un entorno aislado.
- Define las condiciones de convergencia: detén el proceso al cumplirse cualquiera de estas condiciones: obtener la puntuación máxima, no mejorar durante dos rondas consecutivas o alcanzar el máximo de rondas.
- Ajusta el ciclo con un modelo económico y, después, cambia a uno insignia para el experimento formal.
Ejemplo: iterar sobre expresiones regulares para extraer parámetros de registros experimentales
import json, re
from research_client import chat, report

DEV = [
    ("样品A在 350 ℃ 退火 2 小时后测得电导率 4.1 S/m。", {"temp_c": 350, "hours": 2, "cond": 4.1}),
    ("退火温度 420°C,保温 1.5 h,电导率为 12.3 S/m。", {"temp_c": 420, "hours": 1.5, "cond": 12.3}),
    ("B组:300摄氏度下处理 3 小时,σ=0.85 S/m。", {"temp_c": 300, "hours": 3, "cond": 0.85}),
    ("在450 ℃条件下退火4h,测得电导率 20 S/m。", {"temp_c": 450, "hours": 4, "cond": 20}),
]
HOLDOUT = [
    ("样品E 380 ℃ 退火 2.5 小时,电导率 7.6 S/m。", {"temp_c": 380, "hours": 2.5, "cond": 7.6}),
    ("C组于 500°C 保温 0.5 h,σ = 33.1 S/m。", {"temp_c": 500, "hours": 0.5, "cond": 33.1}),
]
FIELDS = ["temp_c", "hours", "cond"]

def score(patterns, data):
    hit, fails = 0, []
    for idx, (text, label) in enumerate(data):
        for f in FIELDS:
            try:
                m = re.search(patterns.get(f, "(?!)"), text)
                ok = m is not None and abs(float(m.group(1)) - label[f]) < 1e-9
            except (re.error, IndexError, ValueError, TypeError):
                ok = False
            hit += ok
            if not ok:
                fails.append(f"样本{idx} 字段{f} 抽取失败:{text}")
    return hit / (len(data) * len(FIELDS)), fails

def parse_json(text):
    return json.loads(text[text.find("{"): text.rfind("}") + 1])

messages = [{"role": "user", "content":
    "为下列实验记录写 Python 正则,抽取 temp_c、hours、cond 三个字段,每个正则恰好一个捕获组,捕获纯数字。"
    "只输出 JSON,例如 {\"temp_c\": \"...\", \"hours\": \"...\", \"cond\": \"...\"},注意转义反斜杠。\n"
    + "\n".join(t for t, _ in DEV)}]

best, stale, patterns = -1.0, 0, {}
for rnd in range(6):
    reply = chat(messages, stage="draft", max_tokens=800)   # 跑通后把 stage 改为 "verify"
    try:
        patterns = parse_json(reply)
        s, fails = score(patterns, DEV)
    except (ValueError, json.JSONDecodeError):
        s, fails = 0.0, ["输出不是合法 JSON"]
    print(f"第 {rnd + 1} 轮 开发集得分 {s:.2f}")
    if s >= 1.0:
        break
    stale = stale + 1 if s <= best else 0
    best = max(best, s)
    if stale >= 2:
        break
    messages += [{"role": "assistant", "content": reply},
                 {"role": "user", "content": "以下抽取失败,请修改正则后重新输出完整 JSON:\n" + "\n".join(fails)}]

print("留出集得分:", score(patterns, HOLDOUT)[0])
report()
Hay que tener en cuenta algo importante: si el modelo obtiene la puntuación máxima en el conjunto de desarrollo, pero la puntuación cae notablemente en el conjunto de reserva, es señal de que está «memorizando las respuestas». En ese caso, amplía el conjunto de desarrollo en lugar de seguir iterando.
Comparación de los tres usos de un agente de IA para investigación
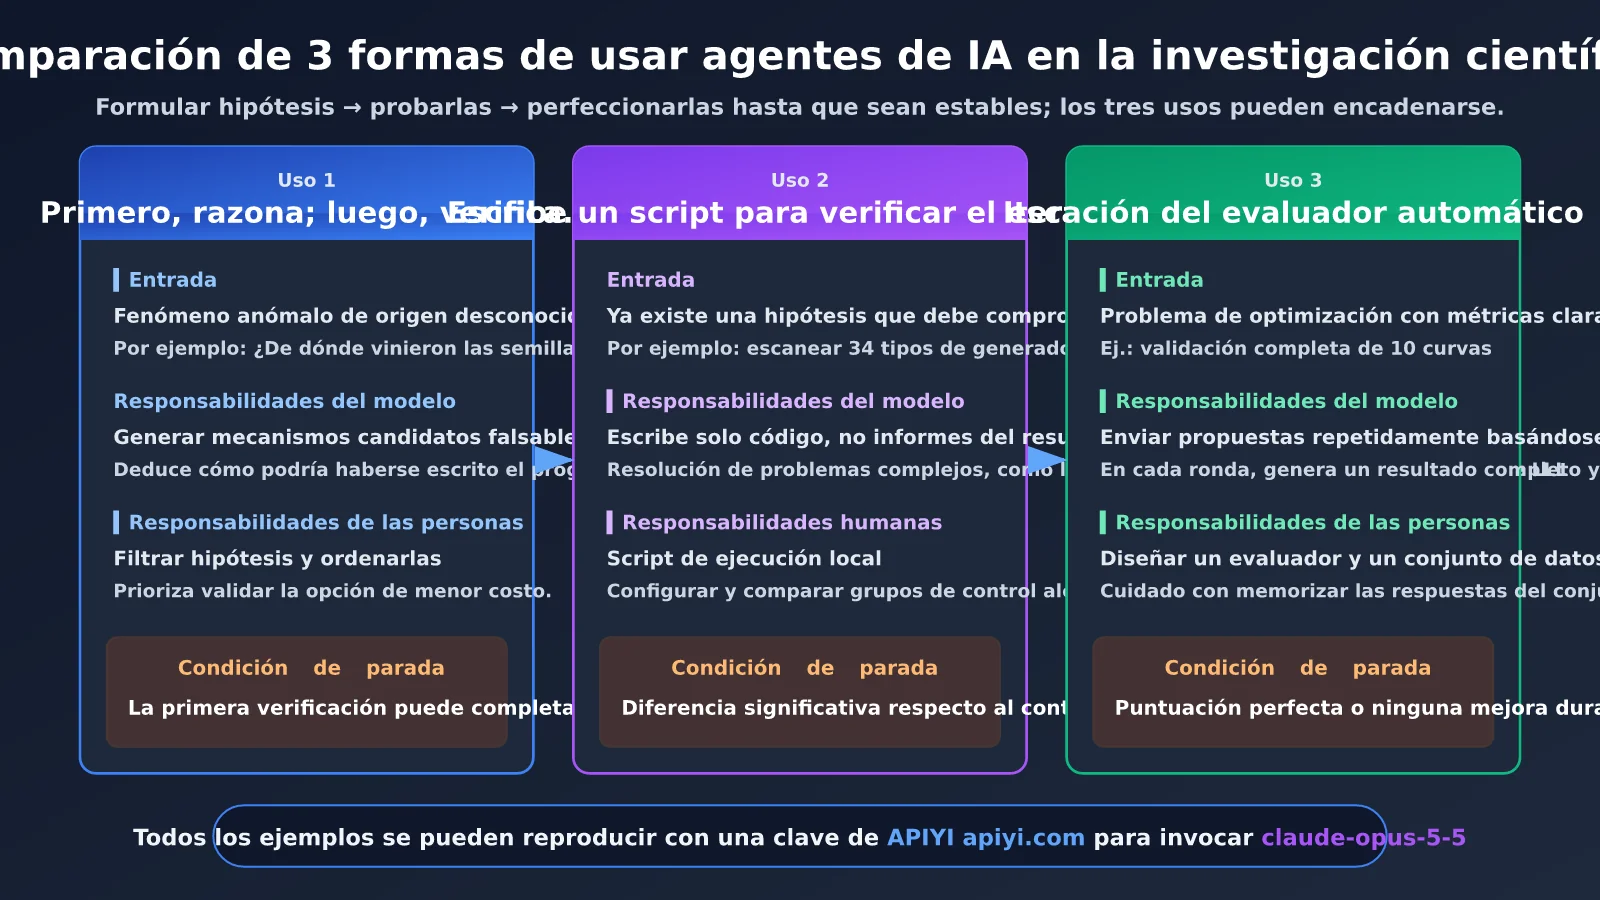
| Dimensión | Uso uno: razonar sobre el mecanismo | Uso dos: escribir scripts de exploración y validación | Uso tres: iterar con evaluación automática |
|---|---|---|---|
| Etapa del caso correspondiente | Inferir cómo se escribió el programa en 1997 | Explorar 34 generadores y encontrar firmas estadísticas | Validar por completo 10 curvas tras recuperar el estado |
| Tareas adecuadas | Anomalías de causa desconocida y deducciones de ingeniería inversa | Comprobar cuantitativamente una hipótesis existente | Problemas de optimización con métricas claras |
| Responsabilidad del modelo | Generar mecanismos candidatos que puedan refutarse | Escribir código, sin informar de resultados | Presentar soluciones de forma iterativa |
| Responsabilidad de la persona | Filtrar y ordenar las hipótesis | Ejecutar el script localmente y revisar el grupo de control | Diseñar el evaluador y el conjunto de reserva |
| Cuándo interviene el modelo insignia | En la inferencia y clasificación finales | Para resolver problemas complejos, como LLL | En las rondas del experimento formal |
| Condición de parada | Poder completar la primera validación en menos de una hora | Diferencia significativa frente al control aleatorio | Puntuación máxima o dos rondas consecutivas sin mejora |
| Forma de invocación | Interfaz unificada de APIYI, apiyi.com | Igual | Igual |
Los tres usos se pueden combinar: el uso uno genera hipótesis, el dos las pone a prueba y el tres perfecciona las soluciones validadas hasta que sean estables.
Por qué las tareas de investigación como esta requieren un modelo insignia de Claude
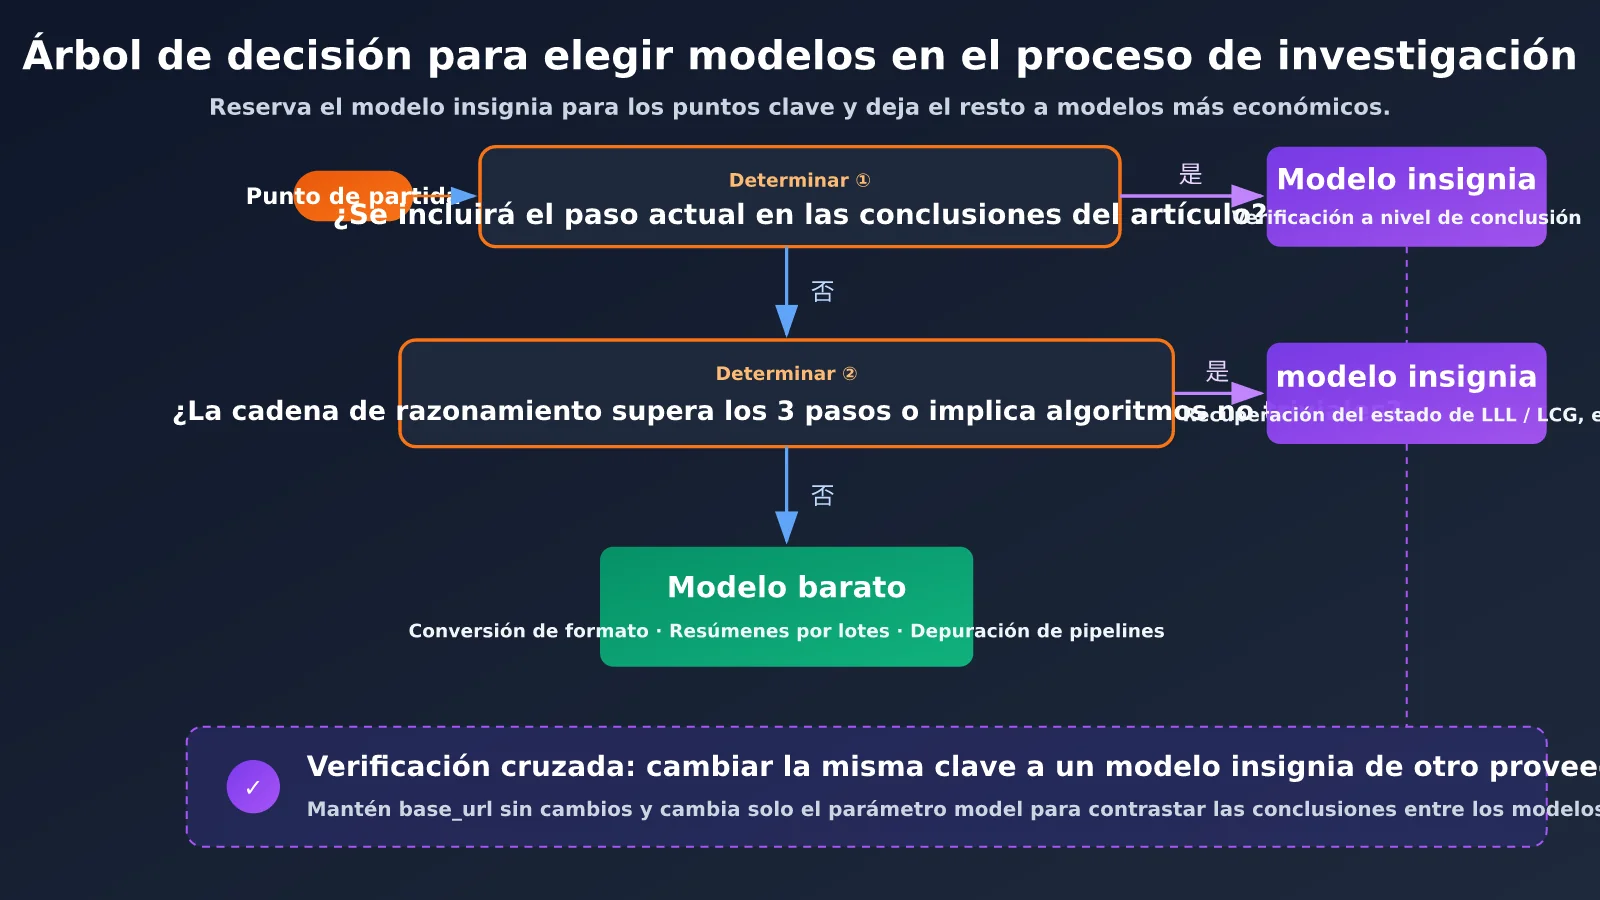
No todos los pasos de una investigación necesitan un modelo insignia, pero hay tareas que prácticamente no se pueden resolver con un modelo pequeño. Puedes usar la siguiente tabla para decidir:
| Criterio | Cuándo conviene usar un modelo insignia | Motivo |
|---|---|---|
| Requiere conectar ideas de distintos campos | Por ejemplo, pasar de «semillas de curvas» a los detalles de implementación de una biblioteca de C de los años 90 | Los modelos pequeños suelen quedarse en la superficie del problema, por ejemplo, seguir intentando adivinar frases |
| La cadena de razonamiento tiene más de 3 pasos y cada uno depende del anterior | Por ejemplo: deducción → búsqueda → firma → recuperación del estado | Si falla un paso intermedio, todo lo que viene después se desvía |
| Requiere cuestionar las propias hipótesis | Por ejemplo, preguntarse «¿y si estoy probando en un entorno de prueba?» | Es más probable que un modelo insignia busque activamente contraejemplos |
| Implica algoritmos no triviales | Por ejemplo, reducción de bases de retículos LLL o recuperación del estado de un LCG truncado | La precisión del código determina directamente si la verificación es válida |
| Las conclusiones se incluirán en un artículo o determinarán la inversión en experimentos | Cualquier conclusión que se vaya a publicar | El costo de equivocarse supera con creces el costo de la invocación |
En cambio, para tareas como convertir formatos, resumir lotes de documentos o depurar una canalización de evaluación, basta con un modelo económico. La clave para controlar los costos no es usar menos modelos insignia, sino reservarlos para los casos de la tabla.
Preguntas frecuentes
Q1: ¿Claude ha descifrado las curvas elípticas de NIST?
No. Claude reconstruyó el proceso de generación de la semilla, que se había generado con lrand48 inicializado mediante una marca de tiempo. No se trata de un nuevo método de ataque ni de una vulnerabilidad, así que los usuarios no necesitan cambiar la configuración ni migrar. De hecho, esta conclusión demuestra que la semilla no se eligió manualmente.
Q2: ¿En qué se diferencia este método de una búsqueda por fuerza bruta tradicional?
La fuerza bruta consiste en probar exhaustivamente las posibilidades dentro de un espacio de hipótesis fijo. Claude primero cambió ese espacio: pasó de «¿qué frase se hasheó?» a «¿qué generador de números aleatorios se usó?». Solo entonces realizó una búsqueda exhaustiva acotada (2^17 bits ocultos). El paso decisivo fue el primero.
Q3: ¿Cuándo se publicó esta investigación? ¿Qué cuestiones siguen sin resolverse?
La página de investigación de Anthropic y la publicación de @AnthropicAI aparecieron el 17 de octubre de 2026. Por ahora, no se ha recuperado la semilla de B-163; tampoco se conoce cómo se generó el punto base G de P-224 a P-521. Además, se omitieron algunas curvas candidatas y se desconoce el motivo.
Q4: ¿En qué situaciones de investigación se pueden aplicar estos tres usos?
– **Investigar anomalías experimentales**: si los datos de un instrumento presentan artefactos periódicos, usa el primer método para deducir cómo está implementado el software de adquisición.
– **Reproducir artículos históricos**: cuando faltan parámetros, usa el segundo método para explorar combinaciones posibles.
– **Extraer y limpiar datos**: usa el tercer método con un evaluador e itera hasta obtener reglas estables.
Q5: ¿Cómo puedo usar una sola Key para invocar varios modelos insignia y hacer una validación cruzada?
Regístrate en APIYI (apiyi.com) y crea una Key. Configura `base_url` como `https://api.apiyi.com/v1` y cambia únicamente el parámetro `model` para alternar entre claude-opus-5-5 y los modelos insignia de las familias GPT y Gemini. Consulta la lista de modelos de la consola para ver los nombres disponibles.
Q6: ¿Qué limitaciones conocidas tienen los agentes de IA para investigación?
– Los modelos pueden inventar mecanismos que parecen razonables, así que cada conclusión debe contar con un script de verificación que se pueda ejecutar localmente.
– Al iterar sobre un evaluador, es fácil sobreajustarlo al conjunto de desarrollo; hay que reservar un conjunto de validación independiente.
– El costo de las invocaciones en varias rondas se acumula. Conviene poner a punto el flujo primero con un modelo económico y registrar el uso. Puedes consultar la facturación en la consola de APIYI (apiyi.com).
Puntos clave de un agente de IA para investigación
- Límites de las conclusiones: Claude reconstruyó el origen de la semilla, no encontró una vulnerabilidad criptográfica. De hecho, la confianza en la curva aumentó.
- El paso clave: Cambiar el espacio de hipótesis es más eficaz que dedicar más capacidad de cómputo al espacio anterior.
- Prioridad a la verificación: El modelo escribe los scripts y las personas los ejecutan. Compara siempre los resultados con una línea base aleatoria.
- Ciclo de evaluación: Combina una evaluación determinista con un conjunto de validación reservado. Detén las iteraciones cuando la puntuación converja.
- Modelos por niveles: Usa modelos económicos para poner a punto el flujo de trabajo y reserva los modelos más avanzados para las deducciones y verificaciones clave.
- Cómo empezar: Usa una sola clave de API de APIYI apiyi.com para invocar claude-opus-5-5 y alterna con otros modelos para contrastar los resultados.
Resumen
La resolución por parte de Claude del misterio de las semillas de las curvas elípticas de NIST ofrece tres lecciones principales para quienes investigan:
- Deduce primero el mecanismo: Parte de cómo se generaron los datos, en lugar de intentar adivinar la respuesta directamente.
- Deja que los scripts hablen: Cada hipótesis debe incluir código de verificación ejecutable y una comparación aleatoria.
- Cierra el ciclo de evaluación: Deja que un programa determinista se encargue de evaluar, itera hasta que los resultados converjan y usa un conjunto de validación reservado para detectar el sobreajuste.
El control de costos es siempre una condición básica: primero pon a punto el flujo de trabajo con un modelo económico y, después, cambia a uno más avanzado para los pasos que impliquen conclusiones de artículos o algoritmos complejos. Se recomienda usar APIYI apiyi.com para ejecutar todo el código de este artículo: empieza por confirmar la semilla P-256 con el código oficial de reproducción y, luego, aplica estos tres enfoques a tu propio proyecto.
Lecturas relacionadas
- 📘 Cómo llamar a los modelos de la serie Claude con el SDK de OpenAI – Conoce las diferencias de parámetros entre las interfaces compatibles
- 📊 Cómo controlar los costos de las llamadas a las API de Modelos de Lenguaje Grande – Aprende a usar las estadísticas de usage y las alertas de presupuesto
- 🚀 Cómo crear un flujo de trabajo de verificación cruzada entre varios modelos – Permite que distintos modelos insignia contrasten sus conclusiones
📚 Referencias
- Página de investigación del equipo Frontier Red Team de Anthropic: investigación sobre el origen de la semilla de la curva ECDSA
- Enlace:
www.anthropic.com/research/ecdsa-curve-origins -
Descripción: Fuente primaria que incluye el método completo, las preguntas pendientes y el código de reproducción CC0
-
Publicación oficial de @AnthropicAI en X (2026-10-17): «It is just timestamps.»
- Enlace:
x.com/AnthropicAI -
Descripción: Anuncio oficial; aquí puedes consultar el debate de la comunidad
-
Centro de documentación de APIYI: instrucciones para usar la interfaz compatible con OpenAI
- Enlace:
docs.apiyi.com - Descripción: Configuración de
base_url, lista de modelos e información sobre tarifas
Autor: Equipo técnico de APIYI
Intercambio técnico: Comparte en los comentarios cómo utilizas agentes de IA en tu investigación. Encontrarás más información de integración en el centro de documentación de APIYI: docs.apiyi.com