作者注:拆解 Claude 推出 NIST 椭圆曲线种子来源的过程,说明这次结论的边界,并给出科研人员能直接复用的 3 种 AI Agent 用法、代码与成本控制方法。
2026 年 10 月 17 日,Anthropic Frontier Red Team 发布了一篇研究:内部研究模型在没有任何提示的情况下,用约半小时推出了 NIST P-192、P-224、P-256、P-384、P-521 五条曲线种子的生成方式。这些种子没有经过任何哈希算法,而是 1990 年代 C 库自带的 lrand48 伪随机数生成器的输出,初始值是 Unix 时间戳。@AnthropicAI 的官方帖只写了一句“It is just timestamps.”,浏览量约 85.5 万。
这不是密码学破解,也不是新漏洞。 对科研人员来说,这个案例的价值在于 Claude 的工作方式:推演机制,写脚本验证,用统计证据排除巧合。这套流程可以直接迁移到你自己的课题。
核心价值:读完本文,你会知道这件事证明了什么、不证明什么,并拿到 3 种可以马上用的科研 AI Agent 工作流,每种都附操作步骤和可运行代码。
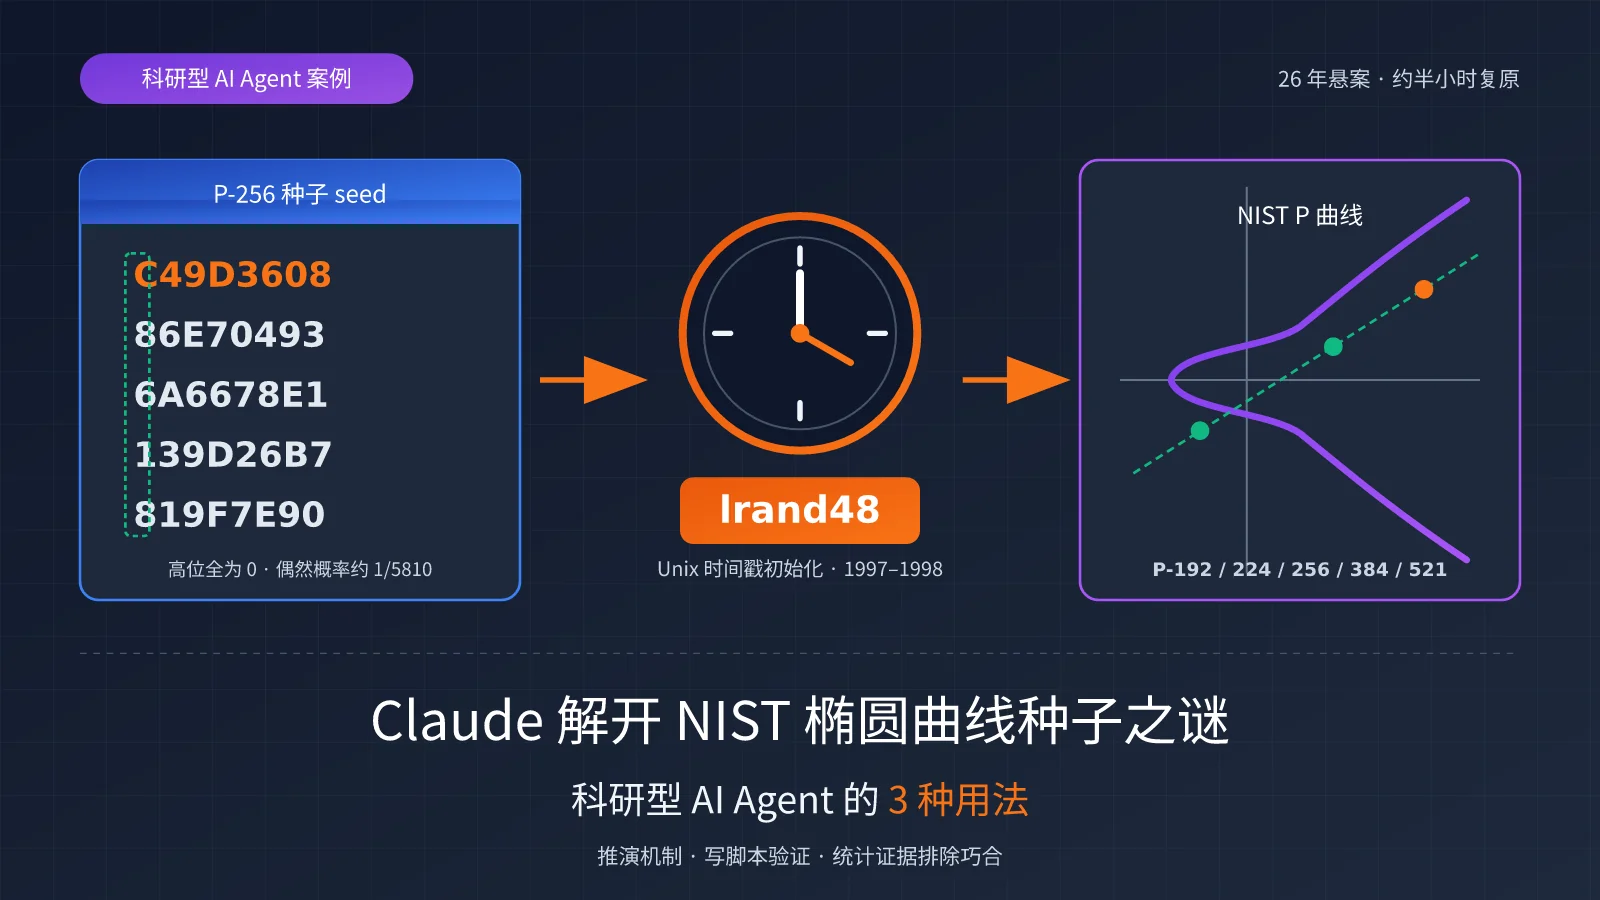
Claude 解开 NIST 椭圆曲线种子之谜:核心要点
| 要点 | 说明 | 对科研人员的意义 |
|---|---|---|
| 谜题背景 | 2000 年 NIST 在 FIPS 186-2 中采纳 ECDSA,曲线种子由 NSA 提供,没有来源说明 | 26 年无人解出的问题,可以作为检验 AI 推理能力的样本 |
| 结论 | 种子来自 lrand48 输出,用 1997 年 5 月至 1998 年 4 月之间的时间戳初始化 | 结论能被任何人复现,验证成本很低 |
| 关键方法 | 推演软件写法,自己写扫描器,用统计特征定位,再恢复状态 | 这三步可以迁移到实验数据分析、逆向建模等任务 |
| 安全含义 | 不构成漏洞,用户无需改配置或迁移 | 写综述或报告时要准确表述,不要夸大 |
| 遗留问题 | B-163 种子未解出,P-224 至 P-521 的基点 G 生成方式仍不清楚 | AI 给出的结论同样有边界,需要记录未解部分 |
NIST 椭圆曲线种子之谜:这件事证明了什么
ECDSA 标准为每条曲线公布了一个 seed,种子的哈希用来确定曲线系数 b。P-256 的种子是 C49D3608 86E70493 6A6678E1 139D26B7 819F7E90。由于来源一直没有说明,社区长期担心 NSA 可能刻意挑选了带弱点的参数。Koblitz 与 Menezes 写过综述《A Riddle Wrapped in an Enigma》,Filippo Valsorda 还为此设了 36864 美元悬赏。坊间一度流传 Jerry Solinas 用一句玩笑话的哈希生成种子,这个说法后来被证明是错的。
这次结论的实际作用,是增强了对这些曲线的信任。种子是用时钟初始化的普通伪随机数生成器跑出来的,没有留下人为挑选的空间,任何人都能复现。原文也提到,有少量同样可用的候选曲线被跳过,原因未知,但数量很少,不像是刻意挑选弱曲线。悬赏奖金将捐给 Internet Security Research Group。
在论文或组会中引用这件事时,比较准确的表述是:“AI 复原了一个历史参数的生成过程,并让它可以被复现。”不要写成“AI 攻破了椭圆曲线”。
Claude 推演种子的 4 个步骤拆解
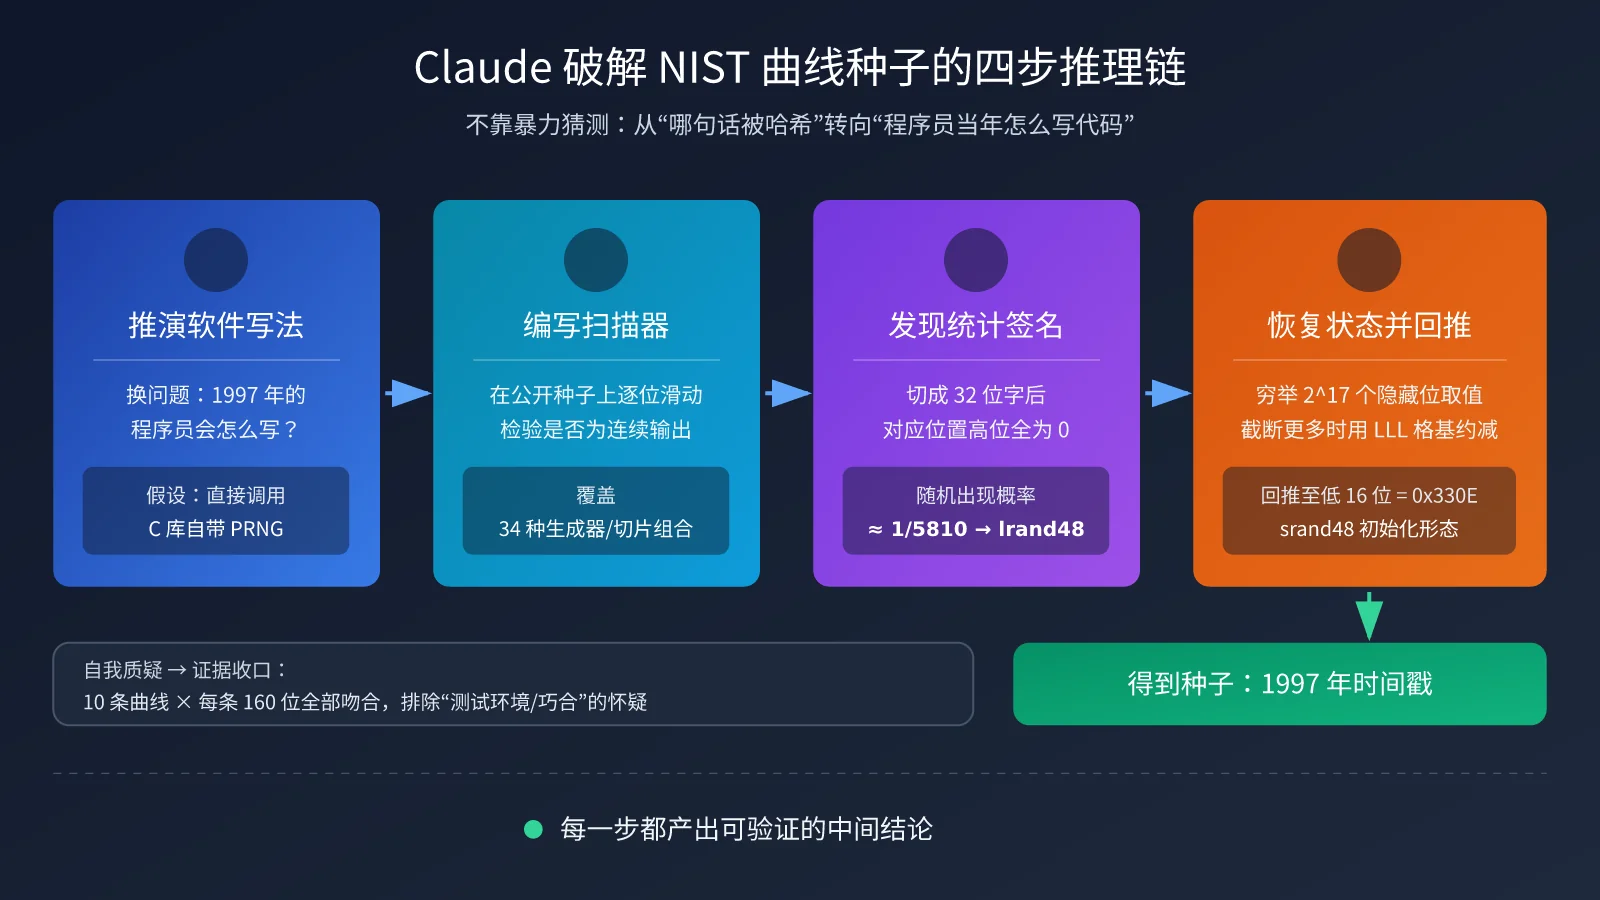
这次推理没有靠暴力猜测。整个过程是一条可以检查的推理链:
- 换问题:不再猜“哪句话被哈希了”,改为推演 1997 年写曲线生成程序的人最可能怎么写代码。结论是他们大概率直接用了 C 库自带的随机数生成器。
- 写扫描器:在已公布的种子上逐位滑动,测试相邻片段是否像某种 1990 年代生成器的连续输出,一共覆盖 34 种生成器与切片组合。
- 找统计签名:把种子切成 32 位字后,相应位置的高位全部为 0,随机出现的概率约 1/5810。这符合 lrand48 只返回 48 位状态中高 31 位的特征。
- 恢复状态并回推:穷举 17 个隐藏位的 2^17 种取值,用后续的字校验。对截断更多的种子,用 LLL 格基约减求解。然后把状态往回推,直到出现 srand48 的初始化形态,也就是低 16 位等于 0x330E。
推理过程中还有一个细节:模型一度怀疑自己是不是处在测试环境里,随后用“10 条曲线、每条 160 位全部吻合,不可能是巧合”排除了这个怀疑。这种“先质疑自己,再用证据收口”的做法,正是科研 Agent 最需要的。
科研型 AI Agent 快速上手:一个 Key 调用旗舰模型
动手之前,先把 API 调用链路跑通。APIYI 提供 OpenAI 兼容接口,一个 Key 可以调用 claude-opus-5-5,也可以切换到 GPT 系、Gemini 系旗舰模型做交叉验证。
接入步骤不必在这里重复,直接参考 API易 官方快速入门文档:docs.apiyi.com/getting-started。按文档在控制台创建 Key、拿到 base_url(https://api.apiyi.com/v1),用文档里的示例确认链路畅通即可,计费方式与可用模型以控制台为准。
后文 3 种用法共用一个很小的封装,保存为 research_client.py,核心只做两件事:按阶段选模型,并累计 token 用量用于成本控制。
# research_client.py
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1")
CHEAP = os.environ.get("CHEAP_MODEL", "claude-opus-5-5")  # 填控制台里的轻量模型名
FLAGSHIP = "claude-opus-5-5"
USAGE = {"prompt": 0, "completion": 0, "calls": 0}


def chat(messages, stage="draft", max_tokens=2048, temperature=0.2):
    """stage='draft' 走便宜模型;stage='verify' 走旗舰模型。"""
    r = client.chat.completions.create(model=FLAGSHIP if stage == "verify" else CHEAP,
        messages=messages, max_tokens=max_tokens, temperature=temperature)
    USAGE["prompt"] += r.usage.prompt_tokens
    USAGE["completion"] += r.usage.completion_tokens
    USAGE["calls"] += 1
    return r.choices[0].message.content


def ask(prompt, stage="draft", system=None, max_tokens=2048):
    msgs = ([{"role": "system", "content": system}] if system else []) + [{"role": "user", "content": prompt}]
    return chat(msgs, stage=stage, max_tokens=max_tokens)


def report():
    print(f"累计调用 {USAGE['calls']} 次,prompt={USAGE['prompt']},completion={USAGE['completion']}")
科研 AI Agent 成本控制:便宜模型调通,旗舰模型做关键验证
科研任务往往要多轮迭代,一开始就全程使用旗舰模型,额度会消耗在格式错误、JSON 解析失败这类低价值问题上。比较稳妥的做法是按阶段分配模型:
| 阶段 | 推荐模型 | 判断标准 | 典型 max_tokens |
|---|---|---|---|
| 流程调试(Prompt 格式、解析、评分器) | 轻量便宜模型 | 管道能端到端跑通,没有报错 | 512-1024 |
| 假设生成(列举候选机制) | 轻量模型优先,覆盖不足时再换旗舰 | 候选列表能覆盖你已知的主流假设 | 1024-2048 |
| 机制推演与关键验证 | claude-opus-5-5 | 结论会写进论文或决定后续实验投入 | 2048-4096 |
| 交叉验证 | 同一个 Key 切换另一家旗舰模型 | 两个模型独立给出相同结论 | 2048 |
实际操作时可以记住一条规则:脚本第一次运行用便宜模型,结论第一次落地用旗舰模型。
科研型 AI Agent 用法一:先推演机制,再验证
这一步对应 Claude 的“换问题”:不直接猜答案,先推演产生数据的机制,再用数据检验。它适合以下场景:实验数据出现异常规律、需要逆向推测历史数据的生成过程、复现论文时找不到参数来源。
操作步骤
- 只描述现象,不给猜测:把观测数据、已知约束和年代背景交给模型,不要写“我觉得是 XX 导致的”,避免把模型带偏。
- 要求列出机制和可证伪预测:每个候选机制都要附一条“如果这个机制成立,数据中应该出现什么特征”。
- 按验证成本排序:让模型按“验证所需时间”从低到高排列,先验证最便宜的那几条。
- 用旗舰模型复核排序:候选列表可以先用便宜模型生成,最终的排序和推演交给 claude-opus-5-5。
Prompt 模板
from research_client import ask, report

PROMPT = """你是一名严谨的研究助理。下面是一组观测数据和背景,不包含任何关于成因的线索。

【观测】
{observation}

【背景约束】
{context}

请完成:
1. 推演“产生这组数据的过程最可能怎么实现”,至少列出 5 个候选机制;
2. 每个机制给出一条可证伪预测:若成立,数据中必然出现的可检验特征;
3. 估计验证每条预测的成本(低/中/高),按成本升序输出;
4. 指出你最不确定的环节。
输出为 Markdown 表格 + 简短说明。"""

draft = ask(PROMPT.format(
    observation="NIST P-256 种子:C49D3608 86E70493 6A6678E1 139D26B7 819F7E90",
    context="1997-1998 年由政府机构用软件生成;官方未公布生成方法;常见猜测为短语哈希但未被证实",
), stage="draft")

final = ask("请审查并修正以下候选机制列表,删除无法证伪的条目,重新排序:\n" + draft,
            stage="verify", max_tokens=3000)
print(final)
report()
判断这一步是否合格,可以看两条标准:每个机制是否都有可证伪预测;排在第一位的验证是否能在一小时内完成。只要有一条不满足,就让模型重写。
科研型 AI Agent 用法二:让模型写扫描/验证脚本
这一步对应 Claude 自己写扫描器、覆盖 34 种生成器与切片组合的做法。关键在于把“看起来像”转换成“统计上不太可能是巧合”。参数扫描、信号检测、搜索数据中隐藏结构等任务都可以这样处理。
操作步骤
- 把用法一中验证成本最低的预测交给模型,要求它写只依赖标准库的扫描脚本。
- 要求脚本同时跑一组随机对照,输出“真实数据命中率”和“随机数据命中率”。
- 由你在本地运行脚本,模型只负责写代码,不负责报告结果。
- 结果显著时,再让旗舰模型写更严格的状态恢复或拟合脚本。
示例:复现“高位全为 0”这类统计签名
下面的脚本演示了这次案例中签名的原理。lrand48 返回的是 48 位状态的高 31 位,所以装进 32 位字后最高位一定是 0,而真随机数据每个字的最高位为 0 的概率只有一半。
import os

def lrand48_stream(seed32, n):
    x = (seed32 << 16) | 0x330E          # srand48 初始化:低 16 位固定为 0x330E
    out = []
    for _ in range(n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        out.append(x >> 17)               # lrand48 只返回高 31 位
    return out

def top_bit_zero_ratio(words):
    return sum(1 for w in words if w >> 31 == 0) / len(words)

lr = lrand48_stream(870000000, 20)        # 1997 年前后的某个 Unix 时间戳
rnd = [int.from_bytes(os.urandom(4), "big") for _ in range(20)]
print("lrand48 最高位为 0 的比例:", top_bit_zero_ratio(lr))   # 恒为 1.0
print("真随机  最高位为 0 的比例:", top_bit_zero_ratio(rnd))  # 约 0.5 上下波动
用官方代码验证最终结论
Anthropic 研究页附带了以 CC0 协议发布的复现代码。按官方说明,下面这组参数应当输出 P-256 标准中的种子:
from datetime import datetime, timezone

def unix(when):
    return int(datetime.fromisoformat(when).replace(tzinfo=timezone.utc).timestamp())

def candidate(t, n, per, shift, width):
    x, out = (t << 16) | 0x330E, ""
    for i in range(per * n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        if i >= per * (n - 1):
            out += "%0*X" % (width, x >> shift)
    return out

seed = candidate(unix("1997-08-16 01:52:34"), 1842, 20, 40, 2)
print(seed)
print("与标准一致:", seed == "C49D360886E704936A6678E1139D26B7819F7E90")
脚本含义是:用时间戳初始化 lrand48,每 20 次输出组成一个 20 字节候选种子,第 1842 个候选就是标准中的种子。整个验证在普通笔记本上一秒内就能完成。“提出假设的成本很高,验证结论的成本很低”,是这类科研任务最理想的结构。
科研型 AI Agent 用法三:配自动评分器,迭代到分数收敛
前两种用法依赖人来判断结果,第三种把判断交给程序。你写一个评分器,模型每轮提交方案,评分器返回分数和失败样本,模型据此修改,直到分数不再提升。这个方法适合数据抽取规则、拟合函数形式、实验参数搜索等有明确评价指标的任务。
操作步骤
- 先写评分器,再找模型:评分器必须是确定性程序,不依赖模型自己打分。
- 划分开发集与留出集:反馈只使用开发集,最后用留出集检查是否过拟合。
- 限制提交形式:让模型提交 JSON 或正则这类数据,避免直接执行模型生成的代码。如果必须执行代码,应放在沙箱中运行。
- 设置收敛条件:满分、连续 2 轮没有提升或达到最大轮数,三者满足其一即停止。
- 用便宜模型调通循环,再换旗舰模型跑正式实验。
示例:从实验记录抽取参数的正则迭代
import json, re
from research_client import chat, report

DEV = [
    ("样品A在 350 ℃ 退火 2 小时后测得电导率 4.1 S/m。", {"temp_c": 350, "hours": 2, "cond": 4.1}),
    ("退火温度 420°C,保温 1.5 h,电导率为 12.3 S/m。", {"temp_c": 420, "hours": 1.5, "cond": 12.3}),
    ("B组:300摄氏度下处理 3 小时,σ=0.85 S/m。", {"temp_c": 300, "hours": 3, "cond": 0.85}),
    ("在450 ℃条件下退火4h,测得电导率 20 S/m。", {"temp_c": 450, "hours": 4, "cond": 20}),
]
HOLDOUT = [
    ("样品E 380 ℃ 退火 2.5 小时,电导率 7.6 S/m。", {"temp_c": 380, "hours": 2.5, "cond": 7.6}),
    ("C组于 500°C 保温 0.5 h,σ = 33.1 S/m。", {"temp_c": 500, "hours": 0.5, "cond": 33.1}),
]
FIELDS = ["temp_c", "hours", "cond"]

def score(patterns, data):
    hit, fails = 0, []
    for idx, (text, label) in enumerate(data):
        for f in FIELDS:
            try:
                m = re.search(patterns.get(f, "(?!)"), text)
                ok = m is not None and abs(float(m.group(1)) - label[f]) < 1e-9
            except (re.error, IndexError, ValueError, TypeError):
                ok = False
            hit += ok
            if not ok:
                fails.append(f"样本{idx} 字段{f} 抽取失败:{text}")
    return hit / (len(data) * len(FIELDS)), fails

def parse_json(text):
    return json.loads(text[text.find("{"): text.rfind("}") + 1])

messages = [{"role": "user", "content":
    "为下列实验记录写 Python 正则,抽取 temp_c、hours、cond 三个字段,每个正则恰好一个捕获组,捕获纯数字。"
    "只输出 JSON,例如 {\"temp_c\": \"...\", \"hours\": \"...\", \"cond\": \"...\"},注意转义反斜杠。\n"
    + "\n".join(t for t, _ in DEV)}]

best, stale, patterns = -1.0, 0, {}
for rnd in range(6):
    reply = chat(messages, stage="draft", max_tokens=800)   # 跑通后把 stage 改为 "verify"
    try:
        patterns = parse_json(reply)
        s, fails = score(patterns, DEV)
    except (ValueError, json.JSONDecodeError):
        s, fails = 0.0, ["输出不是合法 JSON"]
    print(f"第 {rnd + 1} 轮 开发集得分 {s:.2f}")
    if s >= 1.0:
        break
    stale = stale + 1 if s <= best else 0
    best = max(best, s)
    if stale >= 2:
        break
    messages += [{"role": "assistant", "content": reply},
                 {"role": "user", "content": "以下抽取失败,请修改正则后重新输出完整 JSON:\n" + "\n".join(fails)}]

print("留出集得分:", score(patterns, HOLDOUT)[0])
report()
需要特别注意:开发集满分而留出集明显下降,说明模型在“背答案”。这时应该扩充开发集,而不是继续迭代。
3 种科研 AI Agent 用法对比
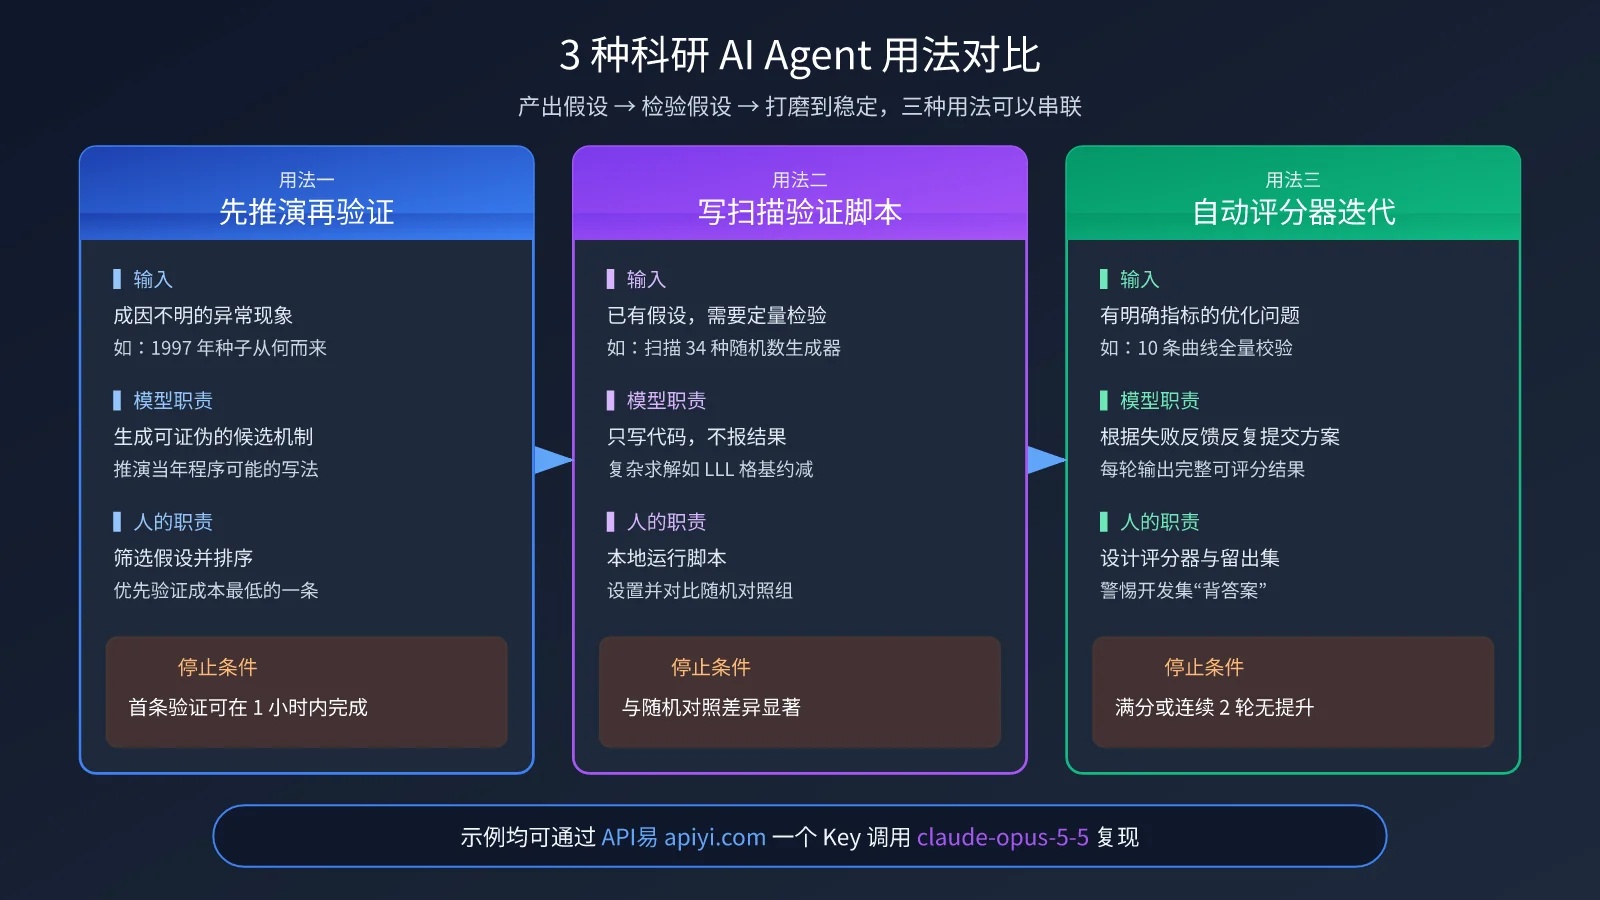
| 维度 | 用法一:推演机制 | 用法二:扫描验证脚本 | 用法三:自动评分迭代 |
|---|---|---|---|
| 对应案例环节 | 推演 1997 年程序写法 | 34 种生成器扫描、找统计签名 | 状态恢复后用 10 条曲线全量校验 |
| 适合任务 | 成因不明的异常、逆向推测 | 假设已有,需要定量检验 | 有明确指标的优化问题 |
| 模型职责 | 生成可证伪的候选机制 | 写代码,不报结果 | 反复提交方案 |
| 人的职责 | 筛选并排序假设 | 本地运行、看对照组 | 设计评分器和留出集 |
| 旗舰模型介入点 | 最终推演与排序 | 写复杂求解(如 LLL) | 正式实验轮次 |
| 停止条件 | 首条验证可在 1 小时内完成 | 与随机对照差异显著 | 满分或连续 2 轮无提升 |
| 调用方式 | API易 apiyi.com 统一接口 | 同左 | 同左 |
三种用法可以串起来使用:用法一产出假设,用法二检验假设,用法三把验证过的方案打磨到稳定。
为什么 Claude 这类科研任务必须用旗舰模型
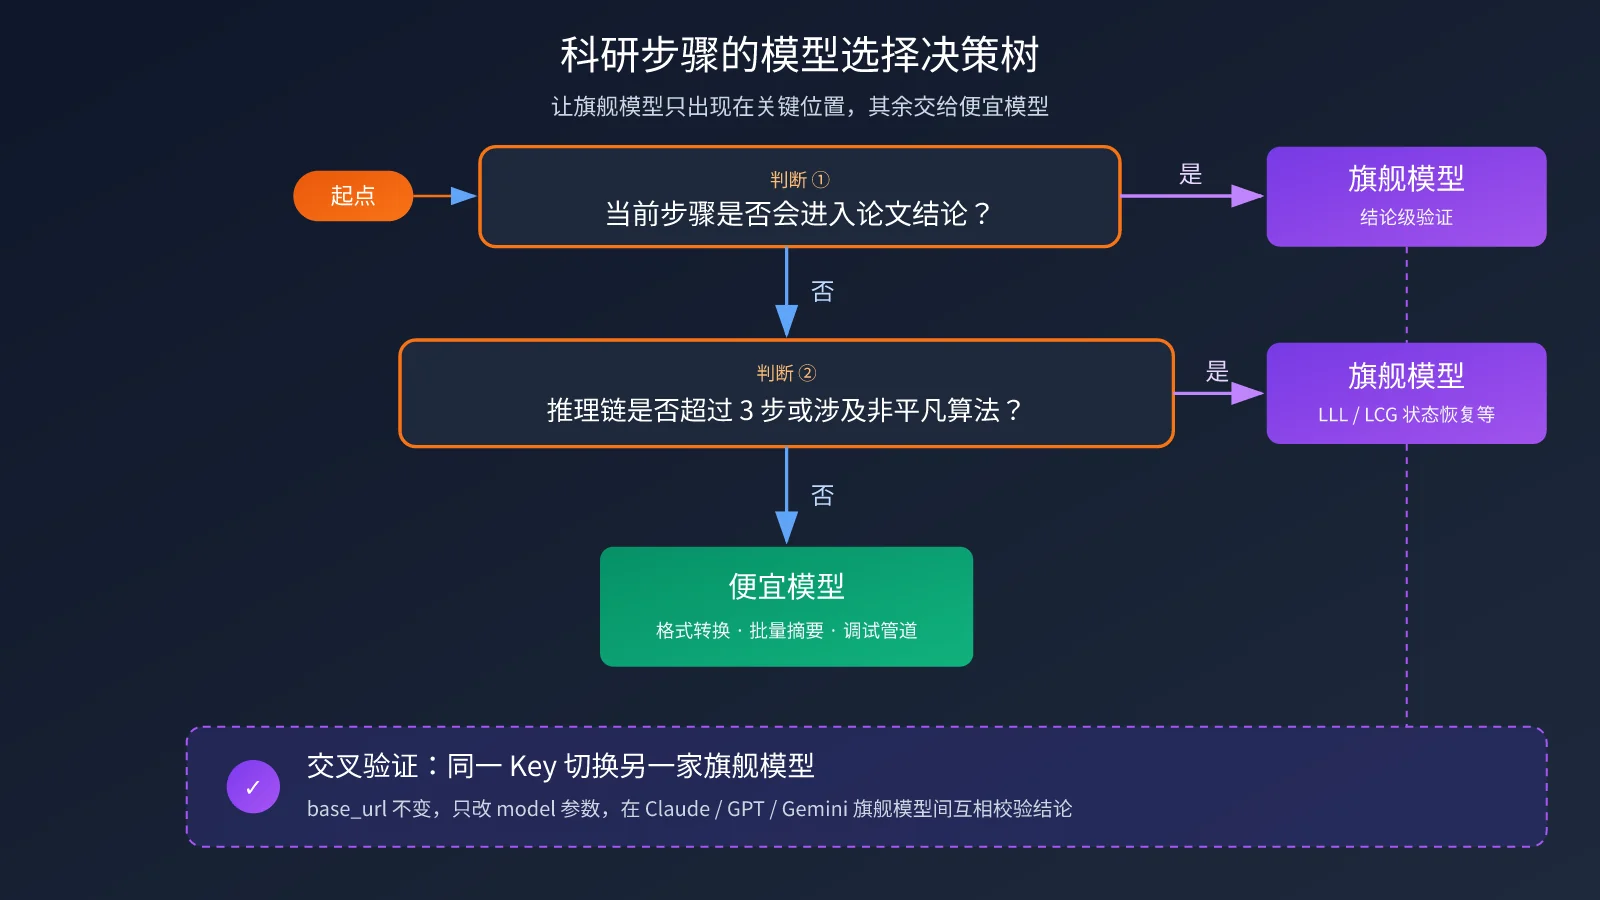
并不是所有科研步骤都需要旗舰模型,但有一类任务换成小模型之后基本做不成。可以用下表判断:
| 判断标准 | 满足时建议旗舰模型 | 原因 |
|---|---|---|
| 需要跨领域联想 | 例如从“曲线种子”联想到“90 年代 C 库实现细节” | 小模型更容易停留在问题表面,比如继续猜短语 |
| 推理链超过 3 步,且每步都依赖前一步 | 例如推演→扫描→签名→状态恢复 | 中间任何一步出错,后面会全部偏离 |
| 需要自我质疑 | 例如怀疑“我是不是在测试环境” | 旗舰模型更可能主动寻找反例 |
| 涉及非平凡算法 | 例如 LLL 格基约减、截断 LCG 状态恢复 | 代码正确率直接决定验证是否成立 |
| 结论会进入论文或决定实验投入 | 任何对外发布的结论 | 出错的代价远高于调用成本 |
反过来,格式转换、批量摘要、调试评分器管道这类工作,用便宜模型就够了。成本控制的核心不是少用旗舰模型,而是让旗舰模型只出现在上表列出的位置。
常见问题 FAQ
Q1:Claude 破解了 NIST 椭圆曲线吗?
没有。Claude 复原的是种子的生成过程,种子来自用时间戳初始化的 lrand48。这不是新的攻击方法,也不构成漏洞,用户不需要修改配置或迁移。这个结论反而说明种子没有被人为挑选。
Q2:这个方法和传统的暴力搜索有什么区别?
暴力搜索是在固定的假设空间里穷举。Claude 先换掉了假设空间,从“哪句话被哈希”换成“用了哪种随机数生成器”,然后才进行有限的穷举(2^17 隐藏位)。真正决定成败的是前一步。
Q3:这项研究是什么时候公布的?还有哪些没解决?
Anthropic 研究页和 @AnthropicAI 的帖子都发布于 2026 年 10 月 17 日。目前 B-163 的种子还没解出,P-224 至 P-521 的基点 G 生成方式也不清楚,另外有少量候选曲线被跳过,原因未知。
Q4:哪些科研场景适合套用这 3 种用法?
– **实验异常溯源**:仪器数据中出现周期性伪影,用用法一推演采集软件的实现方式。
– **复现历史论文**:参数缺失时,用用法二扫描候选参数组合。
– **数据抽取与清洗**:用用法三加评分器,迭代出稳定的规则。
Q5:如何用一个 Key 同时调用多个旗舰模型做交叉验证?
在 API易 apiyi.com 注册并创建 Key,把 base_url 设为 `https://api.apiyi.com/v1`,只需修改 `model` 参数,就能在 claude-opus-5-5 和 GPT 系、Gemini 系旗舰模型之间切换。可用模型名以控制台列表为准。
Q6:科研 AI Agent 有哪些已知限制?
– 模型可能编造看起来合理的机制,所以每个结论都必须有本地可运行的验证脚本。
– 评分器迭代容易在开发集上过拟合,必须保留留出集。
– 多轮调用的成本会累积,应先用便宜模型调通流程,同时记录 usage。计费方式在 API易 apiyi.com 控制台可以查看。
科研型 AI Agent 核心要点 Key Takeaways
- 结论边界:Claude 复原的是种子来源,不是密码学漏洞,曲线可信度反而提高了。
- 关键一步:换掉假设空间,比在旧空间里加大算力更有效。
- 验证优先:模型负责写脚本,人负责运行,一律对照随机基线。
- 评分器闭环:确定性评分加上留出集,迭代到分数收敛就停止。
- 模型分层:便宜模型调通流程,旗舰模型只用于关键推演和验证。
- 上手方式:通过 API易 apiyi.com 一个 Key 调用 claude-opus-5-5,并切换其他模型做交叉验证。
总结
Claude 解开 NIST 椭圆曲线种子之谜,给科研人员的启发主要有三点:
- 先推演机制:从“数据是怎么产生的”出发,而不是直接猜答案。
- 用脚本说话:每个假设都要配可运行的验证代码和随机对照。
- 评分器闭环:把判断交给确定性程序,迭代到收敛,并用留出集检查过拟合。
成本控制始终是前提:流程先用便宜模型跑通,涉及论文结论和复杂算法的步骤再换旗舰模型。推荐通过 API易 apiyi.com 把本文代码完整跑一遍,先用官方复现代码确认 P-256 种子,再把三种用法套到自己的课题上。
延伸阅读 Related Articles
- 📘 如何用 OpenAI SDK 调用 Claude 系列模型 – 了解兼容接口的参数差异
- 📊 大模型 API 调用成本控制实践 – 掌握 usage 统计与预算告警
- 🚀 多模型交叉验证工作流搭建 – 让不同旗舰模型互相核对结论
📚 参考资料
- Anthropic Frontier Red Team 研究页:ECDSA 曲线种子来源研究
- 链接:
www.anthropic.com/research/ecdsa-curve-origins -
说明: 一手来源,包含完整方法、遗留问题和 CC0 复现代码
-
@AnthropicAI 官方 X 帖(2026-10-17):“It is just timestamps.”
- 链接:
x.com/AnthropicAI -
说明: 官方发布声明,可从这里查看社区讨论
-
API易 文档中心:OpenAI 兼容接口调用说明
- 链接:
docs.apiyi.com - 说明: base_url 配置、模型列表与计费说明
作者: APIYI 技术团队
技术交流: 欢迎在评论区分享你在科研中使用 AI Agent 的做法,更多接入资料可访问 API易 docs.apiyi.com 文档中心