작성자 주: Claude가 NIST 타원곡선 시드의 출처를 밝혀낸 과정을 살펴보고, 이번 결론이 의미하는 범위를 설명합니다. 연구자가 바로 활용할 수 있는 AI Agent 활용법 3가지와 코드, 비용 관리 방법도 소개해요.
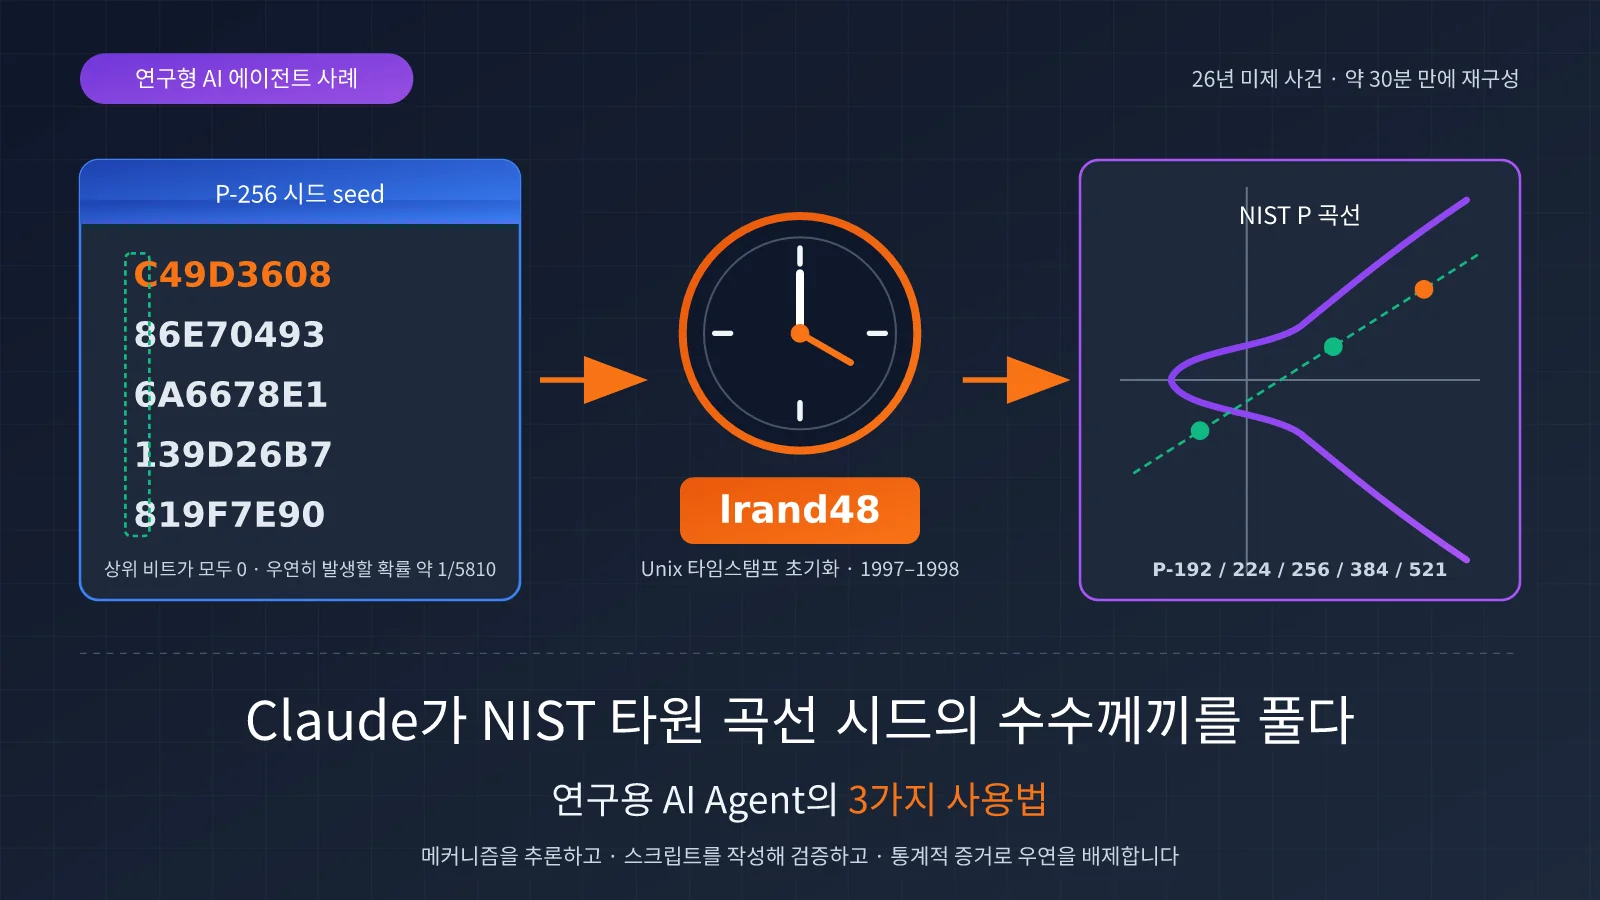
2026년 10월 17일, Anthropic Frontier Red Team은 내부 연구 모델이 아무런 프롬프트 없이 약 30분 만에 NIST P-192, P-224, P-256, P-384, P-521 다섯 곡선의 시드 생성 방식을 밝혀냈다는 연구를 발표했습니다. 이 시드에는 해시 알고리즘이 적용되지 않았습니다. 1990년대 C 라이브러리에 내장된 lrand48 의사 난수 생성기의 출력이었고, 초기값은 유닉스 타임스탬프였습니다. @AnthropicAI의 공식 게시물에는 “It is just timestamps.”라는 문장 하나만 올라왔으며, 조회수는 약 85만 5,000회를 기록했습니다.
이건 암호학을 깨뜨린 것도, 새로운 취약점을 발견한 것도 아닙니다. 연구자에게 이 사례가 중요한 이유는 Claude의 작업 방식에 있습니다. 작동 원리를 추론하고, 검증 스크립트를 작성하고, 통계적 근거로 우연의 가능성을 배제했습니다. 이 과정을 여러분의 연구에도 그대로 적용할 수 있어요.
핵심 가치: 이 글을 읽으면 이번 사례가 무엇을 증명하고 무엇을 증명하지 않는지 알 수 있습니다. 바로 활용할 수 있는 연구용 AI Agent 워크플로 3가지와 각 워크플로의 실행 단계, 실행 가능한 코드도 함께 살펴봅니다.
Claude가 밝혀낸 NIST 타원곡선 시드의 비밀: 핵심 요점
| 요점 | 설명 | 연구자에게 주는 의미 |
|---|---|---|
| 수수께끼의 배경 | NIST는 2000년 FIPS 186-2에서 ECDSA를 채택했습니다. 각 곡선의 시드는 NSA가 제공했지만, 출처는 설명되지 않았습니다. | 26년 동안 풀리지 않았던 문제로, AI 추론 능력을 평가하는 사례로 활용할 수 있습니다. |
| 결론 | 시드는 1997년 5월부터 1998년 4월 사이의 타임스탬프로 초기화한 lrand48의 출력입니다. | 누구나 결과를 재현할 수 있고 검증 비용도 낮습니다. |
| 핵심 방법 | 당시 소프트웨어 작성 방식을 추론하고 직접 스캐너를 작성해, 통계적 특징으로 후보를 좁힌 뒤 상태를 복구했습니다. | 이 세 단계는 실험 데이터 분석이나 역모델링 같은 작업에도 적용할 수 있습니다. |
| 보안상 의미 | 취약점을 발견한 것이 아니므로 사용자가 설정을 바꾸거나 다른 방식으로 마이그레이션할 필요는 없습니다. | 논문이나 보고서에서 의미를 정확하게 표현하고 과장하지 않아야 합니다. |
| 남은 의문 | B-163의 시드는 아직 밝혀지지 않았고, P-224부터 P-521까지 각 곡선의 기준점 G를 어떻게 생성했는지도 여전히 불분명합니다. | AI가 내린 결론에도 한계가 있습니다. 밝혀지지 않은 부분을 함께 기록해야 합니다. |
NIST 타원곡선 시드의 비밀: 이번 사례가 증명하는 것
ECDSA 표준은 각 곡선의 시드를 공개하고, 시드의 해시를 사용해 곡선 계수 b를 결정합니다. P-256의 시드는 C49D3608 86E70493 6A6678E1 139D26B7 819F7E90입니다. 출처가 오랫동안 밝혀지지 않아, 커뮤니티에서는 NSA가 약점이 있는 매개변수를 의도적으로 골랐을 가능성을 우려해 왔습니다. Koblitz와 Menezes는 이 문제를 다룬 리뷰 논문 《A Riddle Wrapped in an Enigma》를 썼고, Filippo Valsorda는 36,864달러의 현상금을 내걸기도 했습니다. 한때 Jerry Solinas가 농담 문장의 해시로 시드를 만들었다는 이야기가 퍼졌지만, 나중에 사실이 아닌 것으로 밝혀졌습니다.
이번 결론은 실제로 이 곡선에 대한 신뢰를 높여 줍니다. 시드는 시계를 초기값으로 사용하는 일반적인 의사 난수 생성기로 만들어졌으며, 사람이 값을 골라 넣을 여지가 없었습니다. 누구나 재현할 수 있습니다. 원문에서는 사용 가능한 후보 곡선이 몇 개 더 있었지만 선택되지 않은 이유는 알 수 없다고도 언급합니다. 다만 후보가 많지 않아 약한 곡선을 의도적으로 선택한 것으로 보기는 어렵습니다. 현상금은 Internet Security Research Group에 기부될 예정입니다.
논문이나 연구실 세미나에서 이 사례를 인용할 때는 “AI가 역사적 매개변수의 생성 과정을 복원해 재현할 수 있도록 했다”라고 표현하는 것이 정확합니다. “AI가 타원곡선을 뚫었다”라고 쓰지는 마세요.
Claude가 시드의 출처를 추론한 4단계
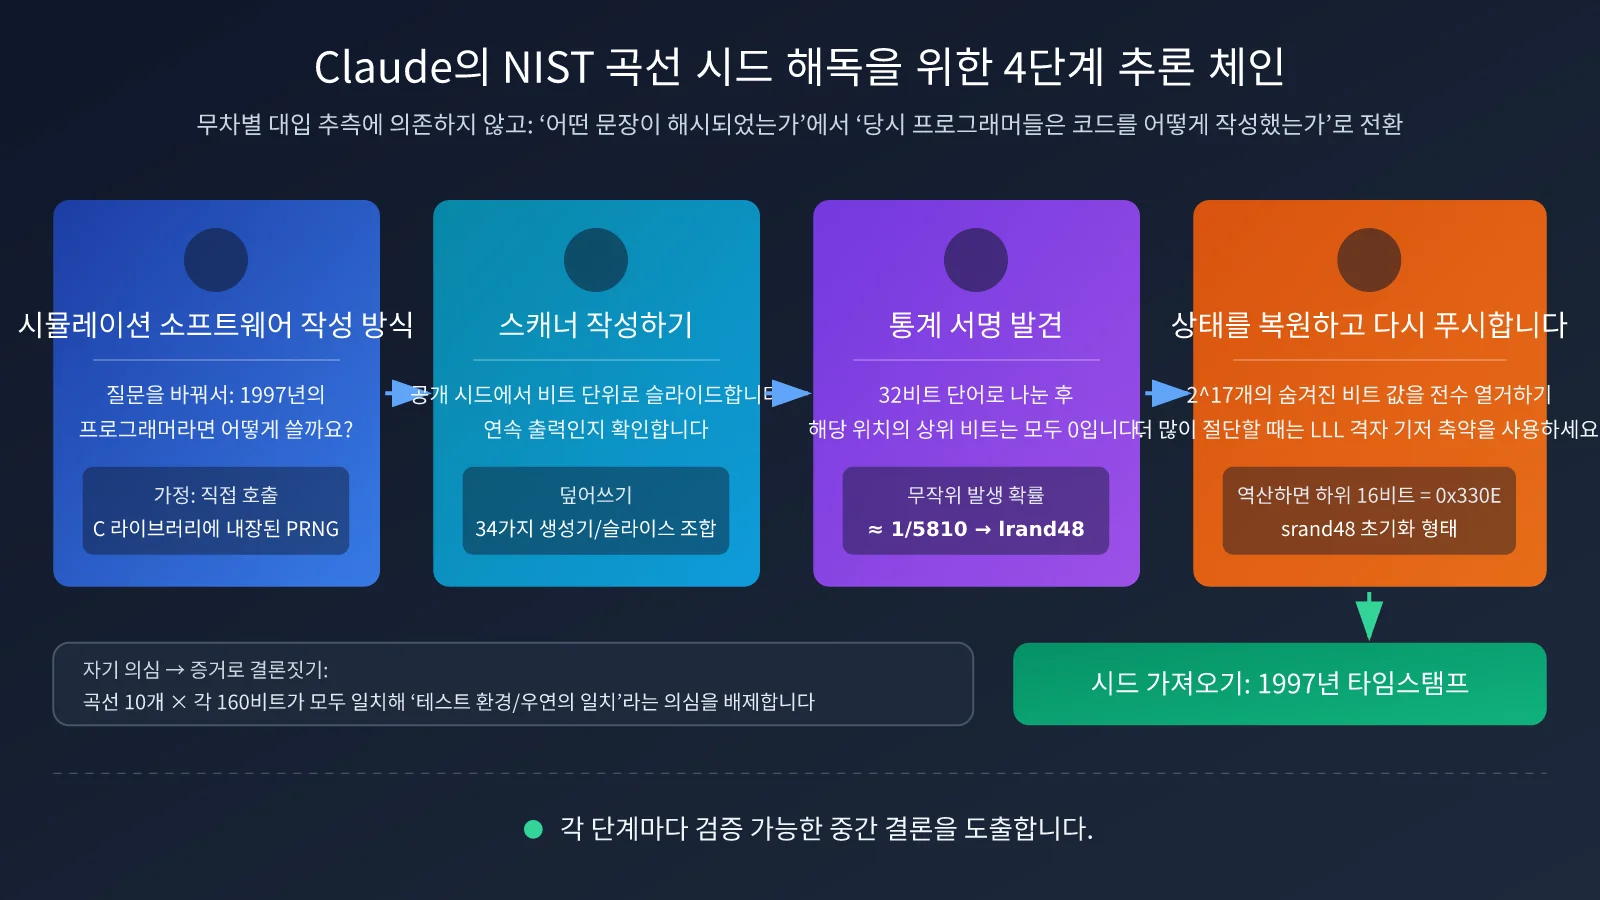
이번 추론은 무작정 대입하는 방식으로 진행되지 않았습니다. 각 단계를 검증할 수 있는 추론 과정은 다음과 같습니다.
- 문제를 다시 정의했습니다: “어떤 문장을 해시했을까?”라는 추측을 멈추고, 1997년에 곡선 생성 프로그램을 작성한 개발자가 코드를 어떻게 썼을지 추론했습니다. 당시 C 라이브러리에 기본으로 포함된 난수 생성기를 직접 사용했을 가능성이 높다는 결론에 도달했습니다.
- 스캐너를 작성했습니다: 공개된 시드에서 비트를 하나씩 옮겨 가며, 연속된 구간이 1990년대 생성기의 연속 출력과 비슷한지 테스트했습니다. 생성기와 슬라이싱 방식의 조합 34가지를 모두 확인했습니다.
- 통계적 특징을 찾았습니다: 시드를 32비트 단위로 나눴을 때 해당 위치의 상위 비트가 모두 0이었습니다. 이 현상이 우연히 나타날 확률은 약 1/5,810입니다. lrand48이 48비트 상태 중 상위 31비트만 반환한다는 특징과 일치합니다.
- 상태를 복구하고 시간을 역산했습니다: 숨겨진 17비트의 가능한 값 2^17개를 모두 확인하고, 이후의 단어와 대조했습니다. 더 많이 잘린 시드에는 LLL 격자 기저 축약을 적용해 해결했습니다. 그런 다음 상태를 역방향으로 추적해 srand48의 초기화 형태, 즉 하위 16비트가 0x330E인 지점까지 되돌렸습니다.
추론 중 흥미로운 점도 있습니다. 모델은 한때 자신이 테스트 환경에 놓인 건 아닌지 의심했습니다. 그러나 “곡선 10개에서 각각 160비트가 모두 일치한 결과는 우연일 수 없다”는 근거로 그 의심을 해소했습니다. 먼저 스스로를 의심하고, 증거로 결론을 다지는 방식이야말로 연구용 Agent에 필요한 태도입니다.
연구형 AI Agent 빠르게 시작하기: API 키 하나로 플래그십 모델 호출
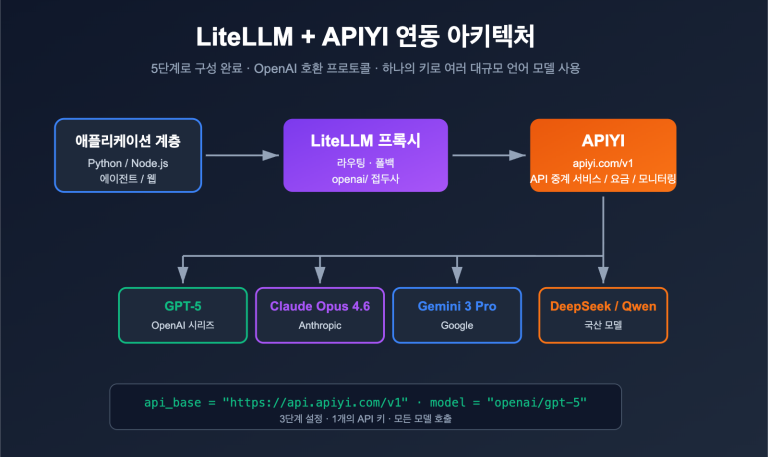
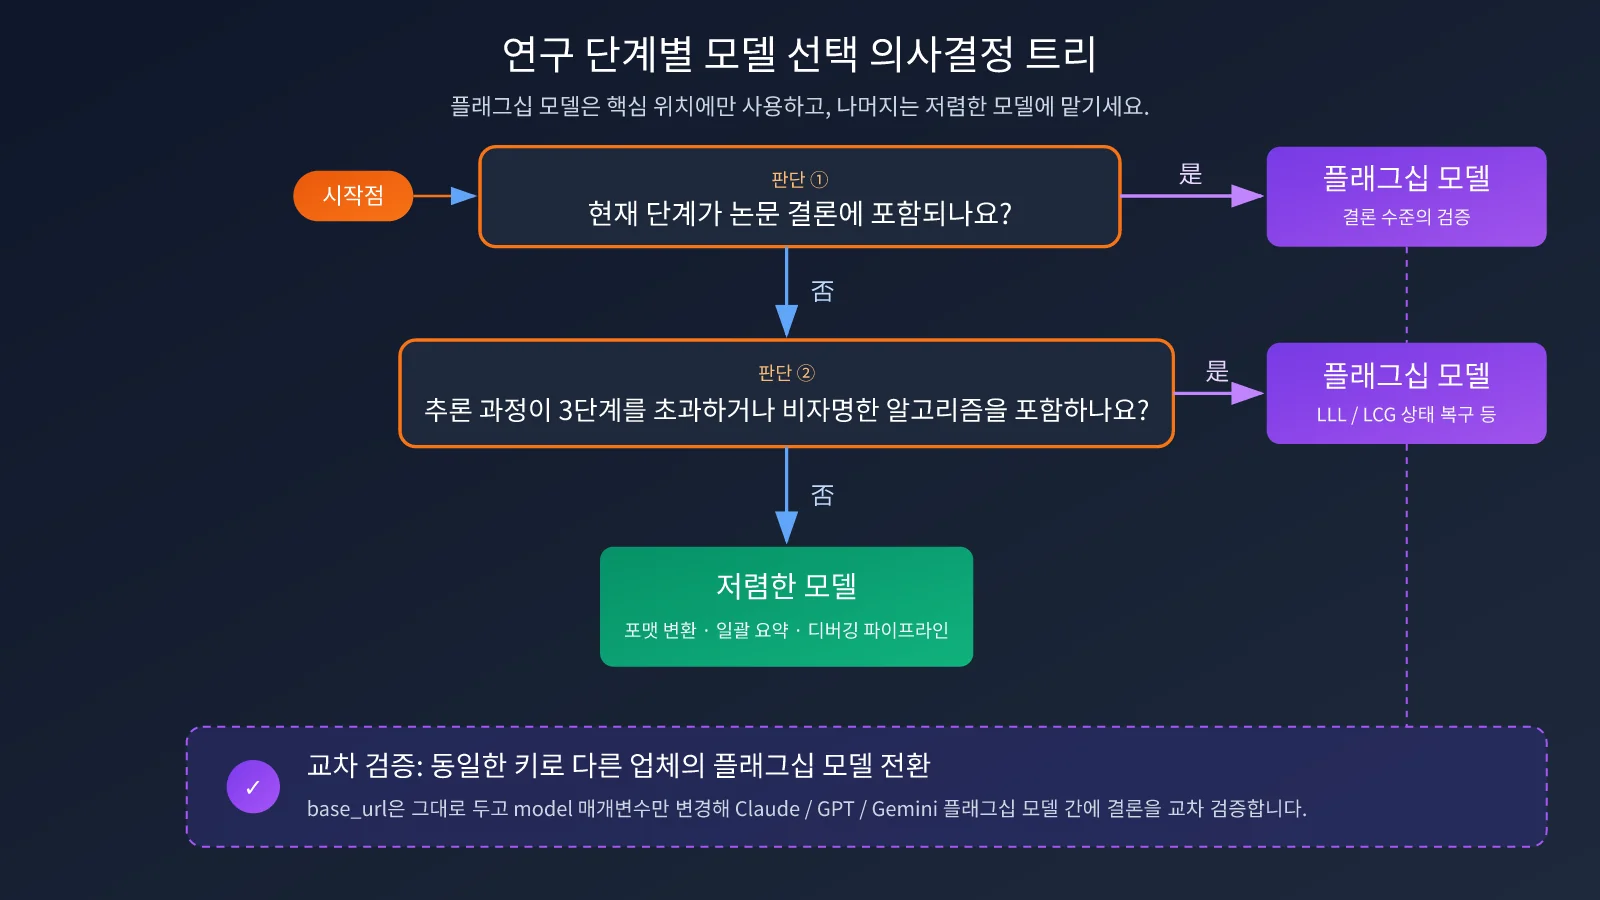
직접 시작하기 전에 API 호출 경로부터 확인해 보세요. APIYI는 OpenAI 호환 인터페이스를 제공해 API 키 하나로 claude-opus-5-5를 호출할 수 있고, GPT 계열이나 Gemini 계열 플래그십 모델로 전환해 교차 검증할 수도 있어요.
연동 절차는 여기서 반복하지 않을게요. APIYI 공식 빠른 시작 문서(docs.apiyi.com/getting-started)를 참고하세요. 문서에 따라 콘솔에서 API 키를 만들고 base_url(https://api.apiyi.com/v1)을 확인한 다음, 예제 코드로 호출이 정상적으로 이뤄지는지 확인하면 돼요. 요금 체계와 사용 가능한 모델은 콘솔에서 확인하세요.
이후 소개할 세 가지 사용법은 작은 래퍼 하나를 공통으로 사용해요. research_client.py로 저장하면 돼요. 핵심 기능은 두 가지예요. 단계에 따라 모델을 선택하고, 비용 관리를 위해 토큰 사용량을 누적해요.
# research_client.py
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1")
CHEAP = os.environ.get("CHEAP_MODEL", "claude-opus-5-5")  # 填控制台里的轻量模型名
FLAGSHIP = "claude-opus-5-5"
USAGE = {"prompt": 0, "completion": 0, "calls": 0}


def chat(messages, stage="draft", max_tokens=2048, temperature=0.2):
    """stage='draft' 走便宜模型;stage='verify' 走旗舰模型。"""
    r = client.chat.completions.create(model=FLAGSHIP if stage == "verify" else CHEAP,
        messages=messages, max_tokens=max_tokens, temperature=temperature)
    USAGE["prompt"] += r.usage.prompt_tokens
    USAGE["completion"] += r.usage.completion_tokens
    USAGE["calls"] += 1
    return r.choices[0].message.content


def ask(prompt, stage="draft", system=None, max_tokens=2048):
    msgs = ([{"role": "system", "content": system}] if system else []) + [{"role": "user", "content": prompt}]
    return chat(msgs, stage=stage, max_tokens=max_tokens)


def report():
    print(f"累计调用 {USAGE['calls']} 次,prompt={USAGE['prompt']},completion={USAGE['completion']}")
연구용 AI Agent 비용 관리: 저렴한 모델로 흐름을 점검하고, 플래그십 모델로 핵심 검증하기
연구 작업은 여러 차례 반복하는 경우가 많아요. 처음부터 끝까지 플래그십 모델만 사용하면 형식 오류나 JSON 파싱 실패처럼 가치가 낮은 문제를 해결하는 데 사용량을 낭비할 수 있어요. 단계별로 모델을 배분하는 편이 안정적이에요.
| 단계 | 추천 모델 | 판단 기준 | 일반적인 max_tokens |
|---|---|---|---|
| 흐름 디버깅(Prompt 형식, 파싱, 평가기) | 가볍고 저렴한 모델 | 파이프라인이 처음부터 끝까지 오류 없이 실행됨 | 512-1024 |
| 가설 생성(가능한 메커니즘 나열) | 우선 경량 모델 사용, 충분히 다루지 못할 때 플래그십 모델로 전환 | 후보 목록에 이미 알려진 주요 가설이 포함됨 | 1024-2048 |
| 메커니즘 추론 및 핵심 검증 | claude-opus-5-5 | 결론이 논문에 반영되거나 이후 실험에 투입할 자원을 결정함 | 2048-4096 |
| 교차 검증 | 같은 API 키로 다른 회사의 플래그십 모델 사용 | 두 모델이 독립적으로 같은 결론을 제시함 | 2048 |
실제로는 다음 원칙을 기억하면 돼요. 스크립트를 처음 실행할 때는 저렴한 모델을, 결론을 처음 확정할 때는 플래그십 모델을 사용하세요.
연구형 AI Agent 활용법 1: 메커니즘을 먼저 추론한 뒤 검증하기
이 단계는 Claude의 ‘문제 바꿔 보기’ 방식에 해당해요. 답을 바로 추측하는 대신 데이터를 만들어 낸 메커니즘을 먼저 추론하고, 데이터를 이용해 검증하는 방법이에요. 실험 데이터에서 이상한 패턴이 나타났을 때, 과거 데이터가 생성된 과정을 역으로 추정해야 할 때, 논문을 재현하는 과정에서 파라미터의 출처를 찾지 못했을 때 유용해요.
진행 단계
- 현상만 설명하고 추측은 제시하지 않기: 관측 데이터와 알려진 제약 조건, 당시의 시대적 배경을 모델에 전달하세요. “XX 때문인 것 같다”는 식의 설명은 모델의 판단에 영향을 줄 수 있으니 피하는 게 좋아요.
- 메커니즘과 반증 가능한 예측을 요청하기: 각 후보 메커니즘에 “이 메커니즘이 맞다면 데이터에서 어떤 특징이 나타나야 하는가?”라는 예측을 하나씩 덧붙이도록 하세요.
- 검증 비용에 따라 정렬하기: “검증에 필요한 시간”이 짧은 순서대로 정렬하게 하고, 가장 쉽게 검증할 수 있는 항목부터 확인하세요.
- 플래그십 모델로 순위 재검토하기: 후보 목록은 저렴한 모델로 먼저 만들고, 최종 순위와 추론은 claude-opus-5-5에 맡기세요.
프롬프트 템플릿
from research_client import ask, report

PROMPT = """你是一名严谨的研究助理。下面是一组观测数据和背景,不包含任何关于成因的线索。

【观测】
{observation}

【背景约束】
{context}

请完成:
1. 推演“产生这组数据的过程最可能怎么实现”,至少列出 5 个候选机制;
2. 每个机制给出一条可证伪预测:若成立,数据中必然出现的可检验特征;
3. 估计验证每条预测的成本(低/中/高),按成本升序输出;
4. 指出你最不确定的环节。
输出为 Markdown 表格 + 简短说明。"""

draft = ask(PROMPT.format(
    observation="NIST P-256 种子:C49D3608 86E70493 6A6678E1 139D26B7 819F7E90",
    context="1997-1998 年由政府机构用软件生成;官方未公布生成方法;常见猜测为短语哈希但未被证实",
), stage="draft")

final = ask("请审查并修正以下候选机制列表,删除无法证伪的条目,重新排序:\n" + draft,
            stage="verify", max_tokens=3000)
print(final)
report()
이 단계가 적절하게 수행됐는지는 두 가지 기준으로 판단할 수 있어요. 각 메커니즘에 반증 가능한 예측이 있는지, 그리고 첫 번째로 제시된 검증을 한 시간 안에 마칠 수 있는지 확인하세요. 둘 중 하나라도 충족하지 못하면 모델에 다시 작성하도록 요청하세요.
연구형 AI Agent 활용법 2: 모델에게 스캔·검증 스크립트 작성 맡기기
이 단계는 Claude가 직접 스캐너를 작성해 생성기와 슬라이스 조합 34가지를 살펴본 방식에 해당해요. 핵심은 ‘그럴듯해 보인다’를 ‘통계적으로 우연일 가능성이 낮다’로 바꾸는 거예요. 매개변수 스캔, 신호 탐지, 검색 데이터의 숨겨진 구조 탐색 같은 작업에 활용할 수 있어요.
진행 단계
- 활용법 1에서 검증 비용이 가장 낮은 예측을 골라 모델에 전달하고, 표준 라이브러리만 사용하는 스캔 스크립트를 작성하도록 요청해요.
- 스크립트에서 무작위 대조군도 함께 실행하고, ‘실제 데이터 적중률’과 ‘무작위 데이터 적중률’을 출력하도록 요청해요.
- 스크립트는 직접 로컬에서 실행하고, 모델은 코드만 작성하도록 해요. 결과를 보고하는 역할까지 맡기지는 마세요.
- 결과가 유의미하면 그다음에 플래그십 모델에 더 엄격한 상태 복원이나 피팅 스크립트 작성을 요청해요.
예시: ‘상위 비트가 모두 0’인 통계적 특징 재현하기
아래 스크립트는 이번 사례에서 확인된 특징의 원리를 보여줘요. lrand48은 48비트 상태값의 상위 31비트를 반환하므로 32비트 워드에 저장하면 최상위 비트는 항상 0이에요. 반면 진짜 무작위 데이터에서 각 워드의 최상위 비트가 0일 확률은 절반뿐이에요.
import os

def lrand48_stream(seed32, n):
    x = (seed32 << 16) | 0x330E          # srand48 초기화: 하위 16비트는 0x330E로 고정
    out = []
    for _ in range(n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        out.append(x >> 17)               # lrand48은 상위 31비트만 반환
    return out

def top_bit_zero_ratio(words):
    return sum(1 for w in words if w >> 31 == 0) / len(words)

lr = lrand48_stream(870000000, 20)        # 1997년 전후의 Unix 타임스탬프
rnd = [int.from_bytes(os.urandom(4), "big") for _ in range(20)]
print("lrand48 최상위 비트가 0인 비율:", top_bit_zero_ratio(lr))   # 항상 1.0
print("진짜 무작위 데이터에서 최상위 비트가 0인 비율:", top_bit_zero_ratio(rnd))  # 약 0.5 전후로 변동
공식 코드로 최종 결론 검증하기
Anthropic 연구 페이지에는 CC0 라이선스로 공개된 재현 코드가 포함돼 있어요. 공식 안내에 따르면 아래 매개변수를 사용했을 때 P-256 표준에 포함된 시드가 출력돼야 해요.
from datetime import datetime, timezone

def unix(when):
    return int(datetime.fromisoformat(when).replace(tzinfo=timezone.utc).timestamp())

def candidate(t, n, per, shift, width):
    x, out = (t << 16) | 0x330E, ""
    for i in range(per * n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        if i >= per * (n - 1):
            out += "%0*X" % (width, x >> shift)
    return out

seed = candidate(unix("1997-08-16 01:52:34"), 1842, 20, 40, 2)
print(seed)
print("표준과 일치:", seed == "C49D360886E704936A6678E1139D26B7819F7E90")
스크립트는 타임스탬프로 lrand48을 초기화한 뒤, 출력값 20개마다 20바이트 후보 시드를 만들어요. 1842번째 후보가 표준에 포함된 시드예요. 전체 검증은 일반 노트북에서도 1초 이내에 끝나요. ‘가설을 세우는 비용은 높고, 결론을 검증하는 비용은 낮다’는 점이 이런 연구 작업에서 가장 이상적인 구조예요.
연구형 AI Agent 활용법 3: 자동 채점기를 붙여 점수가 수렴할 때까지 반복하기
앞의 두 가지 활용법은 사람이 결과를 판단하지만, 세 번째 방법은 프로그램에 판단을 맡겨요. 채점기를 작성하고 모델이 매 라운드마다 해결안을 제출하면, 채점기는 점수와 실패 사례를 반환해요. 모델은 이를 바탕으로 수정하고 점수가 더 이상 오르지 않을 때까지 반복하죠. 데이터 추출 규칙, 피팅 함수 형식, 실험 매개변수 탐색처럼 평가 기준이 명확한 작업에 적합해요.
진행 단계
- 모델을 찾기 전에 채점기부터 작성해요. 채점기는 결정론적으로 동작해야 하고, 모델이 직접 점수를 매기게 해서는 안 돼요.
- 개발 세트와 홀드아웃 세트를 분리해요. 피드백에는 개발 세트만 사용하고, 마지막에 홀드아웃 세트로 과적합 여부를 확인해요.
- 제출 형식을 제한해요. 모델이 생성한 코드를 직접 실행하는 대신 JSON이나 정규식 같은 데이터 형식으로 제출하게 해요. 코드 실행이 꼭 필요하다면 샌드박스에서 실행해야 해요.
- 수렴 조건을 설정해요. 만점, 2회 연속 점수 향상 없음, 최대 라운드 도달 중 하나라도 충족하면 반복을 중단해요.
- 저렴한 모델로 반복 과정을 먼저 점검한 다음, 플래그십 모델로 정식 실험을 진행해요.
예시: 실험 기록에서 매개변수를 추출하는 정규식 반복 개선
import json, re
from research_client import chat, report

DEV = [
    ("样品A在 350 ℃ 退火 2 小时后测得电导率 4.1 S/m。", {"temp_c": 350, "hours": 2, "cond": 4.1}),
    ("退火温度 420°C,保温 1.5 h,电导率为 12.3 S/m。", {"temp_c": 420, "hours": 1.5, "cond": 12.3}),
    ("B组:300摄氏度下处理 3 小时,σ=0.85 S/m。", {"temp_c": 300, "hours": 3, "cond": 0.85}),
    ("在450 ℃条件下退火4h,测得电导率 20 S/m。", {"temp_c": 450, "hours": 4, "cond": 20}),
]
HOLDOUT = [
    ("样品E 380 ℃ 退火 2.5 小时,电导率 7.6 S/m。", {"temp_c": 380, "hours": 2.5, "cond": 7.6}),
    ("C组于 500°C 保温 0.5 h,σ = 33.1 S/m。", {"temp_c": 500, "hours": 0.5, "cond": 33.1}),
]
FIELDS = ["temp_c", "hours", "cond"]

def score(patterns, data):
    hit, fails = 0, []
    for idx, (text, label) in enumerate(data):
        for f in FIELDS:
            try:
                m = re.search(patterns.get(f, "(?!)"), text)
                ok = m is not None and abs(float(m.group(1)) - label[f]) < 1e-9
            except (re.error, IndexError, ValueError, TypeError):
                ok = False
            hit += ok
            if not ok:
                fails.append(f"样本{idx} 字段{f} 抽取失败:{text}")
    return hit / (len(data) * len(FIELDS)), fails

def parse_json(text):
    return json.loads(text[text.find("{"): text.rfind("}") + 1])

messages = [{"role": "user", "content":
    "为下列实验记录写 Python 正则,抽取 temp_c、hours、cond 三个字段,每个正则恰好一个捕获组,捕获纯数字。"
    "只输出 JSON,例如 {\"temp_c\": \"...\", \"hours\": \"...\", \"cond\": \"...\"},注意转义反斜杠。\n"
    + "\n".join(t for t, _ in DEV)}]

best, stale, patterns = -1.0, 0, {}
for rnd in range(6):
    reply = chat(messages, stage="draft", max_tokens=800)   # 跑通后把 stage 改为 "verify"
    try:
        patterns = parse_json(reply)
        s, fails = score(patterns, DEV)
    except (ValueError, json.JSONDecodeError):
        s, fails = 0.0, ["输出不是合法 JSON"]
    print(f"第 {rnd + 1} 轮 开发集得分 {s:.2f}")
    if s >= 1.0:
        break
    stale = stale + 1 if s <= best else 0
    best = max(best, s)
    if stale >= 2:
        break
    messages += [{"role": "assistant", "content": reply},
                 {"role": "user", "content": "以下抽取失败,请修改正则后重新输出完整 JSON:\n" + "\n".join(fails)}]

print("留出集得分:", score(patterns, HOLDOUT)[0])
report()
개발 세트에서 만점을 받았는데 홀드아웃 세트 점수가 눈에 띄게 낮다면 모델이 ‘정답을 외운’ 것일 수 있어요. 이때는 반복을 계속하기보다 개발 세트를 확장해야 해요.
연구형 AI Agent 활용법 3가지 비교
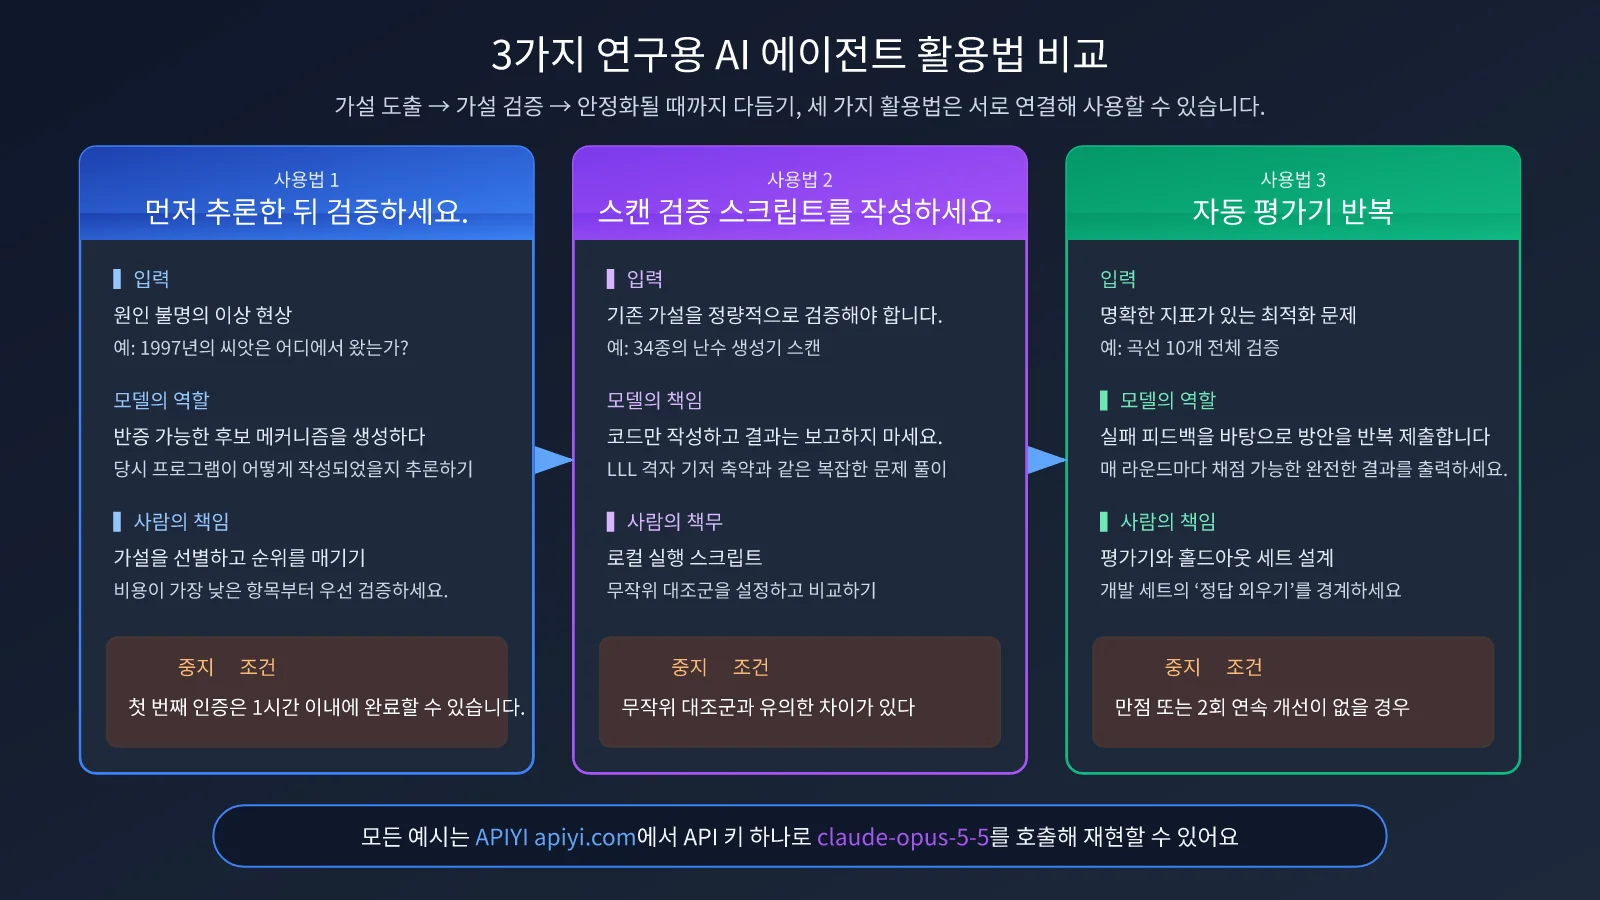
| 항목 | 활용법 1: 메커니즘 추론 | 활용법 2: 스캔·검증 스크립트 | 활용법 3: 자동 채점 반복 |
|---|---|---|---|
| 해당 사례 단계 | 1997년 프로그램 작성 방식 추론 | 생성기 34가지 스캔, 통계적 특징 탐색 | 상태 복원 후 곡선 10개 전체 검증 |
| 적합한 작업 | 원인을 알 수 없는 이상 현상, 역공학적 추론 | 가설은 있지만 정량 검증이 필요한 경우 | 평가 지표가 명확한 최적화 문제 |
| 모델의 역할 | 반증 가능한 메커니즘 후보 생성 | 코드 작성, 결과 보고는 하지 않음 | 해결안을 반복 제출 |
| 사람의 역할 | 가설을 선별하고 우선순위 지정 | 로컬에서 실행하고 대조군 확인 | 채점기와 홀드아웃 세트 설계 |
| 플래그십 모델을 투입할 시점 | 최종 추론 및 우선순위 지정 | 복잡한 계산 문제(예: LLL) 해결 | 정식 실험 라운드 |
| 중단 조건 | 첫 검증을 1시간 이내에 완료할 수 있을 때 | 무작위 대조군과 차이가 유의미할 때 | 만점 또는 2회 연속 점수 향상 없음 |
| 호출 방식 | APIYI apiyi.com의 통합 인터페이스 | 동일 | 동일 |
세 가지 방법은 함께 활용할 수 있어요. 활용법 1로 가설을 세우고, 활용법 2로 검증한 다음, 활용법 3으로 검증된 해결안을 안정적으로 다듬으면 돼요.
Claude 같은 연구 작업에 플래그십 모델이 필요한 이유
모든 연구 단계에 플래그십 모델이 필요한 건 아니지만, 작은 모델로 바꾸면 사실상 해내기 어려운 작업도 있어요. 아래 표를 기준으로 판단해 보세요.
| 판단 기준 | 해당하면 플래그십 모델 권장 | 이유 |
|---|---|---|
| 여러 분야를 넘나드는 연상이 필요함 | 예: ‘곡선 시드’에서 ‘90년대 C 라이브러리 구현 세부 사항’으로 연결 | 작은 모델은 문제의 표면에 머물러 계속 구문을 추측하는 경향이 있어요 |
| 추론 단계가 3단계를 넘고, 각 단계가 앞 단계에 의존함 | 예: 추론 → 스캔 → 서명 → 상태 복구 | 중간 단계에서 하나라도 틀리면 이후 과정이 모두 어긋나요 |
| 스스로 의문을 제기해야 함 | 예: “혹시 테스트 환경에서 실행 중인 건 아닐까?”라고 의심 | 플래그십 모델은 반례를 적극적으로 찾을 가능성이 더 높아요 |
| 자명하지 않은 알고리즘이 포함됨 | 예: LLL 격자 기저 축약, 절단된 LCG 상태 복구 | 코드의 정확성이 검증 결과의 타당성을 직접 좌우해요 |
| 결론이 논문에 실리거나 실험 투입 여부를 결정함 | 외부에 공개하는 모든 결론 | 오류로 인한 비용이 모델 호출 비용보다 훨씬 커요 |
반대로 형식 변환, 대량 요약, 평가기 파이프라인 디버깅 같은 작업은 저렴한 모델로 충분해요. 비용 관리의 핵심은 플래그십 모델 사용을 줄이는 게 아니라, 표에 나온 작업에만 플래그십 모델을 사용하는 거예요.
자주 묻는 질문 FAQ
Q1: Claude가 NIST 타원 곡선을 해독했나요?
아니요. Claude가 복원한 것은 시드 생성 과정이에요. 해당 시드는 타임스탬프로 초기화한 lrand48에서 생성됐어요. 새로운 공격 방법도 아니고 취약점을 의미하지도 않으므로, 사용자가 설정을 변경하거나 마이그레이션할 필요는 없어요. 오히려 이 결과는 시드가 인위적으로 선택되지 않았다는 점을 보여줘요.
Q2: 이 방법은 기존의 무차별 대입 검색과 어떻게 다른가요?
무차별 대입 검색은 정해진 가정 공간 안에서 모든 경우를 탐색해요. Claude는 먼저 가정 공간을 바꿨어요. “어떤 문구를 해시했을까?”에서 “어떤 난수 생성기를 사용했을까?”로 접근을 전환한 다음, 제한된 범위(숨겨진 비트 2^17개)만 탐색했죠. 성공 여부를 결정한 핵심은 첫 단계예요.
Q3: 이 연구는 언제 공개됐나요? 아직 해결되지 않은 부분은 무엇인가요?
Anthropic 연구 페이지와 @AnthropicAI 게시물은 모두 2026년 10월 17일에 공개됐어요. 현재 B-163의 시드는 아직 풀리지 않았고, P-224부터 P-521까지의 생성원 G를 어떻게 만들었는지도 밝혀지지 않았어요. 일부 후보 곡선을 건너뛴 이유도 아직 알 수 없어요.
Q4: 이 세 가지 활용법을 적용하기 좋은 연구 분야는 무엇인가요?
– **실험 이상 현상 추적**: 기기 데이터에서 주기적인 아티팩트가 발견되면, 첫 번째 활용법으로 데이터 수집 소프트웨어의 구현 방식을 추론해 보세요.
– **과거 논문 재현**: 파라미터가 빠져 있다면, 두 번째 활용법으로 가능한 파라미터 조합을 탐색해 보세요.
– **데이터 추출 및 정제**: 세 번째 활용법에 평가기를 더해 안정적인 규칙을 반복적으로 찾아보세요.
Q5: 하나의 Key로 여러 플래그십 모델을 호출해 교차 검증하려면 어떻게 해야 하나요?
APIYI apiyi.com에 가입해 Key를 만들고, `base_url`을 `https://api.apiyi.com/v1`로 설정하세요. `model` 파라미터만 바꾸면 claude-opus-5-5와 GPT 계열, Gemini 계열 플래그십 모델 사이를 전환할 수 있어요. 사용 가능한 모델명은 콘솔 목록을 확인해 주세요.
Q6: 연구용 AI 에이전트에는 어떤 한계가 있나요?
– 모델이 그럴듯한 메커니즘을 지어낼 수 있으므로, 모든 결론에는 로컬에서 실행할 수 있는 검증 스크립트가 필요해요.
– 평가기를 반복 개선하다 보면 개발 세트에 과적합되기 쉬워요. 반드시 홀드아웃 세트를 따로 남겨 두세요.
– 여러 차례 호출하면 비용이 누적돼요. 먼저 저렴한 모델로 흐름을 점검하고, 사용량도 기록하세요. 요금은 APIYI apiyi.com 콘솔에서 확인할 수 있어요.
연구형 AI 에이전트 핵심 요점
- 결론의 범위: Claude가 밝혀낸 것은 시드의 출처이지, 암호학적 취약점이 아니에요. 오히려 타원곡선의 신뢰도는 높아졌어요.
- 핵심 단계: 기존 가설 공간에서 연산량을 늘리는 것보다 가설 공간 자체를 바꾸는 편이 더 효과적이에요.
- 검증 우선: 모델은 스크립트를 작성하고 사람은 직접 실행해요. 모든 결과를 무작위 기준선과 비교해야 해요.
- 평가기 폐루프: 결정론적 평가와 홀드아웃 세트를 활용해 점수가 수렴할 때까지 반복하고 멈춰요.
- 모델 분업: 저렴한 모델로 절차를 점검하고, 중요한 추론과 검증에만 플래그십 모델을 사용해요.
- 시작하는 방법: APIYI apiyi.com에서 API 키 하나로 claude-opus-5-5를 호출하고, 다른 모델로 전환해 교차 검증할 수 있어요.
요약
Claude가 NIST 타원곡선 시드의 수수께끼를 풀어낸 사례가 연구자에게 주는 교훈은 크게 세 가지예요.
- 먼저 생성 원리를 추론하세요: 답을 바로 추측하기보다 데이터가 어떻게 만들어졌는지부터 살펴보세요.
- 스크립트로 검증하세요: 각 가설에는 실행 가능한 검증 코드와 무작위 대조군이 필요해요.
- 평가기 폐루프를 구성하세요: 판단은 결정론적 프로그램에 맡기고, 점수가 수렴할 때까지 반복하세요. 홀드아웃 세트로 과적합도 확인해야 해요.
비용 관리도 중요해요. 먼저 저렴한 모델로 절차를 점검하고, 논문의 결론이나 복잡한 알고리즘을 다루는 단계에서는 플래그십 모델로 전환하세요. APIYI apiyi.com을 통해 이 글의 코드를 처음부터 끝까지 실행해 보세요. 공식 재현 코드로 P-256 시드를 확인한 다음, 세 가지 활용법을 자신의 연구 주제에 적용해 볼 수 있어요.
함께 읽어보기
- 📘 OpenAI SDK로 Claude 시리즈 모델 호출하기 – 호환 인터페이스의 매개변수 차이를 알아보세요
- 📊 대규모 언어 모델 API 호출 비용 관리 실전 – usage 통계와 예산 알림을 활용하는 방법을 알아보세요
- 🚀 여러 모델을 교차 검증하는 워크플로 구축하기 – 서로 다른 최상위 모델이 결론을 교차 확인하도록 설정해 보세요
📚 참고 자료
- Anthropic Frontier Red Team 연구 페이지: ECDSA 곡선 시드 출처 연구
- 링크:
www.anthropic.com/research/ecdsa-curve-origins -
설명: 연구의 전체 방법론과 미해결 과제, CC0 라이선스 재현 코드가 포함된 1차 자료입니다.
-
@AnthropicAI 공식 X 게시물(2026-10-17): “그저 타임스탬프일 뿐입니다.”
- 링크:
x.com/AnthropicAI -
설명: 공식 발표를 확인하고 커뮤니티 논의도 살펴볼 수 있습니다.
-
APIYI 문서 센터: OpenAI 호환 인터페이스 호출 안내
- 링크:
docs.apiyi.com - 설명:
base_url설정, 모델 목록, 요금 안내를 확인할 수 있습니다.
작성자: APIYI 기술팀
기술 관련 의견 교류: 연구에서 AI Agent를 활용한 경험을 댓글로 공유해 주세요. 자세한 연동 자료는 APIYI docs.apiyi.com 문서 센터에서 확인할 수 있습니다.