2026年10月20日、Google Cloudのロンドンの1つのゾーンで、停電による障害が約8時間続きました。その5日前には、DeepSeekも午前中の大半にわたって利用できなくなりました。開発者の間では、自分たちのAIアプリも次に同じような影響を受けるのではないか、という声が上がっています。
上流サービスは、いつ止まるかわかりません。モデルAPIを呼び出しているだけなら、サーバーを別の場所に移す必要はありません。ただし、ビジネスを1社のモデルだけに依存させるのは避けましょう。
この記事でわかること:どんな場合に対策が必要で、どんな場合は不要なのかを見極め、モデルの代替手段を用意する方法がわかります。
今週の2つの障害で、それぞれ何が止まったのか
まずはGoogle Cloudです。2026年10月20日、北京時間14時08分から22時00分まで、ロンドンのeurope-west2-bという1つのゾーンで、電源関連の問題による障害が発生しました。継続時間は7時間52分です。影響を受けたのは、このゾーンに配置されたコンピューティング、ストレージ、データベース、ネットワークです。モデルAPIをリモートから呼び出しているだけのユーザーは、今回の障害から直接的な影響を受けません。ただし、自社サービスがちょうどこのゾーンで稼働していれば、その日の午後はバックグラウンドジョブもデータベース接続も外部向けのAPIも、そこで止まってしまいます。誰も、停止前に代わりに処理を済ませておくことはできません。
次はDeepSeekです。2026年10月15日、北京時間8時11分ごろから、Webサイト、チャット、V4 ProとV4.1 FlashのAPIの一部で障害が発生しました。公式ステータスページの記録では4時間52分続き、当日13時04分に復旧しています。財新やサウスチャイナ・モーニング・ポストは「約5時間」と報じていますが、継続時間は公式記録に基づいています。DeepSeekはその後、10月8日から14日までの利用料金をクレジットとして返還しました。原因は公式に発表されていないため、ここでは推測しません。ユーザーにとって、その日の午前中にサービスを使えたかどうかを左右したのは、原因ではなく、別の手段があったかどうかです。
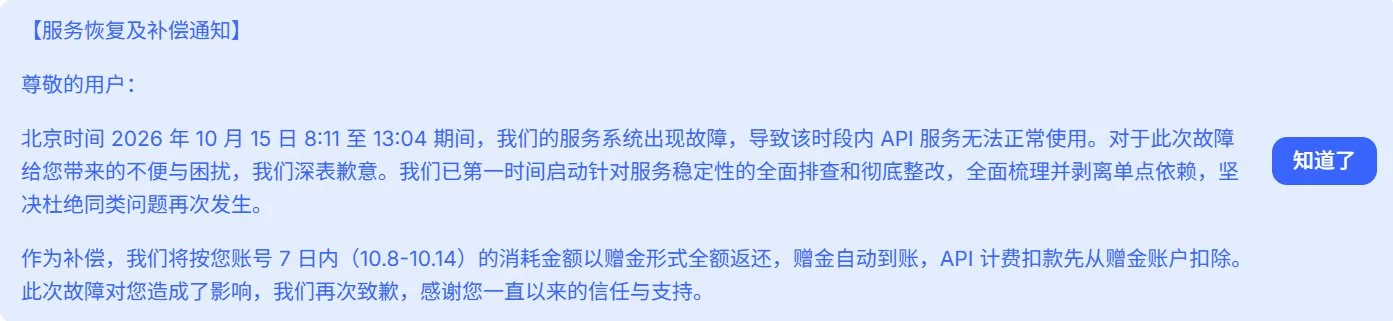
図:DeepSeekがユーザーに送った、サービス復旧および補償に関する通知。北京時間10月15日8:11から13:04まで、APIサービスを正常に利用できない状態が続きました。補償として、各アカウントの10月8日から14日までの利用額が、クレジットとして全額返還されます。クレジットは自動的に付与され、APIの利用料金にはクレジット残高が優先して充当されます。
どちらの障害も、困るポイントは同じです。モデルはその日のワークフローの一部なので、APIが止まれば、コーディングも情報収集もバッチ処理もそこで中断します。上流サービスが復旧するのを待っているうちに、半日が過ぎてしまいます。クレジットの返還で補えるのは請求額であり、止まった仕事ではありません。たとえば、その日に翻訳をまとめて納品する予定だったり、評価を一巡させる予定だったり、リリースを急いでいたりしても、事後の補償で作業が勝手に完了するわけではありません。作業は後ろ倒しになり、翌日の予定まで圧迫します。
| 項目 | Google Cloudの障害で確認された内容 |
|---|---|
| 障害番号 | Xs2XTHzAVC9YnafnPyzj |
| 影響範囲 | europe-west2リージョン内のeurope-west2-bゾーン |
| 原因 | 電源関連の問題。公式から詳細情報の発表はなし |
| 開始時刻 | 北京時間2026年10月20日14時08分 |
| 終了時刻 | 北京時間2026年10月20日22時00分。継続時間は7時間52分 |
| 影響なし | Looker Studio |
ゾーンとリージョンはどう違う?
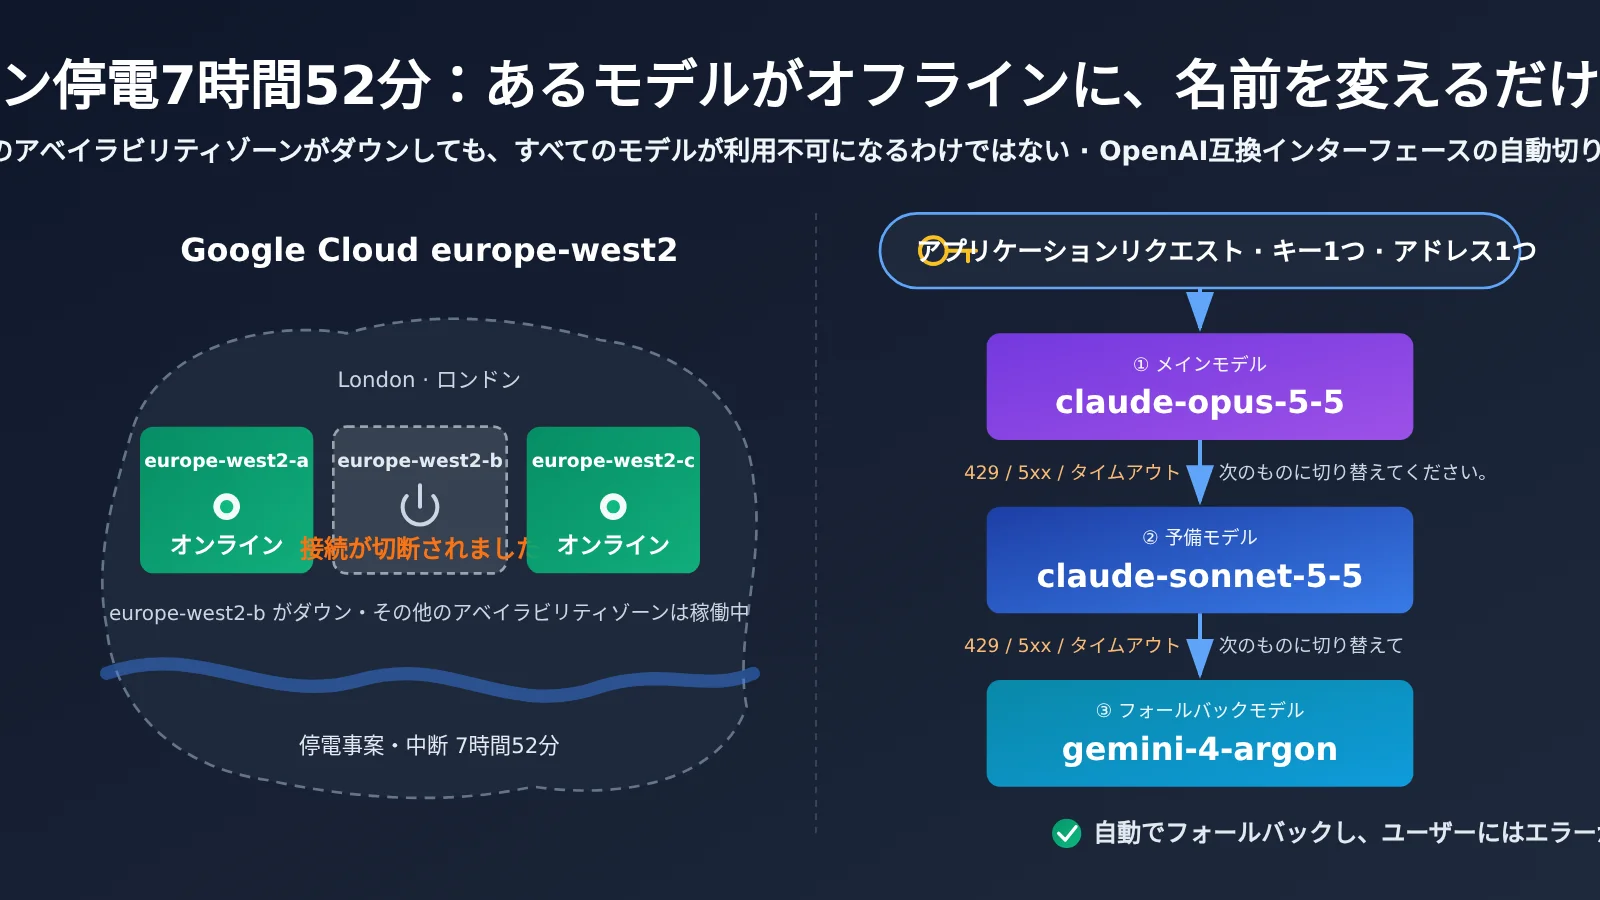
「ロンドンで停電」と聞くと、Google Cloudのロンドン全体が停止したと思うかもしれませんが、実際は違います。リージョン(europe-west2)は、Googleがロンドンに構えるデータセンター群のようなものです。ゾーン(europe-west2-a、b、c)は、その中にある互いに分離された複数の建物にあたります。それぞれ独立した電源とネットワークを備えているのは、1つの建物に障害が起きても、ほかの建物が稼働を続けられるようにするためです。今回停止したのは3つのうちの1つで、残る2つは通常どおり稼働していました。
つまり、実際に大きな影響を受けたのは、サービスをbゾーンにしか配置していなかったチームです。もともとサービスをaゾーンやcゾーンにも分散していれば、稼働中のゾーンへトラフィックを切り替えられるため、影響を大幅に抑えられます。モデルAPIをリモートから呼び出しているだけの人は、今回の停電をほとんど感じなかったでしょう。
2つの障害を並べて見る
| 比較項目 | Google Cloud ロンドン | DeepSeek |
|---|---|---|
| 発生時刻(北京時間) | 2026年10月20日14時08分~22時00分 | 2026年10月15日8時11分~13時04分 |
| 継続時間 | 7時間52分 | 4時間52分 |
| 停止したもの | europe-west2-b内のコンピューティング、ストレージ、データベース、ネットワーク | Webサイト、チャット、V4 ProとV4.1 FlashのAPI |
| 原因 | 電源関連の問題。詳細情報の発表なし | 公式発表なし |
| 事後対応 | 可能であれば、別のゾーンまたはリージョンへの移行を推奨 | 10月8日から14日までの利用分をクレジットとして返還 |
| モデルAPIを呼び出すだけの人 | 直接的な影響なし | 影響を直撃。代替手段がなければ、待つしかない |
2つを並べると、違いがはっきりします。Google Cloudの障害で困ったのは、bゾーンにマシンを配置していた人たちです。対策は、複数のゾーンに分散してデプロイすることです。一方、DeepSeekの障害で困ったのは、1社のモデルしか使っていなかった人たちです。対策は、あらかじめ代替モデルを用意しておくことです。前者はデータセンターの話で、後者はモデルの呼び出し方の話です。以下では後者について説明します。
今回の障害から学ぶべきこと
サービスは停止することがあります。だからこそ、あらかじめ2つ目、3つ目の選択肢を用意しておきましょう。できれば、同じ事業者に依存しない構成が理想です。同じ事業者内で安いプランに切り替えるだけでは、代替策になりません。事業者全体に障害が起きれば、どちらのプランも同時に使えなくなるからです。
切り替えるタイミングにも注意が必要です。429、500、502、503、504、タイムアウトの場合に限ってモデルを切り替えましょう。これらは相手側が一時的に処理しきれていない状態なので、別のモデルに切り替えることで成功する可能性があります。一方、401、403、コンテンツセーフティによる拒否の場合は切り替えないでください。APIキーやコンテンツ自体に問題があるため、モデルをいくつ切り替えても同じ結果になります。
もう一点、切り分けて考えるべきことがあります。障害が起きたアベイラビリティゾーンに自社でデプロイしているデータベースやストレージは、モデルを切り替えても復旧しません。アベイラビリティゾーンをまたいだデプロイを検討しましょう。モデルのフォールバックとデータセンターの災害対策は別の話なので、混同しないようにしてください。
フォールバックを用意したら、障害が収まった後も取り外さないでください。通常時は余計なリクエストを発生させず、メインモデルで一度で成功すれば使われることもありません。それでも、次に障害が起きたときには自動で機能するため、深夜に起きてコードを変更する必要がなくなります。実装に取りかかる前に、まず各モデルへ個別に最もシンプルなリクエストを送り、モデル名に誤りがないこと、正常に応答が返ることを確認しましょう。そのうえで、モデルをどうつなぐかを考えてください。モデルによって回答のスタイルは異なります。出力形式に厳密な要件がある場合は、systemプロンプトに形式を明記しておくと、モデル切り替え後の差を抑えられます。
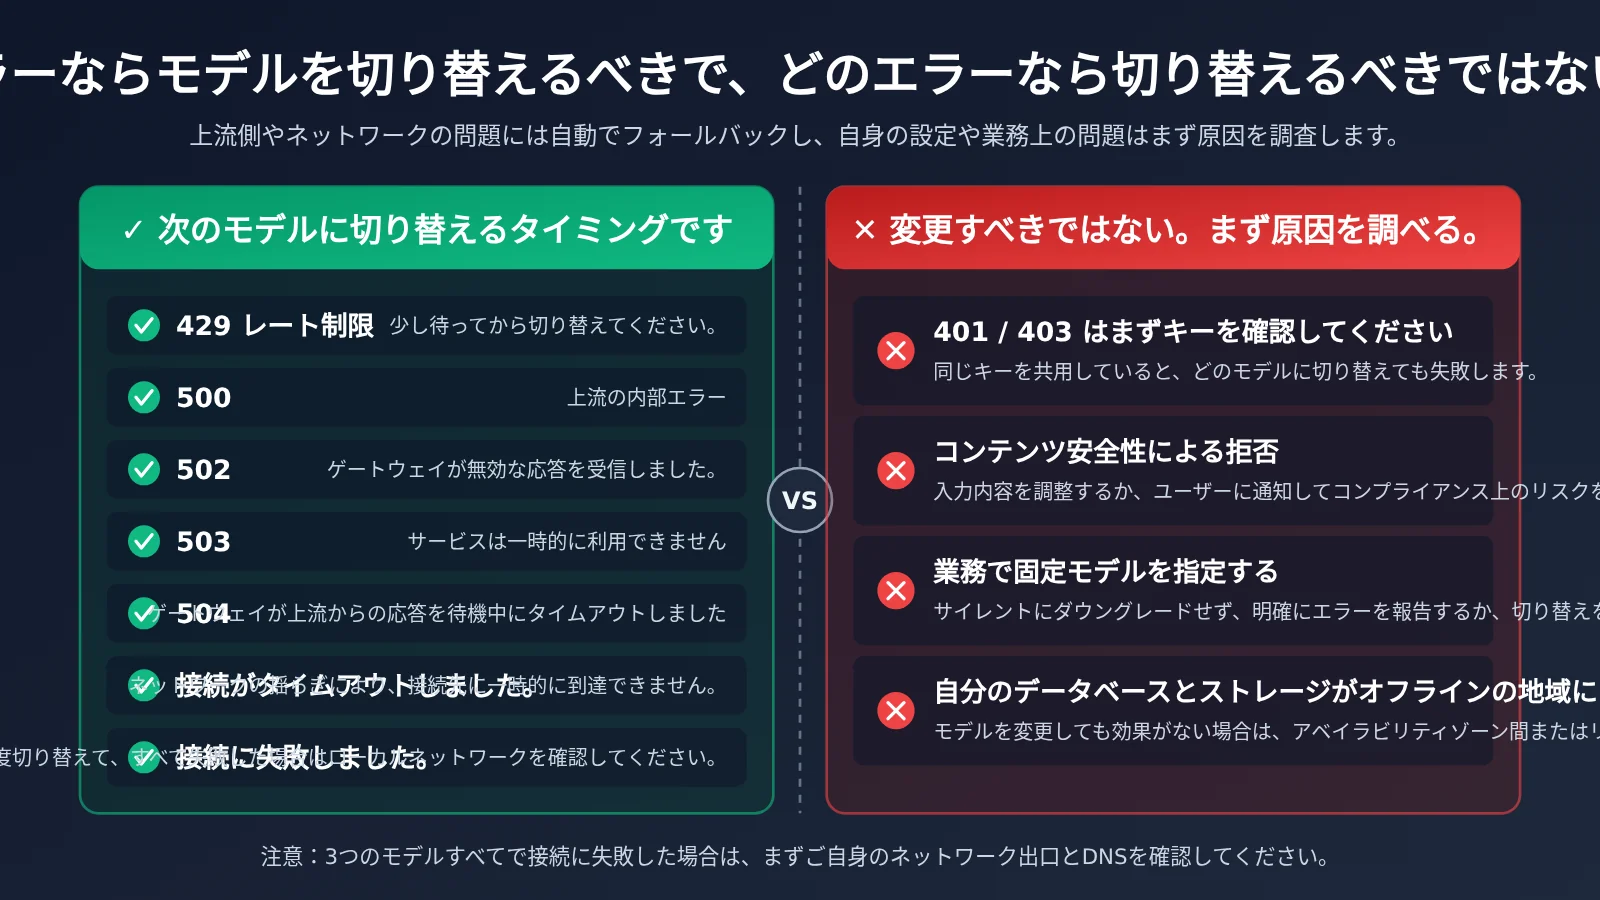
フォールバック経路の設定方法
「失敗したら切り替える」と知っているだけでは不十分です。切り替えが早すぎても遅すぎても問題が起きます。ここでは、よく質問される設定を紹介します。唯一の正解はないので、自分の業務に合わせて調整してください。
| 設定 | 推奨値 | 理由 |
|---|---|---|
| 同じモデルを何回リトライするか | 最大1回。再度失敗したら次のモデルに切り替える | 上流で障害が起きているとき、同じモデルへの連続リトライは、待ち時間を増やすだけになりがちです |
| 1回のリクエストをどれくらい待つか | 対話型は短め、長文生成は長め | 待たせすぎると、切り替わる前にユーザーがページを閉じてしまいます |
| 429が返ったときの対応 | 1〜2秒ほど待ってから切り替える | レート制限は一時的なピークが原因の場合もあり、少し待てば解消することがあります |
| 経路全体で待つ時間の上限 | 3つのモデルを合わせても、ユーザーが許容できる待ち時間を超えないようにする | 3つのモデルすべての応答が遅い場合に、リクエストがいつまでも処理中になるのを防ぎます |
| 記録するログ | どのモデルが成功・失敗したか、エラーコードはいくつか | 障害が起きている事業者を後から把握し、順序を見直すべきか判断できます |
| 担当者に通知するタイミング | 予備モデルが使われる割合が急に増えたとき | フォールバックが機能するとユーザーは気づかず、チームも気づかないことがあります。メインモデルに問題が起きていると、誰かが把握できるようにしましょう |
最後の項目は特に見落とされがちです。フォールバックが優れているほど、メインモデルの障害は目立たなくなります。ログを確認する人がいなければ、メインモデルが丸一日停止していても、誰も気づかず、気づいたときには予備モデルの呼び出しが大量に発生し、請求額が膨らんでいるかもしれません。
モデルを切り替えても、APIキーはそのまま
フォールバックで一番避けたいのは、大がかりな改修です。モデルごとにアカウントを作り、接続先を変え、リクエスト形式まで修正するとなると、多くのチームは次に障害が起きるまで手をつけないでしょう。
APIYIなら、接続先は https://api.apiyi.com/v1/chat/completions のまま、APIキーもそのままで、リクエスト本文の model だけを変更できます。メインモデルに claude-opus-5-5 を使い、失敗したら claude-sonnet-5-5、さらに失敗したら gemini-4-argon に切り替えます。最初の2つは同じプロバイダー、3つ目は別のプロバイダーなので、特定のプロバイダー全体に問題が起きても、別の選択肢が残ります。
改修も最小限で済みます。アプリケーションコードに、順番に試すモデル名のリストを追加するだけです。リクエスト形式、認証方法、レスポンス構造は変更せずに使えるため、テストも簡単です。
| 順番 | モデル名 | 入力価格 | 出力価格 | 役割 |
|---|---|---|---|---|
| 1 | claude-opus-5-5 | 4 | 20 | メインモデル |
| 2 | claude-sonnet-5-5 | 2 | 10 | 1つ目の予備。同じプロバイダーの低価格モデル |
| 3 | gemini-4-argon | 2 | 10 | 2つ目の予備。別のプロバイダー |
| 置き換え候補 | gpt-6-astra | 10 | 50 | より高価な予備モデル。OpenAIのインターフェースのみ対応 |
| 置き換え候補 | deepseek-v4.1-flash | 0.30 | 1.20 | 低価格の予備モデル |
上表の価格は、2026-10-21時点の価格ページをもとに、倍率1で整理したものです。価格は変更される場合があるため、api.apiyi.com の価格ページで最新情報をご確認ください。単位は米ドル/100万トークンです。
3ステップでフォールバックを設定
ステップ1:APIキーを取得する。 api.apiyi.com に登録してAPIキーを作成します。従量課金制で、国内から直接接続でき、海外発行のクレジットカードも不要です。この1つのAPIキーで、上表のすべてのモデルを呼び出せます。
ステップ2:モデルごとに動作確認する。 接続先に https://api.apiyi.com/v1 を設定します。OpenAIのインターフェース形式と互換性があるため、もともとOpenAI公式ライブラリを使っていたコードなら、接続先とAPIキーを変更するだけで利用できます。同じプロンプトを使って claude-opus-5-5、claude-sonnet-5-5、gemini-4-argon をそれぞれ実行し、正常にレスポンスが返り、形式も想定どおりであることを確認してください。
ステップ3:順番を設定し、切り替えをテストする。 3つのモデル名を順番に設定し、前のセクションのルールに沿って切り替える条件を決めます。設定後、すぐに本番環境へ反映するのではなく、まずメインモデルの待機時間を一時的に短く設定し、意図的にタイムアウトを発生させてみましょう。リクエストが2番目のモデルに切り替わり、ログにも記録されるかを確認します。このテストに成功すれば、いざというときの備えができたと言えます。詳しい設定は docs.apiyi.com の導入ドキュメントをご確認ください。
用途に合わせたモデルの順番
この記事では品質を優先した順番を紹介していますが、これが唯一の正解というわけではありません。用途に応じて、先頭にするモデルを変えられます。
| 用途 | 推奨順序 | 理由 |
|---|---|---|
| コーディング、複雑な推論 | claude-opus-5-5 → claude-sonnet-5-5 → gemini-4-argon | 品質を優先した、この記事の基本の順序 |
| カスタマーサポート、日常会話 | claude-sonnet-5-5 → gemini-4-argon → deepseek-v4.1-flash | 呼び出し回数が多く、単価も重要なため、最も高価なモデルをメインにする必要はない |
| 大量の翻訳、要約 | deepseek-v4.1-flash → gemini-4-argon → claude-sonnet-5-5 | 実行回数が多いため、低価格モデルから始め、失敗したら上位モデルに切り替える |
| 出力形式の厳守が必要な用途 | 同じプロバイダーの2モデルを先にし、最後に別のプロバイダーを設定 | 同じプロバイダーのモデルは回答の傾向が近いことが多く、切り替え時の差が小さい |
順番を決める際のポイントは2つです。最後のモデルはできるだけ別のプロバイダーにすること。そして、単価をその処理の価値に見合うものにすることです。大量翻訳の例は、フォールバックのメリットもよく表しています。10月15日に先頭のDeepSeekが停止した場合でも、リクエストは後続の2社に自動で切り替わり、タスクを最後まで完了できます。
ただし、モデルの切り替えで解決できるのは「モデル呼び出しを継続すること」です。データセンターの停電を直すことはできません。
上流サービスは停止する。別の経路を用意しておこう
公表済みの事例として、2026-10-15にDeepSeek公式サービスで発生した障害があります。当時、APIYIはVolcano Engineのフルスペック版チャネルに切り替え、モデル名を変更せずに本番環境を正常な状態へ復旧させました。出典は docs.apiyi.com のリアルタイム更新をご覧ください。
上流サービスが停止するのは、誰かの落ち度というわけではありません。何時間も復旧を待つより、あらかじめ別の経路を用意しておくほうが役に立ちます。普段はほとんど費用も人手もかかりません。必要なのは、障害が起きる前に準備を済ませておくことです。障害が起きてからでは、焦りながら改修することになります。
障害が起きたら、まず確認したい3つの場所
リクエストが突然、大量に失敗し始めても、すぐにコードを変更する必要はありません。まず2分ほどかけて、次の3か所を確認しましょう。1つ目は Google Cloud Service Health。データセンター側で障害が起きていないか確認します。2つ目は、該当するモデルプロバイダーの公式ステータスページです。今回の例なら、DeepSeekのステータスページを確認します。3つ目は docs.apiyi.com のリアルタイム情報です。APIYI側で上流の接続ルートに変更があった場合、ここに情報が掲載されます。
3か所とも正常であれば、自分の環境を確認します。APIキーの有効期限が切れていないか、残高が足りているか、ネットワークの出口やDNSに問題がないかを調べましょう。この順番を逆にすると、自分のコードを長時間調べたあとで、原因が上流サービスにあったとわかることがあります。
今日できる4つのこと
- アプリケーション内でモデルを呼び出している箇所をすべて洗い出し、1社のモデルしか使っていない箇所を確認する。
- 1社のモデルしか使っていない箇所には、別のプロバイダーの予備モデルを最低1つ追加する。
- 前述のルールに従い、429、5xx、タイムアウトの場合にのみ切り替えるようにし、切り替えのたびにログを記録する。
- メインモデルで意図的にタイムアウトを1回発生させ、リクエストが本当に予備モデルに切り替わることを確認する。
この4つを済ませておけば、次にデータセンターが停電したり、モデルプロバイダーが停止したりしても、アプリケーションが止まるのではなく、数秒遅くなる程度で済みます。
よくある質問
Q1:Google Cloudのロンドンで停電が起きた後、すぐにロンドンから移転すべきですか?
必ずしもそうではありません。公式の推奨は「可能であれば」であり、すべての利用者に即時移転を求めているわけではありません。europe-west2-b でワークロードを稼働させているチームは、別のゾーンやリージョンへの移行を検討できます。モデルAPIを呼び出しているだけのチームは移転せず、まずモデルのフォールバックを整えましょう。
Q2:モデルを切り替えると、料金は高くなりますか?
上記の順番なら、むしろ安くなります。メインモデルの claude-opus-5-5 は入力が4、出力が20で、予備モデル2つはいずれも入力が2、出力が10です。入力が10、出力が50の gpt-6-astra のようなモデルを予備リストに加えた場合に限り、コストが上がります。
Q3:1つのAPIキーで、複数のプロバイダーのモデルを呼び出せますか?
はい。これらのモデルは、いずれも同じOpenAI互換の接続先を使い、APIキーも共通です。変更するのは `model` だけです。ただし、gpt-6-astra はOpenAIのインターフェースのみ対応しているため、利用時にはご注意ください。
Q4:予備モデルに切り替えると、回答の品質は下がりますか?
差が出ることはあります。特に、最上位のモデルから低価格モデルに切り替えた場合は、その可能性が高くなります。それでも多くの用途では、少し遅く、多少品質が下がった回答でも、エラーで処理が止まるよりはよいでしょう。出力形式が重要な場合は、systemプロンプトで形式を明確に指定し、ステップ2の方法で複数モデルの出力を事前に比較してから本番環境に反映すると安心です。
Q5:障害が起きていないときも、予備モデルを設定しておくと料金がかかりますか?
かかりません。従量課金制では、実際に送信したリクエストに対してのみ料金が発生します。メインモデルで処理が成功すれば、予備モデルは呼び出されず、費用も発生しません。必要なのは導入時の作業時間と、テストで実行する数回のリクエストだけです。
要点
- 2つのサービス中断:Google Cloud europe-west2-b では7時間52分の停電が発生。DeepSeek公式の記録では、中断時間は4時間52分。
- 事実関係:ヨーロッパ全域で障害が起きたわけではなく、モデル自体も停止していません。DeepSeekは原因を公表していません。
- 切り替え条件:429、500、502、503、504、タイムアウトの場合のみ切り替えます。401、403、コンテンツセーフティによる拒否では切り替えません。
- 設定方法:予備モデルはできるだけ別のプロバイダーから選びます。接続先とAPIキーはそのまま、
modelだけを変更します。 - 動作確認:設定後、メインモデルで意図的にタイムアウトを発生させ、予備モデルに切り替わることと、ログに記録されることを確認します。
料金の返金で請求額は補えても、止まった仕事までは取り戻せません。モデルの順番をあらかじめ決めておけば、次に上流サービスで問題が起きても、ユーザーが感じるのは数秒の遅れだけで済みます。
参考資料
- Google Cloud Service Health:europe-west2 で発生した複数サービスの障害(Xs2XTHzAVC9YnafnPyzj)、2026-10-20
- Google Cloud Service Health:Google SecOps の europe-west2 セキュリティ製品に関する障害(個別記録)、2026-10-20
- BBC:Google Cloudの障害による英国の銀行・公共サービスへの影響に関する報道、2026-10-20
- DeepSeek公式ステータスページ:2026-10-15のサービス中断記録
- 公式ドキュメント:docs.apiyi.com のリアルタイム情報
著者:APIYI 技術チーム
技術に関するご相談:モデルのフォールバック設定でお困りのことがあれば、コメント欄でお気軽にご相談ください。